

Speech-to-Text-API
Sprache mit ElevenLabs Scribe v3 transkribieren
Unser genauestes Speech-to-Text-Modell. Transkribieren Sie Meetings, Anrufe und Interviews – mit Sprecherkennzeichnungen und Kontrolle über die Wörter, die wichtig sind.
- Lovable
- Veed model
- Synthesia
- Stripe
- Perplexity
- Twilio
Präziseste Speech to Text API für Batch-Verarbeitung
Erstellen Sie Untertitel, Transkripte und bearbeitbare Mitschriften für Podcasts, Videos, Interviews und andere Aufnahmen – alles mit branchenführender Genauigkeit per API.
Transkriptionsgenauigkeit auf neuem Niveau
Scribe v3 macht in 102 Sprachen 27 % weniger Wortfehler als Scribe v2 und weniger als jedes andere von uns getestete Batch-Modell.
Für jedes Szenario entwickelt
Transkription für laute Umgebungen, Hintergrundmusik, starke Akzente und Audio in geringer Qualität.
Präzise Kontrolle über Timing, Sprecher und nichtsprachliche Ereignisse.
Die ElevenLabs Transcription API erkennt Lachen, Emotionen und Soundeffekte. Mit Keyterm Prompting steuern Sie die Transkription mit domänenspezifischen Begriffen.
Audio und Video transkribieren
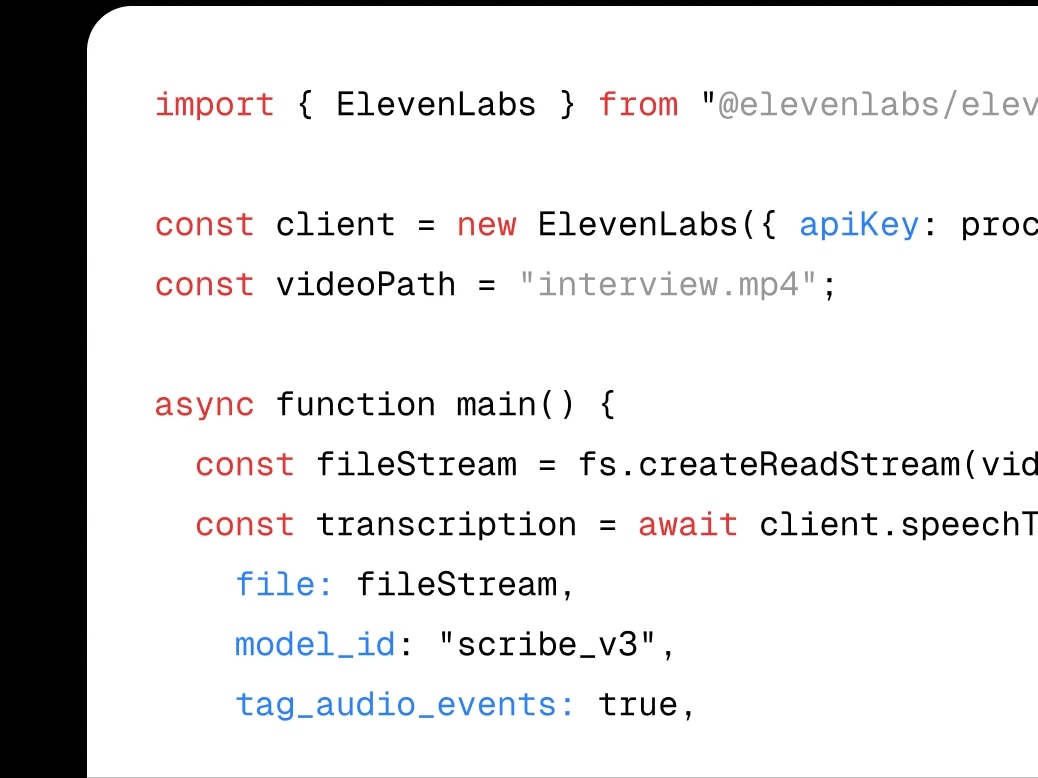
Saubere, bearbeitbare Transkripte

Keyterm Prompting

Dynamische Audiokennzeichnung
Erfassen Sie nichtsprachliche Ereignisse wie Lachen, Applaus, Musik und Hintergrundgeräusche. Transkripte enthalten den vollständigen Kontext Ihres Audios, nicht nur die Wörter.
Intelligente Sprecherdiarisierung
Identifizieren und kennzeichnen Sie automatisch bis zu 32 Sprecher. Klare Zuordnung, wer was gesagt hat, in übersichtlichen Transkripten.
Entitätserkennung
Identifizieren und markieren Sie automatisch 56 Entitätstypen, darunter Namen, Daten, Orte und Organisationen, in Ihren Transkripten.
Klinische Audiodaten mit Scribe v2 Medical transkribieren
Ein Speech-to-Text-Modell für medizinische Transkription und klinische Workflows, mit verbesserter Erkennung von Medikamentennamen sowie anatomischen und pathologischen Begriffen.
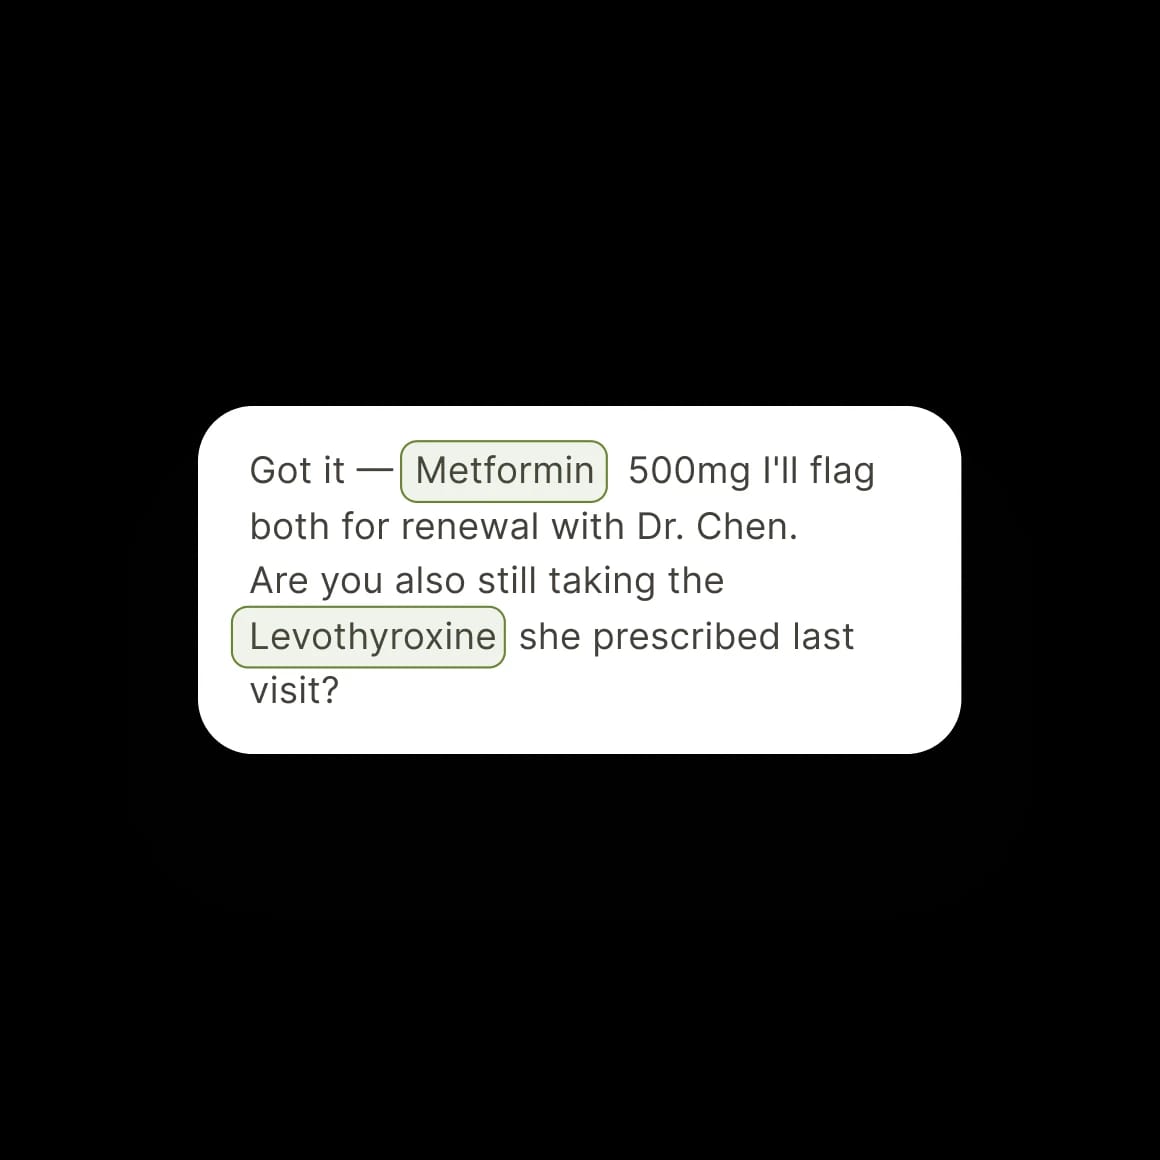
Klinische Sprache transkribieren
Wandeln Sie Gespräche zwischen medizinischem Personal und Patienten, ärztliche Diktate und Patientenaufnahmen in präzisen Text um – bereit zur Prüfung durch Fachpersonal sowie für Notizen, Kodierung und nachgelagerte Dokumentationsworkflows.
Weniger Fehler bei medizinischen Fachbegriffen
Bei Term-WER macht Scribe v2 Medical im Eka Medical ASR-Testsplit 15 % weniger Fehler als Scribe v2 und verbessert die medizinische Spracherkennung für klinisches Vokabular.
Scribe v3
Höchste Genauigkeit, entwickelt für Batch-Workloads.
- 27 % weniger Fehler als Scribe v2
- Niedrigste von uns getestete Diarisierungsfehlerrate
- Zahlenformatierung und Sprachhinweise
- Entitätserkennung und Keyterm-Prompting
- Unterstützt über 90 Sprachen
Scribe v3 Live
Niedrigste Latenz für Echtzeit-Workloads.
- Unter 150 ms Latenz
- 43 % weniger Fehler als v2 Realtime
- Keyterm-Bibliothek und mehrsprachiger Modus
- Verbesserte Sprecherwechselerkennung
- Unterstützt über 90 Sprachen
Scribe v2 Medical
Medizinisches Finetune für klinische Transkription.
- Optimiertes medizinisches Vokabular
- Transkription in über 90 Sprachen
- Wie Scribe v2 bei Alltagssprache
- Verbesserte Erkennung von Medikamentennamen
- HIPAA-geeignet für Enterprise-Kunden
Sprache in über 90 Sprachen und einer breiten Palette von Akzenten transkribieren
Hohe Genauigkeit bei Akzenten, Dialekten und verschiedenen Aufnahmebedingungen.
Ändern Sie languageCode, um Sprachen in der Vorschau anzuzeigen
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
const elevenlabs = new ElevenLabsClient({
apiKey: "<your_api_key>"
});
const response = await fetch(
"https://storage.googleapis.com/eleven-public-cdn/audio/marketing/nicole.mp3"
);
const audioBlob = new Blob([await response.arrayBuffer()], { type: "audio/mp3" });
const transcription = await elevenlabs
.speechToText.convert({
file: audioBlob,
modelId: "scribe_v3",
tagAudioEvents: true,
languageCode: , // Sprache festlegen
diarize: true
});
console.log(transcription);


Für die weltweit führenden Unternehmen und Marken
“Von der Synchronisation von Reels in lokalen Sprachen bis zur Generierung von Musik und Charakterstimmen in Horizon: Die ElevenLabs-Plattform ermöglicht es Kreativen, Unternehmen und Konzernen weltweit, mit Stimme, Musik und Sound im großen Maßstab zu entwickeln.”

“Dank der unübertroffenen Genauigkeit von Scribe in so vielen Sprachen versteht Fieldy jedes tägliche Gespräch und kann einfach über Kontinente hinweg skalieren. Nach dem Wechsel zu ElevenLabs Scribe hat Fieldy die Nutzerbindung um 50 % gesteigert.”

“ElevenLabs hat es uns leicht gemacht, leistungsstarke Text-to-Speech-Funktionen schnell in unser SDK zu integrieren. So können Agents in Echtzeit mit ausdrucksstarken Stimmen auf Nutzerfragen reagieren oder Feedback zu dem geben, was sie sehen.”
“Twilio hat die generative KI-Stimmtechnologie von ElevenLabs in seine CPaaS integriert und damit ConversationRelay erweitert. Diese Integration ermöglicht Unternehmen und Entwicklern, dialogbasierte KI-Sprachinteraktionen zu erstellen, die menschlich und ausdrucksstark klingen und direkt über die Twilio-CPaaS-Plattform in Echtzeit reagieren. Wir bei ElevenLabs freuen uns, dass Twilio ElevenLabs gewählt hat, um ConversationRelay mit den ausdrucksstärksten und natürlichsten verfügbaren Stimmen zu erweitern. ”

APIs für den Produktionseinsatz

Daten werden bei der Übertragung und Speicherung verschlüsselt. SOC 2, HIPAA und DSGVO-Konformität werden unterstützt. Für strengere Datenkontrolle stehen EU-Datenresidenz und Zero-Retention-Modi zur Verfügung.
Daten werden bei der Übertragung und Speicherung verschlüsselt. SOC 2, HIPAA und DSGVO-Konformität werden unterstützt. Für strengere Datenkontrolle stehen EU-Datenresidenz und Zero-Retention-Modi zur Verfügung.
Offizielle Python- und TypeScript-SDKs mit Typsicherheit, Streaming-Unterstützung und klaren Beispielen.
Unser Team sorgt für einen reibungslosen Start und einen zuverlässigen Betrieb. So erhalten Sie konstante Leistung und Sicherheit.
