
Was ist automatische Spracherkennung (ASR)?
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
1952 konnte das weltweit fortschrittlichste Spracherkennungssystem genau 9 Wörter verstehen.
Rund 75 Jahre später transkribiert die automatische Spracherkennung (ASR) Dutzende Sprachen in Echtzeit. Sie ermöglicht alles – von Sprachassistenten auf Ihrem Smartphone bis zu Untertiteln in Live-Videos.
Dieser Leitfaden erklärt die Technologie, die die Lücke zwischen den Systemen von 1952 und heute geschlossen hat: Was ASR ist, wie sie Sprache in Text umwandelt und wie sie sich bis heute weiterentwickelt.
Zusammenfassung:
- ASR steht für automatische Spracherkennung – die Technologie, die gesprochene Audiodaten in geschriebenen Text umwandelt.
- Die früheste Form von ASR entstand 1952. Ende der 2010er-Jahre erreichten Deep-Learning-Systeme menschliche Vergleichswerte.
- Moderne ASR nutzt End-to-End-Neuronale Netzwerke, die mit Millionen Stunden Audiomaterial trainiert wurden.
- Die Wortfehlerrate (WER) ist die Standardmetrik für Genauigkeit. Für produktionsreife ASR spielen jedoch auch Latenz, Diarisierungsqualität und Kontextverständnis eine Rolle.
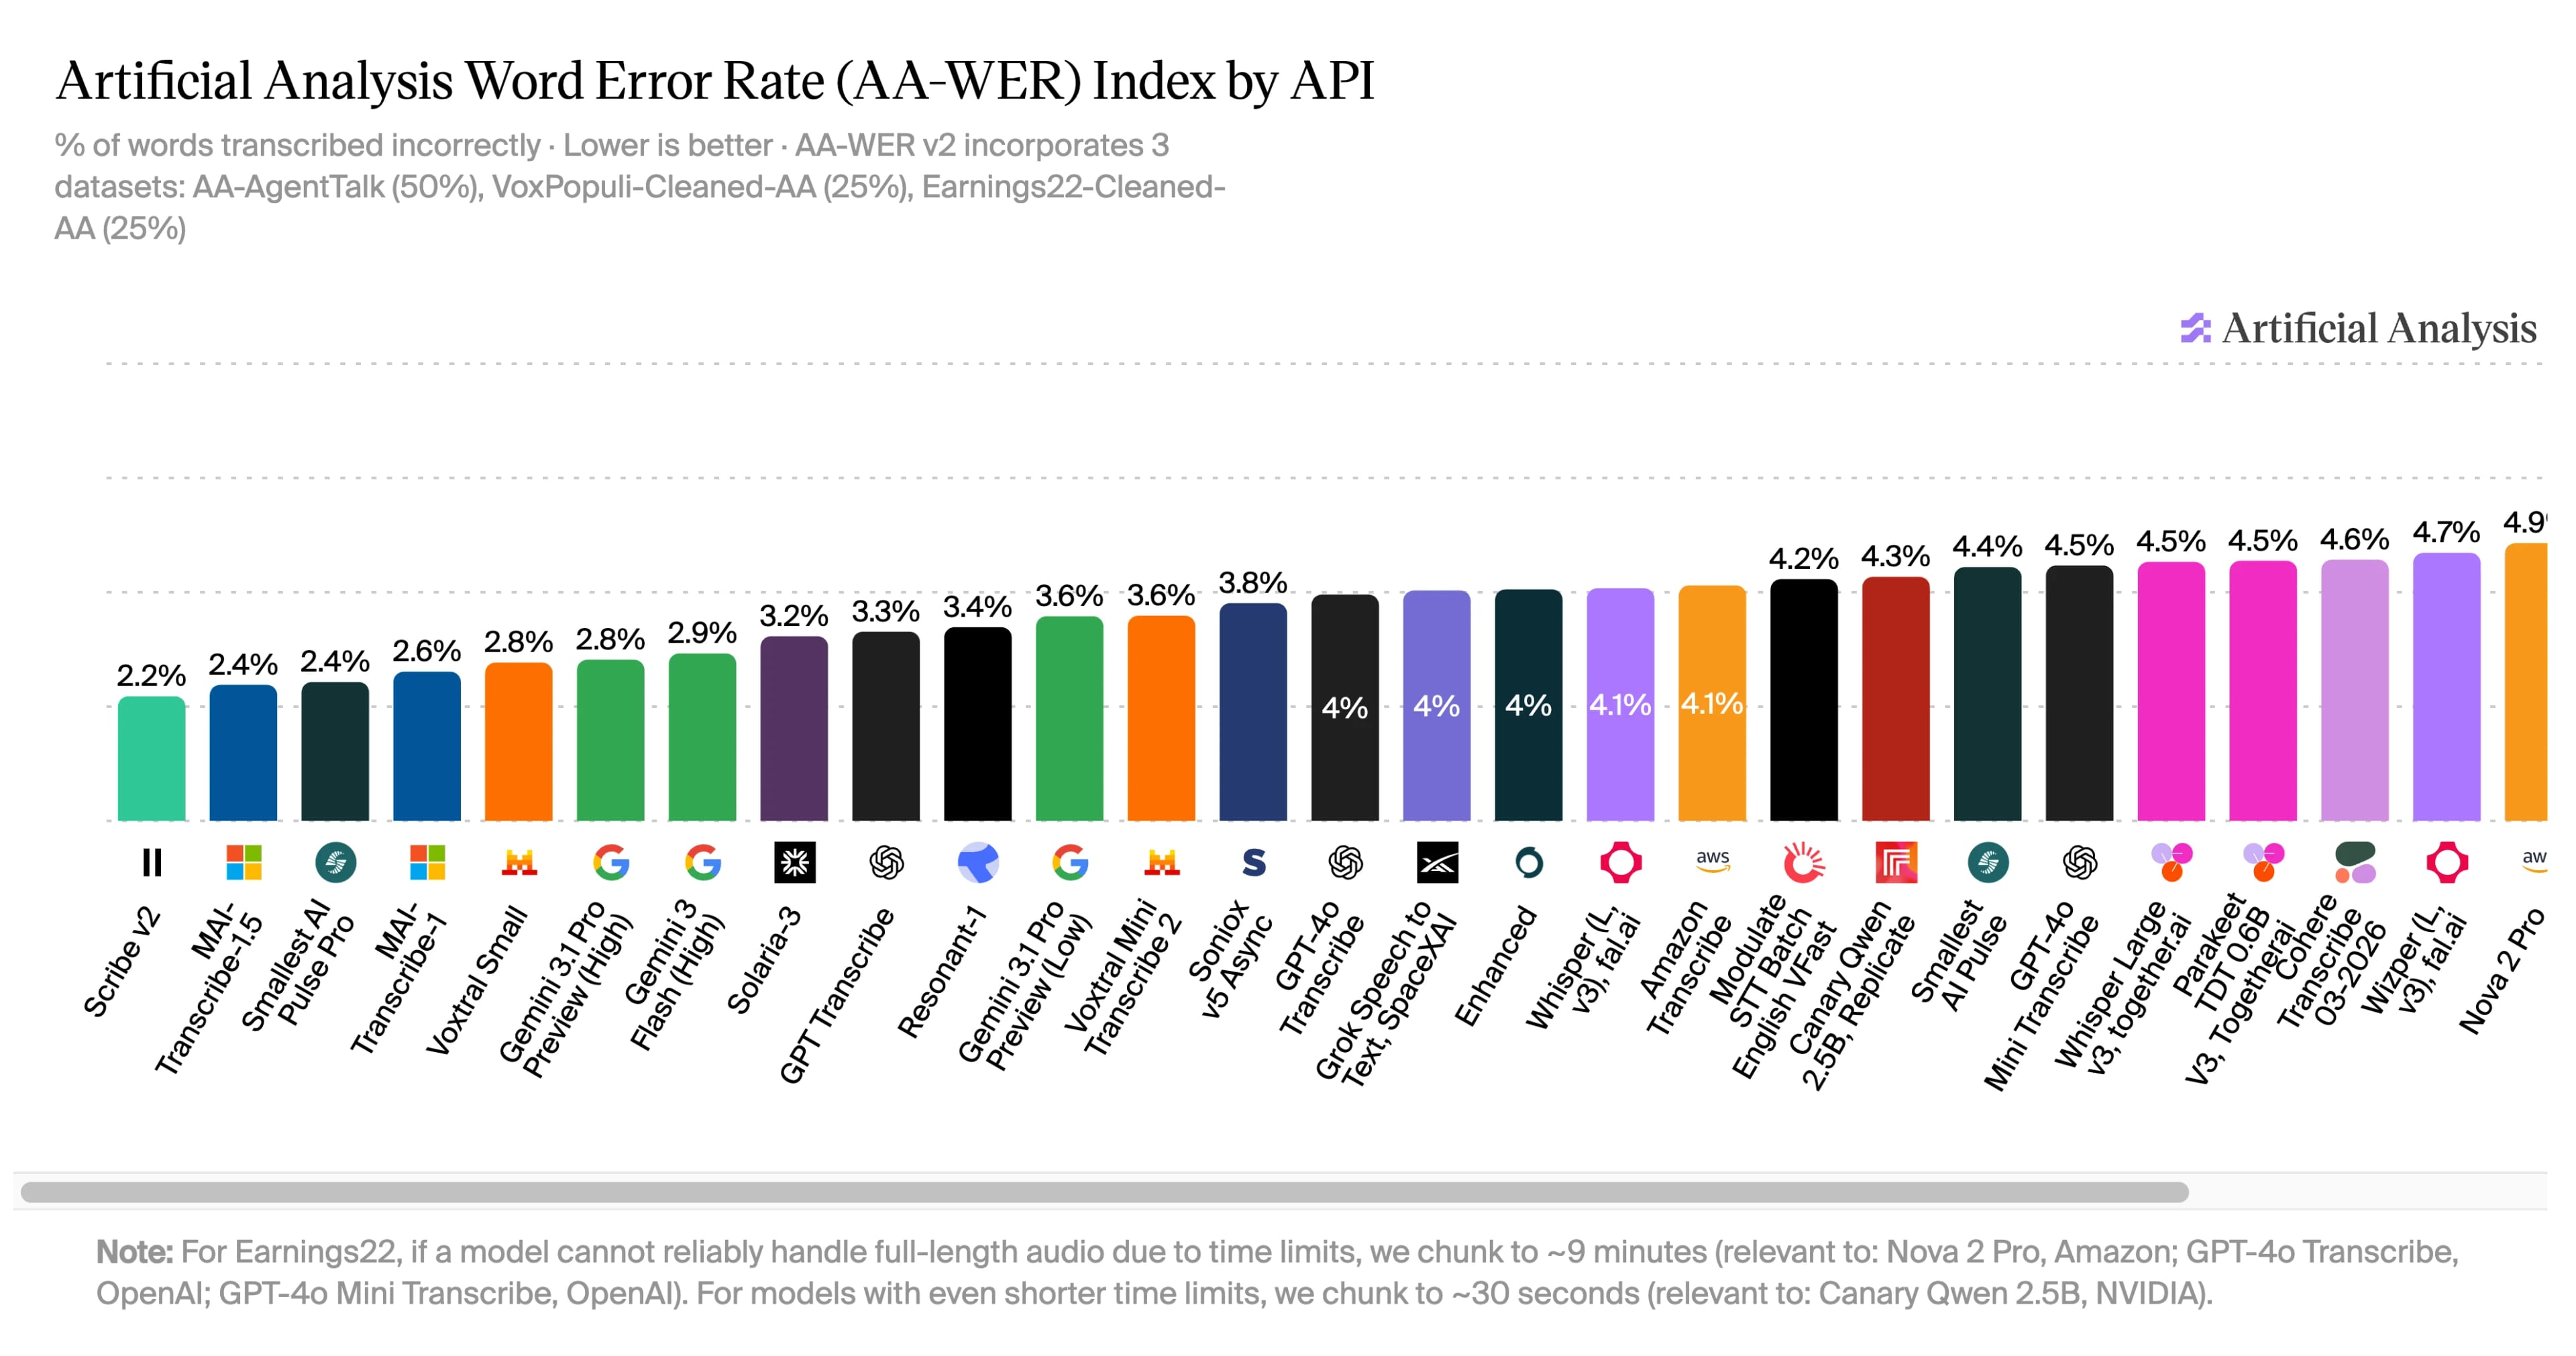
- ElevenAPI bietet Entwicklern produktionsreife ASR, unabhängig bewertet von Artificial Analysis mit einer Wortfehlerrate von 2,2 % – dem niedrigsten Wert in dessen Index (Juli 2026).
Was ist automatische Spracherkennung (ASR)?
Automatische Spracherkennung, oft nur unter dem Kürzel ASR bekannt, bezeichnet Software, die menschliche Sprache erfasst und in präzisen, maschinenlesbaren Text umwandelt. Sie wird auch häufig als Speech to Text oder Spracherkennung bezeichnet, manchmal auch als computerbasierte Spracherkennung.
ASR ist so verbreitet, dass Sie vermutlich täglich damit interagieren, ohne es zu bemerken. Jedes Mal, wenn Sie eine Nachricht diktieren, einem Sprachassistenten eine Frage stellen, Untertitel in einem Live-Video lesen oder durch ein interaktives Sprachdialogsystem navigieren, nutzen Sie ASR.
Obwohl Speech to Text und ASR oft synonym verwendet werden und eng verwandt sind, sind sie nicht genau dasselbe. ASR ist die Technologie, die erkennt, was gesagt wird, während STT die Anwendung dieser Technologie als Werkzeug ist. Sprechererkennungssoftware baut auf ASR auf und erkennt, wer ein bestimmtes Wort gesagt hat. Das bildet die Grundlage für Funktionen zur Sprecherdiarisierung.
Das sind kleine Unterschiede, die Sie jedoch verstehen sollten, wenn Sie ASR-, STT- oder Sprechererkennungssysteme in Ihre Apps oder Website integrieren möchten.
Eine kurze Geschichte der automatischen Spracherkennung
Die Technologie der automatischen Spracherkennung ist weit älter, als die meisten Menschen annehmen. Erste Ansätze reichen bis in die 1950er-Jahre zurück. In den mehr als 70 Jahren seit ihrer Entstehung hat ASR mehrere wichtige Entwicklungsstufen durchlaufen, die ihre Fortschritte maßgeblich geprägt haben.
Das sind die wichtigsten Entwicklungsphasen der ASR-Technologie:
- 1952 und die erste ASR: 1952 entwickelten die Bell Laboratories den Automatic Digit Recognizer, bekannt als AUDREY, um die Ziffern eins bis neun zu verstehen. Das Tool war nur zu etwa 90 % genau und funktionierte nur, wenn sein Erfinder es nutzte. Seine Einsatzmöglichkeiten waren daher äußerst begrenzt. Verglichen mit heutigen Fähigkeiten war es weit entfernt – doch allein die Erkennung von 1 bis 9 war eine beachtliche Leistung.
- 1960er- bis 1970er-Jahre und der wachsende ASR-Wortschatz: In den folgenden Jahrzehnten entwickelten Labore auf der ganzen Welt, darunter IBM, das University College London und NEC in Japan, ähnliche Modelle wie AUDREY für verschiedene Kontexte. Raj Reddy, ein Doktorand aus Indien an der Stanford University, entwickelte für seine Promotion einen Vokalerkenner. Damit legte er die Grundlage für kontinuierliche Spracherkennung ohne Pausen zwischen einzelnen Wörtern. DARPA (Defense Advanced Research Projects Agency) finanzierte in dieser Zeit Forschung, die zu Beam Search führte – einer Methode zur Satzkonstruktion und Dekodierung, die bis 1976 entscheidend für die Erkennung von insgesamt mehr als 1.000 Wörtern war.
- 1980er-Jahre bis frühe 2010er mit statistischen Fortschritten: 1987 kombinierte ein Doktorand von Raj Reddy, der inzwischen als Professor arbeitete, Hidden Markov Models mit Beam Search. Dadurch wurden ASR-Systeme möglich, die nicht mehr auf eine bestimmte Sprecherin oder einen bestimmten Sprecher trainiert werden mussten. Dieser Durchbruch verkürzte die Trainingszeit für Spracherkennungssysteme erheblich. Dragon Systems veröffentlichte 1997 mit NaturallySpeaking Preferred die erste kommerziell verfügbare ASR. Sie konnte 100 Wörter pro Minute erkennen und verkaufte sich gut.
- Die moderne Ära und Deep Learning: In den 2010er-Jahren zeigten Forschende, dass ein einzelnes neuronales Netzwerk, das End-to-End mit Audio und Transkripten trainiert wurde, eine rein statistische Pipeline übertraf. Mit dem Aufkommen tiefer neuronaler Netzwerke erreichten ASR-Systeme eine annähernd menschliche Leistung mit Fehlerraten zwischen 5 % und 10 %. In dieser Zeit kamen sprachbasierte Assistenten wie Alexa und Siri auf den Markt.
Seitdem ist ASR immer genauer und weiter verbreitet geworden. Im Juli 2026 identifizierte die unabhängige Forschung von Artificial Analysis ElevenLabs Scribe v2 mit einer branchenführenden Wortfehlerrate (WER) von nur 2,2 %.
Wie funktioniert ASR? Die Grundlagen von Speech-to-Text-Technologie
ASR erfasst eine Audioaufnahme, wandelt sie in eine numerische Darstellung um und nutzt anschließend ein trainiertes Modell, um die wahrscheinlichste Wortfolge vorherzusagen, die diese Werte darstellen. Moderne ASR führt diesen gesamten End-to-End-Prozess in Echtzeit und in weniger als einer Sekunde aus.
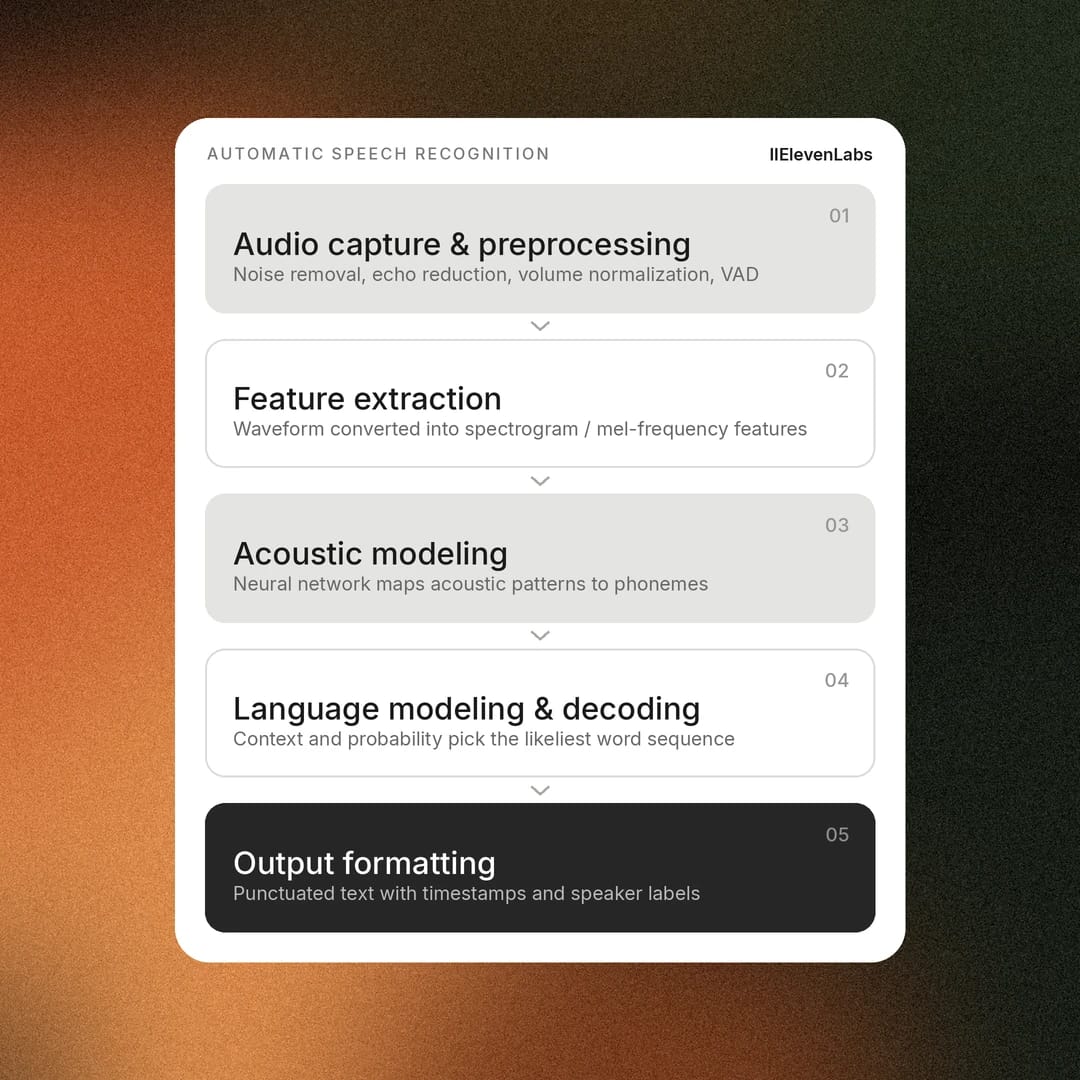
Eine ASR-Pipeline umfasst fünf Hauptphasen:
- Audioerfassung und Vorverarbeitung: Das System zeichnet das Audiosignal auf, entfernt Hintergrundgeräusche, reduziert Echo und normalisiert die Lautstärke, um die Konsistenz zu verbessern. Je nach Modell kann es vor Beginn der Transkription die Sprachaktivitätserkennung (VAD) einsetzen, um Sprache von Stille oder Hintergrundgeräuschen zu unterscheiden.
- Merkmalsextraktion: Die Audiodaten werden in eine numerische Darstellung umgewandelt, meist ein Spektrogramm oder Mel-Frequenz-Merkmale. Diese heben die Frequenzen und Muster der menschlichen Sprache präzise hervor. Dieser Schritt wandelt eine rohe Wellenform in Daten um, die ein Machine-Learning-Modell effizient verarbeiten kann.
- Akustische Modellierung: Ein neuronales Netzwerk analysiert die Merkmale aus dem vorherigen Schritt und prognostiziert Phoneme oder andere Spracheinheiten. Dabei lernt es die Beziehung zwischen akustischen Mustern und gesprochener Sprache. Moderne End-to-End-Modelle führen diesen Schritt häufig gemeinsam mit dem Sprachverständnis aus, statt ihn als vollständig getrennte Phase zu behandeln.
- Sprachmodellierung und Dekodierung: Das System gewichtet anschließend anhand von Regeln wie Grammatik, Kontext und mathematischer Wahrscheinlichkeit, welche Wortfolgen am wahrscheinlichsten sind. Die beiden letzteren Faktoren sind entscheidend: Die IPA-Transkription (Internationales Phonetisches Alphabet) zweier Sätze kann ähnlich sein, obwohl ihr Kontext völlig unterschiedlich ist. Beispielsweise können „Recognize Speech“ und „Wreck a nice peach“ gleich klingen, aber völlig unterschiedliche Bedeutungen haben. Der Kontext hilft dem System bei der Entscheidung, wenn die Präzision allein keine eindeutige Antwort liefert.
- Ausgabeformatierung: Nachdem das System entschieden hat, was die Sprache enthält, wird der endgültige Text mit Satzzeichen und Groß- und Kleinschreibung transkribiert. Zusätzliche Metadaten wie Wortebenen-Zeitstempel und Sprecherlabels ermöglichen detailliertere Transkripte.
Über diese Hauptphasen hinweg wandelt das Modell eingehende Audiodaten in ein geschriebenes Transkript um.
Traditionelle Hybridsysteme vs. End-to-End-ASR mit Deep Learning
Die obige Pipeline beschreibt zwar, wie ASR funktioniert, doch für den mittleren Teil dieser Pipeline gibt es zwei technologische Ansätze.
Ältere Systeme verknüpfen mehrere Komponenten: ein Lexikonmodell, das die Aussprache von Wörtern kodiert, ein akustisches Modell, das Audio auf Phoneme abbildet, und ein Sprachmodell, das wahrscheinliche Wortfolgen vorhersagt. Jede dieser Komponenten erfordert menschliches Fachwissen – von Linguistinnen und Linguisten, die Aussprachewörterbücher manuell erstellen, bis zu Annotierenden, die jedes Wort seiner exakten Position im Audio zuordnen.
End-to-End-Deep-Learning fasst all diese Komponenten in einem einzigen neuronalen Netzwerk zusammen. Das Netzwerk bildet Audio direkt auf Text ab und versteht Aussprache, Akustik und Sprachwahrscheinlichkeiten implizit anhand von Millionen Stunden verknüpfter Audio- und Transkriptdaten.
Sehen wir uns die Unterschiede zwischen traditionellen und modernen Ansätzen für ASR-Technologie an.
So wird ASR-Genauigkeit gemessen: Benchmarks zur Wortfehlerrate (WER)
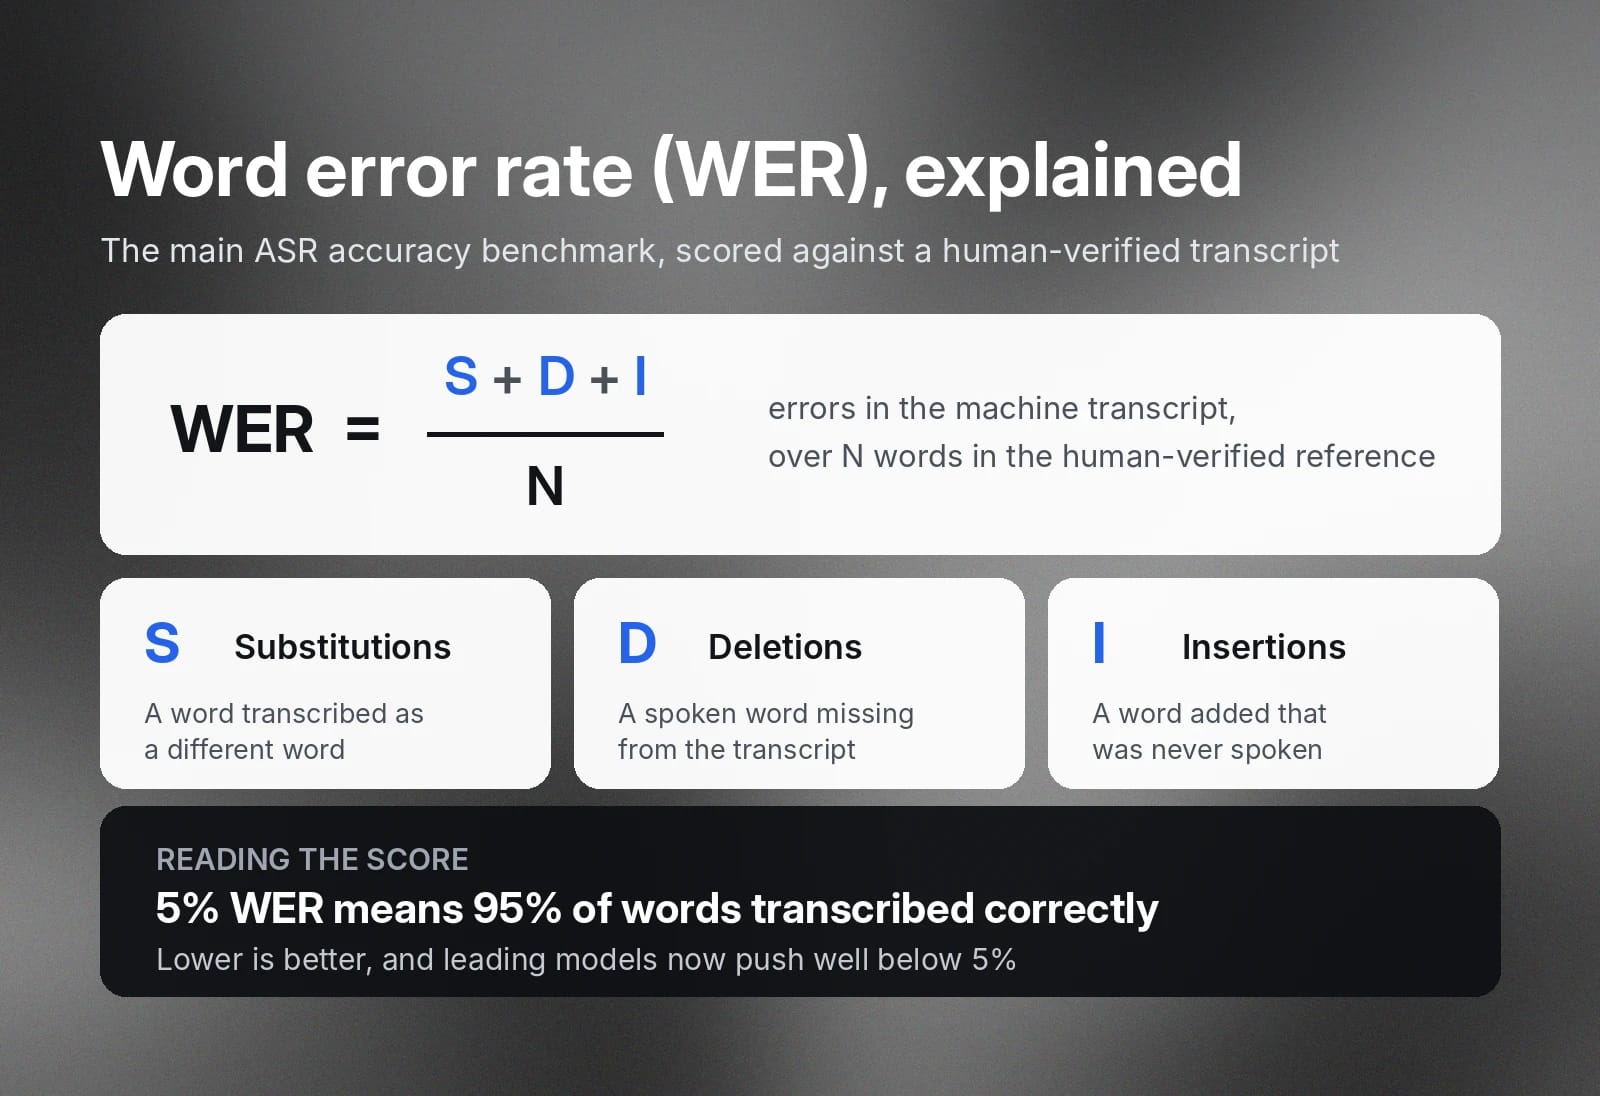
Für alle Speech-to-Text- und ASR-Workflows ist die Wortfehlerrate (WER) die wichtigste Genauigkeitsmetrik für Unternehmen. Sie vergleicht ein mit ASR erzeugtes maschinelles Transkript mit einer von Menschen geprüften Version. Dabei werden drei Hauptfehlertypen berücksichtigt: Ersetzungen, Auslassungen und Einfügungen.
Die WER-Formel teilt die Gesamtzahl der Fehler durch die Anzahl der Wörter im Referenztranskript. Eine WER von 5 % bedeutet, dass das System 95 % des Textes korrekt transkribieren konnte. Die meisten führenden Modelle liegen inzwischen deutlich unter 5 % und nähern sich der Perfektion.
WER ist ein nützlicher Benchmark, doch bei der Bewertung der Effektivität eines ASR-Tools sollten auch andere Faktoren berücksichtigt werden:
- Formatierungsgenauigkeit: Kann das System nicht standardisierte Zeichenfolgen korrekt formatieren? Wird beispielsweise ein Geldbetrag wie 1.225 $ so dargestellt oder als „eintausendzweihundertfünfundzwanzig Dollar“ ausgeschrieben?
- Latenz: Genauigkeit ist wichtig. Wenn ein Tool jedoch mehrere Minuten braucht, um ein einfaches Transkript zu erstellen, ist es nicht nutzbar. Selbst bei hoher Genauigkeit muss es diese mit niedriger Latenz ausbalancieren, um praktisch nützlich zu sein.
- Robustheit: Auch Anwendungsfälle wie starke Akzente oder laute Hintergrundgeräusche sollten die Modellgenauigkeit nicht wesentlich beeinträchtigen.
- Diarisierungsqualität: Anwendungsfälle mit mehreren Sprechenden hängen davon ab, dass jedes Wort der richtigen Person zugeordnet wird. Die Fähigkeit, verschiedene Sprechende zu identifizieren und korrekt zu kennzeichnen, trägt zur ASR bei – insbesondere in Branchen mit vielen Beteiligten wie Gerichtsverhandlungen.
Weitere Informationen finden Sie in unserem umfassenden Leitfaden zur Wortfehlerrate.
Wichtige Vorteile von ASR für moderne Unternehmen
Der weltweite Markt für Sprach- und Sprechererkennung soll bis 2030 auf über 23,11 Milliarden US-Dollar wachsen. Die durchschnittliche jährliche Wachstumsrate von 19,1 % zeigt, wie weit diese Technologie in kommerziellen Geräten verbreitet ist. Jedes moderne Smartphone verfügt über eine Diktaturtastatur und einen Sprachassistenten, die meisten neuen Autos reagieren auf Sprachbefehle und intelligente Lautsprecher oder Assistenten sind heute in Haushalten auf der ganzen Welt zu finden.
Die Interaktion mit Technologie per Sprache ist heute für Kundinnen und Kunden ein Standardweg. Für Unternehmen bietet ASR alles von der Transkription von Kundengesprächen bis zur Unterstützung durch Voice Agents. Sie integriert sich in Prozesse und steigert die Produktivität.
Hier sind einige der wichtigsten Vorteile von ASR für moderne Unternehmen:
- Schnellere Eingabe und Dokumentation: Bereits vor über 10 Jahren veröffentlichte Stanford eine Studie, die zeigte, dass Spracherkennung fast dreimal schneller als das Tippen auf einer Tastatur war und gleichzeitig eine niedrigere Fehlerrate aufwies. Für die große Mehrheit der Menschen ermöglicht ASR eine schnellere Dokumentation für Transkriptions-Workflows und sprachbasiertes Notieren.
- Niedrigere Betriebskosten: In vielen Anwendungsfällen, die früher stundenlanges manuelles Notieren erforderten, senkt ASR-Technologie die Kosten hochwertiger Transkription erheblich. Gerichtsverfahren, Contact Center, Gesundheitseinrichtungen und Geschäftstreffen können heute präzise ASR-Systeme nutzen, die detaillierte Notizen und vollständige diarisierten Gesprächstranskripte erstellen.
- Bessere Barrierefreiheit: Die Weltgesundheitsorganisation prognostiziert, dass bis 2050 2,5 Milliarden Menschen mit einer Form von Hörverlust leben werden. Echtzeit-Untertitel moderner ASR-Tools können digitale Meetings und Medien für Nutzende zugänglich machen.
- Durchsuchbare Sprachdaten: Wenn Sie Sprache mit ASR automatisch transkribieren, wird jede Interaktion zwischen Kunden und Unternehmen vollständig protokolliert. Jeder Vertriebsanruf, jedes Support-Ticket, jedes Gespräch mit Interessenten und jedes Meeting wird zu einem durchsuchbaren und prüfbaren Text. Gerade im KI-Zeitalter kann es beim Aufbau umfassender Wissensdatenbanken helfen, Kontext in maschinenlesbarer Form bereitzustellen. Das hält Informationen sichtbar – für Funktionen ebenso wie für Compliance.
- Kundenerlebnisse rund um die Uhr: ASR liefert eine der grundlegenden Technologien für Voice Agents und ermöglicht automatisierte Support-Anwendungsfälle, die Kundenanrufe lösen – rund um die Uhr.
Automatische Spracherkennung ist in der Technologie so verbreitet, weil ihre Integration viele Vorteile bietet und sie zahlreiche Anwendungsfälle unterstützt. Ob Sie im medizinischen Bereich arbeiten oder Kundenanrufe für Sentiment-Analysen transkribieren möchten: ASR ist eine grundlegende Technologie, die Sie einsetzen werden.
Beliebte ASR-Anwendungen in verschiedenen Branchen
Automatische Spracherkennung ist eine zentrale Technologie in unzähligen Workflows und Produkten. Sie ist so allgegenwärtig, dass Nutzende oft gar nicht darüber nachdenken, wie sie in ihre Technologie integriert ist.
Hier ist ein kurzer Überblick über einige beliebte ASR-Anwendungsfälle weltweit.
Kundenservice und Contact Center
Contact Center gehörten zu den frühen Anwendern von ASR und nutzten sie zur Transkription von Anrufen für Qualitätssicherung und Compliance. Heute kann ASR in Echtzeit laufen, Mitarbeitenden während eines Gesprächs Vorschläge liefern und Tausende Kundeninteraktionen in Daten umwandeln, die Teams analysieren können.
Medien und Unterhaltung
Sender und Streaming-Plattformen können ASR nutzen, um Untertitel von Gesprächen in einem Umfang zu erstellen, den menschliche Transkriptionskräfte nie erreichen könnten. Sie ermöglicht Echtzeit-Transkription und macht Video- und Audiobibliotheken vollständig durchsuchbar.
Gesundheitswesen
Klinisches Personal verbringt einen überraschend großen Teil des Tages mit Dokumentation und Aktenführung. ASR hilft, diese Zeit zurückzugewinnen, und bietet Ärztinnen und Ärzten eine medizinische STT-Plattform, in die sie ihre Notizen in Echtzeit diktieren können.
Virtuelle Meetings
Meeting-Plattformen bieten häufig eine Form digitaler Notizen, um Gespräche währenddessen zu transkribieren. So muss niemand zwischen Teilnahme und Notizen wählen. Dienste wie Google Meet senden diese Transkripte nach jedem Meeting sogar mit hervorgehobenen Aktionspunkten und schaffen so einen durchsuchbaren Informationsindex.
Recht und Compliance
In juristischen Kontexten ist die präzise Aufzeichnung dessen, was gesagt wurde und von wem, eine zentrale Anforderung vor Gericht. Kanzleien nutzen ASR-Plattformen, um ihre Meetings, Anhörungen, Mandantengespräche und Gerichtstermine mit präzisen Zeitstempeln für spätere Referenz zu transkribieren.
Bildung
Hochschullehrende können aufgezeichnete Transkripte ihrer Vorlesungen bereitstellen, damit Studierende einen Nachweis der besuchten Veranstaltungen aufbauen können. Um Informationen zu verstehen und zu behalten, steht Studierenden damit eine umfassende Ressource als Ausgangspunkt zur Verfügung.
Die Rolle von ASR in einer Voice-Agent-Pipeline
ASR ist ein Standardbestandteil verschiedener technischer Implementierungen. In der Voice-Agent-Technologie ist sie die erste von drei übergeordneten Phasen, die in einer kontinuierlichen Schleife ablaufen.
- Zuhören (ASR): Der Agent erfasst eingehende Audioströme und wandelt Sprache in Echtzeit in Text um. Moderne ASR verarbeitet Audio kontinuierlich beim Eintreffen, filtert Hintergrundgeräusche heraus, verarbeitet Unterbrechungen, erstellt Teiltranskripte und erkennt, wann jede Person spricht.
- Denken (Sprachmodell): Ein großes Sprachmodell interpretiert das Transkript. Es versteht die Absicht der Nutzenden, ruft Informationen aus verbundenen Tools und Wissensdatenbanken ab, behält den Gesprächskontext bei und bestimmt die passendste Antwort oder Aktion.
- Sprechen (Text to Speech): Ein Text-to-Speech-Modell wandelt die generierte LLM-Antwort in natürliches, ausdrucksstarkes Audio um. Moderne TTS-Systeme können Tempo, Intonation, Emotion und Betonung anpassen, während sie Audio an den Anrufenden streamen, statt auf die vollständige Antwort warten zu müssen.
Konversationslatenz summiert sich über all diese Phasen hinweg. Streaming-ASR gibt Wörter aus, sobald sie gesprochen werden, statt auf das Ende einer Äußerung zu warten. Das reduziert die Latenz. ElevenAgents nutzt dies als Standard für Echtzeit-Voice-Agents und schafft so ein hocheffizientes Agent-Erlebnis.
Herausforderungen bei ASR und die Weiterentwicklung der Technologie
Obwohl sich ASR-Technologie seit ihren Anfängen im Jahr 1952 stark weiterentwickelt hat, bestehen weiterhin verschiedene Herausforderungen, die die Genauigkeit verringern können.
Im Folgenden finden Sie einige Probleme, auf die ASR-Tools heute noch stoßen:
- Akzente und Dialekte: Verfügbare Trainingsdaten konzentrieren sich typischerweise auf wenige Sprachen und Akzente. Das macht weniger verbreitete Akzente oder Sprachen mit weniger Sprechenden für ASR-Tools schwieriger. Umfangreiche und vielfältige Trainingsdatensätze sind hier die Lösung.
- Hintergrundgeräusche und überlappende Sprechende: Umgebungen mit wechselnder Lautstärke oder lauten Hintergrundgeräuschen erschweren es, einzelne Wörter einer Aufnahme genau zu erkennen. Überlappende Sprechende können einen ähnlichen Effekt haben und die Genauigkeit einer ASR-Transkription verringern.
- Fachspezifischer Wortschatz: Bereiche mit spezifischem Fachjargon oder Abkürzungen benötigen Wörterbücher und Referenzen auf Domänenebene, um die Genauigkeit zu erhöhen. Medizin und Recht sind zwei Bereiche, in denen ASR-Tools zusätzliche Unterstützung oder spezialisiertes Training benötigen.
- Datenschutz und Sicherheit: In vielen Rechtsordnungen gelten Sprachdaten als personenbezogene Daten. Unternehmen benötigen klare Aufbewahrungsrichtlinien und Schutzmechanismen, um den Umgang mit Sprachdaten zu schützen und die Einhaltung umfassenderer Vorschriften sicherzustellen.
Eine übergeordnete Frage bei der Arbeit mit ASR-Technologie ist das Verhältnis von Latenz und Genauigkeit. Manche Anwendungsfälle müssen beides ausbalancieren, während Bereiche wie die Medizin wahrscheinlich der Genauigkeit oberste Priorität einräumen.
Starten Sie mit ElevenAPI für produktionsreife ASR-Integration
ElevenAPI bringt mit Scribe v2, dem ElevenLabs-Speech-to-Text-Modell, produktionsreife automatische Spracherkennung in Ihr Produkt. Scribe v2 bietet Zeitstempel auf Wortebene, Sprecherdiarisierung, Audioereignis-Tags sowie die Genauigkeit und Zuverlässigkeit, die Echtzeitanwendungen benötigen.
Weitere Informationen finden Sie auf der Seite ElevenLabs Speech to Text oder erstellen Sie ein kostenloses Konto, um eine API in wenigen Minuten einzurichten.
Häufige Fragen zu ASR

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.




