Echtzeit- vs. Batch-Transkription: Die wichtigsten Unterschiede
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Bei der Wahl eines KI-gestützten Transkriptionsmodells haben Sie zwei Optionen: Echtzeit- oder Batch-Transkription. Beide wandeln Sprache in Text um, nutzen dabei jedoch unterschiedliche Ansätze.
Echtzeit-Transkription verarbeitet Audio während es entsteht, während die Batch-Transkription eine vollständige Aufnahme nach deren Abschluss verarbeitet. Echtzeit-Transkription liefert sofortige Ergebnisse, Batch-Transkription ist jedoch oft genauer.
In diesem Leitfaden vergleichen wir Echtzeit- und Batch-Transkription, damit Sie das richtige Modell für Ihr nächstes Projekt wählen können. Wir erklären die Funktionsweise beider Modelle, ihre Vor- und Nachteile sowie typische Anwendungsfälle.
Zusammenfassung
- Echtzeit-Transkription verarbeitet Audio, während es entsteht.
- Batch-Transkription verarbeitet eine vollständige Audiodatei auf einmal.
- Echtzeit-Transkription ist schneller, Batch-Transkription jedoch genauer, da das Modell bidirektionalen Kontext aus der gesamten Audiodatei nutzt.
- Echtzeit-Transkription eignet sich am besten für Anwendungen wie Live-Voice Agents, Live-Untertitel für Videos oder Besprechungsnotizen, bei denen Geschwindigkeit wichtiger ist als Genauigkeit.
- Batch-Transkription ist für die nachträgliche Transkription großer Audiomengen genauer und kosteneffizienter.
Was ist Echtzeit-Transkription bei STT?
Bei der Echtzeit-Transkription wandelt ein Speech-to-Text-Modell (STT) Audio während der Aufnahme in geschriebenen Text um. Dies wird auch Streaming-Transkription genannt.
Bei der Echtzeit-Transkription verarbeitet das STT-Modell Audio in kleinen Abschnitten. Der Text ist bereits Millisekunden nach dem Gesprochenen verfügbar. Mit fortschreitendem Gespräch erhält das STT-Modell mehr Daten und Kontext und verfeinert damit das Transkript.
Diese Form der Transkription eignet sich am besten, wenn Geschwindigkeit wichtiger ist als Genauigkeit. So machen diese Modelle Audio- und Videostreams mit Echtzeit-Untertiteln zugänglicher. Ein weiterer typischer Anwendungsfall sind Plattformen für Echtzeit-Notizen.
Was ist Batch-Transkription bei STT?
Batch-Transkription wandelt eine vollständige Audioaufnahme nach Ende der Aufnahme auf einmal von Sprache in Text um. Je nach Länge und Komplexität der Aufnahme dauert der Prozess wenige Sekunden bis über 10 Minuten.
Batch-Transkriptionsmodelle nutzen bei der Verarbeitung den Kontext der gesamten Aufnahme. Dieser vollständige Kontext hilft dem Modell, Abschnitte mit komplexer Sprache, Hintergrundgeräuschen oder Unterbrechungen präzise zu interpretieren. Batch-Modelle ergänzen außerdem Zeichensetzung und Formatierung, womit manche Echtzeitmodelle Schwierigkeiten haben.
Batch-Transkription eignet sich am besten, wenn Genauigkeit höchste Priorität hat. Viele Unternehmen nutzen Batch-Modelle, um lange Interviews, Besprechungen oder Podcasts für ihre Archive zu transkribieren.
Wie Batch- und Streaming-Architekturen die Transkription prägen
Beim Vergleich von Batch- und Stream-Verarbeitung für Transkription nutzen die beiden Modelle grundlegend unterschiedliche Prozesse, die sich auf das Endergebnis auswirken.
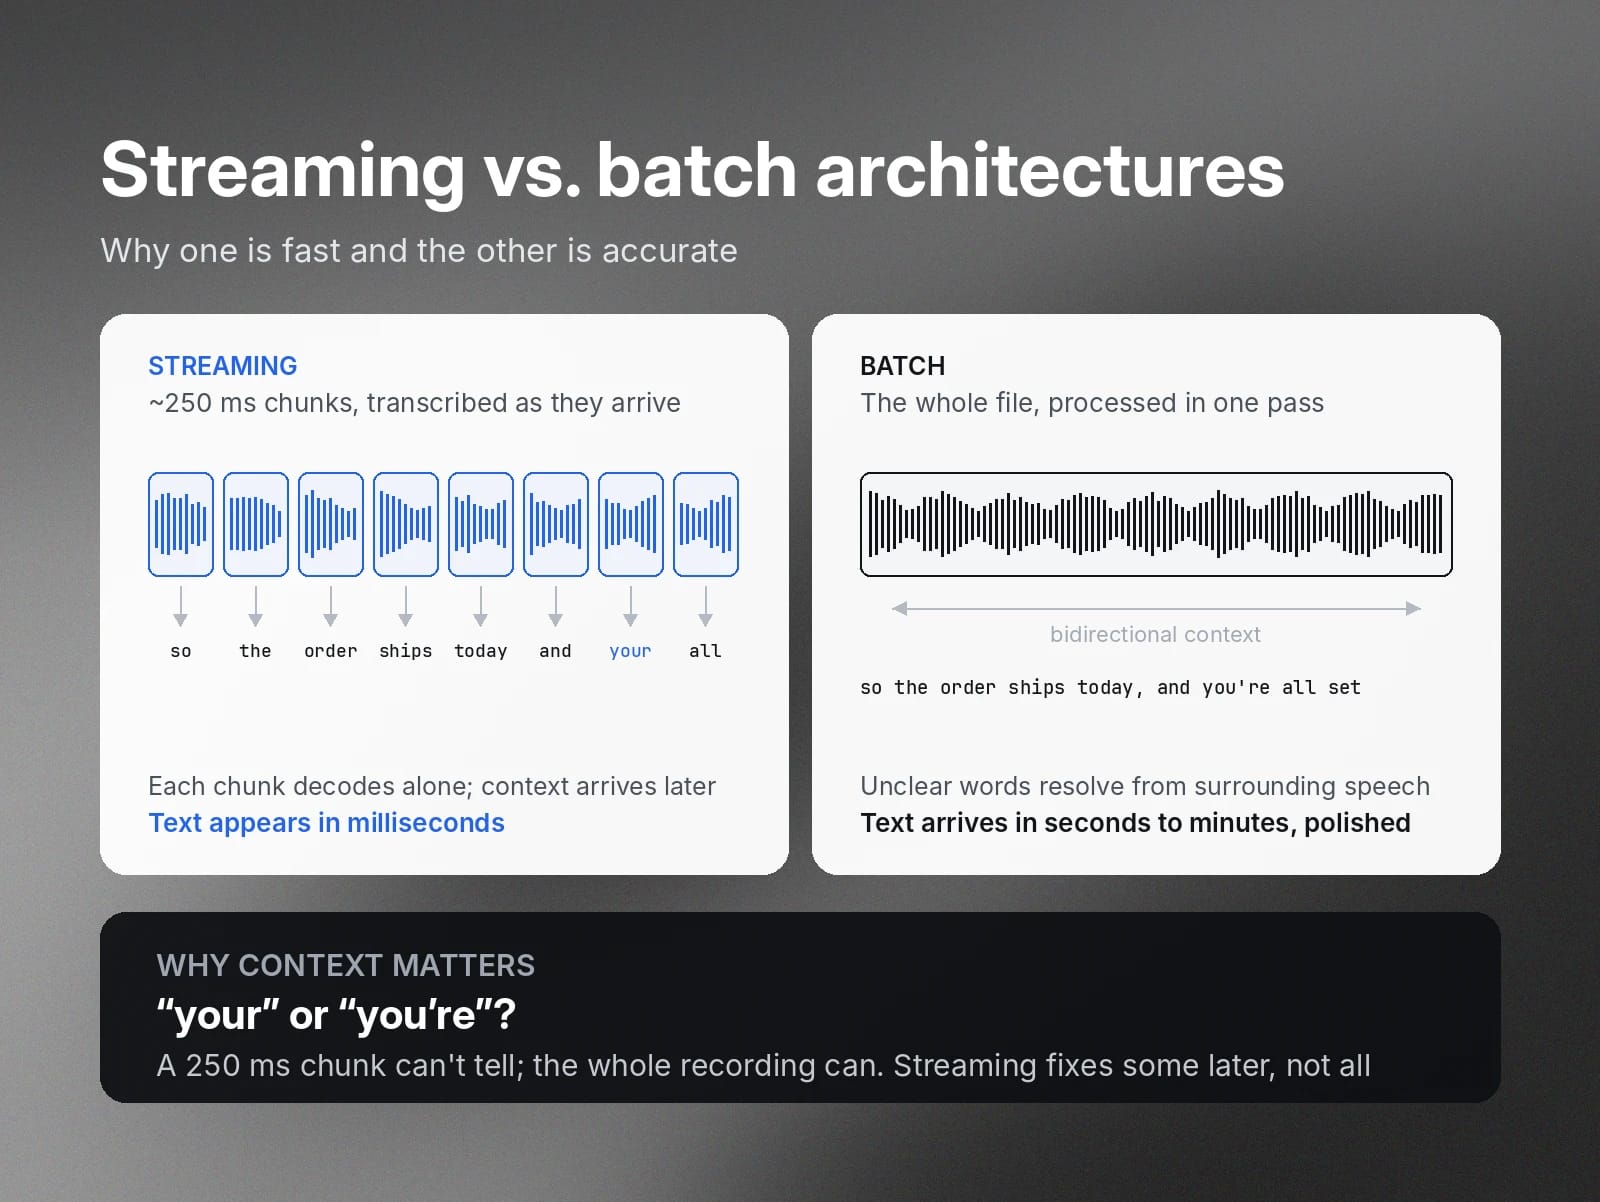
Streaming-Transkriptionsmodelle teilen Audio in Abschnitte auf und transkribieren jeden Abschnitt während er entsteht. Diese Abschnitte sind sehr klein, meist etwa 250 Millisekunden oder weniger. Durch diese Verarbeitung kann das Transkriptionsmodell schnell arbeiten, sodass Text bereits Sekunden nach dem Audio erscheint.
Da diese Audioabschnitte so klein sind, verfügt das Speech to Text-Modell nicht über den vollständigen Gesprächskontext, was zu Fehlern führen kann. Beispielsweise könnte das Transkriptionsmodell „seit“ statt „seid“ verwenden.
Ein Echtzeit-Transkriptionsmodell korrigiert einige dieser Fehler, wenn das Gespräch fortschreitet und der Kontext klarer wird. Häufig reichen Zeit oder Kontext jedoch nicht aus, um jeden Fehler zu korrigieren. Das endgültige Transkript ist daher nicht immer zu 100 % korrekt.
Batch-Transkriptionsmodelle hingegen verarbeiten die gesamte Audiodatei auf einmal. Dadurch verfügt das Transkriptionsmodell über bidirektionalen Kontext für das Gespräch, den es nutzt, um unklare Wörter oder Formulierungen aufzulösen. Ist etwas in der Audiodatei unklar, analysiert das Modell die vorhergehenden und nachfolgenden Wörter, um das Gesagte zu bestimmen und präzise zu transkribieren.
Dieser zusätzliche Kontext macht Batch-Transkriptionsmodelle langsamer als Echtzeit-Transkriptionsmodelle. Das Endergebnis ist jedoch deutlich genauer und besser ausgearbeitet.
Wichtige Merkmale von Echtzeit- und Batch-Transkriptionsmodellen: Latenz, Genauigkeit und Kosten
Sowohl Echtzeit- als auch Batch-Modelle eignen sich für die Transkription. Entscheidend ist die Art Ihres Projekts. Manche Projekte benötigen sofortige Ergebnisse, andere eine hohe Genauigkeit.
Das sollten Sie bei der Wahl zwischen Echtzeit- und Batch-Transkription berücksichtigen:
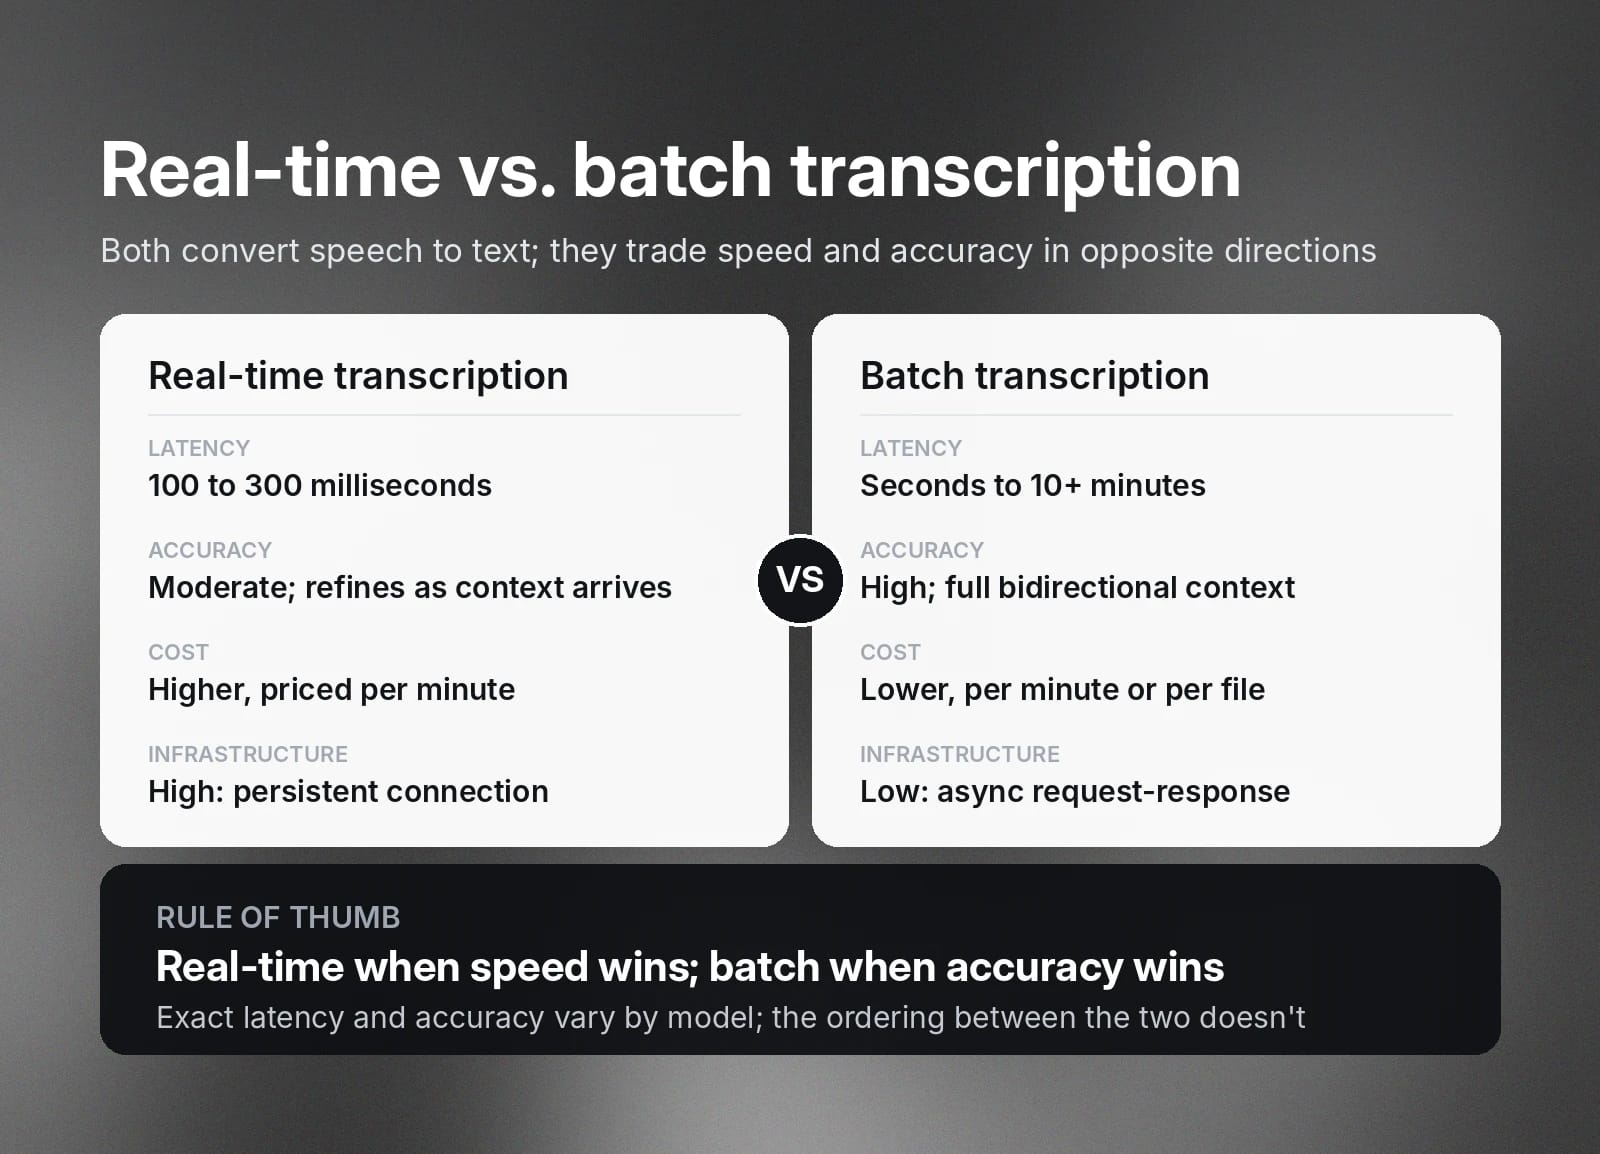
Echtzeit-Transkription | Batch-Transkription | |
Latenz | 100 bis 300 Millisekunden | Einige Sekunden bis über 10 Minuten, abhängig von der Dateilänge |
Genauigkeit | Mittel | Hoch |
Kosten | Hoch, Abrechnung pro Minute | Mittel, Abrechnung pro Minute oder Datei |
Infrastrukturkomplexität | Hoch, erfordert eine stabile Verbindung und Lastverteilung | Niedrig, nutzt eine asynchrone Request-Response-Struktur |
Die genauen Latenz- und Genauigkeitswerte hängen vom verwendeten Transkriptionsmodell ab. Echtzeit-Transkription ist jedoch durchgehend schneller, während Batch-Transkription genauer ist.
Echtzeit-Transkription kostet mehr als Batch-Transkription, da sie komplexere Infrastruktur und einen höheren Betriebsaufwand erfordert. Echtzeitmodelle benötigen eine stabile Verbindung, um ihre Geschwindigkeit zu halten, und brauchen mehr Zeit für Einrichtung und Wartung als Batch-Modelle.
Für Barrierefreiheit in Live-Gesprächen lohnt sich die Investition in Echtzeitmodelle. Für Projekte, bei denen Geschwindigkeit keine Priorität hat, spart Batch-Transkription jedoch Geld und Einrichtungszeit.
API-Vergleich: Echtzeit- vs. Batch-Transkription – das passende Modell für Ihr Projekt wählen
Bevor Sie ein neues Transkriptionsprojekt starten, sollten Sie die Vor- und Nachteile von Batch- und Echtzeitmodellen bewerten, um herauszufinden, welches am besten zu Ihren Zielen passt. So sieht der Entscheidungsprozess in drei realen Szenarien aus.
Live-Voice-Agent: Echtzeit-Transkription
Live-Modelle für konversationelle KI benötigen für Barrierefreiheit eine nahezu sofortige Transkription, insbesondere bei komplexen Aufgaben im Betrieb oder Kundenservice.
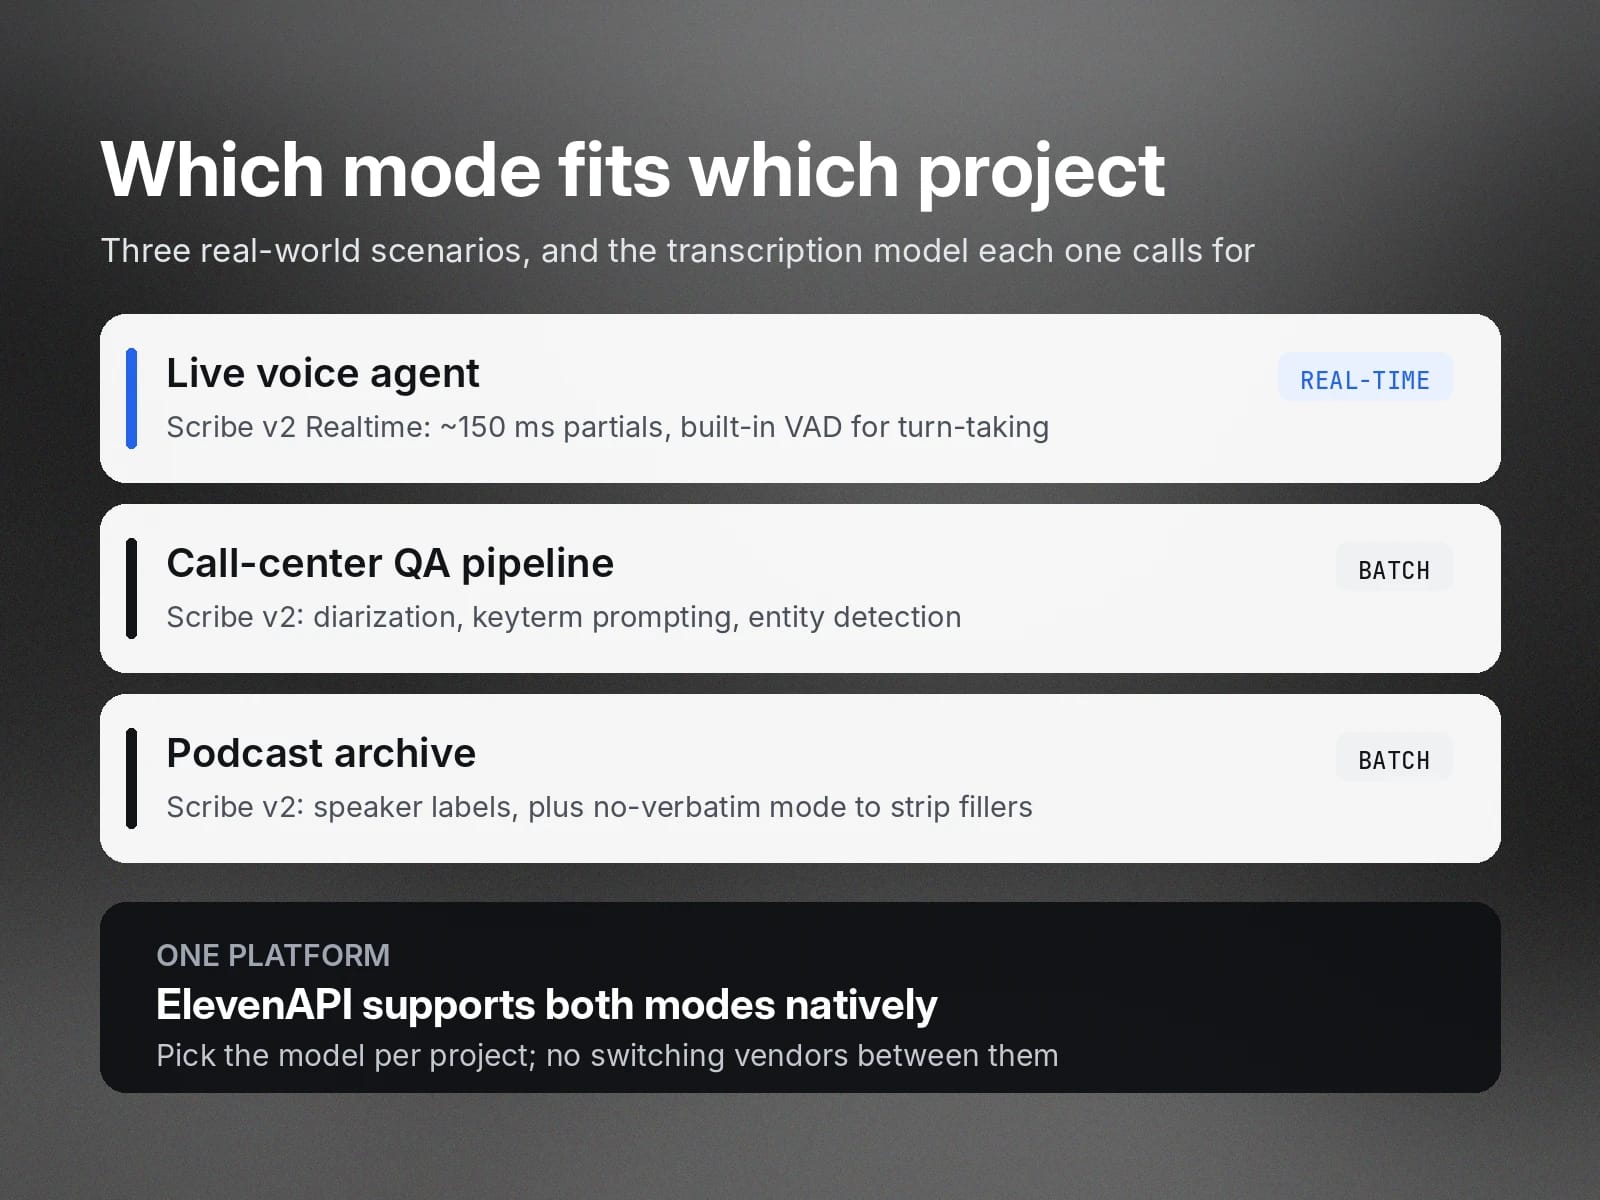
Ein Echtzeitmodell wie Scribe v2 Realtime liefert die niedrige Latenz, die für reibungslose, natürliche Gespräche erforderlich ist. Scribe v2 Realtime liefert Teiltranskripte in etwa 150 Millisekunden.
Transkriptionsmodelle für Live-Voice-Agents benötigen außerdem eine präzise Sprecherwechselerkennung. Sie müssen erkennen, wann ein Nutzer zu sprechen begonnen oder aufgehört hat und sofort reagieren. Eine effektive Sprecherwechsel- und Unterbrechungsverwaltung verhindert, dass das Transkript hinter dem Gespräch zurückbleibt.
Echtzeit-Transkriptionsmodelle priorisieren eine präzise Sprecherwechselerkennung für schnelle Ergebnisse. Scribe v2 Realtime verfügt beispielsweise über integrierte Voice Activity Detection und segmentiert das Transkript daher automatisch, wenn es Stille zwischen Sprechern erkennt.
QA-Pipeline für Callcenter: Batch-Transkription
Bei der Qualitätssicherung ist Genauigkeit entscheidend. Daher ist ein Batch-Transkriptionsmodell wie Scribe v2 in diesem Szenario die sinnvollste Wahl.
Callcenter-Transkripte enthalten oft einzigartige Namen und branchenspezifische Details. Werden sie nicht korrekt transkribiert, können Analysten nur schwer feststellen, ob ein Anruf tatsächlich erfolgreich war. Da Batch-Modelle die gesamte Aufnahme auf einmal verarbeiten, verfügen sie über den Kontext für präzise Transkription und Formatierung.
Scribe v2 bietet mehrere Funktionen zur Steigerung der Transkriptionsgenauigkeit. Sprecherdiarisierung stellt sicher, dass Agents und Kunden stets korrekt zugeordnet werden, auch bei gleichzeitigem Sprechen. Keyterm Prompting gibt dem Modell Marken- und Branchenbegriffe vorab, damit sie korrekt transkribiert werden.
Callcenter-Transkripte können auch sensible Informationen enthalten, die geschwärzt werden müssen, etwa Sozialversicherungs- oder Kreditkartennummern. Scribe v2 verfügt über Entitätserkennung, um diese sensiblen Angaben zu finden und mit Zeitstempeln zu versehen, damit Sie sie entfernen können.
Podcast-Archiv: Batch-Transkription
Für den Aufbau eines Podcast-Archivs benötigen Sie hochwertige Transkripte, auf die Ihr Team und Ihr Publikum jederzeit zugreifen können. Genauigkeit und saubere Formatierung sind hier unverzichtbar. Daher ist Batch-Transkription die richtige Wahl.
Mit Batch-Transkription erhalten Sie präzise Transkripte mit Sprecherzuordnung und Diarisierung für alle Ihre Podcast-Dateien. Scribe v2 bietet außerdem den No-Verbatim-Modus, der Füllwörter, Stottern und Wiederholungen automatisch entfernt. Dadurch verbringen Sie weniger Zeit mit manueller Bearbeitung und können Ihr Podcast-Archiv schneller aufbauen.
ElevenAPI unterstützt nativ sowohl Echtzeit- als auch Batch-Modi. Wenn Sie mehrere Transkriptionsprojekte gleichzeitig durchführen, können Sie ElevenAPI nutzen, um alle auf derselben Plattform zu verwalten. Wählen Sie einfach für jedes Projekt das passende Modell, ohne zwischen verschiedenen Anbietern wechseln zu müssen.
Hybride Transkriptionsmodelle: Echtzeit und Batch verbinden
Hybride Transkriptionsarchitekturen kombinieren Echtzeit- und Batch-Modelle, um Geschwindigkeit und Genauigkeit auszubalancieren.
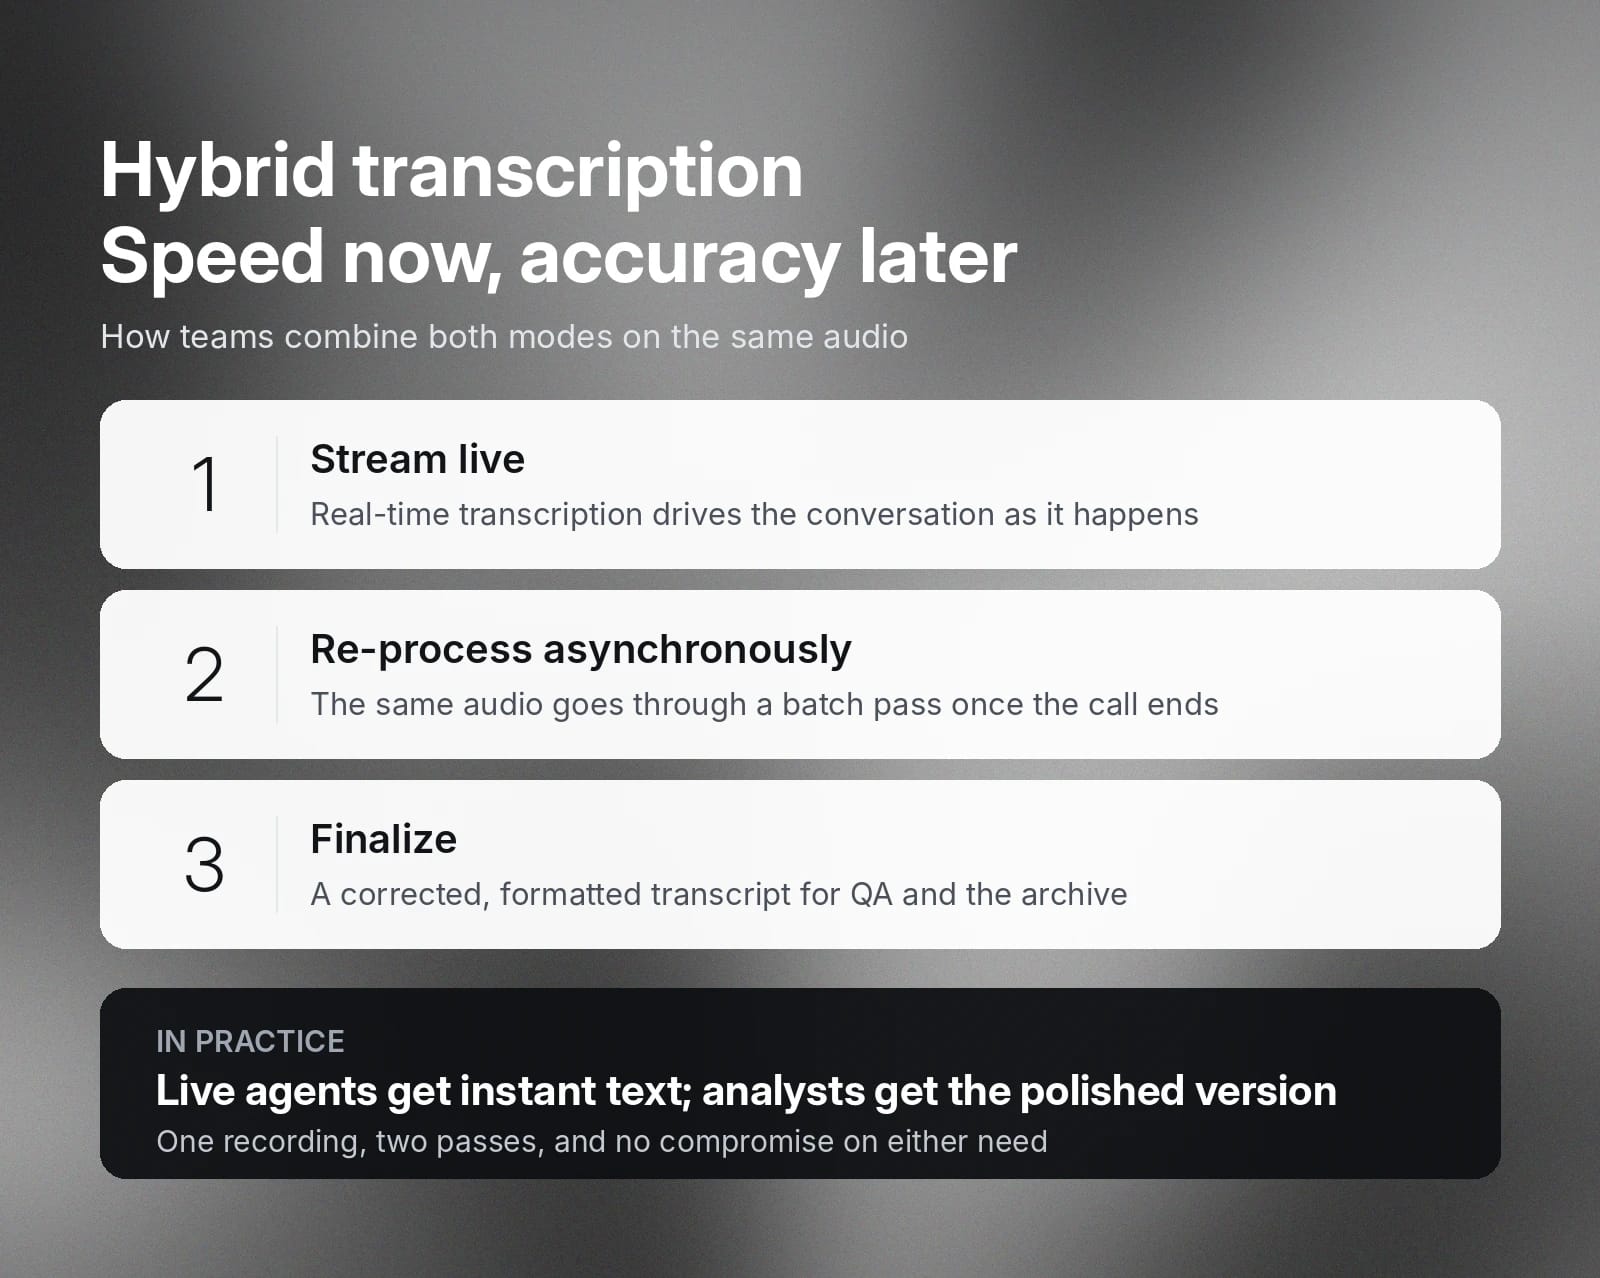
Ein Kundenservice-Team könnte beispielsweise ein Hybridmodell nutzen, um in Live-Gesprächen sofortige Ergebnisse bereitzustellen und das Transkript anschließend für Qualitätssicherung und Archivierung zu optimieren. Live-Agents nutzen Echtzeit-Transkription und senden das erste Transkript anschließend zur asynchronen Nachbearbeitung an ein Batch-Modell.
So funktioniert dieser Ablauf:
Starten Sie mit ElevenAPI für flexible Transkriptionslösungen
ElevenAPI bietet Echtzeit- und Batch-Modelle für schnelle, präzise Transkriptionen in über 90 Sprachen. Die branchenführenden Transkriptionsmodelle von ElevenAPI liefern auch bei Audio mit niedriger Qualität, Hintergrundgeräuschen oder starken Akzenten genaue Ergebnisse.
ElevenAPI bietet Echtzeit- und Batch-Modelle für schnelle, präzise Transkriptionen in über 90 Sprachen. Scribe v2 liefert branchenführende Transkriptionsgenauigkeit und Scribe v2 Realtime hohe Genauigkeit für Live-Anwendungsfälle. Beide liefern auch bei Audio mit niedriger Qualität, Hintergrundgeräuschen oder starken Akzenten zuverlässige Ergebnisse.
Beide Modelle sind auf derselben praktischen Plattform verfügbar und helfen Ihnen, eine Transkriptionsarchitektur zu erstellen, die Ihren Anforderungen entspricht. Entdecken Sie die ElevenLabs Speech to Text API in Aktion oder erstellen Sie einen API-Schlüssel, um loszulegen.



