
Wie funktioniert Audiotranskription mit Zeitstempeln und Ereignis-Tags?
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Ein natives Transkriptionsmodell auf Wortebene verarbeitet eine Audioaufnahme oder einen Echtzeitstream und gibt ein strukturiertes Array aus markierten Token-Objekten mit Zeitstempeln aus, die Sprache und nichtsprachliche Geräusche darstellen. Jedes Token gehört zu einem von drei Typen: word, spacing oder audio_event. Audioereignisse können Lachen, Applaus oder andere Hintergrundgeräusche sein.
In diesem Artikel erklären wir, wie Audiotranskription mit Zeitstempeln funktioniert und warum sie flexibler und leistungsfähiger ist als herkömmliche Transkription mit Forced Alignment.
Zusammenfassung
- Die Transkription auf Wortebene gibt strukturierte Arrays von Sprachdaten und nichtverbalen Audioereignissen mit Zeitstempeln direkt aus.
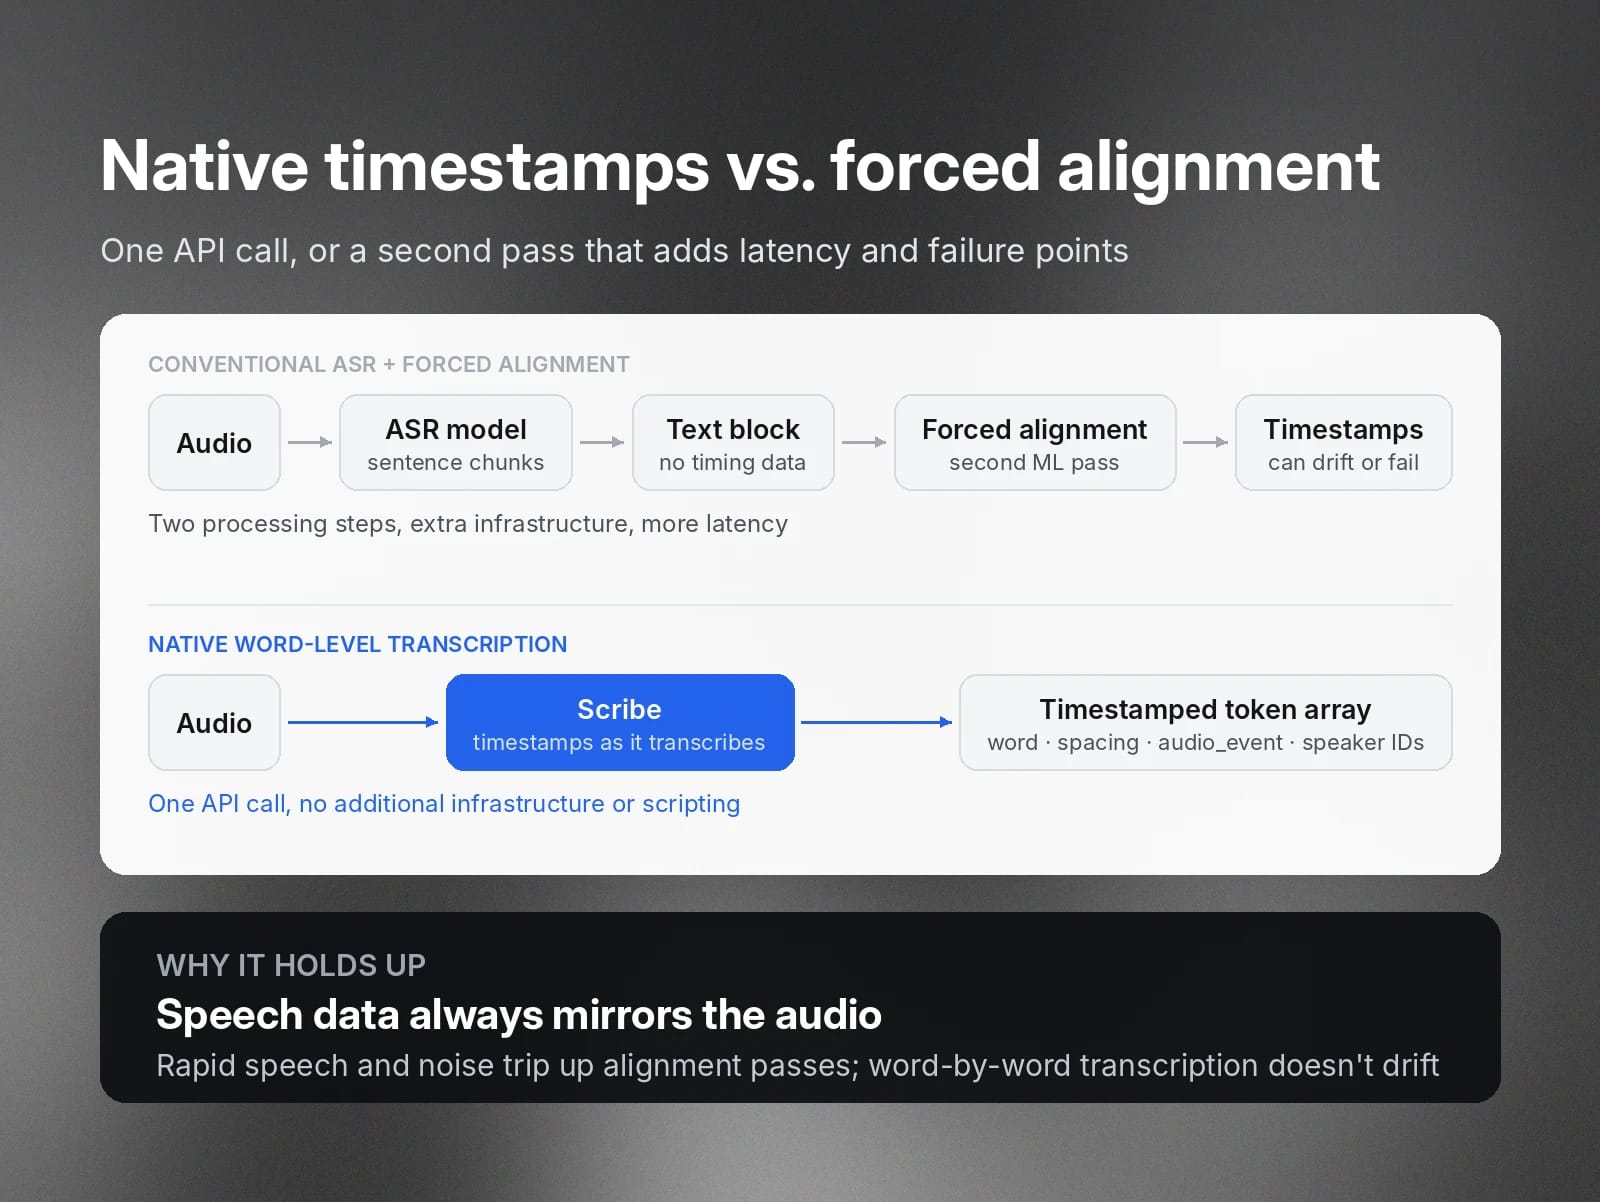
- Das steht im Gegensatz zu herkömmlichen Modellen zur automatischen Spracherkennung, die vollständige Textblöcke ausgeben. Um diese mit dem Roh-Audio zu synchronisieren, ist ein zweiter Forced-Alignment-Prozess nötig. Das dauert länger und erhöht den Rechenaufwand.
- Ereignis-Tags helfen Ihnen, nichtverbale Inhalte wie Lachen oder Applaus zu erfassen. Da diese Daten durchsuchbar sind, können Sie damit anhand von Publikumsreaktionen Highlights oder virale Momente identifizieren.
- Sie können die strukturierten Ausgabedaten für zahlreiche Anwendungsfälle an Anwendungen übergeben, darunter präzise Untertitel, durchsuchbare Audioarchive und automatisiertes Social Clipping.
- Scribes Transkription auf Wortebene unterstützt bis zu 5 Kanäle, die jeweils unabhängig transkribiert werden.
Was ist Audiotranskription mit Zeitstempeln und Ereignis-Tags?
Eine Transkription mit Zeitstempeln ist eine Form der automatischen Spracherkennung (ASR), die beim Transkribieren die genauen Start- und Endzeitpunkte von Wörtern und anderen Audioereignissen wie Applaus erfasst. Die Ausgabe sind vollständig strukturierte, navigierbare Daten.
Herkömmliche ASR-Transkription verarbeitet Audio zu großen Blöcken lesbaren Texts. Sie liefert Untertitel und ein Transkript für menschliche Leser, ist als Datenquelle jedoch nur begrenzt nützlich.
Wenn Sie ihn mit Zeitstempeln strukturieren möchten, müssen Sie den Text durch einen weiteren Machine-Learning-Dienst führen, der ihn dem Audio zuordnet. Sie können letztlich eine ähnliche Ausgabe erzeugen, benötigen dafür aber mehrere Verarbeitungsschritte statt einer nativen API-Ausgabe. Das erhöht Latenz und Rechenaufwand.
Audio navigierbar machen
Der entscheidende Vorteil der Transkription mit Zeitstempeln und Ereignis-Tags ist, dass sie sowohl für Menschen als auch für Maschinen lesbar ist. Das ermöglicht wichtige Geschäftsanwendungen:
- Compliance-Prüfung: Sie können ein Transkript nach Schlüsselwörtern durchsuchen und erhalten für jede Erwähnung sensibler Daten genaue Zeitstempel.
- Videoproduktion und -bearbeitung: Videoproduktionssoftware kann Untertitel auf die Millisekunde mit dem Gesagten auf dem Bildschirm synchronisieren. Sie kann auch Publikumsreaktionen passend kennzeichnen.
- Durchsuchbare Archive: Teams aus PR, Vertrieb und Schulung können unter anderem große Mengen an Kundeninterviews, Messevorträgen, Webinaren oder Bürgerversammlungen in umfangreiche, durchsuchbare Archive transkribieren.
- Marketinganalysen und Kundenstimmung: Ereignis-Tagging kann Publikumsreaktionen kennzeichnen, die in einer einfachen Texttranskription verloren gehen könnten.
Welche Vorteile bieten native Zeitstempel auf Wortebene?
Standardmäßige Speech-to-Text-Modelle verarbeiten Sprache in Abschnitten, meist in ganzen Sätzen oder Absätzen. Wenn Sie Zeitstempel für jedes Wort benötigen, müssen Sie eine weitere Verarbeitungsschicht für einen zweiten Durchlauf mit Forced Alignment entwickeln. Das erhöht Infrastruktur und Latenz und schafft zusätzliche mögliche Fehlerquellen. Beispielsweise können Zeitstempel bei schneller Sprache oder Sprache unter lauten Hintergrundgeräuschen abweichen oder ganz ausfallen.
Transkription mit Zeitstempeln, wie Scribe sie bietet, umgeht dieses Problem durch eine feinere Transkription Wort für Wort. Das geschieht in einem einzigen API-Aufruf. Zusätzliche Infrastruktur oder Skripte sind nicht erforderlich. Das Modell berechnet Zeitstempel während der Transkription, sodass die Sprachdaten das Audio immer exakt abbilden.
Wie funktioniert Transkription mit Zeitstempeln und Ereignis-Tags?
Nehmen wir Scribe als Beispiel.
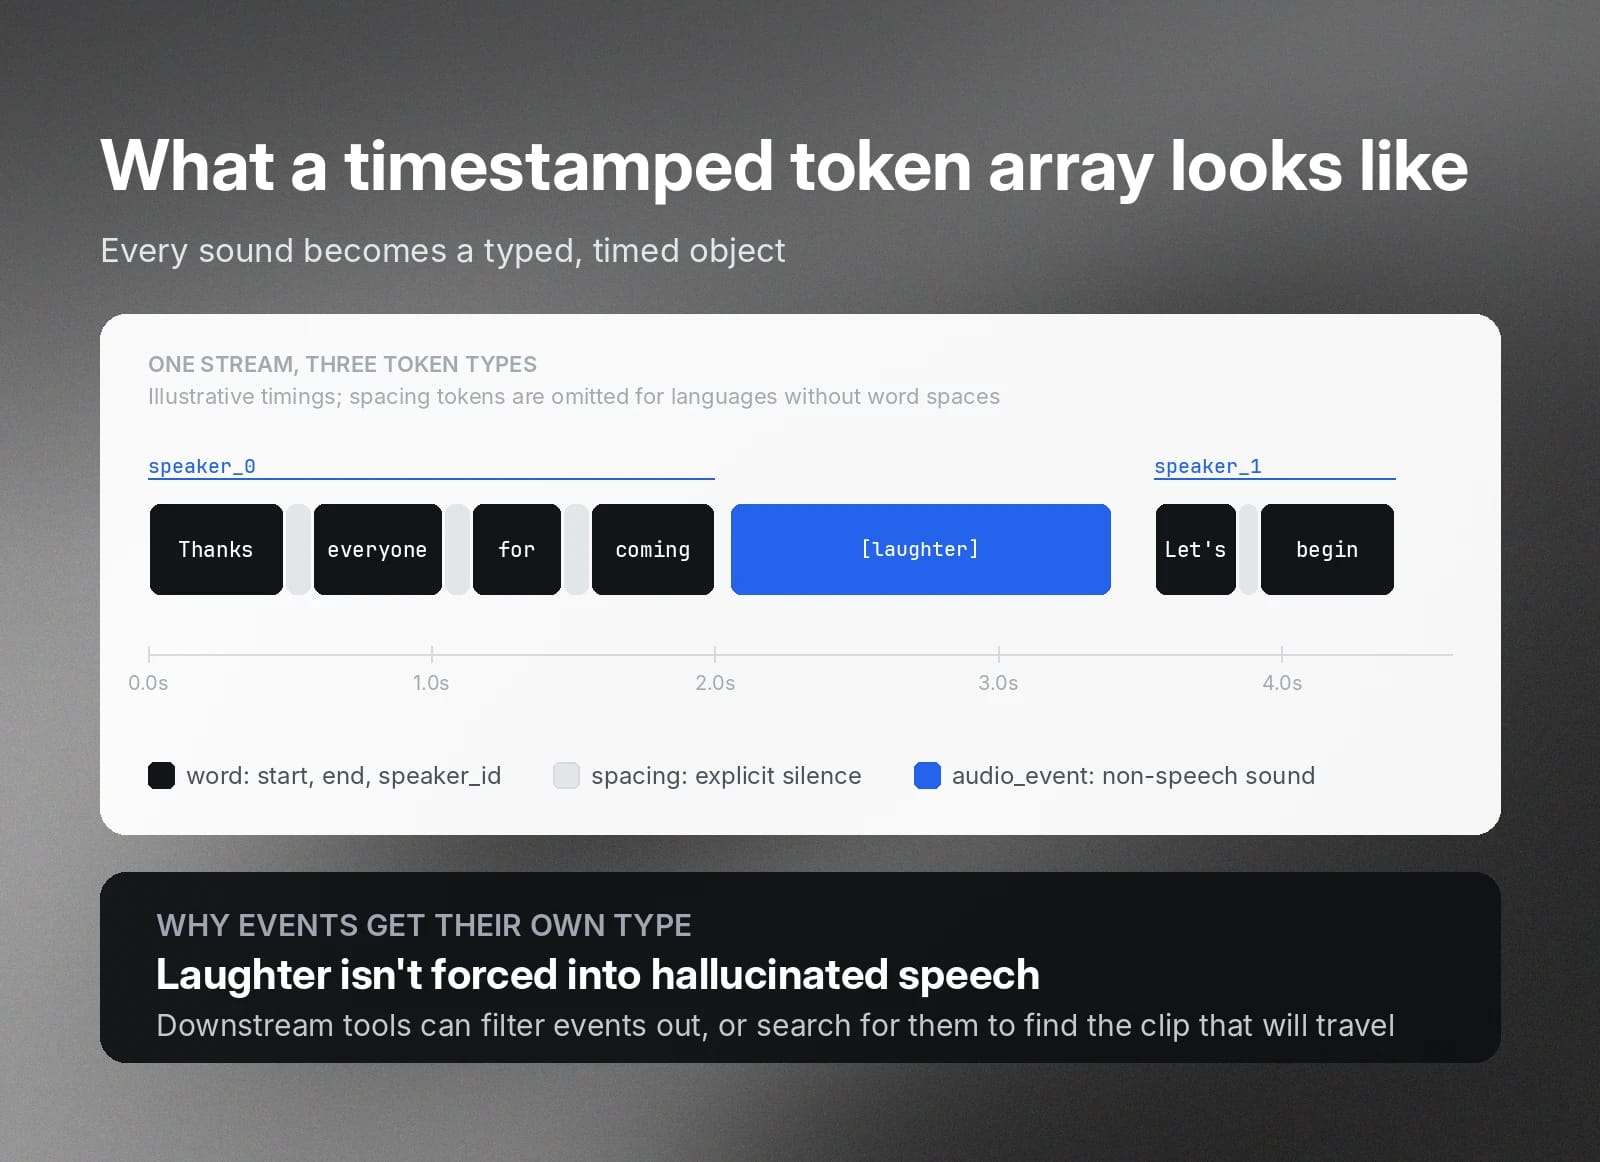
Ein natives Transkriptionsmodell auf Wortebene ordnet die Sprachlaute eines Audiostreams einem strukturierten Array von Token-Objekten zu. Es kennzeichnet jedes Token als einen von drei Typen: word, spacing oder audio_event.
- word: Ein erkanntes einzelnes gesprochenes Wort mit erfasster Start- und Endzeit sowie einem speaker_id-Tag.
- spacing: Explizit gekennzeichnete Stille oder Pausen innerhalb der Sprache. Hilfreich, damit Untertitelungsdienste das richtige Tempo halten. Wird nicht für erkannte Sprachen verwendet, die keine Wortabstände nutzen, etwa Japanisch, Mandarin, Thai, Lao, Burmesisch und Kantonesisch.
- audio_event: Bedeutungsvolle nichtverbale Audiosignale wie Lachen oder Applaus. Das Modell strukturiert diese als separaten Ereignistyp und zwingt das Audio nicht in halluzinierte Sprache.
Parameter für Echtzeitstreaming
Transkriptionsmodelle auf Wortebene können auch spezielle Funktionen zur Unterstützung von Live-Audiotranskription über WebSocket enthalten. Zum Beispiel:
- include_timestamps=true: Dieser Parameter sorgt dafür, dass die Verbindung Zeitstempel auf Wortebene in die JSON-Nachrichten committed_transcript_with_timestamps einfügt, die am Ende jedes finalisierten Audio-Chunks gesendet werden. So erhalten Sie Zeitstempel, während der Stream noch läuft. Audioereignis-Tags werden nur einbezogen, wenn auch tag_audio_events aktiviert ist.
- include_language_detection=true: Dieser Parameter weist die Verbindung an, erkannte gesprochene Sprachen zusammen mit dem Konfidenzwert des Modells für die Erkennung zu kennzeichnen. So können Sie mehrsprachige Untertitel live erstellen.
Wie kennzeichnet ein Speech-to-Text-Modell nichtsprachliche Ereignisse?
Scribe kennzeichnet Audioereignisse, wenn der Parameter tag_audio_events aktiviert ist. Dann kennzeichnet es konkrete Start- und Endzeiten und versieht sie mit Zeitstempeln, genau wie Wörter. Es kann verschiedene Reaktionen markieren, am häufigsten Lachen und Applaus, aber auch andere kontextuell relevante Umgebungsgeräusche wie Schritte oder Hintergrundmusik.
Dadurch werden Transkripte und Untertitel unmittelbar informativer, da wichtiger Kontext hinzukommt. Sarkasmus ist für Leser in einfachem, flachem Text möglicherweise schwerer zu erkennen. Ein [laughter]-Tag bereichert das Transkript und macht es emotional aussagekräftiger.
Bessere Analysen
Ereignis-Tagging macht auch nachgelagerte Analysen sauberer, da diese Tools keinen einzelnen Block unstrukturierten Texts analysieren müssen. Native Transkription auf Wortebene trennt Audioereignisse als strukturierte Daten, sodass Ihre Tools sie bei Bedarf einfach herausfiltern und nur verbale Inhalte verarbeiten können.
Da spacing-Tokens Pausen sichtbar machen, können Sie sie analysieren. Das kann für Stimmungsanalysen und QA-Anwendungsfälle wertvoll sein, etwa um zu messen, wie lange ein Kundenservice-Mitarbeiter während eines Anrufs still war.
Zeitstempel leichter durchsuchen
Oder Sie können gezielt nach ihnen suchen. Bei einer Stimmungsanalyse eines Interviews zum Produkttest können Sie relevante emotionale Reaktionen gezielt herausfiltern. Wenn Sie einen Social-Media-Account betreiben, können Sie in einer einstündigen Rede schnell nach Lachen suchen und so die Clips finden, die Ihrer Einschätzung nach am ehesten viral gehen.
Welche praktischen Anwendungen gibt es für strukturierte Transkripte mit Zeitstempeln?
Strukturierte Daten direkt aus Transkriptionen bieten mehrere wichtige Anwendungsfälle.
Erstellung von Captions und Untertiteln
Sie können Transkripte mit Zeitstempeln ohne Zwischenverarbeitung direkt in Produktionsformate für Untertitel exportieren, darunter SRT und VTT. Ihr Videobearbeitungstool kann Wort-Timings verwenden, um Wörter in den Untertiteln beim Sprechen hervorzuheben.
Das Transkriptionsmodell kann schnelle Sprache leicht verarbeiten, weil es Wort für Wort arbeitet. Während ein herkömmliches Modell bei sehr schneller Sprache oder überlappenden Stimmen scheitern kann, liefert ein Wort-für-Wort-Modell wie Scribe eine saubere, strukturierte Transkription.
Audio- und Videosuche
Mit herkömmlicher Transkription können Sie Schlüsselwörter im Textblock finden, aber ohne Forced Alignment können Sie nicht direkt zu dem Moment springen, in dem ein Satz gesagt wurde. Eine Stichwortsuche in einer Transkription auf Wortebene ist vollständig indexiert und führt Sie direkt zu der Sekunde im Audio, in der ein Satz gesprochen wurde. Dadurch wird Ihr Audioarchiv zu einem vollständig durchsuchbaren Referenzkatalog. Das ist besonders nützlich für die Verwaltung großer Medienbibliotheken, Podcast-Netzwerke und Unternehmensarchive.
Compliance- und Risikoprüfung
Oft möchten Sie Audio mit sensiblen Informationen aufzeichnen, etwa Kundenservice-Anrufe für die Qualitätssicherung. Gerade diese Anrufe enthalten häufig sensible oder regulierte personenbezogene Daten.
Um Compliance einzuhalten und dennoch Audiodaten für Analysen zu nutzen, benötigen Sie eine Möglichkeit, sensible Daten in Transkripten in Echtzeit zu schwärzen. Native Zeitstempel auf Wortebene ermöglichen Ihnen Funktionen wie ElevenLabs' Entitätserkennung, die sensible Entitäten wie Kreditkartennummern oder Namen kennzeichnet und deren Offsets und Zeitstempel zurückgibt. So können Sie sie in Ihren eingehenden Transkripten ausblenden.
Sie können beispielsweise eine Kreditkartennummer, den Geburtsnamen der Mutter, das Geburtsdatum und den Kundennamen erkennen und schwärzen, während sie in einem Anruf zur Identitätsprüfung genannt werden.
Automatisiertes Social-Media-Clipping
Sie können auch Stichwortsuchen programmatisch automatisieren, um Highlights in längeren Inhalten zu finden. Beispielsweise können Sie wichtige Momente aus einer Wahlkampfrede oder einem Unternehmensseminar hervorheben. So verwandeln Sie aktuelle Inhalte in professionell bearbeitete Highlights für YouTube, LinkedIn oder TikTok.
Zeitliche Zuordnung für mehrere Kanäle und Sprecher
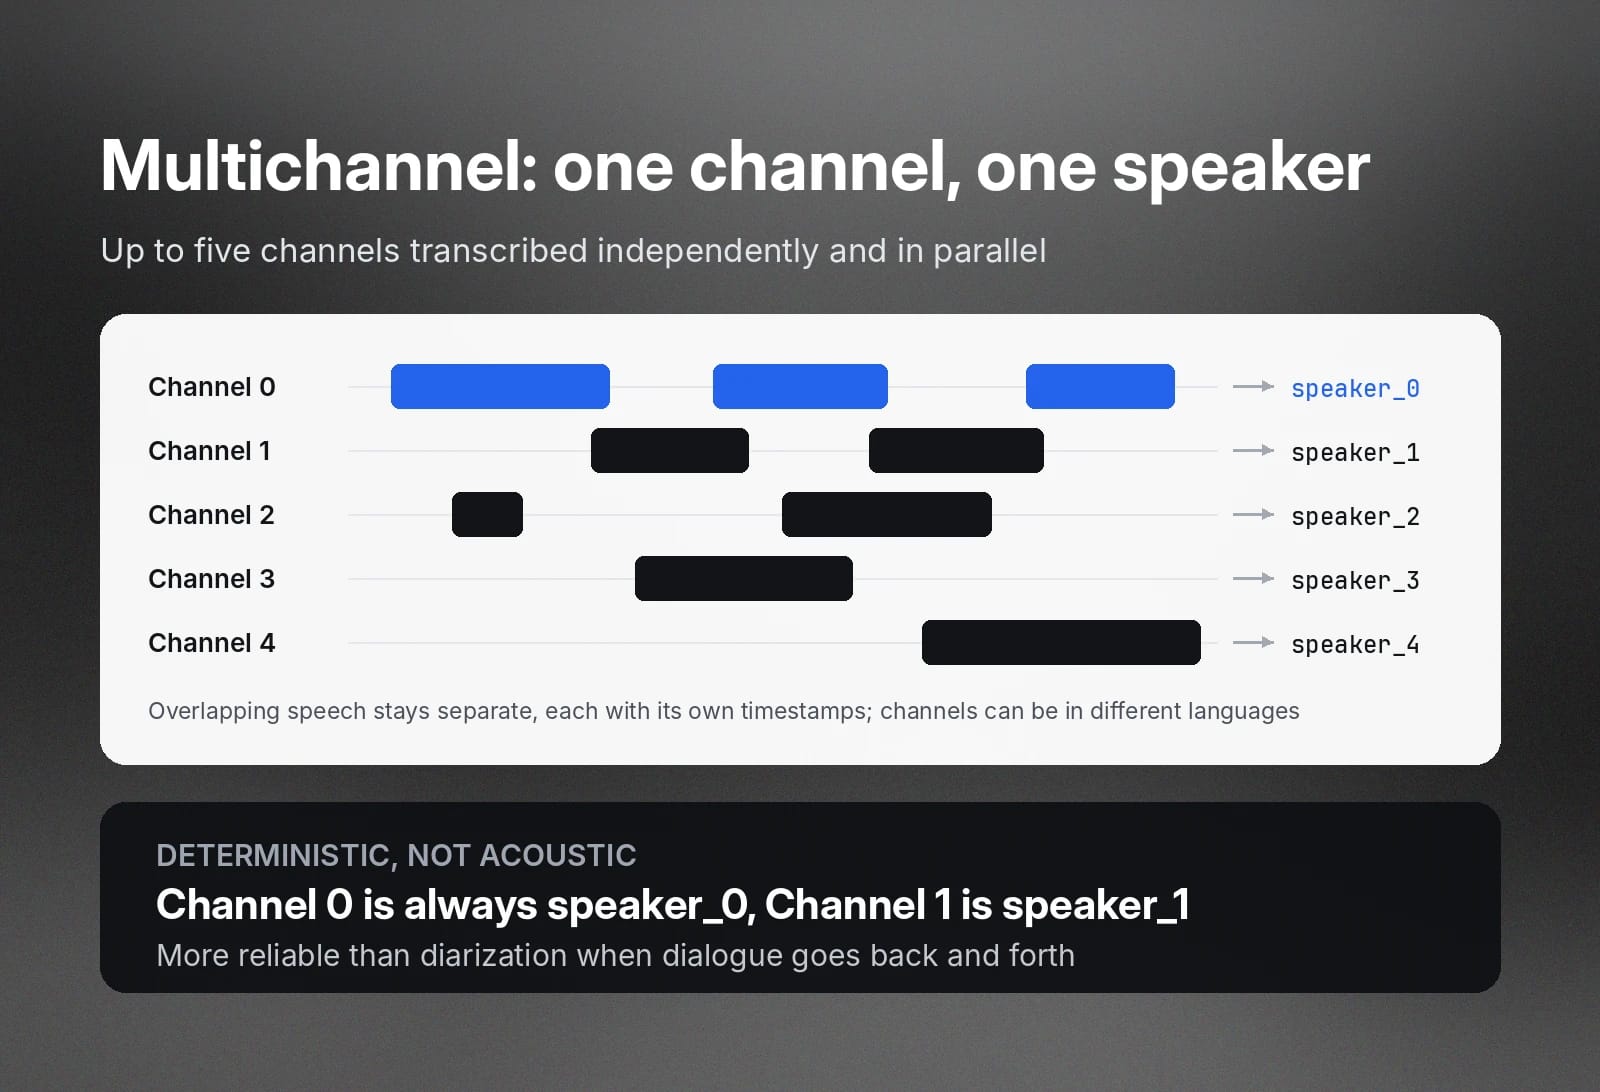
Scribe kann bis zu fünf Kanäle unabhängig und parallel transkribieren. Jeder erhält eine Sprecher-ID und Zeitstempel. Das ist zuverlässiger als die standardmäßige akustische Sprecherdiarisierung, die bei Dialogen mit häufigem Sprecherwechsel oft Probleme hat. Bei Mehrkanalaufnahmen ist Scribes Sprecherzuordnung rein deterministisch. Das heißt: Kanal 0 wird speaker_0 zugeordnet, Kanal 1 speaker_1 und so weiter.
Es kann Sprecher erkennen, die gleichzeitig sprechen möchten, und dennoch unabhängige Zeitstempel für ihre Sprache erzeugen. Sie können auch unterschiedliche Sprachen sprechen.
Zeitstempeldaten im benötigten Format exportieren
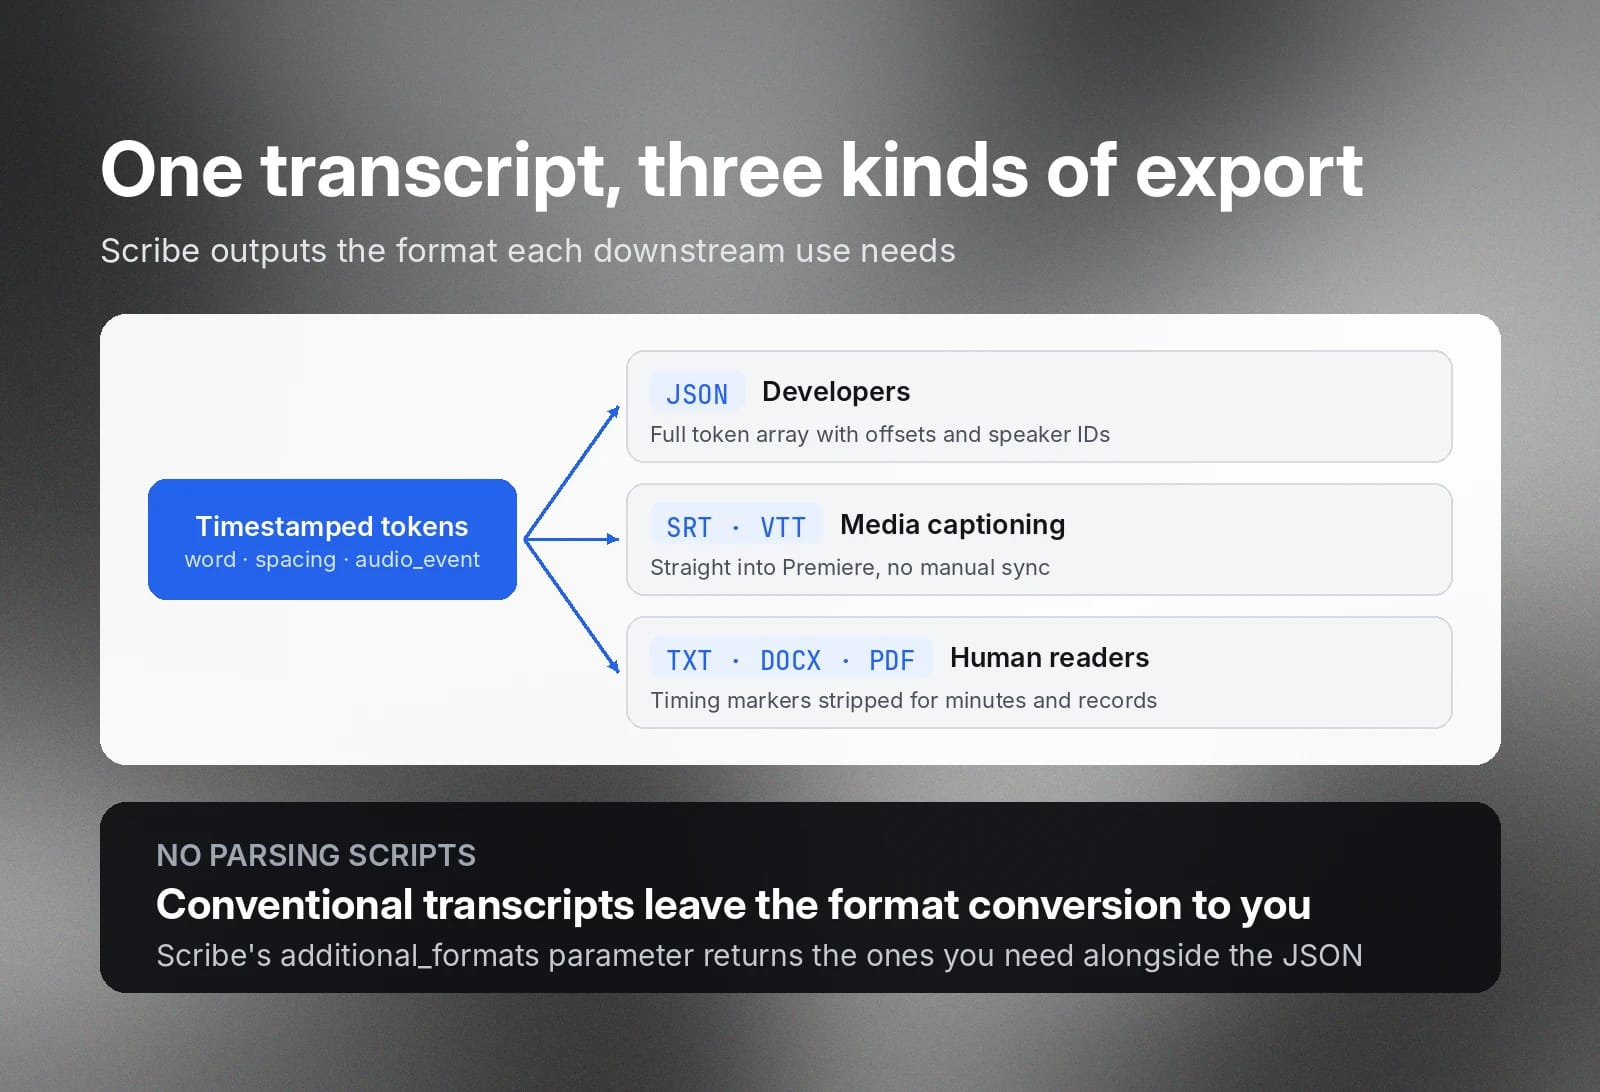
Wenn Sie herkömmliche Transkripte in mehreren Formaten ausgeben möchten, müssen Sie die Parsing-Skripte wahrscheinlich selbst schreiben. Scribe kann Transkripte je nach Verwendungszweck in mehreren Formaten exportieren. Vollständige Schemadefinitionen finden Sie in der ElevenLabs Create Transcript API-Referenz.
Strukturierte Daten für Entwickler: JSON
Scribe unterstützt den Export in JSON für Entwickler, die Daten in einem Schema benötigen, das sie an nachgelagerte Anwendungen übergeben können. Entwickler können diese JSON-Daten beispielsweise nutzen, um interaktive Medien oder eine semantische Suchdatenbank für ihre Organisation zu erstellen. Das vollständige Array aus word-, spacing- und audio_event-Tokens wird mit Start- und End-Offsets sowie Sprecher-IDs ausgegeben.
Medienuntertitel: SRT und VTT
Scribe kann SRT- und VTT-Transkripte ausgeben, die Sie ohne manuelle Synchronisierung direkt in Adobe Premiere oder andere Produktionsanwendungen übernehmen können.
Lesbar für Menschen: TXT, DOCX und PDF
Es kann Transkripte auch in lesefreundlichen Formaten ausgeben. In diesen Formaten entfernt Scribe detaillierte Zeitmarkierungen, damit der Text besser lesbar und für Rechts- oder Auditdokumentationen geeignet ist. Das ist beispielsweise nützlich, wenn Sie Protokolle von Vorstandssitzungen direkt nach einer Sitzung effizient verteilen, Podcast-Transkripte für SEO veröffentlichen oder Rechtsunterlagen archivieren müssen.
Beginnen Sie mit den Transkriptionen von ElevenLabs mit Zeitstempeln und Ereignis-Tags
Native Transkription auf Wortebene liefert Ihnen schnell und effizient die strukturierten Daten, die Sie für Ihre Workflows benötigen.
Beginnen Sie noch heute mit der Transkription Ihrer Audiodaten mit Scribe in ElevenAPI oder erfahren Sie mehr über Transkription auf Wortebene.
FAQ zu Zeitstempeln und Transkription mit Ereignis-Tags

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


