Text to Speech vs. Speech to Text: Was ist der Unterschied?
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Stellen Sie sich vor: Sie fahren zur Arbeit und Ihr Smartphone liest Ihnen Ihre ungelesenen E-Mails mit Text to Speech (TTS) vor. Noch besser: Sie senden Ihre Antworten, ohne Ihr Smartphone berühren oder den Blick von der Straße abwenden zu müssen – alles dank Speech to Text (STT).
Diese Technologien sind nicht nur unterhaltsame, futuristische Konzepte. Sie werden schnell zu festen Bestandteilen unseres Alltags, vereinfachen tägliche Aufgaben und verbessern die Barrierefreiheit.
Tauchen wir ein in die Welt von KI-gestütztem TTS und STT: Was sie sind, worin sie sich unterscheiden, wie sie funktionieren, worauf Sie bei TTS- und STT-Anbietern achten sollten und wie sie in verschiedenen Branchen eingesetzt werden.
Die Unterschiede zwischen TTS und Text aus Sprache
Zwischen TTS und Text-aus-Sprache-Technologie gibt es mehrere wichtige Unterschiede.
Funktionsweise
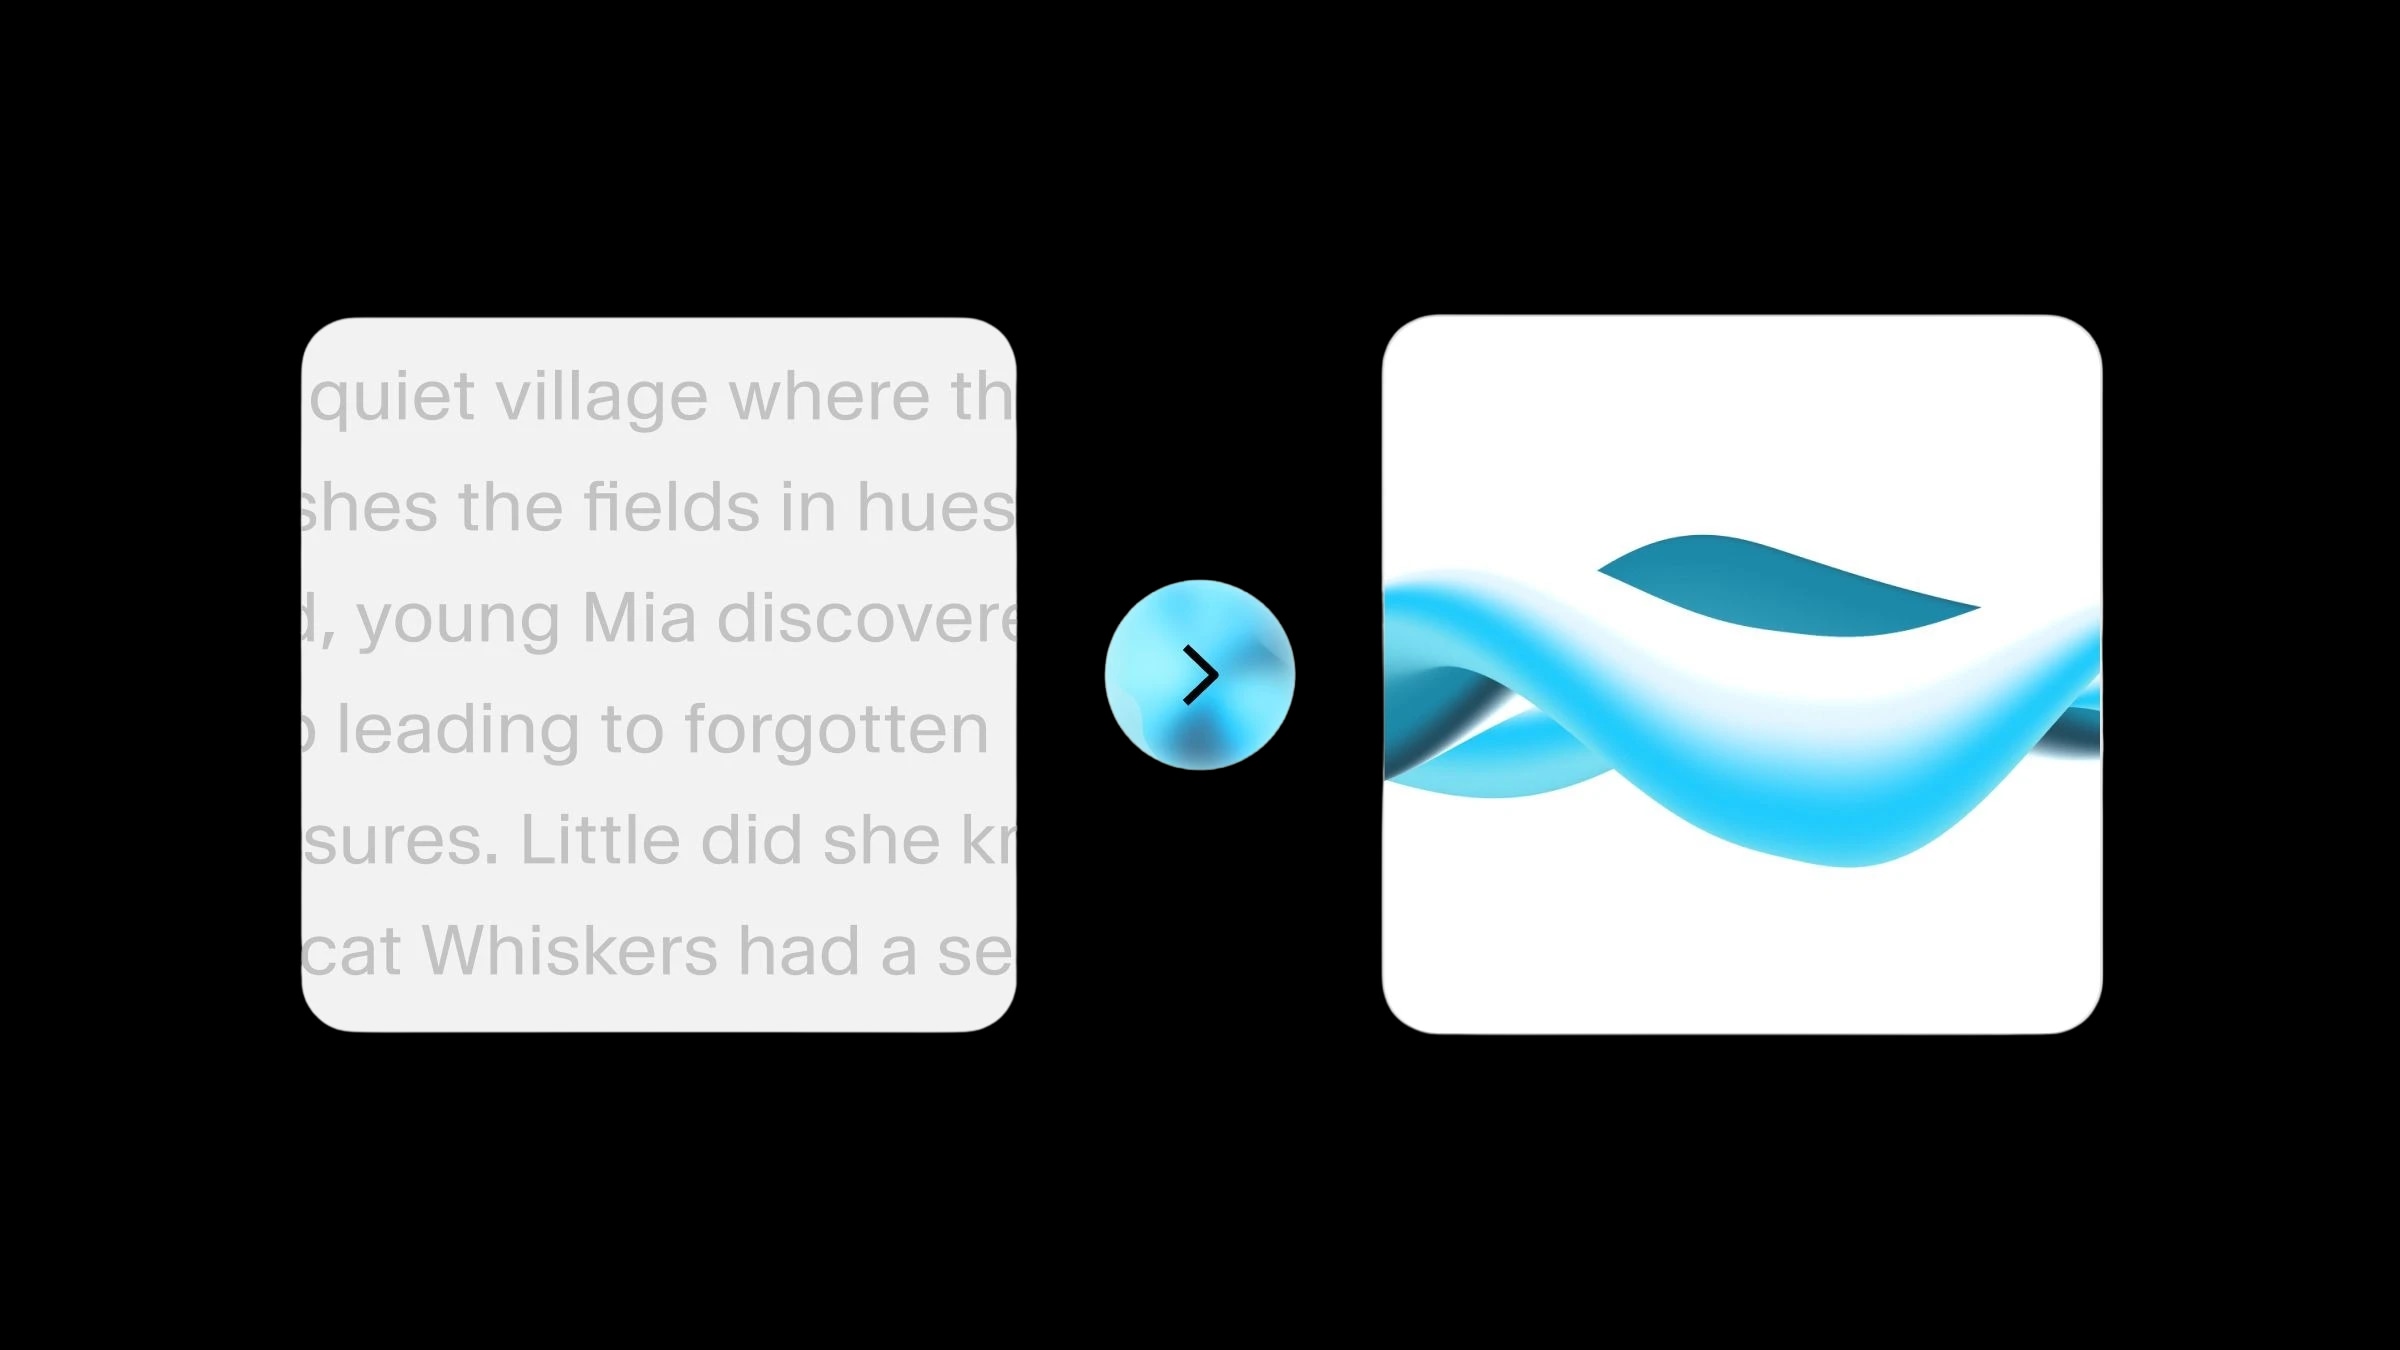
TTS (Text to Speech) wandelt geschriebenen Text in gesprochene Wörter um, während Speech to Text (STT) das Gegenteil tut und gesprochene Wörter in Text transkribiert. TTS macht schriftliche Inhalte hörbar und fungiert als Sprachassistent für Menschen mit Sehbehinderungen oder Lernschwierigkeiten. STT hingegen erfasst gesprochene Sprache und wandelt sie in ein schriftliches Transkript um – hilfreich für Diktate und Sprachbefehle.
Einsatzkontext
TTS wird häufig in E-Readern, Lautsprechersystemen und virtuellen Assistenten integriert, um Audioausgaben bereitzustellen. STT wird für Transkriptionsdienste, sprachgesteuerte Anwendungen und Echtzeit-Untertitel für Menschen mit Hörbehinderungen eingesetzt. Bei TTS liegt der Schwerpunkt auf der Ausgabe und der hörbaren Vermittlung von Informationen. STT ist dagegen eingabeorientiert und konzentriert sich auf das Erfassen und Verarbeiten gesprochener Sprache.
Technologischer Ansatz
TTS umfasst Textanalyse, Sprachverarbeitung und Sprachsynthese. Die Technologie muss die Nuancen gesprochener Sprache, einschließlich Intonation und Rhythmus, präzise wiedergeben. STT benötigt fortschrittliche Spracherkennung, um verschiedene Akzente, Dialekte und Sprachmuster oft in Echtzeit genau zu transkribieren.
Was ist TTS (Text to Speech)?
TTS (Text to Speech) ist eine Technologie, die geschriebenen Text in gesprochene Wörter umwandelt. Im Kern ermöglicht TTS Computern das Vorlesen und verwandelt jeden Text in eine synthetische Stimme. Die Technologie wird vielseitig eingesetzt – von virtuellen Assistenten bis zu Barrierefreiheitstools für Menschen mit Leseschwierigkeiten.
Ein bemerkenswertes Beispiel für fortschrittliche TTS-Technologie sind die TTS-Funktionen von ElevenLabs. ElevenLabs TTS zeichnet sich durch besonders natürliche, menschenähnliche Sprachausgaben aus. Dies gelingt durch fortschrittliche KI-Algorithmen, die nicht nur den Klang menschlicher Sprache nachbilden, sondern auch die Nuancen und Betonungen natürlicher Sprachmuster verstehen und reproduzieren.
Dieser Realismus macht ElevenLabs TTS ideal für ansprechende Audioinhalte in verschiedenen Medien, für Benutzeroberflächen mit Sprachausgabe und als barrierefreie Lesealternative für Menschen mit Sehbehinderungen.
Was ist Text aus Sprache (Speech to Text, STT)?
Text aus Sprache, auch bekannt als Speech to Text (STT), bezeichnet die Umwandlung gesprochener Sprache in geschriebenen Text. Diese Spracherkennungstechnologie ist entscheidend für die Erstellung von Transkriptionen aus Audioaufnahmen, ermöglicht Sprachbefehle und unterstützt Echtzeit-Untertitel für mehr Barrierefreiheit.
ElevenLabs hat STT-Technologie deutlich weiterentwickelt. Unser Modell Scribe wandelt Audio und Video effizient in Text in 99 Sprachen um. Mit seiner benutzerfreundlichen Oberfläche eignet es sich ideal, um Besprechungen, Vorlesungen und Interviews aus Audio- und Videodateien schriftlich festzuhalten.
Wie funktioniert TTS?
TTS-Technologie wandelt geschriebenen Text in hörbare Sprache um. Dieser Prozess umfasst mehrere komplexe Schritte.
Zunächst zerlegt das TTS-System den Text in Phoneme – die kleinsten Lauteinheiten einer Sprache. Diese Segmentierung ist entscheidend, damit das System verschiedene Wörter präzise aussprechen kann.
Nach dieser phonemischen Segmentierung wandelt das System die Laute in digitale Sprache um. Künstliche Intelligenz (KI) spielt dabei eine zentrale Rolle. Mithilfe von KI-Algorithmen, die mit umfangreichen Datensätzen gesprochener Sprache trainiert wurden, kann das System Sprache mit menschenähnlichen Tönen und Rhythmen erzeugen. Diese erzeugte Sprache wird dann den identifizierten Phonemen zugeordnet, sodass eine natürlich klingende Ausgabe entsteht.
Dank Fortschritten bei KI und maschinellem Lernen haben sich moderne TTS-Technologien stark weiterentwickelt. Sie können heute kontextuelle Nuancen verstehen, mehrere Sprachen unterstützen und emotionale Betonungen teilweise nachahmen. Diese Fortschritte haben die Sprachausgabe deutlich menschlicher gemacht und sorgen für natürlichere, ansprechendere Interaktionen mit digitalen Geräten.
Welche TTS-Anbieter sind die besten?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
Wie funktioniert Speech to Text?
Speech-to-Text-Technologie (STT) wandelt gesprochene Sprache durch einen komplexen, mehrstufigen Prozess in geschriebenen Text um.
Zuerst werden gesprochene Wörter erfasst, meist über ein Mikrofon. Diese Audioeingabe wird dann in ein digitales Format umgewandelt, das das System verarbeiten kann. Der Kern von STT ist die Fähigkeit, dieses digitale Audio zu analysieren. Dafür werden komplexe Algorithmen eingesetzt, die Sprache in kleinere, erkennbare Segmente zerlegen.
Diese Segmente sind Phoneme, die kleinsten Lauteinheiten der Sprache. Das STT-System gleicht diese Phoneme mit einem vordefinierten Sprachmodell ab, um Wörter und Wortgruppen zu erkennen. Dieser Schritt ist entscheidend, um unterschiedliche Akzente, Dialekte und Sprachvarianten zu verstehen.
Anschließend wendet das System Techniken der natürlichen Sprachverarbeitung (NLP) an. NLP hilft dabei, Kontext und Syntax der gesprochenen Sprache zu verstehen und ermöglicht so präzisere Transkriptionen. Außerdem kann das System komplexe Satzstrukturen und branchenspezifischen Fachjargon verarbeiten.
Fortschrittliche STT-Systeme nutzen Algorithmen für maschinelles Lernen und Deep Learning, die mit mehr Daten und Nutzung besser werden. Diese Technologien ermöglichen dem System, im Laufe der Zeit neue Sprachmuster, Akzente und sogar Sprachen zu lernen und so Genauigkeit und Effizienz zu steigern.
Zusammenfassend umfasst STT-Technologie die Audioerfassung, phonemische Analyse, Sprachmodellierung und NLP, die alle durch maschinelles Lernen unterstützt werden, um Sprache effektiv in Text umzuwandeln.
Welche Speech-to-Text-Anbieter sind die besten?
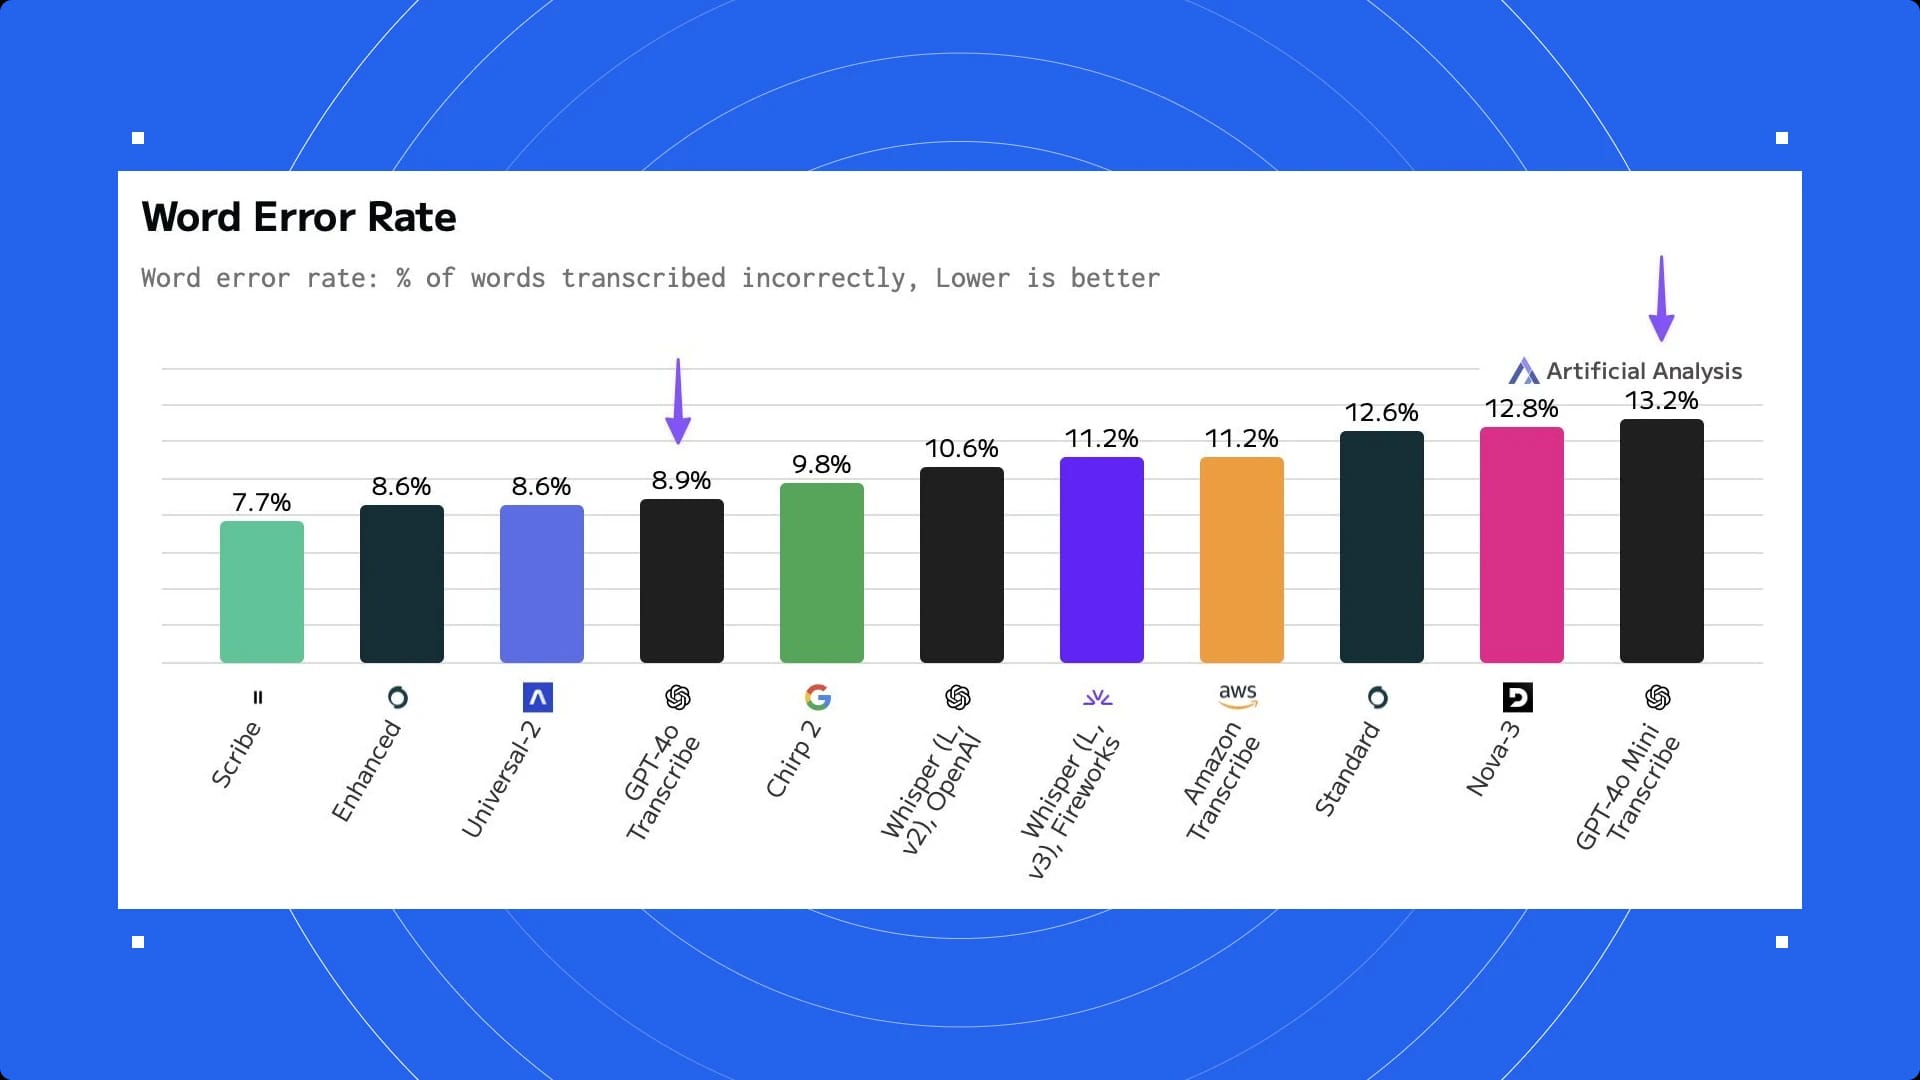
Die besten Speech-to-Text-Anbieter sind ElevenLabs Scribe, gefolgt von OpenAI und weiteren Anbietern wie Google.
TTS und STT: Genauigkeit und Herausforderungen
TTS- und Speech-to-Text-Technologien streben nach menschenähnlicher Präzision. Ihre Genauigkeit verbessert sich ständig – perfekt sind sie jedoch nicht. Das können Sie bei beiden Technologien hinsichtlich Genauigkeit und Herausforderungen erwarten.
Genauigkeit und Herausforderungen bei TTS
KI-Stimmen-TTS-Technologie hat sich stark weiterentwickelt, steht aber weiterhin vor Herausforderungen. Die größte besteht darin, natürlich klingende menschliche Stimmen zu erzeugen. Moderne TTS-Systeme können zwar klare und verständliche Audioausgaben erzeugen, doch menschenähnliche Betonungen und Emotionen einzubringen, bleibt schwierig. Zudem hat TTS Probleme bei der Kontextinterpretation und spricht Wörter abhängig vom Kontext manchmal falsch aus. Eine weitere Herausforderung ist die Anpassung von Stimmen an unterschiedliche Anforderungen, etwa verschiedene Akzente und Sprachmuster – entscheidend für globale Barrierefreiheit.
Genauigkeit und Herausforderungen bei Text aus Sprache/Speech to Text (STT)
STT-Technologie hat bei der Genauigkeit große Fortschritte gemacht, insbesondere mit dem Aufkommen von Deep Learning. In lauten Umgebungen kann es jedoch zu Schwierigkeiten kommen, da Hintergrundgeräusche die Spracherkennung beeinträchtigen. Auch das präzise Erfassen und Transkribieren unterschiedlicher Akzente und Dialekte ist eine große Herausforderung. Darüber hinaus haben STT-Systeme häufig Probleme mit Homophonen – Wörtern, die gleich klingen, aber unterschiedliche Bedeutungen haben – sowie mit komplexer Syntax oder Umgangssprache. Das beeinträchtigt ihre Wirksamkeit in realen Anwendungen.
Anwendungen in verschiedenen Branchen
TTS- und Speech-to-Text-Technologien finden innovative Einsatzmöglichkeiten in zahlreichen Branchen. Sie verändern unseren Umgang mit Informationen und verbessern die Barrierefreiheit.
TTS-Anwendungen in Branchen
TTS-Technologie wird in verschiedenen Bereichen eingesetzt. Im Bildungswesen unterstützt sie die Erstellung barrierefreier Lernmaterialien für Schüler und Studierende mit Leseschwierigkeiten oder Sehbehinderungen. Zum Beispiel durch die Umwandlung von Lehrbüchern in Hörbücher.
In der Automobilindustrie ermöglicht TTS Sprachausgaben in Navigationssystemen. Im Kundenservice wird TTS für automatisierte Antworten in Callcentern eingesetzt und steigert so die Effizienz. Darüber hinaus ist TTS in der Unterhaltungsbranche wichtig, insbesondere in Spielen und virtuellen Assistenten, wo es interaktive Nutzererlebnisse ermöglicht.
STT-Anwendungen in Branchen
STT-Technologie hat vielfältige Anwendungen in zahlreichen Branchen. Im Gesundheitswesen unterstützt sie die Transkription von Arzt-Patienten-Gesprächen und das Diktieren klinischer Dokumentation, was die Effizienz steigert. Im Rechtsbereich wird STT für die Transkription von Gerichtsverhandlungen und juristischen Dokumenten verwendet. Die Technologie spielt auch in den Medien eine wichtige Rolle, indem sie Echtzeit-Untertitel für Sendungen für Menschen mit Hörbehinderungen ermöglicht. In Unternehmen erleichtert STT effiziente Besprechungstranskriptionen und verbessert die Dokumentation sowie den Zugang zu Informationen.
Fazit
TTS- und Speech-to-Text-Technologien (STT) mögen ähnlich wirken, erfüllen jedoch unterschiedliche Funktionen. TTS wandelt geschriebenen Text in gesprochene Wörter um und erweckt schriftliche Inhalte mit menschenähnlichen Stimmen zum Leben. STT macht dagegen das Gegenteil: Es wandelt gesprochene Wörter in geschriebenen Text um und erfasst die Nuancen gesprochener Sprache in Textform.
Beide Technologien nutzen fortschrittliche KI, erfüllen jedoch unterschiedliche Anforderungen: TTS für das hörbare Erfassen schriftlicher Inhalte und STT für schriftliche Aufzeichnungen gesprochener Inhalte.
Bereit zum Start? Testen Sie Eleven v4, unser ausdrucksstärkstes Text-to-Speech-Modell.
Wenn Sie modernste TTS-Technologie erleben möchten, registrieren Sie sich für ElevenLabs noch heute. Sie werden nicht enttäuscht sein.