Wir stellen vor: Eleven v4, unser emotionalstes Modell
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Eine Textzeile kann je nachdem, wie sie gesprochen wird, völlig anders wirken. „Ich brauche Sie, damit Sie ruhig bleiben“ sollte unterschiedlich klingen, je nachdem, wer es sagt: ob ein Arzt es sanft zu einem verängstigten Patienten sagt oder eine Figur in einem Spiel es ihrem Team vor dem Sprung in die Schlacht zuruft.
Heute stellen wir Eleven v4 vor, unser bislang emotionalstes Text to Speech-Modell, sowie seine Variante mit geringer Latenz, Eleven v4 Turbo.
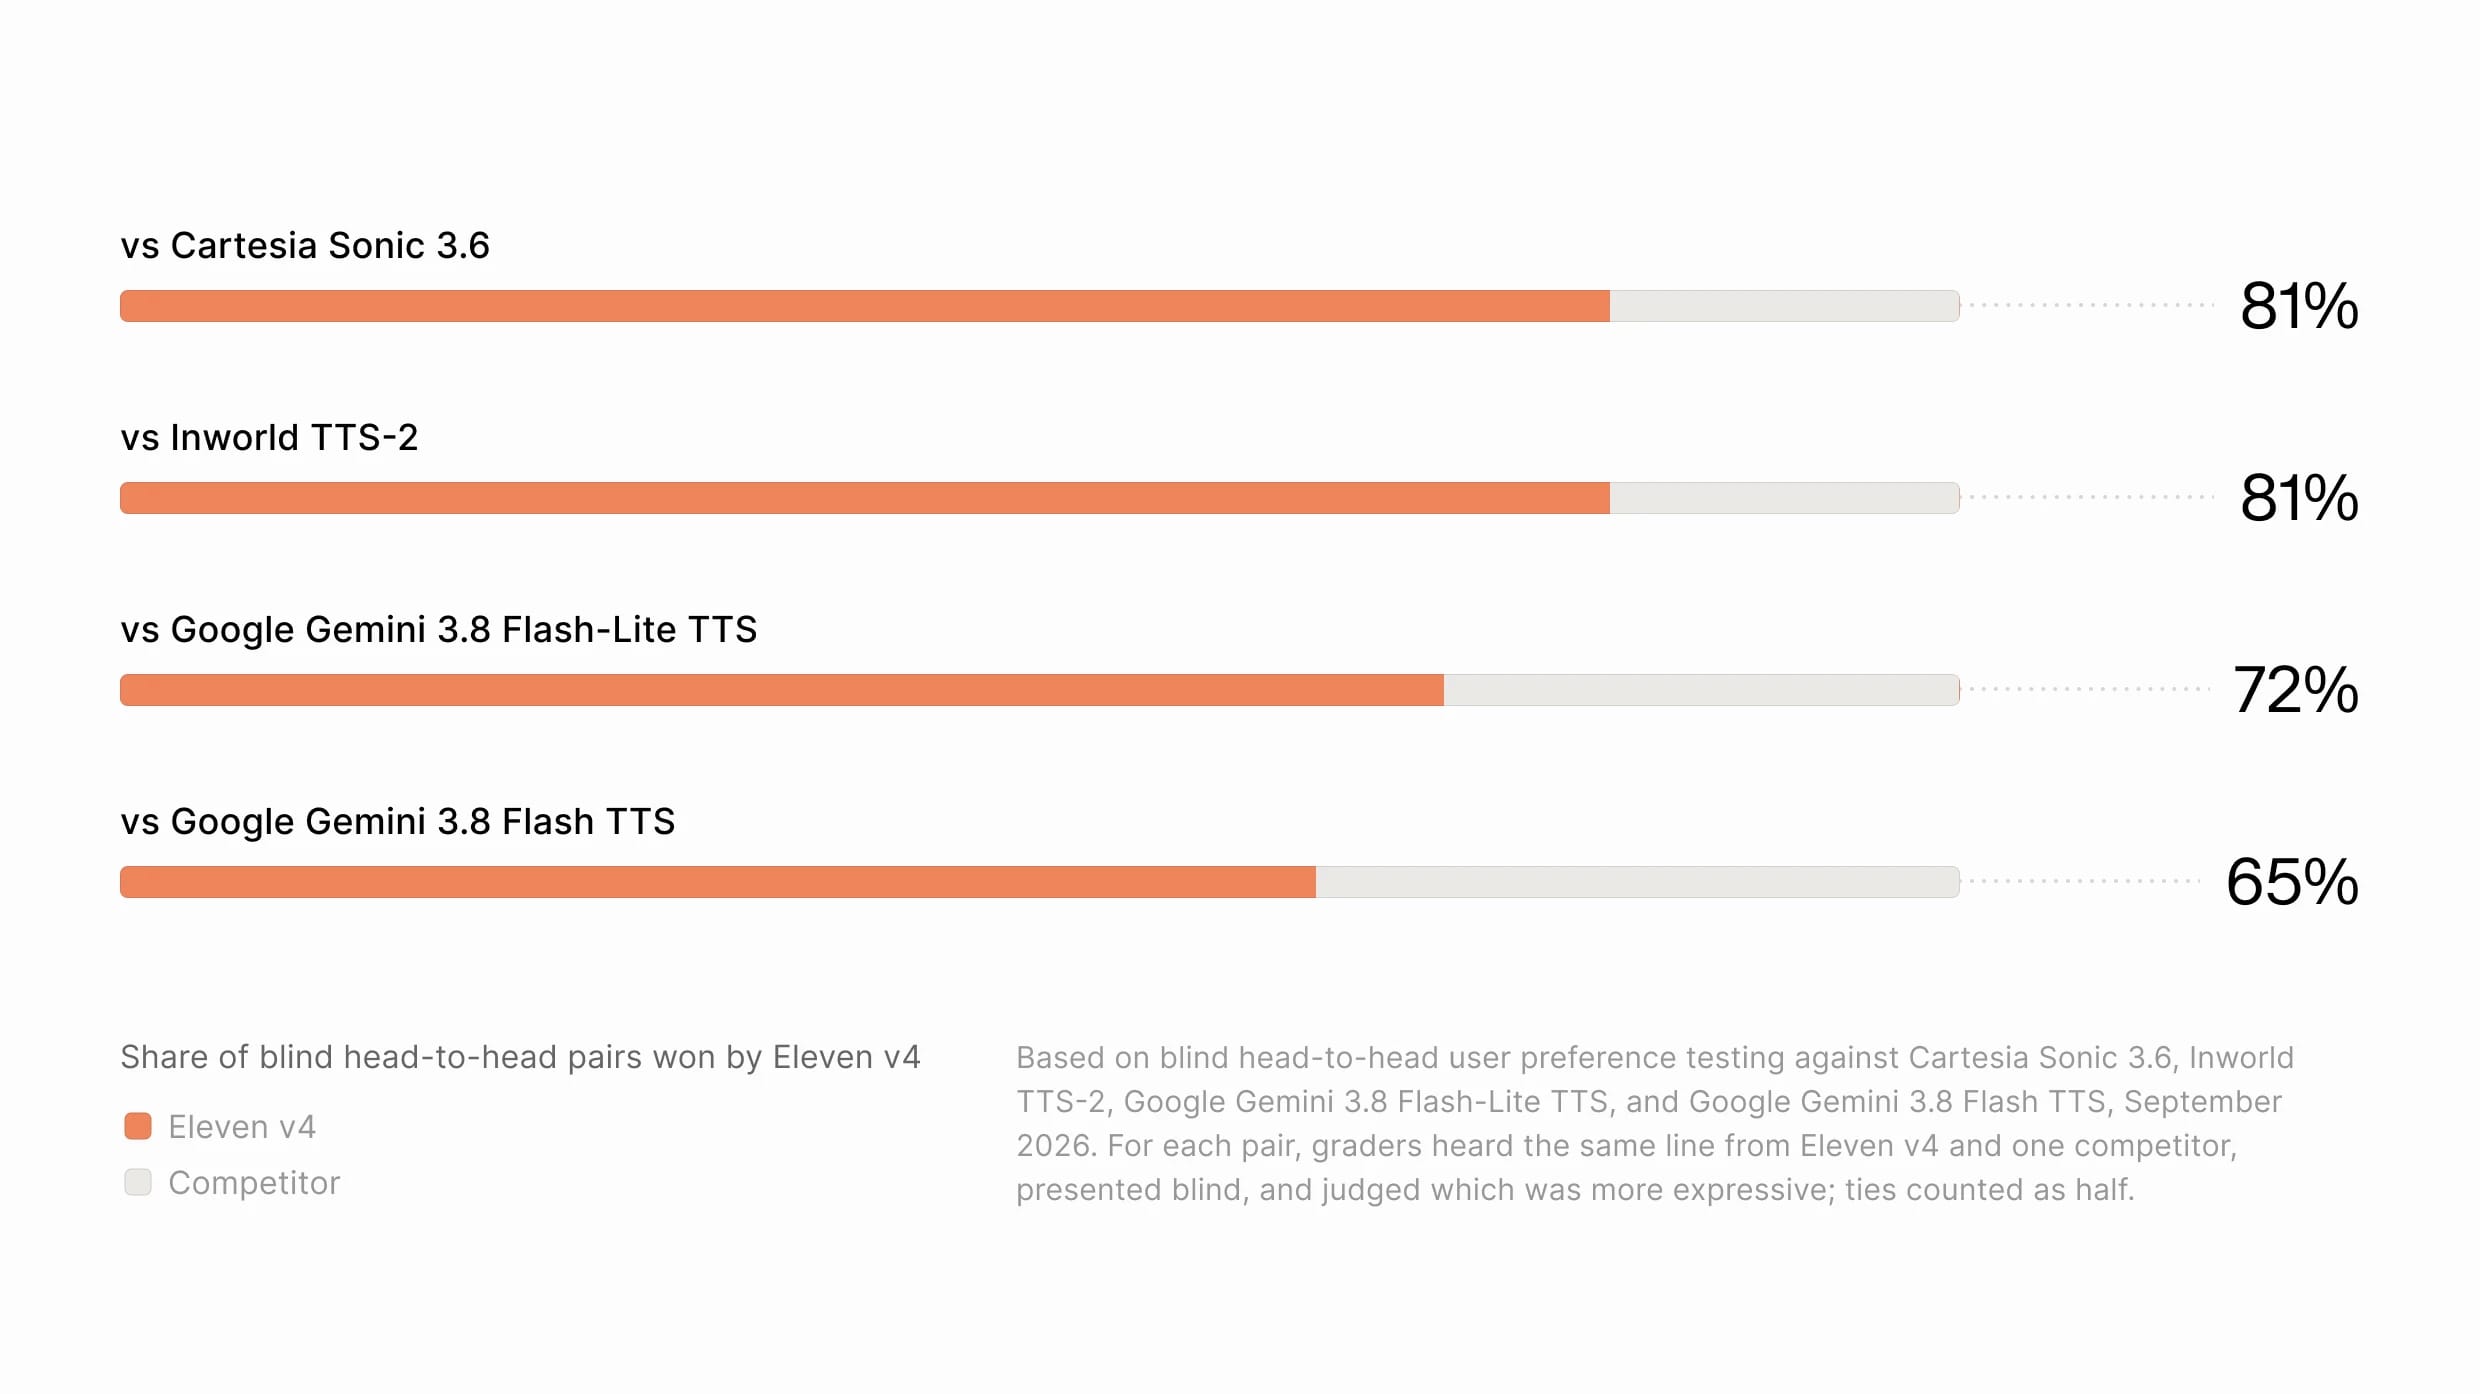
Von Artificial Analysis auf Platz 1 eingestuft1 und in blinden Direktvergleichen von rund 75 % der Hörer gegenüber konkurrierenden Modellen bevorzugt2 wurde Eleven v4 entwickelt, um Tonfall, Tempo, Emotion, Charakter und Kontext zu interpretieren. Es erzeugt Sprache, die dramatisch, zärtlich, dringlich, komisch oder dialogisch klingen kann, ohne die Identität des Sprechers zu verlieren. Natürlichere Dynamiken zwischen mehreren Sprechern lassen Gespräche reaktionsfähig wirken, statt wie aneinandergereihte Einzelzeilen. Sprecher reagieren auf den Gesprächskontext und erzeugen dadurch natürlichere Dialoge und Charakterinteraktionen.
Eine neue Architektur für Leistung
Eleven v4 basiert auf einer vollständig neuen Architektur und ist unser emotionalstes Text to Speech-Modell, das von Artificial Analysis auf Platz 1 eingestuft wurde1. Eleven v4 Turbo bringt dieselbe Technologie in Anwendungsfälle mit geringer Latenz, etwa für Agents. Mit einer medianen Inferenzlatenz von rund 100 ms kann es schneller reagieren als die durchschnittliche Pause zwischen zwei Menschen im Gespräch.
Beide Modelle können Sprache erzeugen, die emotional statt mechanisch wirkt. Auch die zugrunde liegende Audioqualität ist durchgehend höher, mit saubereren und natürlicher klingenden Ergebnissen.
Frühere Generationen von Text-to-Speech-Modellen können Text vorlesen, doch Eleven v4 verleiht Sprache eine emotionale Tiefe, die deutlich natürlicher wirkt. Das Modell kann den beabsichtigten Tonfall, das gewünschte Sprechtempo, den Charakter des Textes und den Kontext interpretieren, um emotional wirkungsvolle Sprache zu erzeugen.
Nutzer haben zudem präzise Kontrolle über die Ergebnisse und können in natürlicher Sprache beschreiben, wie eine Zeile vorgetragen werden soll. Sie können auch konkrete Anweisungen dazu geben, wie bestimmte Formulierungen gesprochen werden sollen, welche Emotion sie vermitteln sollen und sogar Soundeffekte hinzufügen – mit Inline-Tags wie [laughs], [said angrily in French accent], [light rain] oder [phone buzzing]. Eleven v4 befolgt diese Audio-Tags und Regieanweisungen präziser als frühere Modelle. So erhalten Sie genau die gewünschte Darbietung. Das erleichtert die Regie von Erzählungen, die Ausgestaltung von Charakteren und Dialogen sowie alle weiteren Anwendungsfälle, in denen die Darbietung entscheidend ist.
Die ElevenLabs-Entwicklerdokumentation erläutert die vollständige Tag-Syntax und wie Sie diese Tags über die API anwenden. Auch die Unterstützung für Phoneme des Internationalen Phonetischen Alphabets (IPA) wurde deutlich verbessert, sodass benutzerdefinierte Aussprachen zuverlässiger funktionieren.
Eleven v4 verbessert zudem die Konsistenz und dynamische Gespräche zwischen mehreren Sprechern. Mit einer neuen Methode zur Erfassung von Sprecheridentitäten bewahrt Eleven v4 die einzigartigen Eigenschaften jeder Stimme. Es kann Sprache in Agent-Gesprächen, Hörbüchern oder Werbung konsistent halten. Da das Modell den Kontext einer gesamten Szene versteht, erzeugt es natürliche Dialoge, in denen Sprecher auf das zuvor Gesagte reagieren, statt isolierte Zeilen aneinanderzureihen.
Ein Turbo-Modell für Anwendungsfälle mit geringer Latenz
Hochwertige Stimmenmodelle brauchten bislang meist länger für die Spracherzeugung. Nutzer mussten daher zwischen schnellen und ausdrucksstarken Voice Agents wählen. Viele entschieden sich für kompetente, aber monotone Agents, die auf einen gestressten Kunden, der lediglich sein Problem lösen möchte, robotisch wirken können.
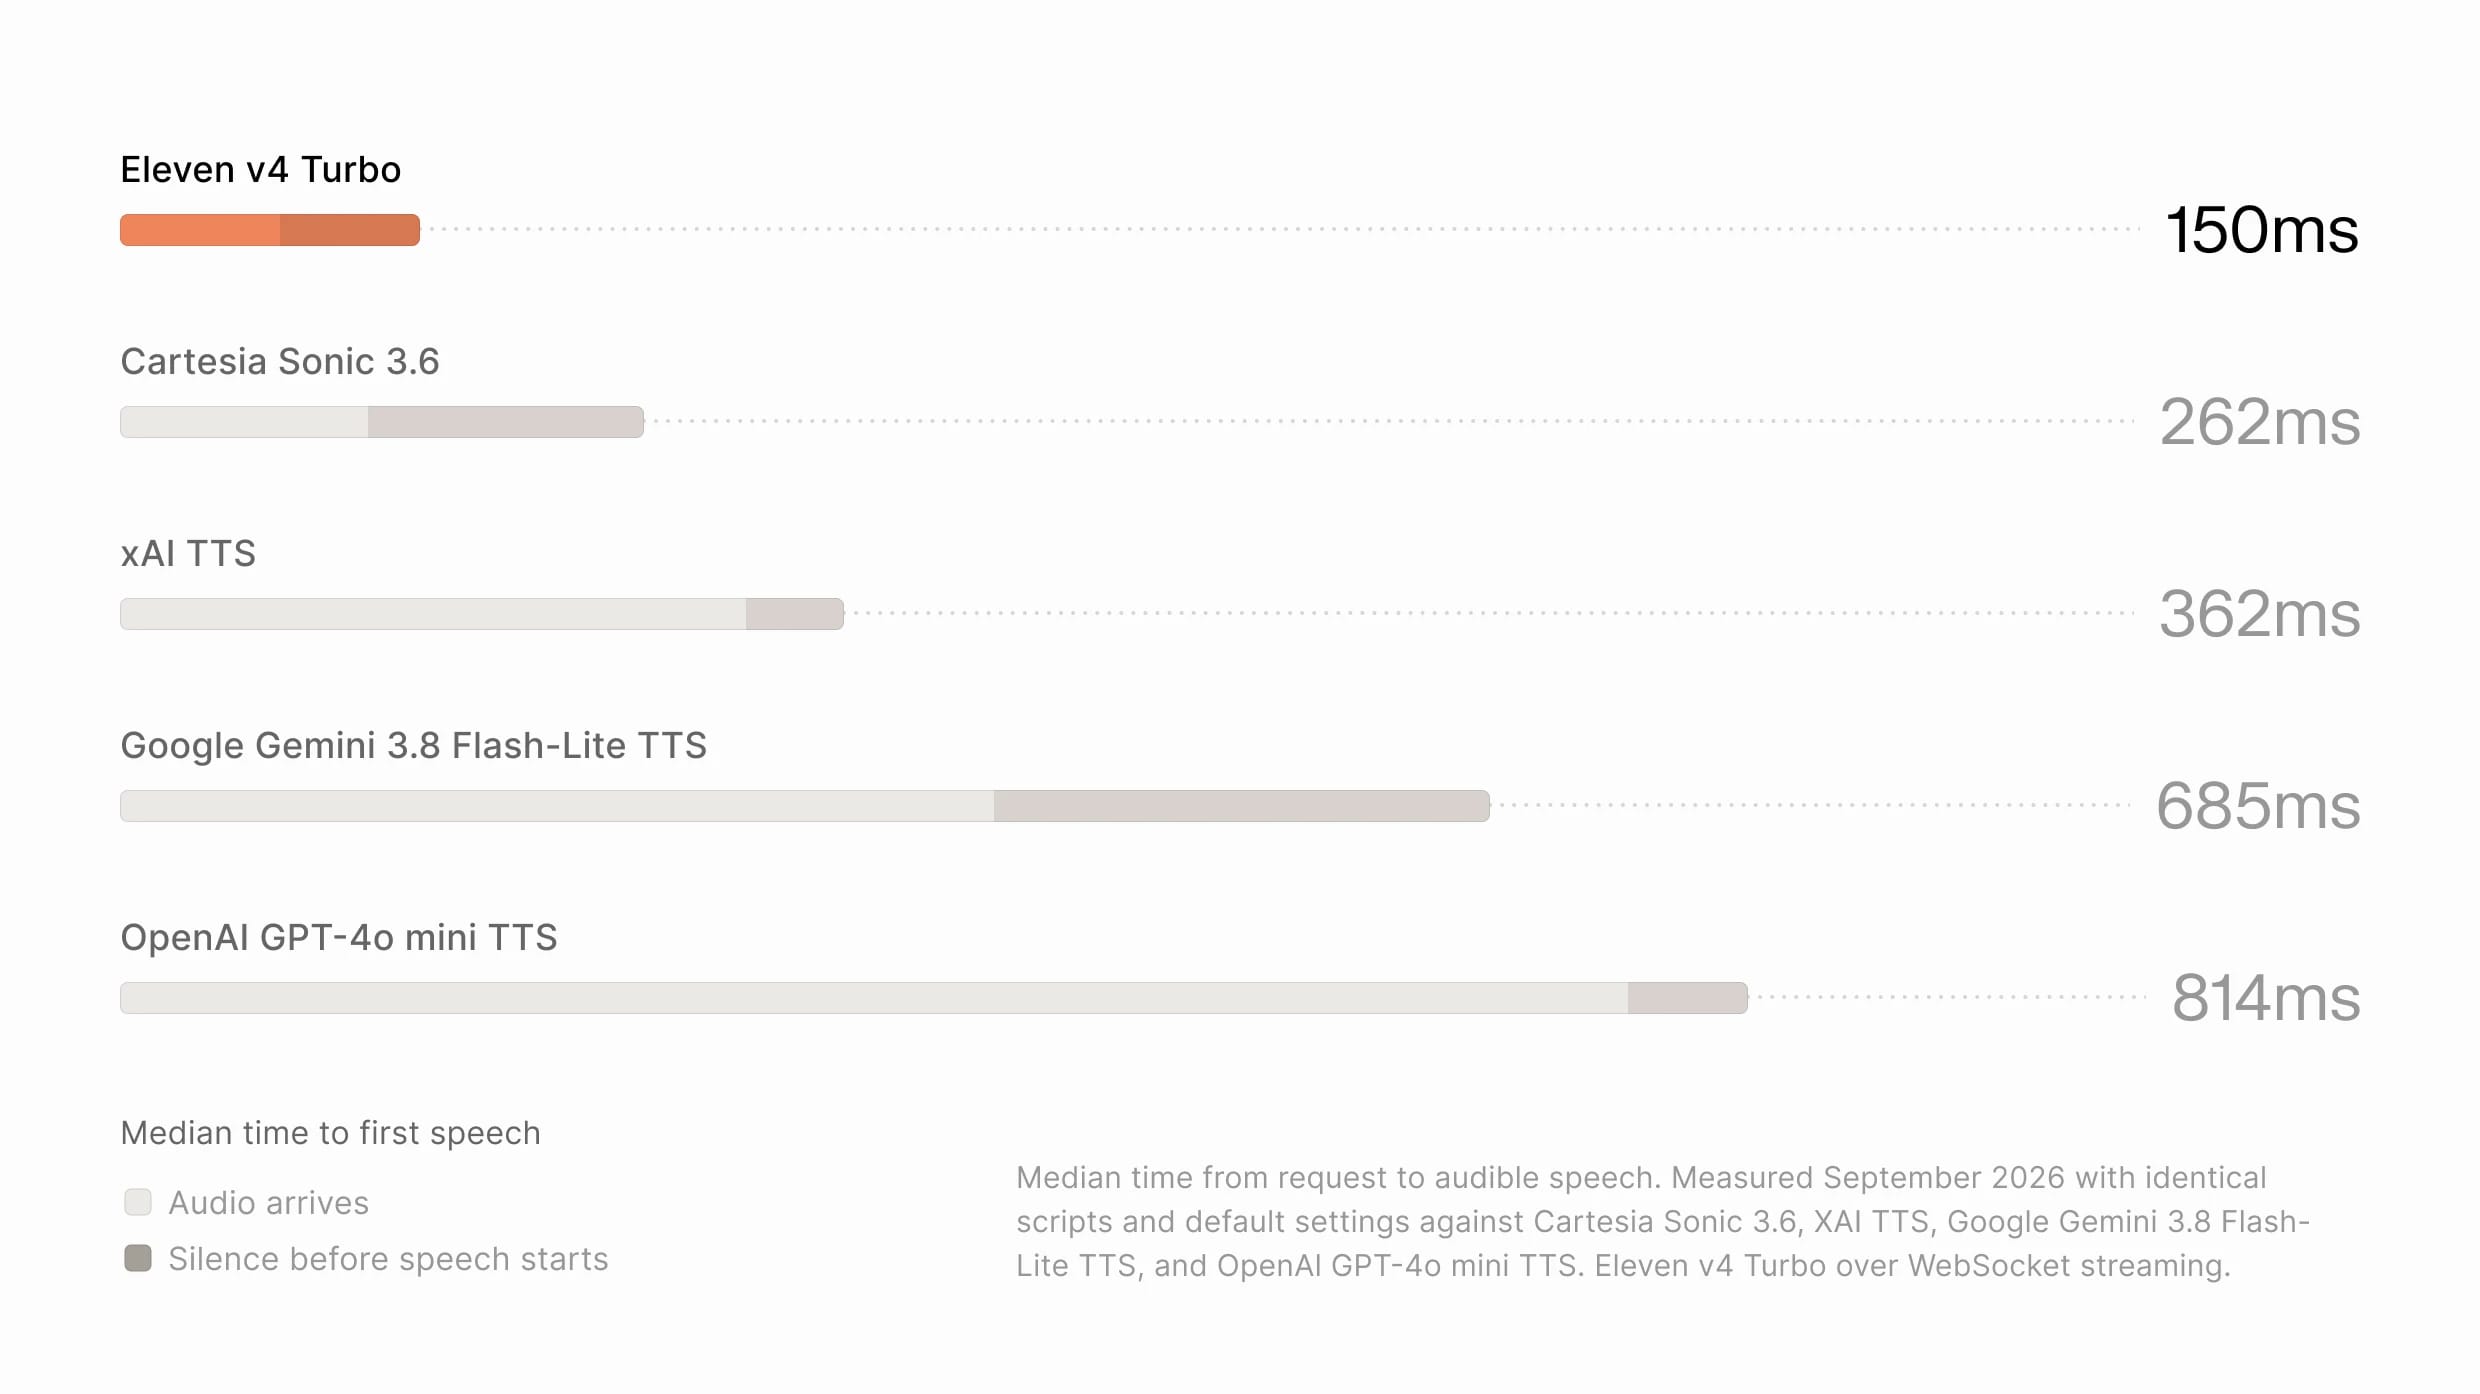
Eleven v4 Turbo kombiniert Geschwindigkeit und Emotion mit einer medianen Zeit bis zur ersten Sprache von rund 150 ms3 und ermöglicht den Einsatz leistungsstarker Agents in unzähligen Branchen: von warmherzigen, beruhigenden Agents im Gesundheitswesen, die medizinische Begriffe korrekt aussprechen, bis zu schnell sprechenden Agents mit Slang, die Spieler im Gaming unterhalten.
Das Modell Eleven v4 Turbo wurde für die Zusammenarbeit mit der Plattform für dialogbasierte Agents von ElevenLabs entwickelt, ElevenAgents. Andere Anbieter für Agents kombinieren Modelle und Software verschiedener Anbieter. Dadurch fehlt Nutzern eine Möglichkeit, die Modellergebnisse für ihre individuellen Anwendungsfälle zu verfeinern oder zu verbessern. Die Forschungs- und Engineering-Teams von ElevenLabs haben Eleven v4 Turbo und ElevenAgents gemeinsam als ein System optimiert. Das liefert ausdrucksstärkere, zuverlässigere Agents mit geringer Latenz.
Eine Stimme, unzählige Sprachen
Wie wir kommunizieren, variiert je nach Kontext, Ort und sogar Tageszeit. Ausdrucksstarke Sprache zu entwickeln, die dies sprachübergreifend widerspiegelt, bleibt eine der schwierigsten Herausforderungen der Audio-KI.
Eleven v4 verbessert sich in all diesen Bereichen. Die Fortschritte gehen weit über die reine Aussprache von Formulierungen hinaus. Eleven v4 erfasst Rhythmus, Emotion und Darbietung sprachübergreifend besser und hilft Creatorn, Sprache zu erzeugen, die sich für Sprache und Kontext natürlich anfühlt. Beispielsweise würden Sie mit einer älteren fremden Person in Japan ganz anders sprechen als in Italien.
Sowohl Eleven v4 als auch Eleven v4 Turbo unterstützen mehr als 90 Sprachen. Eine in einer Sprache aufgezeichnete Stimme spricht nun auch jede andere Sprache fließend. Sie übernimmt den Akzent eines Muttersprachlers, behält dabei jedoch die Identität des Originals. Diese Akzenttreue ist spürbar stärker als zuvor, sodass die Stimme im Verlauf einer Generierung nicht mehr zu ihrem ursprünglichen Akzent zurückkehrt.
Katalanisch
Spanisch
Für Synchronisation und Lokalisierung bedeutet das: Die Stimme Ihrer Marke – ob ein prominenter Schauspieler, mit dem Sie zusammenarbeiten, oder ein Tonfall, der zum Stil Ihres Unternehmens passt – klingt in jeder von Eleven v4 unterstützten Sprache überzeugend.
Authentischeres, konsistenteres Klonen von Stimmen
Das Klonen von Stimmen ist mit Eleven v4 und Eleven v4 Turbo authentischer, leistungsfähiger und konsistenter. Die Sprecherähnlichkeit mit der ursprünglichen Quellstimme ist deutlich höher. Instant Voice Clones können Stimmen jetzt mit nur 10 Sekunden Audio in hoher Qualität erfassen.
Echte Stimme
Eleven v4
Eleven v4 bewahrt die Sprecheridentität zudem zuverlässiger über Generierungen, Dialoge, Erzählungen und neu generierte Zeilen hinweg. Bei Langformprojekten bleiben Charaktere, Sprecher und geklonte Stimmen dadurch während der gesamten Produktion konsistent. Eleven v4 unterstützt nun auch Professional Voice Clones (PVC) für Anwendungsfälle mit höchsten Anforderungen an die Klonqualität.
Auch Request Stitching – das Verketten von Generierungen für längere Inhalte – ist in Eleven v4 deutlich zuverlässiger. Das verbessert die Arbeit mit ElevenLabs Studio und der ElevenLabs Reader App.
Hören Sie den Unterschied selbst
Eleven v4 und Eleven v4 Turbo vereinen unsere neuesten Forschungsergebnisse zur Erzeugung ausdrucksstarker Sprache. Sie wurden für Inhalte entwickelt, bei denen die Darbietung genauso wichtig ist wie die Worte selbst – ob Hörbücher, Charakterdarstellungen, Voiceovers, Synchronisation oder die Lokalisierung dialogbasierter Agents.
Beide Modelle sind jetzt in ElevenAgents, ElevenCreative und über ElevenAPI verfügbar. Erstellen Sie ein kostenloses Konto und starten Sie noch heute mit der Generierung mit Eleven v4 oder Eleven v4 Turbo.
- Artificial Analysis, Provider Voice Arena Leaderboard, September 2026
- Basierend auf blinden Direktvergleichstests zur Nutzerpräferenz gegen Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS und Google Gemini 3.8 Flash TTS, September 2026. Bei jedem Paar hörten Bewerter dieselbe Zeile von Eleven v4 und einem Wettbewerber, ohne zu wissen, welches Modell sie hörten. Sie beurteilten, welches ausdrucksstärker und welches natürlicher klang; Gleichstände zählten zur Hälfte.
- Mediane Zeit von der Anfrage bis zur hörbaren Sprache. Gemessen im September 2026 mit identischen Skripten und Standardeinstellungen gegen Cartesia Sonic 3.6, xAI TTS, Google Gemini 3.8 Flash-Lite TTS und OpenAI GPT-4o mini TTS; die Netzwerklatenz wurde für alle Systeme gemessen und herausgerechnet. Eleven v4 Turbo über WebSocket-Streaming.