Wie werden synthetische Stimmen für natürliche Sprache erstellt?
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Moderne KI-Modelle erstellen heute synthetische Stimmen, die wie natürliche Sprache klingen. Diese Modelle werden mit riesigen Datensätzen echter menschlicher Stimmen trainiert und nutzen fortschrittliche neuronale Netzwerke, um authentische Sprachmuster zu erkennen und nachzubilden. Die Erstellung einer synthetischen Stimme wird auch Sprachsynthese oder Stimmensynthese genannt. Das erzeugte Audio heißt synthetische Sprache.
Um eine neue synthetische Stimme zu erstellen, nimmt eine Person sich selbst beim Sprechen auf. Das KI-Modell analysiert dabei ihre individuellen phonetischen Muster und ihre Intonation und verwendet diese Daten, um die Stimme nachzubilden. Anschließend kann die Person Stimmmerkmale wie Akzent, Tonfall und Sprechtempo anpassen, um das Endergebnis zu erstellen. Manche synthetischen Stimmen sind eine direkte Kopie der Sprache einer Person, andere kombinieren mehrere Stimmen. Stimmen lassen sich auch aus einer Textbeschreibung erstellen – ganz ohne Aufnahme.
Synthetische Stimmen eröffnen viele kreative Möglichkeiten für Podcasts, Hörbücher, Videospiele und Werbung. In diesem Artikel erfahren Sie, wie synthetische Stimmen erstellt werden, warum sie natürlich klingen und wie Sie mit ElevenLabs Ihre eigene synthetische Stimme erstellen.
Zusammenfassung
- Synthetische Stimmen werden mit neuronalen KI-Modellen erstellt, die menschliche Sprachmuster analysieren und nachbilden.
- Synthetische Stimmen eignen sich für die Vertonung von Hörbüchern, Videospieldialoge, Podcasts und Voiceovers in großem Umfang, KI-Agenten im Kundenservice oder sogar zur Bewahrung gefährdeter Stimmen.
- KI-Stimme klonen funktioniert, indem Aufnahmen einer bestimmten Person analysiert und ihr individueller Akzent sowie ihre Sprachmuster nachgebildet werden.
- Moderne KI-Stimmen klingen natürlich, weil sie menschliche Prosodie nachbilden und den Kontext berücksichtigen, statt nur einzelne Wörter oder Silben zu reproduzieren.
So werden synthetische Stimmen Schritt für Schritt erstellt
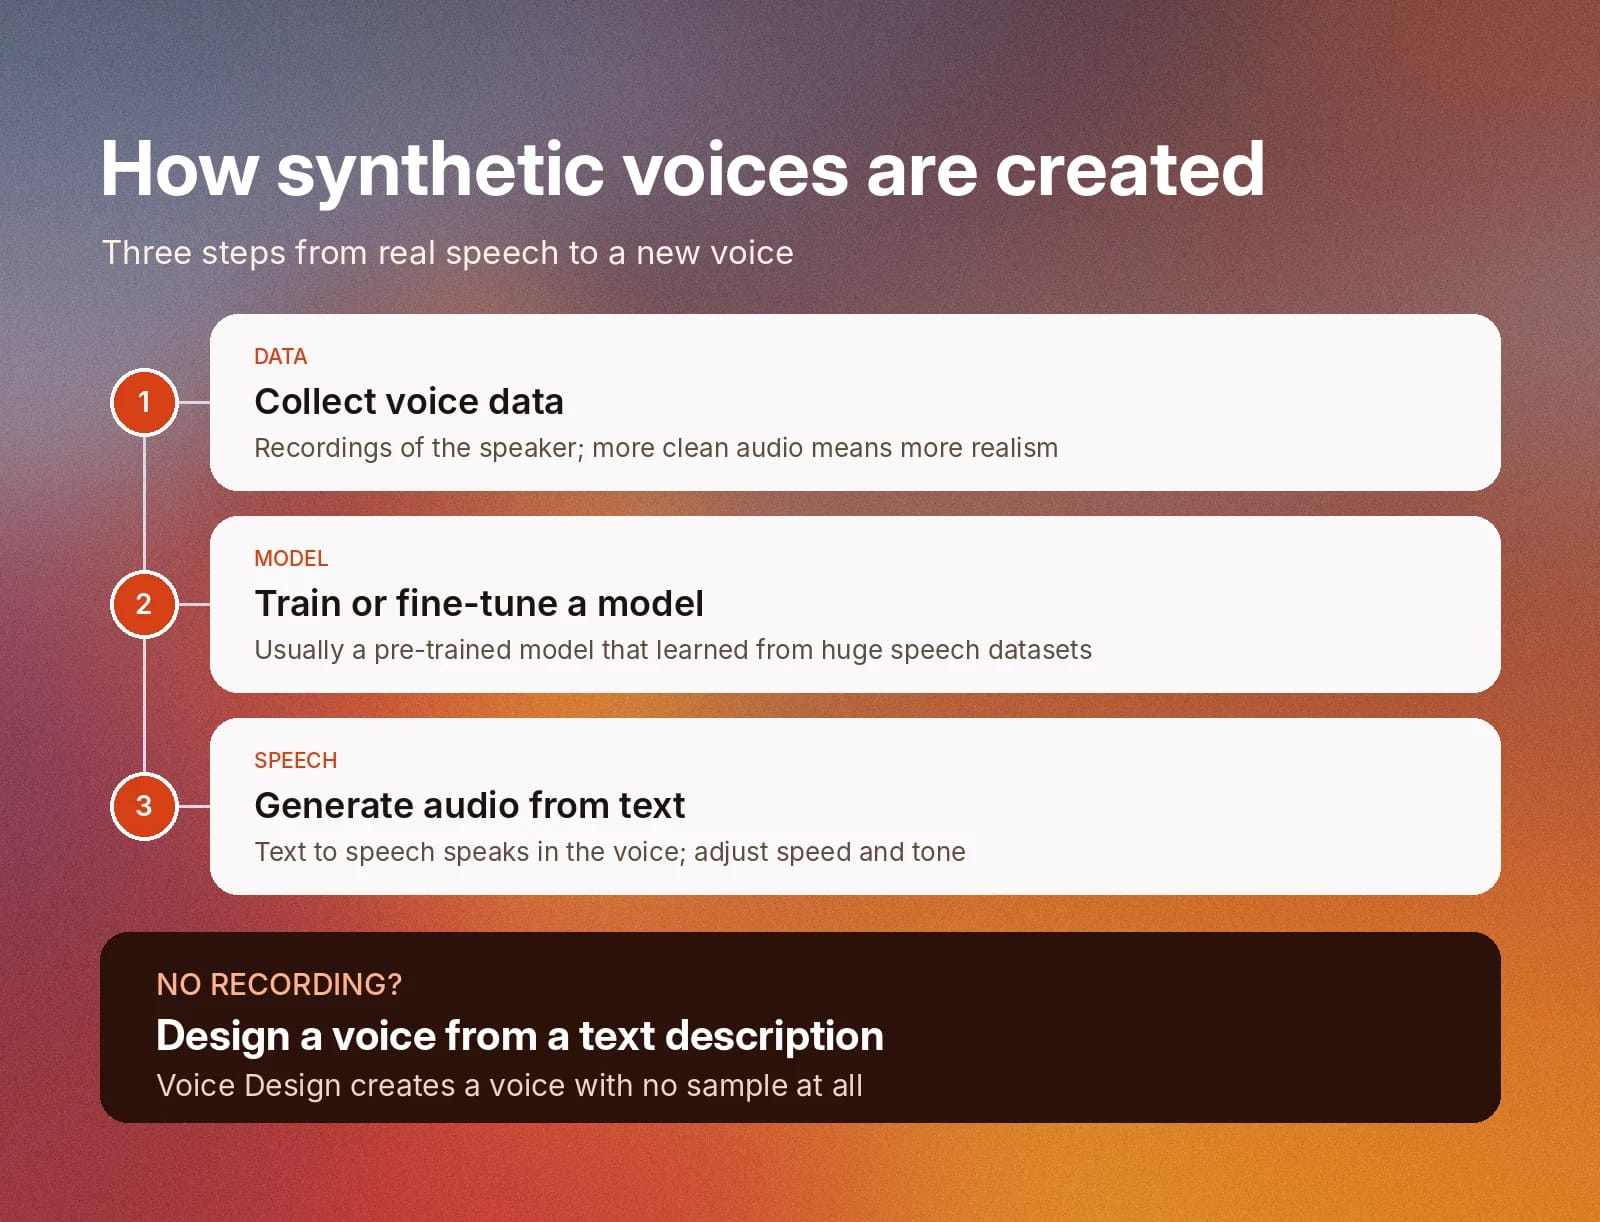
Die Erstellung einer synthetischen Stimme erfolgt in drei Schritten.
So sieht das in der Praxis aus:
- Schritt 1: Sprachdaten erfassen: Synthetische Stimmen beginnen mit echter menschlicher Sprache. Um eine neue Stimme zu erstellen, benötigen Sie Audioaufnahmen der Personen, deren Stimmen Sie nachbilden möchten. Je mehr Daten Sie bereitstellen, desto präziser und realistischer wird die fertige Stimme. Hier finden Sie einige Best Practices für das Klonen von Stimmen.
- Schritt 2: Ein KI-Modell trainieren oder finetunen: Um synthetische Stimmen zu erstellen, analysieren KI-Modelle zunächst umfangreiche Datensätze mit vielfältigen Sprachaufnahmen. Die Modelle nutzen diese Daten, um menschliche Sprachmuster zu verstehen. Nach dem Training kann ein KI-Modell reale Stimmen anhand einer einzigen Sprachaufnahme klonen. Meist verwenden Sie ein vortrainiertes Modell, statt ein eigenes von Grund auf zu entwickeln.
- Schritt 3: Audio aus Text erzeugen: Synthetische Stimmen nutzen Text to Speech, um Audio zu erzeugen. Sie können Faktoren wie Geschwindigkeit und Tonfall an Ihre Vorlieben anpassen. Mehr dazu erfahren Sie in unserem Leitfaden dazu, wie Text-to-Speech-Technologie funktioniert.
Von Sprachdaten zu neuronalem Text to Speech
Neuronale Text-to-Speech-Modelle werden mit zahlreichen Datensätzen echter Sprachaufnahmen trainiert. Diese Datensätze enthalten Aufnahmen in verschiedenen Sprachen, mit unterschiedlichen Akzenten, Emotionen und Tonhöhen. Neuronales Text to Speech ist heute eine weit verbreitete Form der Sprachsynthese.
Traditionelle Modelle fügten vorhandene Aufnahmen von Wörtern, Silben und Phonemen zusammen. Die Ergebnisse klangen sehr robotisch, da sie die Variationen in Tonhöhe, Rhythmus und Ausdruck nicht nachbilden konnten, die Sprache menschlich klingen lassen.
Moderne neuronale Text-to-Speech-Modelle lernen nicht nur, wie Buchstaben und Silben klingen, sondern auch natürliche menschliche Aussprachemuster und Sprachrhythmen. Bei der Umwandlung von Text in Sprache analysieren diese Modelle den Text, wandeln ihn in akustische Merkmale um und erzeugen daraus Wellenformen.
Da akustische Merkmale wie Tonhöhe, Rhythmus und Tonfall in neuronale KI-Modelle integriert sind, klingt die erzeugte Sprache deutlich natürlicher und authentischer als bei früheren Modellen.
Die Ergebnisse lassen sich auch anpassen: Sie können Faktoren wie Geschwindigkeit, Emotion und sogar Akzent ändern, um genau die gewünschte Stimme zu erhalten. Ihre Marke könnte beispielsweise auf der gesamten Website dieselbe synthetische Stimme verwenden, für Marketinginhalte aber Begeisterung und Dringlichkeit sowie für Kundenservice-Interaktionen Ruhe einsetzen.
Standard-, neuronales und generatives Text to Speech
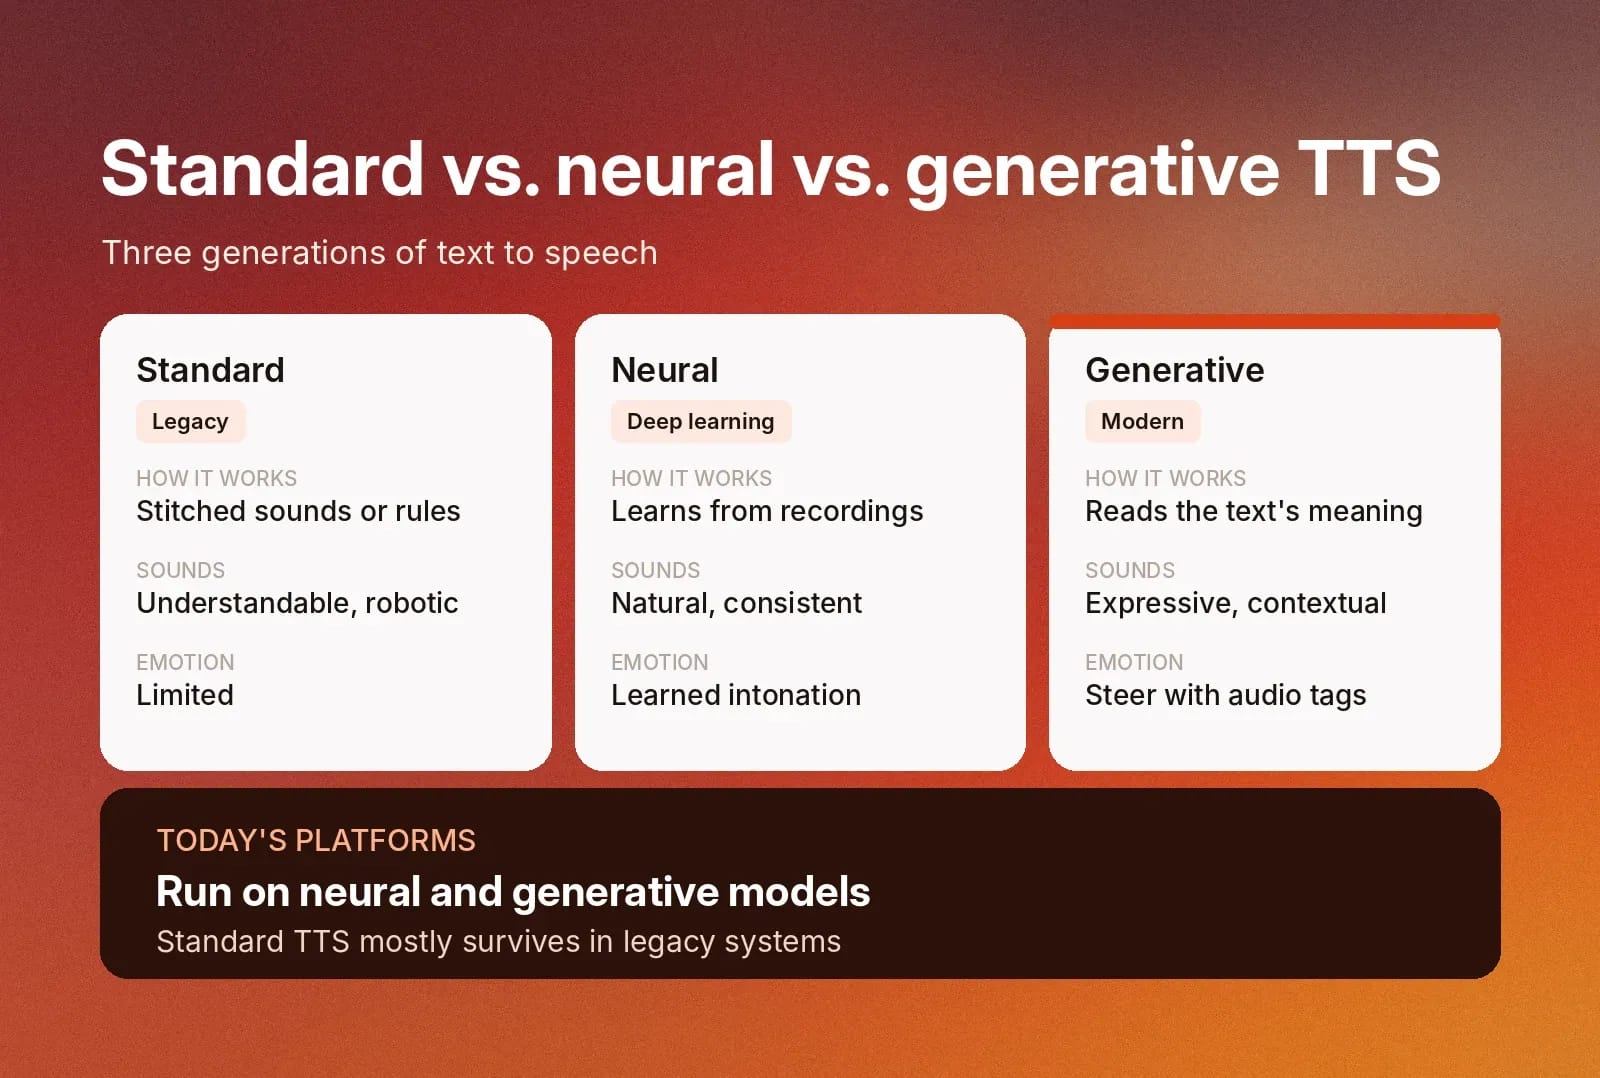
Text-to-Speech-Modelle lassen sich grob in drei Generationen einteilen.
Wenn Sie die Unterschiede verstehen, wird deutlich, warum moderne Modelle wie ElevenLabs Text to Speech so natürlich klingen können.
- Standard-Text-to-Speech: Diese Systeme setzen voraufgezeichnete Laute zusammen oder folgen Regeln und statistischen Modellen, um Text auszusprechen. Die Ausgabe ist verständlich, aber robotisch und wenig emotional.
- Neuronales Text to Speech: Deep-Learning-Modelle lernen Aussprache, Rhythmus und Intonation aus großen Mengen an Aufnahmen und erzeugen Sprache, die deutlich natürlicher und konsistenter klingt.
- Generatives Text to Speech: Generative Modelle werden mit noch größeren und vielfältigeren Sprachdaten trainiert. Sie nutzen die Bedeutung des Textes, um Emotion, Sprechtempo und Betonung festzulegen. Ihre Sprechweise lässt sich mit Anweisungen wie Audio-Tags steuern.
Moderne Stimmplattformen setzen auf neuronale und generative Modelle, während Standard-Text-to-Speech hauptsächlich in Altsystemen weiterverwendet wird.
Warum klingt die KI-Stimmgenerierung natürlich?
KI-generierte synthetische Stimmen klingen menschlichen Stimmen sehr ähnlich. Tatsächlich kann es schwer sein, den Unterschied zu erkennen, wenn Sie nicht genau hinhören.
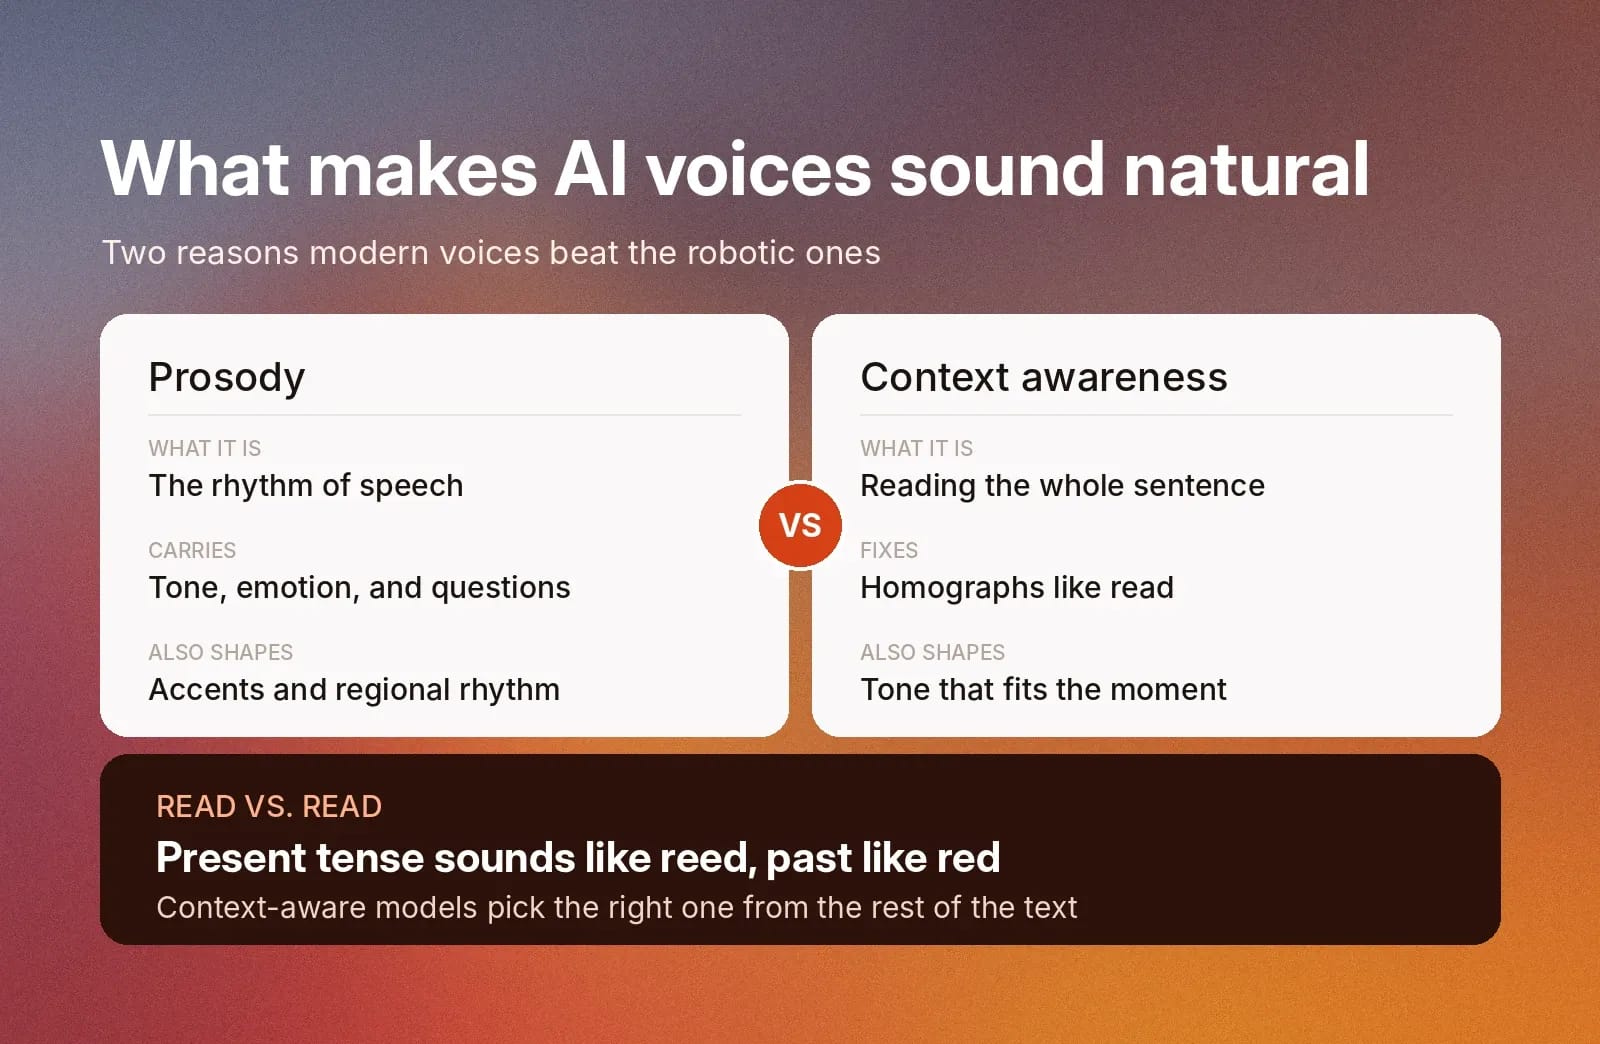
Es gibt zwei Gründe, warum KI-generierte Stimmen natürlicher klingen als die robotischen Stimmen der Vergangenheit: Prosodie und Kontextverständnis.
Prosodie
Prosodie ist der Rhythmus natürlicher menschlicher Sprache. Kleine Änderungen bei Intonation und Geschwindigkeit vermitteln beim Sprechen Tonfall und Emotionen. Schnelles Sprechen kann beispielsweise Stress oder Begeisterung ausdrücken, während eine höhere Tonlage am Satzende aus einer Aussage eine Frage macht.
Heutige KI-Stimmmodelle sind darauf trainiert, Prosodie zu verstehen und nachzubilden. Dadurch folgt die Ausgabe dem natürlichen Fluss menschlicher Gespräche, statt steif oder monoton zu klingen.
Wenn Sie eine synthetische Stimme für ein Hörbuch oder Videospieldialoge verwenden, nutzt sie Prosodie, um die Emotionen der Figur auszudrücken. Erstellen Sie ein Voiceover für Bildungsinhalte oder einen KI-Agenten für den Kundenservice, passt das KI-Modell die Prosodie für eine ruhige, einfühlsame Sprechweise an.
Durch das Verständnis von Prosodie können KI-Modelle auch individuelle Akzente nachbilden. Der Rhythmus eines nordamerikanischen englischen Akzents klingt beispielsweise ganz anders als ein britischer, schottischer oder irischer englischer Akzent, obwohl dieselbe Sprache gesprochen wird.
Kontextverständnis
KI-gestützte TTS-Modelle verarbeiten nicht jedes Wort einzeln, sondern bewerten die gesamte Wortgruppe, den Satz oder das Gespräch und passen die Sprechweise an den Kontext an.
Viele Wörter werden beispielsweise gleich geschrieben, aber je nach Zeitform und Kontext unterschiedlich ausgesprochen. Im Englischen wird „read“ in der Gegenwart wie „reed“ und in der Vergangenheit wie „red“ ausgesprochen.
Da KI-Stimmen den Kontext berücksichtigen, erkennen sie anhand des übrigen Textes die passende Aussprache. Sie passen auch ihre Sprechweise an, damit Tonfall und Emotion zur Situation passen.
Wie funktioniert KI-Stimme klonen?
Beim Klonen von Stimmen bewertet KI die Stimme einer realen Person und überträgt deren Stimmmerkmale auf synthetische Sprache.
Zunächst muss die Person, die ihre Stimme klont, eine kurze Audioprobe bereitstellen. Das KI-Modell nutzt diese Probe, um Akzent, Tonhöhe, Tonfall und Sprechtempo der Person zu erkennen. Mit diesen Merkmalen erstellt das Modell eine digitale Nachbildung der Stimme. Nutzende können mit Text-to-Speech-Technologie neue Sprache in dieser Stimme erzeugen.
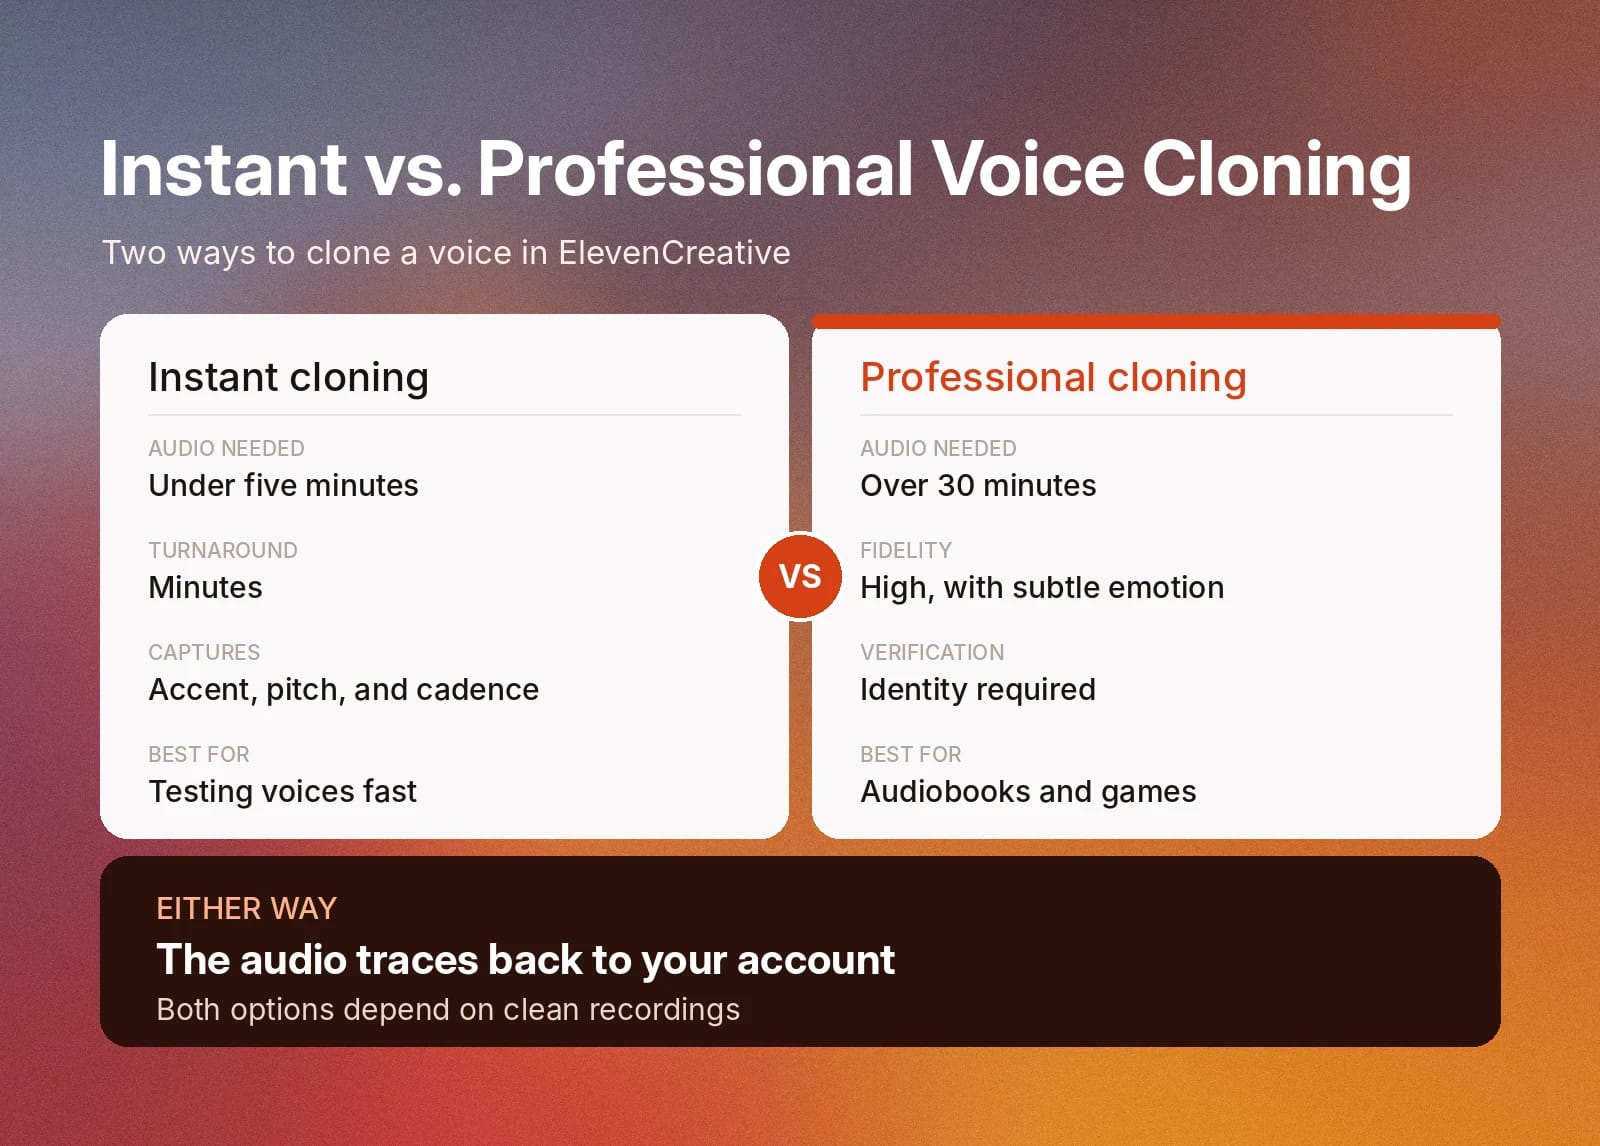
Es gibt zwei Arten des Klonens von Stimmen: Instant und Professional. Instant Cloning erstellt mit weniger als zwei Minuten Beispielaudio eine Stimmreplik. So können Sie Stimmoptionen einfach testen, bevor Sie sich auf ein größeres Projekt festlegen.
Professional Cloning verwendet zwischen 30 Minuten und drei Stunden Audiomaterial, um einen hochauflösenden Voice Clone zu erstellen. Professional Voice Clones bewahren feine Details wie Emotionen und Intonation, die bei Instant Clones nicht vorhanden sind. Außerdem ist eine Identitätsprüfung erforderlich.
Das Klonen von Stimmen bietet viele Einsatzmöglichkeiten – von der schnellen Erstellung von Voiceovers bis zur Bewahrung von Stimmen, die sonst verloren gehen könnten.
So nehmen Sie gute Sprachproben für die Sprachsynthese auf
Die Qualität eines Voice Clones hängt von der Qualität der Aufnahme ab. Auch ohne teure Aufnahmetechnik können Sie viele kleine Maßnahmen ergreifen, um den Klang Ihres Voice Clones zu verbessern.
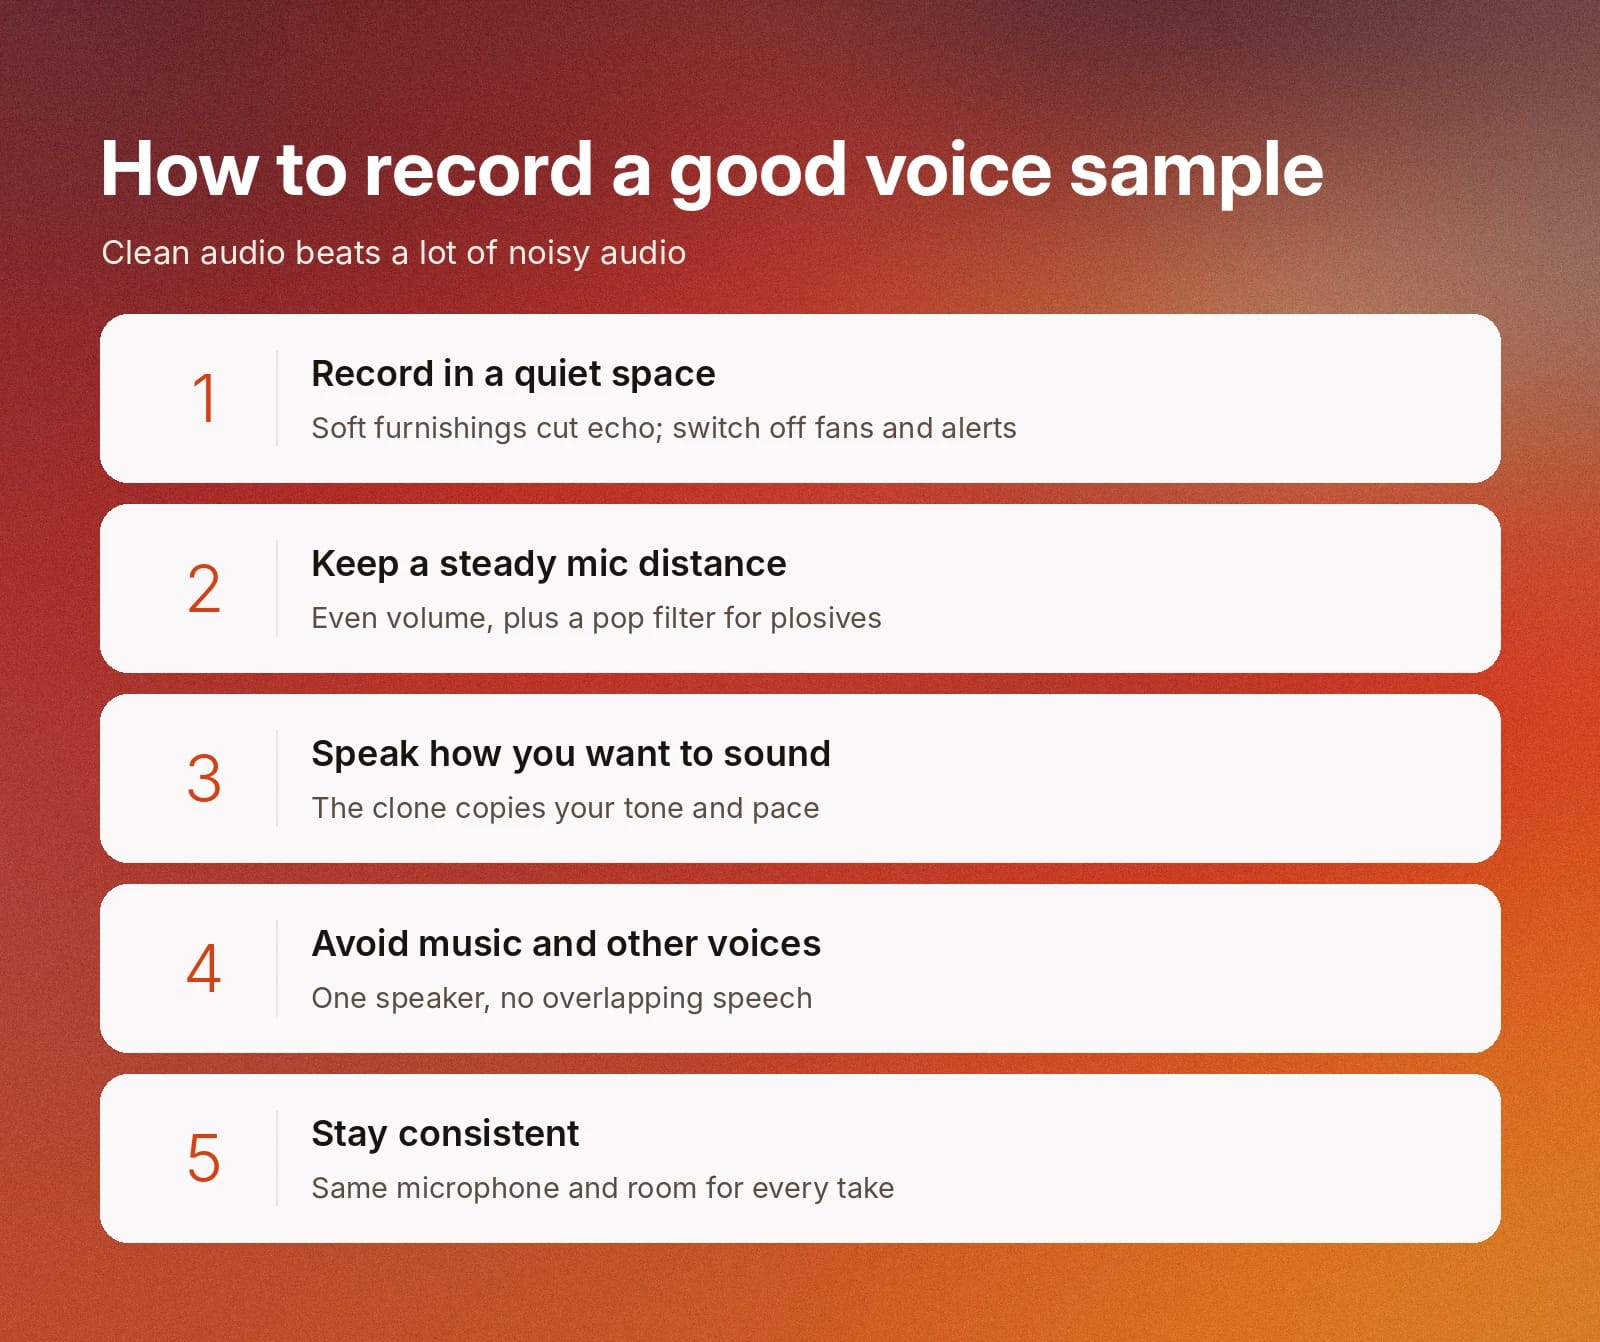
Mit diesen Gewohnheiten nehmen Sie saubere Proben auf:
- In einem ruhigen Raum aufnehmen: Weiche Einrichtungsgegenstände wie Vorhänge und Teppiche reduzieren Hall. Wenn Sie Ventilatoren und Benachrichtigungen ausschalten, entfernen Sie Hintergrundgeräusche.
- Das Mikrofon in gleichbleibendem Abstand halten: Ein konstanter Abstand sorgt für eine gleichmäßige Lautstärke, und ein Popschutz reduziert harte Plosivlaute.
- So sprechen, wie der Clone klingen soll: Der Clone kopiert Ihre Sprechweise. Nehmen Sie im Tonfall und Tempo auf, die Sie verwenden möchten.
- Musik und andere Stimmen vermeiden: Nutzen Sie eine einzelne sprechende Person ohne Hintergrundmusik oder überlappende Sprache.
- Konsistent bleiben: Verwenden Sie für alle Aufnahmen dasselbe Mikrofon und denselben Raum.
Instant Cloning benötigt weniger Audio und Professional Cloning mehr, doch beide sind auf saubere Aufnahmen angewiesen. Sauberes Audio in der richtigen Länge liefert bessere Ergebnisse als eine große Menge verrauschtes Material.
So erstellen Sie eine Stimme ohne Aufnahme: Voice Design
Nicht jede synthetische Stimme beginnt mit einer Aufnahme. Mit Voice Design beschreiben Sie die gewünschte Stimme per Text – einschließlich Details wie Alter, Geschlecht, Akzent, Tonfall und Sprechtempo. Das KI-Modell generiert dann Stimmoptionen, die zu Ihrer Beschreibung passen. Sie können sich die Optionen anhören, die gewünschte auswählen und in Ihrer Stimmbibliothek speichern.
Voice Design ist nützlich, wenn Sie eine Stimme für eine Figur, eine Marke oder ein Produkt benötigen und es keine reale Person zum Klonen gibt. In der Voice-Design-Dokumentation erfahren Sie, wie Sie wirksame Stimmbeschreibungen schreiben.
So erkennen Sie, ob eine Stimme KI-generiert ist
Es gibt kein einzelnes eindeutiges Merkmal, das beweist, dass eine Stimme KI-generiert ist. Aufmerksames Zuhören, Erkennungstools und die Prüfung der Herkunft des Audios sind zusammen zuverlässiger als jedes dieser Mittel allein.
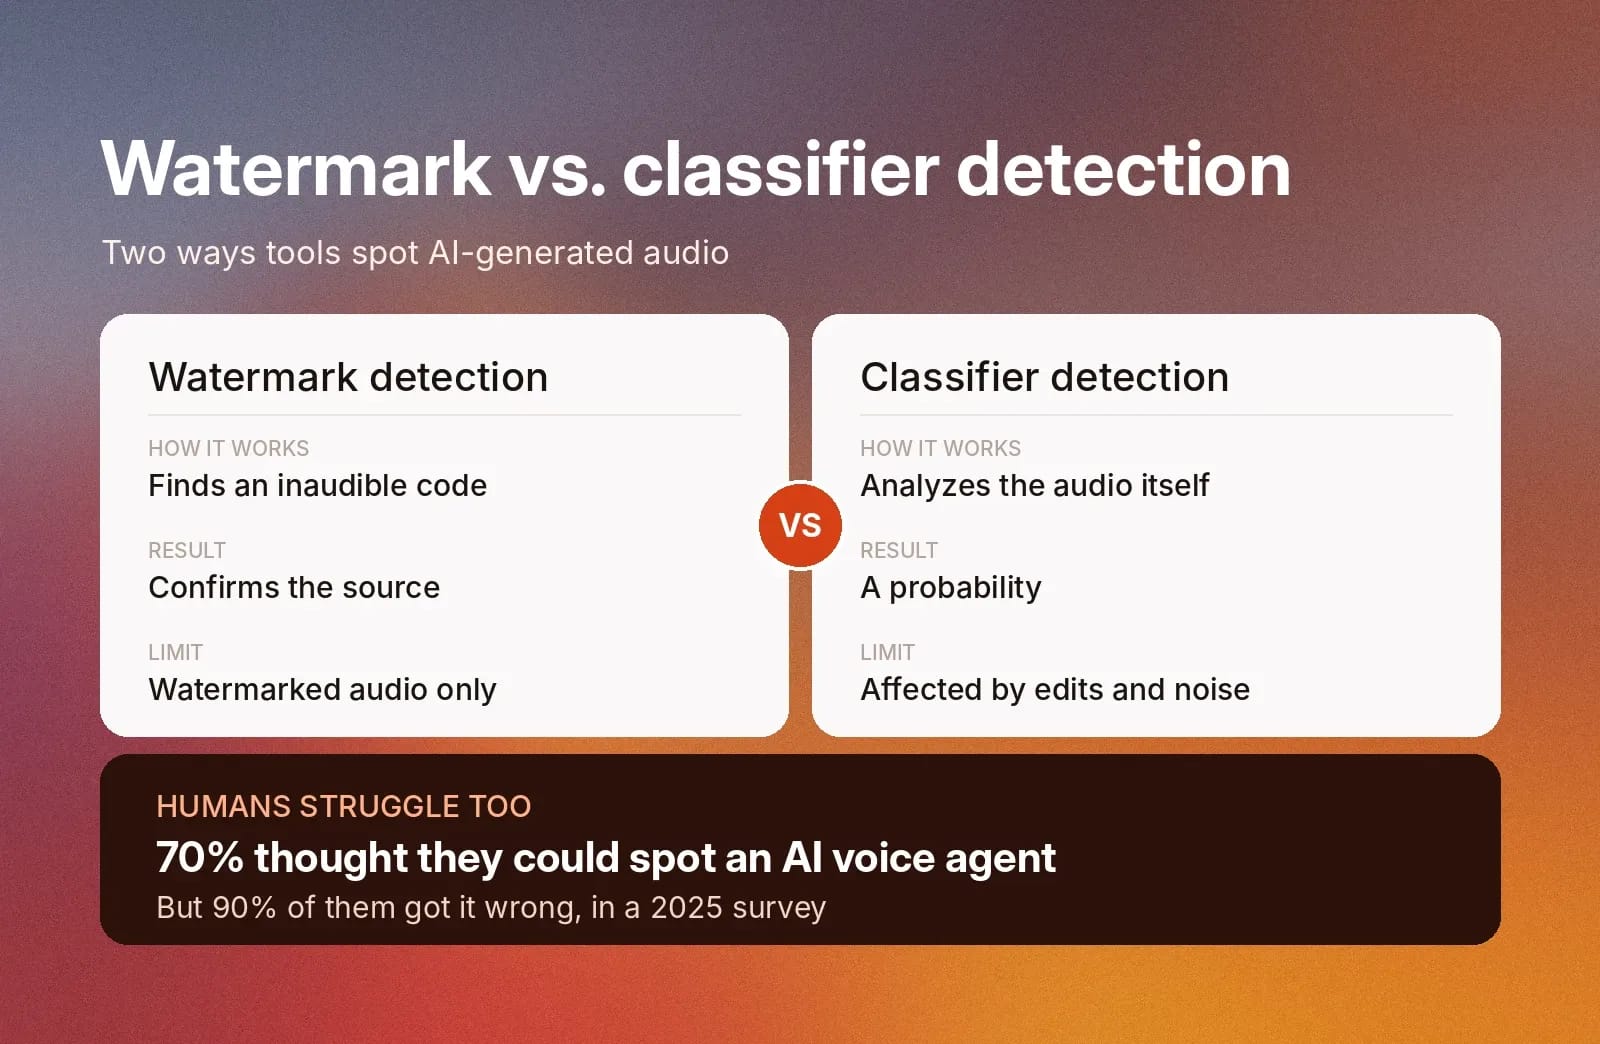
Viele Menschen glauben, den Unterschied zwischen einer echten und einer KI-generierten Stimme zu erkennen, liegen damit aber nicht immer richtig. Eine Umfrage aus dem Jahr 2025 ergab, dass 70 % der Verbrauchenden dachten, sie könnten einen KI-Sprachagenten korrekt erkennen. 90 % von ihnen lagen jedoch falsch.
Statt sich auf das menschliche Gehör zu verlassen, können Sie ein Erkennungstool nutzen. Erkennungstools funktionieren auf zwei grundlegende Arten:
- Watermark-Erkennung: Einige KI-Anbieter betten ein Watermark – einen für Menschen nicht hörbaren Code – in das von ihnen generierte Audio ein. Ein Detektor kann das Watermark finden und bestätigen, woher das Audio stammt. Dies funktioniert nur bei Audio, das ein Watermark enthält.
- Klassifikatorbasierte Erkennung: Ein Klassifikator analysiert das Audio und schätzt die Wahrscheinlichkeit, dass es KI-generiert wurde. Er kann Audio ohne Watermark kennzeichnen, doch das Ergebnis ist nur eine Wahrscheinlichkeit und kann durch Komprimierung, Hintergrundgeräusche oder Bearbeitung beeinflusst werden.
Keine der beiden Methoden ist perfekt. Betrachten Sie ein Erkennungsergebnis als einen Hinweis und prüfen Sie es anhand dessen, was Sie über die Quelle wissen. Wir haben einen Leitfaden zur Erkennung von Audio-Deepfakes verfasst, der näher darauf eingeht.
Der ElevenLabs Speech Classifier ist ein Tool, das die Wahrscheinlichkeit ermittelt, dass eine Audioprobe mit KI-Stimmmodellen von ElevenLabs erzeugt wurde. ElevenLabs arbeitet außerdem mit Reality Defender an Initiativen zur Deepfake-Erkennung, um Stimm-Betrug zu erkennen und zu verhindern.
Worauf Sie achten sollten
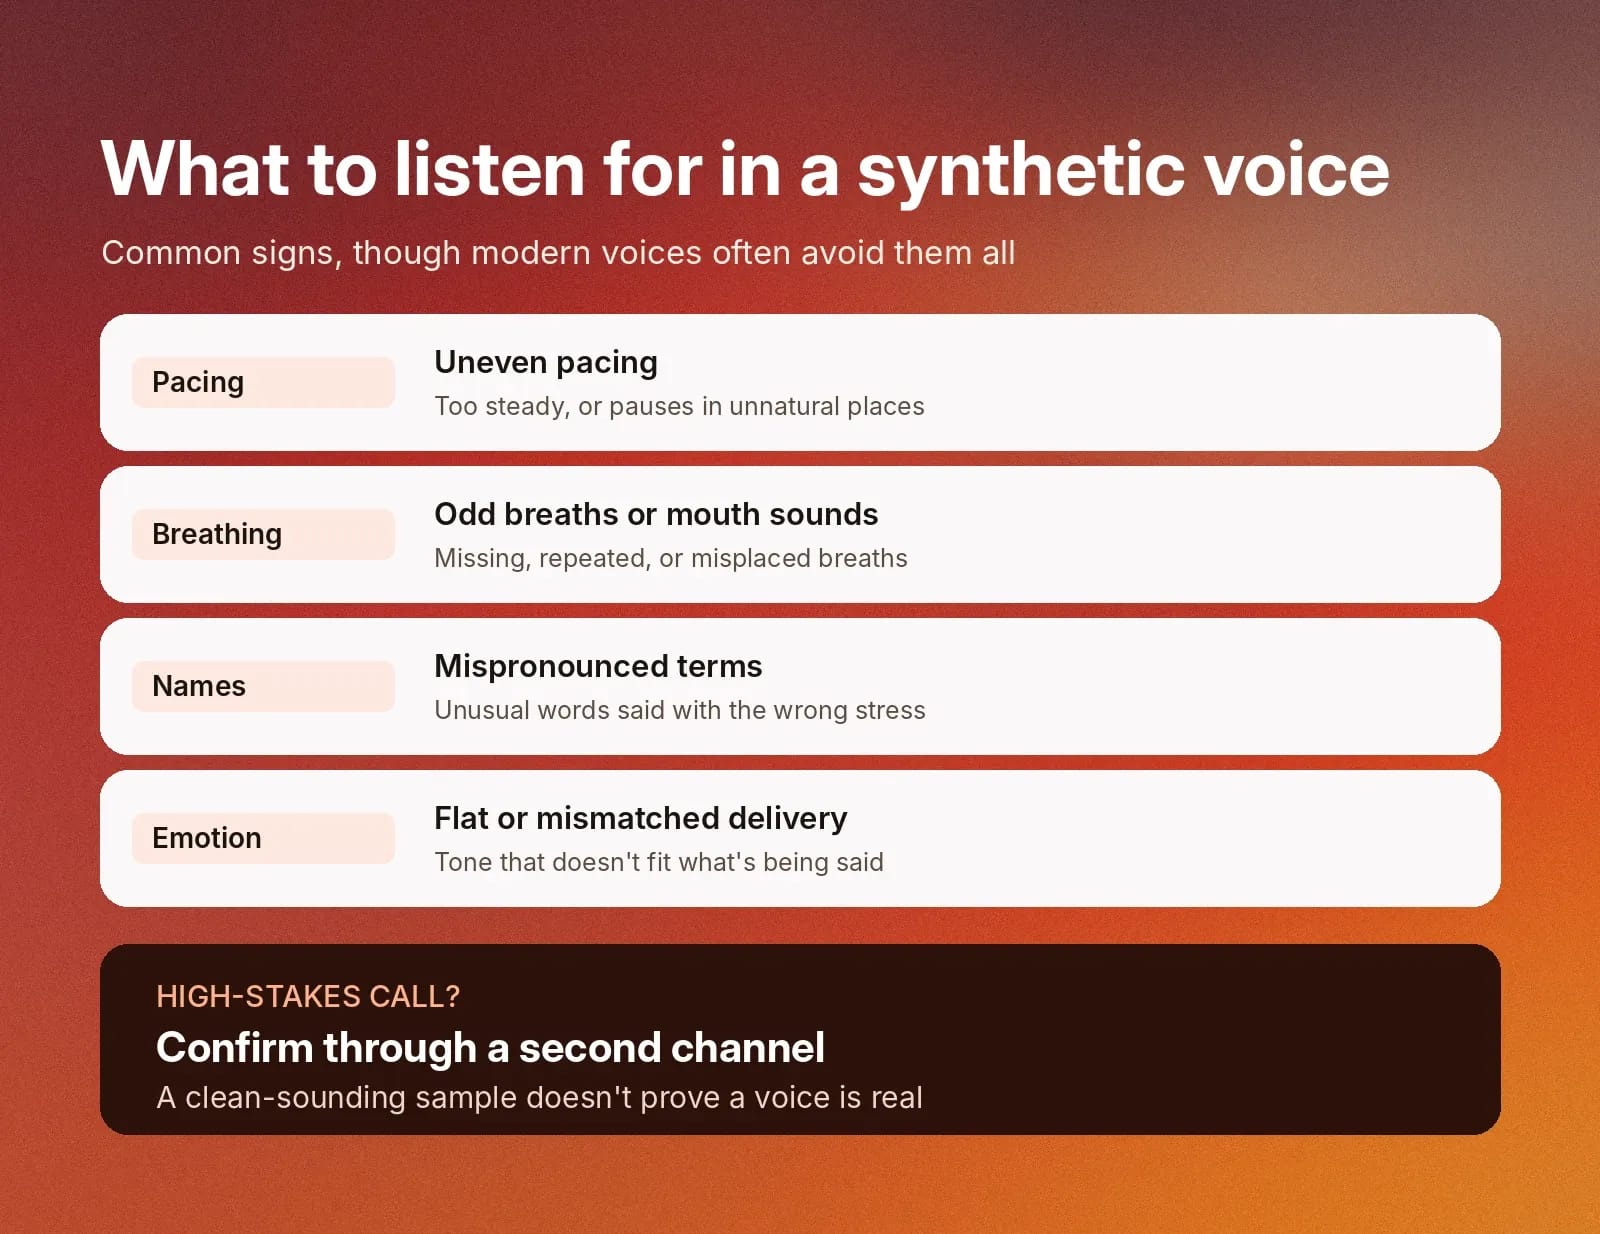
Erkennungstools sind nicht immer verfügbar. Daher hilft es, die häufigen Anzeichen einer synthetischen Stimme zu kennen.
Achten Sie auf:
- Unregelmäßiges Sprechtempo: Sprache, die zu gleichmäßig ist oder an unnatürlichen Stellen pausiert.
- Ungewöhnliche Atem- oder Mundgeräusche: Atemgeräusche, die fehlen, sich wiederholen oder an falscher Stelle auftreten. Sie können auf Audioartefakte hinweisen, die ein Modell unbeabsichtigt erzeugt hat.
- Falsch ausgesprochene Namen oder Begriffe: Ungewöhnliche Wörter mit falscher Betonung. Das kommt besonders häufig in Sprachen vor, die Akzentzeichen zur Betonung bestimmter Silben verwenden, etwa Spanisch.
- Flache oder unpassende Emotionen: Eine Sprechweise, die nicht zur Bedeutung der Wörter passt. Das zeigt mangelndes Verständnis des Textes selbst – ein häufiges Problem bei älteren TTS-Modellen.
Moderne synthetische Stimmen vermeiden oft all diese Merkmale. Eine sauber klingende Probe beweist nicht, dass eine Stimme echt ist. Bei wichtigen Anliegen, etwa einem Anruf mit einer Geldforderung, sollten Sie dies über einen zweiten Kanal bestätigen.
Erstellen Sie individuelle Stimmerlebnisse mit ElevenCreative
ElevenCreative hilft Ihnen, individuelle Stimmerlebnisse für Ihre kreativen Projekte zu erstellen. Wählen Sie aus einer umfangreichen Bibliothek mit mehr als 20.000 vorgefertigten Stimmen oder erstellen Sie mit präzisem und sicherem Klonen Ihre eigene.
Nutzen Sie ElevenCreative, um Ihre Stimme mit Instant Voice Cloning oder Professional Voice Cloning nachzubilden. Instant Voice Cloning funktioniert innerhalb von Minuten, damit Sie Stimmoptionen testen oder persönliche Projekte schnell starten können. Professional Voice Cloning verwendet längere Audioproben, um hochwertige Stimmen zu erstellen, die sich ideal für längere Projekte wie Hörbücher, Videospiele oder Podcasts eignen. Unabhängig von Ihrer Wahl lässt sich das Audio aus Sicherheitsgründen auf Ihr Konto zurückführen.
Die anpassbare Voice Library und die Tools zum Klonen von Stimmen von ElevenCreative helfen Ihnen, Ihre kreativen Projekte umzusetzen. Registrieren Sie sich für ElevenCreative, um ikonische Stimmen zu entdecken oder Ihre eigene zu erstellen.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.