So funktioniert Text to Speech: Von Text zu natürlicher Stimme
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Text-to-Speech-Technologie (TTS) wandelt geschriebene Wörter in gesprochene Audiodateien um. Das System ermittelt zunächst, was der Text sagt und wie er klingen soll. Anschließend erzeugt ein KI-Modell das Audio.
Zunächst normalisiert eine TTS-Engine die Texteingabe und wandelt sie in mathematische Tokens und Vektordarstellungen um, die ein Computersystem verarbeiten kann. Dann verwandelt das Modell diese mathematischen Konstrukte in digitale Klangdarstellungen und schließlich in Audioausgabe.
In diesem Artikel erklären wir, wie verschiedene Text-to-Speech-Tools funktionieren und wie die neueste Generation generativer KI für neuronale Sprachsynthese bisher die natürlichste Sprache erzeugt.
Zusammenfassung
- Text-to-Speech-Systeme wandeln geschriebene Wörter in zwei Schritten in Audio um. Sie konvertieren Text in Tokens oder mathematische Darstellungen von Sprache. Anschließend wandeln sie die Tokens in eine akustische Darstellung um, die als Klang ausgegeben wird.
- Neuere neuronale TTS-Engines nutzen KI-Modelle, um natürlich klingende Sprache zu erzeugen. Unternehmen verwenden sie für die Content-Erstellung, Untertitel und Kundensupport-Agenten.
- Aussprachewörterbücher und phonetische Tags ermöglichen es, die TTS-Ausgabe für einen möglichst natürlichen Klang zu optimieren und Fachbegriffe sowie Namen korrekt auszusprechen.
- Eine Text to Speech API ermöglicht es Ihnen, Geschäftsanwendungen mit hochwertiger Stimmgenerierung zu verbinden.
Was ist TTS? So funktioniert Text-to-Speech-Technologie
Text to Speech analysiert geschriebenen Text, bestimmt, wie jedes Wort klingen soll, und erzeugt dann mithilfe eines neuronalen Modells und eines Vocoders gesprochene Audiodateien.
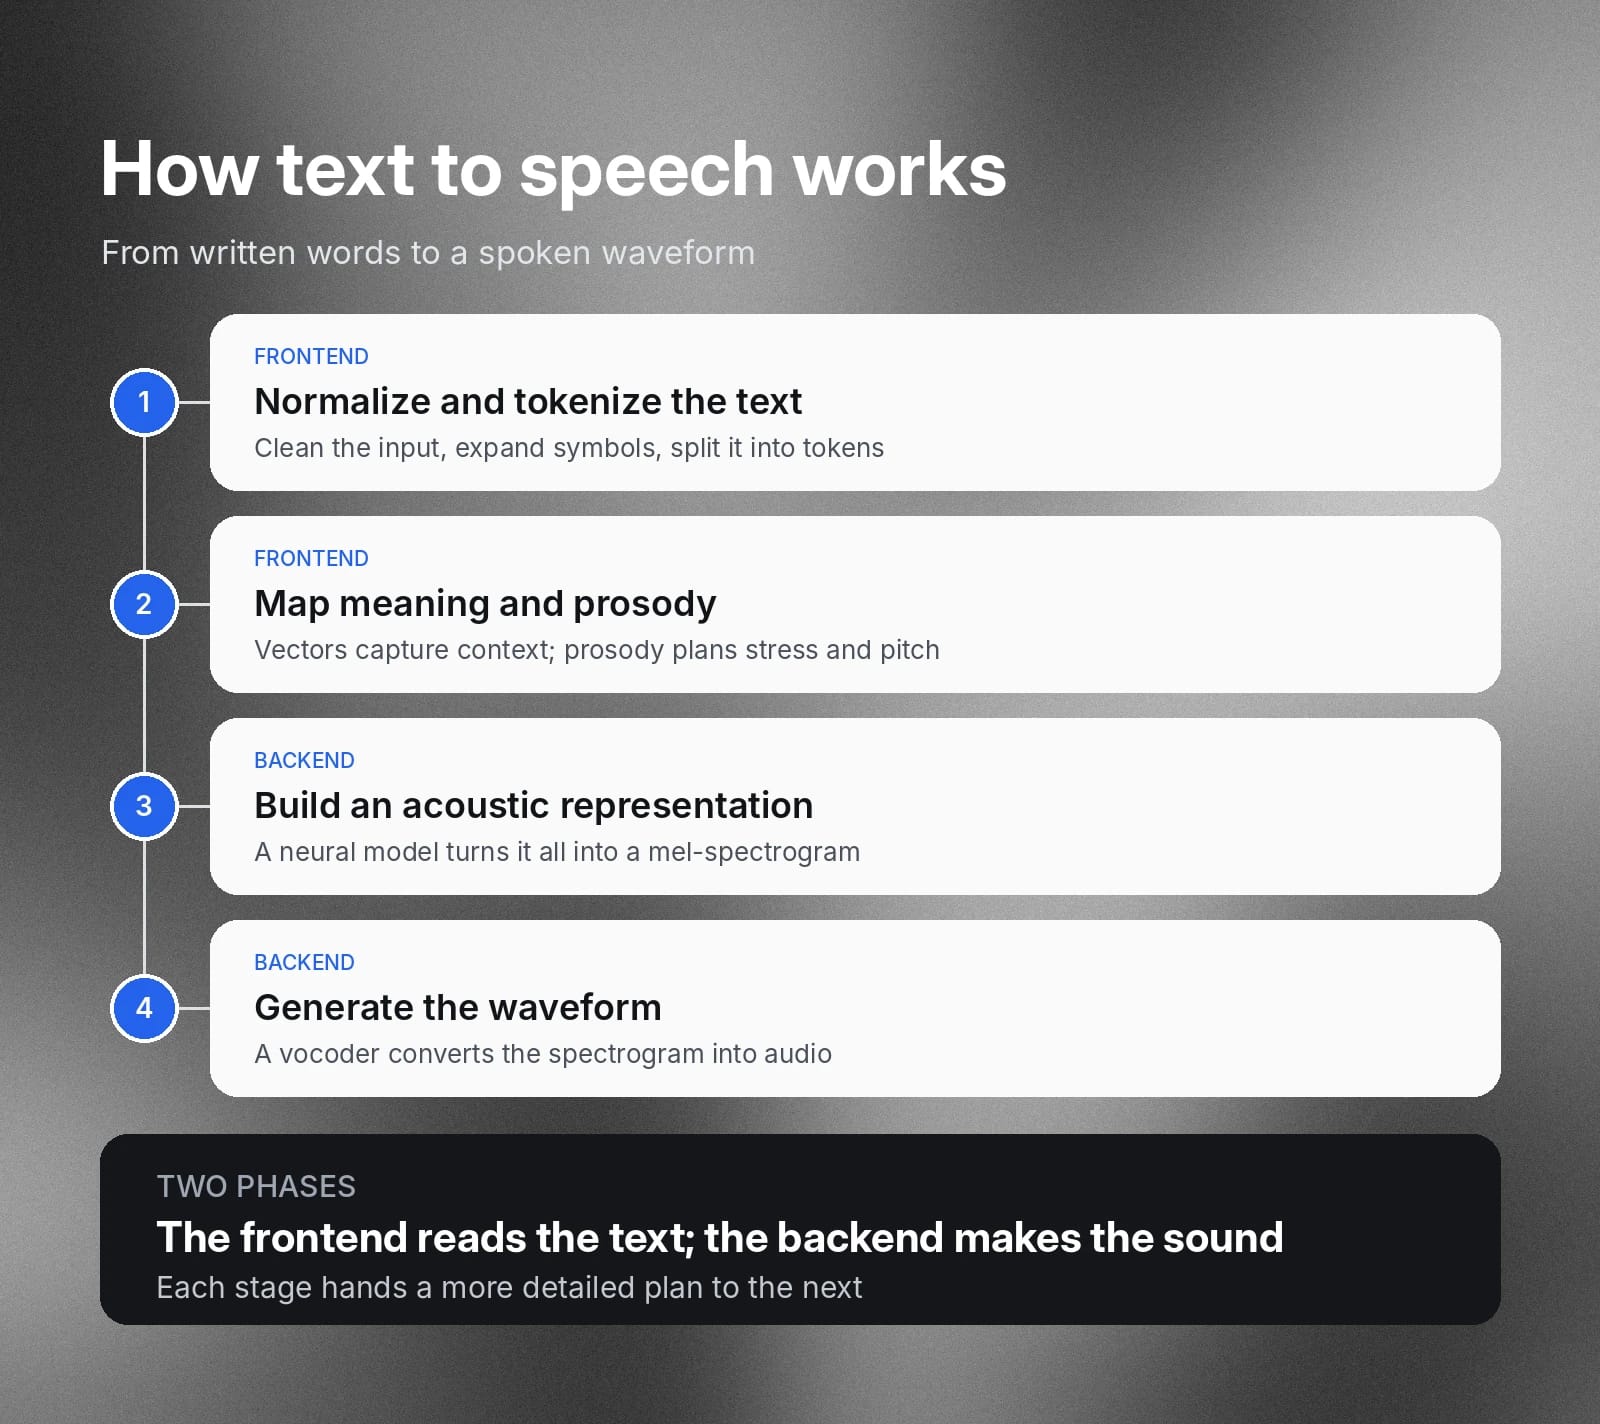
TTS gliedert sich grob in zwei Phasen:
- Frontend: Das System wandelt Text in eine mathematische Form um, mit der die TTS-Engine arbeiten kann.
- Backend: Das System nimmt die Ausgabe der ersten Phase und wandelt sie in Sprachwellenformen um.
Schauen wir uns die Komponenten von TTS genauer an.
Textnormalisierung und linguistische Analyse
Der erste Schritt eines TTS-Prozesses ist die Verarbeitung natürlicher Sprache (NLP): Rohtext wird bereinigt, tokenisiert und disambiguiert. Dabei wird der Text in Tokens zerlegt – einzelne Einheiten geschriebener Sprache, die eine TTS-Engine verarbeiten kann. Ein Token kann ein vollständiges Wort, eine „Subword“-Einheit oder ein Satzzeichen sein.
Text enthält oft neben vollständigen Wörtern auch Symbole wie Abkürzungen und Zahlen. Eine TTS-Engine muss auch bestimmen, wie diese Elemente ausgesprochen werden. Beispielsweise liest sie „$11“ und wandelt den Text in die Laute für „elf Dollar“ um.
Semantische Bedeutung und Prosodie
Prosodie bezeichnet Tonhöhe und Rhythmus der Sprache – das, was TTS natürlich klingen lässt. Während der Textverarbeitung erzeugt die Engine zudem eine Ebene prosodischer Informationen, die Veränderungen bei Betonung und Intonation auf den Text überträgt.
Eine TTS-Engine muss ihre Text-to-Speech-Aussprache zudem an den Kontext anpassen. Sie fasst diese Informationen als Vektordarstellungen zusammen: numerische Daten, die die semantische Ähnlichkeit zwischen Wörtern und Phrasen abbilden. Stellen Sie sich ein X-Y-Diagramm vor, in dem eine Linie über verschiedene Punkte verläuft – allerdings in weit mehr als zwei Dimensionen.
Ein konkretes Beispiel sind Homographen. Homographen sind unterschiedliche Wörter mit gleicher Schreibweise, die manchmal verschieden ausgesprochen werden müssen. Die TTS-Engine muss erkennen, welche Intonation und Betonung sie jeweils beim Sprechen verwenden soll. Zum Beispiel, wie das Graphem „desert“ im Satz „The soldier wanted to desert his unit by hiding in the desert.“ ausgesprochen wird.
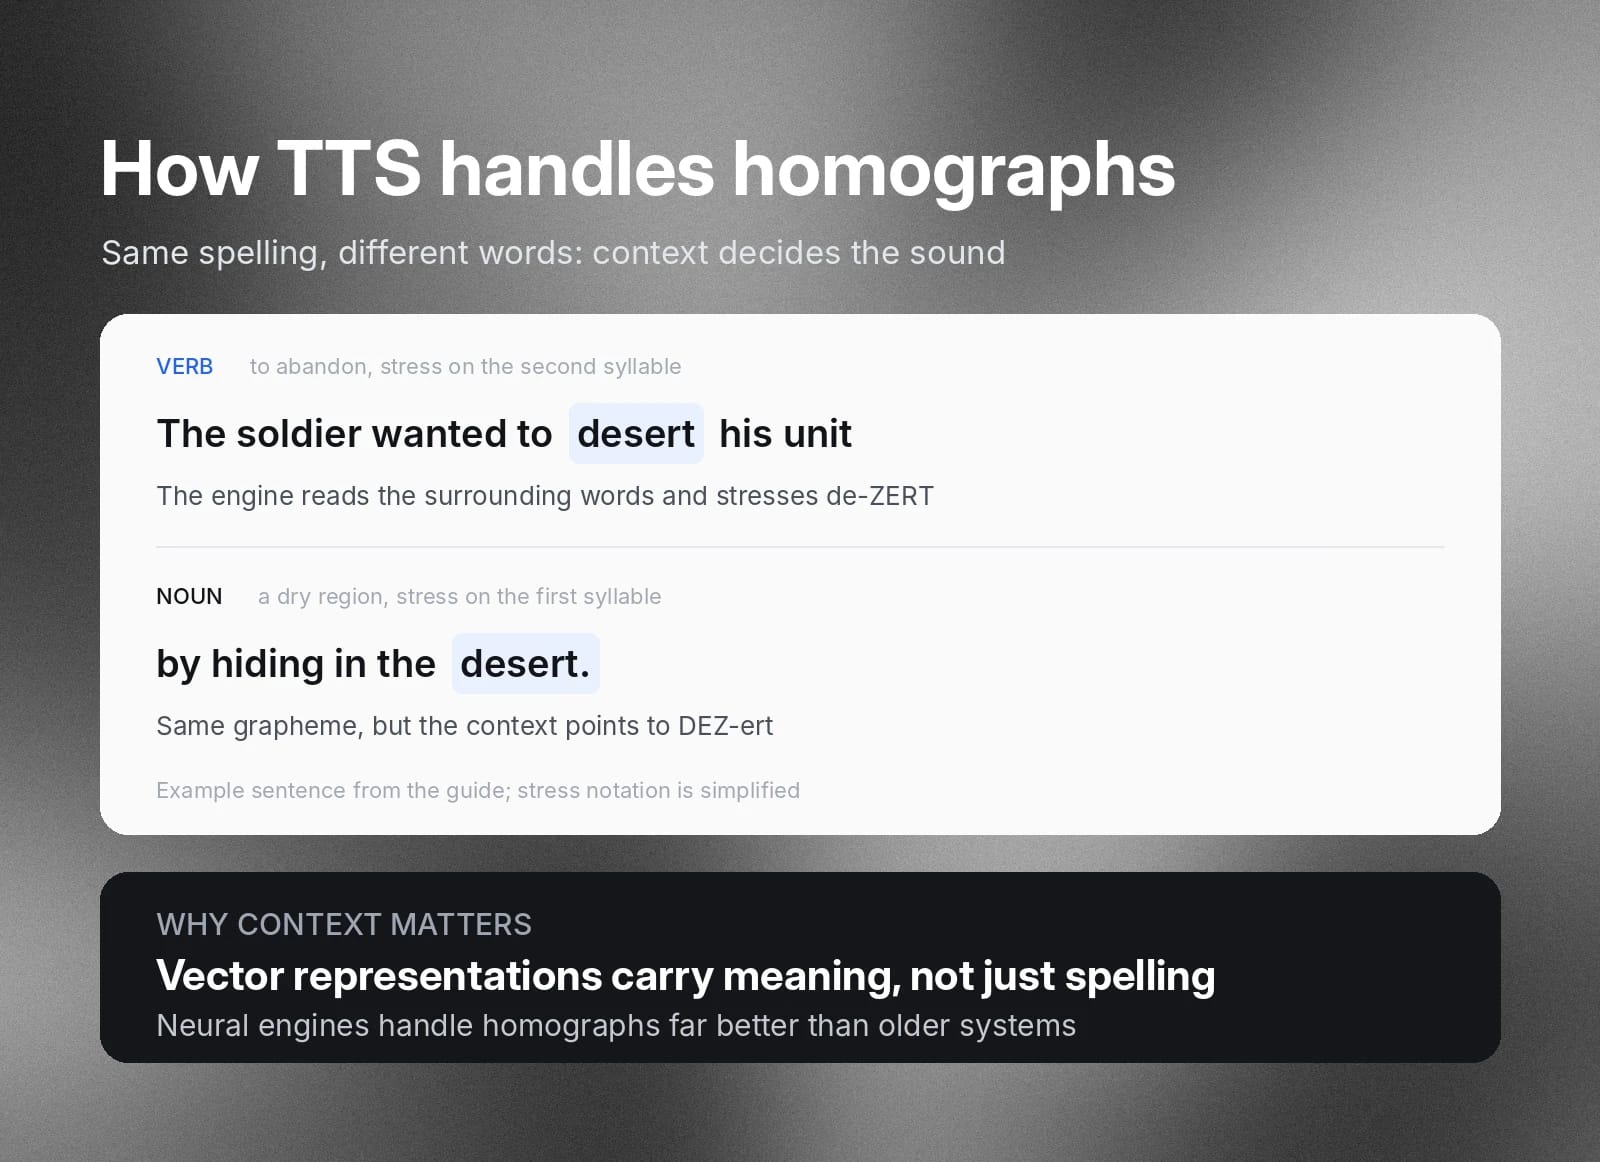
Sehen Sie, wie Eleven v4 dieses Beispiel zum Leben erweckt.
Akustische Modellierung und Wellenform- (Sprach-)Synthese
Die TTS-Engine nimmt die tokenisierten Informationen und Kontextvektoren, die jetzt vollständig als numerische Daten vorliegen, und wandelt sie in eine akustische Darstellung wie ein Mel-Spektrogramm um. Dieses umfasst verschiedene Frequenzen, Energielevel und Klänge, die das Gehirn als Emotion interpretiert. In der Vergangenheit kamen dafür viele verschiedene Systeme zum Einsatz, doch heute zählen neuronale Modelle zu den effektivsten.
Im letzten Schritt wandelt ein Vocoder diese Spektrogramme in Audio um, das menschliche Zuhörer als Sprache erkennen. Dieser Vorgang wird Wellenformgenerierung genannt.
TTS in der Praxis: Ein Beispiel
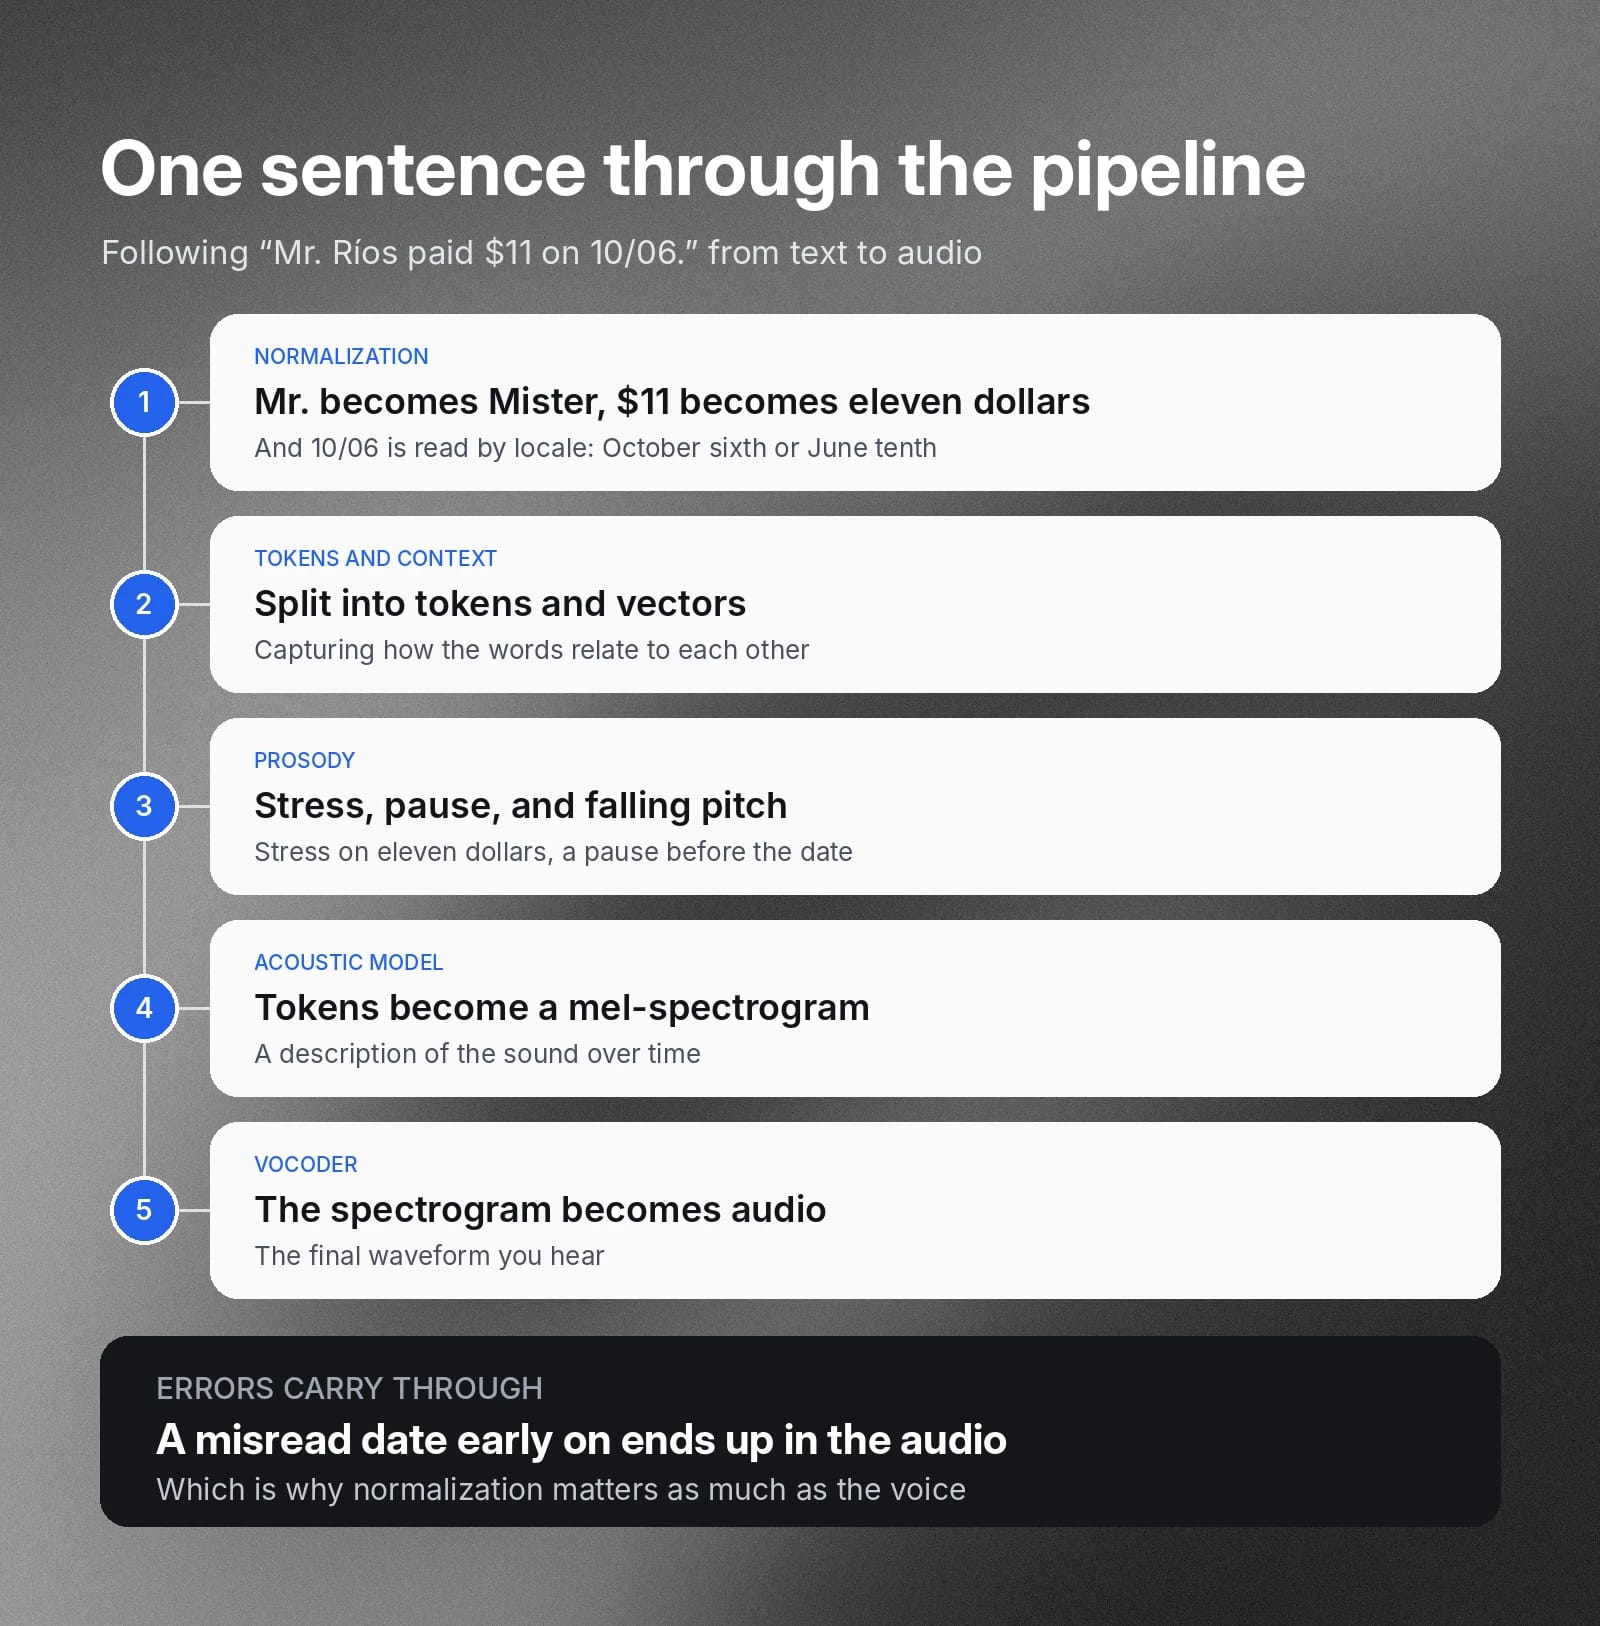
Am einfachsten erkennen Sie, wie die TTS-Phasen zusammenwirken, wenn Sie einen einzelnen Satz durch die Pipeline verfolgen.
Nehmen wir den Text „Mr. Ríos paid $11 on 10/06.“
- Normalisierung: Die Engine erweitert „Mr.“ zu „Mister“, liest „$11“ als „elf Dollar“ und entscheidet abhängig von Gebietsschema und Kontext, ob „10/06“ „sechster Oktober“ oder „zehnter Juni“ bedeutet.
- Tokenisierung und Kontext: Der bereinigte Text wird in Tokens aufgeteilt und in Vektoren umgewandelt, die erfassen, wie die Wörter zueinander in Beziehung stehen.
- Prosodie: Die Engine betont „elf Dollar“, fügt vor dem Datum eine kurze Pause ein und senkt die Tonhöhe am Satzende.
- Akustisches Modell: Das neuronale Modell wandelt Tokens und Prosodieplan in ein Mel-Spektrogramm um, das den Klang über die Zeit beschreibt.
- Vocoder: Der Vocoder wandelt das Spektrogramm in die endgültige Audio-Wellenform um, die Sie hören.
Jede Phase übergibt der nächsten einen detaillierteren Plan. Deshalb wirken sich Fehler am Anfang der Pipeline, etwa ein falsch gelesenes Datum, bis auf das fertige Audio aus.
Warum klingt neuronales Text to Speech menschlicher?
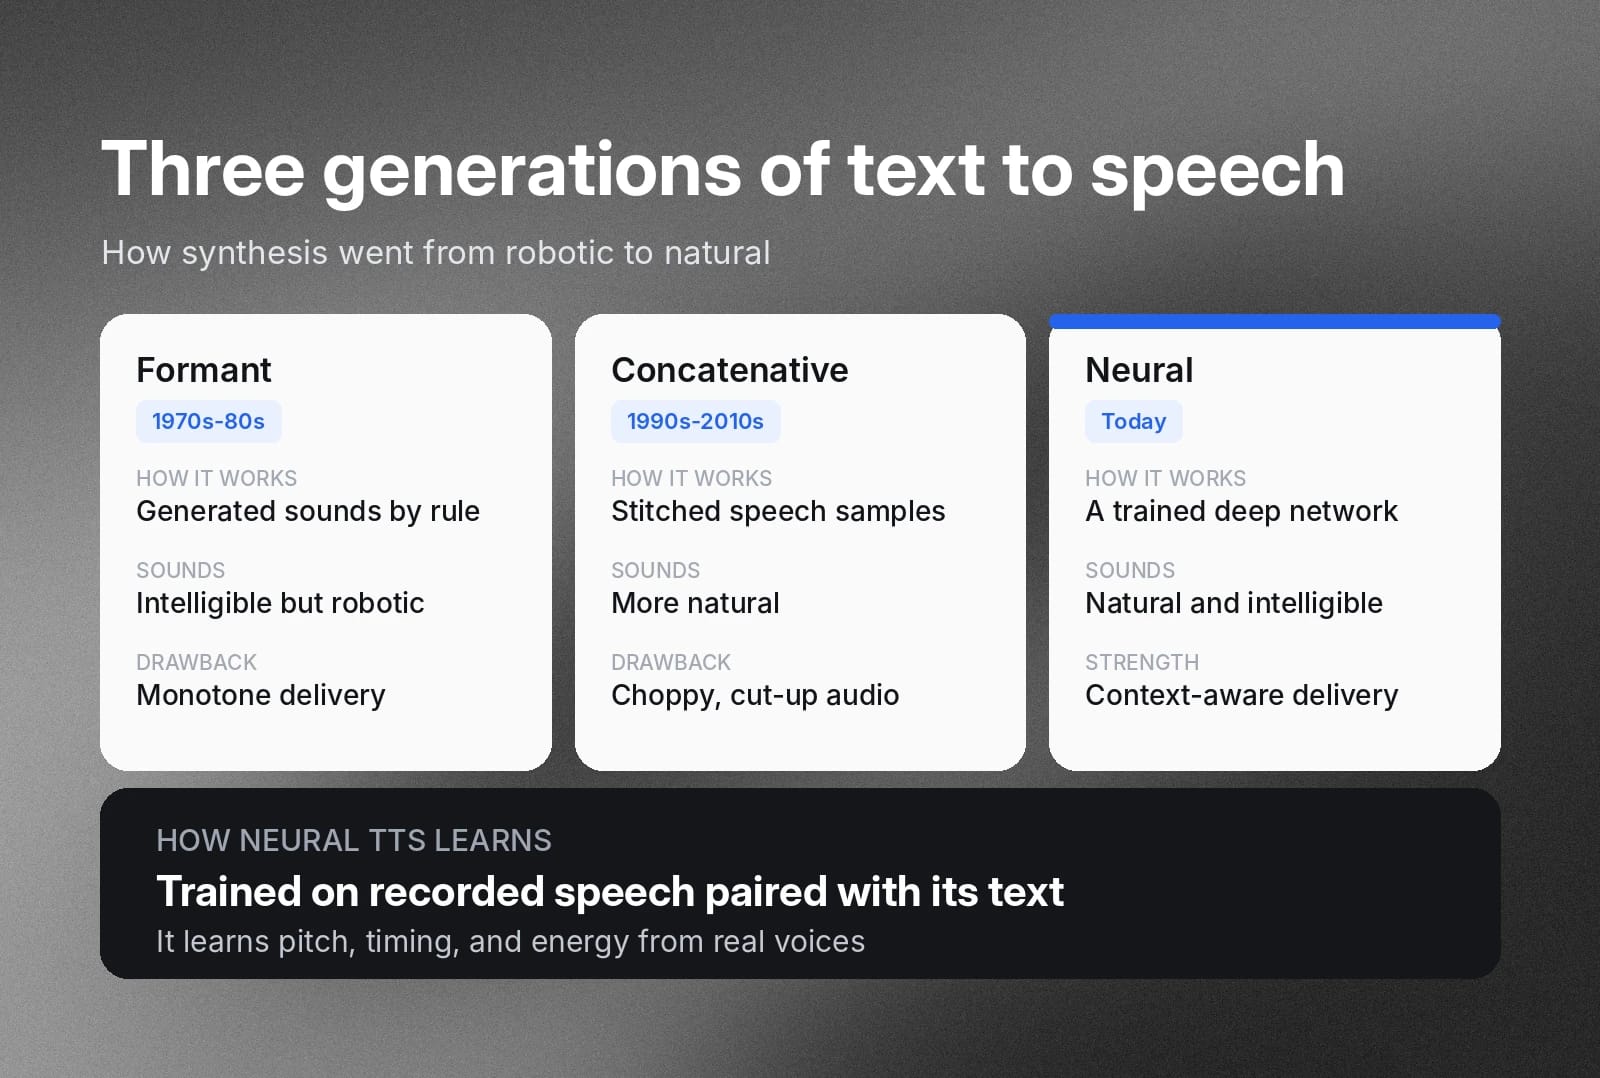
Neuronale Sprachsynthese erzeugt besonders natürliche und verständliche Sprache. Das sind die beiden Kriterien, mit denen Ingenieure TTS-Engines bewerten. Neuronales TTS trainiert ein Deep Neural Network (DNN), um aus Texteingaben Sprache zu erzeugen. Das DNN wird mit großen Mengen aufgezeichneter Sprache und den zugehörigen Texten trainiert.
Engines für neuronale Sprachsynthese sind nur die jüngste Entwicklung von TTS für Unternehmen. Ihnen gingen zwei Generationen kommerzieller Synthesetechnologie voraus.
Die Formantsynthese war in den 1970er- und 1980er-Jahren die dominierende Methode. Statt menschliche Sprache für die Laufzeitausgabe abzutasten, erzeugte sie synthetische Klänge, die Sprache modellierten. Sie war verständlich, aber monoton und klang robotisch.
Die konkatenative Synthese dominierte von den 1990er-Jahren bis in die 2010er und klang natürlicher als frühere Formantsysteme. Statt Töne nach mathematischen Regeln zu erzeugen, setzte sie kleine Aufnahmen menschlicher Sprache zusammen. Diese Systeme verwendeten linguistische Nachschlagetabellen, um normalisierten Text mit Klängen abzugleichen, und gaben dann kleine Einheiten zusammengesetzter Sprachaufnahmen aus einer großen Bibliothek oder einem „Korpus“ aus. Obwohl sie natürlicher klang als Sprache aus einer Formant-Engine, kann Konkatenation Sprache noch immer abgehackt wirken lassen.
Was ist der Unterschied zwischen einem KI-Stimmen-Generator und Text to Speech?
„KI-Stimmen-Generator“ ist ein im Marketing häufig verwendeter Begriff für ein breites Spektrum an Sprachtechnologien, einschließlich Text to Speech. Text to Speech bezeichnet speziell Systeme, die geschriebenen Text als Eingabe verwenden, dessen Semantik und Prosodie modellieren und Audio-Wellenformen ausgeben.
KI-Stimmen-Generatoren bilden ein umfassendes Ökosystem miteinander verbundener Sprachtechnologien, darunter TTS und weitere generative Systeme für Stimmendesign, KI-Stimme klonen und die Übertragung von Stimmstilen. Obwohl der Begriff im Marketing oft synonym mit Text to Speech verwendet wird, beschreibt er besser die übergeordnete Kategorie generativer Sprachtools, zu der TTS gehört.
Text to Speech für Content, Barrierefreiheit und Support nutzen
Text-to-Speech-Modelle sind weltweit ein zentraler Bestandteil persönlicher und geschäftlicher Workflows geworden.
Hier sind einige der wichtigsten Anwendungsfälle für Text to Speech.
Content-Erstellung
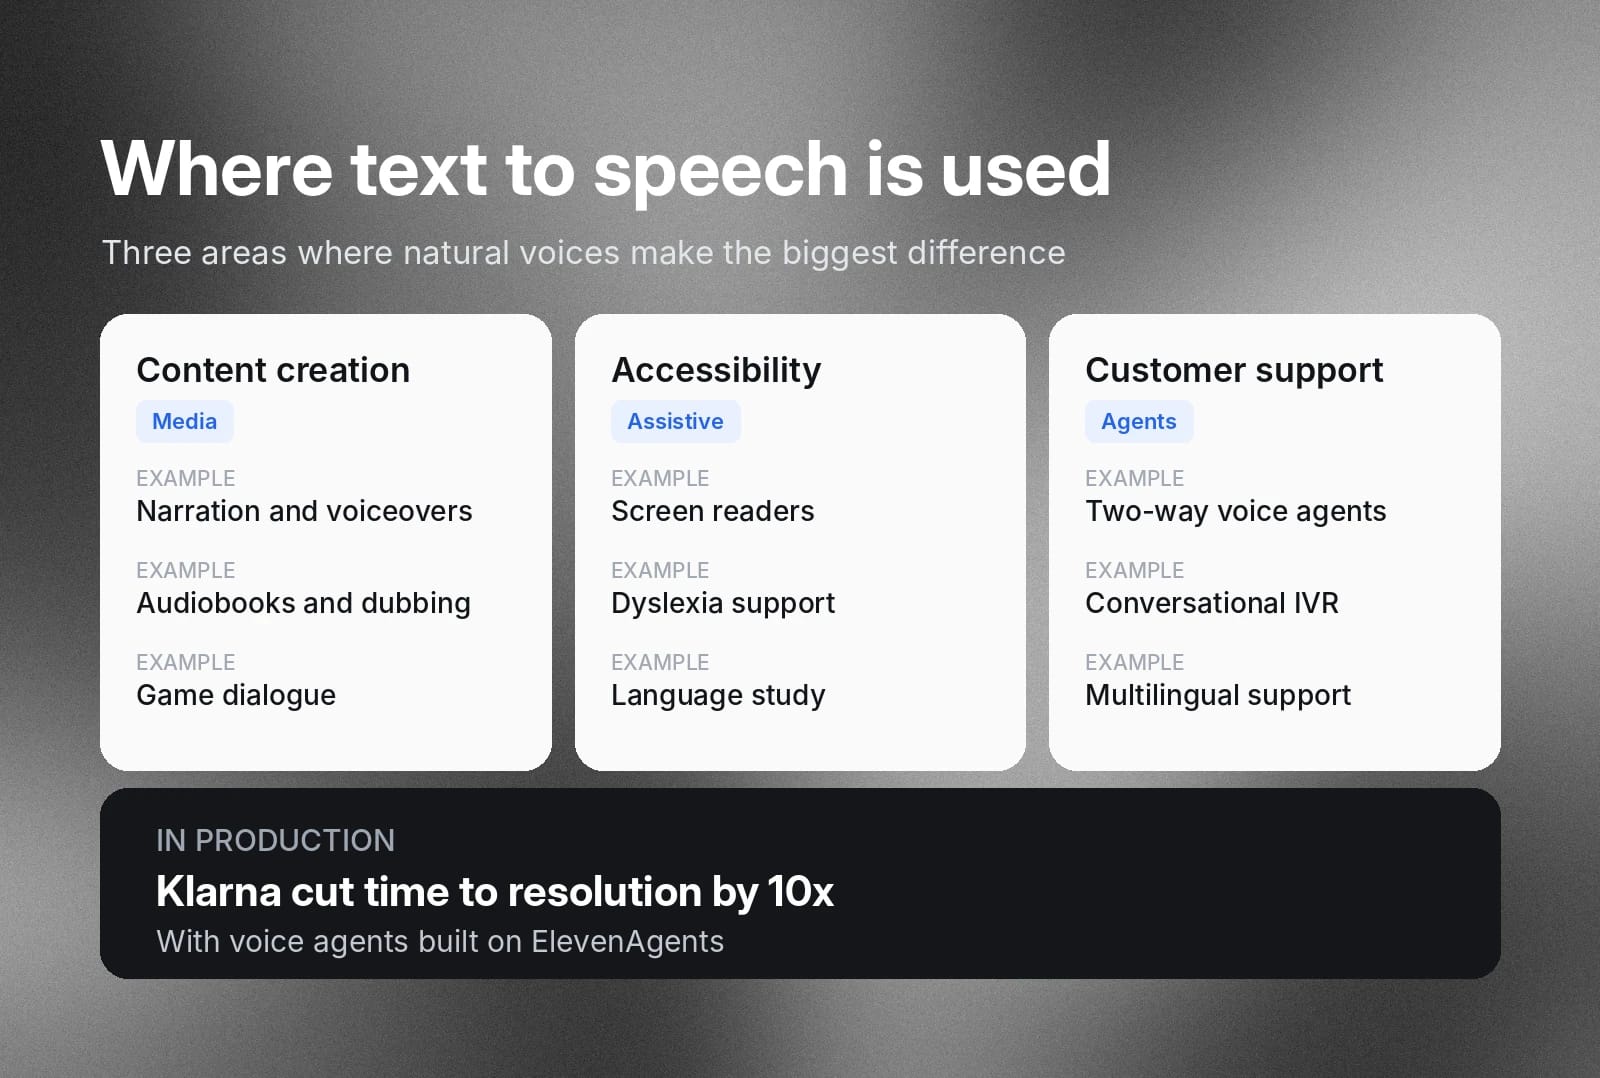
Text-to-Speech-Tools können die Kosten groß angelegter Medienproduktionen senken und die Zeit im Studio für Sprecheraufnahmen und Nachbearbeitung reduzieren.
Beispiele für Anwendungsfälle:
- Erzählstimmen
- Voiceovers
- Synchronisation
- Hörbuchproduktion
- Spieledialoge
Beispielsweise nutzte TAP ElevenLabs TTS, um Bildungsinhalte zu skalieren – für Schulen in ganz Indien.
Barrierefreiheit
Text to Speech zählt zu den meistgenutzten assistiven Technologien, weil Menschen schriftliche Inhalte dadurch hörend aufnehmen können. Natürliche Sprache verbessert die Aufmerksamkeit der Zuhörer und verringert mentale Ermüdung bei längeren Inhalten.
Häufige Anwendungsfälle für TTS-Barrierefreiheit sind:
- Screenreader: Lesen Sie ganze Seiten mit einem Screenreader und TTS vor.
- Unterstützung bei Legasthenie und Leseverständnis: Reduzieren Sie die Belastung beim Lesen, indem Sie Lesesitzungen von einer TTS-Stimme begleiten lassen.
- Sehschwäche und Blindheit: Screenreader lesen Schnittstellenelemente und Seiteninhalte vor, sodass Menschen Software und Websites ohne Sicht auf den Bildschirm nutzen können.
- Kognitive Unterschiede und Aufmerksamkeitsprobleme: Text zu hören, kann den Aufwand beim Lesen langer Dokumente senken und die Konzentration erleichtern.
- Lernen und Sprachstudium: Studierende hören die korrekte Aussprache neuer Vokabeln und können Lehrbücher unterwegs oder beim Lernen anhören.
Screenreader sind umfassende Tools für Barrierefreiheit, die alles auf einem Bildschirm beschreiben, einschließlich Schaltflächen und Menüs. Vorlesetools konzentrieren sich auf den Inhalt selbst, meist mit einer mitlaufenden Hervorhebung. Sie profitieren von natürlicheren Stimmen, weil Menschen sie über längere Zeit nutzen.
Kundensupport
Neuronale Sprachsynthese kann zusammen mit einem LLM, das agentische Interaktionen ermöglicht, ein hochwertiges Kundenerlebnis bieten. Plattformen wie ElevenAgents kombinieren die Stimmebene mit Spracherkennung, einem LLM und verbundenen Tools, die einem Agenten ermöglichen, die Bedürfnisse eines Anrufers zu verstehen und mit natürlicher Stimme zu antworten.
Mit ElevenAgents erstellte Agenten funktionieren über Telefon, Web, WhatsApp, E-Mail und SMS. So können Kunden Gespräche kanalübergreifend fortsetzen, ohne sich wiederholen zu müssen. Beispiele:
- Bidirektionale Sprach-KI-Agenten: Führen Live-Gespräche, indem sie Fragen aus einer Wissensdatenbank beantworten oder Kunden in bestimmte Abläufe wie Rückerstattungen oder Käufe leiten.
- Interactive-Voice-Response- (IVR)-Systeme: Ersetzen Sie veraltete Menüstrukturen wie „Drücken Sie 3 für den Vertrieb“ durch Gespräche, in denen Ihre Kunden natürlich sprechen können.
- Mehrsprachiger Support: Betreuen Sie Kunden in ihrer eigenen Sprache über eine einzige Agentenkonfiguration.
Klarna verkürzte beispielsweise die Lösungszeit mit ElevenAgents um das Zehnfache
Wie steuern Text-to-Speech-Engines die Aussprache?
Moderne Engines für neuronale Sprachsynthese können sehr natürlich klingende Sprache erzeugen. Doch bei etwas so umfassendem, tiefgehendem und dynamischem wie menschlicher Sprache wird es immer Sonderfälle geben. Vielleicht möchten Sie Akzente, Slang oder regionale Aussprachen in Ihrer erzeugten Sprache beibehalten. Möglicherweise produzieren Sie Audio für eine Branche mit spezifischen Aussprachen technischer Begriffe. Oder Sie möchten einfach, dass Ihr Markenname stets auf eine ganz bestimmte Weise ausgesprochen wird.
Aussprachewörterbücher und Phonem-Überschreibungen
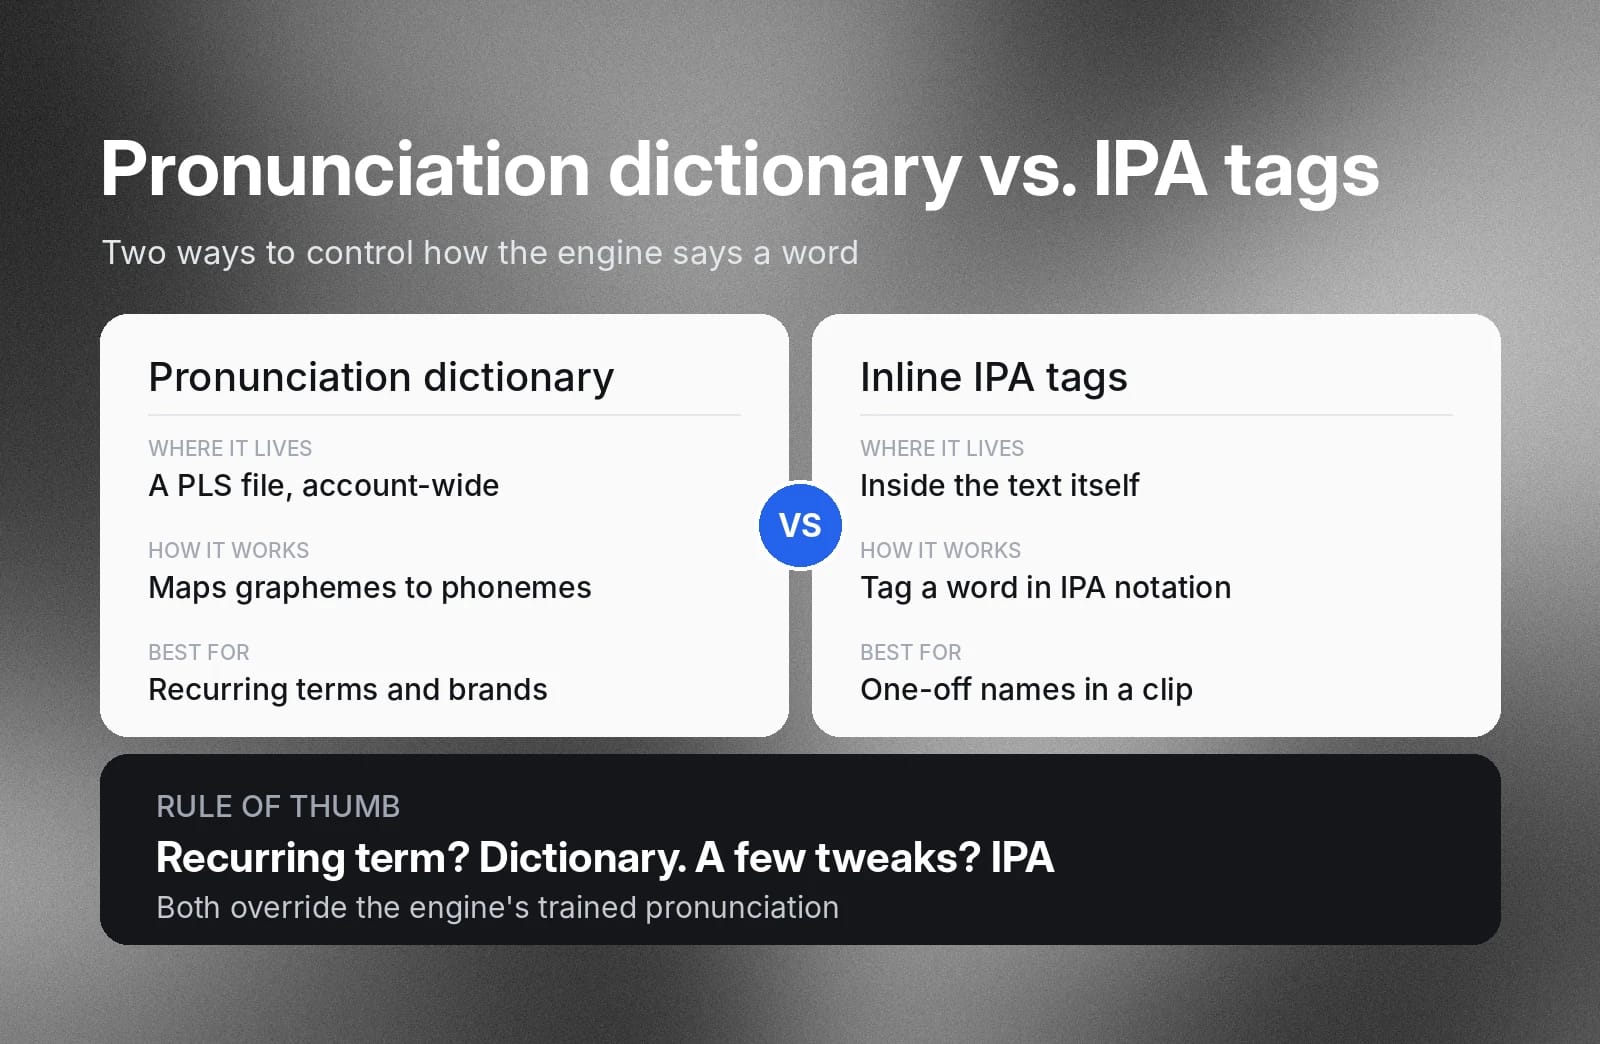
Die ElevenAPI von ElevenLabs enthält ein Aussprachewörterbuch, mit dem Sie anpassen können, wie die Engine spricht. Sie erstellen ein Wörterbuch in einer W3C-standardisierten Pronunciation Lexicon Specification (PLS)-Datei, die Grapheme (Symbole im Text) auf Phoneme abbildet (gesprochene Wörter, in Laute zerlegt). Trifft die TTS-Engine auf eines der aufgeführten Grapheme, überschreibt sie ihre trainierte Aussprache und verwendet die phonetische Aussprache aus dem Wörterbuch.
In der Dokumentation Aussprachewörterbücher verwenden erfahren Sie, wie Sie ein Aussprachewörterbuch in ElevenAPI erstellen.
Native IPA und phonetisches Prompting
Einige TTS-Modelle erkennen auch Inline-Aussprachetags, die direkt in die Texteingabe eingebettet sind. Statt ein kontoweites Wörterbuch zu erstellen, können Sie Wörter im Text mit standardisierter IPA-Notation markieren, wenn Sie die Aussprache nur in ein oder zwei Audioclips anpassen möchten. Zum Beispiel, wenn Sie ein Hörbuch aufnehmen und der Name einer fiktiven Figur auf eine bestimmte Weise ausgesprochen werden soll.
Häufige Herausforderungen bei Text to Speech und Lösungen
Selbst die besten TTS-Modelle können mit den Nuancen menschlicher Sprache Schwierigkeiten haben. Zwei der häufigsten Probleme sind die falsche Aussprache neuer Wörter und monotone Sprache. So lösen Sie sie.
Falschaussprache unbekannter Wörter, Fachbegriffe und Eigennamen
TTS-Engines verwenden Algorithmen, um anhand der Zuordnung von Graphemen zu Phonemen in ihren Trainingsdaten vorherzusagen, wie normalisierter Text ausgesprochen werden soll. Sie treffen anhand des aufgenommenen Texts und Kontexts die bestmögliche Einschätzung. Wie im vorigen Abschnitt beschrieben, gibt es jedoch viele Sonderfälle, in denen Sie eine ganz bestimmte Aussprache benötigen.
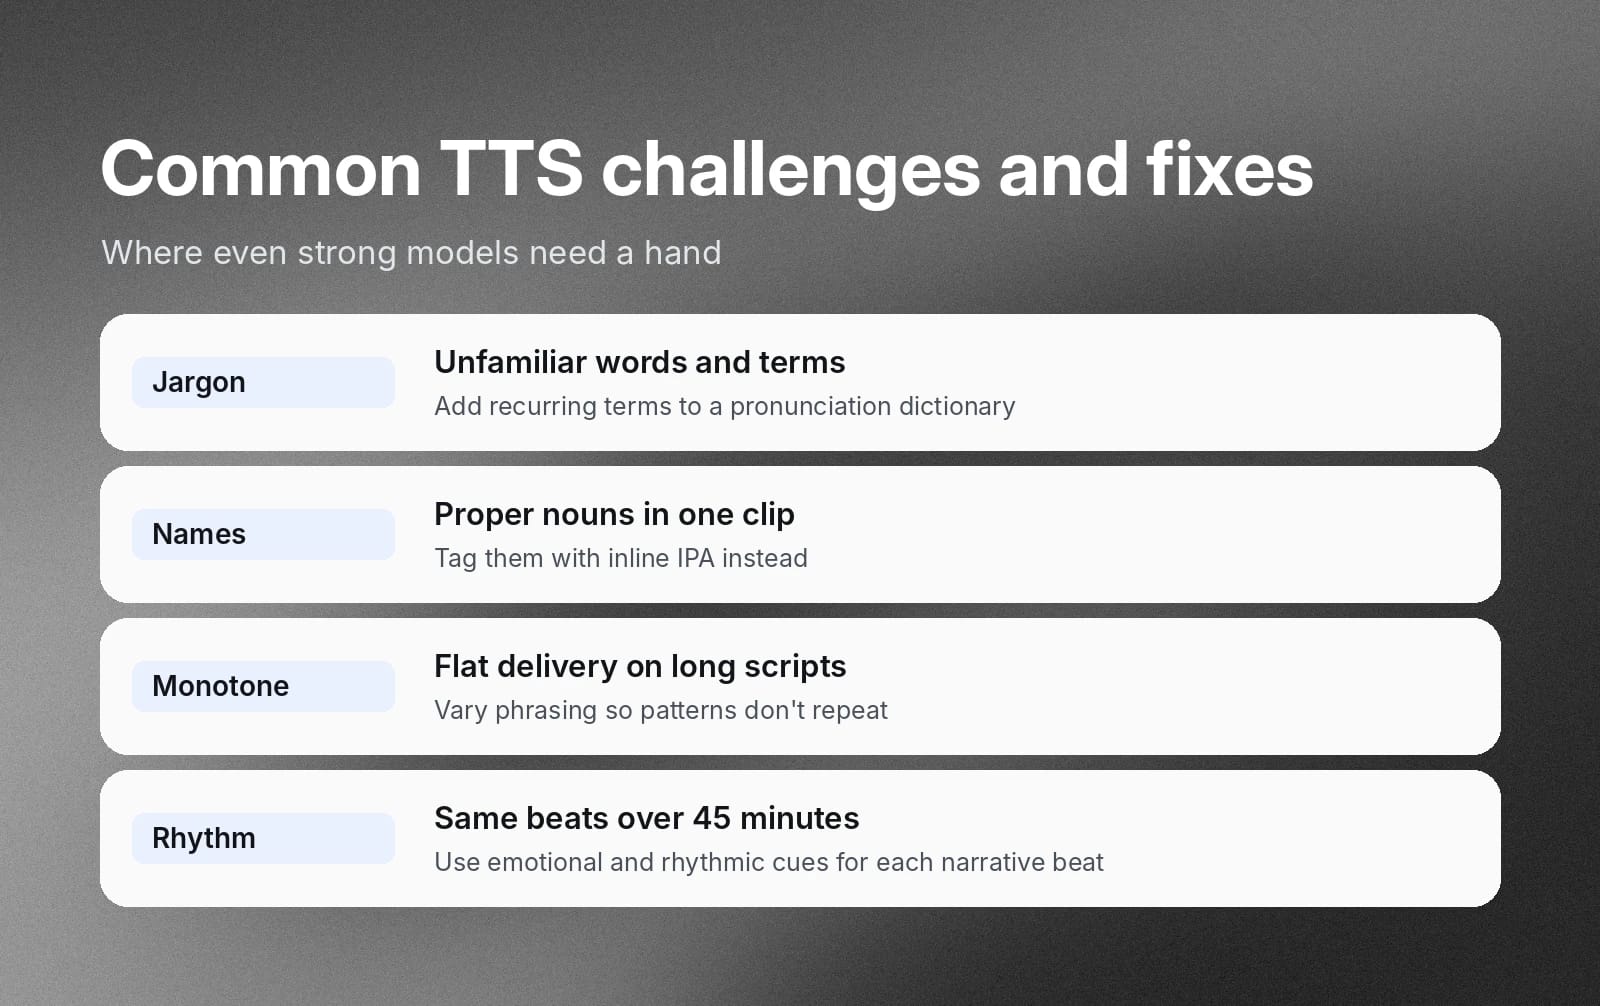
Aussprachewörterbücher oder gezielte IPA-Tags sind die besten Tools für diese Sonderfälle. Wenn ein häufig wiederkehrender Begriff konsistent ausgesprochen werden soll, ist ein Wörterbuch die beste Lösung. Für gezielte Anpassungen einiger weniger Begriffe verwenden Sie phonetische IPA-Tags.
Monotone Wiedergabe
Diese Probleme treten besonders häufig bei längeren Skripten auf, in denen dieselben Wörter oder Phrasen immer wieder gesprochen werden. Die synthetisierte Sprache einer Engine kann in 10-Sekunden-Clips hervorragend klingen. Doch über einen 45-minütigen Vortrag hinweg ermüden Zuhörer schnell durch dieselbe routinierte Aussprache und dieselben Rhythmusmuster.
Variieren Sie die Formulierungen in Ihren Skripten und setzen Sie phonetische Tags gezielt ein, um Aussprachen regelmäßig zu variieren. Nutzen Sie emotionale und rhythmische Hinweise, um die Sprachausgabe dynamischer zu gestalten, mit steigender und fallender Tonhöhe bei unterschiedlichen erzählerischen Momenten.
Natürliche Spracherlebnisse mit einer Text to Speech API erstellen
Leichte Webtools eignen sich hervorragend für kleine Audioclips, skalieren jedoch nicht gut für größere Geschäftsanforderungen. Wenn Sie Tausende Kundeninteraktionen pro Minute verwalten oder hochwertige Audioinhalte in Langform erzeugen möchten, benötigen Sie leistungsfähigere TTS-Tools.
Mit einer Text to Speech API wie ElevenAPI können Sie Ihre Software direkt mit Modellen für neuronale Sprachsynthese verbinden. Mit REST-Anfragen oder persistenten WebSockets erzeugen Sie Audio bei Bedarf für Agenten oder andere Zwecke im großen Maßstab.
So funktioniert eine Text-to-Speech-API-Anfrage
Die Modelle sind komplex, aber der Entwickler-Workflow ist leicht zu verstehen und einfach einzurichten.
Mit ElevenAPI können Sie Text to Speech in Ihre Anwendungen integrieren – in wenigen Minuten:
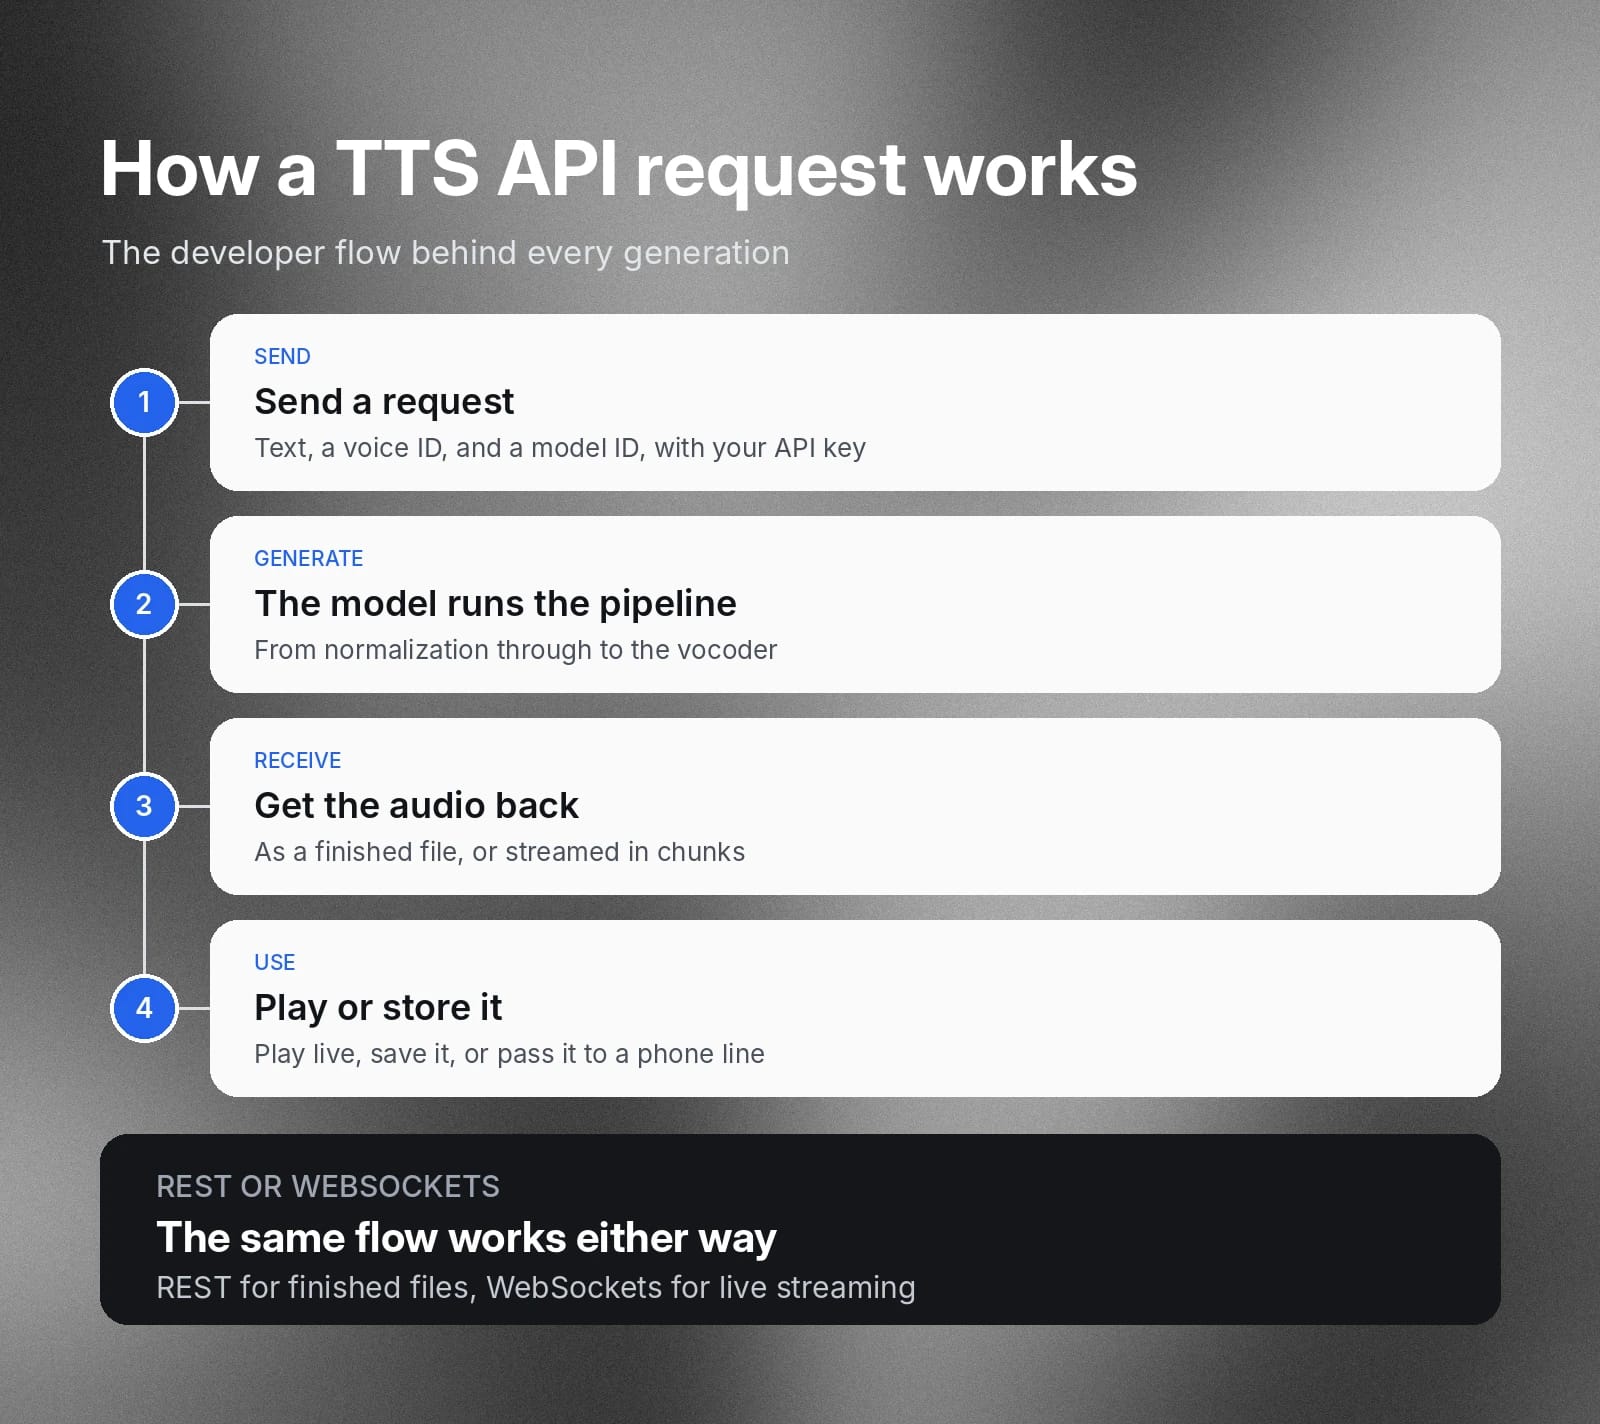
- Anfrage senden: Ihre Anwendung sendet den Text, eine Voice-ID und eine Modell-ID zusammen mit Ihrem API-Schlüssel an die API.
- Generieren: Das Modell durchläuft die oben beschriebene Pipeline – von der Normalisierung bis zum Vocoder.
- Audio empfangen: Die API gibt die fertige Audiodatei zurück oder streamt sie in Chunks, sodass die Wiedergabe vor Abschluss der Generierung beginnen kann.
- Wiedergeben oder speichern: Ihre Anwendung gibt das Audio live wieder, speichert es oder leitet es an ein anderes System wie eine Telefonleitung weiter.
Derselbe Ablauf gilt, unabhängig davon, ob Sie REST für fertige Dateien oder WebSockets für Live-Streaming verwenden. Die unten beschriebenen SDKs kapseln diese Aufrufe für Sie.
Architekturüberlegungen für Entwickler
Je nach Anwendungsfall müssen Sie Kompromisse zwischen Verarbeitungsgeschwindigkeit, Audiotreue, Netzwerklatenz und -protokollen sowie Integrationsmöglichkeiten abwägen.
Latenz vs. Qualität
Damit dialogorientierte Agenten natürlich klingen, sollten Sie etwa 100 ms bis zum ersten Audio anstreben. Das bedeutet, die Latenz im Netzwerk und zur TTS-Engine zu minimieren. Entscheidend ist dabei, welche Audioqualität die Architektur Ihres Agenten innerhalb dieser Einschränkung liefern kann.
Bei langen Audioinhalten wie Podcasts oder Vorträgen ist Latenz dagegen weniger wichtig. Statt die Latenz zu minimieren, sollten Sie eine Ausgabe mit hoher Klangtreue maximieren.
Streaming-Protokolle
Die Protokolle für Ihre API-Verbindung können ebenfalls Latenz und Leistung beeinflussen. WebSockets ermöglichen echtes bidirektionales Audio-Streaming. Dadurch können Sie Text-Chunks verarbeiten, statt auf das Rendern eines vollständigen Feeds zu warten. Die Wiedergabe kann mit den ersten Chunks beginnen, während die TTS-Engine spätere noch verarbeitet.
SDKs
Text-to-Speech-APIs für Unternehmen wie ElevenAPI bieten vollständige Software Development Kits (SDKs) für Python und TypeScript/JavaScript sowie REST-APIs, damit Sie neue Architekturen schnell aufbauen können. Nutzen Sie sie, um den Integrationsaufwand für Ihr Entwicklungsteam zu senken.
Mit ElevenAPI für Text to Speech starten
Natürliche TTS-Synthese aus einem führenden Sprachmodell liefert die hochwertige Audioausgabe, die Ihre Agenten und Audioproduktionen Produktionen benötigen, um Zuhörer zu binden. Ob Sie einen hochwertigen dialogorientierten Agenten für Kundenworkflows suchen oder TTS in Ihre Anwendung integrieren möchten: ElevenLabs bietet eine Lösung.
Starten Sie noch heute und erzeugen Sie Ihr eigenes Audio mit hoher Klangtreue mit ElevenAPI oder erfahren Sie mehr über ElevenAgents.
FAQs

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.