SSML-Tags erklärt: So steuern Sie Pausen, Aussprache und Sprechtempo bei Text to Speech
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Speech Synthesis Markup Language (SSML) ist eine XML-basierte Markup-Sprache, die Text mit Tags versieht, um einem Text to Speech-Modell mitzuteilen, wie es ihn sprechen soll – einschließlich Pausen, Wortaussprachen und zu betonender Phrasen.
Diese Steuerungsebene steckt hinter vielen KI-Stimmen, die Sie bereits hören. Sowohl ein Interactive-Voice-Response-System (IVR), das eine Bestätigungsnummer vorliest, als auch ein KI-Hörbuch-Sprecher, der am Ende eines Kapitels pausiert, nutzen eine Variante davon. Wenn Sie KI-generierte Sprache angepasst haben, sind Sie wahrscheinlich schon auf SSML gestoßen.
SSML ist seit über zwei Jahrzehnten Teil der TTS-Technologie und für viele Anbieter weiterhin zentral bei der Bereitstellung von TTS. Dieser Leitfaden erklärt, was SSML ist und wo es in der Modellpalette von ElevenLabs genau zum Einsatz kommt – zusammen mit dem verbesserten Audio-Tag-System, das Eleven v3 und Eleven v4 für führende, natürlich klingende Text to Speech verwenden.
Erleben Sie Eleven v4 mit Audio Tags
Eleven v4 entdeckenZusammenfassung
- SSML ist eine auf dem W3C basierende Markup-Sprache zur Steuerung von Pausen, Betonung, Aussprache und Sprechtempo in synthetisierter Sprache.
- ElevenLabs-Modelle unterstützen mit Ausnahme von Eleven v3 und Eleven v4 das SSML-Tag <break> für Pausen von bis zu 3 Sekunden.
- Eleven Flash v2 und Eleven Turbo v2 unterstützen das Tag <Phonem> für eine benutzerdefinierte englische Aussprache.
- Eleven v3 und Eleven v4 unterstützen SSML überhaupt nicht. Stattdessen nutzen sie Audio Tags für Anweisungen in natürlicher Sprache in Klammern wie [whispering] und [sighs], um den Fluss synthetisierter Sprache zu steuern.
- Die WebSocket API steuert das SSML-Parsing über den Parameter enable_ssml_parsing und sendet SSML-Tags als vollständige Nachrichten, um zusätzliche Latenz zu vermeiden.
- Tags wie <prosody>, <say-as>, <sub>, <lang>, <voice> und <audio> werden von ElevenLabs-Modellen nicht unterstützt, haben aber jeweils eine Alternative: Stimmeinstellungen, Textnormalisierung, Aussprachewörterbücher, mehrsprachige Modelle, separate Stimmen und Soundeffekte.
Was ist SSML?
SSML ist eine Markup-Sprache, mit der Sie geschriebenen Text mit Anweisungen versehen können, wie eine Synthese-Engine ihn sprechen soll. Das World Wide Web Consortium (W3C) entwickelte sie als Standard, um über reine Text-to-Speech-Modelle hinauszugehen. SSML bietet explizite, maschinenlesbare Vorgaben für die Aussprache eines Textabschnitts, statt sich auf die Interpretation von Klartext zu verlassen.
SSML ist keine einzigartige Markup-Sprache, die auf einen einzelnen Anbieter beschränkt ist. Amazon Polly und Microsoft Azure Speech verwenden SSML-Tags wie <break> und <emphasis> als primären Steuerungsmechanismus. Die meisten Cloud-Text-to-Speech-Plattformen akzeptieren eine Variante des Standards. SSML war lange vor generativen Stimmenmodellen die Standardmethode zur Annotation von Sprache.
SSML bleibt ein grundlegender Standard, während sich neuere, modellspezifische Steuerungen parallel zu modernen generativen Sprachtechnologien entwickeln. Diese herstellerneutrale Spezifikation ermöglicht es Anbietern, gemeinsame Kern-Tags zu implementieren. Darauf können sie eigene Erweiterungen und Einschränkungen aufbauen.
Gängige SSML-Tags und ihre Funktion
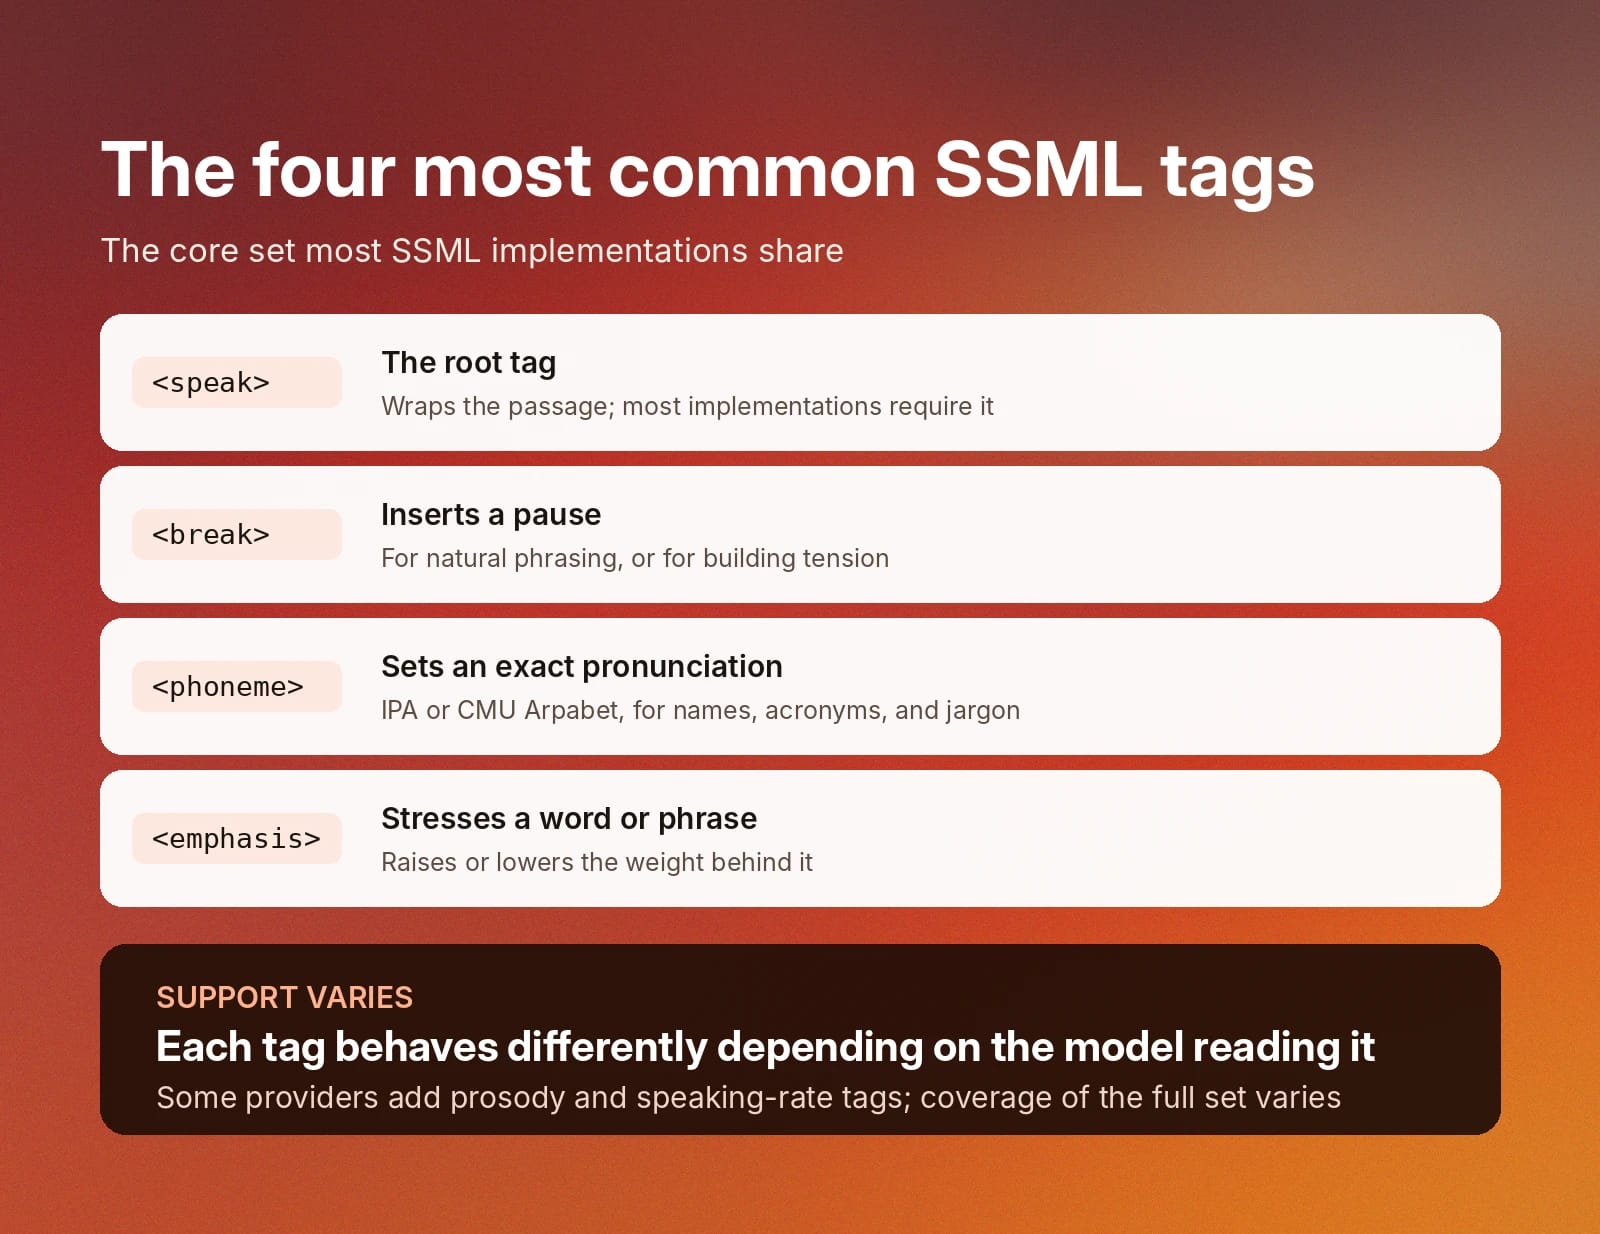
SSML-Implementierungen haben einen Satz von Kern-Tags gemeinsam, nach denen die meisten Menschen suchen, wenn sie synthetisierte Sprache steuern möchten.
Diese gängigen SSML-Tags sind:
- <speak>: Das ist das Root-Tag, das den gesamten Text umschließt. Die meisten Implementierungen benötigen es, um den enthaltenen Inhalt als SSML zu erkennen.
- <break>: Fügt eine Pause mit festgelegter Dauer ein. Das ist für natürliche Formulierungen zwischen Satzteilen oder Sätzen sowie zum Aufbau von Spannung in einem Text nützlich.
- <phoneme>: Legt die genaue Aussprache eines Wortes mithilfe eines phonetischen Alphabets wie IPA oder CMU Arpabet fest. Das ist für Akronyme, Namen oder Fachbegriffe nützlich.
- <emphasis>: Betont ein Wort oder eine Phrase und ahmt nach, wie Sprecher die Bedeutung natürlich stärker oder schwächer gewichten.
Jedes dieser vier Tags verhält sich je nach lesendem TTS-Modell anders. Einige Anbieter unterstützen zusätzliche Tags für Prosodie oder Sprechgeschwindigkeit. Ein für einen TTS-Anbieter geschriebenes Skript verhält sich nicht genauso bei einem anderen – selbst wenn beide SSML-Unterstützung angeben –, weil die Abdeckung des vollständigen Tag-Sets variiert.
Am stärksten variiert, welche Tags ein bestimmtes Text-to-Speech-Modell tatsächlich verarbeitet. Hier wird die Implementierung von ElevenLabs spezifisch.
SSML mit ElevenLabs verwenden
Die SSML-Unterstützung bei ElevenLabs ist nicht vollständig einheitlich. Sie hängt vom Modell ab, das Sie zur Audiogenerierung auswählen. Das Tag <break> wird am breitesten unterstützt, während <phoneme> nur für einen kleineren Teil der Modelle verfügbar ist.
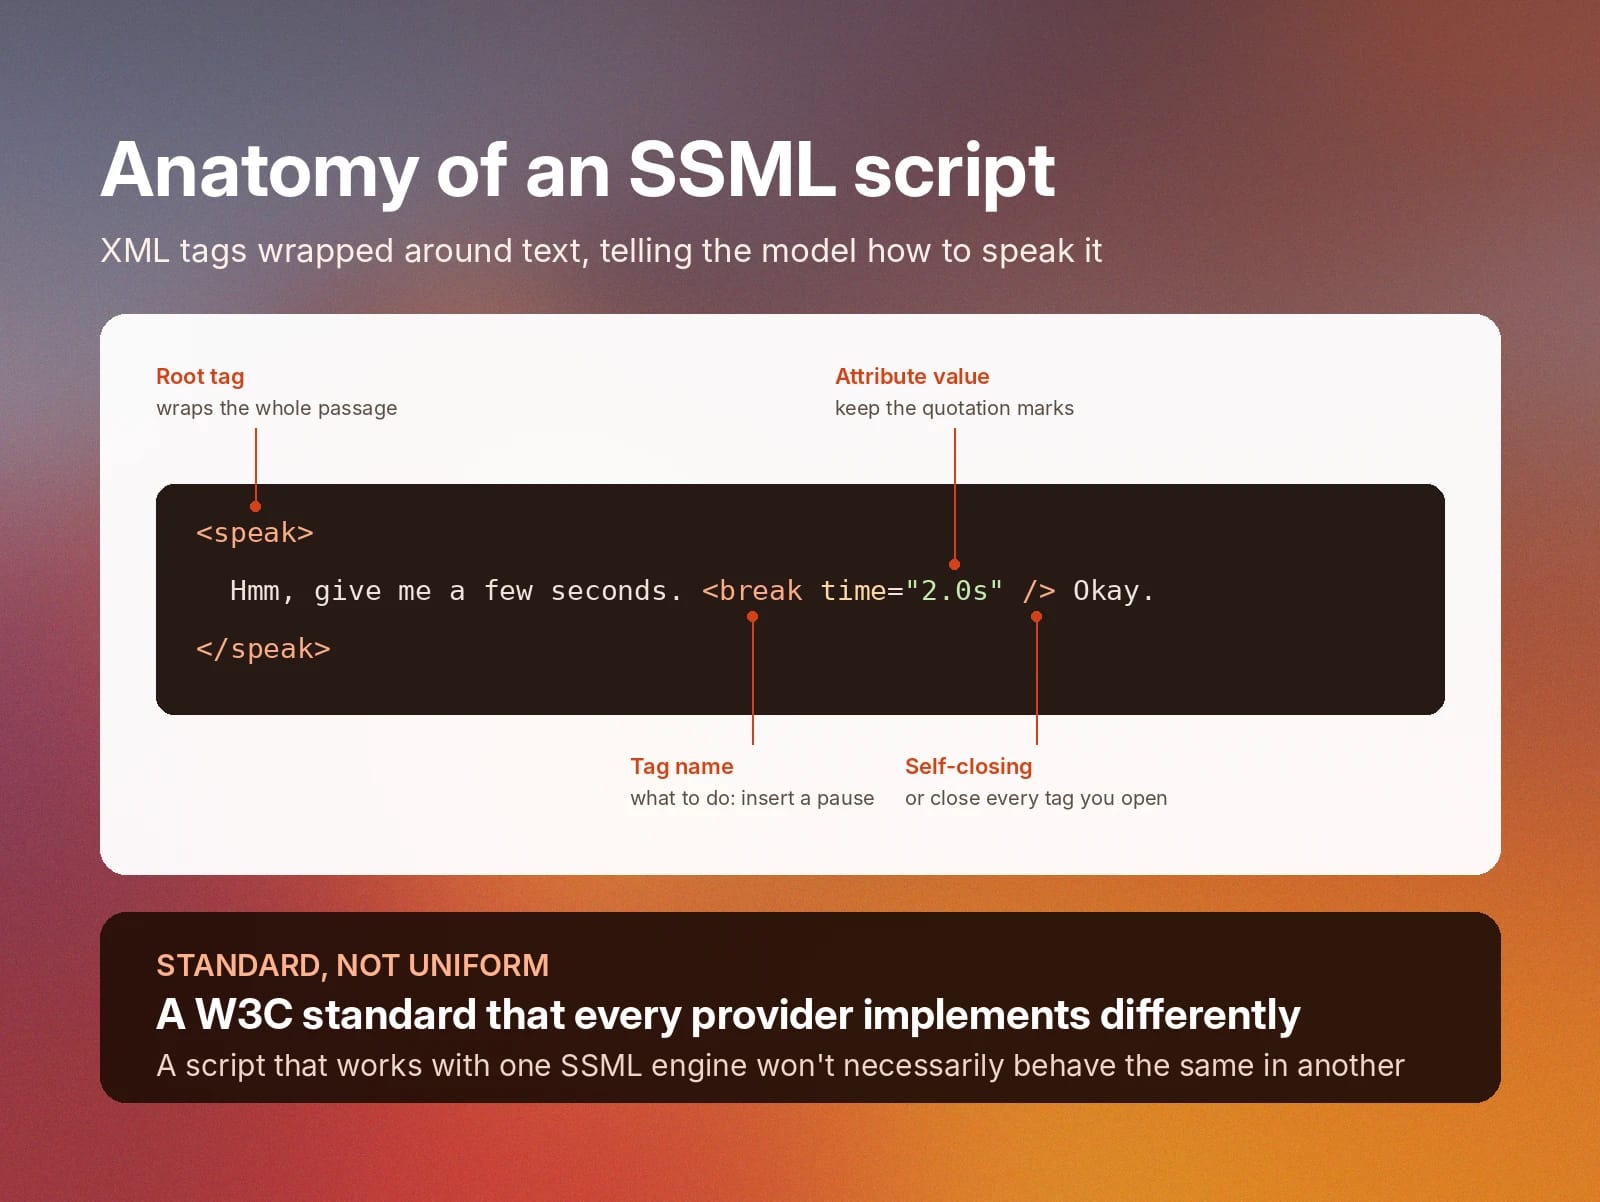
Ältere ElevenLabs-TTS-Modelle wie Multilingual v2 unterstützen das Tag <break> für Pausen von bis zu drei Sekunden. Zum Beispiel könnte ein KI-Agent sagen: „Einen Moment, ich denke nach“, und dann <break time="2.0s" /> verwenden, um vor „Alles klar, ich weiß, wie ich helfen kann“ eine hörbare Pause zu erzeugen. Es ist in vielen Workflows das häufigste Tag, weil es einen natürlicheren Gesprächsstil simuliert.
Bei SSML-Tags sollten Sie sich auf wenige gleichzeitig beschränken. Viele Tags in einem Satz oder Absatz können dazu führen, dass ein Modell sein Tempo unerwartet ändert oder verschiedene Audioartefakte erzeugt. Auch unterschiedliche Stimmen verarbeiten Pausen unterschiedlich, insbesondere Stimmen, die mit Füllwörtern wie „äh“ oder „hm“ trainiert wurden.
SSML in der Praxis mit ElevenLabs
Die ElevenLabs-Modelle Flash v2 und Turbo v2 gehen noch einen Schritt weiter und unterstützen zusätzlich das Tag <phoneme> für benutzerdefinierte Aussprachen – allerdings nur auf Englisch. Dadurch eignet sich das Phoneme-Tag, um die Aussprache eines Namens, Akronyms, Fachbegriffs oder anderer geschäftsbezogener Formulierungen zu korrigieren. Das gilt, solange das Skript auf einem dieser beiden Modelle läuft.
Eleven v3 und Eleven v4 weichen dagegen vollständig von diesem Muster ab. Sie verwenden Audio Tags zur Steuerung der Sprechweise. Darüber hinaus führt Eleven v4 native Inline-IPA-Unterstützung ein, sodass IPA-Symbole in Schrägstrichen direkt im Text gelesen werden können. Im Folgenden behandeln wir, was das Break-Tag und die Steuerung der Sprechweise ersetzt.
Eine vollständige Übersicht der Text-to-Speech-Steuerungen von ElevenLabs, einschließlich Aussprachewörterbüchern und Textnormalisierung, finden Sie im Leitfaden zu Best Practices.
SSML-Codebeispiele mit ElevenLabs
Die folgenden Beispiele zeigen SSML in einem Skript und in einem API-Aufruf. Denken Sie daran: <break> funktioniert mit jedem Modell außer Eleven v4 und Eleven v3, und <phoneme> funktioniert nur mit Flash v2 und Turbo v2 (nur Englisch).
Ein einfaches SSML-Skript mit einer Pause
Schließen Sie den Text und das Tag in einen <speak>-Block ein und lassen Sie die Anführungszeichen um den Attributwert stehen:
Weitere Informationen zu Pausen und SSML-Phoneme-Tags über die ElevenAPI.
Eine Aussprache mit <phoneme> korrigieren
Verwenden Sie IPA oder das CMU Arpabet, um genau festzulegen, wie ein Wort klingen soll. Hier wird der Name „Siobhan“ mit IPA angeleitet, während „Madison“ mit dem CMU Arpabet definiert wird:
Sprache mit SSML in Python generieren
Dieser Aufruf sendet ein Skript mit einem Break-Tag an ein Modell, das es unterstützt:
Sprache mit SSML in JavaScript generieren
Unten finden Sie ein ähnliches Beispiel für die Sprachgenerierung mit SSML, diesmal in JavaScript.
SSML und die WebSocket API
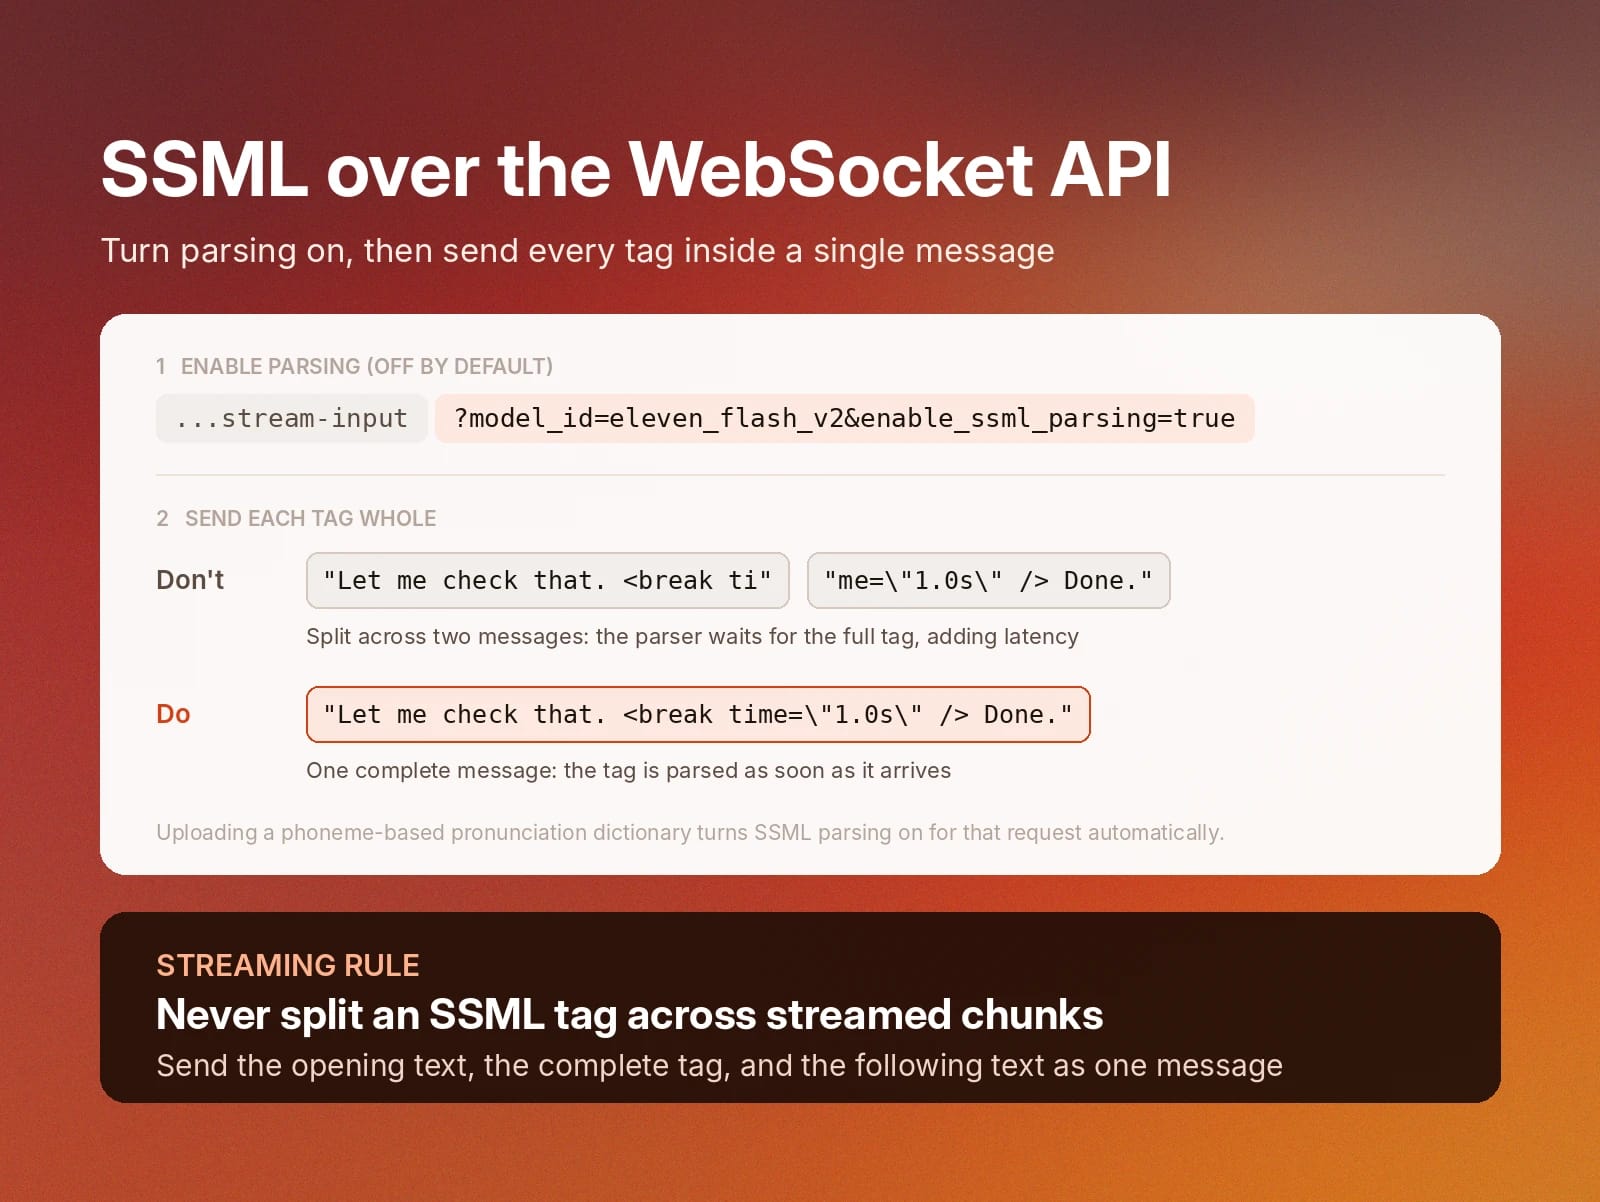
Beim Streamen von Audio über die WebSocket API von ElevenLabs statt über eine Standard-HTTP-Anfrage müssen Sie das SSML-Parsing ausdrücklich aktivieren. Es ist standardmäßig deaktiviert und wird über den Parameter enable_ssml_parsing gesteuert.
Für optimale Ergebnisse empfiehlt es sich, jedes SSML-Tag als vollständig eigenständige Nachricht zu senden, statt es auf mehrere gestreamte Chunks aufzuteilen. Wird ein Tag mitten in einer Nachricht geteilt, erhöht das die Latenz, da der Parser das vollständige Tag benötigt, bevor er es verarbeiten kann.
Das Hochladen eines phonembasierten Aussprachewörterbuchs aktiviert das SSML-Parsing für die Anfrage automatisch, auch wenn der Parameter enable_ssml_parsing nicht ausdrücklich gesetzt wurde. Vollständige Parameterdetails und verfügbare Nachrichtenformate für die WebSocket API finden Sie in diesem Docs-Leitfaden zum Generieren von Audio in Echtzeit.
Das folgende Beispiel aktiviert das SSML-Parsing in der Verbindungs-URL und sendet das vollständige Break-Tag in einer einzelnen Nachricht:
SSML-Tags, die ElevenLabs nicht unterstützt – und was Sie stattdessen verwenden können
SSML-Tags, die ElevenLabs nicht unterstützt – und was Sie stattdessen verwenden können
Wenn Sie mit einem älteren ElevenLabs-Modell arbeiten, kann es nützlich sein zu wissen, welche SSML-Tags unterstützt werden. Aufgrund der bevorzugten Alternativen verarbeiten ältere ElevenLabs-Modelle heute nur noch <break> und <phoneme>; die übrigen SSML-Tags werden durch andere Methoden abgedeckt.
Andere SSML-Tags, die Sie aus der W3C-Spezifikation kennen, werden nicht als Auszeichnung gelesen und benötigen daher jeweils einen anderen Ansatz. Hier sehen Sie, wodurch Sie andere SSML-Tags bei ElevenLabs ersetzen können:
SSML-Tag
Funktion
Alternative
<prosody>
Legt Tonhöhe, Sprechgeschwindigkeit und Lautstärke fest
Die Stimmeinstellungen für Geschwindigkeit und Stabilität. In Eleven v3 und Eleven v4 Tags für die Sprechweise wie [slowly] oder [rushed]
<emphasis>
Betont ein Wort oder eine Formulierung
Großschreibung oder Satzzeichen zur Betonung. In Eleven v3 und Eleven v4 Tags wie [shouts]
<say-as>
Steuert, wie Zahlen, Daten und Akronyme gelesen werden
Textnormalisierung, den Wert ausschreiben oder eine Regel im Aussprachewörterbuch
<sub>
Ersetzt die gesprochene Form eines geschriebenen Worts
Eine Alias-Regel im Aussprachewörterbuch
<lang>
Wechselt die Sprache für eine Formulierung
Ein mehrsprachiges Modell mit der Formulierung in der Zielsprache
<voice>
Wechselt den Sprecher mitten im Skript
Eine separate Generierung pro Stimme oder Dialoge mit mehreren Sprechern in Eleven v3 und Eleven v4
<audio>
Fügt eine aufgezeichnete Audiodatei oder einen Klang ein
Soundeffekt-Audio-Tags in Eleven v3 und v4, das Soundeffekt-Tool von ElevenLabs oder Audiomischung nach der Generierung
Prosodie: Tonhöhe, Sprechgeschwindigkeit und Lautstärke mit SSML
Prosodie: Tonhöhe, Sprechgeschwindigkeit und Lautstärke mit SSML
Um das Tempo innerhalb eines Skripts zu ändern, teilen Sie den Text in separate Generierungen auf oder fügen Sie <break>-Tags zwischen den Sätzen ein. In Eleven v3 und v4 verwenden Sie die Audio Tags aus der obigen Tabelle, etwa [slowly], [rushed] und [whispers], direkt in der Zeile.
Um das Tempo innerhalb eines Skripts zu ändern, teilen Sie den Text in separate Generierungen auf oder fügen Sie zwischen Sätzen <break>-Tags ein. Bei Eleven v3 und v4 verwenden Sie die Audio Tags aus der Tabelle oben, etwa [slowly], [rushed] und [whispers], direkt in der Zeile.
Aussprache: <phoneme>, <say-as> und <sub> mit SSML
Das sind die wichtigsten Methoden:
- Verwenden Sie <phoneme> für eine einmalige Korrektur in Flash v2 oder Turbo v2, wie im obigen Beispiel.
- Verwenden Sie ein Aussprachewörterbuch für Begriffe, die in vielen Skripten wiederkehren. Ein Wörterbuch kann Phonemregeln und Alias-Regeln enthalten, die sich wie <sub> verhalten, zum Beispiel indem „UN“ „United Nations“ zugeordnet wird.
- Für Anwendungsfälle von <say-as>, etwa Zahlen, Daten, Währungen und Telefonnummern, nutzen Sie die Textnormalisierung, die geschriebene Werte in gesprochene Wörter umwandelt. Wenn ein Wert auf genau eine Weise gelesen werden muss, etwa eine Bestätigungsnummer, schreiben Sie ihn aus oder setzen Sie die Ziffern im Skript mit Leerzeichen.
Sprache und Gebietsschema
Sprache und Gebietsschema
Flash v2 und Turbo v2 sind ausschließlich englischsprachig. Skripte mit mehreren Sprachen benötigen daher ein mehrsprachiges Modell wie Multilingual v2, Flash v2.5, Eleven v3 oder Eleven v4. Eleven v4 und v3 unterstützen zudem Akzent-Tags wie [French accent] sowie IPA-Transkription in über 70 Sprachen.
Flash v2 und Turbo v2 sind nur für Englisch verfügbar. Skripte mit mehreren Sprachen benötigen daher ein mehrsprachiges Modell wie Multilingual v2,
Audio und Soundeffekte
Um Klang direkt in die Sprache einzufügen, schreiben Sie einfach das Soundeffekt-Tag, etwa [applause] oder [door slamming], und Eleven v4 und Eleven v3 setzen es um. Für längeres oder detaillierteres Sounddesign generieren Sie den Soundeffekt separat und mischen ihn in Ihrem Editor oder Produktionsworkflow mit der Sprachspur.
Um Klang direkt in die Sprache einzufügen, schreiben Sie einfach das Soundeffekt-Tag, etwa [applause] oder [door slamming], und erleben Sie, wie Eleven v4 und Eleven v3 es zum Leben erwecken. Für längeres oder detaillierteres Sounddesign
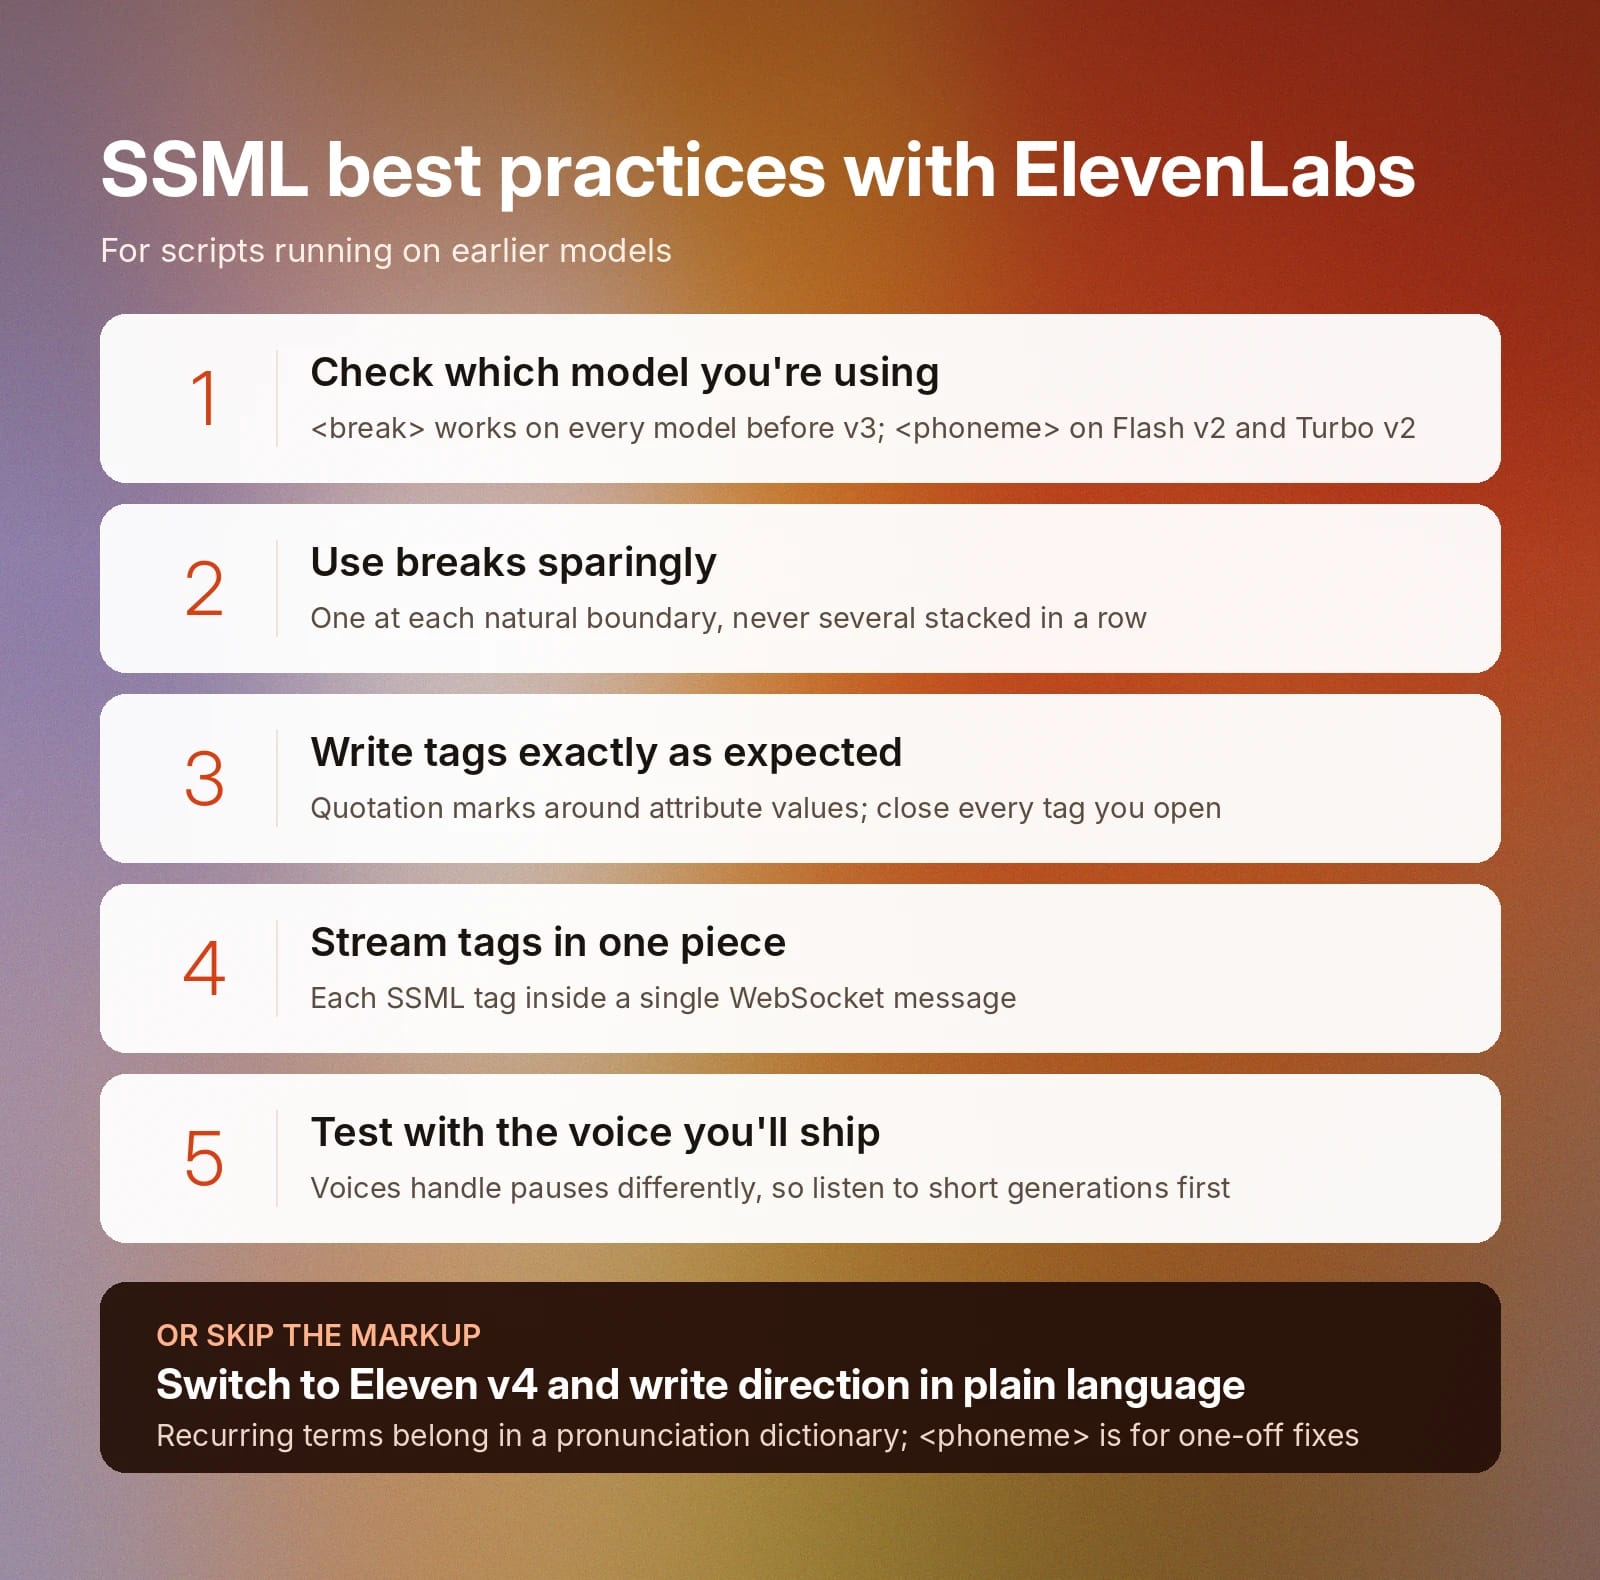
SSML-Best-Practices mit ElevenLabs
Bei der Arbeit mit SSML in ElevenLabs helfen Ihnen diese Tipps beim Einstieg:
- Prüfen Sie, welches Modell Sie verwenden: <break> funktioniert auf allen Modellen außer Eleven v3, <phoneme> nur auf Flash v2 und Turbo v2, und Audio Tags nur auf neueren Modellen wie Eleven v4 und Eleven v3.
- Verwenden Sie Breaks sparsam: Setzen Sie eines an jeder natürlichen Grenze, statt mehrere hintereinanderzustapeln.
- Schreiben Sie SSML-Tags korrekt: Behalten Sie die Anführungszeichen um Attributwerte bei, etwa <break time="2.0s" />, und schließen Sie jedes geöffnete Tag.
- Streamen Sie Tags vollständig: Senden Sie jedes SSML-Tag innerhalb einer einzelnen WebSocket-Nachricht.
- Testen Sie mit der Stimme, die Sie veröffentlichen: Stimmen verarbeiten Pausen unterschiedlich. Hören Sie sich daher kurze Generierungen an, bevor Sie ein vollständiges Skript ausführen. ElevenLabs bietet mehr als 17.500 Stimmen in unserer Stimmbibliothek.
Zusätzlich zu diesen Best Practices für SSML empfiehlt sich ein Aussprachewörterbuch für Begriffe, die häufig vorkommen. Für einmalige Korrekturen ist <phoneme> die beste Option.
Was sind die wichtigsten Anwendungsfälle für SSML?
Was sind die wichtigsten Anwendungsfälle für SSML?Prosodie in KI-generierte Sprache.
Hier sind einige Anwendungsfälle, in denen sich der Standard bewährt:
- Interactive-Voice-Response-Systeme (IVR): Nützlich, wenn ein IVR-System zwischen einer Ansage und einem Menü pausieren oder Zahlen deutlich vorlesen soll.
- Dialogorientierte Agenten: Eine kurze Pause vor einer Antwort einfügen, damit der Austausch natürlich klingt.
- Hörbücher und lange Erzählformate: Pausen an Kapitelenden und zwischen Szenen, um den Übergang klar zu markieren.
- E-Learning und Schulungen: Die Aussprache von Produktnamen, Fachbegriffen, Akronymen und unternehmensspezifischen Begriffen korrigieren.
- Benachrichtigungen und Warnungen: Steuern, wie Daten, Uhrzeiten und Referenzcodes vorgelesen werden.
SSML bietet zwar zahlreiche Anwendungsfälle, doch all diese lassen sich mit Audio Tags umsetzen, ohne häufig komplexe SSML-Tags auswendig lernen und in Skripte einfügen zu müssen. Eleven v4 und Eleven v3 haben das Audio-Tag-System entwickelt, um Nutzern volle Kontrolle über ihre KI-generierten Sprachausgaben ohne den Aufwand von SSML zu geben.
SSML bietet zwar eine Reihe von Anwendungsfällen, doch all dies lässt sich mit Audio Tags erreichen, ohne oft komplexe SSML-Tags auswendig lernen und in Ihre Skripte einfügen zu müssen. Eleven v4 und Eleven v3 haben das Audio-Tag-System entwickelt, damit Nutzer ihre KI-generierten Sprachausgaben ohne den Aufwand von SSML vollständig steuern können.
Warum Eleven v4 Audio Tags statt SSML verwendet
- Emotionen oder Gefühle wie [sad] oder [excited]
- Sprechweise und Tempo wie [whispers] oder [rushed]
- Menschliche Reaktionen wie [sighs] oder [laughs]
- Akzente und Charakterstimmen wie [French accent]
- Soundeffekte wie [applause] oder [door shutting]
Der Grund für dieses Design liegt darin, wie das Modell Kontext in Gesprächen liest. Die Architektur von Eleven v4 erfasst Kontext umfassender als frühere Modelle und kann dadurch emotionale Signale, Tonwechsel, Sprecherwechsel und Kontextinformationen ohne separate Parameter oder Einstellungen berücksichtigen.
SSML gibt an einer festen Stelle im Text spezifische Anweisungen, wodurch die Sprechweise starr und abgehackt wirken kann. SSML ist einer der Hauptgründe, warum KI-Text trotz hochwertiger zugrunde liegender Modelle roboterhaft klingt.
Ein Hinweis wie [whisper] gibt Eleven v4 eine Interpretationsvorgabe, die auf die umgebende Zeile angewendet und durch die Prosodie des gesamten Umfelds geprägt wird.
Die meisten SSML-Elemente haben ein direktes v4-Äquivalent:
SSML-Tag
Funktion
Eleven-v4-Äquivalente
<break time="1s">
Fügt eine Pause ein
[pause], Auslassungspunkte oder ein Zeilenumbruch
<prosody rate="slow">
Verlangsamt die Sprache
[drawn out] oder [slowly]
<prosody rate="fast">
Beschleunigt die Sprache
[rushed]
<emphasis>
Betont ein bestimmtes Wort
[shouts] oder ein Wort großschreiben
<prosody pitch="high">
Erhöht die Tonhöhe
Emotionale Tags wie [excited]
<prosody pitch="low">
Senkt die Tonhöhe
Emotionale Tags wie [sorrowful]
Für die Aussprache gilt das gleiche Ersatzmuster. IPA wird in Eleven v4 nativ unterstützt, mit Transkription in über 90 Sprachen. So können Teams die Aussprache ohne XML-Tags steuern, indem sie die Transkription direkt zwischen Schrägstrichen in den Text einfügen.
Für die Aussprache gilt dasselbe Ersetzungsmuster. IPA wird von Eleven v4 nativ unterstützt, mit Transkription in über 90 Sprachen. So können Teams die Aussprache ohne XML-Tags steuern, indem sie Transkriptionen direkt im Text in Schrägstriche setzen.
Starten Sie mit natürlich klingender Sprache in ElevenCreative
Erleben Sie, wie Audio Tags mit Eleven v4 zu fertigem Audio werden, oder erstellen Sie ein kostenloses Konto, um SSML und Audio Tags noch heute mit eigenen Skripten auszuprobieren.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.