
Was ist Prosodie und wie prägt sie gesprochene Sprache?
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Prosodie umfasst Rhythmus, Betonung und Intonation beim Sprechen – Muster, die unseren Worten über ihre wörtliche Bedeutung hinaus Sinn geben. Wie hoch oder tief unsere Stimme ist, wie schnell wir sprechen und welche Wörter wir betonen, beeinflusst, wie Sprache vermittelt und verstanden wird.
Früher beschrieb Prosodie nur menschliche Sprache. Heute wird sie auch für die KI-Stimmtools, die sie erzeugen sollen, immer wichtiger. Sie entscheidet maßgeblich darüber, ob KI menschlich wirkt – es geht nicht mehr nur darum, die richtigen Worte in die richtige Reihenfolge zu bringen, sondern auch um die feinen Modulationen, die Bedeutung vermitteln. Das gilt besonders in Bereichen wie Kundenservice oder Audio-Narration, wo ein falsch gesprochenes Wort die gesamte Botschaft schwächen kann.
Dieser Artikel erklärt, was Prosodie ist, zeigt Beispiele und erläutert ihre Bedeutung für Text to Speech-Modelle (TTS), damit Sie verstehen, was nötig ist, damit KI menschlicher klingt und wirkt.
Zusammenfassung
- Prosodie beim Lesen spiegelt das Textverständnis einer lesenden Person wider und fördert die Leseflüssigkeit.
- Prosodie ermöglicht Text to Speech-Modellen, einfachen Text in natürlich klingendes, menschliches Audio umzuwandeln.
- Prosodie lässt sich KI-Stimmen über Tools wie Stimmenauswahl, Audiotags und Satzzeichen hinzufügen.
Was ist Prosodie?
Prosodie bezeichnet die Muster von Tonhöhe, Timing und Betonung beim Sprechen. Dazu gehört sowohl die Art, wie etwas klingt (etwa Phoneme) als auch die emotionale Färbung hinter den Worten – etwa ob Sie einen Befehl, eine Frage oder eine Aussage äußern oder sarkastisch sind.
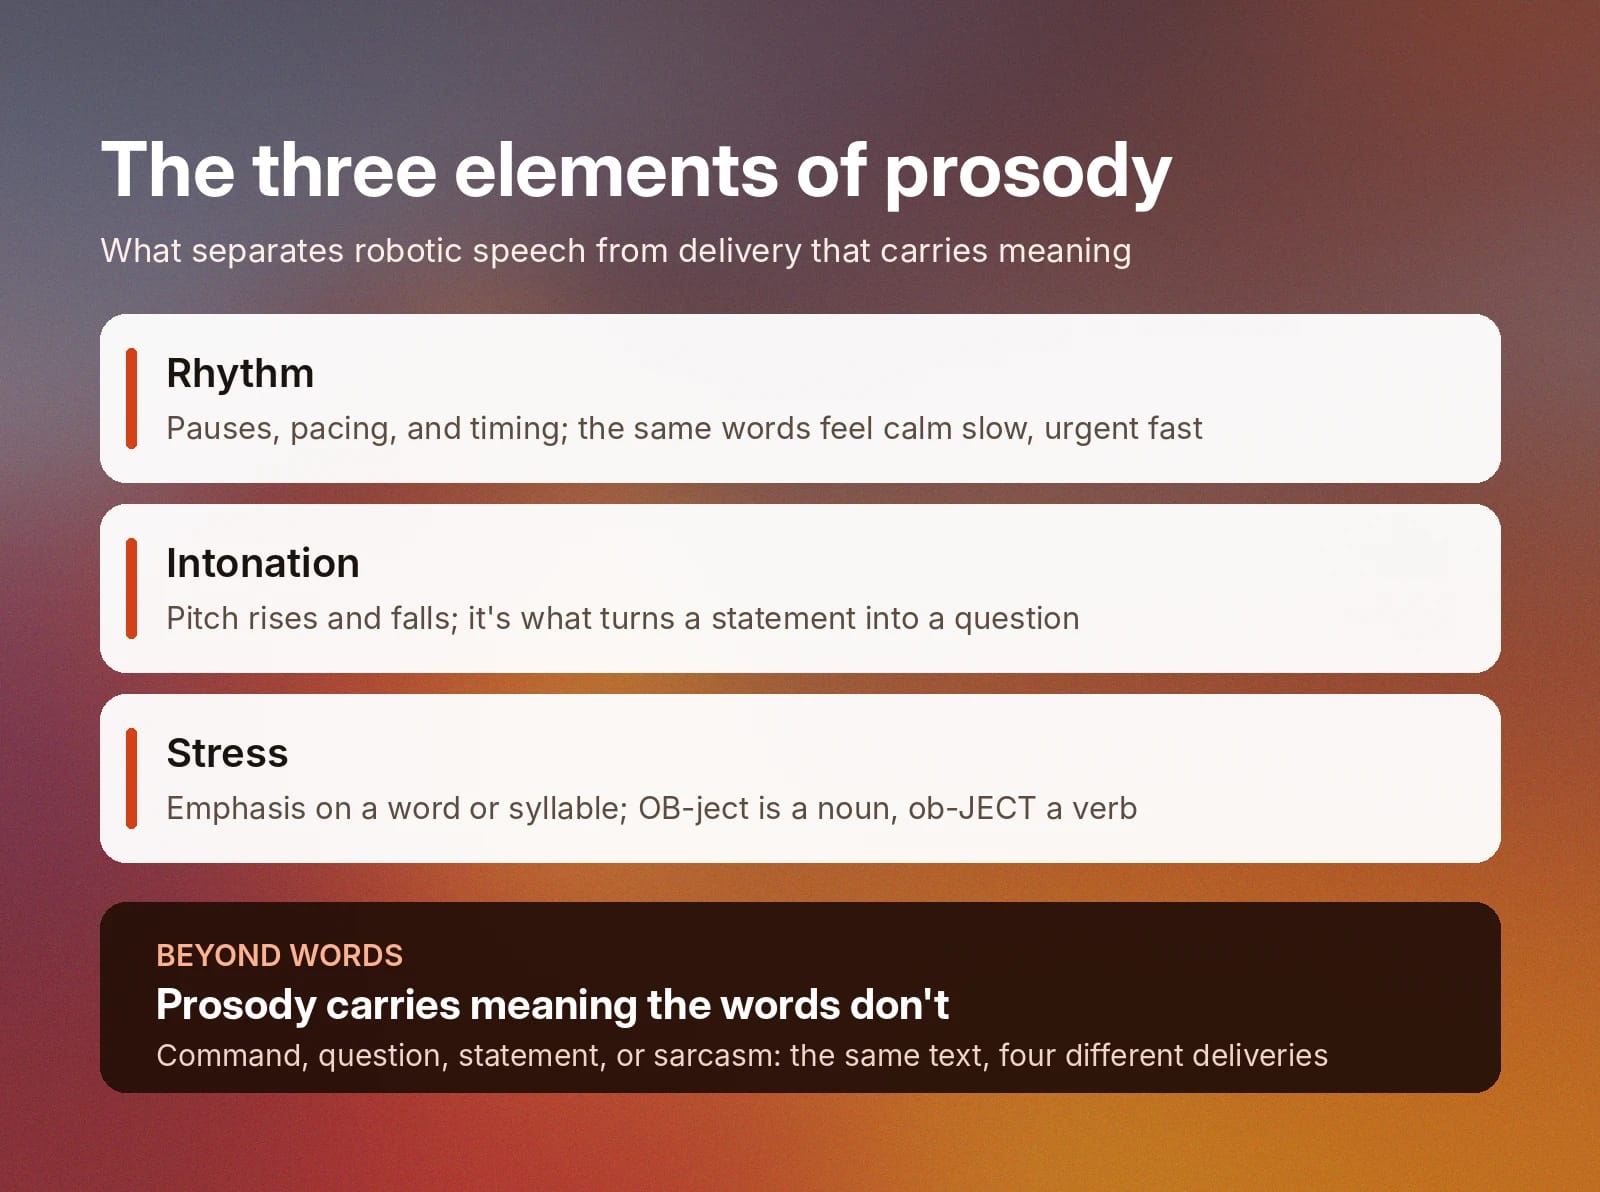
Bei der Bewertung von Prosodie betrachten wir in der Regel drei Elemente:
- Rhythmus: Wie Timing und Sprechtempo Muster erzeugen.
- Intonation: Wie die Tonhöhe innerhalb eines Satzes steigt und fällt.
- Betonung: Wie bestimmte Wörter oder Silben durch Tonhöhe, Lautstärke oder Dauer hervorgehoben werden.
Diese drei Elemente steuern zu können, unterscheidet ====--ic Sprache von einer Sprechweise, die über die Worte selbst hinaus Bedeutung vermittelt.
Prosodie beim Sprechen verstehen: Rhythmus, Intonation und Betonung
Auch wenn sie einfach wirken, tragen Rhythmus, Intonation und Betonung wesentlich dazu bei, die Gefühle hinter unseren Worten zu vermitteln.
Hier sehen Sie genauer, wie diese drei Kernelemente die Sprache beeinflussen.
Rhythmus
Der Rhythmus bestimmt Pausen, Tempo und Timing, die der Sprache Struktur geben. In romanischen Sprachen wie Französisch und Spanisch erhält jede Silbe tendenziell gleich viel Zeit, während Englisch und Deutsch beim Timing und Tempo der Wörter stärker variieren.
Der Rhythmus kann auch verändern, wie ein Satz wirkt. Wenn man „Wir sind unterwegs“ langsam und gleichmäßig sagt, klingt es beruhigend. Schnell gesagt wirken dieselben Worte gedrängt und erzeugen ein Gefühl von Dringlichkeit.
Langsamere Sprechweise
Intonation
Intonation beschreibt, wie die Tonhöhe steigt und fällt. Sie unterscheidet oft eine Frage von einer Aussage.
Betrachten Sie diesen Satz: „Jim hat das Spiel gewonnen.“ Endet er mit einem Punkt, wird „gewonnen“ auf derselben Tonhöhe wie die übrigen Wörter gesprochen. Soll er jedoch eine Frage ausdrücken („Jim hat das Spiel gewonnen?“), steigt die Tonhöhe am Ende.
Sie kann auch Emotionen ausdrücken. Ein begeistertes „Hallo!“ hat eine andere Tonhöhe als ein enttäuschtes oder desinteressiertes „Hallo.“
Jim hat das Spiel gewonnen
Betonung
Betonung beschreibt, wie ein Wort oder ein Teil eines Wortes hervorgehoben wird.
Das Wort „umfahren“ hat beispielsweise zwei Bedeutungen. Liegt die Betonung auf der ersten Silbe („UMfahren“), meint es, etwas zu umfahren. Die Betonung auf der zweiten Silbe („umFAHren“) bedeutet dagegen, etwas mit einem Fahrzeug anzufahren.
In einem Satz lenkt Betonung den Fokus auf ein Wort. Die Betonung von „ich“ in „Ich habe Jim beim Spiel gesehen“ zeigt der zuhörenden Person, dass es wichtig ist zu wissen, wer Jim beim Spiel gesehen hat. Wird dagegen „Spiel“ betont, verweist das darauf, wo Jim gesehen wurde.
Wie beeinflusst Prosodie das Lesen?
Prosodie beim Lesen gibt Wörtern Kontext. Stellen Sie sich vor, Sie lesen einem Kind eine Geschichte vor: Ohne unterschiedliche Stimmen und Tonlagen könnte das Kind schwerer erkennen, was eine Figur fühlt oder was eine Szene ausdrückt.
Prosodie ist außerdem ein zuverlässiger Indikator für Leseflüssigkeit. Menschen, die eine Sprache fließend beherrschen, können geschriebenen Wörtern prosodische Betonung hinzufügen. Das zeigt, dass sie nicht nur die Wörter verstehen, sondern auch die Bedeutung dahinter, die nicht auf der Seite steht.
Insgesamt verbessert Prosodie Lese- und Sprachkompetenz, indem sie Wörtern und Formulierungen Kontext gibt. Sie verringert Missverständnisse, indem sie die Bedeutung von Wörtern mit dem Publikum oder der Situation verbindet, in der sie gesprochen werden.
Warum ist Prosodie für Text to Speech-Modelle wichtig?
Die Wörter, die ein Text to Speech-Modell in Audio umwandelt – ob aus einem Skript oder von einem LLM generiert –, beginnen als einfacher Text. Die Wörter können genau richtig sein, doch Text allein vermittelt keine Tonlage, Betonung oder Gefühle.
Denken Sie an einen klassischen IVR-Bot, der sagt: „Es tut mir leid. Das habe ich nicht verstanden.“ Diese Aussage wird typischerweise mit flacher Prosodie gesprochen. Deshalb haben die meisten Zuhörenden nicht den Eindruck, dass dem Bot die verursachten Unannehmlichkeiten wirklich leidtun.
Vergleichen Sie dieses Szenario mit einem KI-Sprachagenten, der einem frustrierten Kunden hilft, dessen Flug gestrichen wurde.
Die Antwort wirkt menschlich, wenn der KI-Agent sagt: „Ich verstehe Sie, und es tut mir wirklich leid“, denn die Antwort klingt nicht eintönig. Sie enthält ein leichtes Seufzen, eine Pause am Anfang und eine tiefe Tonlage – all das vermittelt die Entschuldigung ebenso wie die Worte.
Wenn der Agent diese prosodischen Elemente richtig einsetzt, kann er eine angespannte Situation entschärfen, statt die Frustration noch zu verstärken.
Text to Speech-Modelle leisten mehr als KI-Agenten. Sie sind auch die Grundlage der Tools von ElevenCreative für Voiceovers, Narration und Marketinginhalte. Eine KI-Stimme, die Prosodie korrekt einsetzt, unterstützt Sie bei:
- Voiceovers: Erstellen Sie Werbung, Erklärvideos und Social-Media-Inhalte, die wirklich fesselnd klingen.
- Hörbüchern: Erzählen Sie mit der passenden emotionalen Nuance, sodass Angst, Freude oder Sarkasmus einer Figur so deutlich werden wie bei menschlichen Sprecherinnen und Sprechern.
- Lokalisierung: Bewahren Sie die emotionale Absicht des Originalinhalts über Sprachen hinweg.
- Marketing- und Markenbotschaften: Sorgen Sie für den passenden Ton und vermeiden Sie eine ernste Sprechweise, wenn sie lebhaft sein sollte – oder umgekehrt.
Prosodie macht all das möglich. Sehen wir uns als Nächstes an, wie Text to Speech-Modelle sie tatsächlich erzeugen.
Wie TTS-Modelle Prosodie erzeugen
Heutige neuronale Text to Speech-Modelle (neuronales TTS) erzeugen Prosodie mit Deep-Learning-Modellen, die mit echter menschlicher Sprache trainiert wurden. Statt handgeschriebenen phonetischen Regeln zu folgen, lernt das Modell die Beziehung zwischen Text und seinem tatsächlichen Klang beim Vorlesen.
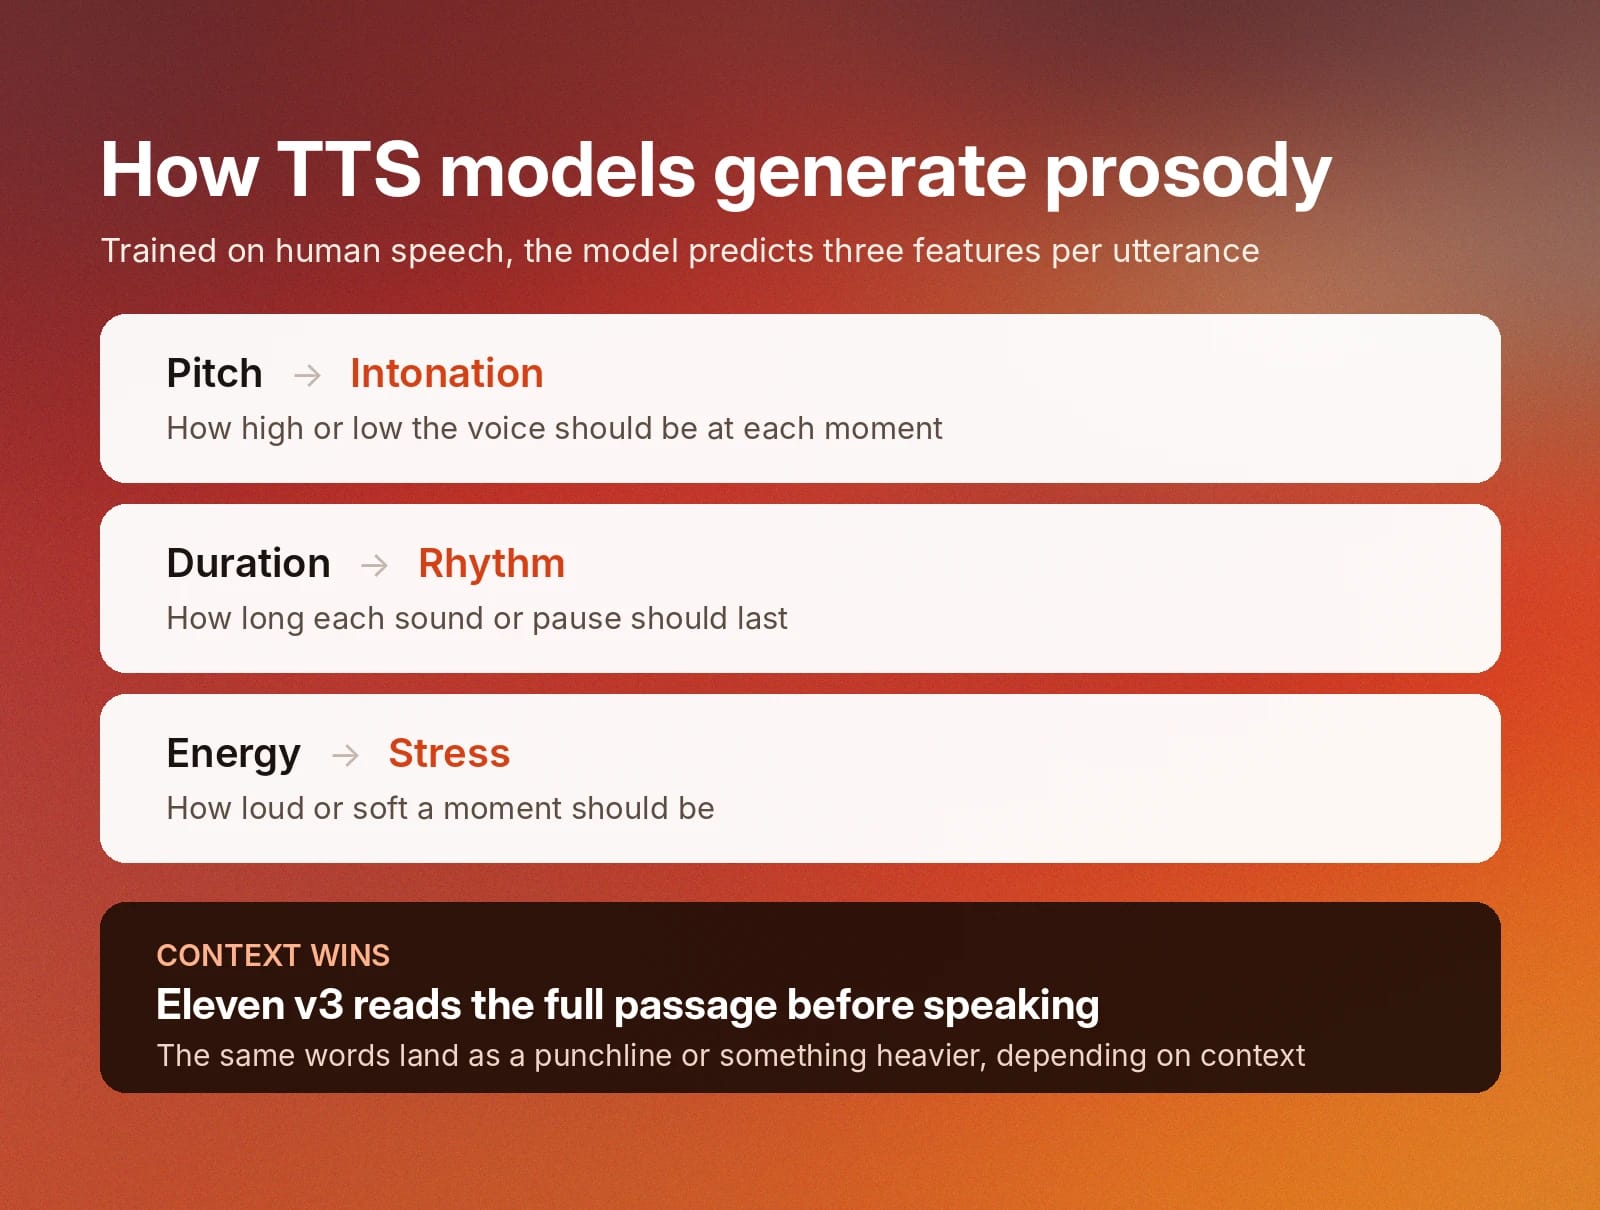
Dieser Trainingsprozess ermöglicht dem TTS-Modell, drei Merkmale innerhalb einer Äußerung vorherzusagen:
- Tonhöhe: Wie hoch oder tief die Stimme sein sollte, wodurch Intonation entsteht.
- Dauer: Wie lange jeder Laut oder jede Pause dauern sollte, wodurch Rhythmus entsteht.
- Energie: Wie laut oder leise ein Moment sein sollte, wodurch Betonung und Hervorhebung entstehen.
Ein Modell, das mit Tausenden Stunden menschlicher Sprache trainiert wurde, hat zum Beispiel unzählige Fragen gehört, die Ungläubigkeit ausdrücken, wie „Warte, du hast was gemacht?“, gesprochen mit einem starken Anstieg der Tonhöhe und einem Energieschub beim letzten Wort. Durch wiederholte Beispiele lernt es dieses Muster und verwendet dieselbe Sprechweise, wenn es erneut auf eine Formulierung trifft, die dieselbe Art von Unglauben ausdrückt.
Wie viel Kontext ein Modell bei der Erzeugung dieser Sprechweise nutzen kann, hängt jedoch auch von der Architektur ab, die die Vorhersage trifft.
Ältere TTS-Modelle arbeiteten mit einer Pipeline: Sie verarbeiteten Text Satz für Satz und übergaben Vorhersagen zwischen getrennten Netzwerken, bevor sie Audio erzeugten. Neuere transformerbasierte Modelle fassen diese Pipeline in einem einzigen End-to-End-Prozess zusammen.
Statt einen Satz isoliert zu lesen, liest das Modell zunächst den gesamten Abschnitt und nutzt dann diesen breiteren Kontext, um zu entscheiden, wie eine Zeile klingen soll. Dieselben Wörter können je nach umgebendem Text als Pointe oder als etwas weitaus Schwerwiegenderes wirken.
Modelle wie Eleven v3 lesen den vollständigen Abschnitt, bevor sie Audio erzeugen, damit die Sprechweise den Kontext des umgebenden Textes widerspiegelt.
Wie Nutzer Prosodie in TTS steuern
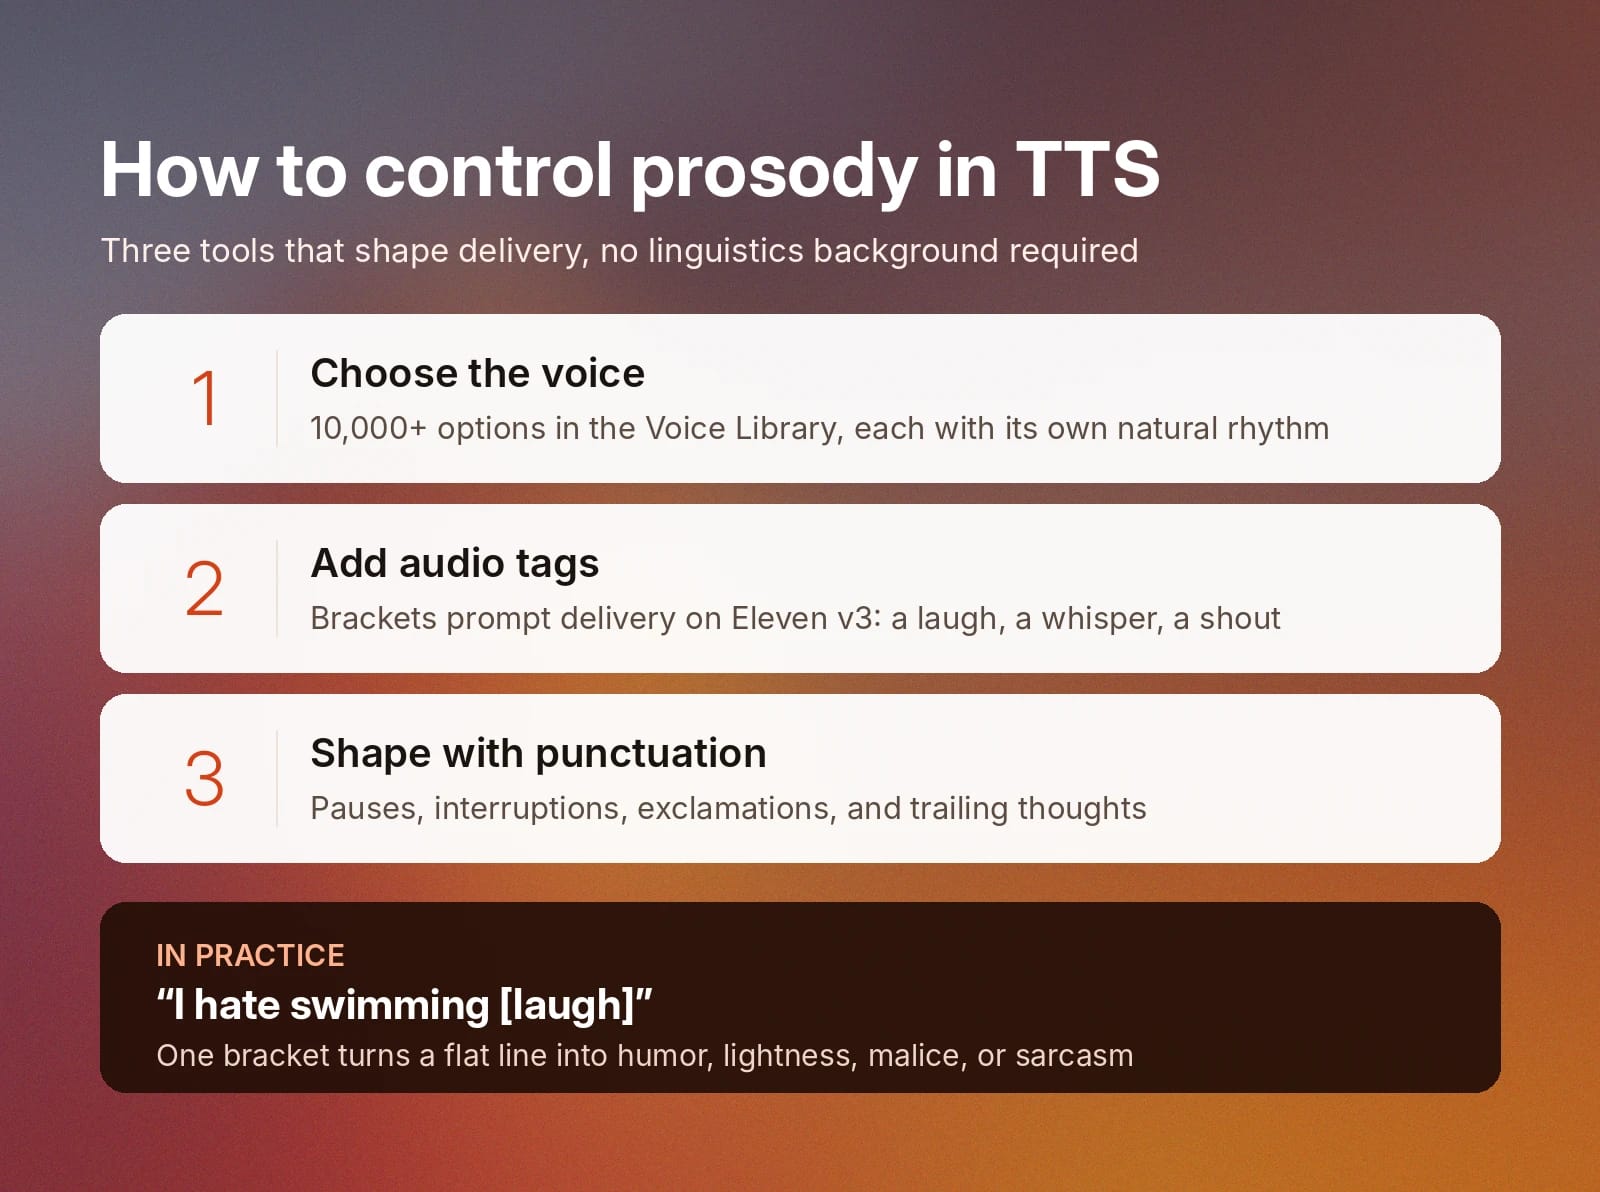
Nutzer können Prosodie in TTS steuern, indem sie einzigartige KI-Stimmen auswählen und emotionale Tags in Skripte einfügen. ElevenCreative bietet Ihnen beispielsweise Zugriff auf die Stimmbibliothek, in der Sie aus mehr als 10.000 Stimmen diejenige mit dem gewünschten natürlichen Rhythmus und der passenden Intonation auswählen können.
Eleven v3, unser ausdrucksstärkstes TTS-Modell, bietet Ihnen außerdem die Möglichkeit, Audiotags hinzuzufügen – in eckigen Klammern im Text –, um das Modell zu einer bestimmten prosodischen Nuance anzuleiten. Vielleicht möchten Sie zwischen Sätzen ein Lachen einfügen, um Humor, Leichtigkeit, Bosheit oder Sarkasmus zu zeigen, oder ein Wort zur Betonung flüstern oder rufen lassen. Auch Satzzeichen können Pausen, Unterbrechungen, Ausrufe, Fragen oder ausklingende Stimmelemente erzeugen.
So könnte das aussehen:
- „[laughing] Ich hasse Schwimmen.“
- „[surprised] Ich kann nicht glauben, dass er das getan hat! Ich bin schockiert … und beeindruckt.“
- „[annoyed] Mach das nicht!"
Sehen wir sie in Aktion:
Zusammen bedeuten diese Tools, dass Sie keinen Hintergrund in Linguistik oder Audioproduktion brauchen, um Prosodie zu steuern. Jeder kann beeinflussen, wie eine KI-Stimme klingt – einfach durch die Auswahl einer Stimme, das Hinzufügen eines Tags oder das Anpassen der Satzzeichen.
Ausdrucksstarke KI-Stimmen mit ElevenCreative verbessern
Ob Sie Werbung schalten, in sozialen Medien posten oder Videos erstellen: Sie möchten, dass sie so klingen, als hätte eine echte Person sie erstellt und gesprochen.
Mit ElevenCreative können Sie Audio und visuelle Inhalte in wenigen Minuten in großem Umfang erstellen. Die KI-native Plattform verwandelt geschriebenen Text in menschenähnliche Sprache, die auf Kontext, Emotion und Absicht der sprechenden Person abgestimmt ist. Mit über 70 Sprachen in Eleven v3 und einer umfangreichen Stimmbibliothek können Sie sicher sein, bei Ihrem Publikum den richtigen Ton zu treffen.
Erfahren Sie mehr über TTS in ElevenCreative oder registrieren Sie sich, um zu starten und zu sehen, wie KI-Stimmen mit natürlicher Prosodie Ihre Inhalte verändern können.
Häufige Fragen zur Prosodie

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.

