Mit Google anmelden




Wie Ihr Transkript erkennt, wo jedes Wort gesprochen wird
- Kategorie
- Forschung
- Datum
Starter für 1 $Sichern Sie sich Ihren ersten Monat Starter für 1 $
Starter für 1 $Sichern Sie sich Ihren ersten Monat Starter für 1 $

Wir stellen Eleven v4 vorLernen Sie Eleven v4 kennen, unser bisher ausdrucksstärkstes Modell.
Vertraut von über 1 Mio. Nutzern · Kostenlos starten
Ausgewählt für Ihren Anwendungsfall
Ausgewählt für Ihren Anwendungsfall
Stimme auswählen
Sprache generieren
Neueste Modellveröffentlichung
Erstellen Sie steuerbare, ausdrucksstarke Sprache mit Emotionen, Audioereignissen und immersiven Klanglandschaften.
Unsere Voice-KI reagiert auf emotionale Hinweise im Text und passt die Sprechweise sowohl an den unmittelbaren Inhalt als auch an den weiteren Kontext an. So erreichen unsere KI-Stimmen eine große emotionale Bandbreite und vermeiden logische Fehler beim Vorlesen Ihrer Inhalte.
Erstellen Sie steuerbare, ausdrucksstarke Sprache mit Emotionen, Audioereignissen und immersiven Klanglandschaften.
Die Stimme hielt einen Moment inne, [leise] als ob sie ihre Gedanken sammelte, bevor sie fortfuhr. Jeder Atemzug wirkte absichtlich, jede Zögerung perfekt getimt.
Das war keine synthetische Sprache mehr [lacht herzlich] - es war eine Stimme, die Timing, Emotion und den Raum zwischen den Worten verstand.
Text verwandelte sich in Präsenz. [seufzt zufrieden] Worte erhielten Leben, Persönlichkeit, Seele.
 Rachel
Entdecken Sie eine stetig wachsende Sammlung ausdrucksstarker, lebensechter Stimmen für jeden Einsatzbereich – von Erzählungen bis zu Charakteren.
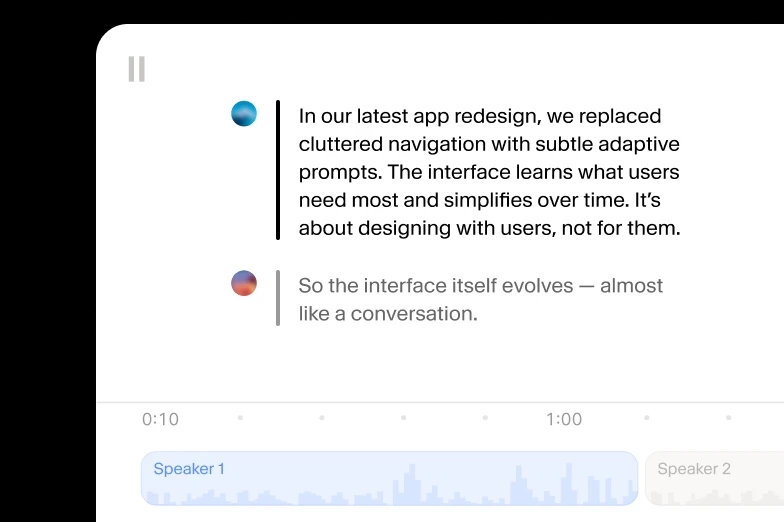
Erstellen Sie Audiogespräche, in denen Sprecher Kontext und Emotionen teilen.
Replizieren Sie sofort Ihre eigene Stimme oder gestalten Sie einzigartige KI-Stimmen mit voller Kontrolle.
Erwecken Sie Geschichten in über 70 Sprachen zum Leben – mit muttersprachlicher Emotionalität und Klarheit.
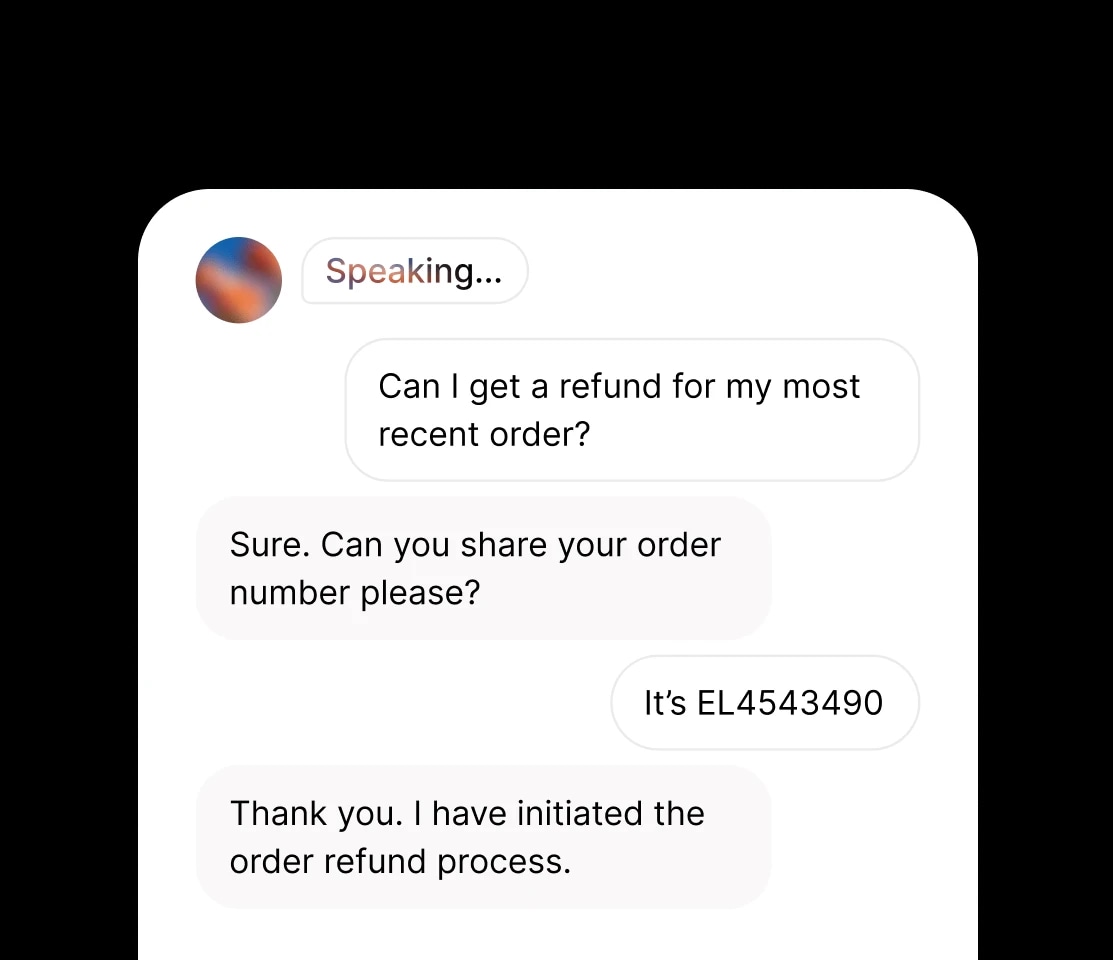
Unser schnellstes und emotionalstes Stimmenmodell für ausdrucksstarke Sprache mit Emotionen, Audioereignissen und Klanglandschaften
Unser fortschrittliches, ausdrucksstarkes Modell mit Audio-Tags für präzise emotionale Steuerung. Ideal für Storytelling, Gaming und Medienproduktion in über 70 Sprachen.
Unser lebensechtes, emotional reiches Text to Speech-Modell unterstützt 29 Sprachen. Ideal für Voiceovers, Hörbücher, Postproduktion und Content-Erstellung.
Unser schnelles, erschwingliches Sprachsynthesemodell. Ideal für Entwickler-Anwendungsfälle, bei denen Geschwindigkeit zählt und nicht-englische Sprachen erforderlich sind.
10k Credits pro Monat
Preise exkl. Steuern, Abgaben und Zölle. Alle Preismodelle anzeigen.

Daten werden bei der Übertragung und Speicherung verschlüsselt. SOC 2, HIPAA und DSGVO-Compliance werden unterstützt. Für strengere Datenkontrolle stehen EU Data Residency und Zero Retention zur Verfügung.
Daten werden bei der Übertragung und Speicherung verschlüsselt. SOC 2, HIPAA und DSGVO-Compliance werden unterstützt. Für strengere Datenkontrolle stehen EU Data Residency und Zero Retention zur Verfügung.
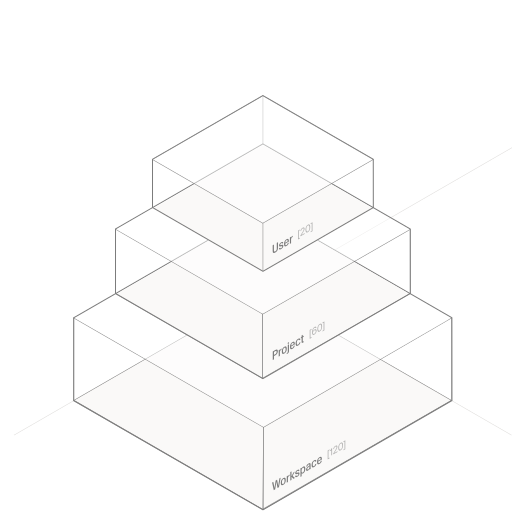
Legen Sie granulare Teamberechtigungen fest und arbeiten Sie unternehmensweit zusammen, indem Sie Stimmen, Assets und Ressourcen über Ihre Agenten und Ihre Content-Produktionspipeline hinweg teilen.
Unser Team sorgt für einen reibungslosen Start und zuverlässige Abläufe – mit konsistenter Leistung und Sicherheit.
Die besten KI-Audiomodelle in einem leistungsstarken Editor.
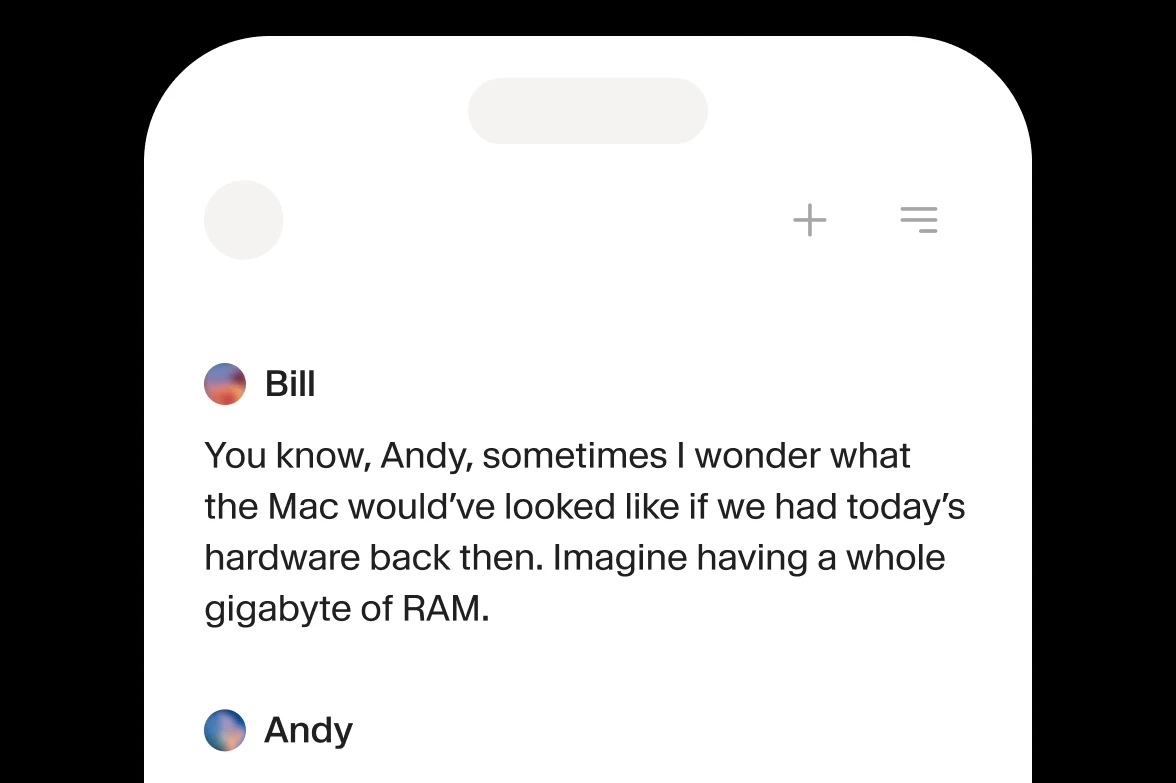
Erstellen Sie in Sekunden ausdrucksstarkes Audio mit unseren iOS- und Android-Apps.
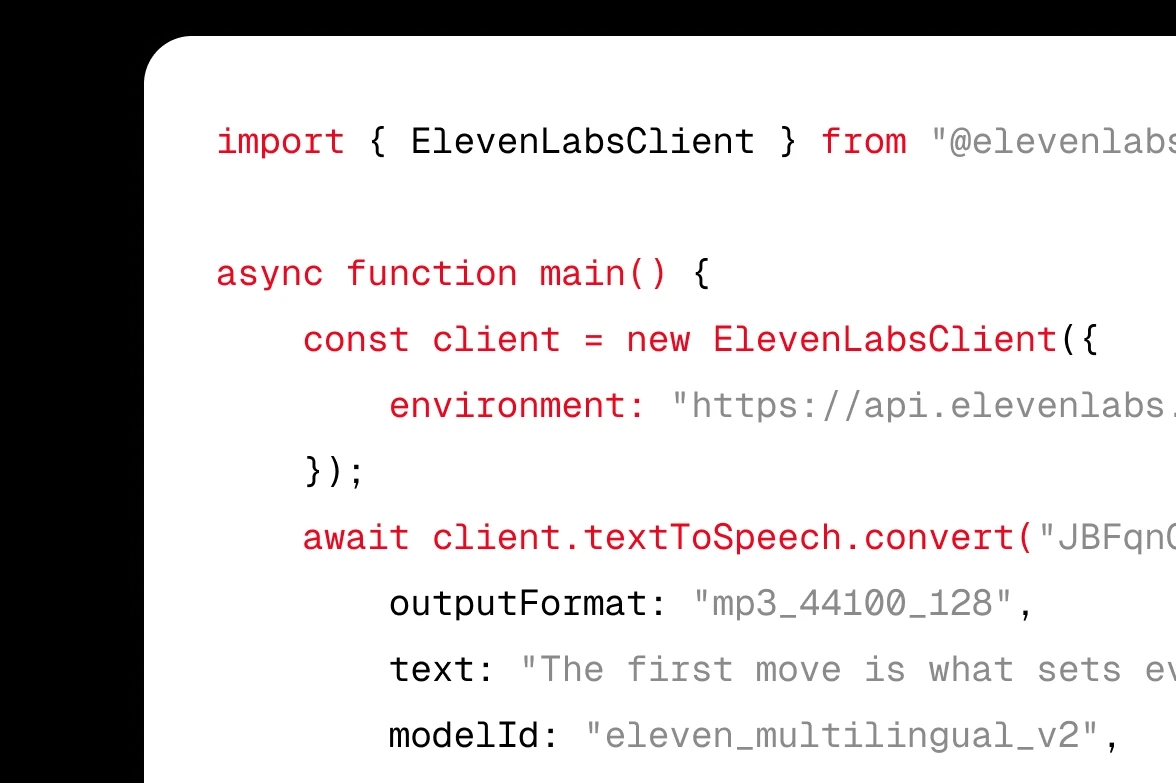
Integrieren Sie ElevenLabs Text to Speech (TTS) über APIs oder SDKs in Ihr Produkt.