Text to Speech API-Integration: Streaming, Batching, Retries
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Die Integration einer Text to Speech API ist einfach … nach einigen konkreten Entscheidungen: Welchen Übertragungsmodus Sie verwenden, wie Sie Modell und Ausgabeformat wählen, wie Sie streamen, wie Sie hohe Volumen verarbeiten, ohne Ihr Parallelitätslimit zu überschreiten, wie Sie cachen und Wiederholungen handhaben, damit Sie nie zweimal für dieselbe Audiogenerierung zahlen, und wie Sie die Zeit bis zum ersten Byte mit einem anderen Anbieter vergleichen.
Um Sie bei der Integration einer Text to Speech API zu unterstützen, haben wir jede dieser Architekturentscheidungen und die jeweiligen Maßnahmen aufgeschlüsselt. Dieser Leitfaden hilft Ihnen, die ElevenLabs Text to Speech API zu integrieren und zu skalieren – mit Codebeispielen, die Sie direkt in die Produktion übernehmen können.
Einen umfassenden Hintergrund zu den hier genannten Konzepten finden Sie in unseren Leitfäden zum Verständnis von Audio-Streaming, zur Latenzoptimierung und zur ElevenLabs-Modellübersicht.
Zusammenfassung
- Es gibt einen ElevenLabs Text to Speech API-Endpunkt, auf den Sie auf drei Arten zugreifen können: Batch-Konvertierung, HTTP-Stream und stream-input-WebSocket.
- Über HTTP zählt jede laufende Anfrage zu Ihrem Parallelitätslimit, während über WebSocket nur die aktive Generierung zählt.
- Begrenzen Sie Ihre Parallelität knapp unter Ihrem Planlimit und cachen Sie einen Hash jedes Parameters, der die Ausgabe beeinflusst, damit derselbe Text nie zweimal abgerechnet wird.
- Wiederholen Sie 429- und 5xx-Fehler mit exponentiellem Backoff und Full Jitter, um frühzeitig zu drosseln, bevor Sie das Parallelitätslimit erreichen.
Drei Möglichkeiten zur Integration der Text to Speech API
Es gibt einen Text to Speech-Endpunkt, aber Ihre Integrationsmethode bestimmt Latenz, Komplexität und Kosten.
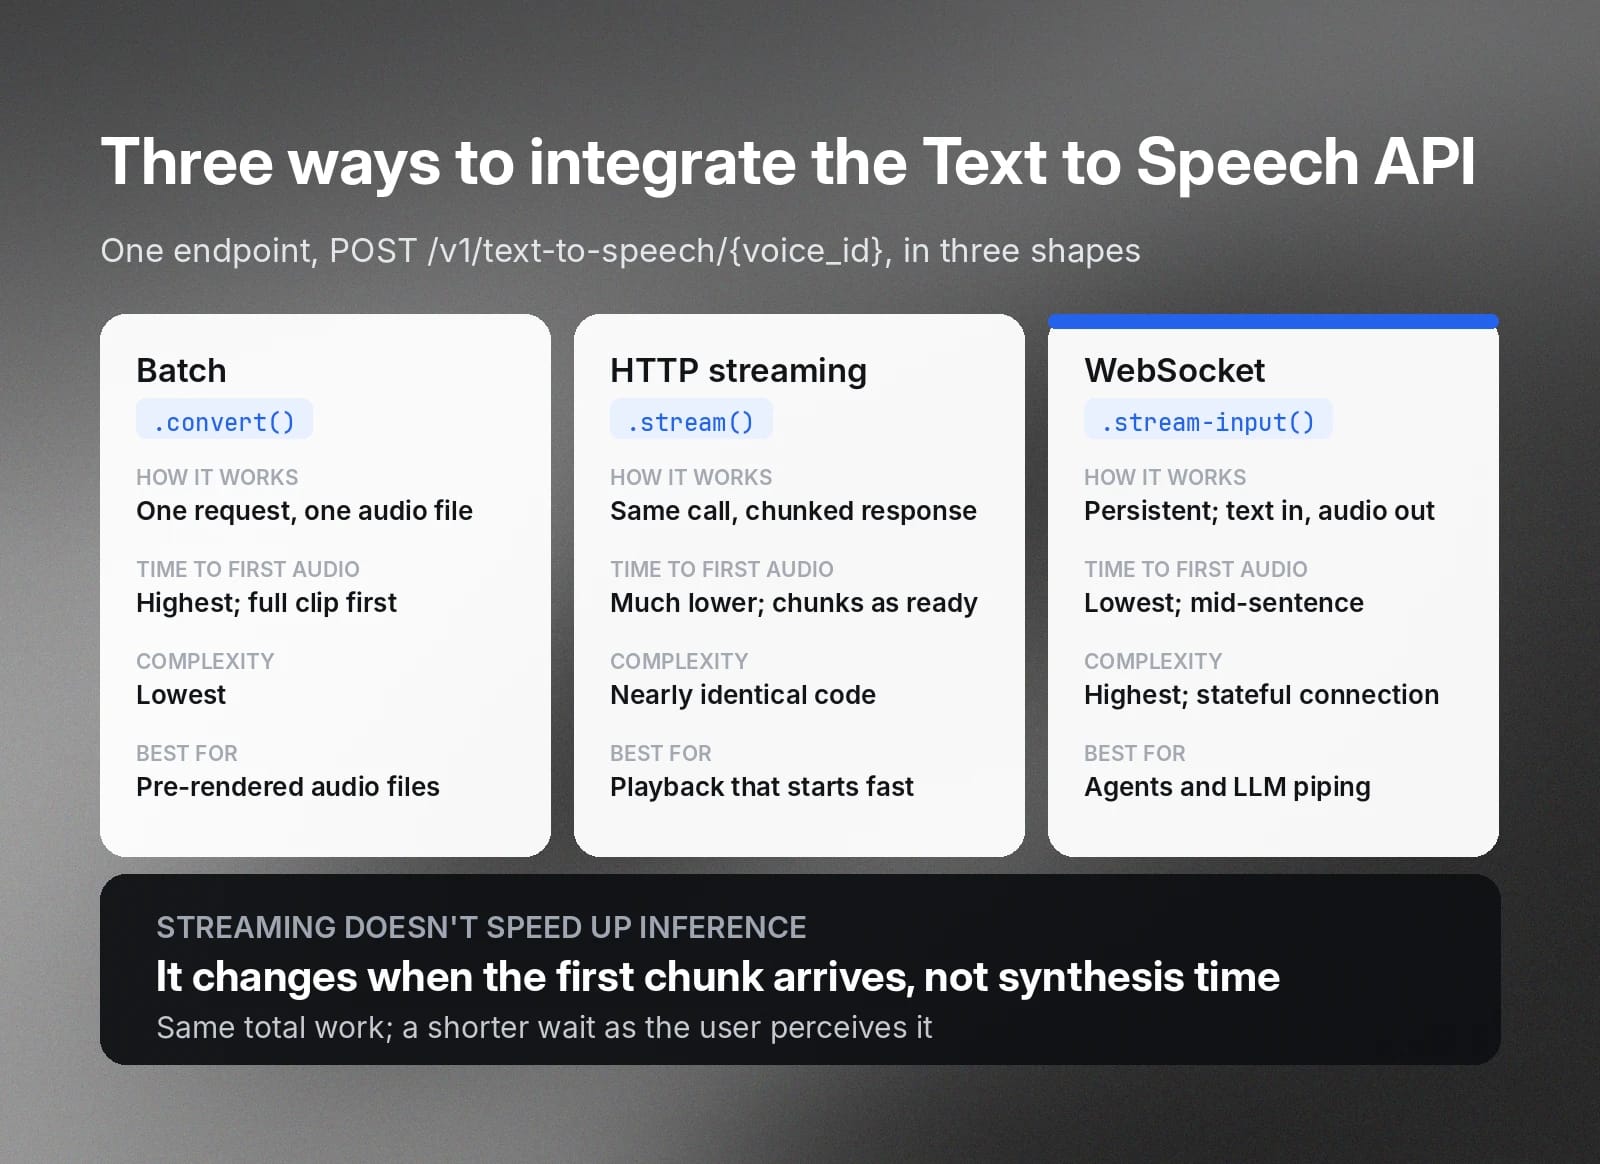
Derselbe Aufruf POST /v1/text-to-speech/{voice_id} funktioniert in drei Varianten, die jeweils für leicht unterschiedliche Aufgaben geeignet sind. Hier ist eine Übersicht aller drei Möglichkeiten zur Integration der Text to Speech API:
- Batch (convert) ist die einfachste Integration: Sie senden eine Anfrage und erhalten eine Audioantwort. Diese Option ist am wenigsten komplex und hat die längste Zeit bis zum ersten Audio, da der gesamte Clip synthetisiert wird, bevor die ersten Bytes zurückkommen.
- HTTP-Streaming (stream) nutzt dieselbe Anfrage, überträgt die Antwort jedoch in Chunks: Sie hängen /stream an den Pfad an, rufen die stream-Methode auf und erhalten das Audio als Chunked Response. Der Code ist nahezu identisch, die wahrgenommene Latenz aber deutlich geringer.
- Der WebSocket (stream-input) hält eine persistente Verbindung: Sie senden Text schrittweise und erhalten dabei Audio-Chunks zurück. Er ist für interaktive Agents konzipiert und dafür, die Ausgabe eines LLMs während der Token-Generierung in Sprache umzuwandeln, noch bevor der Satz fertig ist.
Streaming erzeugt Audio nicht schneller; die Inferenzzeit bleibt gleich. Streaming verändert, wann Sie den ersten Chunk erhalten: Er wird gesendet, bevor der gesamte Clip fertig ist. Dadurch verkürzt sich die vom Nutzer wahrgenommene Wartezeit, obwohl der Gesamtaufwand gleich bleibt.
Entscheidungstabelle: Batch vs. Streaming vs. WebSocket
Bei der Wahl zwischen diesen drei Methoden sollten Sie mehrere Faktoren berücksichtigen.
Als Kurzleitfaden: Wählen Sie Batch für Offline-Rendering, HTTP-Streaming für bekannten Text, auf den ein Nutzer wartet, und WebSocket für Agents und Live-LLM-zu-Sprache.
Die Tabelle unten zeigt die Abwägungen in den Dimensionen, die bei Skalierung entscheidend sind.
Über HTTP zählt jede laufende Anfrage – ob Batch oder Streaming – während ihrer gesamten Dauer zu Ihrem Parallelitätslimit. Über einen WebSocket zählt nur die Zeit, in der das Modell aktiv Audio generiert; ein offener, aber inaktiver Socket verursacht nahezu keine Kosten.
Bei einem kaskadierten Voice Agent, der während eines gesamten Gesprächs eine Verbindung offen hält, aber nur während der Sprechzüge des Agents Audio generiert, ist dieser Unterschied groß. Das ist der Hauptgrund für WebSockets beim Erstellen von Agents. Das vollständige Protokoll ist im Leitfaden für Echtzeit-Text-to-Speech-WebSockets dokumentiert.
Modell und Ausgabeformat wählen
Zwei Entscheidungen bestimmen das Audio, das Sie aus Ihrer TTS-API-Integration erhalten. Erstens das Modell, das Qualität und Geschwindigkeit festlegt. Zweitens das Ausgabeformat, das Container, Bitrate und Abtastrate bestimmt.
Wenn Sie beides von Anfang an richtig wählen, fügen sich nachgelagerte Aspekte wie Latenz und Telefoniekompatibilität nahtlos ein.
Modelle
Wir bieten mehrere Text to Speech-Modelle an. Sie sind nicht von besten bis schlechtesten eingestuft; jedes trifft andere Abwägungen.
Die Angabe von ~75 ms bezeichnet die Modellinferenz unter repräsentativen Bedingungen, ohne Netzwerk- und Anwendungslatenz. Sie steigt bei längeren Eingaben und unter Last. Messen Sie immer aus Ihrer Anwendung heraus, nicht anhand eines Benchmarkwerts.
Flash-Modelle sind kleiner und nutzen stärkere Approximationen, um die Inferenzzeit zu reduzieren. Eleven v4 und Multilingual v2 sind größere Modelle, die pro Zeichen mehr Zeit investieren, um reichhaltigere Ergebnisse zu erzeugen.
Für Echtzeit- oder Agent-Pfade verwenden Sie eleven_flash_v2_5; es ist die mehrsprachige Option mit der niedrigsten Latenz. Für Erzählungen, Hörbücher oder Marketing-Voiceovers verwenden Sie eleven_multilingual_v2, wenn Sie stabile, hohe Klangtreue wünschen, oder eleven_v4, wenn Sie maximale Ausdrucksstärke und emotionale Bandbreite benötigen.
Wenn die Aussprache wichtig ist, etwa bei Telefonnummern, Daten oder Währungen, normalisieren Sie Zahlen selbst in Ihrer Anwendung, bevor der Text die API erreicht. Schreiben Sie die gewünschte gesprochene Form aus.
Eine eigene Normalisierung sorgt für eine modellübergreifend vorhersehbare Aussprache und vermeidet die Abhängigkeit von modellspezifischen Standardwerten, die sich ändern können.
Ausgabeformat
Der Parameter output_format steuert Container, Abtastrate und Bitrate des zurückgegebenen Audios. Die am häufigsten verwendeten Werte:
Stimmeinstellungen
Die folgenden Einstellungen steuern, wie die generierte Sprache ausgegeben wird:
- Stability: Steuert Konsistenz gegenüber Ausdrucksstärke. Niedrigere Werte erzeugen variablere, ausdrucksstärkere Sprache, während höhere Werte für eine gleichmäßigere, vorhersehbarere Wiedergabe sorgen.
- SimilarityBoost: Steuert, wie eng die Ausgabe der Referenzstimme folgt.
- Style: Verstärkt bei höheren Werten den natürlichen Sprechstil der Stimme.
- useSpeakerBoost: Verstärkt die Ähnlichkeit mit dem ursprünglichen Sprecher bei geringfügig höherer Latenz.
- Speed: Passt das Sprechtempo um den Standardwert 1,0 an.
Von diesen Einstellungen hat Stability typischerweise den größten Einfluss auf die wahrgenommene Qualität. Niedrigere Werte erzeugen ausdrucksstärkere, aber weniger konsistente Ergebnisse, während höhere Werte Konsistenz und Vorhersehbarkeit priorisieren.
Bei der Wahl einer Stimme bietet Flash in Kombination mit einem Instant Voice Clone oder einer Standardstimme die niedrigste Latenz. Professional Voice Clones klingen hervorragend, verursachen aber zusätzlichen Aufwand pro Generierung, den Sie berücksichtigen sollten.
In diesem Leitfaden lautet die Beispiel-Stimm-ID JBFqnCBsd6RMkjVDRZzb (George).
Streaming-Integration (HTTP und WebSocket)
In diesem Abschnitt behandeln wir den praktischen Kern der Text to Speech API-Integration. Wir erläutern die Installation des SDK, das Öffnen eines Streams und das Verarbeiten eingehender Audiodaten. Der HTTP-Pfad deckt die meisten Wiedergabeszenarien im Web und in Apps ab, während der WebSocket-Pfad Agents und Live-LLM-Ausgabe abdeckt.
Beide Wege setzen voraus, dass Sie den untenstehenden ElevenLabs-Client initialisiert haben.
Der Streaming-Pfad öffnet einen Stream und verarbeitet Chunks, sobald sie eintreffen. voiceId ist das erste Positionsargument, gefolgt von einem Optionsobjekt mit camelCase-Schlüsseln (modelId, outputFormat, voiceSettings):
Für die WebSocket-Variante verbinden Sie sich mit wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-input, senden zunächst eine Nachricht mit Ihren Stimmeinstellungen und einem vorangestellten Leerzeichen, schicken dann Textnachrichten, sobald sie verfügbar sind, und lesen JSON-Frames zurück, deren audio-Feld Base64-codierte Chunks enthält.
Batching und Parallelitätslimits für hohen Durchsatz
Integrationen mit hohem Durchsatz werden durch Parallelität bestimmt: die Anzahl der Anfragen, die im selben Moment Audio generieren. Jeder Plan hat ein Limit je Modellfamilie.
Jeder Plan umfasst ein eigenes Parallelitätslimit:
- Free: 4 parallele Flash-Anfragen.
- Starter: 6 parallele Flash-Anfragen.
- Creator: 10 parallele Flash-Anfragen.
- Pro: 20 parallele Flash-Anfragen.
- Scale und Business: 30 parallele Flash-Anfragen; Enterprise-Limits werden individuell festgelegt.
Die Limits für Multilingual v2 liegen bei etwa der Hälfte der oben genannten Werte.
Ein begrenzter Pool entschärft dies, indem er die Anzahl gleichzeitig laufender Anfragen limitiert:
Setzen Sie MAX_CONCURRENCY etwas unter Ihr Planlimit, statt genau darauf. Dieser Puffer absorbiert weiteren Traffic, der denselben Schlüssel nutzt, und hält Sie unter dem Schwellenwert, ab dem ein 429 zurückgegeben wird.
Zeichenlimits und Aufteilen langer Texte
Jedes Modell begrenzt die Anzahl der Zeichen, die es in einer einzelnen Anfrage akzeptiert. Bei jeder Langform-Integration müssen Sie Text aufteilen und die Audiodaten anschließend wieder zusammensetzen.
Hier sind die Zeichenlimits pro Anfrage für jedes Modell:
- Flash v2.5: Akzeptiert bis zu 40.000 Zeichen pro Anfrage.
- Flash v2: Akzeptiert bis zu 30.000 Zeichen pro Anfrage.
- Multilingual v2: Akzeptiert bis zu 10.000 Zeichen pro Anfrage.
- Eleven v3: Akzeptiert bis zu 5.000 Zeichen pro Anfrage.
- Eleven v4: Akzeptiert bis zu 10.000 Zeichen pro Anfrage.
Längere Texte müssen in mehrere Anfragen aufgeteilt werden. Teilen Sie möglichst an Satzgrenzen, damit die Prosodie an der Nahtstelle zwischen Chunks erhalten bleibt.
Generieren Sie die Chunks der Reihe nach und führen Sie die Audiodaten zusammen. Bei Langform-Erzählungen, bei denen jeder Chunk unabhängig ist, greifen die beiden Teile direkt ineinander: Übergeben Sie die splitText-Ausgabe an den begrenzten Pool oben und lassen Sie ihn den Rest erledigen.
Caching und Idempotenz
Text-to-Speech-Ausgabe ist ausreichend deterministisch, sodass es verschwenderisch ist, denselben Text mit derselben Stimme, demselben Modell und denselben Einstellungen erneut zu generieren. Cachen Sie das Ergebnis mit einem Hash der Eingaben, die das Audio beeinflussen. Derselbe Schlüssel dient bei Wiederholungen zugleich als Idempotenz-Token.
So setzen Sie beides um.
Die Regel dafür lautet: Jeder Parameter, der das Audio verändert, muss im Schlüssel enthalten sein, einschließlich outputFormat und Stimmeinstellungen. Richtig umgesetzt dient derselbe Schlüssel zugleich als Idempotenz-Token. Wenn ein Client eine bereits erfolgreiche Anfrage wiederholt, geben Sie die gecachten Bytes zurück, statt erneut zu generieren.
Fehlerbehandlung und Ratenlimits (429)
Ein Produktionsclient benötigt Wiederholungen mit Backoff und Jitter sowie eine je Statuscode unterschiedliche Behandlung, denn manche Fehler sollten wiederholt werden und andere nicht.
Die Tabelle unten ordnet jedem Status die richtige Aktion zu. Der Abschnitt erklärt außerdem, warum ein 429 ein weiches Limit und keine harte Grenze ist.
Ein 429 ist keine harte Grenze, und es hilft, den Mechanismus zu verstehen. Wenn Sie das Parallelitätslimit überschreiten, werden Anfragen zunächst nach Priorität in eine Warteschlange gestellt, was typischerweise etwa 50 ms hinzufügt. Erst wenn Sie danach weiterhin über der Kapazität liegen, erhalten Sie einen 429.
Die Antwort enthält außerdem die Header current-concurrent-requests und maximum-concurrent-requests, die Ihren aktuellen Spielraum anzeigen. Sie können sie auslesen und drosseln, bevor Sie das Limit erreichen.
Wenn Sie mehr Spielraum statt eines besseren Wiederholungsverhaltens benötigen, upgraden Sie Ihren Plan. Enterprise-Kunden können über ihren Account Manager höhere Limits anfragen.
Latenz und Zeit bis zum ersten Byte vergleichen
Die Latenz hängt von Ihrer Region, Ihrer Eingabe und der aktuellen Auslastung ab. Daher ist nur ein Latenzwert verlässlich, den Sie in Ihrer eigenen Umgebung gemessen haben.
Dieser Abschnitt zeigt Ihnen die Zeit bis zum ersten Byte (TTFB) für den Flash-Streaming-Endpunkt. Er ist so aufgebaut, dass Sie dasselbe Test-Setup auf einen anderen Anbieter richten und beide unter identischen Bedingungen vergleichen können.
Betrachten Sie dies als Methode, nicht als veröffentlichtes Ergebnis. Ein einzelner Durchlauf garantiert nichts.
Beim Vergleich der Latenz einer Text to Speech API-Integration sind einige wichtige Einschränkungen zu beachten:
- Netzwerk-Roundtrip einbeziehen: TTFB hängt von Ihrem Standort und dem nächstgelegenen Cluster des Anbieters ab. Führen Sie den Test daher dort aus, wo Ihre Server üblicherweise laufen.
- Einen Warm-up-Durchlauf verwerfen: Die erste Anfrage über eine kalte Verbindung ist langsamer und kann Ihre Werte verzerren.
- Eingaben konstant halten: Eingabelänge, Stimme, Modell und Auslastung beeinflussen alle das Ergebnis. Halten Sie sie daher bei allen Anbietern identisch.
- Eine Verteilung angeben: Die Werte unterscheiden sich von Durchlauf zu Durchlauf. Veröffentlichen Sie daher Median und p95 statt eines einzelnen Werts.
Unter Berücksichtigung dieser Punkte können Sie mit dem Benchmarking beginnen.
Um mit einem anderen Anbieter zu vergleichen, schreiben Sie eine Funktion mit derselben Struktur. Führen Sie dann beide über einen kleinen Runner aus, der einen Warm-up-Aufruf verwirft, etwa 20 zeitlich getrennte Messungen durchführt, damit sie sich nicht gegenseitig beeinflussen, und Median sowie p95 in Millisekunden ausgibt.
Ein fairer Vergleich hängt von der Kontrolle der Variablen ab.
Führen Sie beide Anbieter auf demselben Rechner und im selben Netzwerk aus, idealerweise auf einem Server in der Region, in der Sie tatsächlich bereitstellen, statt auf einem Laptop mit privatem Breitbandanschluss. Verwenden Sie denselben Eingabetext und halten Sie das Audio kurz, damit die Modellinferenz den Wert stärker bestimmt als die Generierungslänge. Geben Sie Median und p95 über viele Durchläufe an, denn eine einzelne Messung ist Rauschen.
Beachten Sie, dass TTFB über das öffentliche Internet 20–200 ms Netzwerk-Roundtrip enthält, die nichts mit dem Modell zu tun haben. Wir betreiben Cluster in Nordamerika, Europa und Südostasien und leiten zum nächstgelegenen weiter. Platzieren Sie Ihren Testclient entsprechend in derselben Region, sonst messen Sie hauptsächlich die Entfernung zum Rechenzentrum.
Wichtigste Erkenntnisse für Ihre Text to Speech API-Integration
Eine produktive Text to Speech-API-Integration hängt von einer Handvoll wichtiger Entscheidungen ab.
Wenn Sie diese richtig treffen, fügt sich alles Weitere nahtlos ein:
- Modell nach Einsatz wählen: Verwenden Sie Flash v2.5 für alles Interaktive und ein Modell mit höherer Klangtreue wie Multilingual v2 oder Eleven v4 für Offline-Rendering, bei dem die Latenz weniger wichtig ist.
- Streamen, wenn ein Nutzer wartet: Verwenden Sie HTTP-Streaming für bekannten Text und einen WebSocket für Agents, damit Leerlaufzeit Ihr Parallelitätsbudget nicht belastet.
- Parallelität auf Ihr Planlimit begrenzen: Begrenzen Sie parallele Anfragen knapp unter Ihr Planlimit und cachen Sie anhand eines Hashs aller ausgaberelevanten Parameter, damit dasselbe Audio nie zweimal abgerechnet wird.
- 429 und 5xx mit exponentiellem Backoff und Full Jitter wiederholen: Drosseln Sie bei 429 und 5xx mit Full Jitter und beobachten Sie die Parallelitäts-Header, um zu sehen, wie nah Sie am Limit sind.
- Lange Texte an Satzgrenzen aufteilen: Teilen Sie an Satzgrenzen innerhalb des Zeichenlimits jedes Modells, damit die Prosodie an der Nahtstelle erhalten bleibt.
Wenn Sie noch tiefer einsteigen möchten, sehen Sie sich die Streaming-Anleitung, das Konzept zu Audio-Streaming, die Authentifizierung und Einmal-Token für die clientseitige Nutzung an.
Erstellen Sie Ihre Text to Speech-Integration mit ElevenAPI
Nach diesem Leitfaden kennen Sie alle Muster, die Sie für eine produktive Text to Speech API-Integration benötigen. Von Streaming, Batching und Caching über Wiederholungen bis hin zum Benchmarking sind Sie bereit für den produktiven Einsatz.
Starten Sie, indem Sie mehr über die Text to Speech API erfahren oder sich registrieren, um noch heute Ihren ersten Aufruf mit ElevenAPI auszuführen.
FAQ zur Text to Speech API-Integration

Tadas Petra ist Developer Relations Engineer und unterstützt Entwickler beim Einsatz der ElevenLabs-Produktpalette. Er ist außerdem Gründer von Hungrimind, einer Plattform für Entwicklerbildung. Zuvor war er Lead Developer Advocate bei Agora und Dozent bei Zero To Mastery.