Kaskadierte vs. Fusionierte Modelle: Wie die Architektur bestimmt, ob Ihr Voice-Agent unternehmensbereit ist
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Die meisten Menschen denken, Voice Agents würden entweder mit einer kaskadierten oder einer fusionierten Architektur entwickelt. In der Praxis liegen Agenten auf einem Spektrum zwischen beiden Ansätzen. Je nach Anwendung kommen typischerweise fünf Architekturen zum Einsatz.
Die Architektur eines Agenten bestimmt, ob er im Produktivbetrieb zuverlässig arbeitet, sich an spezifische Geschäftsanforderungen anpassen lässt und in Gesprächen natürlich klingt. Eine fusionsbasierte Architektur wie das Realtime-Modell von OpenAI kann in kurzen Dialogen beeindruckend lebensecht wirken. Doch wenn Teams Compliance-Leitplanken durchsetzen, eine fehlgeschlagene Antwort debuggen oder bei Erscheinen eines stärkeren LLM im nächsten Monat wechseln müssen, bietet ein einzelnes fusioniertes Netzwerk kaum Möglichkeiten.
Bei ElevenLabs nutzen wir eine fortschrittliche kaskadenbasierte Architektur. Wir setzen spezialisierte Komponenten für Spracherkennung, Schlussfolgern und Sprachgenerierung ein, um ein hohes Maß an Intelligenz und Zuverlässigkeit zu erreichen. Kontextbezogene Prosodie, Optimierung für geringe Latenz und intelligentes Turn-Taking sorgen für natürlich fließende Gespräche. Wir haben sie so entwickelt, weil die Unternehmen und Behörden, mit denen wir arbeiten, Agenten benötigen, die realistisch klingen und bei komplexen Aufgaben im Produktivbetrieb vertrauenswürdig sind.
Dieser Artikel erläutert die fünf wichtigsten Architekturen, ihre Stärken und Grenzen sowie unsere Sicht auf die Grundlage für Agenten in kritischen Workflows.
Was Teams bei der Wahl einer Architektur bewerten
Die Fragen von Teams lassen sich meist in drei Kategorien einteilen.
Kann sie komplexe Aufgaben bewältigen?
- Schlussfolgern und Modellflexibilität: Können Sie die besten Modelle für Ihren Anwendungsfall wählen, einschließlich der leistungsstärksten verfügbaren LLMs, und upgraden, sobald bessere Optionen verfügbar sind?
- Agentenlogik: Können Sie die Gesprächsabläufe, Entscheidungsregeln und Eskalationspfade definieren und steuern, denen Ihr Agent folgt?
- Tool-Nutzung: Kann die Architektur mehrstufiges Tool Calling und Integrationen mit externen Systemen unterstützen?
Klingt und wirkt sie menschlich?
- Prosodie: Liefert der Agent natürlichen Rhythmus, Intonation und emotionalen Ton?
- Latenz: Sind die Antworten schnell genug für ein natürliches Gespräch?
- Turn-Taking: Weiß der Agent, wann er sprechen, pausieren oder das Wort übergeben soll?
Kann ich ihr im Produktivbetrieb vertrauen?
- Zuverlässigkeit: Arbeitet der Agent vorhersehbar und konsistent oder verändert sich sein Verhalten mit der Zeit?
- Leitplanken: Kann die Architektur Schutzmechanismen gegen unbeabsichtigte Antworten oder adversarielle Nutzer durchsetzen?
- Transparenz: Erzeugt die Architektur Zwischenausgaben oder ist sie eine Black Box?
Die Abwägungen zwischen kaskadierten und fusionierten Architekturen
Kaskadenbasierte Architekturen entstehen durch die Verkettung spezialisierter Komponenten: Speech to Text (STT), ein Large Language Model und Text to Speech (TTS). Jede Stufe kann unabhängig optimiert, getestet und aktualisiert werden.
Kaskadierte Architektur
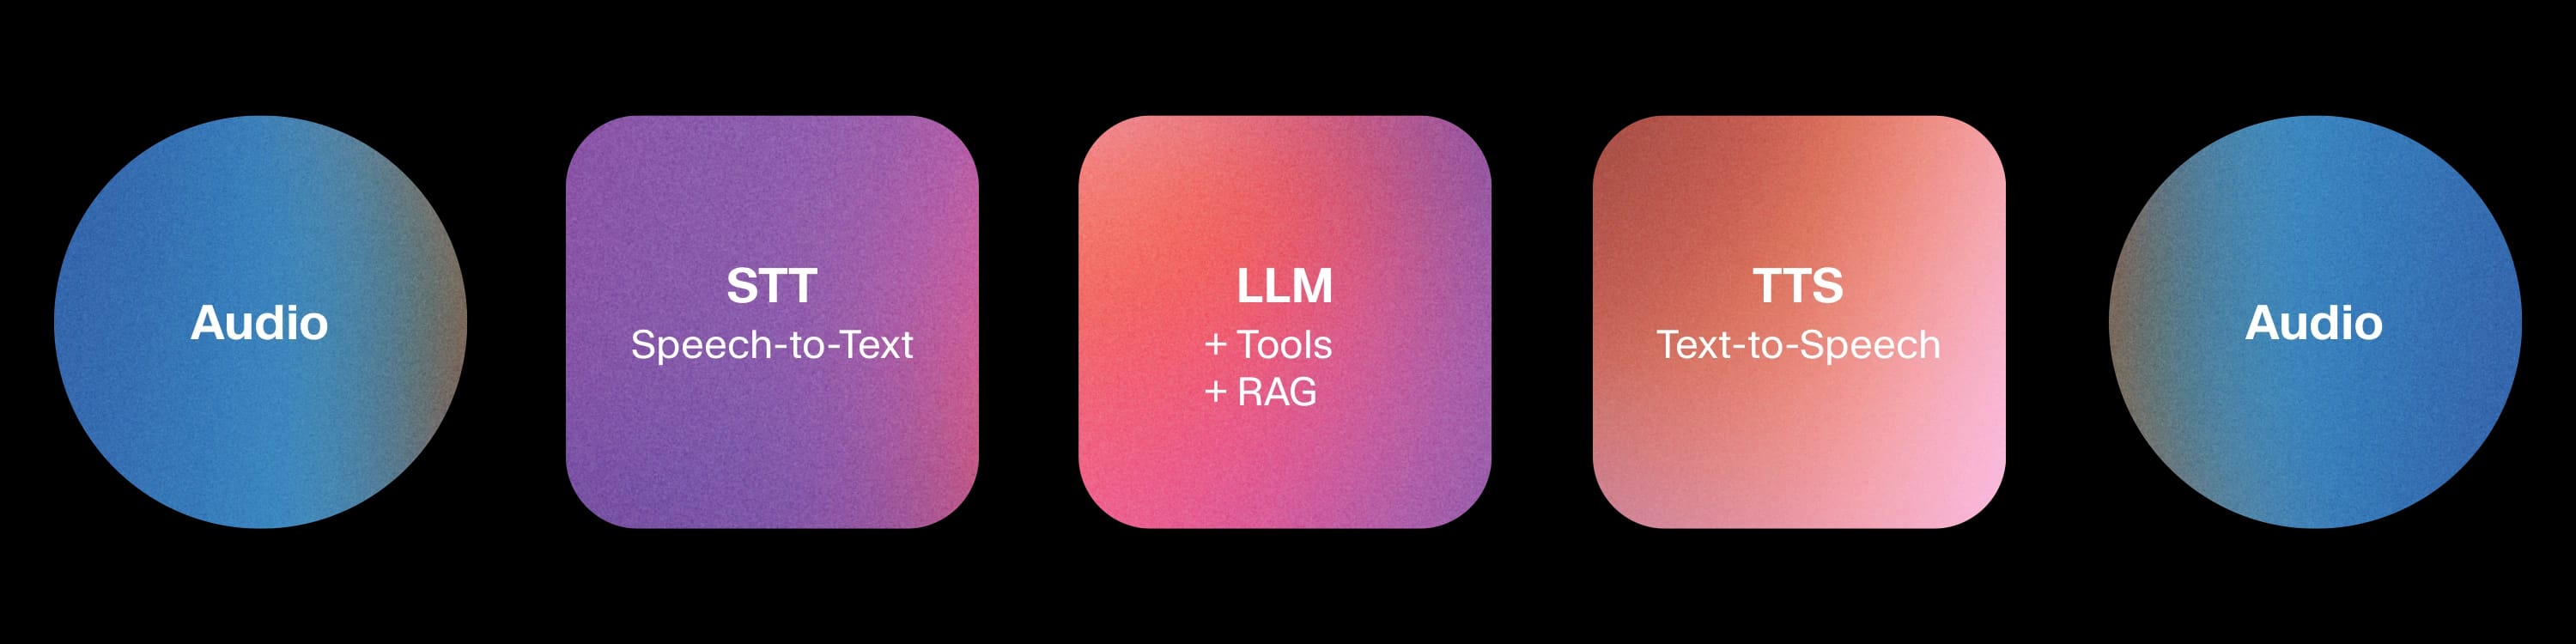
Diese Modularität macht kaskadierte Architekturen zur Grundlage der meisten unternehmenstauglichen Agenten. Jede Stufe erzeugt prüfbare Ausgaben: lesbaren Text zwischen STT und LLM sowie zwischen LLM und TTS. Leitplanken lassen sich auf der Textebene durchsetzen, aktuelle Frontier-LLMs können ohne Änderungen an Sprachmodellen integriert werden, und bei Fehlern lässt sich die Ursache meist ermitteln.
Der langjährige Kritikpunkt an kaskadierten Architekturen ist, dass sie prosodische Signale verlieren. Sprache wird auf Text reduziert, und Intonation, Rhythmus und Emotion müssen bei der Ausgabe rekonstruiert werden. Diese Signale lassen sich durch explizite Modellierung teilweise wiederherstellen, werden jedoch nicht so natürlich erfasst wie bei fusionierten Ansätzen. Andere Aspekte wie Latenz und Turn-Taking lassen sich bei beiden Ansätzen in der Regel auf ein vergleichbares Leistungsniveau optimieren.
Fusioniertes Modell
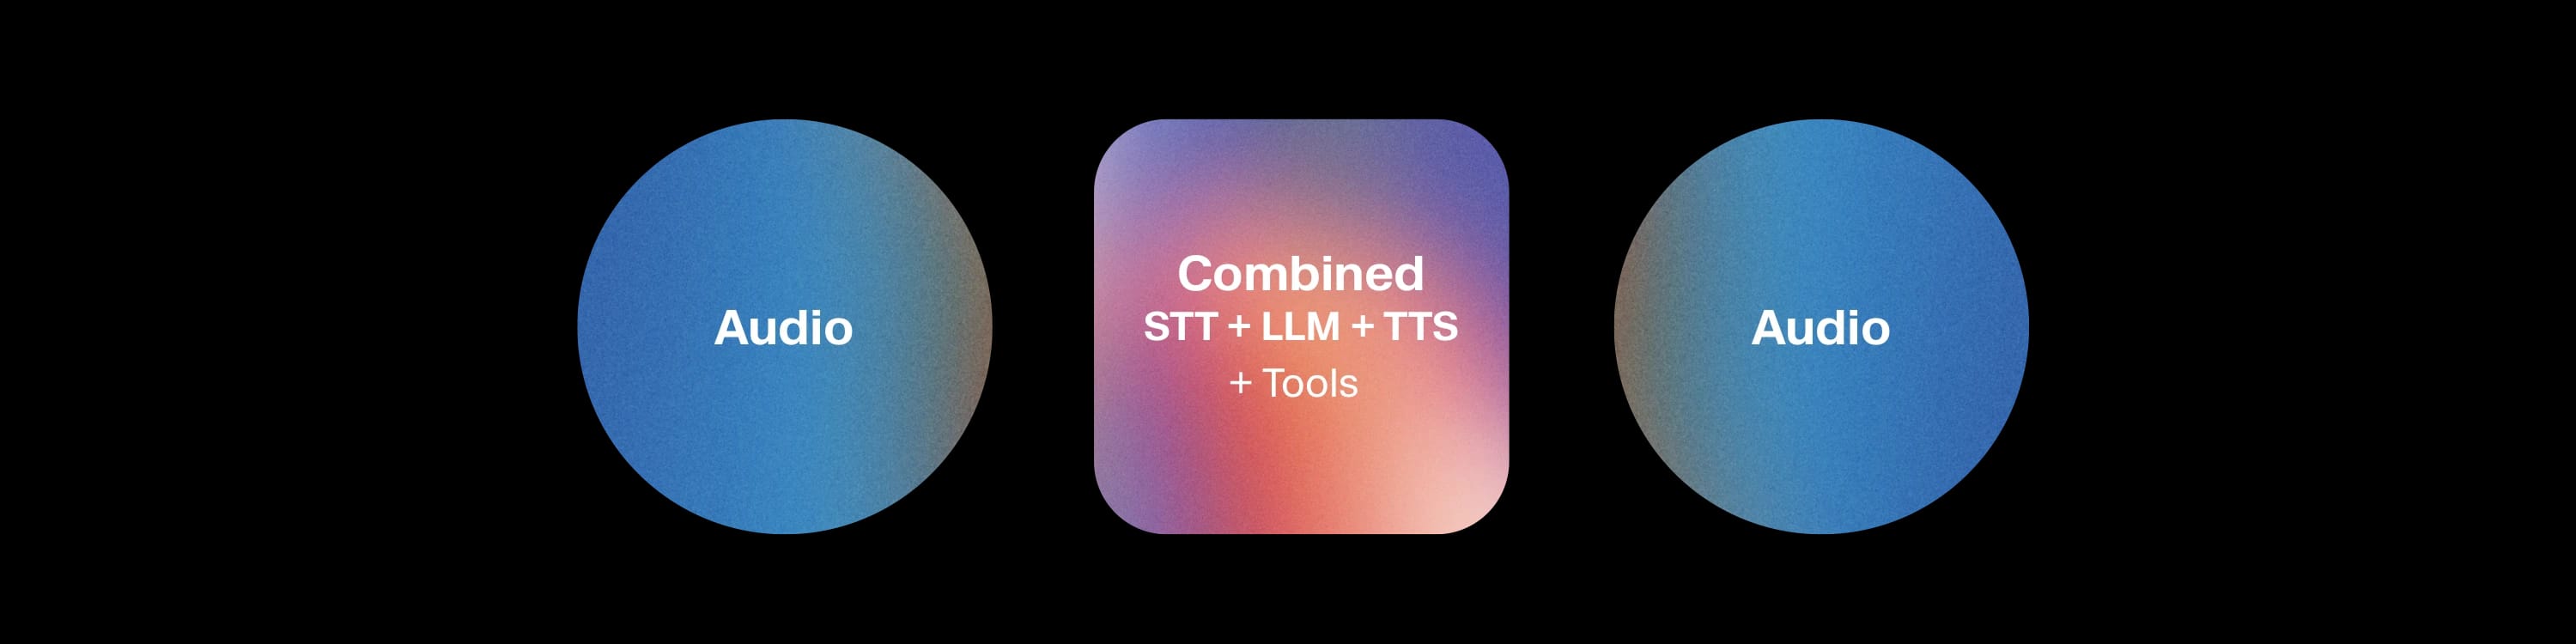
Fusionierte Architekturen verfolgen einen grundlegend anderen Ansatz. Erkennung, Schlussfolgern und Generierung erfolgen innerhalb eines einzigen multimodalen Netzwerks. Audio kommt hinein und Audio kommt heraus – ohne prüfbare Ebene dazwischen.
Das Fehlen von Zwischenstufen ist zugleich Vorteil und Einschränkung. Eine fusionierte Architektur kann prosodische Signale natürlich bewahren, weil Sprache nie in Text zerlegt wird. Allerdings sind die Möglichkeiten begrenzt, Leitplanken durchzusetzen, einzelne Komponenten auszutauschen oder Zwischenausgaben zum Debuggen zu prüfen. Auch beim Finetuning von STT für branchenspezifische Terminologie oder bei der Integration eines anderen LLM für stärkeres Schlussfolgern und Tool Calling gibt es Einschränkungen. Das System besteht aus einem Netzwerk, und Teams sind auf die Schlussfolgerungsfähigkeiten beschränkt, mit denen es ausgeliefert wird. Das bedeutet heute leichtere Kerne, die bei komplexen Aufgaben nicht mit Frontier-LLMs mithalten können.
Die fünf Architekturen
1. Einfache Kaskadierung
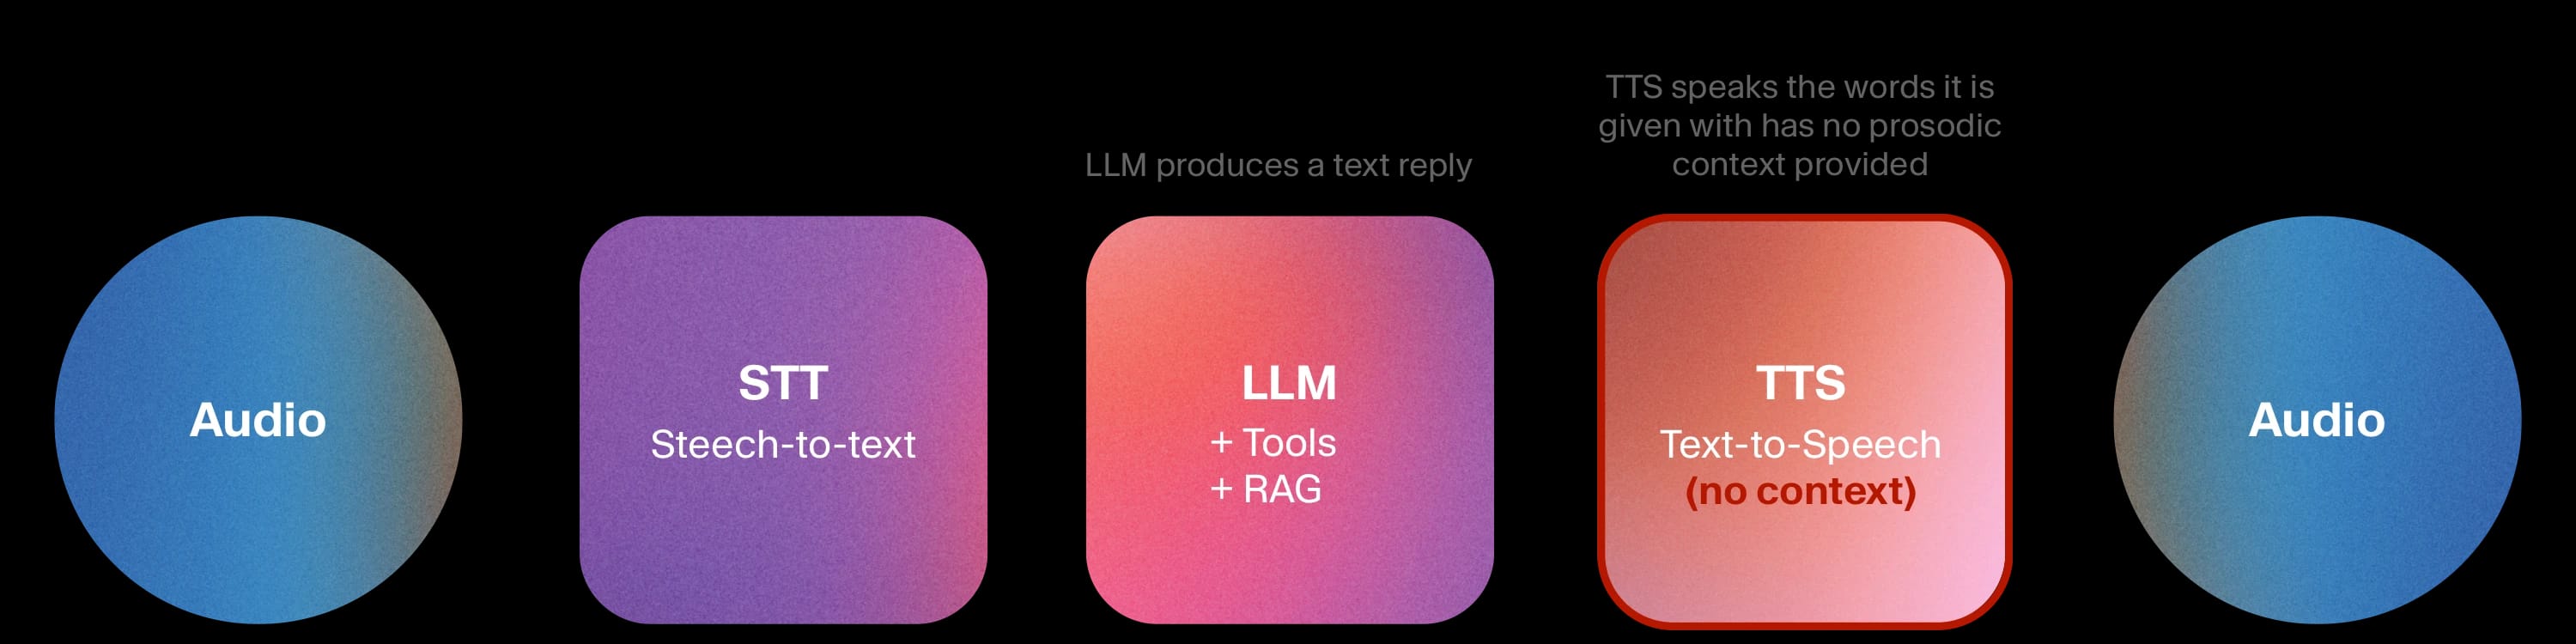
Audio wird transkribiert, das LLM generiert eine Textantwort und TTS spricht sie aus. Jede Stufe arbeitet mit Klartext. Daher können Sie alles einsehen, testen und steuern.
Die Vertrauensvorteile liegen auf der Hand: Leitplanken auf Textebene, deterministische Gesprächsabläufe und vollständige Audit-Trails. Da das LLM eine eigenständige Komponente ist, können Sie den Agenten mit dem Frontier-Modell kombinieren, das die stärksten Fähigkeiten für Schlussfolgern oder Tool Calling bietet, und sofort upgraden, wenn ein besseres verfügbar ist. Die Schwäche liegt in der Gesprächsqualität: Ohne kontextbezogenes TTS klingt der Agent zwar funktional, aber flach. Es gibt keine emotionale Anpassung oder prosodische Variation. Das ist für die Wiedergabe von Kontoständen akzeptabel, aber nicht ausreichend für die Betreuung frustrierter Kunden.
Beispielhafte Anwendungsfälle:
- IVR-Ersatzlösungen in Telekommunikation und Versorgungswirtschaft
- Bearbeitung von FAQs beim SaaS-Onboarding
- Ausgehende Benachrichtigungen wie Terminbestätigungen, Medikamentenerinnerungen und Liefermeldungen, bei denen Konsistenz wichtiger ist als Wärme
2. Erweiterte Kaskadierung
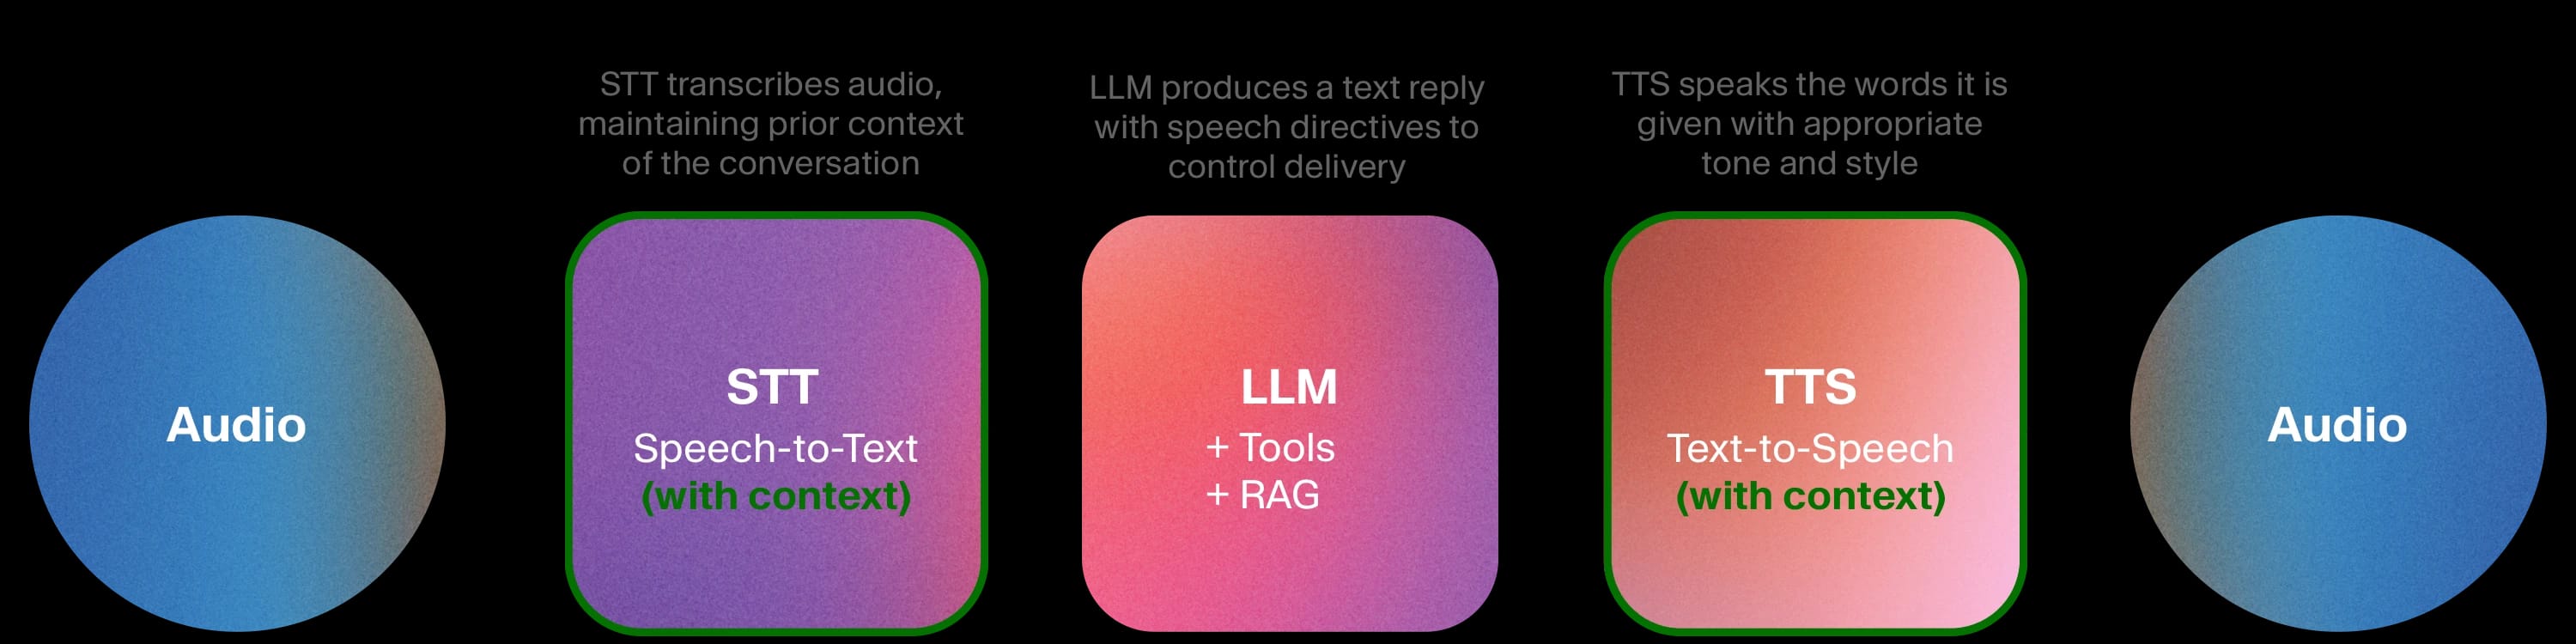
Dieselbe modulare Architektur, doch nun arbeiten mehrere Komponenten mit umfassenderem Kontext. Das haben wir mit Expressive Mode in ElevenAgents entwickelt.
Das Scribe v2 Realtime-STT-Modell erstellt schnelle, präzise Transkriptionen auf Grundlage des bisherigen Gesprächskontexts. Aus dem Text weist das LLM das TTS an, wie es Sprache ausgeben soll – nicht nur, was es sagen soll – etwa „beruhigend“, „mit Nachdruck“ oder „dringlich“. So passt es seinen Ton im Verlauf des Gesprächs dynamisch an. Das Turn-Taking-System nutzt dieselben Signale und ermöglicht dem Agenten zu bestimmen, wann er antworten und wann er das Wort übergeben soll. Die Sprachmodelle sind gemeinsam in einem Stack untergebracht, ohne Netzwerksprünge zwischen den Komponenten, sodass die Latenz niedrig bleibt.
Die Architektur behält alles aus der einfachen Kaskadierung bei: vollständige Transparenz, Leitplanken auf Textebene, austauschbare Komponenten, Domänenanpassung und Zugriff auf die leistungsstärksten verfügbaren Modelle für Tool Calling und Schlussfolgern. Sie verbessert Prosodie, Latenz und Turn-Taking deutlich. Teams können ein neues Frontier-LLM in der Woche seiner Veröffentlichung integrieren oder STT für das Gesundheitswesen auf den Fachwortschatz abstimmen, ohne eine andere Komponente neu entwickeln zu müssen.
Beispielhafte Anwendungsfälle:
- Kundensupport für Finanzdienstleistungen, bei dem ein empathischer Ton bei Anrufen wegen strittiger Abbuchungen mit strengen Compliance-Leitplanken und vollständiger Interaktionsprotokollierung kombiniert wird
- Empfangskräfte im Gesundheitswesen, die Patientenanrufe mit angemessener Dringlichkeit priorisieren, HIPAA-konforme Abläufe nutzen und auf medizinische Terminologie abgestimmte Spracherkennung einsetzen
- Vertriebsassistenten, die einen warmen, überzeugenden Ton beibehalten, während sie einem strukturierten Leitfaden folgen und Aktualisierungen ins CRM übertragen
3. Hybride kaskadierte und fusionierte Architektur
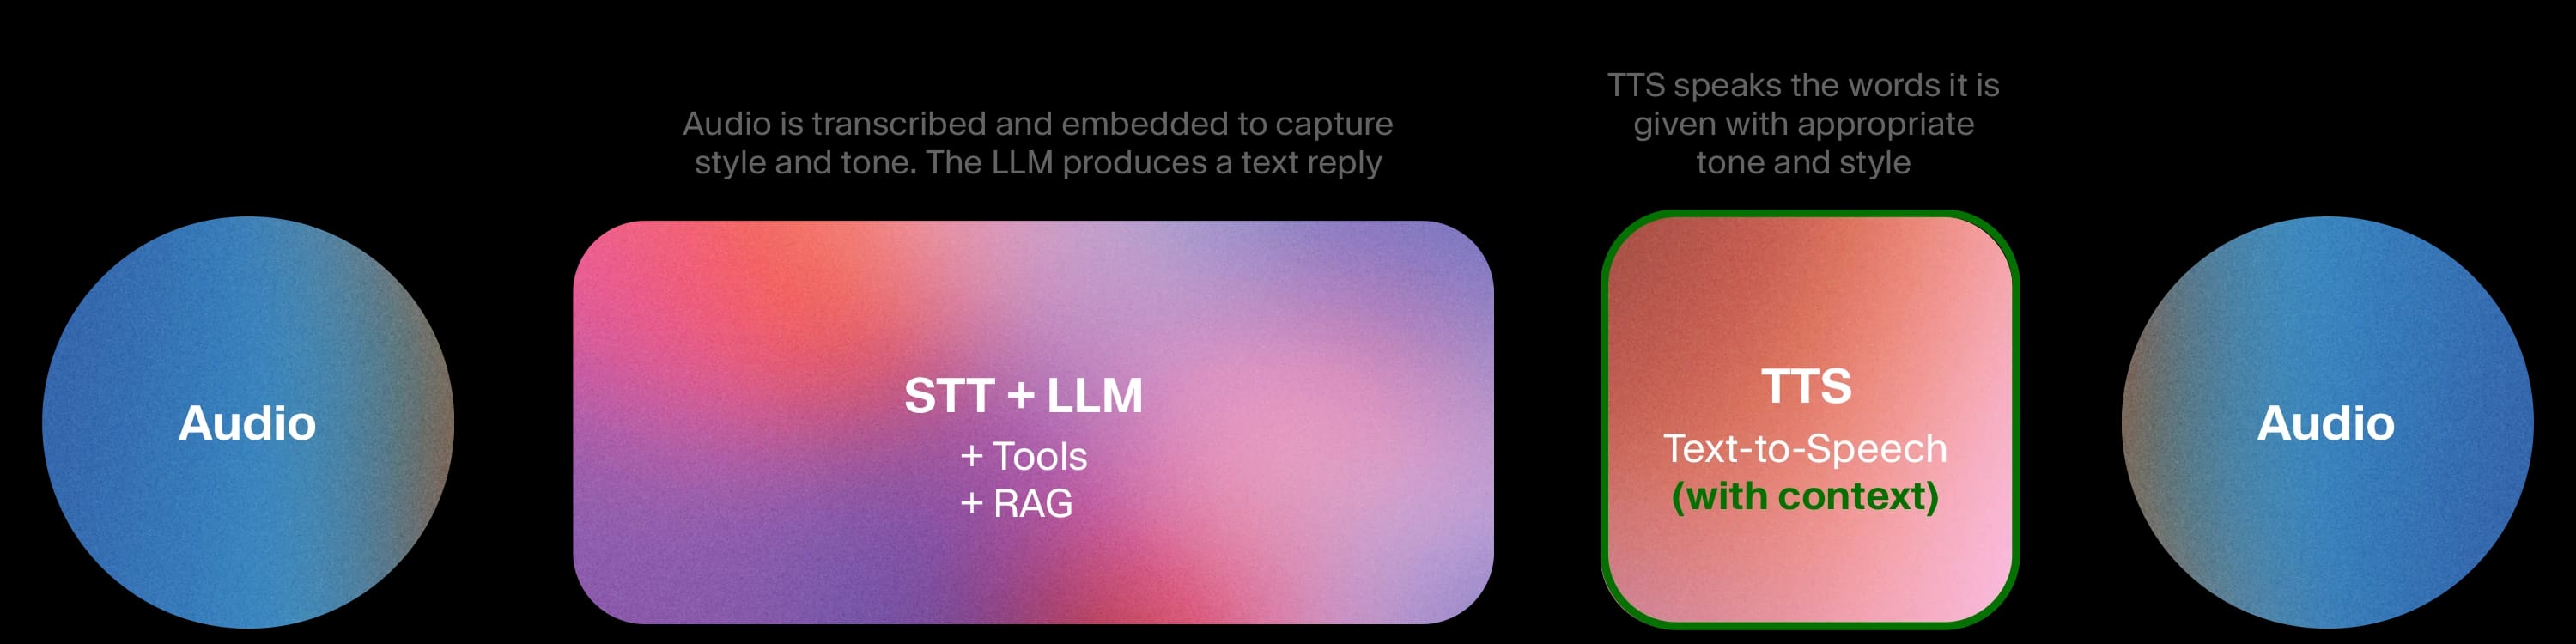
Einige Architekturen speisen akustische Merkmale der Eingabesprache – Aussprache, Emotion und Tonfall – als Embeddings direkt in das LLM ein, statt sie zuerst in Text umzuwandeln. TTS bleibt modular.
Dadurch erhält das LLM umfassendere Informationen darüber, wie etwas gesagt wurde, nicht nur darüber, was gesagt wurde. Das ist für bestimmte Anwendungen wertvoll. Der fusionierte ASR+LLM-Block lässt sich schwerer auditieren als eine klare Textübergabe, weil die Zwischendarstellung ein Embedding ist und nicht von Menschen gelesen werden kann. Auch das LLM ist nicht mehr einfach austauschbar. Damit sind Ihre Fähigkeiten für Schlussfolgern und Tool Calling auf das Modell beschränkt, auf dem der fusionierte Block aufgebaut wurde.
Beispielhafte Anwendungsfälle:
- Sprachlernen und Aussprachetraining, bei denen es genauso wichtig ist zu hören, wie ein Schüler spricht, wie was er sagt
- Tonfallsensibler Support mit geringer Komplexität, bei dem das Erkennen von Frustration wichtig ist, die Aufgabe selbst jedoch einfach ist.
4. Sequenziell fusioniert
Ein einziges multimodales Modell übernimmt Erkennung, Schlussfolgern und Generierung in einem Durchgang – jeweils Zug um Zug.
Die Prosodie kann stark sein. Da Sprache nie in Text zerlegt wird, bewahrt das Modell Tempo, Intonation und emotionale Signale auf natürliche Weise. Kurze Gespräche können bemerkenswert flüssig klingen.
Ohne Textebene sind die Möglichkeiten zur Durchsetzung von Leitplanken begrenzt, ebenso die Zwischenausgaben zum Debuggen und die Flexibilität, ein besseres LLM einzusetzen oder das STT für Ihre Domäne anzupassen. Die Schlussfolgerungskerne sind meist leichter als Frontier-LLMs, weshalb komplexes Tool Calling und mehrstufige Aufgaben beeinträchtigt werden. Wenn eine Aufgabe die Lösung eines komplexen Problems erfordert, reicht Prosodie allein nicht aus.
Beispielhafte Anwendungsfälle:
- Persönliche Begleiter, Unterhaltungs-Chatbots und Anwendungen, bei denen Ausdrucksstärke das Engagement steigert und Compliance-Anforderungen gering sind.
5. Duplex fusioniert
Eingabe und Ausgabe werden gleichzeitig verarbeitet: Das Modell hört zu und spricht zugleich. Dadurch können kurze Dialoge bemerkenswert natürlich wirken – mit echten Überlappungen beim Sprechen und fließenden Sprecherwechseln.
Sie ist zugleich die am schwersten steuerbare Architektur. Leitplanken sind sehr schwer durchzusetzen, und Übersprechen führt zu unvorhersehbaren Fehlern. Prüfen, protokollieren oder debuggen ist äußerst schwierig. Das System ist weitgehend geschlossen und bietet kaum Möglichkeiten zum Austausch von Komponenten, zur Domänenanpassung oder zur Anpassung an individuelle Anforderungen. Schlussfolgern und Tool-Nutzung sind noch stärker eingeschränkt als bei sequenziell fusionierten Modellen, weil die gleichzeitige Verarbeitung weniger Kapazität für komplexe Logik lässt. Und dieselbe gleichzeitige Verarbeitung, die kurze Dialoge natürlich klingen lässt, macht längere Gespräche instabil.
Beispielhafte Anwendungsfälle:
- Experimentelle Begleiter-Apps, soziale Sprachplattformen und Forschungsdemos, bei denen unvorhersehbares Verhalten akzeptabel ist.
Die passende Architektur für Ihren Anwendungsfall wählen
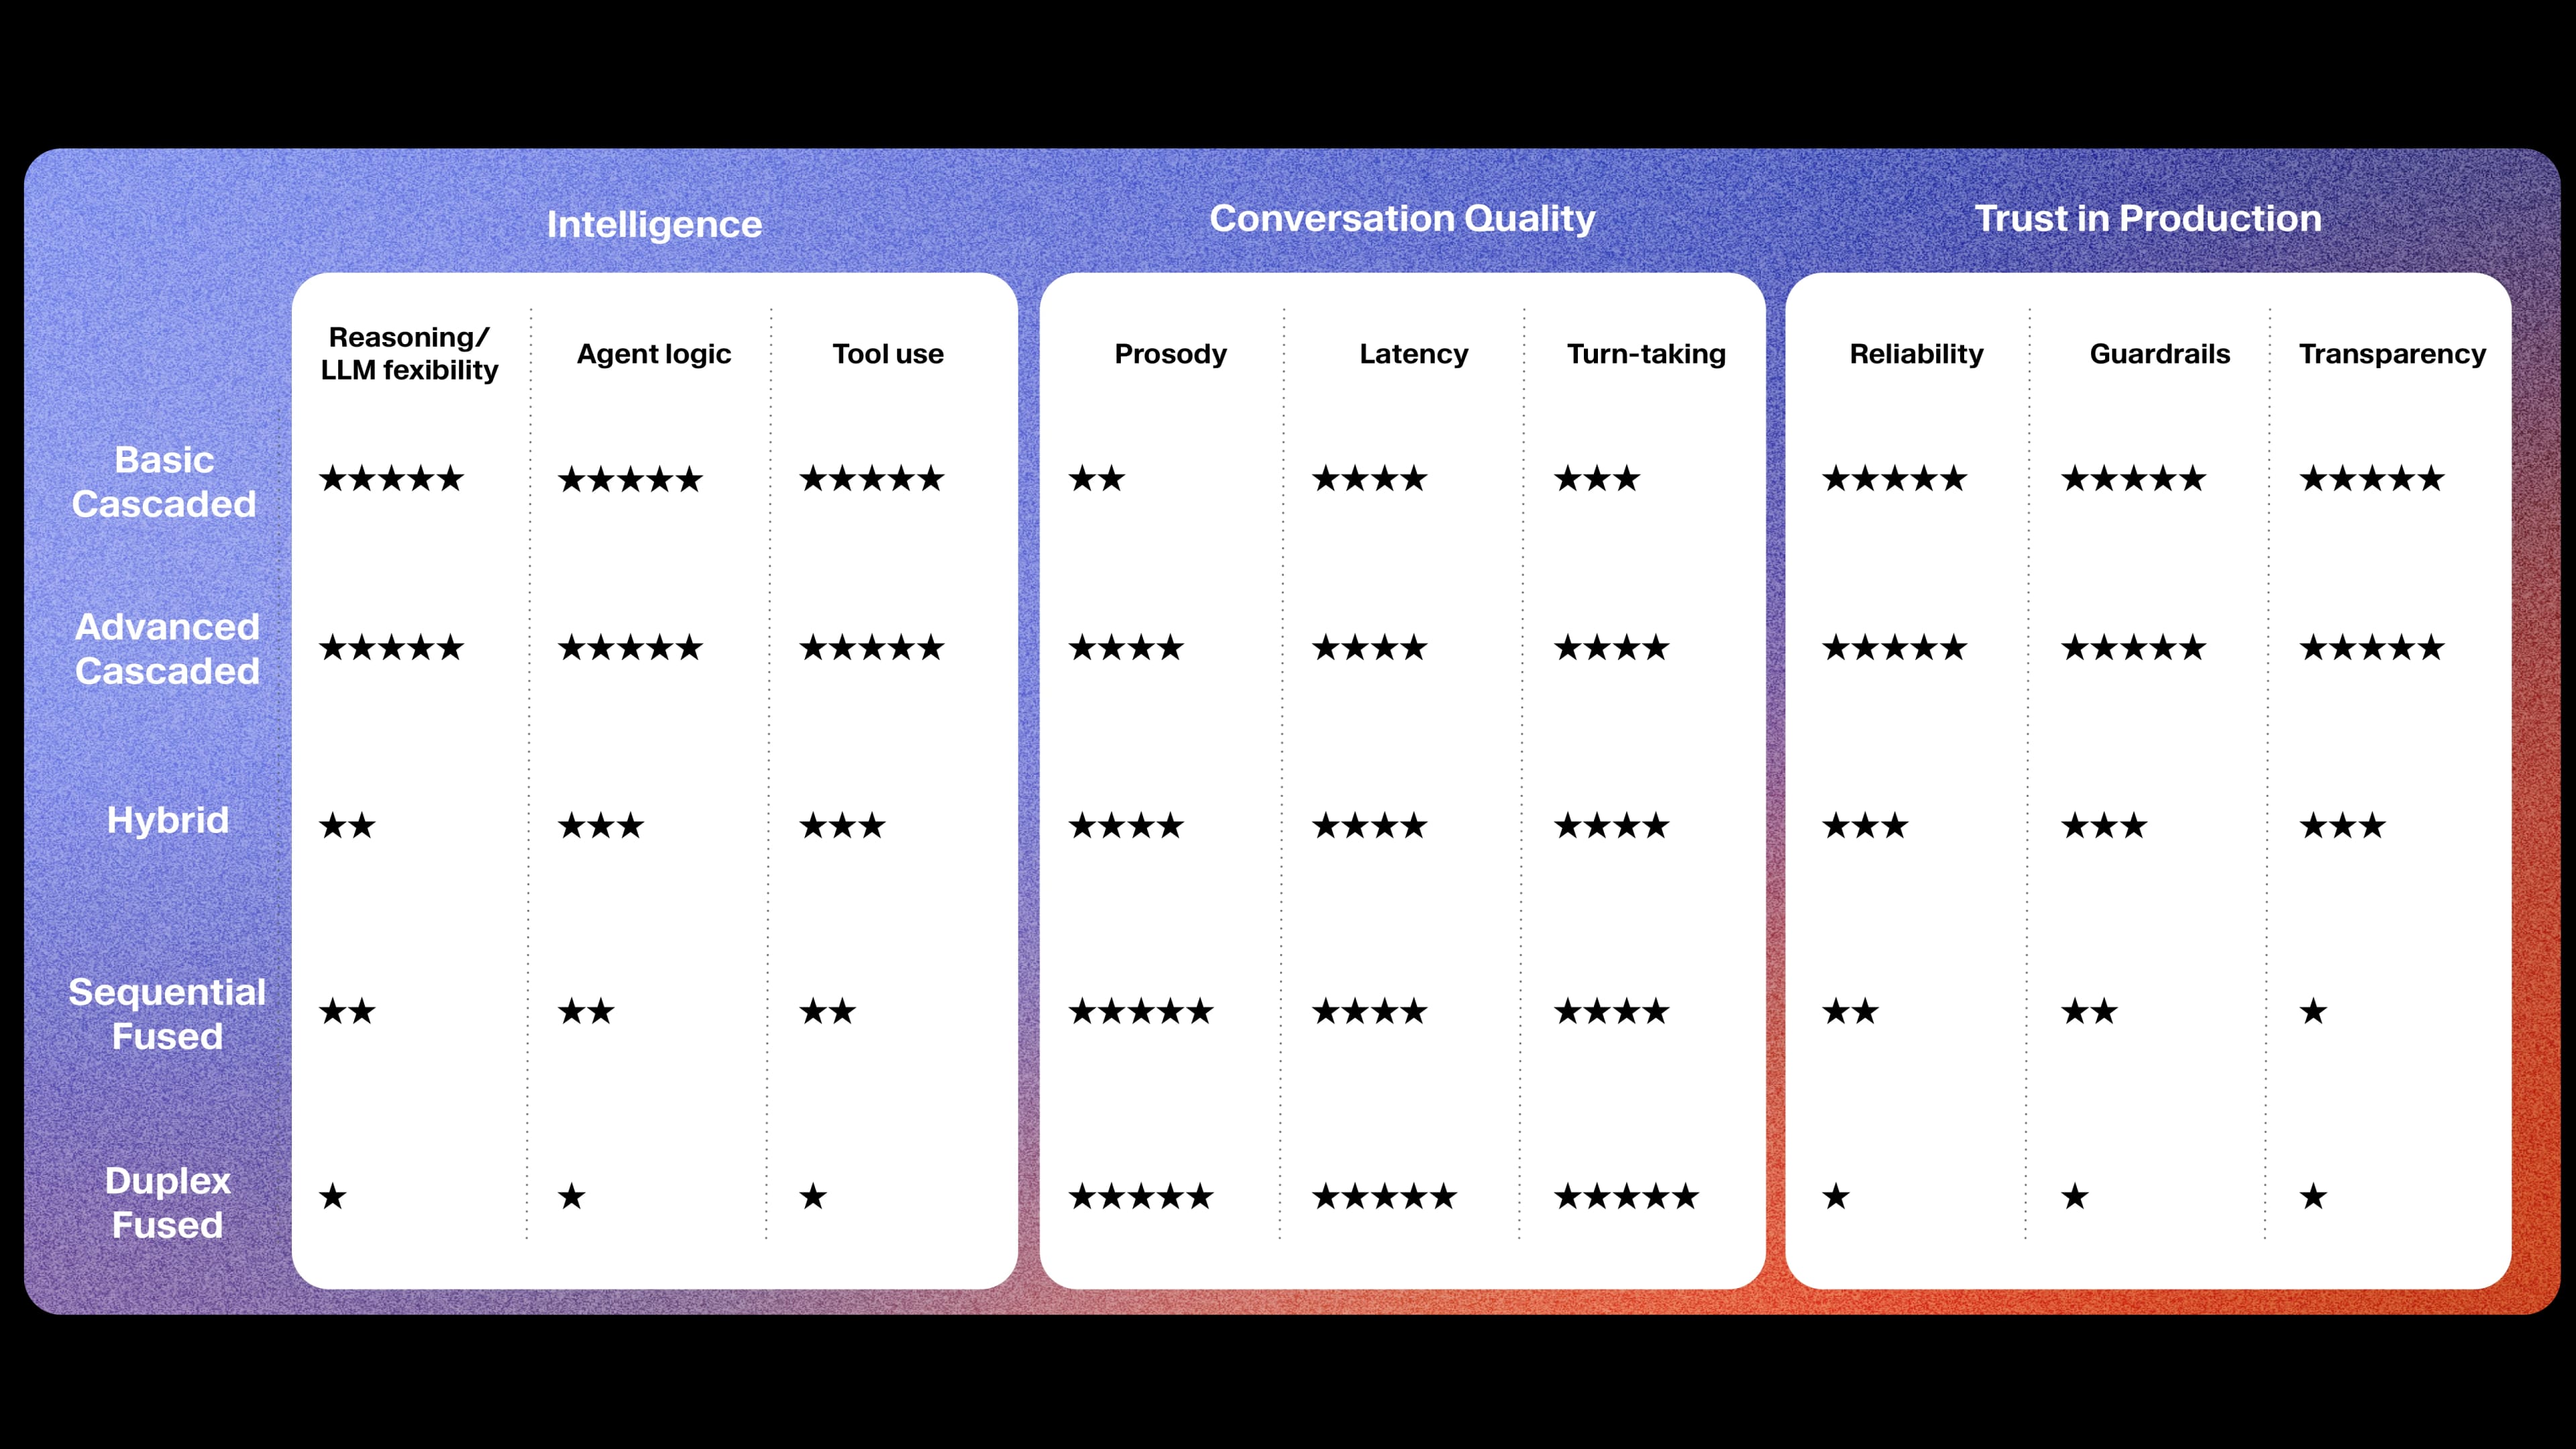
Die passende Architektur hängt davon ab, was eine Anwendung benötigt. Wenn Sie ein Erlebnis entwickeln, bei dem natürlich klingende Sprache das Hauptmerkmal ist, bieten fusionierte Architekturen echte Stärken – sofern Sie bei Frontier-Schlussfolgern, Leitplanken und Transparenz Kompromisse eingehen möchten. Fusionierte Modelle liegen bei der Prosodie vorn. Erweiterte kaskadierte Systeme holen jedoch jedes Quartal auf, während fusionierte Modelle aufgrund architektonischer Einschränkungen bei komplexem Schlussfolgern oder Vertrauenswürdigkeit keine nennenswerten Fortschritte gemacht haben.
Für die meisten Unternehmen und Behörden ist die beste Architektur eine, die hervorragend klingt und zugleich leistungsfähig, anpassbar, vertrauenswürdig und bereit für den Einsatz im großen Maßstab ist. Deshalb haben wir ElevenAgents mit einer fortschrittlichen kaskadierten Architektur entwickelt und in Expressive Mode sowie erstklassige, gemeinsam optimierte Modelle für Speech to Text und Text to Speech investiert. Damit können Teams Agenten entwickeln und dabei hohe Intelligenz, Zuverlässigkeit und Kontrolle mit natürlicher, menschenähnlicher Sprache verbinden.
Da KI-Agenten zunehmend in Kundensupport, Bildung, persönlichen Assistenten und weiteren Bereichen eingesetzt werden, werden jene erfolgreich sein, deren Architekturen auf ihre spezifischen Anwendungen zugeschnitten sind.