Die Orchestrierungs-Engine von ElevenAgent im Detail
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
ElevenAgents basieren auf einer latenzarmen Orchestrierungs-Engine, die speziell für Echtzeitgespräche entwickelt wurde und weniger als 100 ms Overhead verursacht. Diese Architektur kombiniert die beste Forschung von ElevenLabs mit führenden LLMs von Anbietern wie OpenAI, Google und Anthropic sowie ausgewählten von ElevenLabs gehosteten Open-Source-Modellen. Durch den Einsatz mehrerer Modelle in verschiedenen Phasen der Antwortpipeline stellt der Agent sicher, dass Gespräche sowohl hochreaktiv als auch kontextsensitiv sind. Indem wir die Stärken der einzelnen Modelle dynamisch kombinieren, erreichen wir zuverlässige, skalierbare Leistung für eine Reihe von Unternehmensaufgaben und Gesprächsszenarien und optimieren zugleich das Verhältnis von Intelligenz, Geschwindigkeit und Kosten.
In diesem Beitrag erklären wir, wie diese Modelle zusammenarbeiten, um die Kernfähigkeiten bereitzustellen, die Agents für komplexe Umgebungen benötigen – und insbesondere, welches Modell welche Tokens wann sieht. Im Mittelpunkt steht die Verwaltung des Gesprächsverlaufs an verschiedenen Punkten der Interaktion. Wir zeigen erneut, wie und wo der Gesprächsverlauf geteilt wird, um seine Rolle in der Orchestrierung sowohl für unabhängige als auch für Multi-Agent-Workflows.
Unabhängiger Agent
Zunächst betrachten wir den unabhängigen Agent und seine Kernkomponenten. Ein Agent mit minimalem Nutzen verfügt sinnvollerweise über einen System-Prompt, Zugriff auf mehrere Tools und eine Wissensdatenbank. Kunden sollten unabhängige Agents Workflows vorziehen, wenn ihr Anwendungsfall nur begrenzt eine strikte Abfolge von Schritten überprüfen muss oder wenn Wissenssilos innerhalb der Agents vermieden werden sollen. Wissenssilos entstehen, wenn bestimmte Tools, Dokumente oder historische Kontexte für einige Sub-Agents zugänglich sind, für andere jedoch nicht. Sie sind Multi-Agent-Workflows inhärent und schaffen einen Zielkonflikt zwischen Flexibilität und Determinismus.
Bei unabhängigen ElevenLabs Agents ist es wichtig zu verstehen, wie sie:
- effektive Generierungsanfragen erstellen
- relevante Dokumente abrufen und einbinden
- Tool-Aufrufe generieren und ausführen, um Agent-Antworten zu unterstützen
- Ergebnisse für Auswertung und Datenerfassung ausgeben
Gesprächskontext erstellen
Ein Gespräch zwischen einem Kunden und einem ElevenLabs Agent besteht aus einer Reihe von Gesprächszügen, wobei jeder Zug einen Nachrichtenaustausch zwischen beiden Parteien umfasst. Diese abwechselnde Liste aus Agent- und Benutzernachrichten bildet den Ausgangspunkt für den Gesprächskontext. Bei jedem Gesprächszug erhält das zugrunde liegende LLM Generierungsanfragen mit einer Reihe abwechselnder Agent- und Benutzernachrichten, die jeweils eine Nachricht länger ist als im vorherigen Zug. Dieser Nachrichtenreihe wird selbstverständlich eine einzelne Systemnachricht mit dem System-Prompt des Agents vorangestellt.
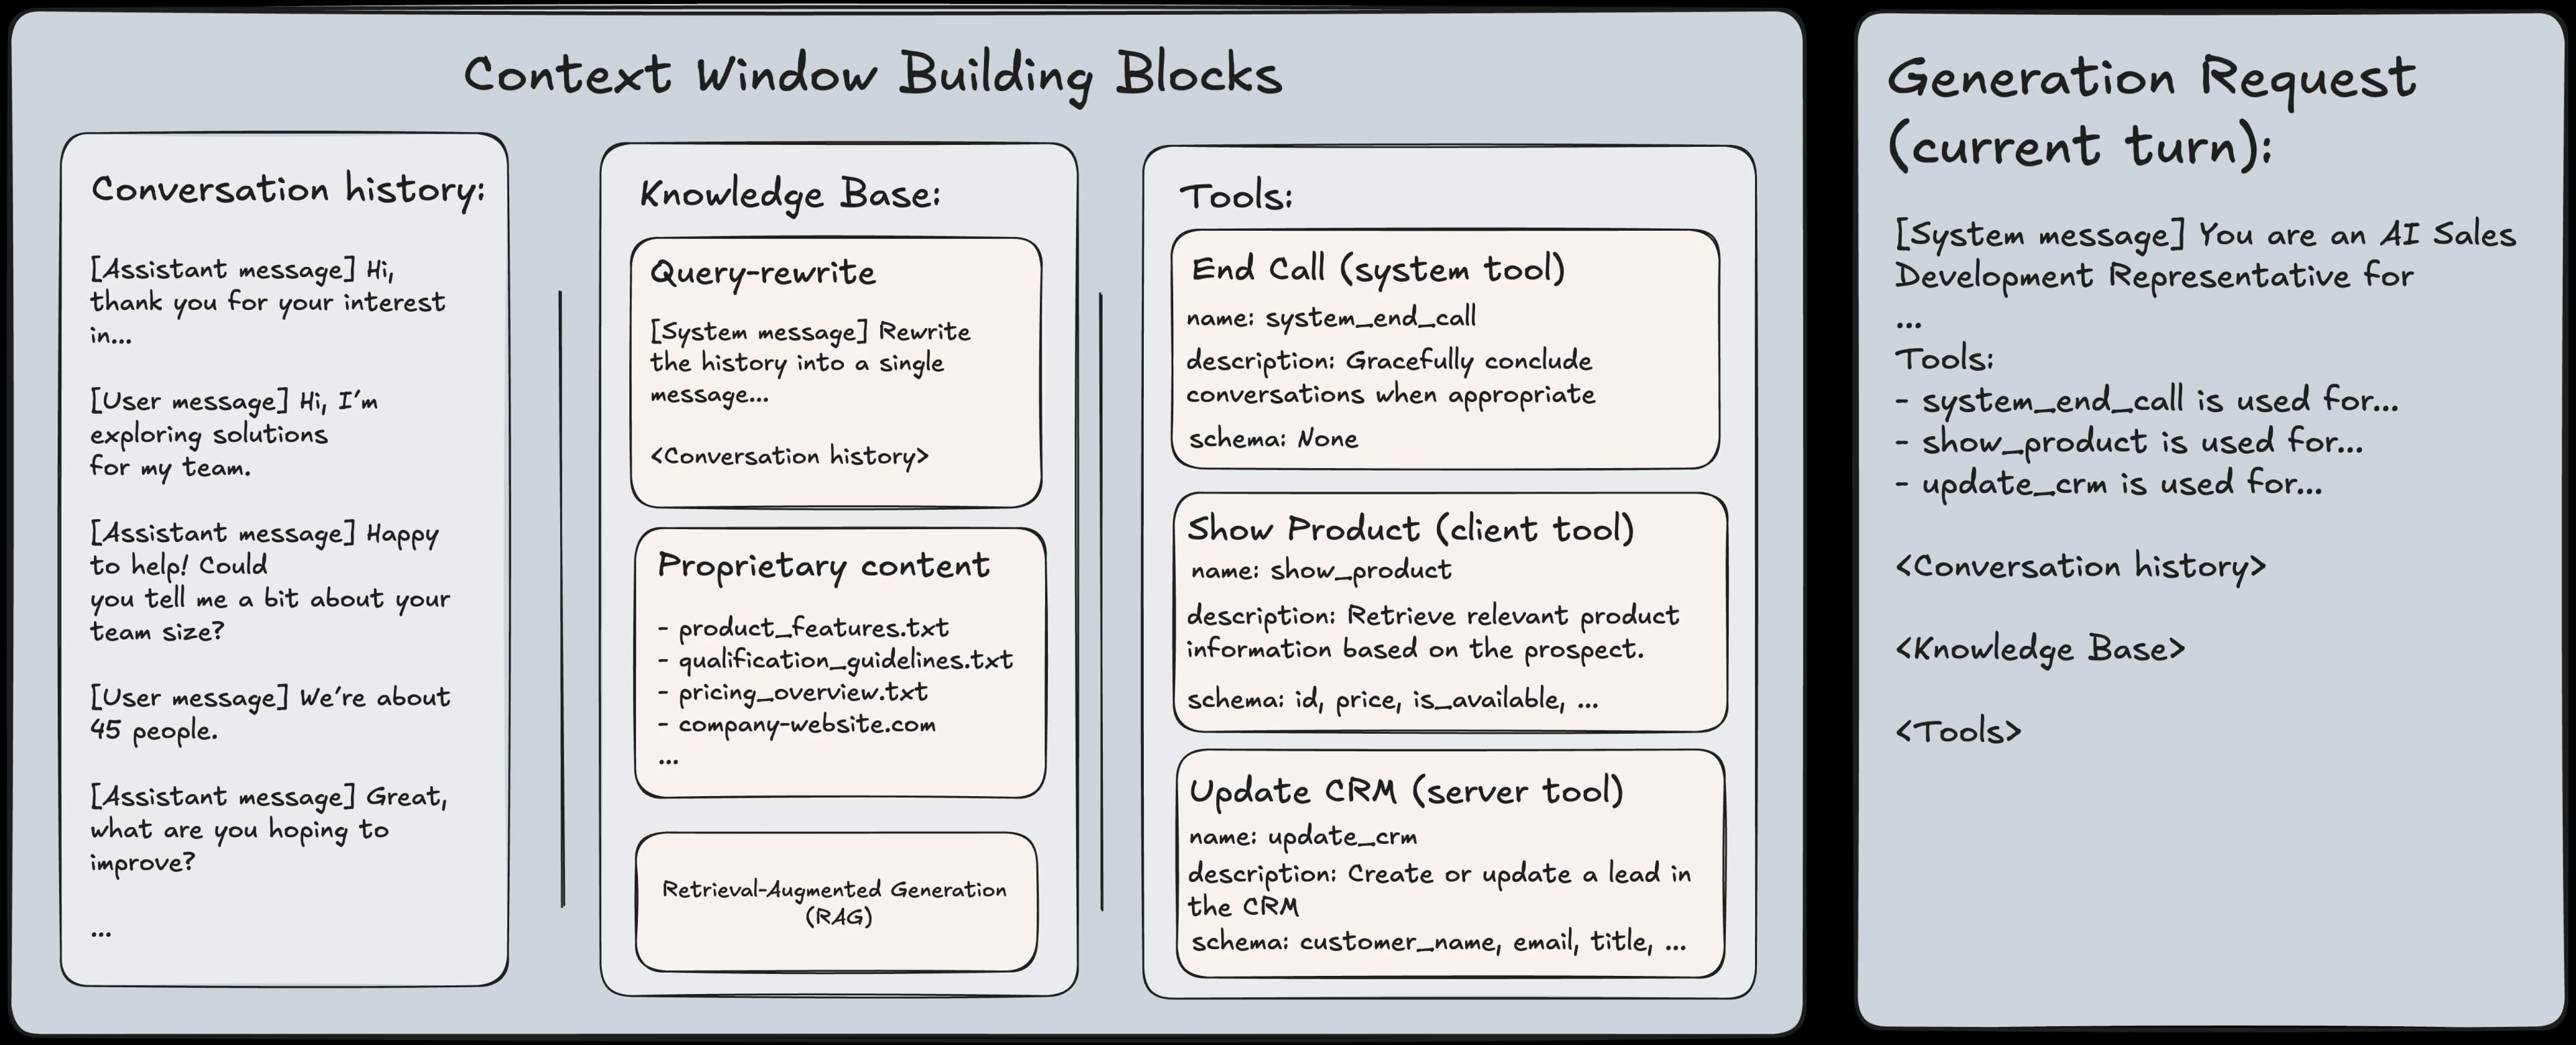
Der ElevenLabs Orchestrator reduziert die wahrgenommene LLM-Latenz, indem er vorhersagt, wann ein Nutzer aufgehört hat zu sprechen. In manchen Fällen kann dies innerhalb eines einzelnen Gesprächszugs zu mehreren LLM-Generierungsanfragen mit demselben Gesprächskontext führen. Während die Orchestrierung optimiert, wie schnell Agents antworten, hängt die Antwortqualität ebenso stark davon ab, wie auf Wissen zugegriffen wird. Mit zunehmender Nutzung stützen Kunden die Antworten ihrer Agents typischerweise auf eine Kombination aus proprietärer Dokumentation und öffentlichen Inhalten. Seit mehreren Jahren ist Retrieval-Augmented Generation (RAG) der Standardansatz dafür. ElevenAgents Wissensdatenbanken bauen auf RAG auf – mit einer optimierten Multi-Modell-Architektur, die wir in einem früheren Beitrag beschrieben haben. So lassen sich Dokumente zuverlässig abrufen, auch wenn die letzte Nutzereingabe eine Nachfrage, die Bestätigung einer Klarstellung oder keine explizite Frage enthält.
Der Abruf ist jedoch nur eine Möglichkeit, wie Agents mit externen Systemen interagieren.
Mit Tools Aktionen ausführen und Informationen abrufen
ElevenLabs Agents können über ein flexibles Tools-System während eines Gesprächs reale Aktionen ausführen und Live-Informationen abrufen. Diese Leistungsfähigkeit bringt eine wichtige Designüberlegung mit sich: Jedes aktivierte Tool vergrößert den serialisierten Prompt, da Name, Beschreibung und Parameterschema zusammen mit System-Prompt und Gesprächsverlauf eingefügt werden. Mit jedem zusätzlichen Tool steigt auch der Aufwand für das Modell, die richtige Abfolge von Tools aufzurufen. Im Agent Builder beschreibt die Tool-Beschreibung, was das Tool macht und welche Felder es zurückgibt. Anhand dieser Informationen versteht das Sprachmodell den Nutzungskontext. Sobald dies definiert ist, gehören die konkreten Bedingungen zum Aufrufen des Tools in den System-Prompt des Agents. Beispiel:
- Tool-Beschreibung für lookup_order: „Ruft die Bestelldetails eines Kunden anhand der Bestell-ID ab. Gibt Bestellstatus, gekaufte Artikel, Lieferadresse und Sendungsnummer zurück.“
- Anweisung im System-Prompt: „Rufen Sie nach der Identitätsprüfung des Kunden das Tool lookup_order auf, um die Bestelldetails abzurufen.“
Diese Aufgabentrennung hält Tool-Definitionen für verschiedene Agents wiederverwendbar und ermöglicht zugleich, dass der System-Prompt jedes Agents den genauen Zeitpunkt eines Tool-Aufrufs steuert. Damit Kunden diese System-Prompts effektiv gestalten können, bieten wir in unserem Prompting Guide weiterführende Hinweise. In diesem Rahmen können vor allem folgende Tool-Typen definiert werden:
- Webhook-Tools, die externe APIs aufrufen.
- Client-Tools, die Tool-Anfragen als Events über den Conversation-WebSocket senden.
- System-Tools für integrierte Aktionen wie Anrufweiterleitungen.
- MCP-Tools, die mit Model Context Protocol-Servern verbunden werden.
Wenn ein Agent ein Tool einsetzen möchte, entnimmt er dem Gespräch die nötigen Informationen und sendet eine Anfrage zu dessen Ausführung. Sobald das Tool ein Ergebnis zurückgibt, wird dieses dem Gespräch hinzugefügt, sodass das Modell in seiner nächsten Antwort natürlich darauf Bezug nehmen kann. Bei Bedarf kann die Tool-Ausgabe auch die gespeicherten Informationen des Agents als dynamische Variable aktualisieren. Diese Informationen werden als einfache Schlüssel-Wert-Paare gespeichert und mithilfe vordefinierter Zuordnungen aus der Tool-Antwort extrahiert. Nach dem Festlegen können diese Variablen über den System-Prompt, zukünftige Tool-Parameter und Workflow-Bedingungen wieder in den Agent einfließen. Diese Rückkopplung gibt Agents eine Art Arbeitsgedächtnis, das sich mit jeder Interaktion weiterentwickelt.
Damit ist beschrieben, wie Tools in das Reasoning des Agents integriert werden. Auch der Zeitpunkt ihrer Ausführung lässt sich konfigurieren. Tools können in einem von drei Ausführungsmodi laufen, die jeweils für andere Gesprächsanforderungen geeignet sind. Im Immediate Mode wird das Tool ausgeführt, sobald das LLM es anfordert. Dies ist die Standardeinstellung für schnelle Abfragen, bei denen Nutzer eine nahezu sofortige Antwort erwarten, etwa beim Prüfen eines Bestellstatus. In Kombination mit Pre-Tool Speech generiert der Agent zunächst eine kurze Bestätigung wie „Ich prüfe das für Sie“ und gibt sie an den Nutzer zurück, während das Tool parallel läuft. So entstehen kaum Gesprächspausen. Bei langsameren Tools verlängert die Plattform diese Überbrückungsnachrichten automatisch entsprechend der erwarteten Wartezeit. Der Post-Tool Speech Mode hingegen verzögert die Ausführung, bis der Agent zu Ende gesprochen hat. Das ist entscheidend für Aktionen mit realen Folgen, etwa eine Anrufweiterleitung, das Beenden einer Sitzung oder das Übermitteln einer Zahlung. Der Nutzer hört den vollständigen Kontext, beispielsweise „Ich verbinde Sie jetzt mit der Rechnungsabteilung“, und kann die Aktion noch unterbrechen, bevor sie ausgeführt wird. Im Async Mode läuft das Tool vollständig im Hintergrund, ohne das Gespräch anzuhalten. Dieser Modus eignet sich am besten für Fire-and-Forget-Vorgänge wie das Senden einer E-Mail, das Auslösen eines externen Workflows oder das Protokollieren von Daten, bei denen der Agent in seiner Antwort nicht auf das Ergebnis Bezug nehmen muss.
Nachdem Ausführung und Orchestrierung eingerichtet sind, gilt es als Nächstes zu verstehen, wie sich die Leistung messen lässt.
Leistung messen
Nach Abschluss eines Anrufs mit einem Agent möchten Kunden möglicherweise bestimmte Informationen aus dem Anruf zur weiteren Analyse und Speicherung extrahieren oder feststellen, ob ein Anruf erfolgreich war. Hier kommen Datenerfassung und Bewertungskriterien ins Spiel. Die Datenerfassung ermöglicht, strukturierte Informationen aus einem Anruftranskript für nachgelagerte Analysen und Aggregationen zu extrahieren. Kunden exportieren diese Ausgaben häufig in ihr Enterprise Data Lakehouse für Berichte oder Anreicherungs-Workflows. So kann ein Sales Development Agent automatisch Interessentendaten aus einem Gespräch extrahieren, um einen Lead im Customer-Relationship-Management-System (CRM) zu erstellen oder zu aktualisieren. Bewertungskriterien hingegen legen fest, ob ein Anruf als erfolgreich gilt. Sind alle konfigurierten Kriterien erfüllt, wird der Anruf als erfolgreich markiert; andernfalls wird er als fehlgeschlagen gekennzeichnet. Das stellt sicher, dass Gespräche definierte Qualitäts- und Integritätsstandards konsequent erfüllen, und ermöglicht schnelles Feedback. Nach Abschluss eines Anrufs und Auslösen des Post-Call-Webhooks verarbeitet der Agent das finale Transkript einschließlich Tool-Ausführungen und Metadaten mit einem LLM zusammen mit allen konfigurierten Datenerfassungspunkten und Bewertungskriterien. Das Modell verwendet diesen kombinierten Prompt, um festzustellen, ob jedes Bewertungskriterium erfüllt ist, und die angegebenen Datenpunkte für nachgelagerte Analysen zu extrahieren. Da das LLM diese Konfigurationen direkt als Teil seines Eingabe-Prompts interpretiert, ist eine klare und einheitliche Formatierung wichtig, damit das Modell sie korrekt versteht und anwendet. Daher empfehlen wir folgende Best Practices für Beschreibungen von Bewertungskriterien und Datenerfassung.
Bewertungskriterien
- Ein klares Ziel pro Kriterium: Ein Satz oder kurzer Stichpunkt ist besser als mehrere Ziele in einem Kriterium.
- Beobachtbar und transkriptbasiert: Formulieren Sie das Ziel so, dass Erfolg oder Misserfolg anhand des Transkripts entschieden werden kann: was gesagt wurde, was der Agent getan hat und was der Nutzer gefragt hat. Vermeiden Sie Ziele, die externen Kontext erfordern, den das LLM nicht hat.
- Explizite Ergebnisse für Erfolg, Misserfolg und unbekannt: Das LLM weiß bereits: Um Erfolg zu markieren, muss das Ziel erfüllt sein; für Misserfolg darf es nicht erfüllt sein; und für unbekannt darf dies aus dem Transkript nicht ersichtlich sein. Das Ziel sollte daher so formuliert sein, dass „erfüllt“ gegenüber „nicht erfüllt“ klar definiert ist. Ist es mehrdeutig, kann das Modell zu unbekannten oder falschen Klassifizierungen neigen.
- Prägnant formulieren: Manchmal werden viele Bewertungskriterien zusammen gesendet. Lange Bewertungskriterien können daher Rauschen hinzufügen und möglicherweise Halluzinationen verursachen.
- Die Sprache ist wichtig: Jede vom LLM bereitgestellte Begründung dazu, ob ein Bewertungskriterium erfüllt wurde, wird in derselben Sprache wie die Kriterienbeschreibung ausgegeben. Das sollten Sie berücksichtigen.
Datenerfassung
- Beschreiben Sie genau, was extrahiert werden soll: Die Beschreibung ist das wichtigste Signal für das LLM. Geben Sie an, was das Feld bedeutet, in welcher Situation es gesetzt werden soll und was bei Unklarheiten zu tun ist, z. B. „Null lassen, wenn der Kunde nie ein bevorzugtes Datum genannt hat“.
- Entsprechen Sie dem erwarteten Typ: Der vom LLM bereitgestellte Wert entspricht immer dem Datentyp, der dem Datenerfassungspunkt zugewiesen ist, etwa Boolean, String oder Integer. Die Beschreibung sollte dazu passen. Verwenden Sie beispielsweise „Anzahl der angefragten Artikel extrahieren“ für Integer und „Ja/Nein, ob der Kunde dem Angebot zugestimmt hat“ für Boolean.
- Verwenden Sie Enums, wenn möglich: Wenn bei Strings die möglichen Werte festgelegt sind, verwenden Sie im Schema ein Enum. Das schränkt das Modell ein und reduziert ungültige Ausgaben.
- Ein Extraktionsziel pro Element: Packen Sie nicht mehrere unabhängige Fakten in die Beschreibung eines Elements. Teilen Sie sie in separate Elemente auf, sodass jeder Aufruf ein einziges klares Extraktionsziel hat.
- Beschreibungen kurz halten: Beschreibungen können einige Sätze umfassen; lange Absätze sind nicht nötig. Das Transkript ist bereits in der Nutzernachricht enthalten, daher reichen Schema und kurze Beschreibung aus.
Aktuell ist das für diesen Auswertungs- und Extraktionsschritt verwendete LLM fest auf ein latenzarmes Modell eingestellt, um eine schnelle Verarbeitung sicherzustellen. In naher Zukunft möchten wir Optionen einführen, die Kunden mehr Flexibilität bieten.
Als Nächstes betrachten wir Anwendungsfälle, die strukturierte Orchestrierung, Determinismus oder Spezialisierung auf mehrere Gesprächsrollen erfordern und für die Kunden stattdessen Workflows einsetzen können.
Workflows
Workflows bieten eine visuelle Oberfläche zur Gestaltung komplexer Gesprächsabläufe. Daraus entsteht das logische Objekt, mit dem der Orchestrator mehrere Sub-Agents, Tools und Übergaben unter einer unabhängigen Agent-Kennung verwaltet. Workflows führen zusätzliche Komponenten ein, die über die für unabhängige Agents beschriebenen hinausgehen. Dazu gehört:
- wie System-Prompts und Gesprächsziele von Sub-Agents interagieren.
- wie die Navigation durch verschiedene Übergangspunkte im Graphen bestimmt wird.
Spezialisierte Gesprächsziele
Workflows nutzen Funktionen unabhängiger Agents wieder, um Verhalten durchzusetzen, das während einer Interaktion konsistent bleibt. Dazu gehören gemeinsame Elemente wie der Basis-System-Prompt, zentrale Tools und globale Wissensdatenbanken, die unabhängig vom aktiven Teil des Workflows immer verfügbar sein sollen. Der übergeordnete System-Prompt definiert typischerweise den globalen Gesprächskontext, den erwarteten Ton, Sicherheitsbeschränkungen sowie marken- oder produktweite Anweisungen.
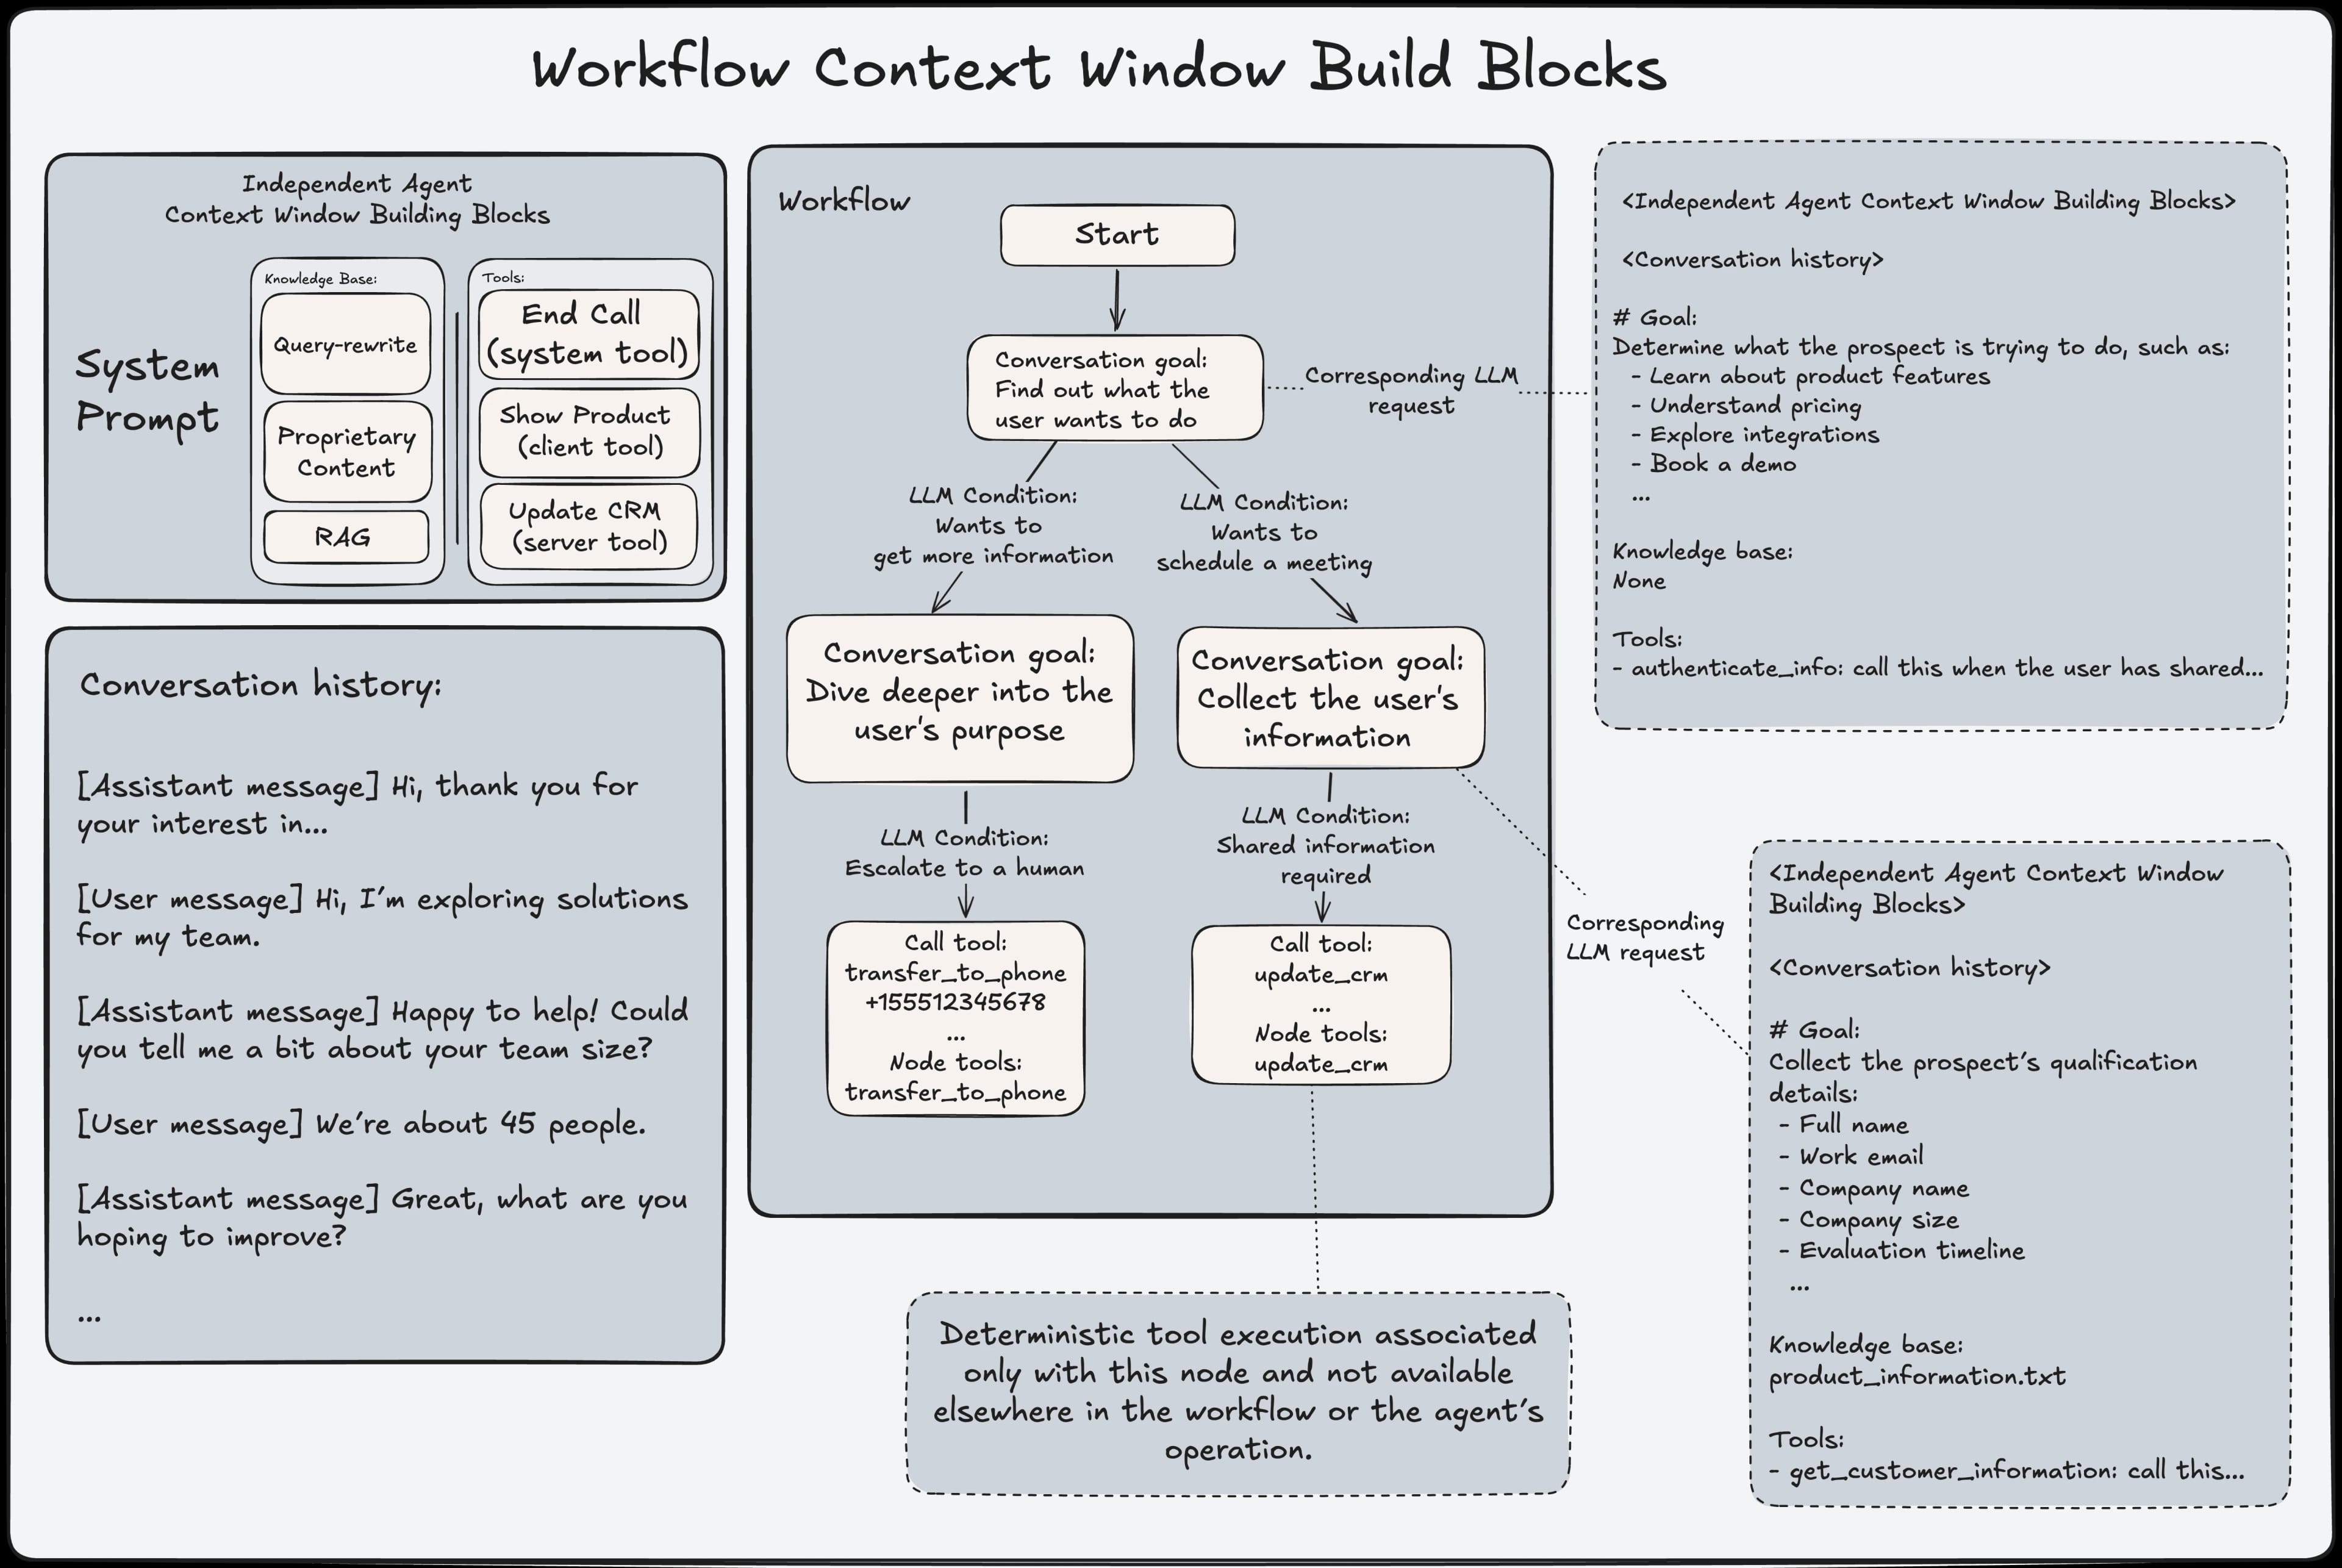
Auf dieser gemeinsamen Grundlage führen Workflows spezialisierte Sub-Agents ein, die innerhalb eines gerichteten Graphen arbeiten. Jeder Sub-Agent erhält ein eng abgegrenztes Ziel und ergänzt die Basiskonfiguration um weitere Prompt-Anweisungen, Tools und Wissensquellen, die nur für seine Rolle relevant sind. Statt das gesamte Gesprächs-Setup neu zu definieren, erweitern Sub-Agents die Absicht des Basis-Agents durch Prompt-Komposition und selektive Kontexterweiterung. Der Gesprächsverlauf bleibt bei Übergängen zwischen Sub-Agents erhalten, um Kontinuität zu wahren. Dennoch arbeitet jeder Sub-Agent mit einer bewusst eingeschränkten Sicht auf das System. Wissensdatenbanken und Tools werden selektiv bereitgestellt. So entstehen klare Silos, die eine Vermischung von Verantwortlichkeiten verhindern. Um diese Isolation zu verstärken, wird das Orchestrator-Objekt bei jedem Übergang neu aufgebaut, als handele es sich um einen unabhängigen Agent. Dadurch bleiben Prompt-Zustand, Konfiguration und verfügbare Fähigkeiten des aktiven Sub-Agents vollständig deterministisch. Dieses Design ermöglicht Workflows globale Konsistenz bei lokaler Spezialisierung. Das Ergebnis sind vorhersehbares Verhalten, eine klare Aufgabentrennung und präzise Kontrolle darüber, wie Kontext, Wissen und Aktionen in jeder Phase einer Interaktion angewendet werden.
Ein zentraler Mechanismus für diese Kontrolle ist die Steuerung der Übergänge zwischen Sub-Agents.
Workflow-Übergänge mit LLM-Bedingungen steuern
Workflows durchlaufen einen gerichteten Graphen aus Sub-Agents, wobei Übergänge zwischen Knoten durch explizite Bedingungen gesteuert werden. Diese Bedingungen bestimmen, wann die Kontrolle von einem Sub-Agent zum nächsten wechselt, und ermöglichen Workflows, auf Nutzereingaben, Tool-Ergebnisse und dynamische Variablen zu reagieren. Graph-Bedingungen können deterministisch oder LLM-ausgewertet sein. Deterministische Bedingungen wie bedingungslose Übergänge, Prüfungen dynamischer Variablenausdrücke oder Tool-Ergebnisbedingungen bieten starke Garantien für den Kontrollfluss. Sie eignen sich gut, um einen strikten Ablauf in einem Workflow durchzusetzen. LLM-basierte Bedingungen ermöglichen dagegen die semantische Auswertung natürlichsprachlicher Kriterien, etwa das Erkennen der Nutzerabsicht oder ob bestimmte Informationen bereitgestellt wurden.
Wichtig ist, dass LLM-Bedingungen außerhalb des System-Prompts des aktiven Agents ausgewertet werden und dessen Generierungsverhalten nicht beeinflussen. Stattdessen wertet der Orchestrator sie parallel anhand des aktuellen Gesprächszustands aus. Diese Trennung stellt sicher, dass die Übergangslogik den Prompt des Agents nicht verunreinigt oder die Generierung von Antworten beeinflusst. Gleichzeitig können Workflows LLM-Reasoning für eine flexible Navigation im Graphen nutzen. Durch die Kombination deterministischer und LLM-ausgewerteter Bedingungen erreichen Workflows sowohl Vorhersehbarkeit als auch Anpassungsfähigkeit: deterministische Übergänge, wenn Korrektheit entscheidend ist, und LLM-basierte Übergänge, wenn semantische Interpretation erforderlich ist.
Wenn ein Gespräch in eine neue Phase übergeht, aktiviert das System eine speziell auf diesen Schritt zugeschnittene Version des Agents. Jede Phase arbeitet mit eigenen fokussierten Anweisungen und hat nur Zugriff auf das Wissen und die Tools, die für ihre Aufgabe relevant sind. Beispielsweise kann eine Phase zur Bearbeitung von Rückerstattungen auf Erstattungsrichtlinien zugreifen, ohne irrelevanten Kontext aus Onboarding oder Triage zu übernehmen. Die Bewegung zwischen den Phasen wird durch explizite Übergangsbedingungen gesteuert. Diese Bedingungen bestimmen, wann sich die Verantwortung verschieben soll, und ermöglichen Routing-Entscheidungen, die sich natürlich aus dem Gespräch ergeben. Um Kontinuität zu wahren, bleibt die Nutzererfahrung über Übergänge hinweg nahtlos. Jede Phase übernimmt den relevanten Gesprächskontext, ohne die Mechanik der Übergabe offenzulegen. Schutzmechanismen überwachen außerdem die Übergänge, um unproduktive Routing-Zyklen zu verhindern und sicherzustellen, dass der Workflow stabil und zielgerichtet bleibt.
Sicherheit und Datenschutz
Für Anwendungsfälle mit erhöhten Anforderungen an Sicherheit und Datenschutz können Kunden zusätzliche Komponenten des Orchestrators nutzen.
Guardrails
ElevenLabs Agents setzen Sicherheits-Guardrails über ein konfigurierbares Moderations- und Alignment-System um, das Nutzer- und Agent-Nachrichten in Echtzeit auswertet. Eingehende Inhalte werden mehreren Risikokategorien zugeordnet, darunter sexuelle Inhalte, Gewalt, Belästigung, Hass und Selbstverletzung. Für jede Kategorie lassen sich Schwellenwerte unabhängig konfigurieren. Wird ein Guardrail ausgelöst, wird das Gespräch sofort beendet und der Client erhält einen eindeutigen Fehlergrund. So werden unsichere Interaktionen früh und konsistent blockiert, ohne sich allein auf promptbasierte Maßnahmen zu verlassen. Guardrails arbeiten außerhalb der Prompt-Logik des Agents und bieten eine zuverlässige Durchsetzungsebene, die nicht durch Modellverhalten oder Nutzereingaben umgangen werden kann. Dieser Ansatz ermöglicht Kunden, die Sicherheitssensitivität an ihren Bereich anzupassen und zugleich eine deterministische Durchsetzung zur Laufzeit beizubehalten.
Konforme Datenverwaltung
Sprecher können einem Agent manchmal sensible Informationen mitteilen, die strengen Anforderungen an Speicherung und Verarbeitung unterliegen, etwa medizinische Daten, die HIPAA-konform verarbeitet werden müssen. Für solche Anwendungsfälle bieten wir den Zero Retention Mode (ZRM) auf Agent- oder Workspace-Ebene. Wenn er aktiviert ist, werden alle Anrufdaten ausschließlich im Arbeitsspeicher verarbeitet und niemals dauerhaft gespeichert. Nach Abschluss von Anruf und Verarbeitung behält ElevenLabs keine Informationen. Daher sind Transkripte, Audioaufnahmen und Analyseergebnisse nicht im Agents Dashboard verfügbar. Diese Richtlinie gilt sowohl für kundenseitige Systeme als auch für interne Logs. Obwohl die Daten nicht gespeichert werden, werden sie während des Anrufs verarbeitet. Konfigurierte Post-Call-Webhooks erhalten die Ausgaben, sodass Kunden Transkripte oder Analyseergebnisse bei Bedarf in ihren eigenen Systemen speichern können.
Wenn ZRM aktiv ist, stellen wir zudem sicher, dass Subprozessoren keine Daten speichern. Dafür beschränken wir verfügbare LLMs auf Anbieter mit vertraglichen Zusagen, die das Training mit oder die Speicherung von Kundendaten untersagen. Derzeit umfasst dies Modelle von Google Gemini und Anthropic Claude. Kunden, die unter ZRM ein anderes LLM nutzen möchten, können eine eigene Vereinbarung mit diesem Anbieter schließen und es als benutzerdefiniertes LLM mit API-Schlüsseln konfigurieren, die durch diese Vereinbarung abgedeckt sind. Da dies die Datenverarbeitung über unsere übliche Vertrauensgrenze hinaus erweitert, muss unser Safety-Team den Anwendungsfall manuell prüfen und genehmigen, bevor er aktiviert wird. ZRM stellt sicher, dass ElevenLabs und seine Subprozessoren keine Anrufdaten speichern. Kunden bleiben jedoch dafür verantwortlich, dass externe Tools oder Webhooks ihres Agents die geltenden Anforderungen an Aufbewahrung und Regulierung erfüllen.
Ausblick
In diesem Beitrag haben wir untersucht, wie ElevenLabs Agents Gesprächskontext, Tools, Auswertung und strukturierte Workflows verwalten, um zuverlässige Echtzeiterlebnisse im großen Maßstab bereitzustellen. Da Kunden Agents in immer komplexeren Umgebungen einsetzen, erweitern wir die Flexibilität unserer Orchestrierungs-Engine kontinuierlich – von konfigurierbaren Auswertungsmodellen und erweiterten Übergangssteuerungen bis hin zu tieferer Beobachtbarkeit der Prompt-Komposition und Tokennutzung über alle Phasen hinweg.
Unser Forward Deployed Engineering-Team arbeitet eng mit Kunden zusammen, damit sich diese Fähigkeiten im Gleichschritt mit realen Deployments weiterentwickeln. Die nächste Generation von Agents wird noch mehr Transparenz, Determinismus und Anpassungsfähigkeit bieten, ohne die latenzarme Leistung zu beeinträchtigen, die Echtzeitgespräche ermöglicht.


