Wie wir RAG um 50 % schneller gemacht haben
- Verfasst von
- Michal Korbela
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
RAG verbessert die Genauigkeit von KI-Agenten, indem es LLM-Antworten auf große Wissensdatenbanken stützt. Statt die gesamte Wissensdatenbank an das LLM zu senden, bettet RAG die Anfrage ein, ruft die relevantesten Informationen ab und übergibt sie dem Modell als Kontext. In unserem System fügen wir zunächst einen Schritt zur Umformulierung der Anfrage hinzu, der den Dialogverlauf vor dem Abruf zu einer präzisen, eigenständigen Anfrage verdichtet.
Bei sehr kleinen Wissensdatenbanken kann es einfacher sein, alles direkt in den Prompt einzufügen. Wird die Wissensdatenbank jedoch größer, wird RAG unverzichtbar, um Antworten präzise zu halten, ohne das Modell zu überlasten.
Viele Systeme behandeln RAG als externes Tool. Wir haben es jedoch direkt in die Request-Pipeline integriert, sodass es bei jeder Anfrage ausgeführt wird. Das gewährleistet eine konsistente Genauigkeit, birgt aber auch ein Latenzrisiko.
Warum die Umformulierung von Anfragen uns ausgebremst hat
Die meisten Nutzeranfragen beziehen sich auf vorherige Gesprächsbeiträge. Daher muss das System den Dialogverlauf zu einer präzisen, eigenständigen Anfrage verdichten.
Zum Beispiel:
- Wenn der Nutzer fragt: „Können wir diese Limits anhand unserer Spitzenlastmuster anpassen?“
- Formuliert das System dies um zu: „Können API-Ratenlimits im Enterprise-Tarif für bestimmte Datenverkehrsmuster angepasst werden?“
Die Umformulierung macht aus vagen Bezügen wie „diese Limits“ eigenständige Anfragen, die Abrufsysteme nutzen können. Das verbessert Kontext und Genauigkeit der finalen Antwort. Die Abhängigkeit von einem einzigen extern gehosteten LLM machte uns jedoch stark von dessen Geschwindigkeit und Verfügbarkeit abhängig. Allein dieser Schritt verursachte mehr als 80 % der RAG-Latenz.
Wie wir das mit Model Racing gelöst haben
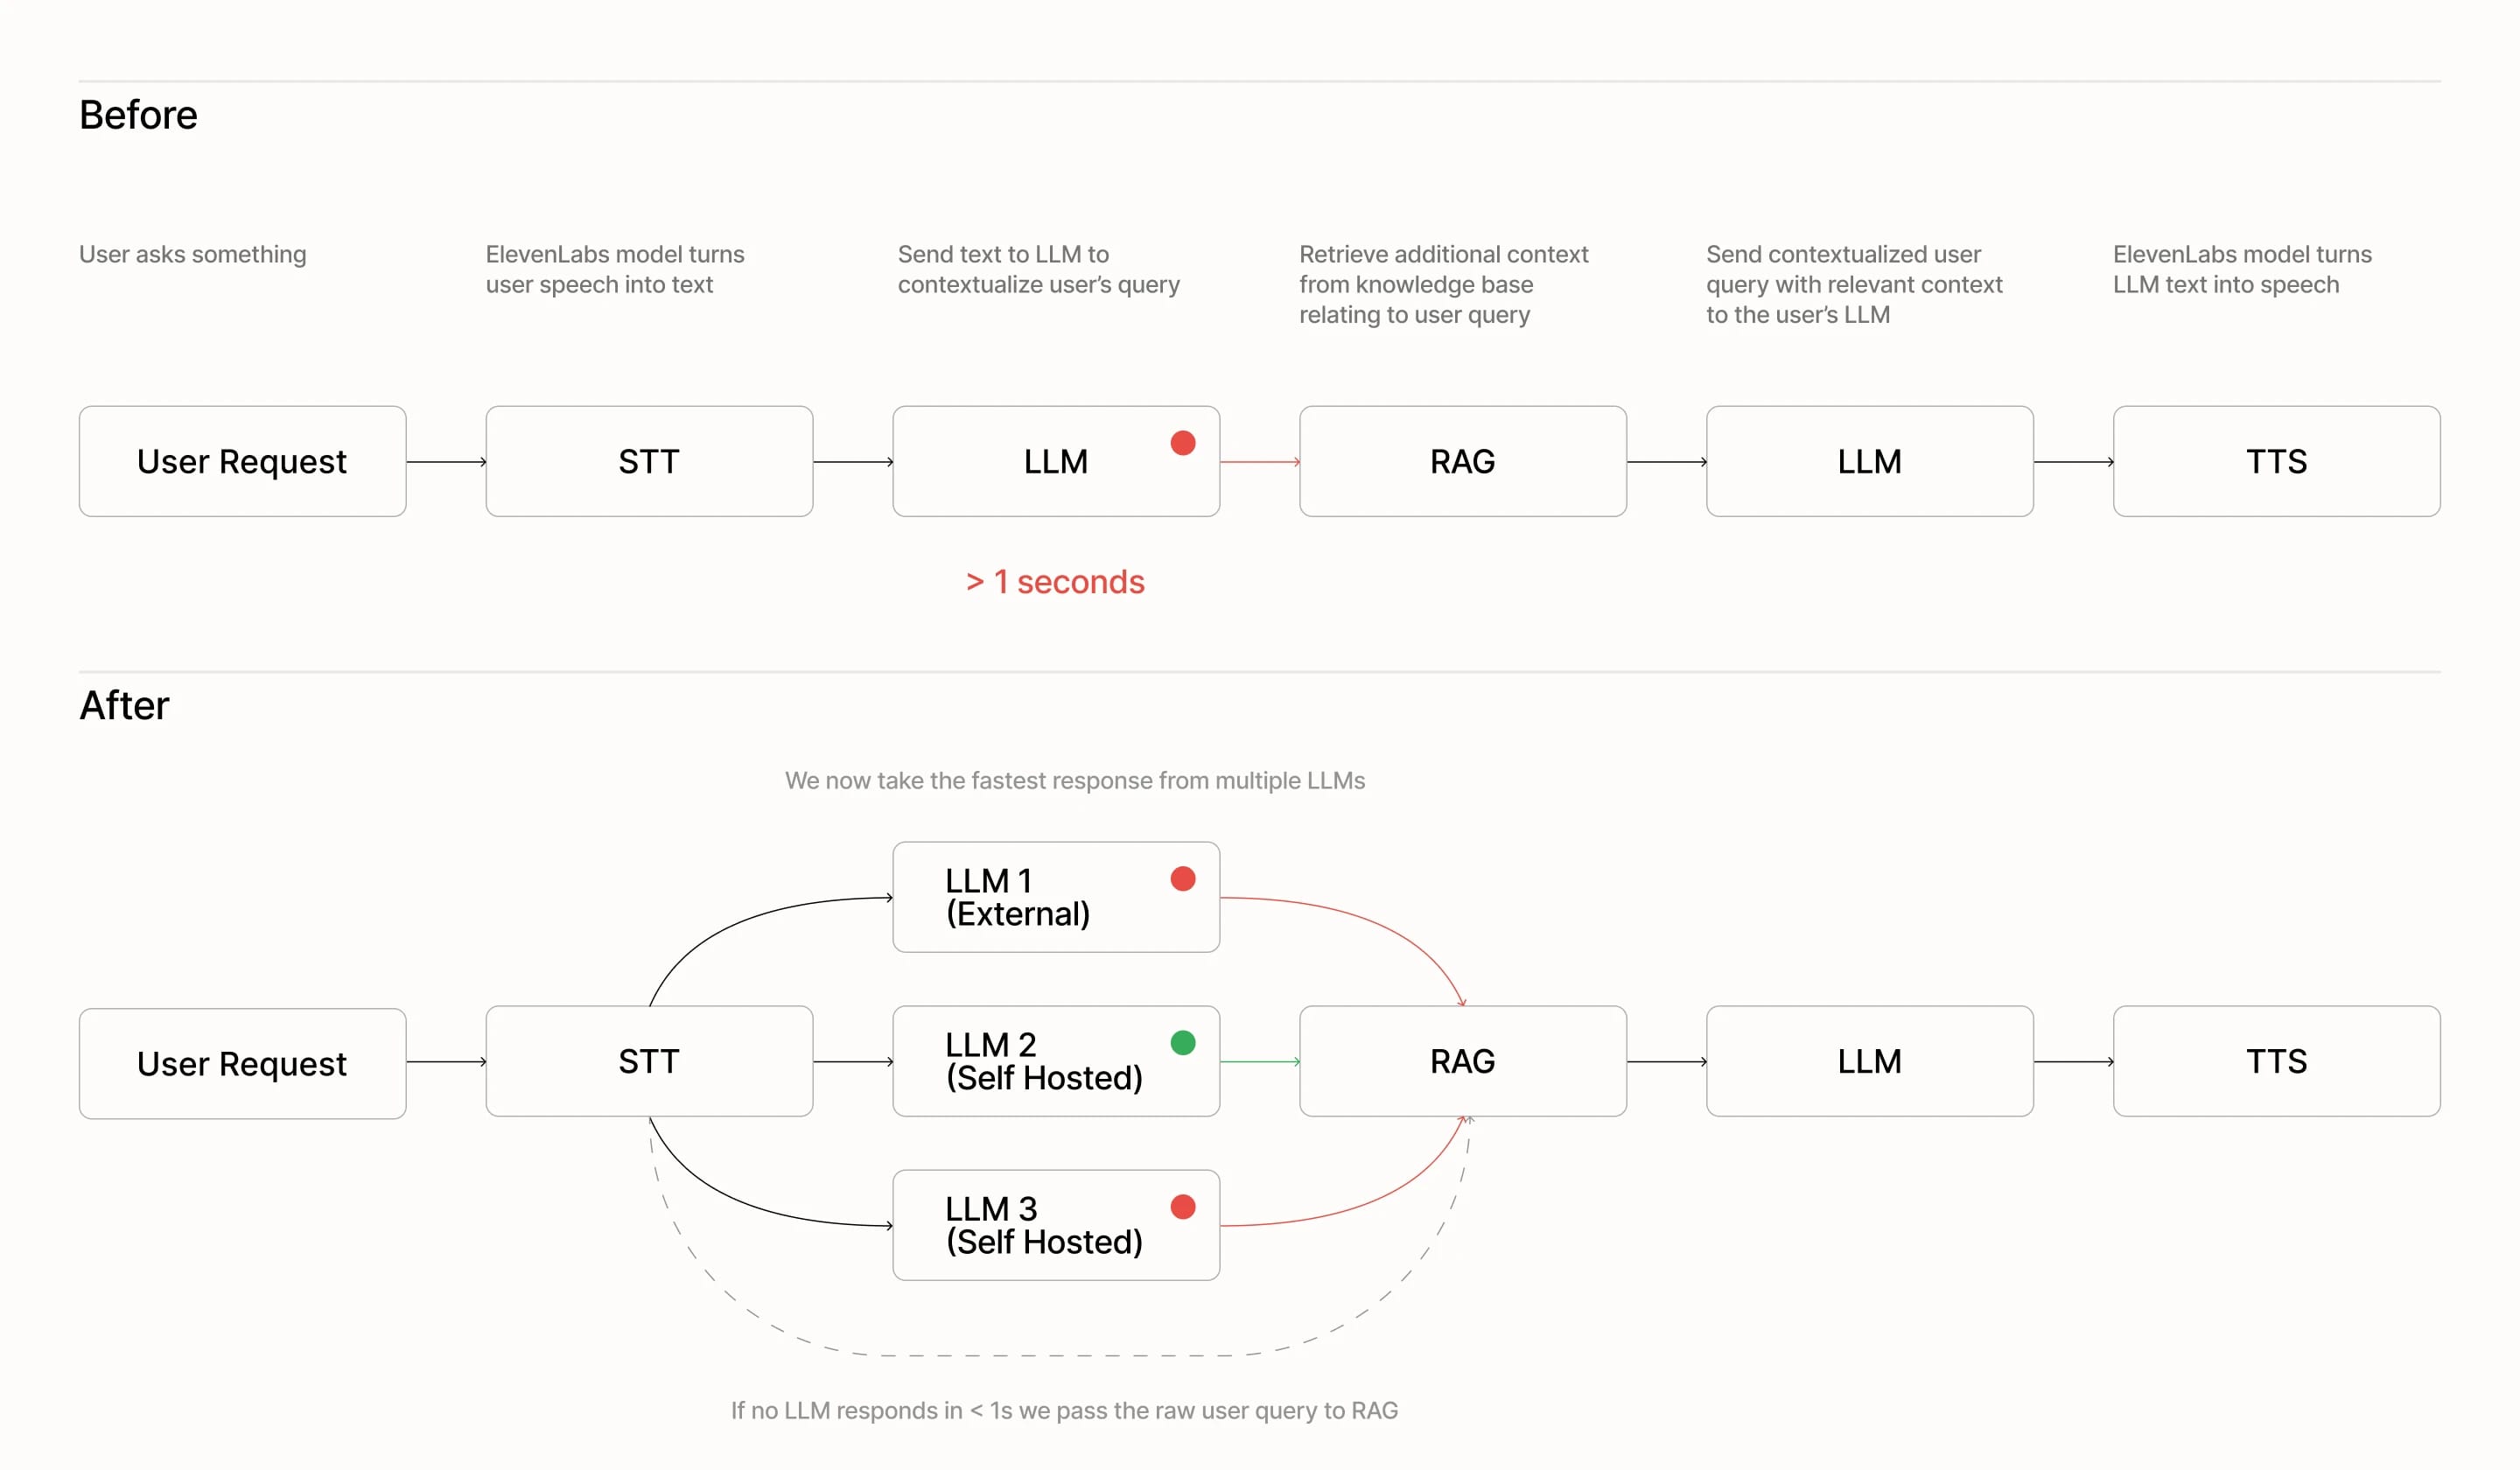
Wir haben die Umformulierung von Anfragen als Wettlauf neu konzipiert:
- Mehrere Modelle parallel. Jede Anfrage wird gleichzeitig an mehrere Modelle gesendet, darunter unsere selbst gehosteten Modelle Qwen 3-4B und 3-30B-A3B. Die erste gültige Antwort gewinnt.
- Fallbacks für unterbrechungsfreie Gespräche. Antwortet innerhalb einer Sekunde kein Modell, greifen wir auf die ursprüngliche Nachricht des Nutzers zurück. Sie ist möglicherweise weniger präzise, vermeidet aber Verzögerungen und stellt Kontinuität sicher.
Die Auswirkungen auf die Performance
Diese neue Architektur halbierte die mediane RAG-Latenz von 326 ms auf 155 ms. Anders als viele Systeme, die RAG selektiv als externes Tool auslösen, führen wir es bei jeder Anfrage aus. Bei einer medianen Latenz von 155 ms ist der zusätzliche Aufwand dafür vernachlässigbar.
Latenz vorher und nachher:
- Median: 326 ms → 155 ms
- p75: 436 ms → 250 ms
- p95: 629 ms → 426 ms
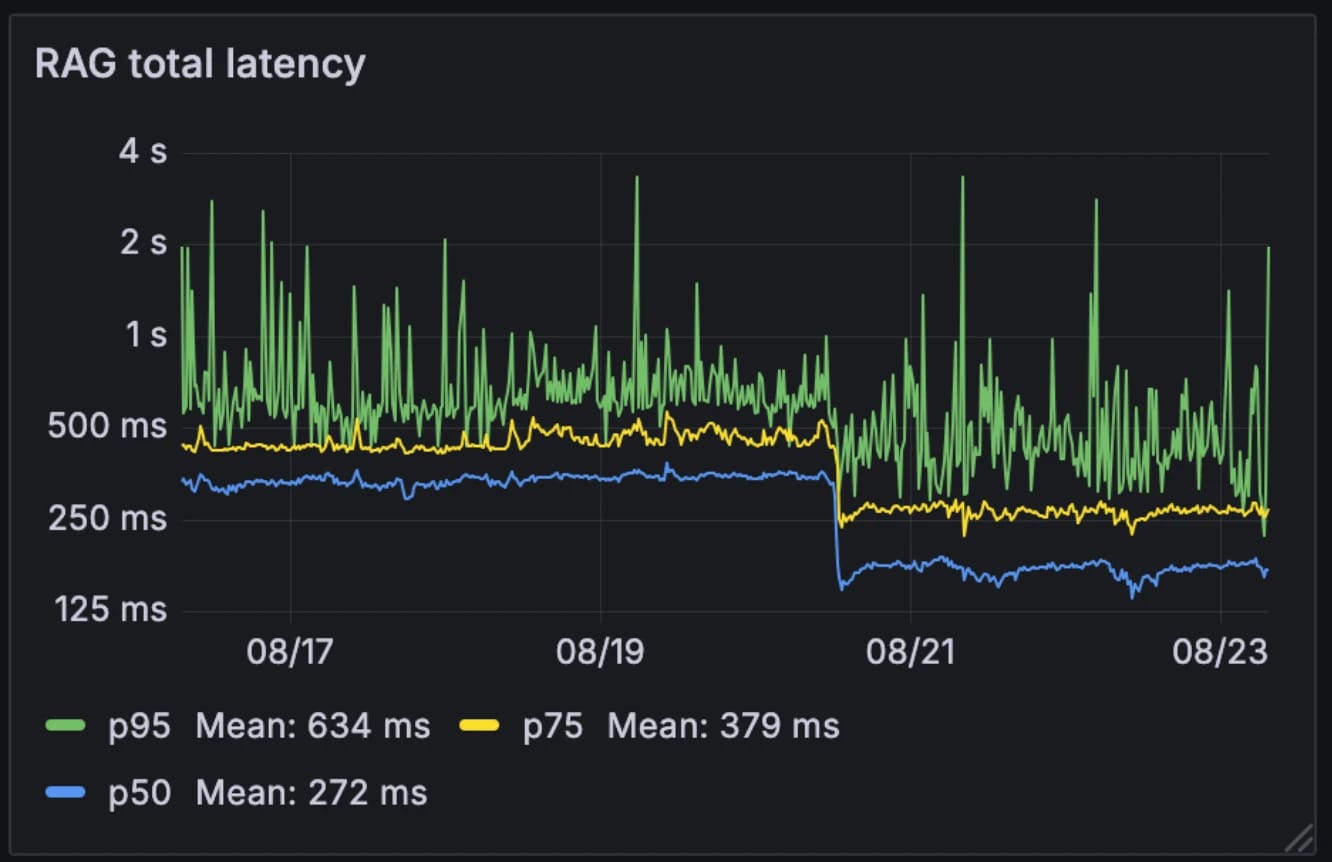
Die Architektur hat das System zudem widerstandsfähiger gegenüber Schwankungen in der Modellleistung gemacht. Während extern gehostete Modelle zu Spitzenzeiten langsamer werden können, bleiben unsere internen Modelle relativ konstant. Der Wettlauf der Modelle gleicht diese Schwankungen aus und macht unvorhersehbare Leistung einzelner Modelle zu stabilerem Systemverhalten.
Als beispielsweise einer unserer LLM-Anbieter im vergangenen Monat einen Ausfall hatte, liefen Gespräche nahtlos auf unseren selbst gehosteten Modellen weiter. Da wir diese Infrastruktur bereits für andere Dienste betreiben, sind die zusätzlichen Rechenkosten vernachlässigbar.
Warum das wichtig ist
Die RAG-Abfrageumformulierung in unter 200 ms beseitigt einen wichtigen Engpass für Conversational Agents. Das Ergebnis ist ein System, das selbst bei großen Unternehmenswissensdatenbanken kontextbewusst bleibt und in Echtzeit arbeitet. Da der Abrufaufwand nahezu vernachlässigbar ist, können Conversational Agents ohne Leistungseinbußen skalieren.