Was sind Audio Tags? Der vollständige Leitfaden für emotionales TTS
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
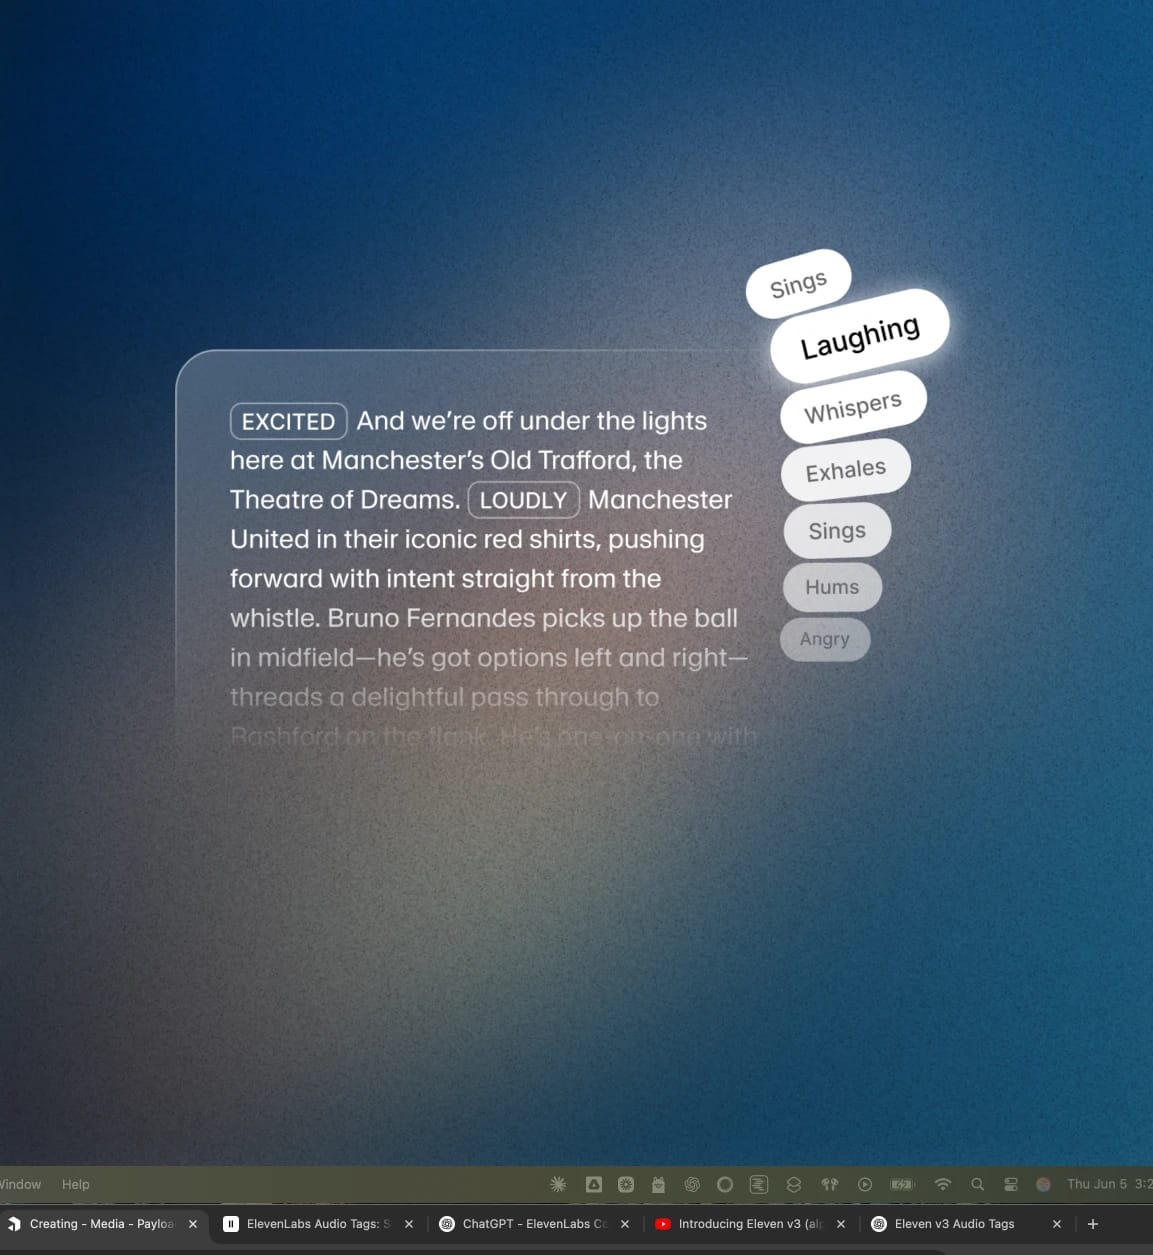
Audio Tags sind natürliche Hinweise in eckigen Klammern wie [laughs], [gasps], [excited] und [worried], die Eleven v3 und Eleven v4 als Regieanweisungen statt als auszusprechende Wörter interpretieren. Wenn Sie ein Skript für ein Text to Speech-Modell schreiben, geben Ihnen diese Audio Tags präzise Kontrolle über die emotionale Wiedergabe Ihres Textes.
Eleven v3 wurde im März 2026 öffentlich verfügbar. Vor v3 war es ein Prozess aus wiederholtem Generieren von Inhalten und Hoffen auf das Beste, eine bestimmte emotionale Wiedergabe aus einem Text to Speech-Modell zu erhalten. Audio Tags beseitigen dieses Rätselraten und geben Ihnen volle Kontrolle über eine emotionale Text to Speech-Wiedergabe. Eleven v4 geht noch weiter und gibt Ihnen präzise emotionale Kontrolle.
Dieser Leitfaden erklärt, was Audio Tags sind, wie sie funktionieren, welche Tag-Kategorien verfügbar sind und wie sie sich mit SSML (Speech Synthesis Markup Language) vergleichen. Außerdem behandeln wir gängige Anwendungsfälle mit Links zu jeweils eigenen Leitfäden.
Zusammenfassung
- Audio Tags sind Hinweise in eckigen Klammern wie [shouts] oder [excited], die Emotion, Tempo, Vortragsweise und Tonfall in TTS mit Eleven v3 und Eleven v4 steuern.
- Eleven v3 und Eleven v4 unterstützen kein SSML, ersetzen es aber durch Audio Tags für ein natürlicheres Schreiberlebnis.
- Tags decken mehrere Kategorien ab, darunter Emotionen, Vortragsweise und Tempo, menschliche Reaktionen, Akzente und Soundeffekte.
- Interpunktion und Großschreibung in Ihrem Text ermöglichen es Ihnen, das Tempo einer KI-Stimmen-Performance zu gestalten.
- Sie können auf Audio Tags in ElevenLabs über die UI oder API zugreifen.
Wie funktionieren Audio Tags?
Audio Tags stehen direkt in Ihrem Transkript und sind in eckige Klammern gesetzt. Wenn sich die Vortragsweise ändern soll, etwa von normal zu [worried], fügen Sie einfach ein Audio Tag hinzu.
Sie können auch mehrere Tags in einem Satz verwenden und sie für eine vielschichtigere Performance kombinieren, etwa [tired] Es war ein langer Tag… [upset] Wie viele weitere Tage halte ich noch durch?
Die Architektur hinter Eleven v4 ermöglicht dem Modell, Kontext tiefer zu erfassen als frühere Modelle. So kann es emotionale Hinweise, Tonwechsel, Sprecherwechsel und Kontextsignale ohne separate Parameter oder Einstellungen berücksichtigen. Sagen Sie dem Modell einfach, was der Moment verlangt, und es liefert die Zeile genau wie geplant.
Eleven v4 beherrscht auch natürlich wirkende Dialoge mit mehreren Sprechern, einschließlich Unterbrechungen, Stimmungswechseln und dem natürlichen Hin und Her echter Gespräche – allein durch Tags und die Skriptstruktur.
Audio Tags vs. SSML
Wenn Sie mit anderen TTS-Systemen gearbeitet haben, kennen Sie wahrscheinlich die Speech Synthesis Markup Language. Plattformen wie Amazon Polly und Microsoft Azure Speech verwenden SSML-Tags wie <break> oder <emphasis>, um einem TTS-Skript zusätzlichen Kontext zu geben.
Eleven v4 unterstützt weder SSML-Break-Tags noch den Rest des SSML-Tag-Sets. Stattdessen übernehmen Audio Tags, Interpunktion und die Struktur eines Textes diese Rolle – bei präziser Kontrolle über die Vortragsweise.
Die folgende Tabelle ordnet gängige SSML-Tags ihrem Eleven v4-Äquivalent zu.
Aus Sicht eines Autors ist es deutlich einfacher, [whispers] zu einer Zeile hinzuzufügen, als eine Prosodie-Rate zu konfigurieren.
Die Kategorien von Audio Tags in v3: Performance mit Audio Tags steuern
Sie können Audio Tags an beliebiger Stelle in Ihrem Skript platzieren, um die Vortragsweise in Echtzeit zu gestalten. Sie können auch Tag-Kombinationen innerhalb eines Skripts oder sogar eines Satzes verwenden.
Tags fallen in die folgenden Kernkategorien.
Emotionen
Diese Tags helfen Ihnen, den emotionalen Ton der Stimme festzulegen – ob düster, intensiv oder beschwingt. Sie können beispielsweise einen oder mehrere der Tags [sad], [angry], [happily] und [sorrowful] verwenden.
Vortragsweise und Tempo
Hier geht es stärker um Tonfall und Performance. Mit diesen Tags passen Sie Lautstärke und Energie für Szenen an, die Zurückhaltung oder Nachdruck erfordern. Beispiele sind [whispers], [shouts] und [softly].
Menschliche Reaktionen
Natürliches Sprechen enthält Reaktionen. Sie können damit Realismus schaffen, indem Sie natürliche, ungeplante Momente in Sprache einbetten. Tags wie [laughs], [clears throat] und [sighs] helfen dabei, ein TTS-Modell zu schaffen, das menschliche Emotionen ausdrücken kann.
Weitere Beispiele für Kategorien von Audio Tags:
- Akzente und Charakterstimmen: Akzent-Tags versetzen die Stimme in eine bestimmte Region oder Persona, ohne das Modell zu wechseln, etwa [French accent], [British accent] oder [pirate voice]. So machen Sie aus einer einzelnen Stimme eine flexible Besetzung statt einer festen Performance.
- Soundeffekte: Soundeffekt-Tags fügen nichtsprachliche Audios direkt zur Generierung hinzu, etwa [gunshot], [explosion] und [clapping]. Sie eignen sich für immersive Audios, Spiele und dramatisierte Erzählungen, bei denen die Szene mehr als eine Stimme braucht. Alternativ nutzen Sie den ElevenCreative KI-Soundeffekt-Generator.
Tags geben Ihnen weitreichende Kontrolle, doch auch mit Interpunktion können Sie Rhythmus und Betonung gestalten. Fügen Sie beispielsweise Auslassungspunkte für eine natürliche Pause hinzu oder verwenden Sie Kommas für natürliche Atempausen. Schreiben Sie ein Wort in Großbuchstaben, um es zu betonen: „Ich will es JETZT.“
Was können Sie mit Audio Tags tun?
Audio Tags erschließen die emotionale Komplexität von Skripten auf intuitive Weise. Schreiben Sie natürlich und fügen Sie Tags nach Bedarf hinzu.
Hier sehen Sie einige Anwendungsfälle für emotionales TTS mit Audio Tags.
Situationsbewusstsein in KI-Audio
Tags wie [whisper] oder [shouting] ermöglichen Eleven v4, auf den jeweiligen Moment zu reagieren. Ob Sie eine Warnung abschwächen oder für Spannung eine verlängerte Pause halten: Sie können dynamisches Situationsbewusstsein in Ihr Skript einbauen.
Eine vollständige Aufschlüsselung finden Sie in unserem Leitfaden zu Situationsbewusstsein in KI-Audio.
Charakter-Performance in Sprache steuern
Wenn Sie ein Skript mit mehreren Charakteren entwickeln, möchten Sie klar zeigen, wie sich jede Stimme unterscheidet. Von der Anpassung ihrer Persönlichkeit mit [sarcastically] bis zur Definition ihrer Sprechweise mit [British accent] können Sie mit unserer TTS-Engine ein vollständiges Spektrum an Emotionen abbilden.
Erfahren Sie mehr über die Steuerung von Charakter-Performance in KI-Sprache.
Emotionalen Kontext in Sprache ausdrücken
Mit Audio Tags können Sie die emotionale Wiedergabe einer Zeile während ihres Verlaufs gestalten. Sie können Emotionen über eine gesamte Rede hinweg aufbauen und einen Höhepunkt erreichen, wenn Sie Ihren Charakter in seiner vollen Entfaltung sehen. Tags wie [awe], [booming] und [big laugh] helfen Ihnen, ein vollständiges emotionales Spektrum in Ihre KI-Stimmen-Performance einzubauen.
Lesen Sie mehr über den Einsatz von emotionalem Kontext in KI-Sprache.
Dialoge mit mehreren Charakteren zum Leben erwecken
Bei Dialog-Performances mit mehreren Charakteren können Sie jede Zeile mit einem Audio Tag beginnen, um vielseitige Charakterdialoge zu entwickeln.
Nehmen Sie folgendes Beispiel: Tom: [coughing] [beginning to speak] Entschuldigung, ich bin heute etwas krank— Emma: [interrupting] —Krank? Du weißt doch, wie sehr ich Husten hasse, Tom! Tom: [surprised] Es ist nur ein kleiner Husten, nichts Ernstes. Wie würdest du dich fühlen, wenn— Emma: [overlapping] [annoyed] —Ich glaube, du solltest nach Hause gehen.
Erfahren Sie, was Sie außerdem mit Dialogen mit mehreren Charakteren in Eleven v3 tun können.
Präzise Steuerung der Vortragsweise für KI-Sprache
Mit Eleven v3 und Eleven v4 steuern Sie das Sprechtempo über Audio Tags oder Interpunktion. Tags wie [pause], [rushed] oder [drawn out] ermöglichen Ihnen, die Zeile aktiv und präzise zu gestalten. Alternativ können Sie Auslassungspunkte, Punkte und Ausrufezeichen einsetzen, um Emotionen natürlich in Ihre TTS-Performance einzubauen.
Wir haben einen ausführlichen Leitfaden über präzise Steuerung der Vortragsweise in Eleven v3 verfasst.
Emotionales TTS ist über die API verfügbar
Audio Tags funktionieren über die Text to Speech API genauso wie in der ElevenLabs-UI. Schreiben Sie das Tag direkt in den Skripttext, und die API gibt die getaggte Performance im generierten Audio zurück – von Hörbuch-Pipelines bis zu Werbe-Voiceovers.
Erfahren Sie mehr über Eleven v4 oder kontaktieren Sie den Vertrieb und starten Sie noch heute.
FAQ zu Audio Tags und emotionalem TTS

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.