Eleven v3 Audio Tags: Situatives Bewusstsein für KI-Audio
- Verfasst von
- Ryan Morrison
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Audio Tags sind ein zentraler Bestandteil des neuen Eleven v3 (Alpha)-Modells für Text to Speech. Sie ermöglichen es Ihnen, die Darbietung von Textzeilen zu steuern — indem Sie Tonfall, Emotion und Tempo an den realen Kontext anpassen.
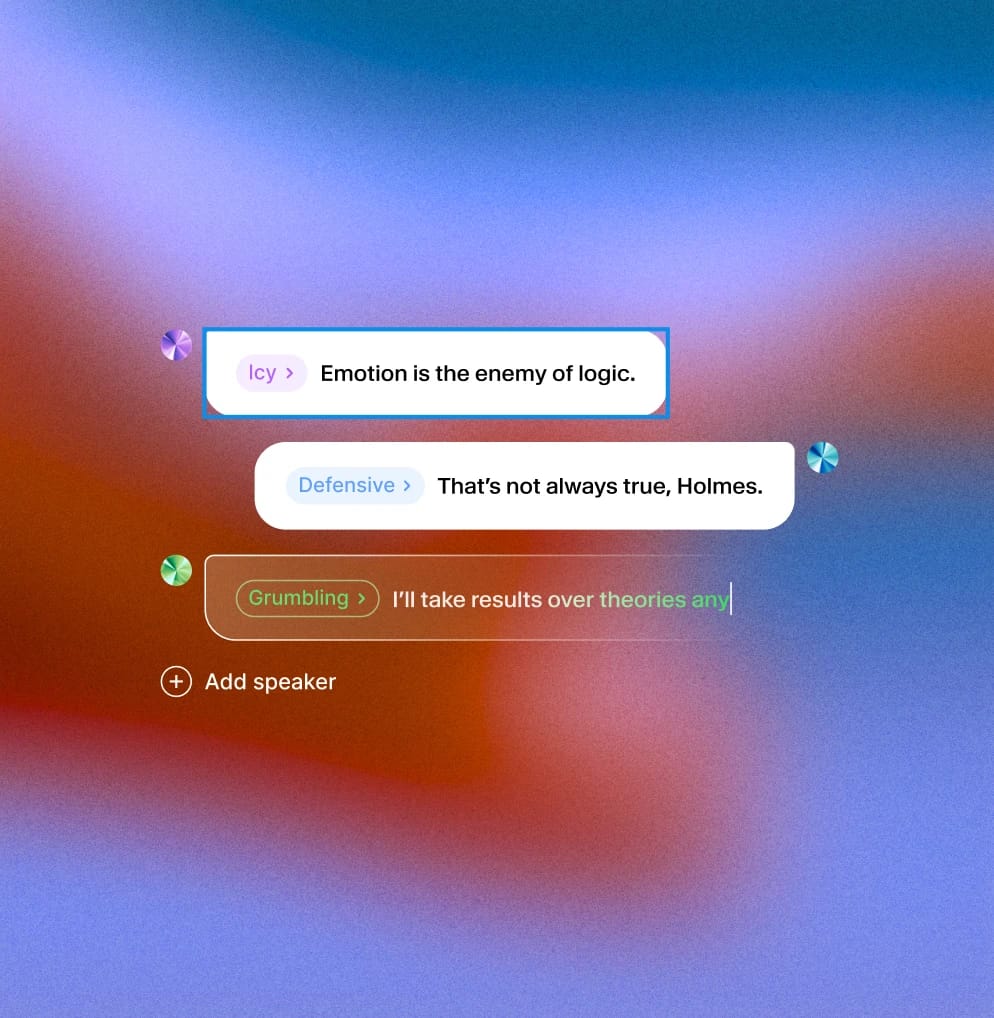
Audio Tags sind einfach gesagt Wörter in eckigen Klammern. Das Modell interpretiert sie als Regieanweisungen. So können Sie die Sprechweise mitten im Satz an emotionale Momente oder situative Veränderungen anpassen — und der KI ein gewisses Situationsbewusstsein geben.
Was bedeutet Situationsbewusstsein bei KI-Sprache?
Situationsbewusstsein bedeutet, dass die KI ihre Sprechweise an den jeweiligen Moment anpasst. Mit Audio Tags steuern Sie nicht nur, was das Modell sagt — sondern auch, wie es reagiert.
Ob Sie mit dem Tag [SHOUTING] Dringlichkeit erzeugen, mit [WHISPER] eine Warnung abschwächen oder mit [SIGH] Zögern vermitteln: Tags machen aus einer Erzählung eine Darbietung. Besonders wertvoll sind sie in Szenen mit viel Kontext oder Dynamik.
Darbietung statt bloßes Vorlesen
Stellen Sie sich vor, Sie schreiben das Skript für ein Veo-3-Highlight-Video eines Fußballspiels zwischen 11 United und 12 United. Die Intensität soll mit dem Spielgeschehen steigen: „Er zieht an einem Verteidiger vorbei — [EXCITED] jetzt kommt die Flanke — [SHOUTING] TOOOOR!“
Oder Sie vertonen einen spannungsgeladenen Moment in einem Hörbuch: „[WHISPERING] Ich glaube, jemand ist im Haus. [PAUSE] Bleib leise.“
Das sind keine stilistischen Zusätze. Sie definieren den Moment und prägen seine Wirkung. Das Modell liest nicht vor — es spielt.
Gängige Tags für situative Einsätze
Mit Audio Tags können Sie verschiedene emotionale und körperliche Signale simulieren:
- Emotionaler Tonfall: [EXCITED], [NERVOUS], [FRUSTRATED], [TIRED]
- Reaktionen: [GASP], [SIGH], [LAUGHS], [GULPS]
- Lautstärke & Energie: [WHISPERING], [SHOUTING], [QUIETLY], [LOUDLY]
- Tempo & Rhythmus: [PAUSES], [STAMMERS], [RUSHED]
Tags lassen sich kombinieren, um Nuancen hinzuzufügen: „[NERVOUSLY] Ich ... ich bin nicht sicher, ob das funktioniert. [GULPS] Aber versuchen wir es trotzdem.“
Darbietungen gezielt steuern
Eleven v3 unterstützt diese Tags mit einem tieferen Kontextmodell. Es kann den Tonfall mitten in der Zeile ändern, Unterbrechungen verarbeiten und den Redefluss halten — für eine natürlichere Sprechweise, ohne das Skript umzuschreiben.
Für Voice-Designer, Spieleentwickler und Geschichtenerzähler eröffnet das eine neue kreative Ebene. Sie schreiben nicht nur Dialogzeilen. Sie führen Regie.
Die richtige Stimme auswählen
Professional Voice Clones (PVCs) sind derzeit noch nicht vollständig für Eleven v3 optimiert. Dadurch kann die Klonqualität im Vergleich zu früheren Modellen geringer ausfallen. Wenn Sie v3-Funktionen nutzen möchten, empfiehlt es sich in dieser Forschungs-Vorschauphase, einen Instant Voice Clone (IVC) oder eine gestaltete Stimme für Ihr Projekt zu wählen. Die PVC-Optimierung für v3 folgt in Kürze.
Ryan kam zu ElevenLabs nach mehr als zwei Jahrzehnten im Nachrichten- und Verlagswesen, einschließlich Rollen bei der BBC und Future Plc. Er konzentriert sich auf Content-Strategie und Storytelling und hilft ElevenLabs, seine Geschichte zu gestalten und zu teilen.