Flash kennenlernen
- Veröffentlicht
AnhörenArtikel anhören
Flash kennenlernen. Unser neuestes Modell erzeugt Sprache in 75 ms plus Anwendungs- & Netzwerklatenz.
Flash ist unser empfohlenes Modell für latenzarme dialogorientierte Sprachagenten. Sie können Flash schon heute auf unserer Conversational-AI-Plattform nutzen.
Oder entwickeln Sie direkt über die API mit den Modell-IDs „eleven_flash_v2“ und „eleven_flash_v2_5“: https://elevenlabs.io/docs/api-reference/text-to-speech/convert
Flash v2 ist nur auf Englisch verfügbar, Flash v2.5 unterstützt 32 Sprachen. Beide kosten 1 Credit pro 2 Zeichen
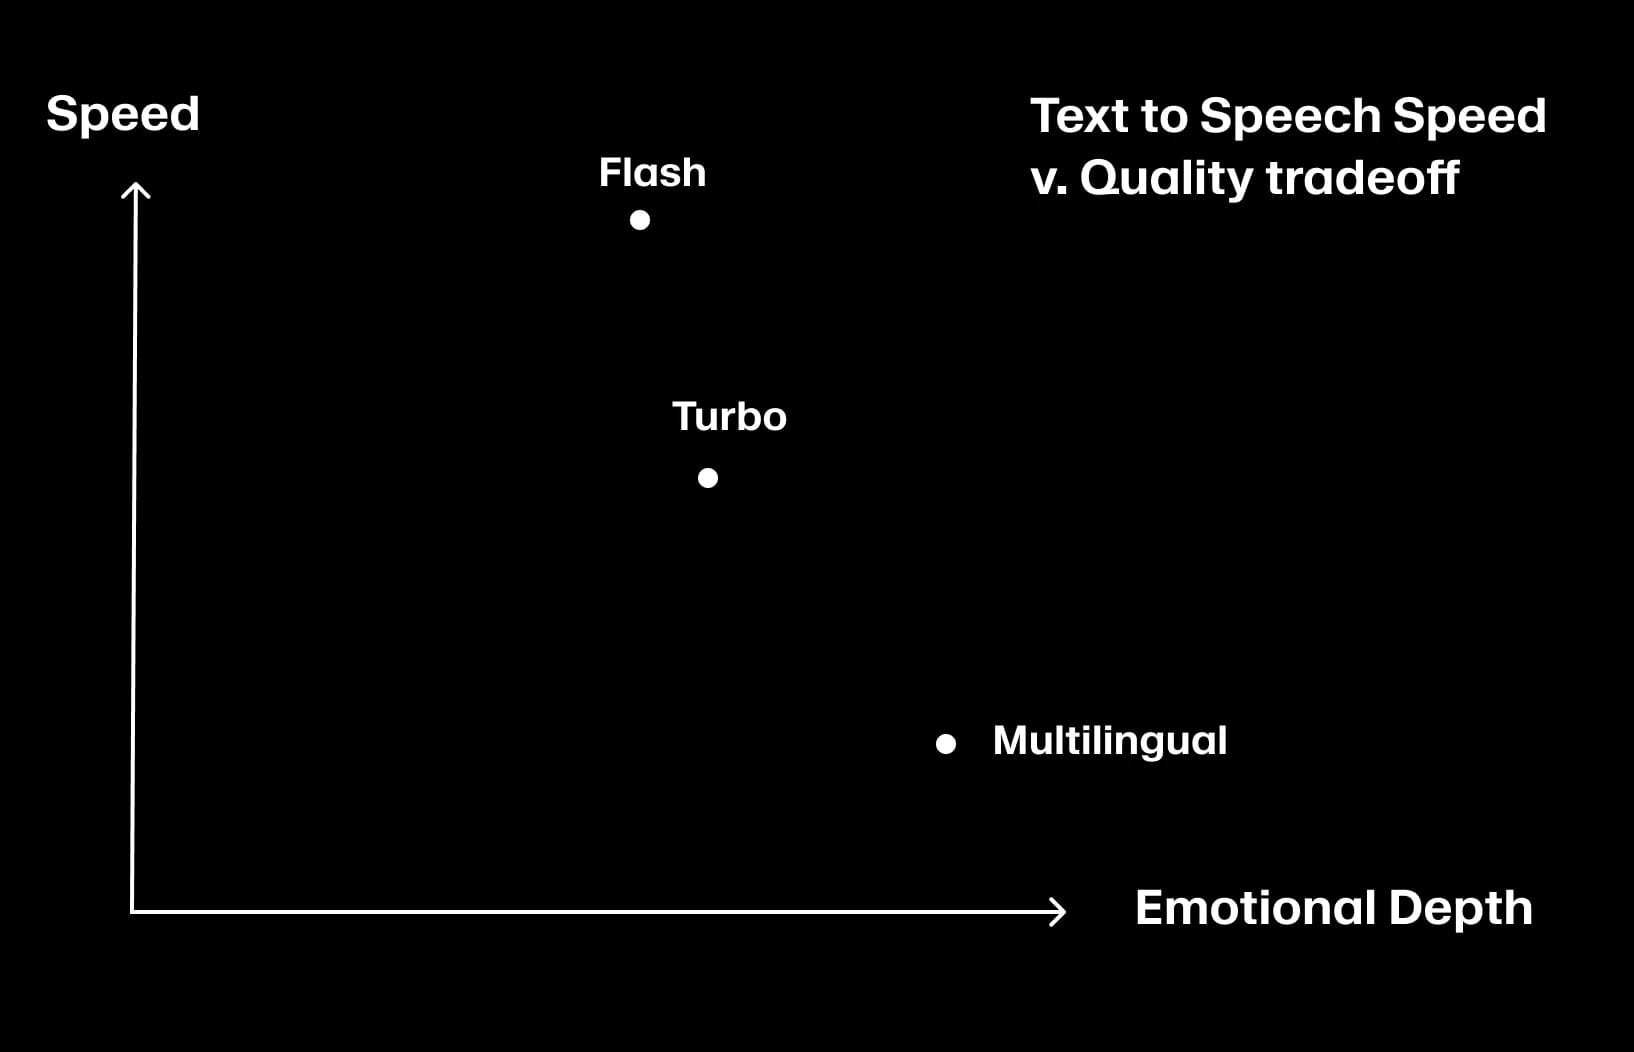
Es bietet etwas geringere Qualität und emotionale Tiefe als die Turbo-Modelle, aber deutlich niedrigere Latenz. In Blindtests mit unseren menschlichen Bewertern erzielte Eleven Flash durchgehend bessere Ergebnisse als vergleichbare Modelle mit extrem niedriger Latenz. Damit ist es das schnellste Modell seiner Art mit dieser Qualität.
In unserem Leitfaden zu Modellen finden Sie das beste Modell für Ihren Anwendungsfall: https://elevenlabs.io/docs/developer-guides/models
Wir freuen uns auf all die latenzarmen, menschenähnlichen dialogorientierten Interaktionen, die Flash ermöglichen wird.