
Bewertungsrahmen für Sprachagenten: 6 Säulen erklärt
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Voice Agents müssen eine Vielzahl nahezu gleichzeitig arbeitender Tools orchestrieren. Es ist ein präzises Zusammenspiel aus der Erfassung von Kundenanmerkungen mit Echtzeit-Speech to Text (STT), der Verarbeitung von Kontext und Erstellung einer Antwort mit einem Large Language Model (LLM) sowie der anschließenden Audiogenerierung mit Text to Speech-Software (TTS).
Wie lässt sich die Leistung von Voice Agents bei so vielen beweglichen Teilen präzise bewerten?
In diesem Artikel stellen wir ein Framework zur Bewertung von Voice Agents mit sechs Säulen vor. Es beschreibt genau, was Sie bei der Bewertung des Agentenerfolgs messen sollten. Außerdem erläutern wir, warum Branchen diese Säulen unterschiedlich gewichten sollten und welche häufigen Fehler Sie bei der Bewertung vermeiden sollten.
Zusammenfassung
- Die sechs zentralen Säulen zur Bewertung von Voice Agents sind TTS-Stimmqualität, Gesprächsqualität, Tool-Nutzung und Aufgabenerledigung, Intelligenz, Compliance und Sicherheit sowie Zuverlässigkeit.
- Die wichtigsten Ziele für den Produktivbetrieb sind ein MOS von 4,3, ein TSR von über 85 % und eine Zeit bis zum ersten Audio unter 500 ms.
- Verschiedene Branchen gewichten die einzelnen Säulen unterschiedlich, wobei bestimmte Einsatzbereiche einer Säule Vorrang geben.
- Häufige Testfehler sind, nur sauberes Audio zu bewerten und P99-Latenzspitzen zu ignorieren.
- ElevenLabs führt bei den wichtigsten Kennzahlen: Scribe v2 erreicht mit 2,2 % die niedrigste WER im Markt (Artificial Analysis, Juni 2026), Flash v2.5 und Turbo v2.5 gehören bei der Geschwindigkeit zu den führenden Modellen (Artificial Analysis, Juni 2026), und ElevenAgents bietet eine Modellinferenzlatenz von ca. 75 ms.
Was ist ein Framework zur Bewertung von Voice Agents?
Ein Framework zur Bewertung von KI-Voice-Agents ist ein strukturiertes System, mit dem Sie Leistung über mehrere Dimensionen hinweg testen können. Ein umfassendes Framework enthält Kennzahlen für alles – von Audiotreue über Gesprächsfluss bis hin zur Einhaltung regulatorischer Vorgaben.
Im Gegensatz zu einem Text-Chatbot leitet ein Voice Agent jede Interaktion durch mindestens drei aufeinander aufbauende Technologien: automatische Spracherkennung (ASR), die die Worte eines Nutzers in Text umwandelt; ein LLM, das eine Antwort erstellt; und ein TTS-System, das diese Antwort wieder in Audio umwandelt. Fällt eines dieser Systeme aus, beeinträchtigt das die gesamte Erfahrung.
Genau diese Komplexität macht es erforderlich, dass Unternehmen Voice Agents vor der Auswahl eines Anbieters und dem Deployment bewerten. Zusätzliche Latenz oder ungenaue Antworten können reale Folgen haben, etwa Kundenabwanderung oder schlimmstenfalls regulatorische Geldstrafen und Reputationsschäden.
Ein Framework zur Bewertung von Voice Agents nutzt Benchmarks und messbare Daten, um festzustellen, ob ein Agent für bestimmte Anwendungsfälle geeignet ist. Aus geschäftlicher Sicht hilft Ihnen die Bewertung verschiedener Sprachmodelle, das beste Modell für Ihre Kunden auszuwählen.
Die sechs Säulen zur Bewertung von Voice Agents
Obwohl Sie einen KI-Agenten erstellen und bereitstellen können wie nie zuvor, sind die aktiven Prozesse im Hintergrund recht komplex. Mehrere Komponenten arbeiten zusammen, um einem Nutzer zuzuhören, seine Absicht zu verstehen, diese Informationen an ein LLM weiterzugeben und anschließend eine Audioantwort zu erzeugen. Dabei laufen viele Aktionen nahezu gleichzeitig ab.
Wenn Unternehmen mit dem bestmöglichen Voice Agent zusammenarbeiten möchten, benötigen sie ein strenges Framework für Benchmarks.
Wenn Sie eher an Testergebnissen interessiert sind, bietet Artificial Analysis verschiedene Agentenvergleiche anhand unterschiedlicher Komponenten. Unten sehen Sie die Ergebnisse ihres direkten Geschwindigkeitsvergleichs, in dem ElevenLabs Turbo v2.5 und Flash v2.5 bei den pro Sekunde verarbeiteten Zeichen mit deutlichem Abstand führen.
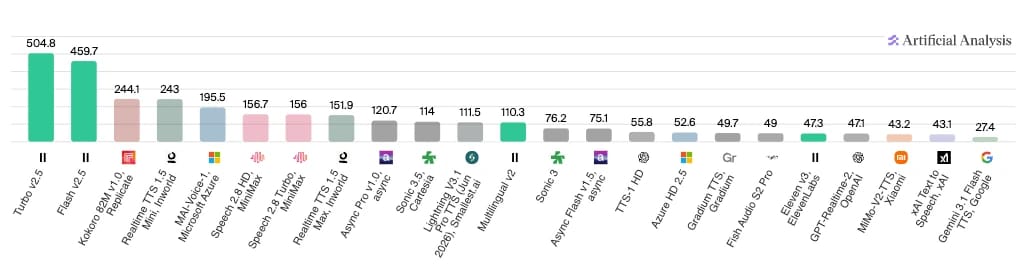
Für Entwickler und Unternehmen, die eigene Experimente durchführen möchten, sind dies die sechs Säulen eines Bewertungsframeworks für KI-Agenten:
- TTS-Stimmqualität: Wie natürlich, klar und ausdrucksstark synthetisierte Sprache für Endnutzer klingt. Führende Modelle wie Eleven v4 bieten in über 70 Sprachen eine menschenähnliche, emotionale Sprachwiedergabe.
- Gesprächsqualität: Versteht ein Modell menschliche Sprache, erfasst es die Bedeutung und antwortet es über mehrere Gesprächswechsel hinweg zeitnah im Kontext?
- Tool-Nutzung: Das Ausmaß, in dem ein KI-Agent Aufgaben mit verfügbaren Ressourcen ohne menschliches Eingreifen erledigt.
- Intelligenz: Wie gut ein Modell schlussfolgert, neue Eingaben verarbeitet und ungenaue oder halluzinierte Antworten vermeidet.
- Compliance und Sicherheit: Neben allen Fähigkeiten müssen KI-Voice-Agents alle regulatorischen und Compliance-Anforderungen einschließlich aktiver Schutzmechanismen erfüllen.
- Zuverlässigkeit: Faktoren wie die Gesamtverfügbarkeit und konsistente Leistung unter Last entscheiden darüber, ob ein Conversational-AI-Agent mit der Nachfrage skalieren kann.
Obwohl jede dieser Säulen eigenständig ist, greifen sie ineinander und schaffen ein hochwertiges Enderlebnis für Nutzer. Verbessert ein Modell beispielsweise die Stimmqualität, hat aber weiterhin eine hohe Latenz, entstehen für Kunden unangenehme Wartezeiten, bevor das Modell spricht.
Sehen wir uns diese Säulen zur Bewertung von Voice AI genauer an.
TTS-Stimmqualität
Wir beginnen mit der Stimmqualität, da sie Menschen bei der Interaktion mit einem Conversational-AI-Agenten vermutlich zuerst auffällt. Klingt die Stimme roboterhaft oder unheimlich, verschlechtert sich das subjektive Erlebnis erheblich.
Eine der ursprünglichen Bewertungskennzahlen, definiert vom Telecommunication Standardization Sector der Internationalen Fernmeldeunion (ITU-T), ist der Mean Opinion Score (MOS). MOS verwendet eine Skala von 1 bis 5, wobei 1 unbrauchbar und 5 ausgezeichnet bedeutet. Bei dieser subjektiven Messung hören Menschen zu und geben nach einem Anruf Feedback.
Alles unter MOS 3,5 ist auf dieser Skala wenig überzeugend, insbesondere nach heutigen Maßstäben, und dürfte die Kundenzufriedenheit beeinträchtigen.
MOS ist zwar eine menschenzentrierte Kennzahl, doch mehrere technische Anforderungen fließen in diesen Wert ein:
- Tonhöhenkonsistenz und Jitter: Tonhöhe und Jitter sind zwei sprachliche Elemente, die Menschen beim Zuhören intuitiv wahrnehmen. „Tonhöhe“ bezeichnet die wechselnde Intonation beim Sprechen, etwa wenn Sie bei einer Frage natürlicherweise die Stimme heben. Jitter entsteht, wenn das Verständnis eines Sprachmodells für Tonhöhe schwankt und es dadurch keine stimmige Prosodie über einen Satz hinweg beibehalten kann. Der Branchenrichtwert für Jitter liegt bei 30 ms.
- Emotionaler Ausdruck: Eine klare und präzise Stimme klingt dennoch falsch, wenn ihr Ton nicht zum beabsichtigten emotionalen Gehalt eines Satzes passt. Ohne präzise tonale Hinweise bauen menschliche Zuhörer weniger Beziehung zu Conversational-AI-Agenten auf und bewerten sie schlechter. ElevenAgents bietet nahezu menschenähnlichen Ausdruck und verbindet jede Antwort mit einer klaren emotionalen Absicht.
- Hintergrundgeräusche: Hintergrundgeräusche bei Voice Agents haben zwei separate Dimensionen, die bewertet werden sollten. Auf der Ausgabeseite werden Antworten dezent Umgebungsgeräusche hinzugefügt, damit Agents natürlicher klingen. Auf der Eingabeseite ist die Filterung von Hintergrundgeräuschen auf der STT-Ebene eine optionale Einstellung, die die Genauigkeit erhöht. Testen Sie bei der Bewertung eines Agents beides: Prüfen Sie, ob Umgebungsgeräusche natürlich klingen, und bewerten Sie die STT-Genauigkeit mit aktiviertem und deaktiviertem Rauschfilter.
Beim Berechnen des MOS sollten Sie 4,3 bis 4,5 anstreben. Das zeigt hohe Werte in allen diesen Wahrnehmungskategorien. Für MOS-Prognosen im großen Maßstab ohne menschliche Testgruppen können Sie Tools wie UTMOS und NISQA verwenden.
Gesprächsqualität
Gesprächsqualität ist eine zusammengesetzte Säule zwischen Stimmqualität und Aufgabenerledigung. Sie misst, wie effektiv ein Voice Agent die Bedürfnisse eines Nutzers versteht, ihn kontextgerecht unterbricht und dies über einen mehrstufigen Dialog bis zum Abschluss fortführt.
Die wichtigste Kennzahl ist hier die Genauigkeit der Intent-Klassifizierung. Typische Werte liegen zwischen 85 % und 92 %, Spitzenmodelle erreichen über 96 %. 85 % mögen hoch erscheinen, bedeuten jedoch, dass 15 % des eingehenden Traffics falsch kategorisiert und an die falschen Ressourcen weitergeleitet werden.
Zu den technischen Faktoren für eine hohe Genauigkeit der Intent-Klassifizierung gehören:
- Sprecherwechsel: Der Sprecherwechsel bestimmt, wie gut ein Voice Agent den natürlichen Gesprächsfluss steuert. Er bewertet, wann der Agent zuhören, antworten oder auf weitere Eingaben warten sollte. Dazu gehört auch der Umgang mit Unterbrechungen, bei denen ein Modell eine bereits laufende Antwort verwirft und anhand der neuen Eingabe eine neue erstellt. ElevenLabs verwendet einen Multi-Kontext-WebSocket für die nahtlose Verarbeitung dieser eleganten Unterbrechungen.
- Latenz: Latenz bezeichnet die Ende-zu-Ende-Verzögerung zwischen dem Ende eines Satzes durch den Nutzer und dem Beginn der Audioantwort des Agents. Voice Agents für den Produktivbetrieb sollten eine Zeit bis zum ersten Audio unter 500 ms anstreben; unter 300 ms ist besser. ElevenLabs Flash-Modelle bieten mit ca. 75 ms eine branchenführende Modellinferenzzeit und schaffen damit gute Voraussetzungen in dieser Kategorie.
- Fallback-Rate: Die Fallback-Rate misst, wie oft ein KI-Agent einen Nutzer nicht versteht und um Klarstellung oder Wiederholung bittet. Sie ist weitgehend eine Folge der STT-Genauigkeit: Verhört oder verfälscht die Spracherkennung, was ein Kunde gesagt hat, erhält das LLM fehlerhafte Eingaben. Die Fallback-Rate wird nach folgender Formel berechnet: Fallback-Rate (%) = (Anzahl der Fallbacks / Gesamtzahl der Interaktionen) * 100.
ElevenLabs Scribe V2 hat bei der Speech-to-Text-Modellevaluierung von Artificial Analysis mit 2,2 % die niedrigste WER
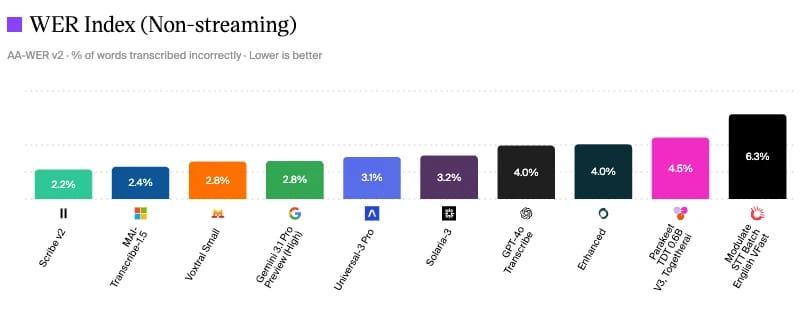
Bewertung von Speech-to-Text-Modellen durch Artificial Analysis
Eine Möglichkeit zur Messung der Gesprächsqualität ist die Betrachtung von Branchenbenchmarks für unterschiedliche Komponenten. Wie Sie sehen, hat ElevenLabs’ Scribe v2 mit 2,2 % seit Juni 2026 die niedrigste Word Error Rate. Das bedeutet weniger Fehlverständnisse, weniger Fallbacks und eine genauere Intent-Klassifizierung.
Unternehmen stellen möglicherweise fest, dass die Gesprächsqualität auch vom Workflow abhängt, in dem ein Voice Agent eingesetzt wird. Im Kundenservice wären beispielsweise die Qualität der Eskalationsübergabe oder die Lösung von FAQs weitere Aspekte.
Tool-Nutzung und Aufgabenerledigung
Während Qualität misst, wie sich ein Gespräch angefühlt hat, misst die Aufgabenerledigung, ob es zu einem erfolgreichen Ergebnis geführt hat. Unternehmen sollten diesem Teil des Bewertungsframeworks für Voice Agents besondere Aufmerksamkeit schenken, da er direkt mit Geschäftsergebnissen verbunden ist.
Ein Maß für die Tool-Nutzung ist die Genauigkeit der Slot-Befüllung. Sie bestimmt, wie gut KI-Agenten routinemäßige Aufgaben erledigen können, etwa das Ausfüllen eines Formulars mit Kundeninformationen. Eine hohe Genauigkeit bei der Slot-Befüllung zeigt, dass der Agent nahtlos vom Gespräch zur Aktion übergehen kann, ohne dabei Informationen zu verlieren.
Die Task Success Rate (TSR) ist eine prozentuale Messgröße für die End-to-End-Aufgaben, die ein Agent erfolgreich abgeschlossen hat. Der Abschluss hängt davon ab, ob ein Agent eine Anfrage versteht und anschließend die richtigen angebundenen Tools nutzt – APIs, Datenbanken, Retrieval-Augmented Generation (RAG) und interne Wissensdatenbanken.
Die Formel für TSR lautet:
TSR = (vollständig erledigte Aufgaben / insgesamt versuchte Aufgaben) x 100
Voice Agents für den Produktivbetrieb sollten einen TSR von über 85 % anstreben und dabei die Genauigkeit und Zuverlässigkeit von Tool-Aufrufen überwachen. Um Einbußen beim TSR zu vermeiden, sollten Sie jede Änderung an Prompts oder angebundenen Modellen mit Regressionstests prüfen. Selbst eine kleine Abweichung kann erhebliche Folgen für Ihren TSR haben.
Intelligenz
Intelligenz beschreibt die Fähigkeit eines Voice Agents zum Schlussfolgern und zu komplexeren Aufgaben. Diese Säule grenzt ein sprachgesteuertes IVR-System (Interactive Voice Response) klar von einem KI-Voice-Agent ab.
Zu den wichtigsten zu bewertenden Dimensionen gehören:
- Halluzinationsrisiko: Halluzinationen, bei denen ein Agent Informationen erzeugt, die ungenau sind oder Unternehmensdokumenten widersprechen, sind bei Voice AI besonders schädlich, da sie überzeugend vorgetragen werden können. Aktuelle Studien deuten darauf hin dass häufige Halluzinationen die Kundenzufriedenheit mit Voice Agents erheblich beeinträchtigen.
- Umgang mit Anfragen außerhalb des Geltungsbereichs: Intelligente Agents erkennen, wenn eine Frage außerhalb ihres Kontextbereichs liegt, und können angemessen reagieren. Statt eine Antwort zu halluzinieren, lehnen sie ab oder lenken das Gespräch zurück in einen kontextuell abgedeckten Bereich.
- Kontexterhalt: Kann ein Agent über mehrere Gesprächswechsel hinweg Entitäten und frühere Zusagen nachverfolgen? Ohne diese Fähigkeit müssen Kunden sich möglicherweise wiederholen oder erhalten widersprüchliche Antworten.
- Schlussfolgern und mehrstufige Logik: Kann der Agent bedingte Logik korrekt verarbeiten oder Schlussfolgerungen über mehrere Gesprächswechsel hinweg verketten? Besonders bei technischeren Anwendungsfällen wie Finanzdienstleistungen ist die Fähigkeit, innerhalb eines vordefinierten Kontexts zu schlussfolgern, für den Erfolg entscheidend.
Für diese Dimensionen und Komponenten gibt es mehrere Drittanbieter-Benchmarks. Beispielsweise bewertet Stanfords Holistic Evaluation of Language Models (HELM) die LLM-Leistung in verschiedenen Kategorien. Für Halluzinationen bietet TruthfulQA eine fundierte Analyse dazu, wie häufig falsche Antworten in Ergebnisse gelangen.
Ein Vorteil von ElevenAgents ist, dass Sie die LLM-Schicht vollständig austauschen können – anders als bei manchen Sprachplattformen, die Sie an ein einziges zugrunde liegendes Modell binden. In der Praxis können Sie so das Modell einsetzen, das bei den Benchmarks für Schlussfolgern für Ihren spezifischen Anwendungsfall führend ist.
Compliance und Sicherheit
Unternehmen müssen aktive Schutzmechanismen implementieren, um schädliche oder richtlinienwidrige Ausgaben zu verhindern. Anders als Prompt-Anweisungen auf Systemebene, die umgangen oder überschrieben werden können, laufen unabhängige Guardrail-Prüfungen als separate Schicht außerhalb des Modells. Sie bewerten Ausgaben, bevor diese den Nutzer erreichen, und stoppen das Gespräch, wenn es in einen gefährlichen Bereich gerät.
Prüfbarkeit ist eine damit verbundene Anforderung. Agents im Produktivbetrieb müssen detaillierte Protokolle von Entscheidungen und Ausgaben in einem Format führen, das eine nachträgliche Überprüfung unterstützt. Besonders in stark regulierten Branchen ist der Nachweis von Compliance im Nachhinein genauso wichtig wie ihre Einhaltung von Anfang an.
Welche Vorschriften Ihr Unternehmen genau einhalten muss, hängt von der Branche ab. Zu den am häufigsten relevanten Frameworks gehören:
- HIPAA: Für geschützte Gesundheitsdaten im US-Gesundheitswesen.
- PCI-DSS: Für jeden Agent, der Zahlungskartendaten verarbeitet.
- DSGVO: Datenschutzpflichten für die EU und Unternehmen mit Kunden in der EU.
Für Unternehmen, die ihre Compliance-Position bewerten, erfüllt ElevenLabs AICPA SOC Type II und die DSGVO und verfügt außerdem über die AIUC-1-Zertifizierung. Der AIUC-1 ist ein Sicherheitsstandard, der speziell für KI-Agenten entwickelt wurde.
Zuverlässigkeit
Zuverlässigkeit ist die letzte Säule unseres Bewertungsframeworks für Voice Agents. Sie behandelt, ob ein Agent beständig in Echtzeit liefern kann.
Achten Sie bei der Bewertung eines Voice Agents auf folgende Merkmale:
- Verfügbarkeit: Jedes kundenorientierte Deployment erwartet 99,9 % Verfügbarkeit, um Ausfälle zu vermeiden. Besonders bei dauerhaft verfügbaren Anwendungsfällen wie eingehendem Support ist eine zuverlässige Verfügbarkeit ein wichtiger Faktor.
- Kontrollierte Degradierung: Aufgrund der zugrunde liegenden Komplexität von Voice Agents sollte ein Agent die Verschlechterung einer Komponente kontrolliert behandeln. In der Praxis bedeutet das, an einen Menschen weiterzuleiten, statt unter erhöhter Last oder mit Fehlerausgaben weiterzuarbeiten.
- Leistung unter Last: Lasttests sollten vor dem Go-live mindestens das Zweifache Ihrer erwarteten Spitzenparallelität simulieren. Tests unter hoher Belastung können Latenzanstiege oder Leistungseinbußen aufdecken, die erst im großen Maßstab auftreten.
Selbst ein hochwertiges Modell, das alle anderen Anforderungen erfüllt, kann unbrauchbar sein, wenn es nicht mit Ihrer Kundennachfrage skaliert. ElevenAgents wird von 1.000.000 führenden Kreativen und Unternehmen genutzt. Das zeigt, dass die Plattform Deployments auf Unternehmensebene ermöglichen kann, ohne Abstriche bei Leistungsbenchmarks zu machen.
MOS für Voice Agents messen: Schritt für Schritt
Wenn Ihr Unternehmen MOS manuell messen möchte, benötigen Sie eine große Gruppe menschlicher Zuhörer und eine Auswahl an Audioclips aus realen Gesprächen. Es ist ein strukturierter Prozess aus Feedback sammeln, Mittelwerte bilden und Daten interpretieren.
So messen Sie MOS für Voice Agents in der Praxis:
- Testset vorbereiten: Wählen Sie eine repräsentative Stichprobe von Audioausgaben Ihres Agents aus, die mindestens 100 Clips aus verschiedenen Gesprächen umfasst.
- Bewertungssitzung durchführen: Bitten Sie Ihre menschlichen Zuhörer, jeden Clip anhand der Qualität des Kommunikationserlebnisses auf einer Skala von 1 bis 5 zu bewerten.
- Bewertungen zusammenführen und Scores berechnen: Bilden Sie für jeden Clip den Durchschnitt der Bewertungen und anschließend den Durchschnitt über alle Beispielclips, um einen Gesamt-MOS zu ermitteln. Ein MOS von 4,3 oder höher zeigt, dass Ihr Voice Agent für den Produktivbetrieb bereit ist.
Dieser Prozess ist zwar manuell aufwendig, liefert Ihnen aber einen belastbaren MOS für den gewählten Voice Agent. Wenn Sie den Test im großen Maßstab durchführen möchten, können Sie menschliche Zuhörer durch automatisierte Tools wie NISQA ersetzen, die MOS-Scores programmatisch vorhersagen. Sie können diese Systeme in Ihre aktiven Pipelines integrieren, um MOS fortlaufend zu überwachen.
Benchmarks für KI- und menschliche Tests: FCR, AHT und CSAT
Die wiederholte Berechnung von MOS im Zeitverlauf zeigt Modellverbesserungen oder Regressionen. Zusätzlichen Kontext erhalten Sie durch Benchmarks gegenüber menschlicher Leistung. Was Menschen in vergleichbaren Rollen tatsächlich erreichen, zeigt, ob Ihr Voice Agent einem idealen Leistungsniveau nahekommt.
Hier sind einige Kennzahlen für Benchmarks zwischen KI- und menschlichen Tests.
KI-Agenten sollten mit menschlichen Agents bei FCR und CSAT gleichziehen und zugleich die AHT deutlich verbessern. Letzteres liegt daran, dass KI-Agenten typischerweise allgemeinere Gespräche als menschliche Agents bearbeiten. Viele Unternehmen setzen einen Workflow um, in dem KI-Agenten als erste Ansprechpartner dienen und Anrufe nur bei zu hoher Komplexität an menschliche Agents weitergeben.
Daten des KI-Vergleichsaggregators Poe aus dem Jahr 2025 zeigen, dass ElevenLabs insgesamt die stärkste Fähigkeit zur Erfüllung von Anfragen behielt und 74,4 % aller eingehenden Anfragen abschloss. Dieser Erfolg hat zu schnell wachsender Nutzung geführt: Eleven v3 und v2.5-Turbo machten im Zeitverlauf mehr als 60 % der an KI-Modelle gesendeten Nachrichten aus.
Für ein besseres Erlebnis verwenden Sie Eleven v4 – unser ausdrucksstärkstes TTS-Modell.
Im Zeitverlauf an KI-Modelle gesendete Nachrichten: ElevenLabs führt beim Poe-Framework zur Bewertung von Voice Agents
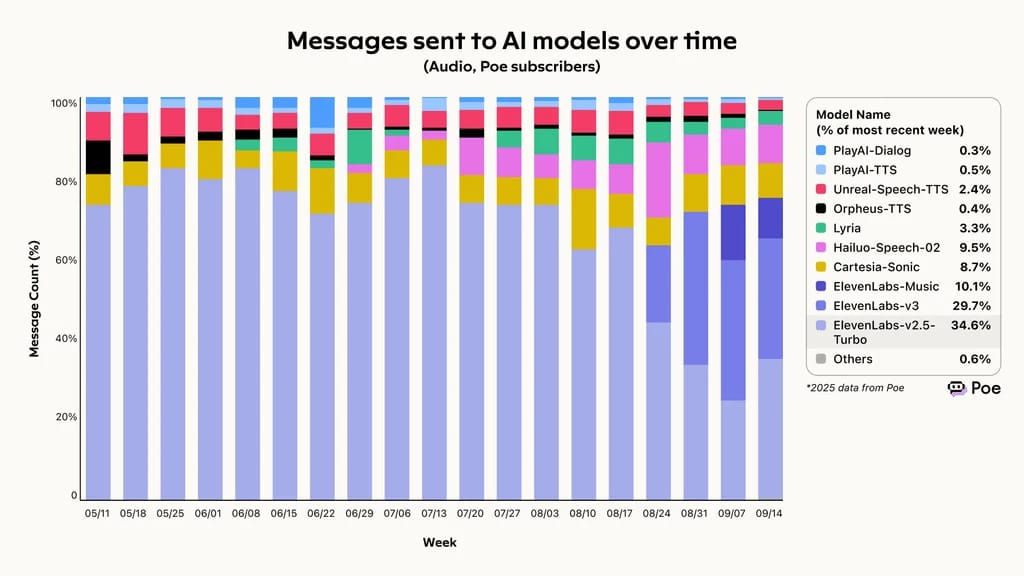
Im Zeitverlauf an KI-Modelle gesendete Nachrichten, laut Benchmark von Poe
Häufige Fehler beim Testen von Voice Agents
Wenn Sie einem Bewertungsframework für Voice Agents folgen, ist es verlockend, Best-Case-Szenarien zu testen. Doch die tägliche Erfahrung von Kunden mit Ihren Voice-AI-Systemen entsteht nicht unter idealen Bedingungen.
Hier sind drei häufige Fehler beim Testen von Voice Agents und wie Sie sie beheben:
- Den einfachsten Weg testen: Berücksichtigen Sie insbesondere bei der Auswahl von Audioclips für MOS auch Grenzfälle. Clips mit Hintergrundgeräuschen oder akzentuierter Sprache sind im Alltag äußerst häufig. Wenn Sie nur „saubere“ Audiodateien testen, wird Ihr MOS falsch kalibriert.
- Containment vor Lösung priorisieren: Wenn Sie Ihre Modelle darauf optimieren, Nutzer im Agentensystem zu halten, steigen die Containment-Raten, ohne dass sich die Ergebnisse verbessern. Ist Ihr FCR trotz hoher Containment-Rate niedrig, führt der Agent Nutzer durch eine frustrierende Schleife. Ermöglichen Sie Nutzern, auf Wunsch mit menschlichen Agents zu sprechen.
- Latenzperzentile ignorieren: SLAs definieren Latenz oft über P95. Diese Kennzahl ist wichtig, um für die Mehrheit Ihrer Kunden ein konsistentes Erlebnis zu gewährleisten. Vergessen Sie jedoch nicht, dass auch die letzten 5 % echte Kunden sind. Bei einem System mit 10.000 täglichen Anrufen sind 5 % immer noch 500 Menschen mit einem langsamen Gespräch. Machen Sie P99 zu Ihrem zentralen SLA-Ziel, nicht nur Median oder P95.
Wenn Sie dies berücksichtigen, können Sie faire und repräsentative Ausgangswerte festlegen, statt mit idealisierten Durchschnittswerten zu arbeiten.
Warum anwendungsfallspezifische Bewertungen wichtig sind
Die sechs in diesem Framework beschriebenen Säulen geben Orientierung zu den Bereichen, die Sie untersuchen sollten. Die Gewichtung jeder Säule hängt jedoch von Ihrer Branche ab. Ein Finanzdienstleister kann beispielsweise Compliance und Tool-Nutzung priorisieren, während für eine Verbrauchermarke die TTS-Stimmqualität maßgeblich sein kann.
Hier sind zwei Beispiele für anwendungsfallspezifische Bewertungen und dafür, wie sie das Gleichgewicht zwischen den einzelnen Säulen verschieben können.
Kundensupport
In bestimmten Branchen wie Callcentern sind weitere Kennzahlen zur Aufgabenerledigung wie die Lösung beim Erstkontakt (FCR) ein wichtiger Teil der Betrachtung. Eingehende Anrufe ohne menschliches Eingreifen erfolgreich bearbeiten zu können, senkt die Belastung für menschliche Kundendienstmitarbeiter erheblich. McKinsey schätzt dass Callcenter mit Voice Agents das Interaktionsvolumen um bis zu 50 % reduzieren können.
Eine weitere, wenn auch weniger wichtige Dimension als die Task Success Rate, ist die Containment-Rate. Sie untersucht die Gesamtdauer eines Anrufs. Ist Ihre Containment-Rate sehr hoch, aber Ihr FCR niedrig, halten Ihre Agents Menschen in der Leitung, ohne dem Kunden eine Lösung zu bieten. In der Praxis kann das für Kunden eine frustrierende Erfahrung sein, bei der sie sich im Kreis drehen.
Weitere zu verfolgende Kennzahlen sind AHT, wobei KI-Agenten routinemäßige Probleme schnell lösen sollen. Deshalb würde der Bereich Kundensupport die Gesprächsqualität, insbesondere Sprecherwechsel und Fallback-Rate, gegenüber anderen Bereichen priorisieren.
Gesundheitswesen
Gesundheitswesen ist ein stark regulierter Bereich. Strenge Compliance-Anforderungen machen den Betrieb von Voice Agents äußerst sensibel. Compliance ist ein zentrales Thema und verschiebt die Gewichtung der Sicherheitssäule des Frameworks deutlich in Richtung Compliance und Intelligenz.
Chatbots im Gesundheitswesen müssen Terminvereinbarungen, Zugangswege zur Telemedizin, Symptom-Triage und Fragen zu Versicherungen bearbeiten. All dies erfordert ein hohes Maß an Intelligenz und Tool-Nutzung und zeigt erneut, dass branchenspezifische oder rollenspezifische Anforderungen beeinflussen, welche Säulen am wichtigsten sind.
Unabhängig davon, in welcher Branche Ihr Unternehmen tätig ist: Wenn Sie die Kernpfeiler der Bewertung von Voice Agents verstehen und ausgewogen anwenden, finden Sie die besten Agents für Ihre Anforderungen.
Mit ElevenAgents für hohe Leistung und niedrige Latenz entwickeln
Die Plattform, auf der Sie entwickeln, beeinflusst direkt die Leistung Ihrer Voice Agents in realen Workflows. Besonders bei der Interaktion mit Ihren Kunden müssen Sie darauf vertrauen können, dass Ihr Agent in jeder Kategorie überzeugt.
ElevenAgents ist für Voice-Deployments im Produktivbetrieb konzipiert und kombiniert branchenführendes TTS über Eleven v4, Echtzeit-STT über Scribe v2 sowie eine Agenten-Orchestrierungsschicht für Enterprise-Skalierung. Jede Komponente ist darauf ausgelegt, die in diesem Framework festgelegten Benchmarks zu erfüllen, damit Sie Ihren Kunden hochwertige Erlebnisse bieten können.
Ob Sie noch Optionen abwägen oder bereit sind, mit der Entwicklung zu beginnen: ElevenLabs bietet Ihnen einen passenden Weg. Entdecken Sie die ElevenAgents-Plattform und erfahren Sie, wie sie zu Ihrem Anwendungsfall passt, oder registrieren Sie sich und beginnen Sie noch heute mit der Entwicklung.
FAQs zur Bewertung von Voice Agents

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.



