
JavaScript-Spracherkennung-Tutorial: Voice UX entwickeln
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Dank browsernativer Speech-to-Text-APIs (STT) wie der Web Speech API ist es jetzt einfacher, Spracherkennung in Websites und browserbasierte Apps zu integrieren. Entwickler können Mikrofoneingaben einfach streamen, Audiodaten analysieren und Transkripte über API-Aufrufe verarbeiten – ohne einen lokalen Server für automatische Spracherkennung aufzusetzen.
Die Web Speech API ist eine gängige Spracherkennungs-API für die Implementierung von Sprachbefehlen in JavaScript. Sie bietet Methoden, Argumente und Eigenschaften für Echtzeit-Transkription im Webbrowser. Für komplexe Webclients kann die Web Speech API jedoch eingeschränkt sein.
Dieser Leitfaden zeigt, wie Sie mit der Web Speech API eine einfache JavaScript-Web-App zur Spracherkennung einrichten, welche Einschränkungen sie hat und welche Alternativen es für robustere Clients zur Echtzeit-Transkription gibt.
Zusammenfassung
- Die Web Speech API ist eine browsernative Speech-to-Text-API, die Mikrofonaudio zur Verarbeitung an einen Cloud-Backend-Dienst sendet.
- Entwickler verwenden die API-Klasse SpeechRecognition, um JavaScript-Anwendungen für Sprachbefehle zu entwickeln.
- Berücksichtigen Sie beim Entwickeln einer Spracherkennungs-App den Datenschutz, indem Sie anzeigen, dass eine Audioaufnahme läuft.
- Die Web Speech API hat mehrere Einschränkungen, darunter inkonsistente Transkriptionen, Browserabhängigkeit und fehlendes Intent-Verständnis.
- ElevenLabs bietet hochpräzise, produktionsreife Speech-to-Text-APIs, die Streaming auf Client- und Serverseite unterstützen.
So funktioniert die Web Speech API
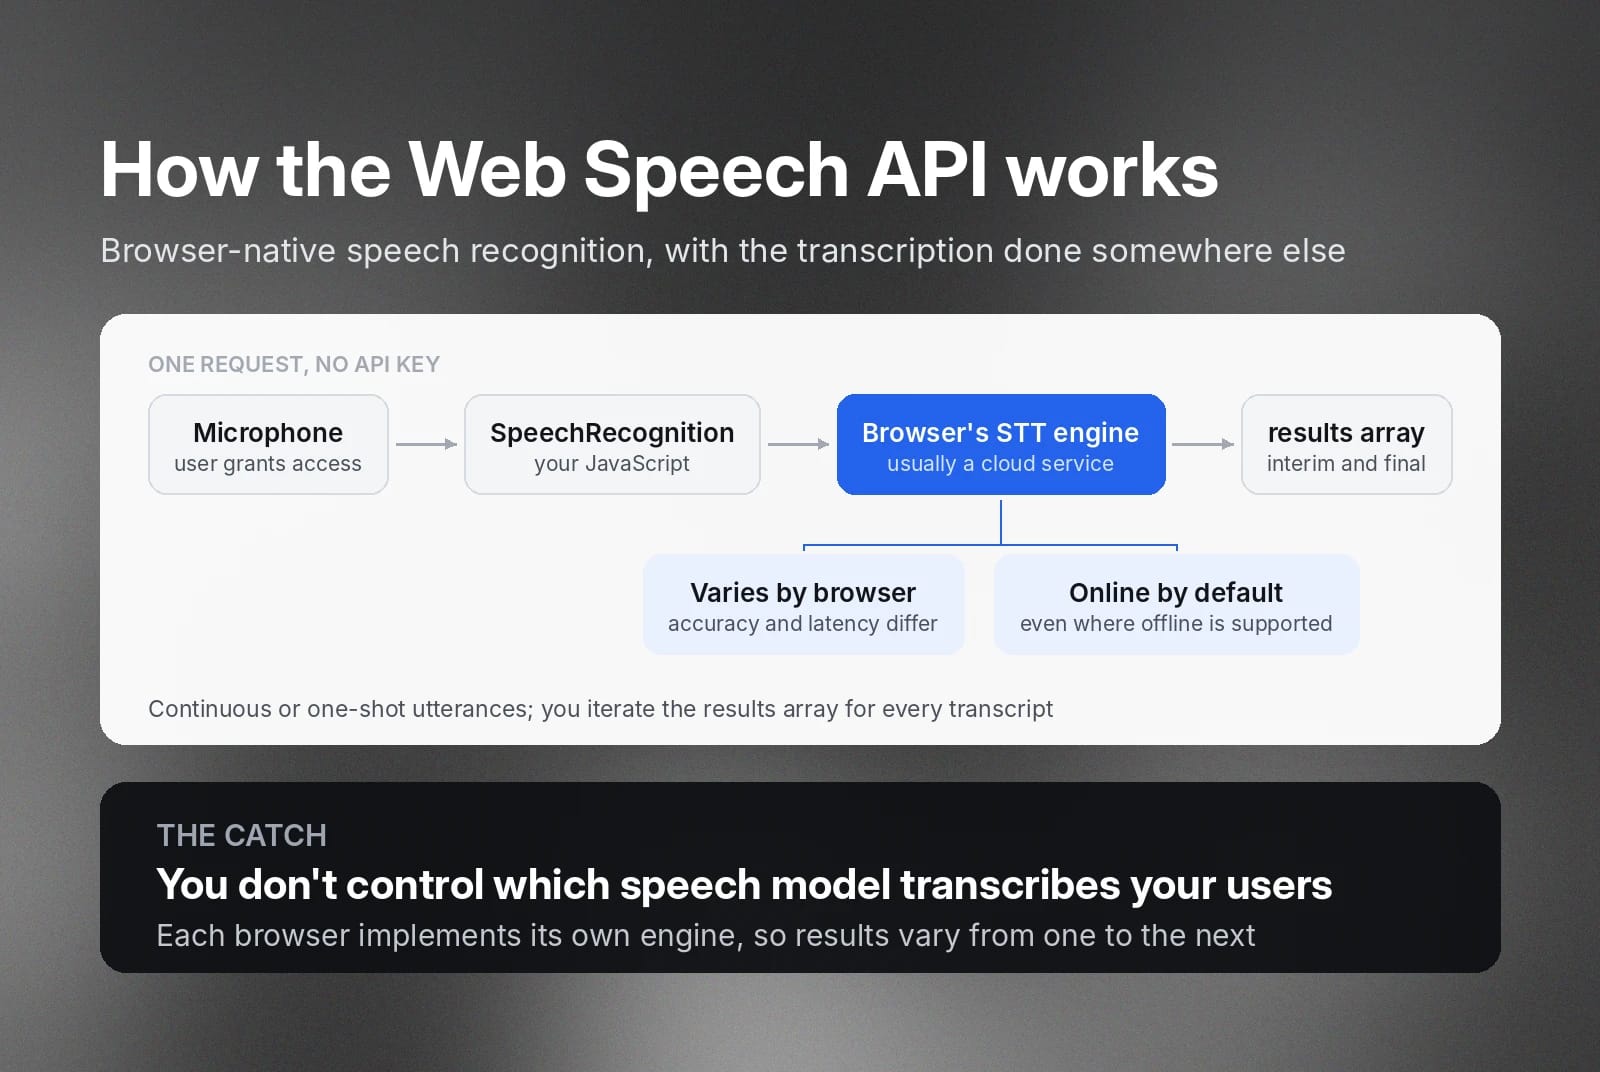
Die Web Speech API bietet Webentwicklern browsernative Spracherkennung, ohne dass ein lokaler Server erforderlich ist. Im Wesentlichen sendet die Web Speech API einen Audiostream aus Ihrem Webbrowser zur Verarbeitung, Analyse und Umwandlung in Transkripte an einen Cloud-Backend-Dienst. Da sie für die Transkription auf die Backend-Engine des Browsers angewiesen ist, unterscheiden sich die Ergebnisse je nach Browser.
Im Allgemeinen benötigt die Web Speech API eine aktive Internetverbindung, um Audiostreams zu transkribieren, insbesondere bei der Entwicklung für Chrome und Safari. Einige Browser unterstützen inzwischen jedoch Offline-Transkription. Dabei fungiert der Browser als Speech-to-Text-Engine, identifiziert Phoneme und wandelt sie in zusammenhängenden Text um.
Unabhängig vom verwendeten Browser sind die Grundlagen der API gleich.
- Sie benötigen keinen API-Schlüssel, um eine API-Anfrage zu stellen.
- Die Web Speech API unterstützt kontinuierliche oder einmalige Äußerungen.
- Sie gibt sowohl vorläufige als auch finale Transkripte zurück.
Da jeder Browser die STT-Engine jedoch anders implementieren kann, können Genauigkeit und Latenz variieren.
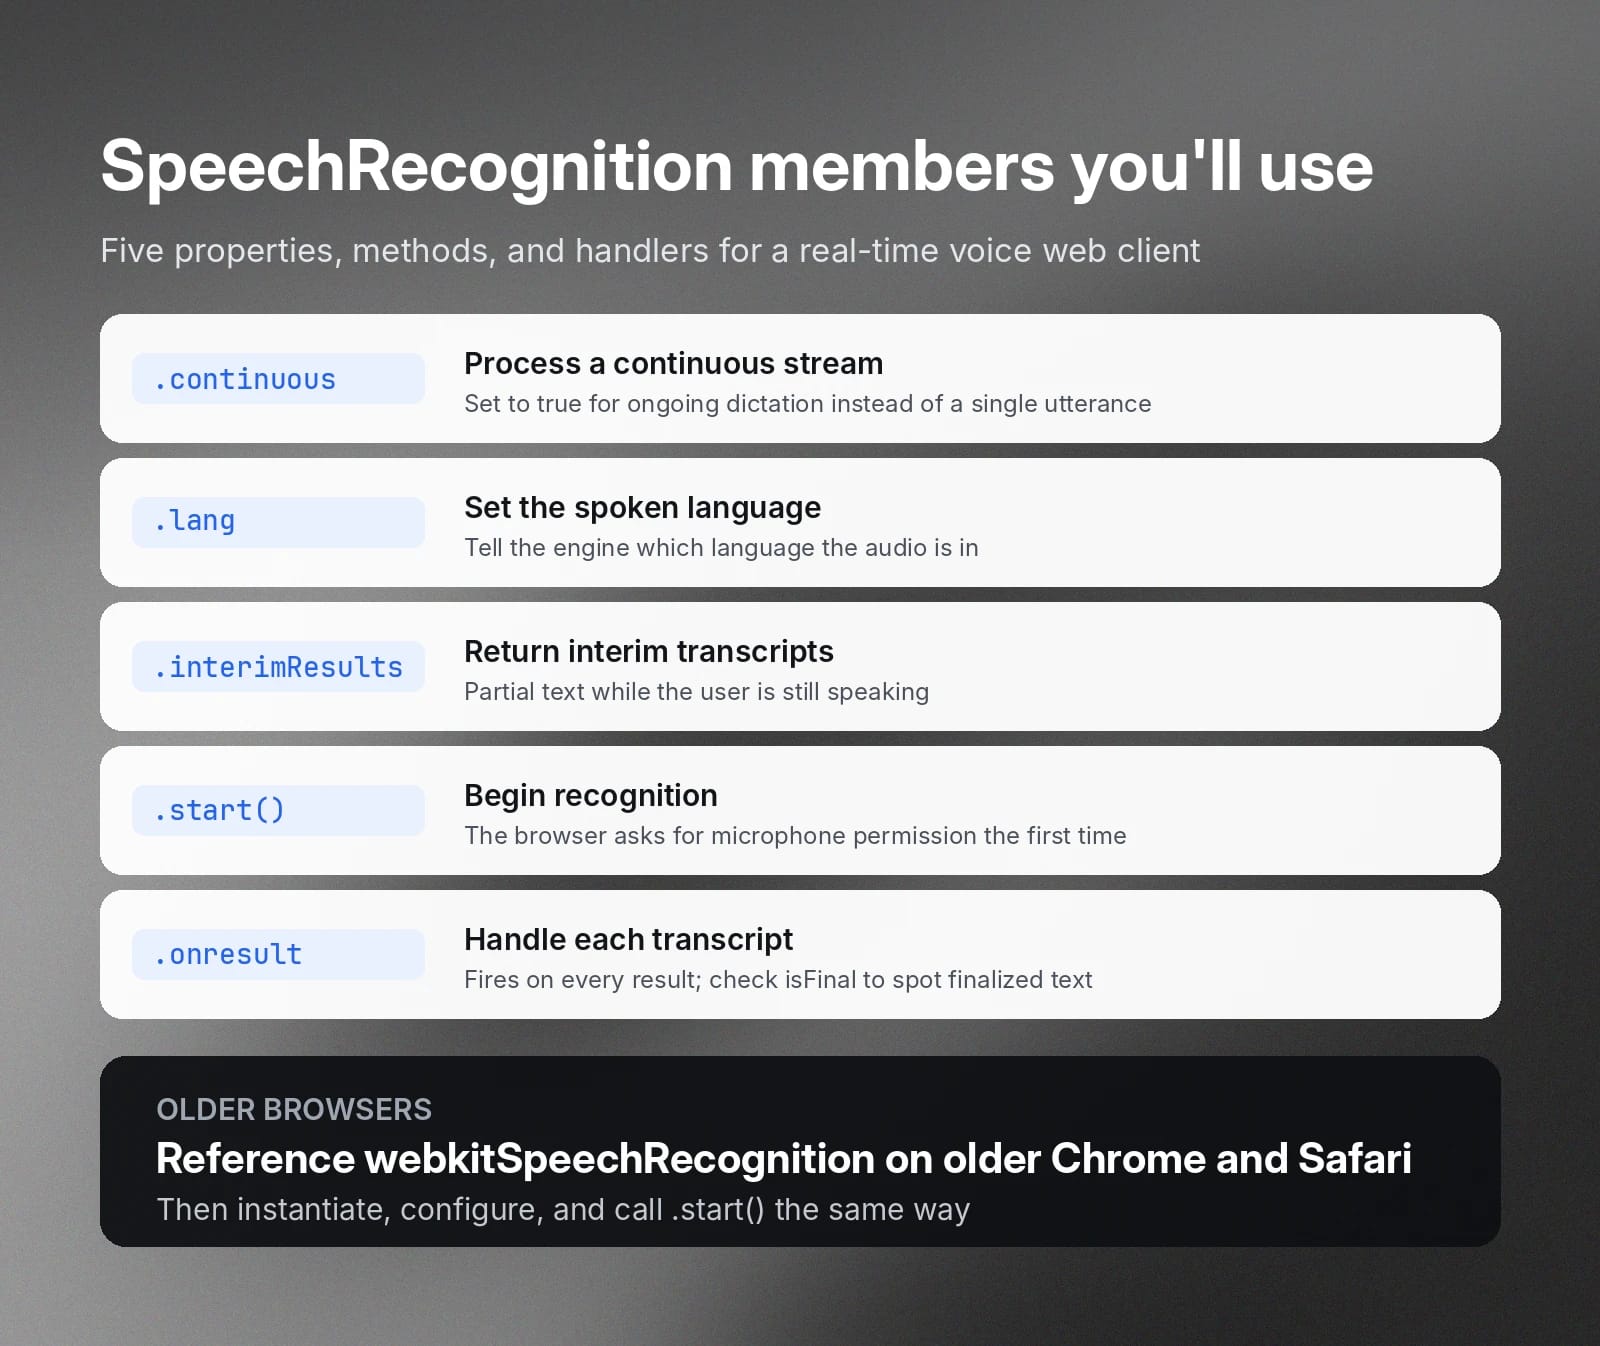
Um die Web Speech API zu verwenden, initialisieren Sie die SpeechRecognition-Schnittstelle in Ihrem JavaScript-Code. Anschließend greifen Sie beim Programmieren auf Methoden, Attribute und Event-Handler zu. Hier sind einige, die Sie zum Entwickeln eines Webclients für die Sprachsuche verwenden.
- SpeechRecognition.continuous: Aktiviert die Speech-Engine für die Verarbeitung eines kontinuierlichen Streams, wenn der Wert auf true gesetzt ist.
- SpeechRecognition.lang: Legt die Sprache des Audios fest.
- SpeechRecognition.interimResults: Weist die Engine an, vorläufige Transkripte zurückzugeben.
- SpeechRecognition.start(): Startet den Spracherkennungsprozess.
- SpeechRecognition.onresult: Akzeptiert einen Event-Handler, den die API auslöst, wenn sie die Transkription abgeschlossen hat.
Die Web Speech API gibt die Transkription in einem String-Array zurück. Wenn die STT-Engine ein vorläufiges oder finales Transkript zurückgibt, finden Sie es im Array results. Es kann einen oder mehrere Strings enthalten. Deshalb müssen Sie die Ergebnis-Strings durchlaufen, um den gesamten transkribierten Text abzurufen.
Hinweis: Wenn Sie die vorläufige Transkription aktiviert haben, prüfen Sie die Eigenschaft isFinal, um festzustellen, ob der Text ein finales Transkript ist.
Ein JavaScript-Beispiel zur Spracherkennung erstellen
Dieses Beispiel verwendet die JavaScript-Schnittstelle SpeechRecognition, um eine Web-App für Echtzeit-Transkription zu entwickeln. Der folgende Screenshot zeigt die fertige Seite.
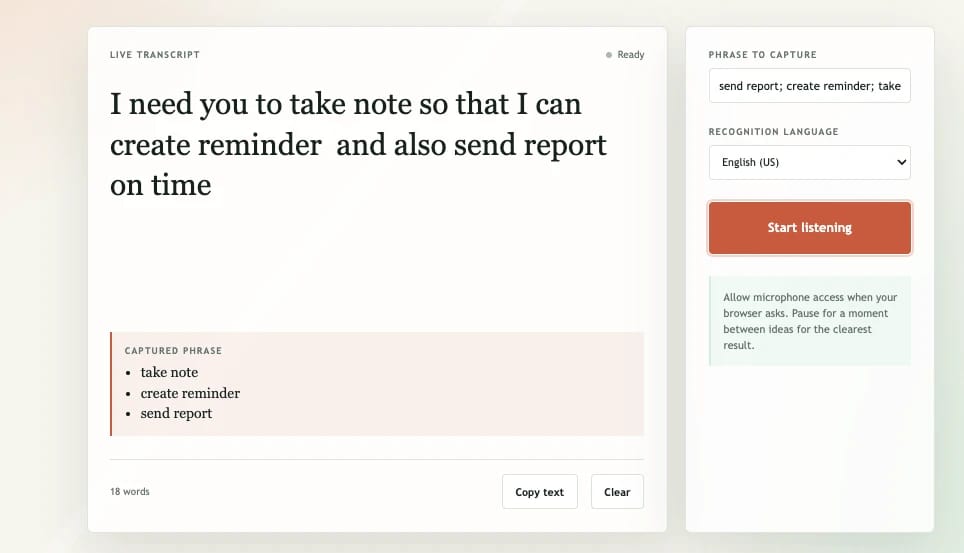
Auf der Beispielseite startet eine Schaltfläche „Zuhören starten“ die Aufnahme. Während der Nutzer spricht, sendet der Browser das Audio an die STT-Engine, wartet auf die Transkription und zeigt sowohl vorläufigen als auch finalen Text an.
Das Beispiel enthält auch eine Funktion für Sprachbefehle, die bestimmte vom Nutzer aufgelistete Begriffe erfasst. Sie vergleicht das Transkript in Ihrem eigenen Code mit einer vordefinierten Phrasenliste. Das unterscheidet sich von Keyterm-Prompting in einer Speech-to-Text-API.
Die folgenden Ausschnitte zeigen die wichtigsten Teile dieses Beispiels.
SpeechRecognition API einrichten und Mikrofonzugriff anfordern
Um sie in Ihrem Code zu verwenden, müssen Sie zuerst die Klasse SpeechRecognition instanziieren. Bei einer älteren Chrome- oder Safari-Version referenzieren Sie webkitSpeechRecognition.
Erstellen Sie dann eine SpeechRecognition-Instanz und konfigurieren Sie den Streaming-Modus, die Unterstützung vorläufiger Transkriptionen und die gesprochene Sprache.
Anschließend können Sie die Transkription durch Aufrufen der Methode .start() starten.
Beim ersten Start des Spracherkennungsprozesses fordert der Browser den Nutzer zur Berechtigung auf. Der Nutzer muss auf „Zulassen“ klicken, um die Transkription zu starten. Andernfalls gibt die API einen Wert „not-allowed“ im SpeechRecognitionErrorEvent-Handler zurück.
Live-Transkripte und finale Ergebnisse anzeigen
In diesem Beispiel zeigen wir das Transkript an, während der Nutzer ins Mikrofon spricht. Dazu fügen wir dem Event onresult eine Funktion hinzu.
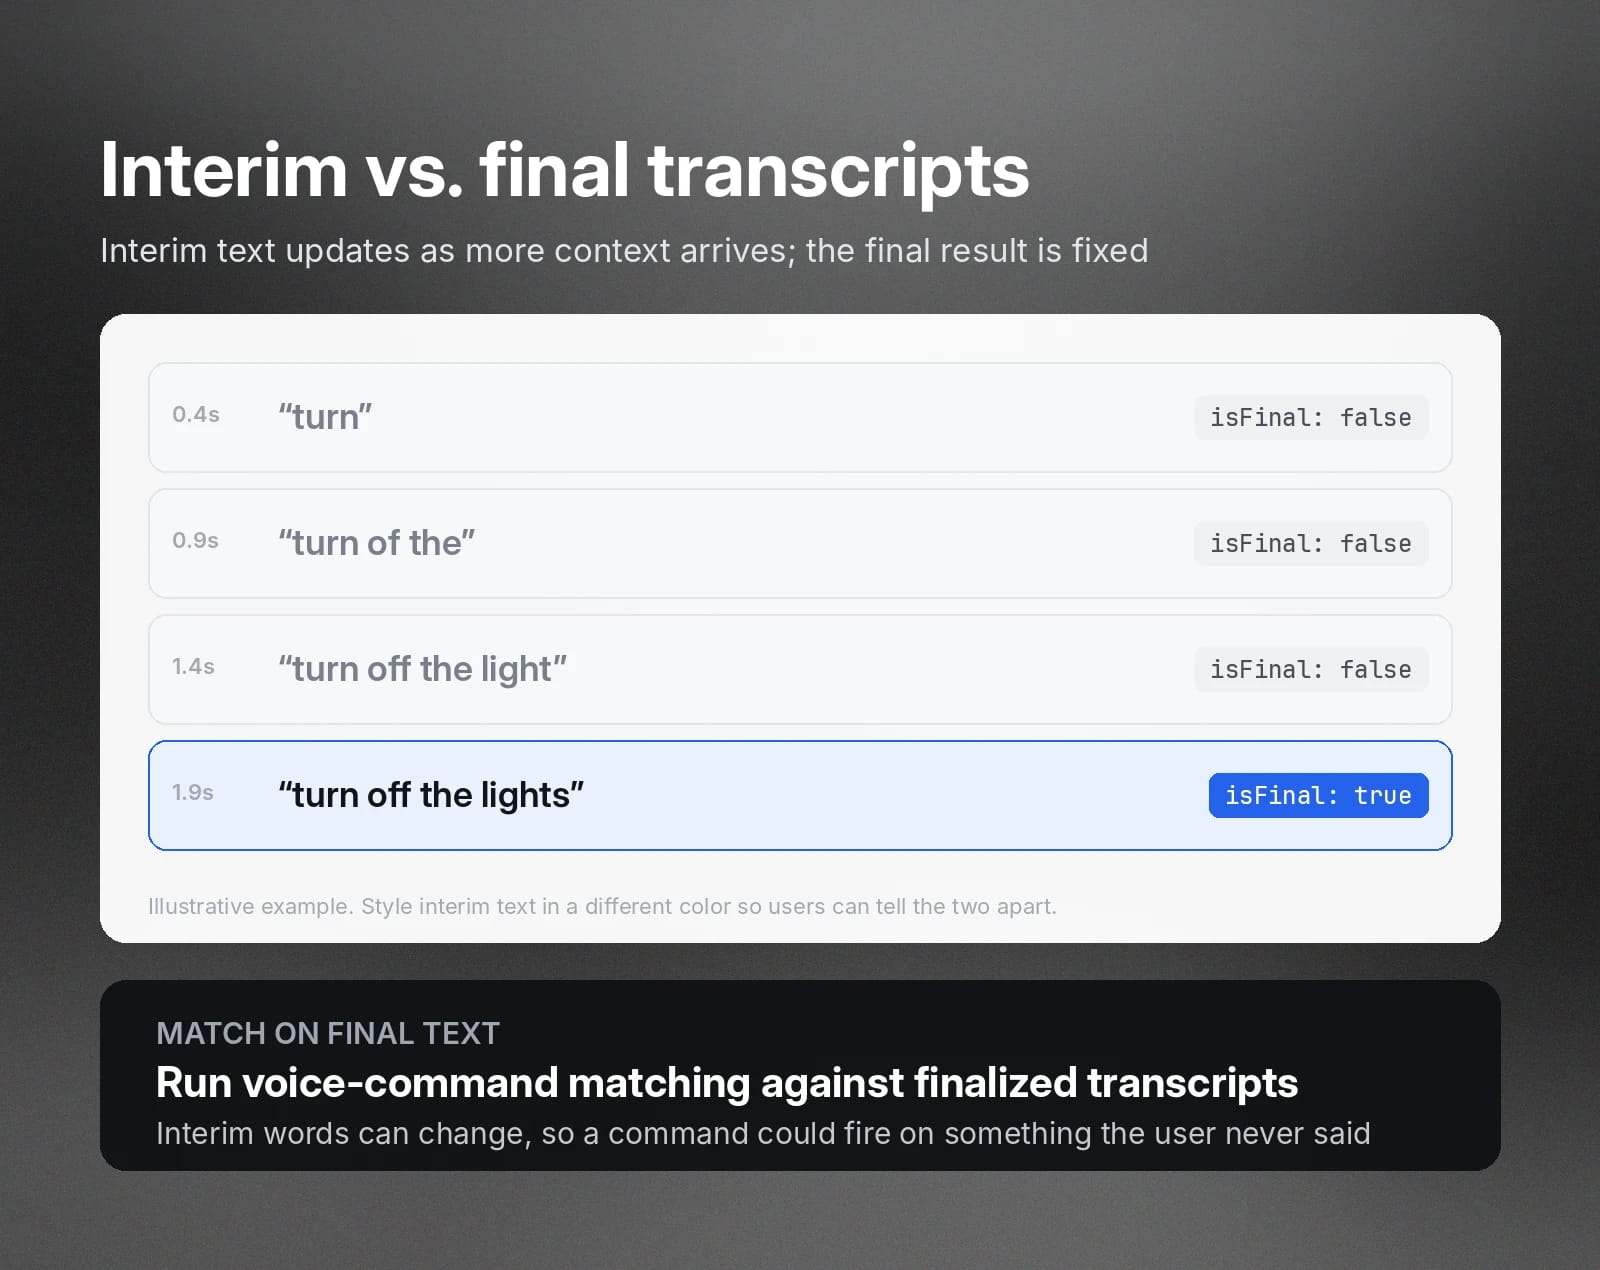
Vorläufige Transkripte sind nicht finalisiert. Der angezeigte Text entspricht daher möglicherweise nicht genau den gesprochenen Worten. Wenn die STT-Engine durch nachfolgende Wörter mehr Kontext erhält, korrigiert sie das Transkript und gibt es im String zurück.
Sie können vorläufigen Text auch in einer anderen Farbe formatieren, damit er sich vom finalen Transkript abhebt. Dieses CSS übernimmt das:
Sprachbefehle in JavaScript hinzufügen
Fügen Sie ein Textfeld hinzu, in das Nutzer die zu erkennenden, durch Semikolons getrennten Phrasen eingeben. (Alternativ können Sie die Phrasen in einer JSON-Datei speichern und in Ihren Code laden.)
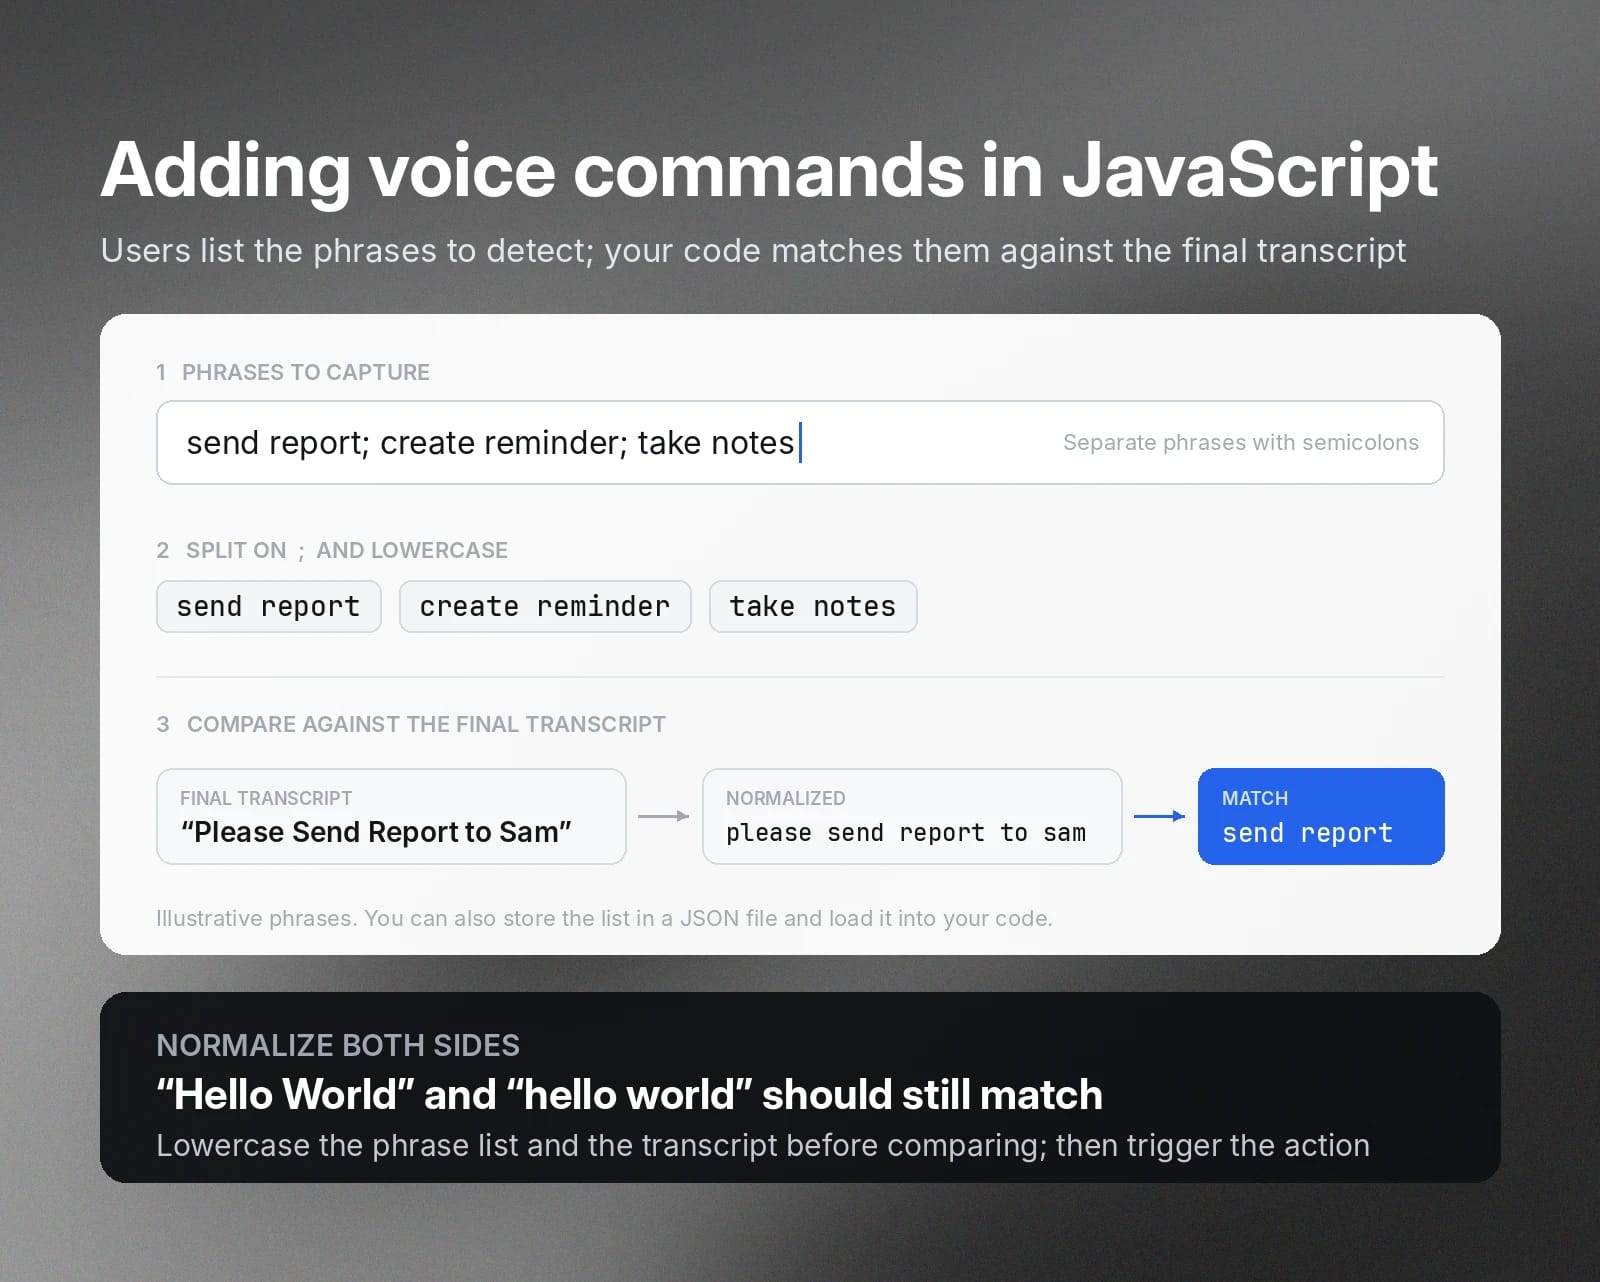
Erstellen Sie dann eine Funktion, die das finale Transkript mit der Phrasenliste vergleicht. Normalisieren Sie beim Textabgleich beide Listen, indem Sie sie in Kleinbuchstaben umwandeln. Denn Nutzer können Wörter großschreiben, was trotz identischer Wörter zu keiner Übereinstimmung führen kann. Beispielsweise sollten „Hello World“ und „hello world“ übereinstimmen, auch wenn eines großgeschrieben ist.
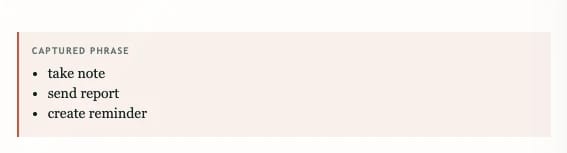
Jedes Mal, wenn der Code ein Transkript erhält, durchläuft er die Phrasenliste. Bei einer Übereinstimmung lösen Sie eine Aktion aus, etwa das Starten einer Anwendung oder in diesem Fall die Anzeige der passenden Phrase in einem separaten Bereich.
Browserunterstützung, Berechtigungen und Erkennungsfehler behandeln
Die Web Speech API macht Speech-to-Text-Erkennung in JavaScript zugänglich, funktioniert aber nicht immer fehlerfrei. Nutzer verwenden möglicherweise einen Browser mit eingeschränkter oder keiner Backend-Unterstützung für die SpeechRecognition API. In manchen Fällen schlägt die Transkription wegen Netzwerkproblemen fehl.
Ihr Code muss diese Bedingungen daher behandeln und Nutzer entsprechend informieren.
Informieren Sie Nutzer beispielsweise darüber, Chrome oder Edge zu verwenden, wo die SpeechRecognition API nachweislich funktioniert.
Um Fehler zu behandeln, verknüpfen Sie eine Fehlerbehandlungsfunktion mit dem onerror-Event-Handler und verarbeiten den jeweiligen Fehlercode.
Zum Beispiel:
Fehlercode | Aktion |
not-allowed | Zeigen Sie einen Text an, der den Nutzer auffordert, die Browsereinstellungen zu prüfen. |
no-speech | Fordern Sie den Nutzer auf, näher am Mikrofon zu sprechen. |
network | Bitten Sie den Nutzer, die Internetverbindung zu prüfen. |
aborted | Informieren Sie den Nutzer, dass der Spracherkennungsprozess gestoppt wurde. |
JavaScript-Spracherkennung barrierefrei und datenschutzbewusst gestalten
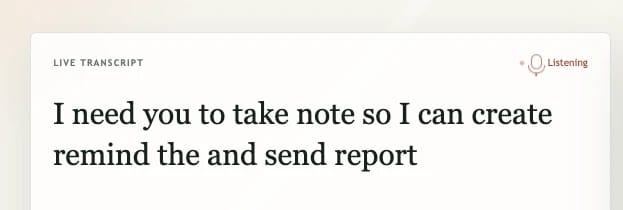
Berücksichtigen Sie bei der Integration der Web Speech API den Datenschutz. Zeigen Sie immer einen visuellen oder sprachlichen Hinweis, bevor der Webclient mit der Aufnahme beginnt. Zeigen Sie beispielsweise ein Zuhörsymbol als visuellen Hinweis, während der JavaScript-Code zur Spracherkennung das Mikrofonsignal aktiv an die Speech-to-Text-Engine sendet.
Ein weiterer wichtiger Bereich für Entwickler ist der Datenschutz. Bei einer Transkription mit der SpeechRecognition API erfolgt die Transkription standardmäßig online. Selbst wenn der Browser Offline-Speech-to-Text unterstützt, versucht die API zuerst eine Online-Transkription.
Diese technischen Spezifikationen sind entscheidend, wenn Sie Transkriptionsdienste entwickeln, für die Datenresidenz, Governance und Compliance streng reguliert sind.
Wann browserbasierte Spracherkennung für die Produktion nicht ausreicht
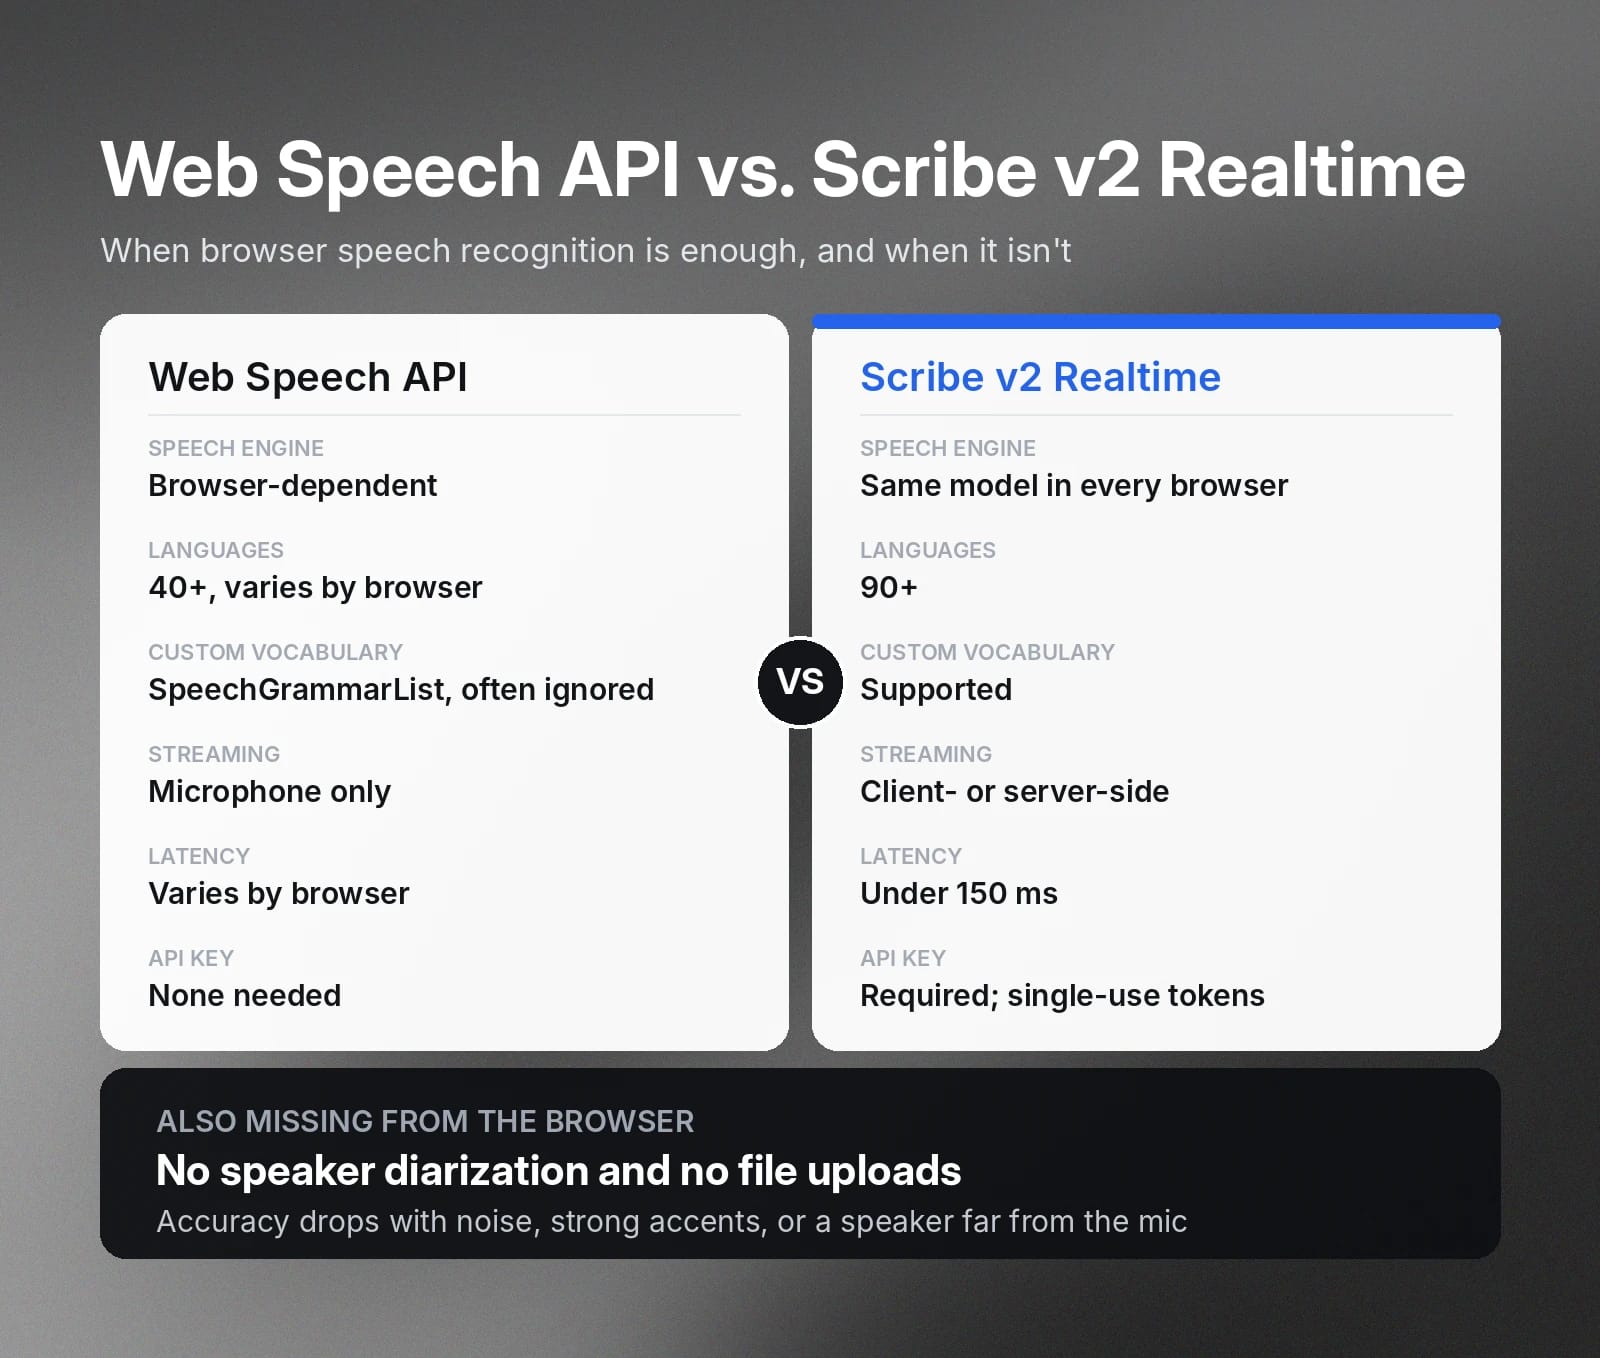
Wir haben Schritte gezeigt, um automatische Spracherkennung für browserbasierte Sprach-Apps mit der Web Speech API zu entwickeln. Die API macht Speech-to-Text-Funktionen für JavaScript-Entwickler zugänglich. Mehrere Einschränkungen begrenzen jedoch die Einsatzmöglichkeiten, insbesondere bei kommerziellen Webprodukten.
- Browserabhängig: Die Transkription hängt stark vom Browser des Nutzers ab. Entwickler haben keine Kontrolle über die verwendeten Sprachmodelle, was zu inkonsistenter Transkriptionsleistung führt.
- Eingeschränkte Sprachunterstützung: Die API unterstützt über 40 Sprachen, die genaue Anzahl kann jedoch je nach Browser variieren.
- Sprecherdiarisierung: Sie können nicht erkennen, wer spricht, und einzelne Sprecher im Transkript abbilden.
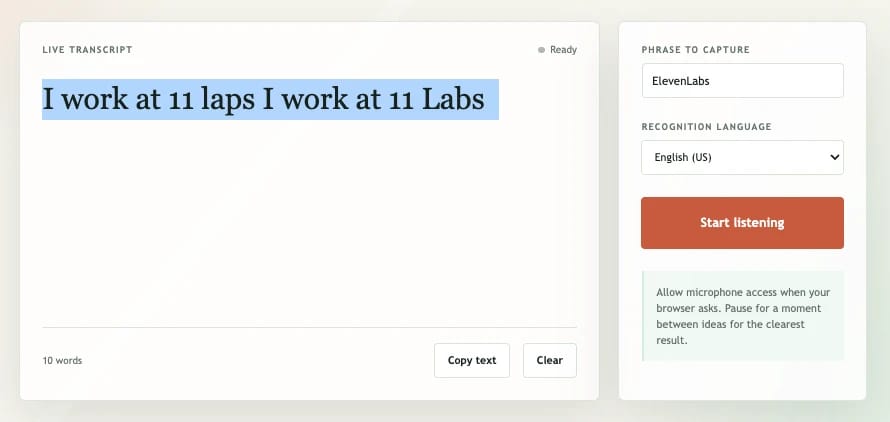
- Benutzerdefinierte Vokabulare: Die SpeechRecognition API unterstützt benutzerdefinierte Vokabulare nicht zuverlässig. Beispielsweise kann sie „ElevenLabs“ nicht präzise transkribieren. (Die offizielle SpeechRecognition API bietet über SpeechGrammarList eine Schnittstelle für benutzerdefinierte Vokabulare, aber moderne Browser ignorieren sie häufig.)
- Genauigkeit: Die Transkriptionsgenauigkeit sinkt bei lauter Umgebung, starkem Akzent oder großem Abstand zum Mikrofon.
- Serverseitiges Streaming: Sie können nur vom Mikrofon streamen, da die Web Speech API weder Server-Streaming noch manuelle Uploads von Audiodateien unterstützt.
Wenn diese Einschränkungen Sie daran hindern, Ihr Spracherkennungsprodukt zu kommerzialisieren, empfehlen wir ElevenLabs Scribe v2 Realtime.
ElevenLabs Scribe v2 Realtime ist ein Spracherkennungsmodell mit hochpräziser Echtzeit-Transkription bei einer Latenz unter 150 ms. Es unterstützt über 90 Sprachen, browserunabhängige Konsistenz und benutzerdefinierte Vokabulare. Mit ElevenLabs Scribe v2 Realtime können Sie Streaming auf Client- oder Serverseite nutzen, passend zur Architektur Ihrer Web-App.
JavaScript-Spracherkennung-Tutorial mit ElevenLabs Scribe v2 Realtime
Das Entwickeln eines Sprachbefehls in JavaScript mit ElevenLabs folgt einem ähnlichen Ansatz. Sie müssen jedoch einen ElevenLabs API-Schlüssel erstellen, um die API-Anfragen zu autorisieren. Nachfolgend finden Sie die wichtigsten Schritte zum Erstellen eines Webclients, der vom Mikrofon streamt.
- ElevenLabs SDK installieren
- Einmal-Token erstellen, um den API-Schlüssel weiterzugeben, ohne ihn offenzulegen
- Scribe v2 Realtime mit den gewünschten Parametern konfigurieren und verbinden
- Event-Handler erstellen, um Transkripte zu verarbeiten und Ausnahmen zu behandeln
Ausführliche Informationen zu Scribe v2 Realtime finden Sie in unserer offiziellen Dokumentation.
Mit ElevenAPI produktionsreifes Speech to Text nutzen
ElevenAPI bietet produktionsreife Speech-to-Text-Modelle für die Entwicklung von Webclients und Servern. Über die Echtzeit-Spracherkennung hinaus nutzen Entwickler die Speech-to-Text-Modelle von ElevenAPI für Batch-Transkription mit Sprecherdiarisierung, Zeitstempeln auf Wortebene und asynchroner Verarbeitung.
Statt die Speech-to-Text-Engine kontinuierlich abzufragen, können Sie im ElevenLabs-Dashboard einen Webhook erstellen und eine Callback-URL angeben, an die die API das fertige Transkript liefert.
Ob Sie einen Webclient oder eine Server-App mit automatischer Spracherkennung entwickeln möchten: ElevenAPI bietet Audiomodelle, die Sie einfach in Ihren Code integrieren können.
Holen Sie sich Ihren ElevenLabs API-Schlüssel und entdecken Sie die API-Dokumentation, um mit der Entwicklung zu beginnen.
Häufig gestellte Fragen

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


