
Python-Tutorial zur Spracherkennung: Von der Audiodatei zum Transkript
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Spracherkennung in eine Python-App zu integrieren, war früher aufwendig. Python-Entwickler mussten den Transkriptionsprozess selbst implementieren – also Audiovorverarbeitung, Merkmalsextraktion und Modellintegration. Zudem hatten Entwicklungsteams mit Audioverarbeitung auf niedriger Ebene, mäßiger Transkriptionsqualität und Verzögerungen zwischen gesprochenen Worten und Live-Untertiteln zu kämpfen.
Fortschritte bei Audiomodellen und SDKs für Spracherkennung ändern das.
In diesem Python-Tutorial zur Spracherkennung erfahren Sie, wie Sie die Speech to Text-Audiomodelle von ElevenLabs in Ihr Python-Projekt integrieren, um transkriptionsfähige Apps für den kommerziellen Einsatz zu entwickeln.
Zusammenfassung
- Kommerzielle Speech to Text-Modelle bieten Funktionen wie Sprecherdiarisierung, Zeitstempel auf Wortebene und Keyterm-Prompting, die einfachen Spracherkennungsmodellen fehlen.
- ElevenAPI ergänzt Ihren Python-Code mit Spracherkennung über Scribe v2 und Scribe v2 Realtime.
- Entwickler können ElevenLabs Skills auf einer KI-Coding-Plattform installieren, um präzisen Python-Code auf Basis der offiziellen API-Dokumentation zu generieren.
- Sie können die ElevenLabs API kostenlos testen, bevor Sie für die kommerzielle Entwicklung ein kostenpflichtiges Abo abschließen.
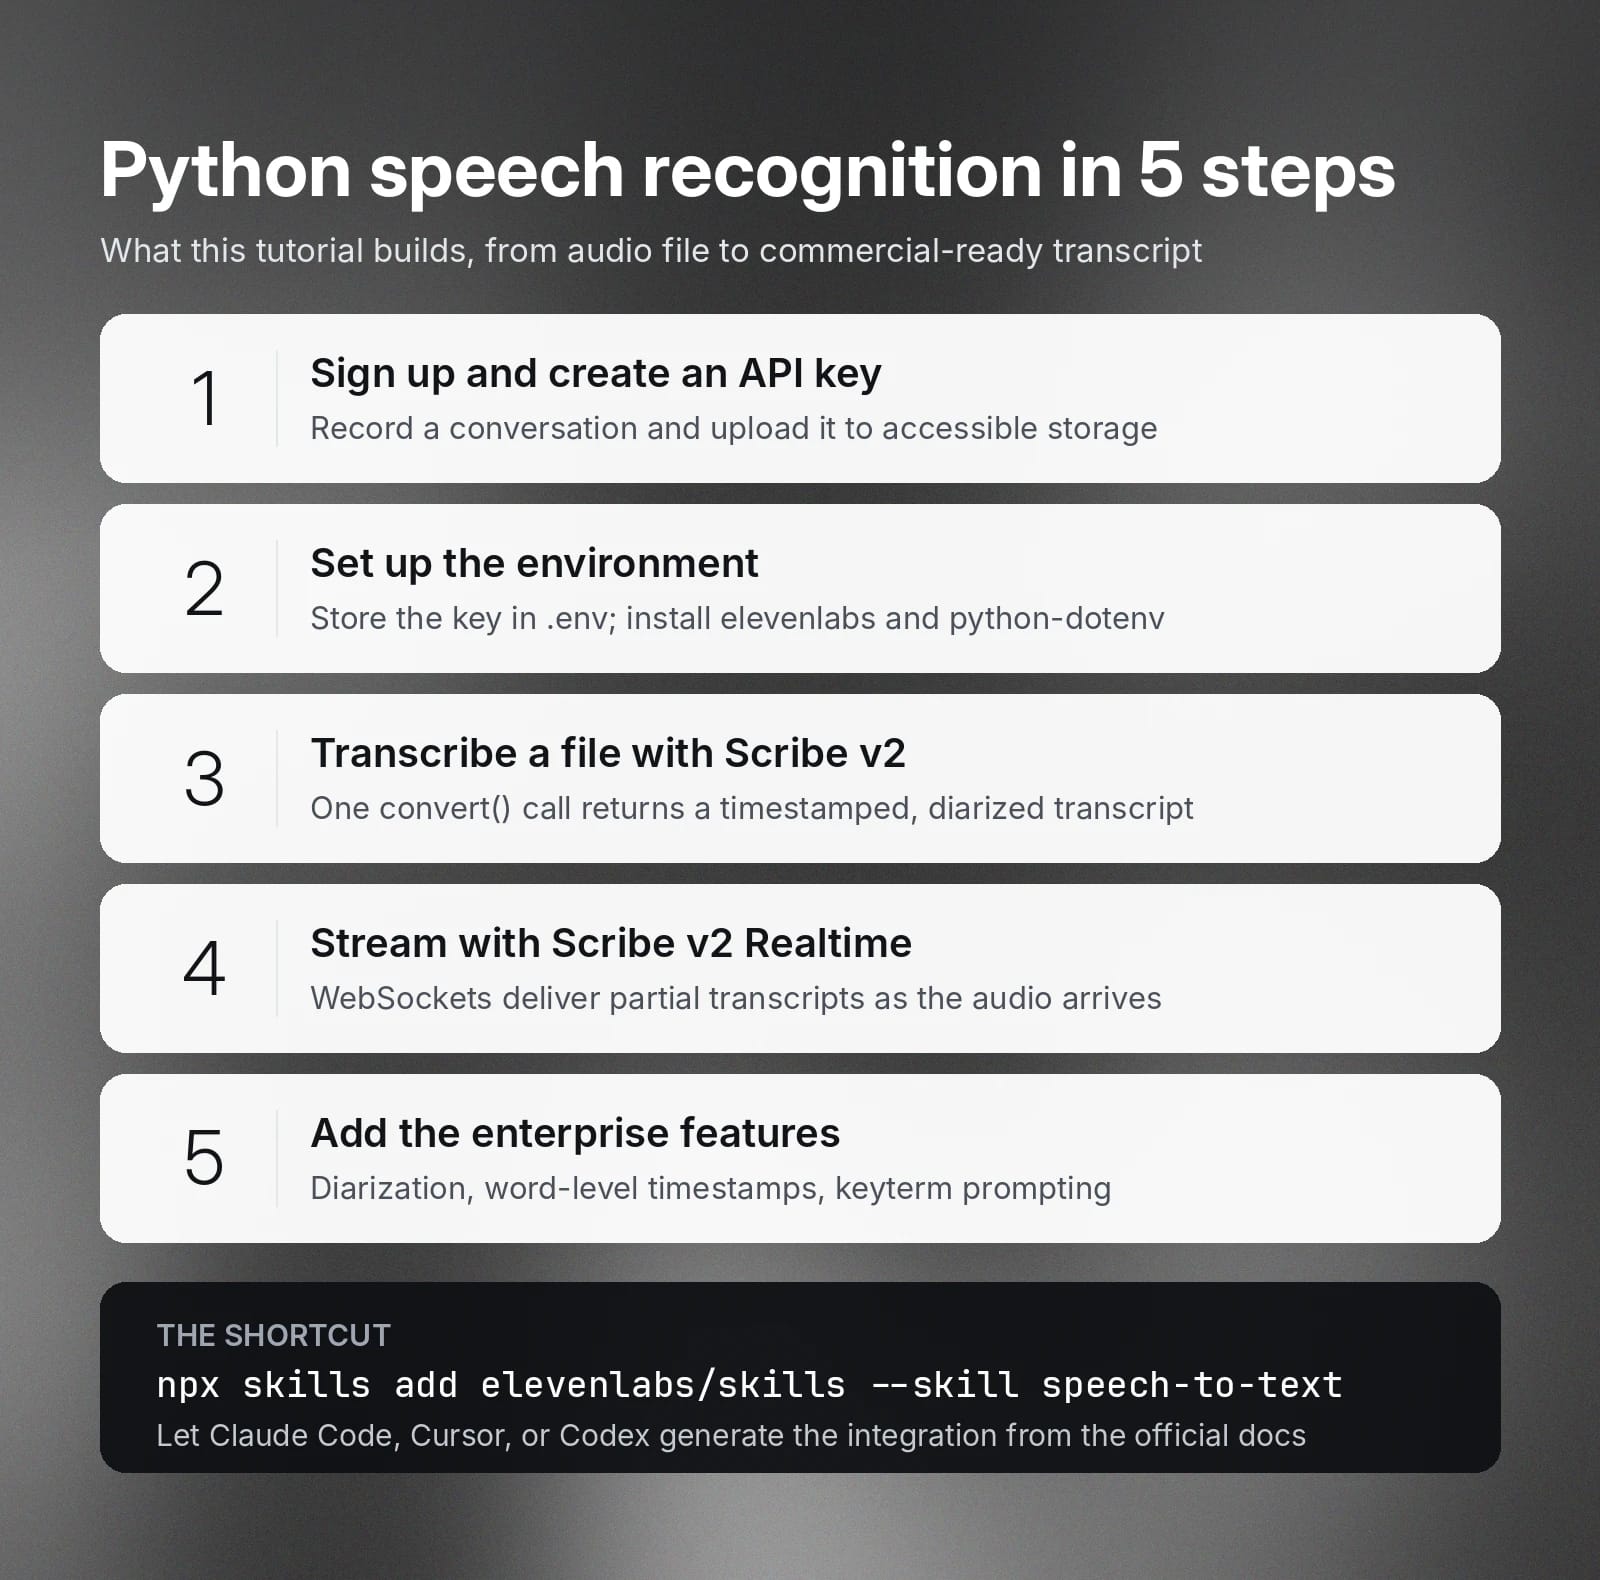
Was dieses Python-Tutorial zur Spracherkennung behandelt
Dieses Tutorial behandelt Voraussetzungen, API-Integration und erweiterte Transkriptionsfunktionen, mit denen Sie eine Python-App zur Spracherkennung für Enterprise-Anwendungsfälle entwickeln.
Die Spracherkennung hat sich in den letzten Jahren stark weiterentwickelt. Insbesondere große Sprachmodelle und neuronale Deep-Learning-Netze haben verändert, wie Python-Entwickler Transkriptions-SDKs einsetzen. Viele Tutorials zeigen zwar, wie einfache Transkriptions-Apps entstehen, doch nur wenige behandeln die Funktionen, die ein kommerziell einsetzbares Produkt benötigt.
Dieses Tutorial schließt diese Lücke.
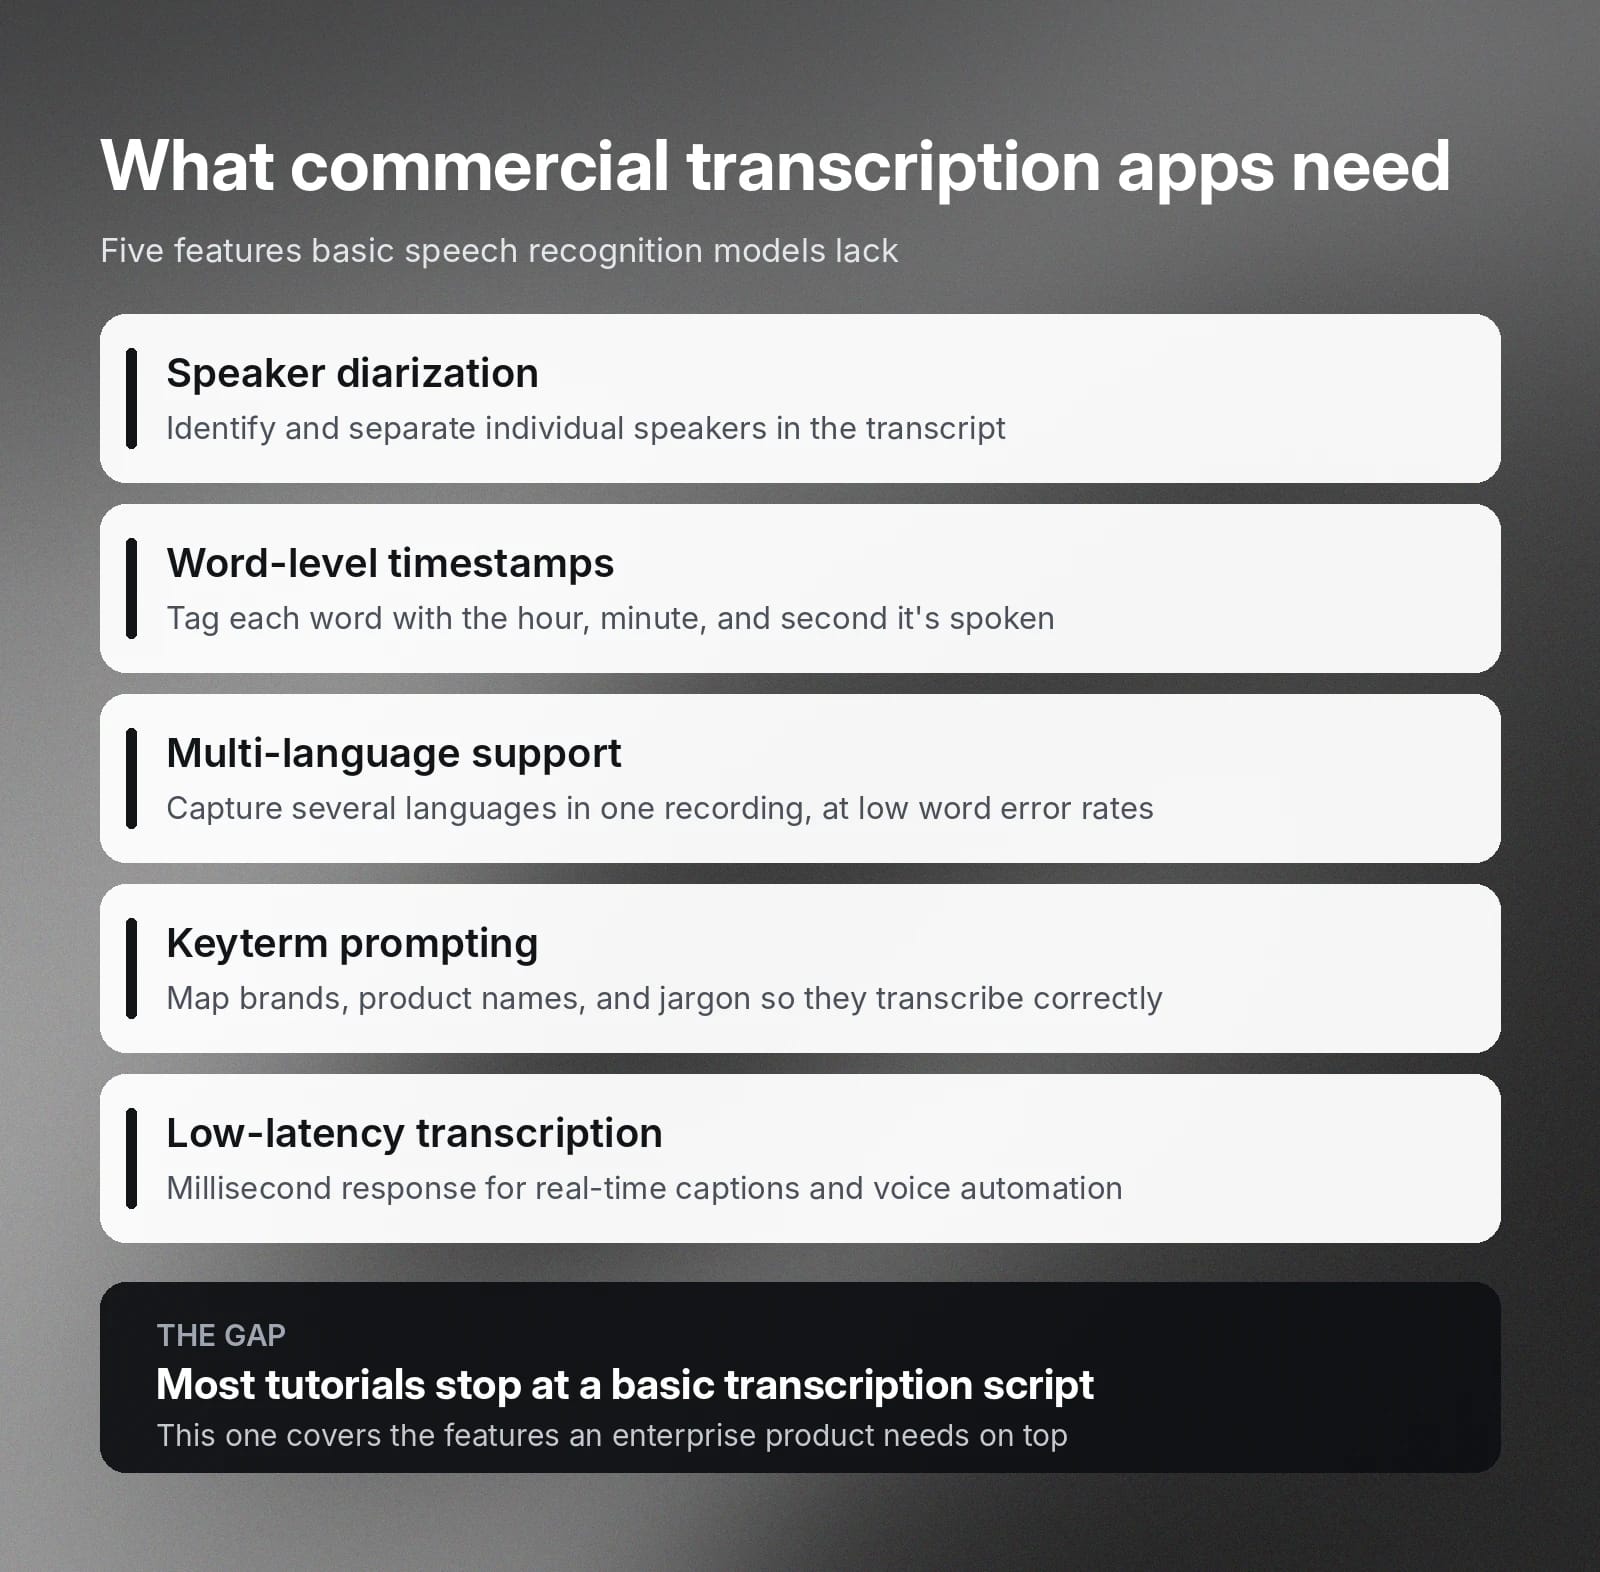
Viele Enterprise-Transkriptionslösungen benötigen beispielsweise diese Funktionen:
- Sprecherdiarisierung: Die Fähigkeit, einzelne Sprecher im Transkript zu erkennen und voneinander zu trennen.
- Zeitstempel: Jedes Wort präzise mit der relativen Stunde, Minute und Sekunde markieren, zu der es gesprochen wird.
- Mehrsprachige Unterstützung: Erkennt Sprache in verschiedenen Sprachen innerhalb einer einzelnen Aufnahme oder eines Livestreams bei niedriger Wortfehlerrate.
- Keyterm-Prompting: Spezielle Wörter wie Marken, Produktnamen und Fachbegriffe zuordnen, um falsch geschriebene Transkriptionen zu vermeiden.
- Transkription mit geringer Latenz: Speech-to-Text-Antworten im Millisekundenbereich für Echtzeit-Transkriptions-Apps.
Hinweis: Dieses Tutorial geht über einfache persönliche Skripte für Hobby- oder private Projekte hinaus. Es enthält keine Anwendungslogik, die auf der Integration der Speech to Text API aufbaut, da diese je nach Unternehmen unterschiedlich ist.
Voraussetzungen für die Python-Integration zur Spracherkennung
Dieses Tutorial basiert auf ElevenAPI, einer produktionsreifen API von ElevenLabs, die die Interaktion mit Stimmmodellen in Ihrem Code vereinfacht. Mit ElevenAPI erhalten Sie Zugriff auf Scribe v2 und Scribe v2 Realtime, unsere führenden Stimmmodelle für Batch- und Live-Transkription.
Statt direkt auf ElevenLabs Speech to Text-Modelle zuzugreifen, übergeben Sie Audioaufnahmen, Livestreams und Argumente über API-Aufrufe. Das Audiomodell wandelt die Audiodaten dann in Text um. Nach Abschluss erhalten Sie die Transkripte im Code oder über einen Webhook.
Führen Sie zunächst diese Vorbereitungsschritte aus.
- Bei ElevenLabs registrieren.
- Ihren API-Key erstellen.
- Ein Gespräch aufzeichnen und in einen öffentlich zugänglichen Speicher hochladen.
Sobald Sie bereit sind, fahren Sie mit dem nächsten Abschnitt fort.
Umgebung einrichten
Bevor Sie ElevenLabs-Modelle integrieren, richten Sie Ihre Python-Umgebung ein, um Ihren ElevenLabs API-Key zu schützen. Wie alle API-Keys sollten Sie ihn als Umgebungsvariable (verwaltetes Secret) in der .env-Datei speichern.
Bei einem API-Aufruf übergeben Sie die Umgebungsvariable. So verhindern Sie, dass der API-Key bei API-Anfragen über ein öffentliches Netzwerk versehentlich offengelegt wird.
Führen Sie als Nächstes einen Bash-Befehl aus, um elevenlabs, das ElevenLabs SDK, in Ihrer Python-Umgebung zu installieren. Mit dem SDK greifen Sie auf verschiedene Stimmmodelle zu. In diesem Fall wählen Sie zwischen Scribe v2 und Scribe v2 Realtime.
Sie müssen außerdem python-dotenv installieren. Damit kann Ihr Python-Code auf Umgebungsvariablen zugreifen, die in der .env-Datei gespeichert sind.
Ihr erstes Transkriptionsskript schreiben
Nach dem Einrichten der Python-Umgebung können Sie die Audiodatei mit ElevenLabs Scribe v2 transkribieren.
ElevenLabs Scribe v2 ist ein führendes Spracherkennungsmodell, mit dem Sie Audiodateien im großen Maßstab transkribieren. Es erkennt Phoneme selbst bei starken Hintergrundgeräuschen mit hoher Genauigkeit. Um Audio zu transkribieren, senden Sie die Aufnahme über die ElevenLabs API an das Modell und rufen das fertige Transkript ab.
Unten finden Sie ein Python-Code-Snippet, das eine Audiodatei in ein Transkript mit Zeitstempeln und Sprecherdiarisierung umwandelt.
Der Code lädt die erforderlichen Bibliotheken mit den benötigten Funktionen. Er lädt außerdem die von Ihnen deklarierten Umgebungsvariablen in die Programmumgebung.
Anschließend erstellt er einen ElevenLabs-Client mit dem in der Umgebungsvariable gespeicherten API-Key. Danach lädt er die Audiodatei herunter und wandelt sie in Binärdaten um.
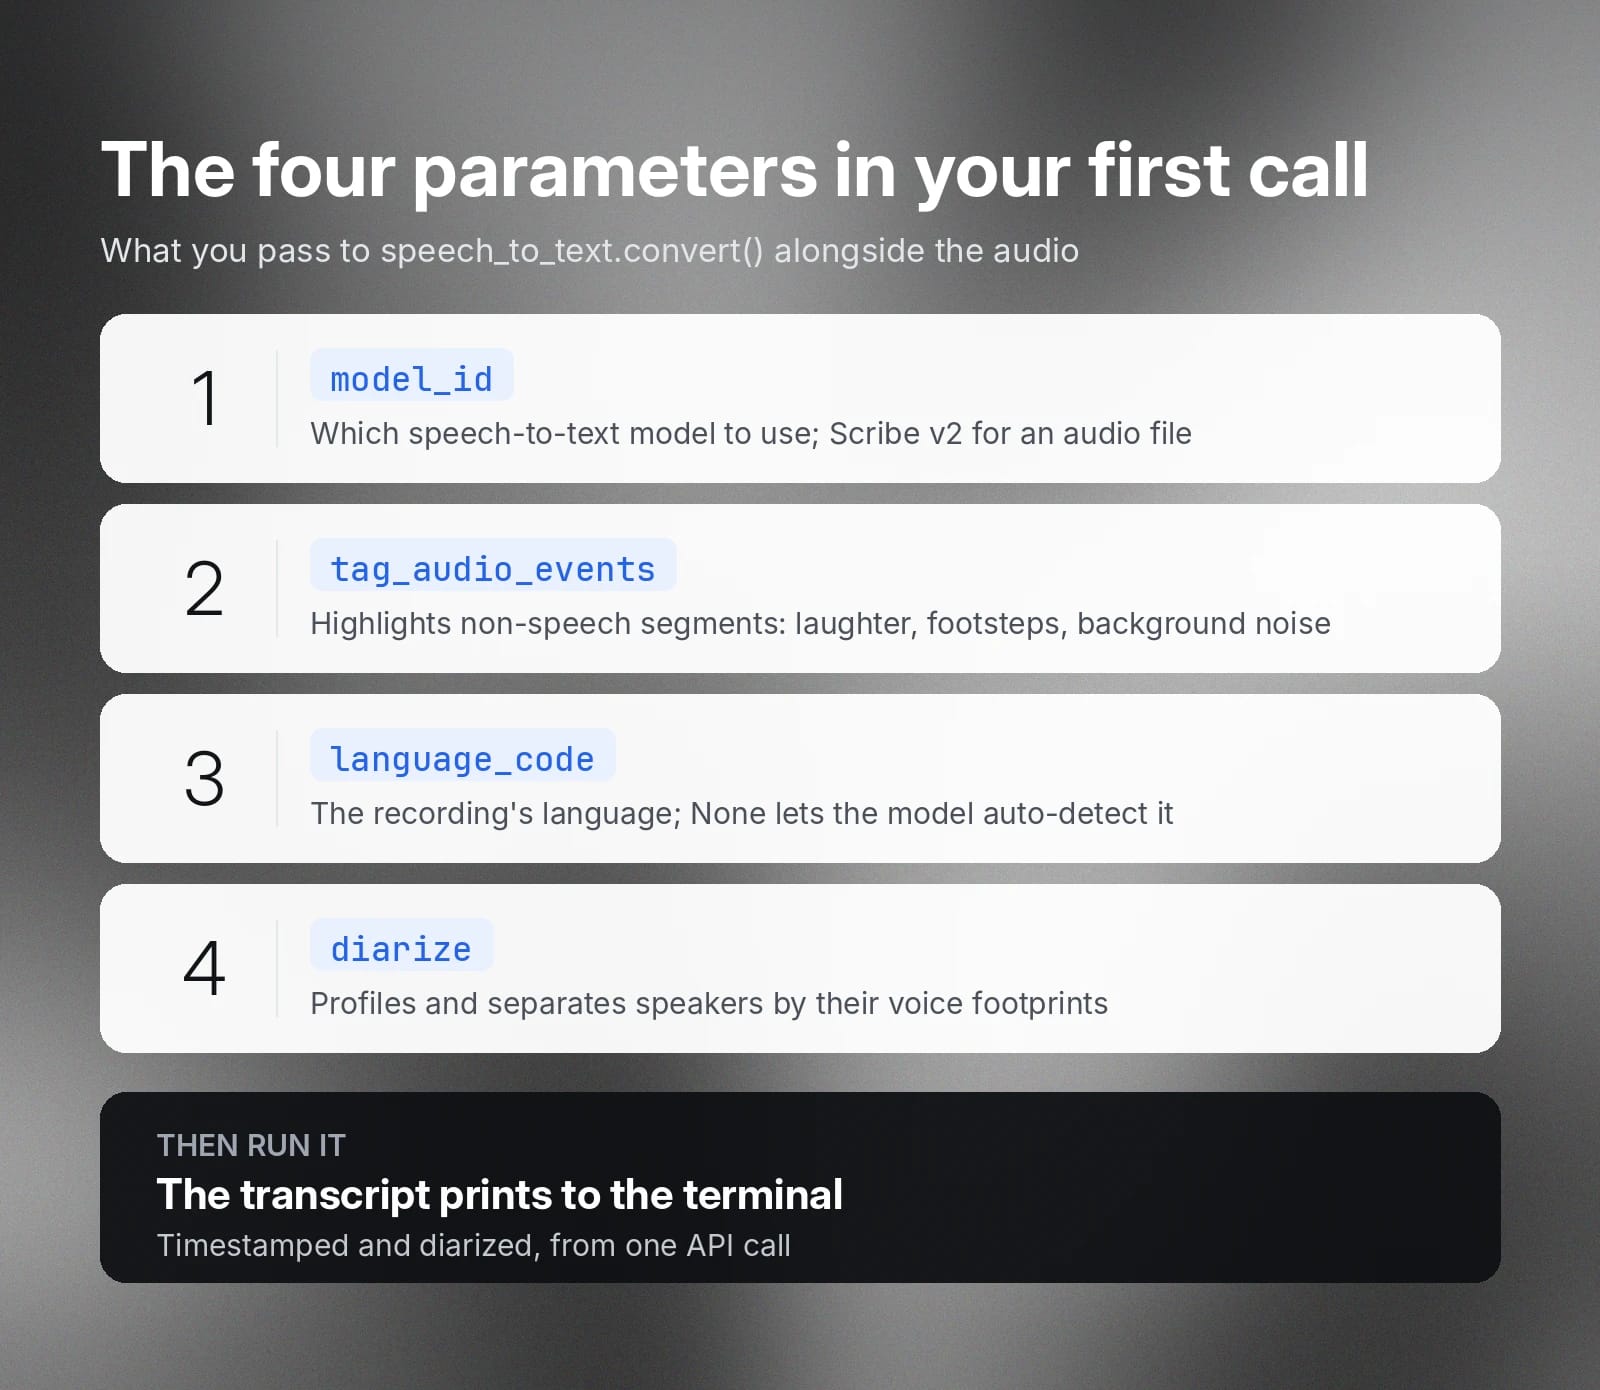
Sobald Sie die Rohdaten des Audios haben, senden Sie sie zusammen mit mehreren Parametern an die ElevenLabs API.
- model_id gibt an, welches Speech-to-Text-Modell Sie verwenden möchten. Da Sie eine Audiodatei übergeben, ist Scribe v2 die beste Option.
- tag_audio_events ermöglicht es Ihnen, nichtsprachliche Segmente wie Lachen, Schritte und andere Hintergrundgeräusche hervorzuheben.
- language_code steht für die Sprache der Gespräche in der Aufnahmedatei. Wenn der Wert auf None gesetzt ist, erkennt das Modell die Sprache automatisch.
- diarize gibt an ob das Modell verschiedene Sprecher anhand ihrer Stimmmerkmale profilieren und voneinander trennen soll.
Führen Sie den Code schließlich aus. Das transkribierte Audio wird im Terminal angezeigt.
Streaming-Spracherkennung in Python
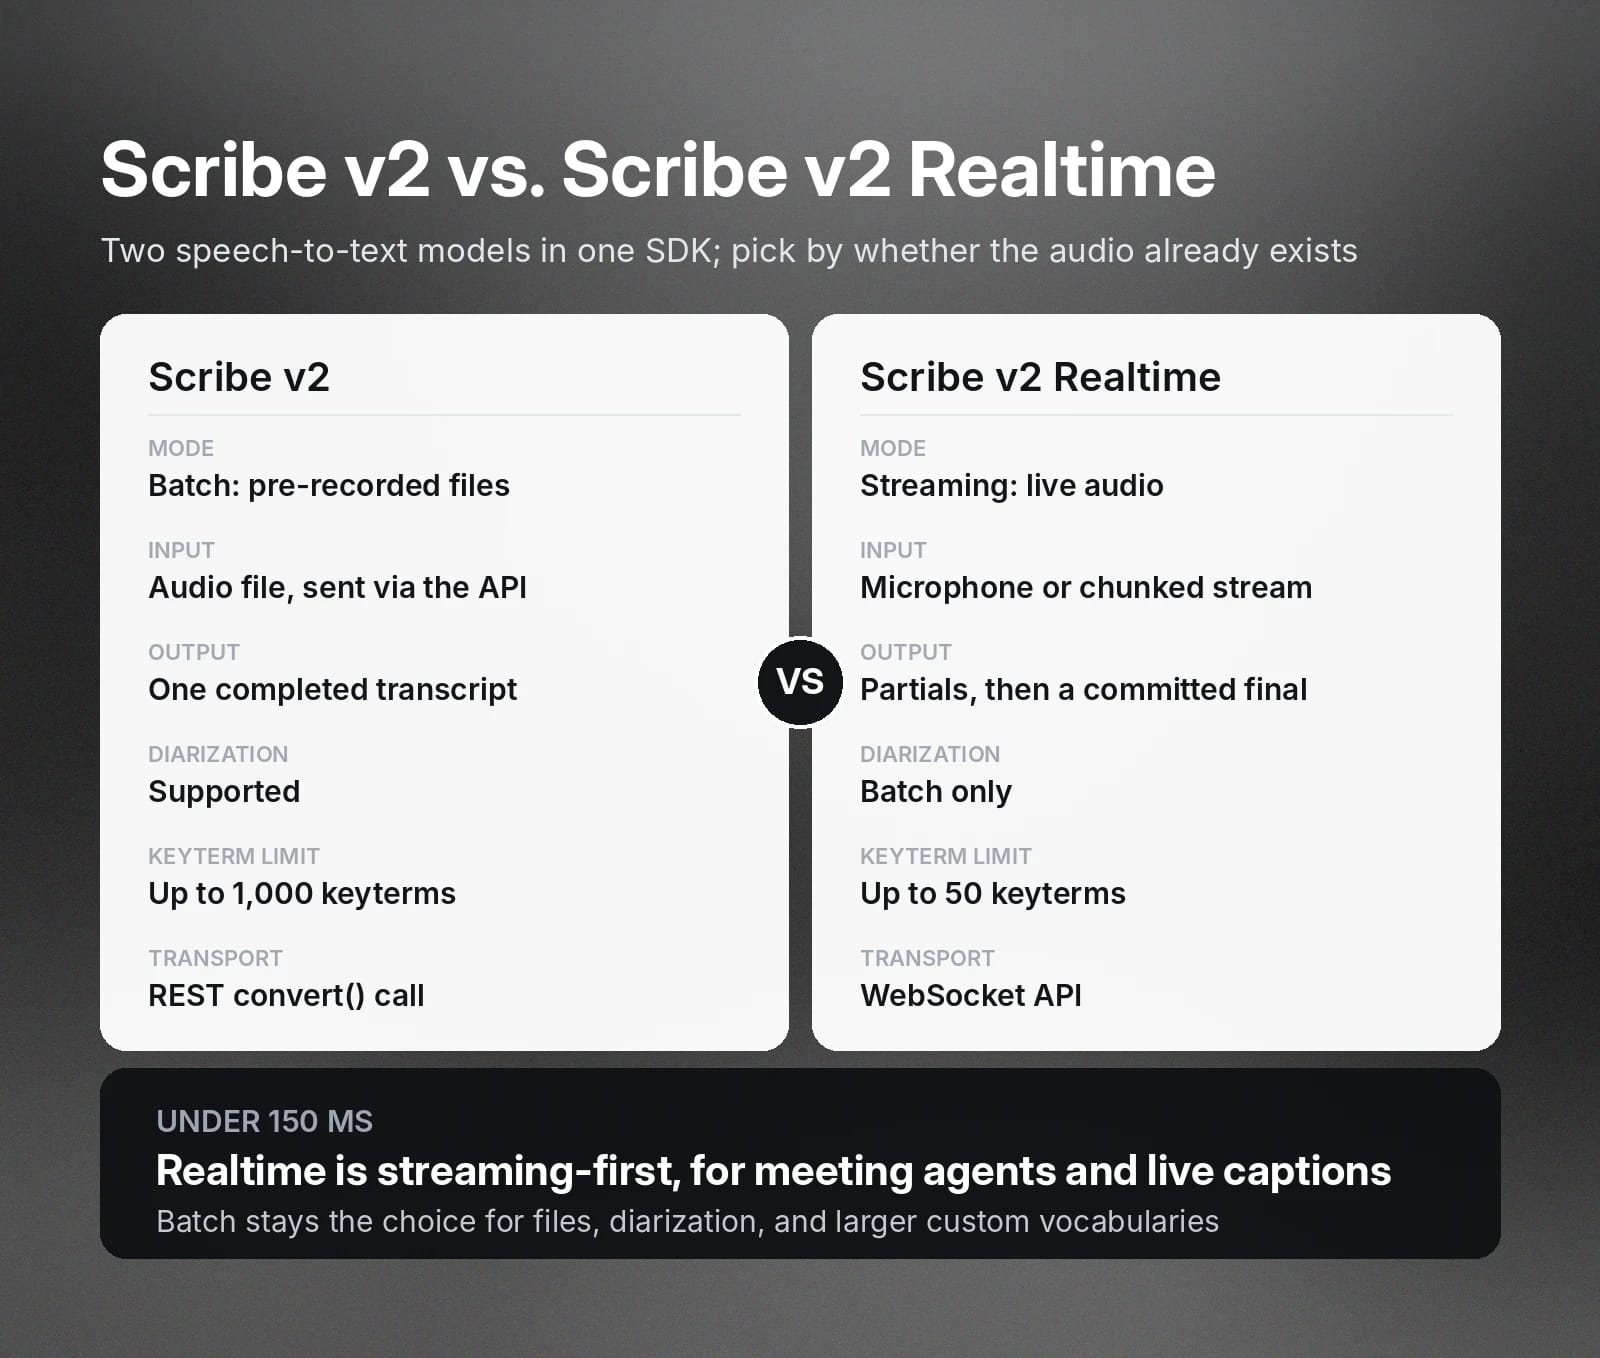
Das obige Beispiel behandelt die Batch-Transkription, die sich für voraufgezeichnete Dateien eignet. ElevenLabs bietet jedoch auch APIs für Streaming-Spracherkennung. Im Gegensatz zur Batch-Verarbeitung läuft die Spracherkennung hier in Echtzeit, um Transkripte während des Gesprächs zu generieren.
Dazu verbinden Sie Ihren Python-Code über die WebSocket API mit dem Modell Scribe v2 Realtime.
Scribe v2 Realtime bietet eine Streaming-First-Architektur mit einer Transkriptionslatenz von unter 150 ms. Mit Scribe v2 Realtime entwickeln Sie Anwendungen wie Meeting-Agents, Tools für Barrierefreiheit und sprachgesteuerte Automatisierung. Das Modell gibt ein Teiltranskript zurück, während es den Audiostream verarbeitet. Das finale Transkript gibt es erst zurück, wenn der Code ein Audiosegment automatisch oder manuell bestätigt.
Je nach Audioquelle und Anwendungstyp integrieren Sie die Spracherkennung mit der ElevenLabs API entweder server- oder clientseitig.
- Clientseitiges Streaming ermöglicht Streaming direkt vom Mikrofon oder über manuell segmentierte Audiostreams.
- Serverseitiges Streaming leitet Audiodaten von einer URL oder Audioquelle an das Stimmmodell weiter.
Sowohl client- als auch serverseitiges Streaming ermöglichen einen asynchronen Workflow. Statt die API fortlaufend abzufragen, verwenden Sie WebSockets zur Verarbeitung der Ergebnisse. In Ihrem Code müssen Sie Handler erstellen, die Teil- und finale Transkripte empfangen.
Weiterführend: Diarisierung, Zeitstempel und benutzerdefiniertes Vokabular
Zusätzlich zur automatischen Spracherkennung unterstützen ElevenLabs Speech to Text-Modelle Diarisierung, Zeitstempel und benutzerdefiniertes Vokabular.
- Diarisierung: Nur die Batch-Transkription unterstützt Sprecherdiarisierung. Sie aktivieren die Diarisierung, indem Sie das Argument diarize setzen. Die Mehrkanal-Transkription, ein Modus innerhalb der Batch-Transkription, unterstützt jedoch keine Diarisierung.
- Zeitstempel: Bei der Batch-Transkription können Sie Zeitstempel auf Wort- oder Zeichenebene wählen. Setzen Sie dazu bei der Methode convert den Parameter timestamps_granularity.
- Benutzerdefiniertes Vokabular: Sowohl Echtzeit- als auch Batch-Transkription unterstützen Keyterm-Prompting. Diese Funktion lenkt das Modell auf bestimmte Keyterms, die Sie in eine Liste aufnehmen. Scribe v2 Realtime unterstützt bis zu 50 Keyterms, Scribe v2 bis zu 1.000 Keyterms.
Den ElevenLabs Skill in KI-Coding-Assistenten verwenden
KI-Coding-Assistenten beschleunigen die Entwicklung. Wenn Sie Tools wie Claude Code, Cursor, Codex oder ähnliche KI-Coding-Tools verwenden, können Sie ElevenLabs Skills in Ihrer Coding-Umgebung hinzufügen.
Führen Sie dafür diesen Befehl im Terminal Ihrer Plattform aus:
Der KI-Coding-Agent lädt den Speech-to-Text-Skill aus dem GitHub-Repository von ElevenLabs herunter und installiert ihn im lokalen Skill-Verzeichnis. So generieren Sie automatisch Python-Code für Spracherkennung auf Basis der offiziellen Dokumentation von ElevenLabs, statt die gesamte API-Integration von Grund auf zu schreiben.
Nach der Installation können Sie Python-Code für Spracherkennung generieren, indem Sie in natürlicher Sprache beschreiben, was er tun soll. Der Coding-Assistent generiert anhand der Beschreibung automatisch Code mit dem Speech-to-Text-Skill sowie dem richtigen Modell und den passenden Parametern.
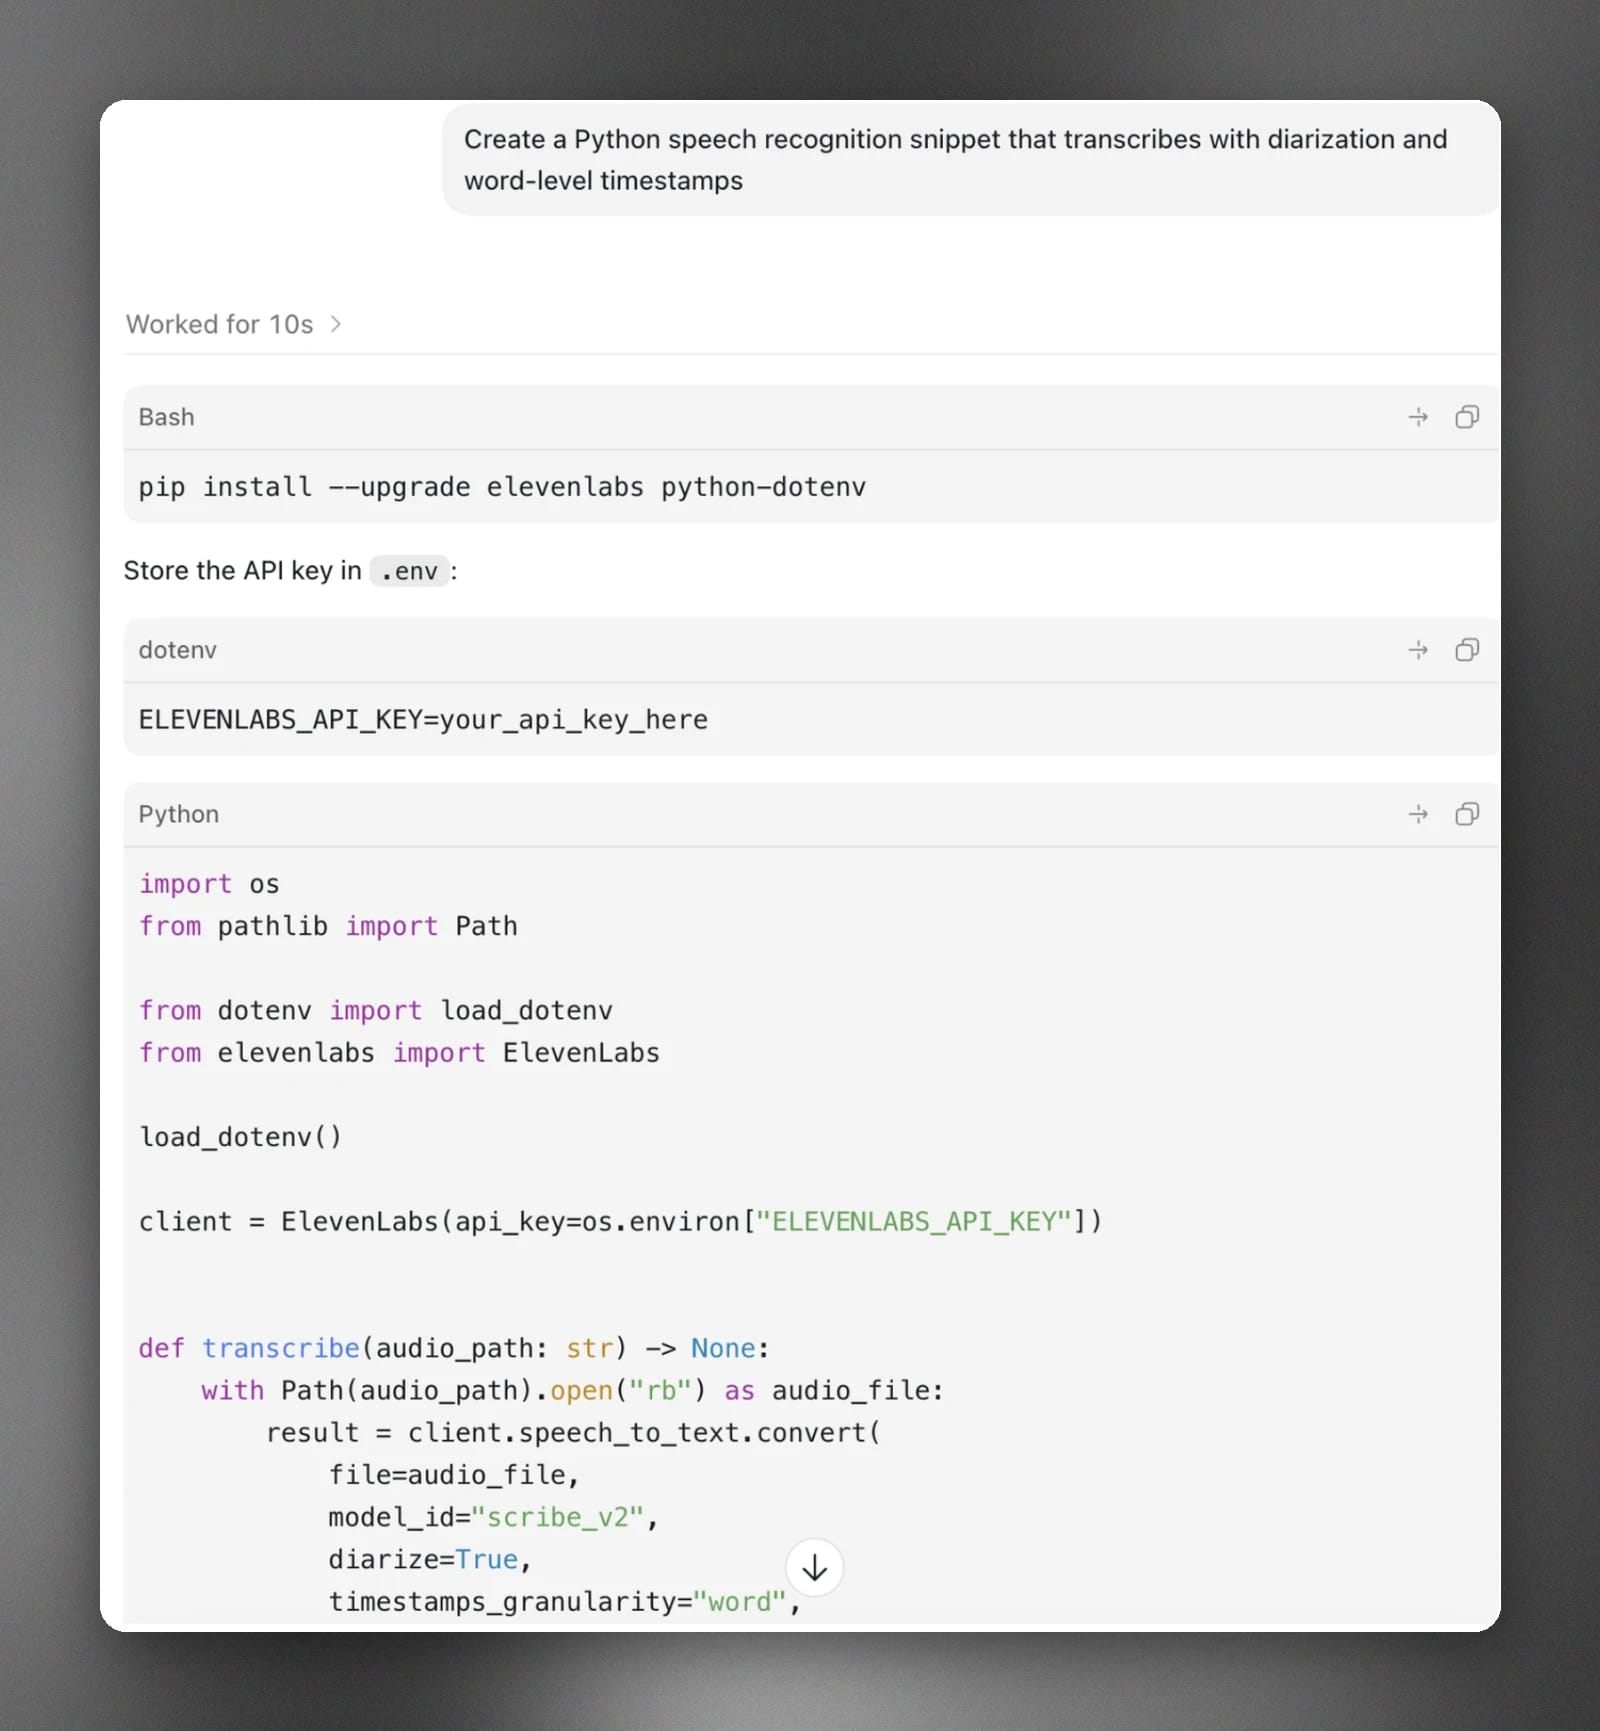
Wenn Sie beispielsweise in Codex „Erstelle ein Python-Snippet zur Spracherkennung, das mit Diarisierung und Zeitstempeln auf Wortebene transkribiert“ eingeben, erhalten Sie ein ähnliches Snippet wie unten.
Mit ElevenAPI für Spracherkennung starten
ElevenAPI ermöglicht Ihnen den Zugriff auf fortschrittliche Speech to Text-Modelle, um Apps zur Spracherkennung in Python zu entwickeln.
Mit ElevenAPI vermeiden Sie Integrationscode von Grund auf, der Produktinnovationen verzögert. Stattdessen nutzen Sie SDKs, die Speech to Text-Dienste mit Anforderungen auf kommerziellem Niveau bereitstellen – etwa Keyterm-Prompting, Diarisierung und Zeitstempel.
Erstellen Sie jetzt Ihren ElevenLabs API-Key und lesen Sie unsere offizielle Dokumentation , um zu erfahren, wie die API funktioniert.
Häufig gestellte Fragen

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


