
Was ist Sprecherdiarisierung? Funktionsweise und Anwendungsfälle
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Sprecherdiarisierung verarbeitet einen Audiostream mit einer unbekannten Anzahl von Sprechern und erstellt eine Zeitleiste mit gekennzeichneten Segmenten: Sprecher A von 0:00 bis 0:42, Sprecher B von 0:42 bis 1:15, anschließend wieder Sprecher A. Das System weiß nicht, wer die Sprecher sind, erkennt aber, dass es sich um unterschiedliche Personen handelt, und hält ihre Kennzeichnungen über die gesamte Aufnahme hinweg konsistent.
Dieser Prozess macht Audio mit mehreren Sprechern nutzbar. Besprechungsnotizen, Callcenter-Analysen, Interviewtranskriptionen, Podcast-Bearbeitung und juristische Aufzeichnungen setzen voraus, nicht nur zu wissen, was gesagt wurde, sondern auch, wer es gesagt hat.
Dieser Leitfaden erklärt, wie Diarisierung funktioniert, wie sie sich von verwandten Techniken wie Segmentierung und Identifikation unterscheidet, welche Open-Source-Tools sie unterstützen und wie Sie die Leistung eines Diarisierungssystems messen.
Zusammenfassung
- Sprecherdiarisierung segmentiert eine Audioaufnahme danach, wer spricht, und erstellt gekennzeichnete Sprecherwechsel, ohne Personen namentlich zu identifizieren.
- Sprecherdiarisierung unterscheidet sich von Sprechersegmentierung, die Sprecherwechsel erkennt, und Sprecheridentifikation, die Stimmen realen Namen zuordnet.
- Die Leistung der Diarisierung wird mit der Diarisierungsfehlerrate (DER) für die Gesamtgenauigkeit und der Jaccard-Fehlerrate (JER) gemessen, um zu prüfen, ob die Genauigkeit für jeden Sprecher erhalten bleibt.
Was ist Sprecherdiarisierung und wie funktioniert sie?
Sprecherdiarisierung ist der Prozess, einen Audiostream danach in Segmente zu unterteilen, wer spricht. Ein Transkript mit Sprecherdiarisierung kennzeichnet jedes Audiosegment mit einer Sprecheridentität. Einfach gesagt beantwortet sie die Frage: „Wer hat wann gesprochen?“
Ein Rohtranskript einer Besprechung liefert Ihnen die Worte, während ein diarisiertes Transkript zeigt, dass Sprecher 1 die Frage gestellt, Sprecher 2 sie beantwortet und Sprecher 3 mittendrin unterbrochen hat.
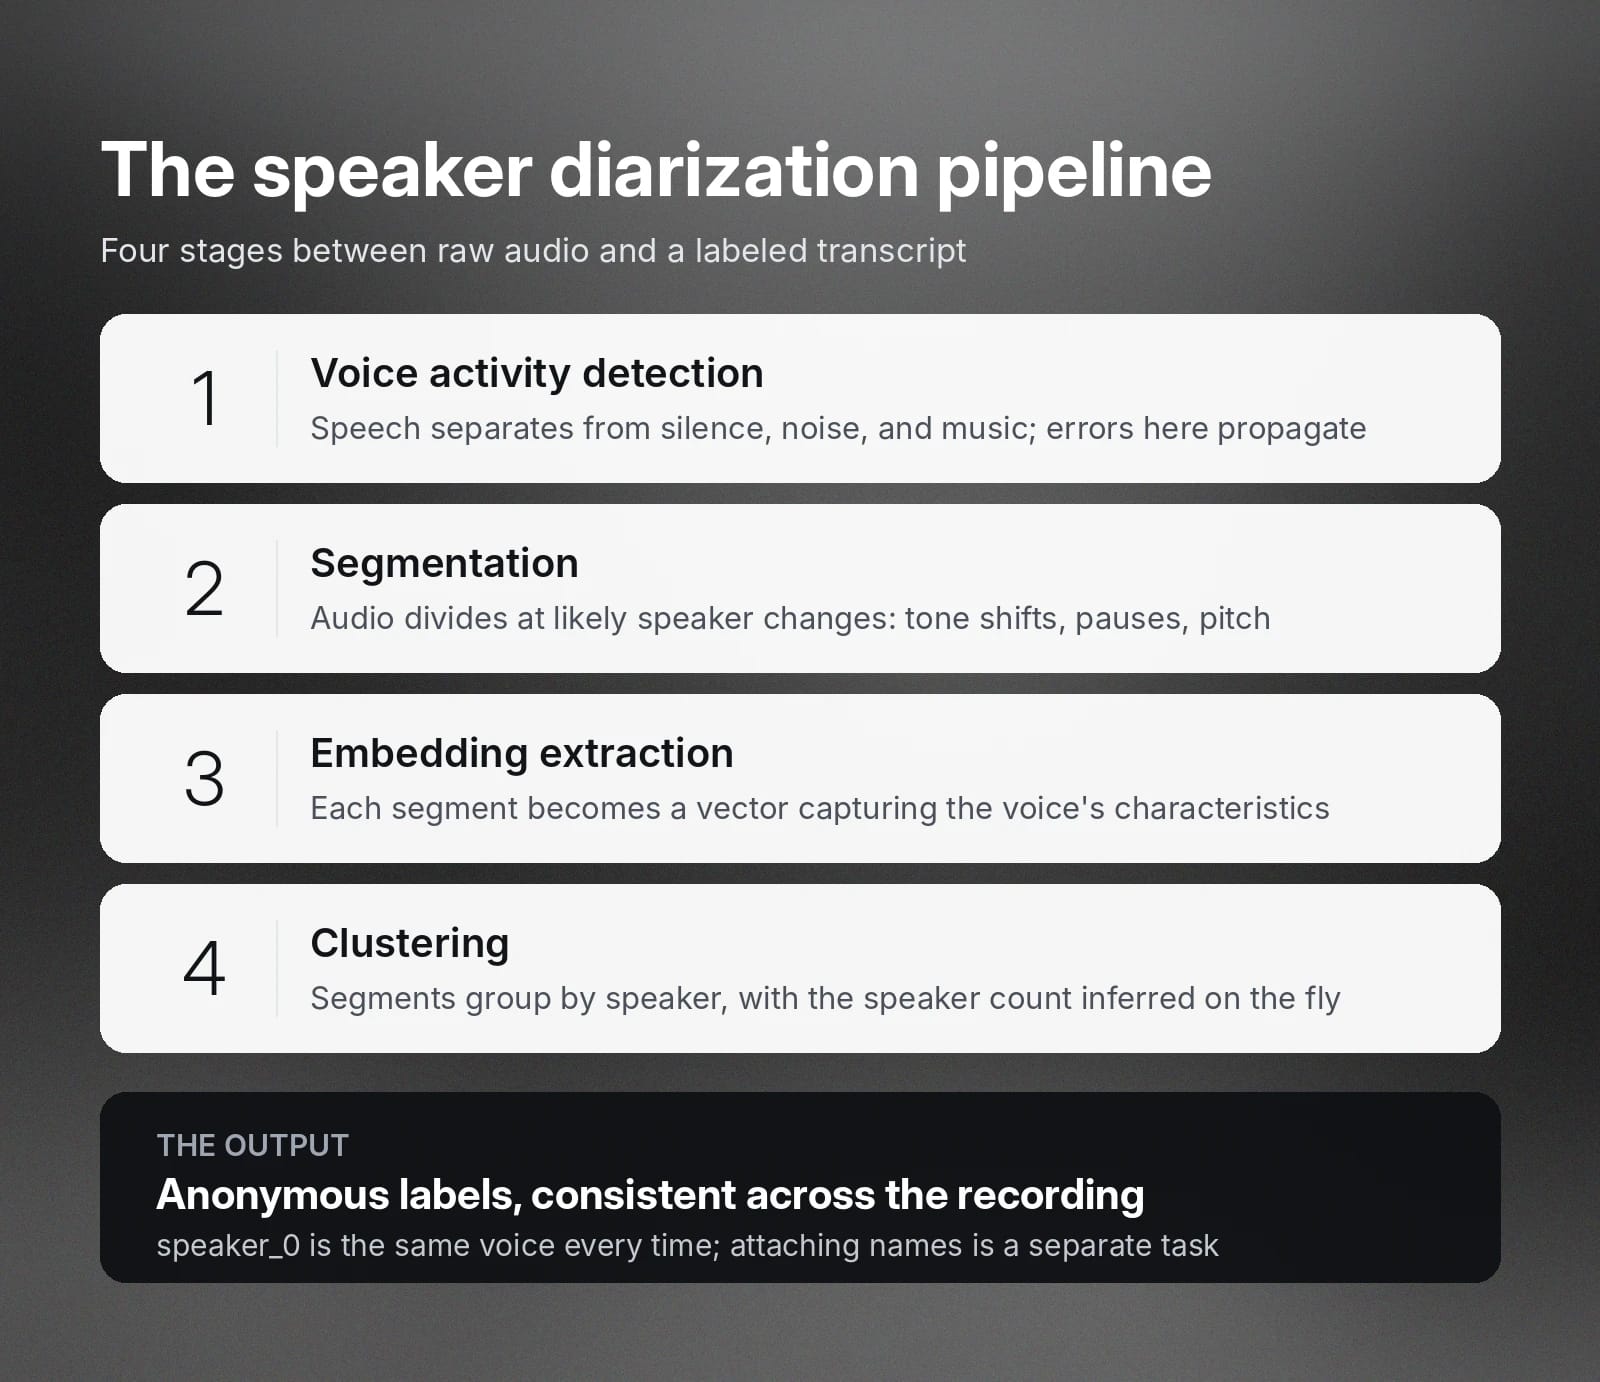
Die meisten Systeme zur Sprecherdiarisierung folgen einer Pipeline mit vier Stufen:
Sehen wir uns diese Stufen genauer an.
Sprachaktivitätserkennung (VAD)
Sprachaktivitätserkennung trennt Sprache von allem anderen: Stille, Hintergrundgeräuschen, Musik oder Tastaturklicks. Nur Audiosegmente mit tatsächlicher Sprache gelangen in die nächste Stufe.
Fehler in dieser Stufe wirken sich auf alle folgenden Stufen aus.
Segmentierung
Diese sprachhaltigen Segmente werden anschließend an Stellen unterteilt, an denen der Sprecher vermutlich wechselt, etwa bei einer Veränderung des Stimmklangs, einer Pause zwischen Sprecherwechseln oder einer Änderung des Tonhöhenmusters. Die meisten Systeme erkennen diese Wechselpunkte direkt, indem sie die akustischen Eigenschaften auf beiden Seiten einer potenziellen Grenze vergleichen.
Einige Segmentierungstools teilen Audio in kurze, gleichmäßige Fenster auf, etwa in Zwei-Sekunden-Abschnitte, und verlassen sich dann auf die Clustering-Stufe, um benachbarte Fenster desselben Sprechers zusammenzuführen.
Embedding-Extraktion
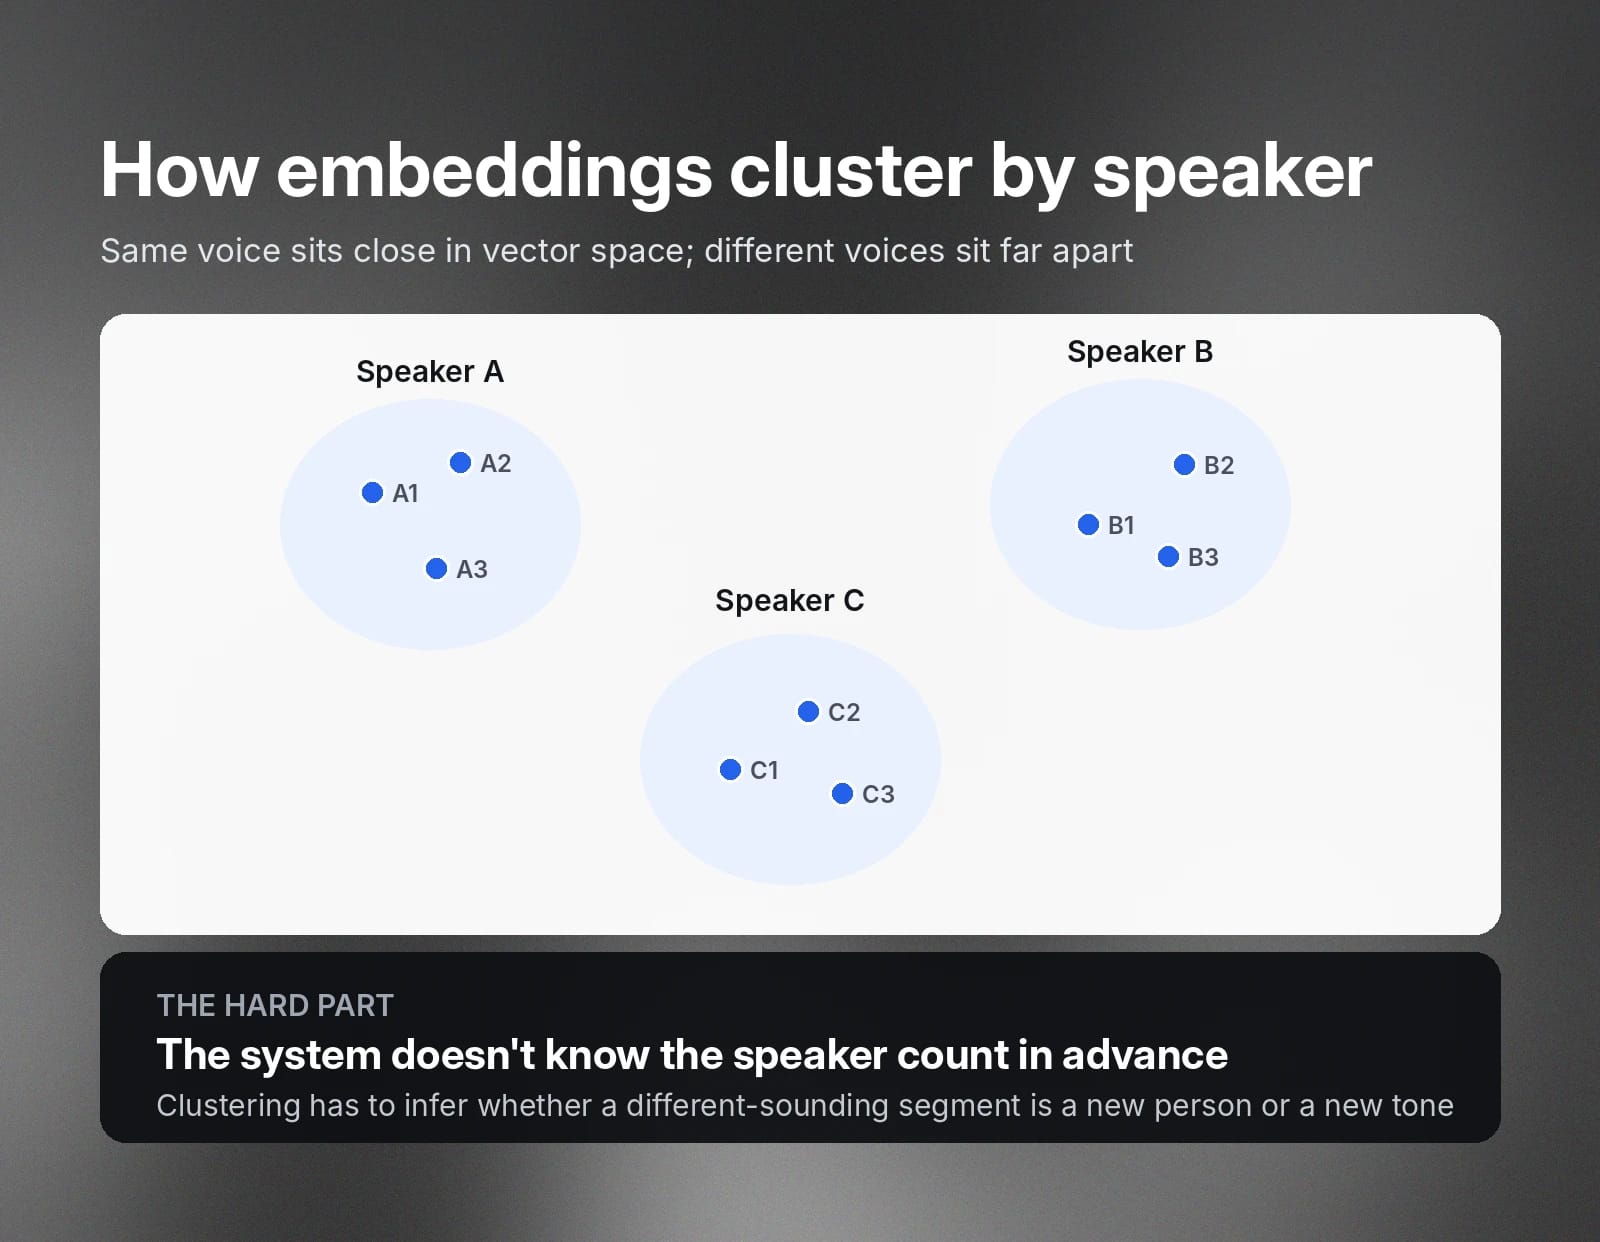
Jedes Sprachsegment wird in ein Sprecher-Embedding umgewandelt, also einen numerischen Vektor, der die stimmlichen Merkmale der sprechenden Person erfasst. Embeddings desselben Sprechers liegen im Vektorraum nah beieinander, während Embeddings verschiedener Sprecher weiter voneinander entfernt sind.
Clustering
Die Embeddings werden anschließend gruppiert, sodass Segmente desselben Sprechers dieselbe Kennzeichnung erhalten. Das System kennt die Anzahl der Sprecher in der Regel nicht im Voraus. Der Clustering-Algorithmus muss sie daher ableiten und entscheiden, ob ein leicht anders klingendes Segment von einem neuen Sprecher stammt oder von derselben Person mit anderem Stimmklang.
Das Ergebnis ist eine Reihe von Sprecherkennzeichnungen mit Zeitbereichen, meist zusammen mit einem Transkript. Ein diarisiertes Transkript eines Gesprächs zwischen zwei Personen sieht beispielsweise so aus:
- [speaker_0] Danke für Ihren Anruf. Wie kann ich Ihnen helfen?
- [speaker_1] Hallo, ich rufe wegen meiner Rechnung vom letzten Monat an.
- [speaker_0] Gerne, ich sehe gleich nach.
Die Kennzeichnungen sind anonym und intern konsistent. Speaker_0 ist bei jedem Auftreten dieselbe Stimme, aber das System weiß nicht, dass speaker_0 Fergal heißt. Reale Identitäten zuzuordnen ist eine andere Aufgabe, auf die wir unten eingehen.
Wichtige Unterschiede zwischen Sprechersegmentierung und Sprecheridentifikation
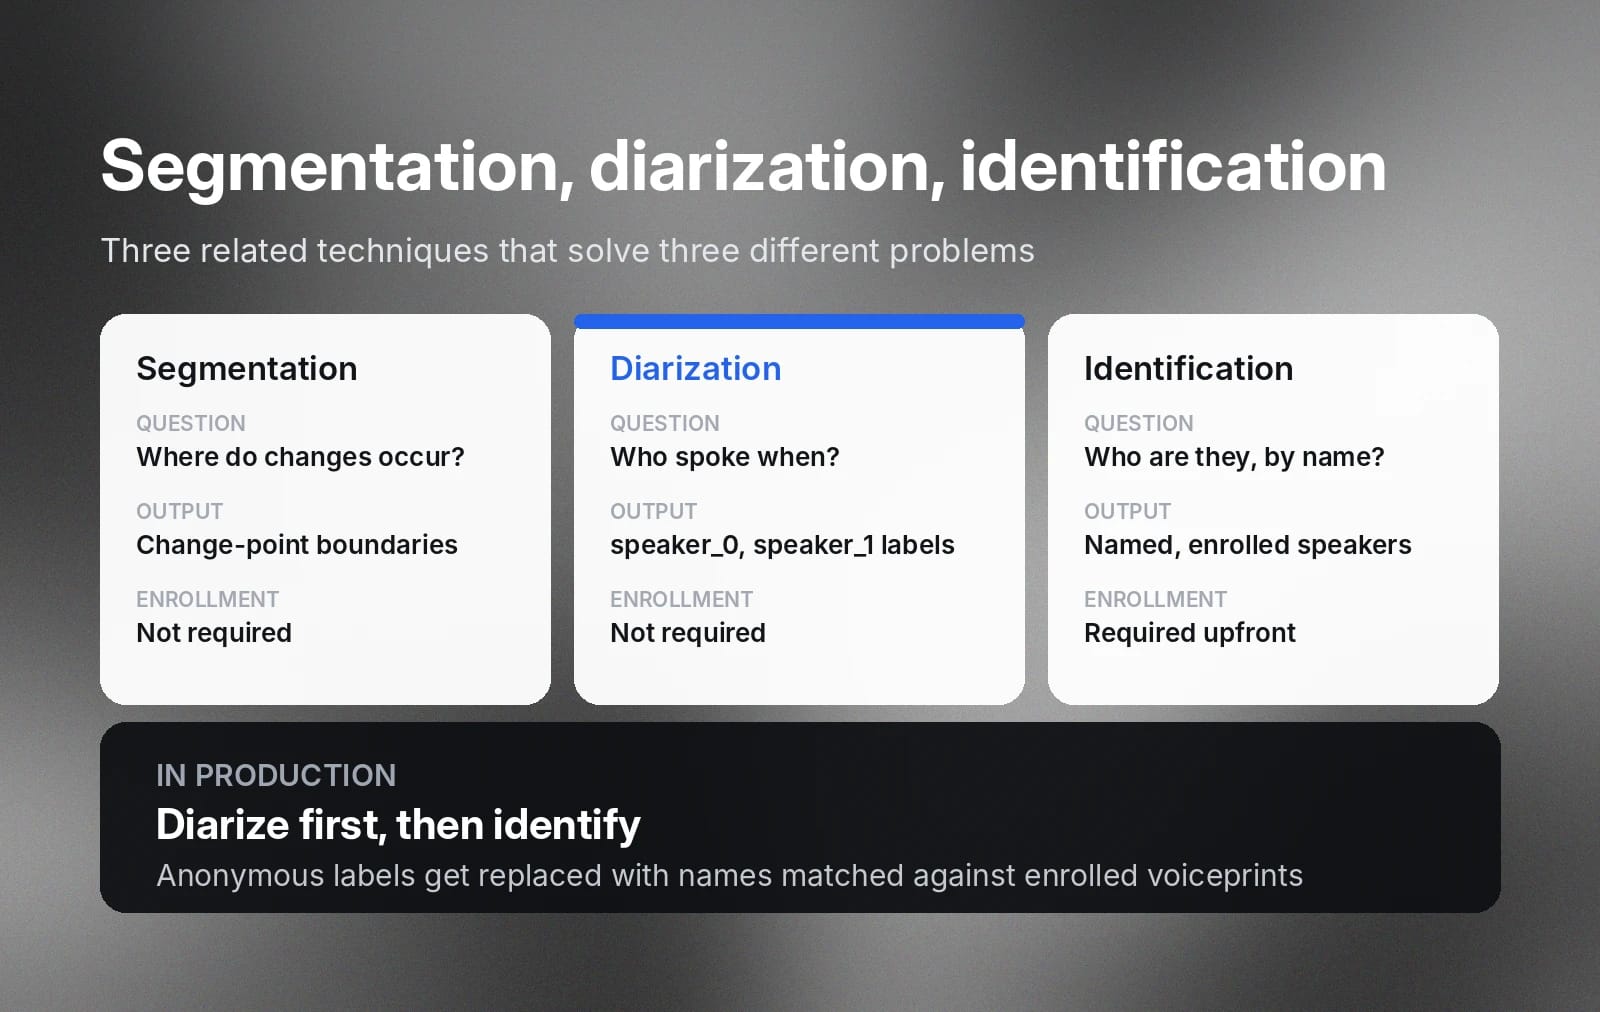
Sprechersegmentierung und Sprecheridentifikation überschneiden sich beide stark mit der Diarisierung, weshalb die drei Begriffe häufig verwechselt werden.
Jede dieser Methoden löst ein leicht anderes Problem. Daher ist es wichtig, den Unterschied bei der Bewertung von Tools zu verstehen.
Wie bereits erläutert, ist die Sprechersegmentierung ein früher Schritt innerhalb der Diarisierungspipeline. Sie findet die Grenzen, an denen ein Sprecher zu einer anderen Stimme wechselt, ohne Kennzeichnungen zuzuweisen. Die Segmentierung zeigt Ihnen, dass bei 0:42 ein Wechsel stattgefunden hat. Die Diarisierung baut darauf auf, indem sie die resultierenden Segmente gruppiert und vollständig gekennzeichnete Ergebnisse erstellt. So wissen Sie, dass die Stimme bei 1:15 dieselbe ist, die zu Beginn der Aufnahme gesprochen hat.
Die Sprecheridentifikation ist eine eigenständige Fähigkeit außerhalb der Diarisierung, wird aber häufig mit ihr kombiniert. Die Identifikation bestimmt, wer diese Sprecher tatsächlich sind. Ein Identifikationssystem vergleicht Stimmen mit registrierten Stimmabdrücken und nutzt eine Referenz bekannter Sprecher, um Identitäten zurückzugeben. Nach der Identifikation werden aus speaker_0 und speaker_1 „Fergal“ und „Eric“.
Viele Produkte kombinieren diese Tools, um ein umfassenderes finales Transkript zu erstellen. Ein Besprechungstool könnte dies automatisch tun und möglicherweise sogar Zeichenfolgen wie den Namen verwenden, den jemand in Teams oder Meet festgelegt hat. So werden die Beiträge aller Teilnehmer ohne manuelle Prüfung namentlich zugeordnet.
Beliebte Open-Source-Tools und -Bibliotheken für Sprecherdiarisierung
Open-Source-Tools für Sprecherdiarisierung sind eine Überlegung wert, wenn Sie Kontrolle, Flexibilität oder lokale Bereitstellung benötigen. Die beste Wahl hängt von der Art der verarbeiteten Audiodaten ab – Telefonate, Besprechungen, Podcasts oder Sendungen –, von Ihren Latenzanforderungen und davon, wie viel Entwicklungszeit Sie investieren können.
Hier sind einige der beliebtesten Optionen.
Pyannote.audio
Pyannote.audio ist ein PyTorch-basiertes Toolkit, das speziell für Sprecherdiarisierung entwickelt wurde, und eine der meistgenutzten Open-Source-Optionen. Es bietet vortrainierte Pipelines für den gesamten Diarisierungs-Stack, einschließlich VAD, Segmentierung, Embeddings und Clustering, sowie Bausteine zum Trainieren oder Finetunen von Modellen mit eigenen Daten.
Die vortrainierten Modelle werden über Hugging Face bereitgestellt und häufig als Diarisierungsschicht in größeren Transkriptionsprojekten eingesetzt.
WhisperX
WhisperX kombiniert OpenAIs Whisper ASR mit Diarisierung und erzwungener Ausrichtung. Whisper allein erstellt starke Transkripte, weist jedoch keine Sprecherkennzeichnungen zu, und seine Zeitstempel sind nur näherungsweise. WhisperX fügt eine wortgenaue Zeitstempelausrichtung hinzu und integriert eine auf pyannote basierende Diarisierung. So entstehen Transkripte, in denen jedes Wort sowohl einen präzisen Zeitstempel als auch eine Sprecherkennzeichnung trägt.
NVIDIA NeMo
NVIDIA NeMo enthält Diarisierung als Teil seines umfassenderen Conversational-AI-Frameworks. Es bietet trainierbare Diarisierungsmodelle, einschließlich End-to-End-Ansätzen zur Verarbeitung überlappender Sprache, und ist für Teams konzipiert, die maßgeschneiderte Sprachsysteme im großen Maßstab auf GPU-Infrastruktur entwickeln.
Bei jedem dieser Tools müssen Sie die Diarisierungsinfrastruktur selbst verwalten, einschließlich Modellbereitstellung, Skalierung, Überwachung und Updates. Für Teams, die diesen Betriebsaufwand vermeiden möchten, bieten verwaltete APIs für Sprecherdiarisierung eine einfachere Alternative. Sie lassen sich in bestehende Workflows integrieren oder übernehmen die gesamte Diarisierungspipeline und eignen sich daher gut für Produktionsanwendungen wie Kundensupport-Analysen, Besprechungstranskription und Podcast-Verarbeitung.
Echtzeit-Diarisierung: Herausforderungen und Anwendungsfälle
Echtzeit-Diarisierung ist deutlich schwieriger als die Diarisierung einer abgeschlossenen Aufnahme, weil das System Entscheidungen mit unvollständigem Kontext treffen muss.
Ein Offline-System sieht die gesamte Aufnahme, bevor es sich festlegt. Es kann eine Stimme in Minute 2 mit einer Stimme in Minute 40 vergleichen und zuverlässig entscheiden, dass es derselbe Sprecher ist, weil ihm beide Zeitpunkte gleichzeitig zur Verfügung stehen. Ein Echtzeitsystem hat diesen Vorteil nie: Es muss Sprache in dem Moment kennzeichnen, in dem sie eintrifft, ohne Zugriff darauf, was als Nächstes gesagt wird, und mit kaum oder keiner Möglichkeit, eine getroffene Entscheidung zu revidieren.
Dieser fehlende zukünftige Kontext macht drei konkrete Probleme in Echtzeit deutlich schwerer lösbar:
- Latenz vs. Genauigkeit: Ohne die Möglichkeit, die gesamte Unterhaltung vor und zurück zu analysieren, geht das Einhalten strengerer Reaktionszeitvorgaben direkt auf Kosten der Genauigkeit.
- Überlappende Sprache: Wenn Menschen gleichzeitig sprechen, könnte ein System, das das Audio erneut verarbeitet, die Stimmen möglicherweise trennen. Ein Echtzeitsystem muss sie einer einzigen Kennzeichnung zuordnen oder direkt spezialisierte Modelle einsetzen, die Überlappungen erkennen.
- Kurze Äußerungen: Ein kurzes „Ja“ oder „Nur zu“ liefert dem System kaum genug Stimme zur Analyse. Ohne umgebenden Kontext muss es dennoch sofort eine Kennzeichnung festlegen.
Trotz dieser Schwierigkeit können einige Anwendungen nicht warten, bis eine Aufnahme abgeschlossen ist. Live-Untertitelung für Besprechungen und Sendungen benötigt Sprecherkennzeichnungen, während Menschen sprechen. Contact-Center-Software , die Agenten während eines Anrufs Hinweise gibt, muss in Echtzeit wissen, welche Wörter der Kunde verwendet. Sprachagenten , die Anrufe mit mehreren Teilnehmern bearbeiten, müssen ohne Verzögerung verfolgen, wer was fragt. In jedem Fall ist ein etwas weniger genaues, aber sofortiges System besser als ein genaueres mit Verzögerung.
Für Workloads, die keine Echtzeitkennzeichnungen benötigen, etwa Analysen, Compliance-Prüfungen und Transkripterstellung, bleibt die Batch-Diarisierung die bessere Wahl, da sie deutlich genauer ist.
So bewerten Sie die Leistung der Sprecherdiarisierung
Bei der Messung der Diarisierungsgenauigkeit sind zwei Kennzahlen besonders wichtig: die Diarisierungsfehlerrate (DER), die die Gesamtgenauigkeit erfasst, und die Jaccard-Fehlerrate (JER), die prüft, ob diese Genauigkeit für jeden Sprecher gilt.
Die DER berechnet konkret den Anteil der gesamten Sprechzeit, der falsch zugeordnet wurde. Sie kombiniert drei Fehlertypen:
- Fehlalarm-Sprache: Das System hat ein Segment als Sprache gekennzeichnet, obwohl niemand sprach.
- Übersehene Sprache: Jemand sprach, aber das System kennzeichnete es als Stille.
- Sprecherverwechslung: Sprache wurde erkannt, aber dem falschen Sprecher zugeordnet.
DER = (Fehlalarm + übersehene Sprache + Sprecherverwechslung) / gesamte Sprechdauer
Eine DER von 10 % bedeutet, dass die Fehler über diese drei Typen hinweg einem Zehntel der gesamten Sprechzeit entsprechen. Niedrigere Werte sind besser, und Ergebnisse sind nur vergleichbar, wenn sie unter denselben Bedingungen mit denselben Daten gemessen wurden. Die DER variiert stark mit Audioqualität, Sprecheranzahl und dem Umfang der Überlappungen in der Aufnahme.
Die Jaccard-Fehlerrate (JER) misst die Diarisierungsgenauigkeit für jeden Sprecher separat und mittelt das Ergebnis anschließend über alle Sprecher. Für jeden Referenzsprecher ordnet der Evaluator die ähnlichste Sprecherkennzeichnung des Systems zu und vergleicht die korrekt überlappende Zeit mit der gesamten Zeit, die einem der beiden Sprecher zugewiesen wurde.
Stellen Sie sich beispielsweise eine 60-minütige Besprechung vor, in der Sprecher A 50 Minuten und Sprecher B 10 Minuten spricht. Ein Diarisierungssystem kennzeichnet 48 von 50 Minuten von Sprecher A korrekt, aber nur 4 von 10 Minuten von Sprecher B. Die Gesamt-DER kann dennoch relativ gut aussehen, weil Sprecher A den Großteil der Besprechung einnimmt. Die JER berücksichtigt das schlechte Ergebnis von Sprecher B gleich stark, da sie Sprecher A und Sprecher B vor der Mittelwertbildung unabhängig bewertet.
JER_Sprecher = 1 - (korrekte_Überlappung / (ref_Zeit + sys_Zeit - korrekte_Überlappung))
Die endgültige JER ist der Durchschnitt dieser Fehlerraten pro Sprecher:
JER = (1 / N) * Σ[JER_Sprecher_i] für i = 1..N
Das Tracking von DER und JER liefert ein umfassenderes Bild der Diarisierungsgenauigkeit: DER für die Gesamtgenauigkeit, JER dafür, ob diese Genauigkeit für alle Teilnehmer gilt, einschließlich Personen, die seltener sprechen.
Tests mit produktionsnahen Audiodaten
Berechnen Sie bei der Bewertung eines Sprecherdiarisierungssystems sowohl DER als auch JER mit Audio, das Ihren tatsächlichen Einsatzbedingungen entspricht: Ihrer typischen Sprecheranzahl, Ihrer Audioqualität und dem Ausmaß an Übersprechen.
Veröffentlichte Benchmark-Ergebnisse werden möglicherweise mit sauberen, kontrollierten Datensätzen wie Studio-Aufnahmen gemessen, die selten dem entsprechen, wie echte Anrufaufzeichnungen oder Live-Besprechungen klingen. Ein System mit guten Benchmark-Ergebnissen kann bei verrauschtem Audio mit Überlappungen aus der Praxis dennoch deutlich schlechter abschneiden. Testen Sie mit Ihren eigenen Daten, bevor Sie sich für ein Diarisierungsprodukt entscheiden.
Erste Schritte mit ElevenAPI für Sprecherdiarisierung
Wenn Sie eine Transkriptionsfunktion mit Unterstützung für mehrere Sprecher entwickeln möchten, Scribe v2 von ElevenLabs stellt Sprecherdiarisierung über eine einzelne Speech-to-Text-API bereit. Senden Sie Audio mit diarize=true an den Endpunkt. Die JSON-Antwort kennzeichnet jedes Wort mit einer Sprecher-ID – für bis zu 32 Sprecher, in über 90 Sprachen und für Dateien mit bis zu 10 Stunden Länge.
Zwei Optionen erweitern die Standardausgabe der Diarisierung. Für Anrufaufzeichnungen kennzeichnet detect_speaker_roles=true Sprecher als Agent und Kunde statt mit anonymen Nummern. Wenn Ihr Workspace registrierte Sprecherprofile enthält, kann use_speaker_library=true erkannte Sprecher mit registrierten Stimmen abgleichen und Diarisierung und Identifikation in einer Anfrage zusammenführen.
Ein Diarisierungsschwellenwertparameter ermöglicht Ihnen, den Kompromiss zwischen übermäßiger Aufteilung und Zusammenführung von Sprechern anzupassen. Und wenn Ihre Sprecher bereits auf separaten Audiokanälen isoliert sind, etwa in Stereo-Anrufaufzeichnungen, Mehrkanaltranskription ordnet Sprecher nach Kanal zu und überspringt die Diarisierung vollständig.
Der Speech-to-Text-Schnellstart führt Sie Schritt für Schritt durch die erste Integration. Für regulierte Bereitstellungen ist die Plattform SOC-2-, ISO-27001-, PCI-DSS-L1- und HIPAA-konform. EU-Datenresidenz und ein Modus ohne Datenspeicherung sind verfügbar.
Möchten Sie Sprecherdiarisierung in Ihre Systeme integrieren? Beginnen Sie mit Ihrem API-Schlüssel oder sehen Sie sich die ElevenLabs-Dokumentation an, um mehr zu erfahren.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


