Audio-Deepfake-Erkennung: Funktionsweise und Prüfung von ElevenLabs-Audio
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Audio-Deepfake-Erkennung ist die Analyse von Sprachaufnahmen, um festzustellen, ob Sprache authentisch ist. KI-Sprachsynthesizer, die Deepfakes erzeugen, werden immer zugänglicher. Daher ist es sowohl im öffentlichen Leben als auch in Unternehmen wichtig geworden, schnell zu erkennen, ob die gehörte Sprache echt ist oder von böswilligen Akteuren manipuliert wurde.
In diesem Artikel erläutern wir die Funktionsweise der Audio-Deepfake-Erkennung, verschiedene Erkennungsarten, ihre Stärken und Schwächen sowie die Integration der Deepfake-Erkennung in Systeme zur Betrugserkennung im großen Maßstab.
Zusammenfassung
- Deepfake-generierte Sprache lässt sich allein mit dem Gehör immer schwerer erkennen. Sie stellt sowohl im öffentlichen Leben als auch für Unternehmen ein erhebliches Risiko dar.
- Es gibt mehrere Arten von Software zur Deepfake-Erkennung. Herkömmliche Tools nutzen statistische Analysen, um die Wahrscheinlichkeit zu bewerten, dass eine Audioaufnahme KI-generiert ist.
- Neue Wasserzeichen-Technologie ermöglicht eine eindeutige Ja-oder-Nein-Antwort darauf, ob eine Sprachprobe synthetisiert wurde.
- Wasserzeichen sind sehr präzise, doch Detektoren funktionieren nur mit Audio des jeweiligen Anbieters. Der Audio Detector von ElevenLabs kann beispielsweise von den eigenen Produkten erzeugte Wasserzeichen mit hoher Genauigkeit erkennen, nicht jedoch die anderer Unternehmen.
- Wasserzeichen sind eine wichtige Ressource für Organisationen, die Deepfakes im großen Maßstab erkennen müssen. Sie sollten jedoch nur eines von vielen Tools im Deepfake-Erkennungsstack sein.
Was ist Audio-Deepfake-Erkennung?
Audio-Deepfake-Erkennung ist der Prozess, mit dem festgestellt wird, ob Sprachaufnahmen durch künstliche Intelligenz erzeugt oder manipuliert wurden.
Ein Deepfake ist jede Art von Medieninhalt – meist Bild, Video oder Audio –, die von einer generativen KI-Anwendung erstellt wird, um falsch darzustellen, was jemand sagt oder tut. Audio-Deepfakes haben viele böswillige Einsatzmöglichkeiten. Sie können für Betrug, Zugriffsversuche auf persönliche Konten, politische Propaganda oder zur heimlichen Imitation eines Ehepartners oder Familienmitglieds in familiären Streitfällen verwendet werden.
Aktuellen Trends zufolge sind die wahrscheinlichsten Opfer von Audio-Deepfake-Betrug:
- Politiker und andere Personen des öffentlichen Lebens: Personen, deren umfangreiche Stimmproben online für das Training verfügbar sind, könnten von Gegnern oder Dritten per Deepfake imitiert werden, um die Öffentlichkeit zu täuschen.
- Familienmitglieder: Böswillige Akteure könnten gefundene Sprachaufnahmen nutzen, um ältere Familienmitglieder mit Deepfake-generierten Geldforderungen zu betrügen.
- Führungskräfte: Gefälschte Interviews, Präsentationen und Ergebnis-Telefonkonferenzen können einer Unternehmensmarke schaden.
- Kundenservice-Teams: Betrüger könnten gesammelte Stimmproben nutzen, um Kundenservice-Teams zur Freigabe privater Kontozugänge zu verleiten.
Leider sind Menschen keine zuverlässigen Deepfake-Erkenner. Unter kontrollierten Forschungsbedingungen ist die Fähigkeit von Menschen, sie zu erkennen, nicht besser als Zufall, und diese Forschung stammt bereits aus dem Jahr 2024. Generative Medien sind seitdem deutlich ausgefeilter geworden.
Aufklärung und Gesetzgebung werden viel dazu beitragen, die Gesellschaft gegen den Einfluss von Deepfakes zu schützen. Dennoch sind zuverlässige Erkennungsmethoden weiterhin notwendig.
Wie funktioniert die Audio-Deepfake-Erkennung?
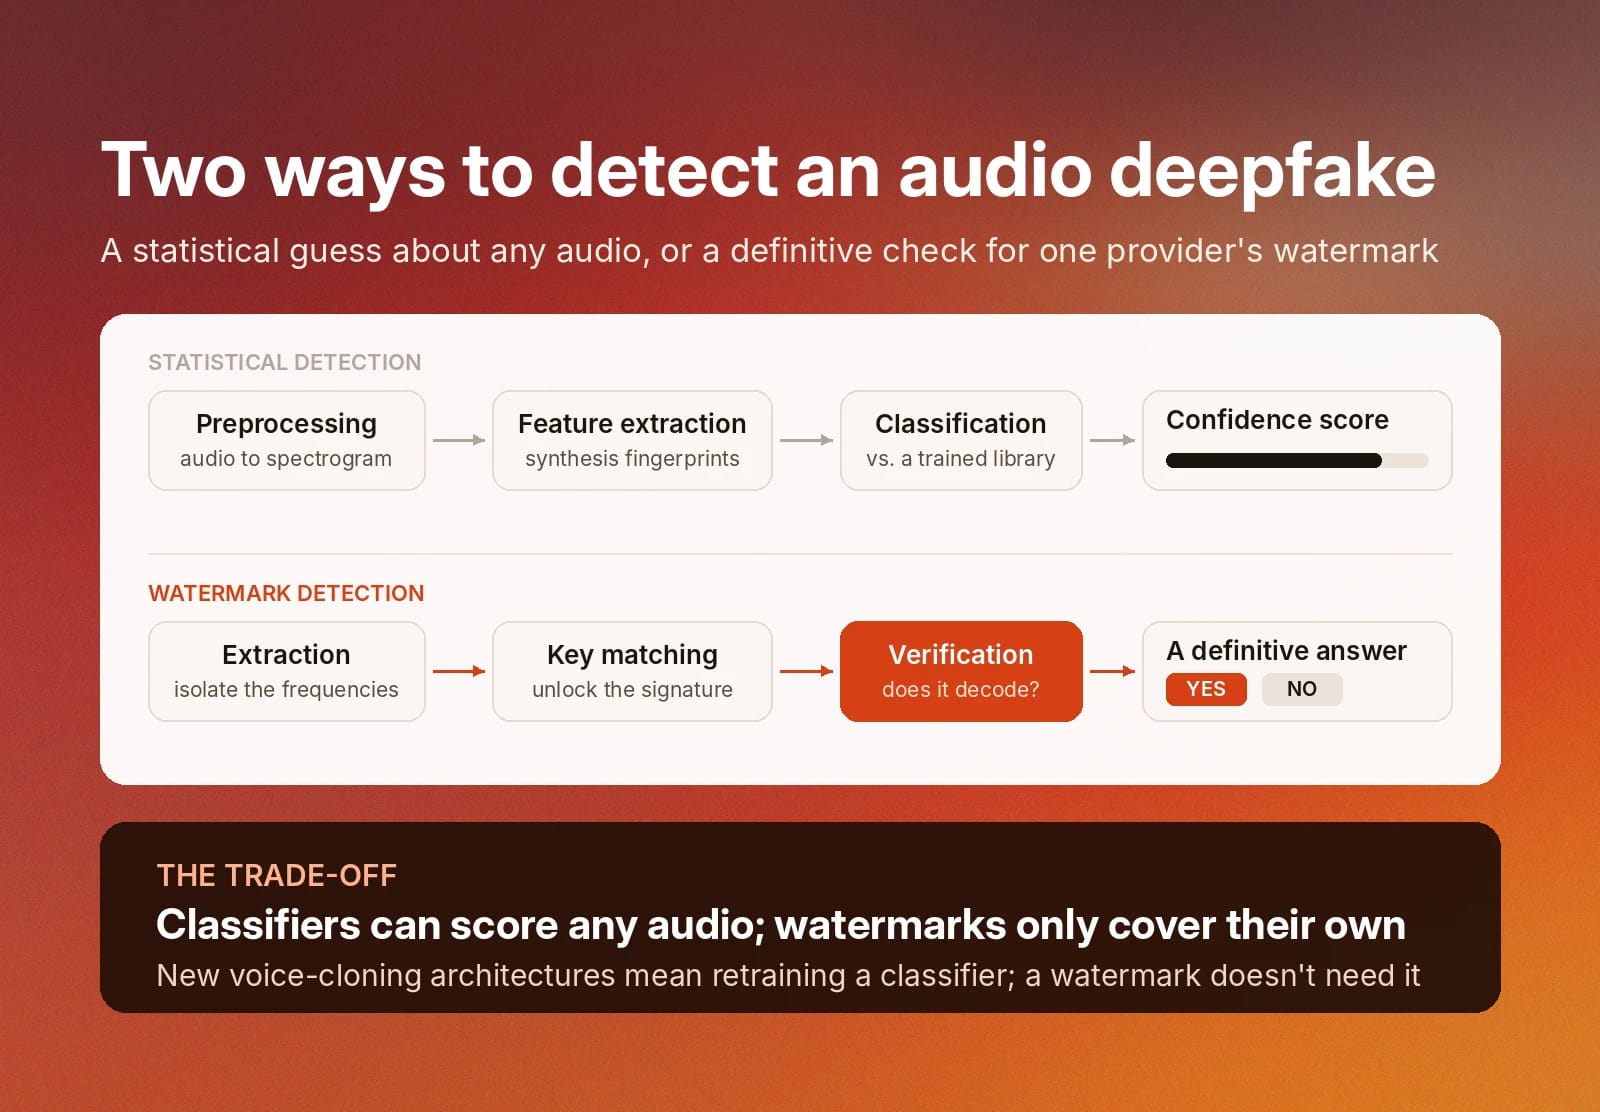
Herkömmliche Deepfake-Erkennung nutzt statistische Analysen, um die Wahrscheinlichkeit zu messen, dass Medien von einer KI generiert wurden. Ein Erkennungstool verwendet maschinelle Lernverfahren, um die zugrunde liegenden Muster verschiedener Arten synthetisierter Sprache zu erkennen.
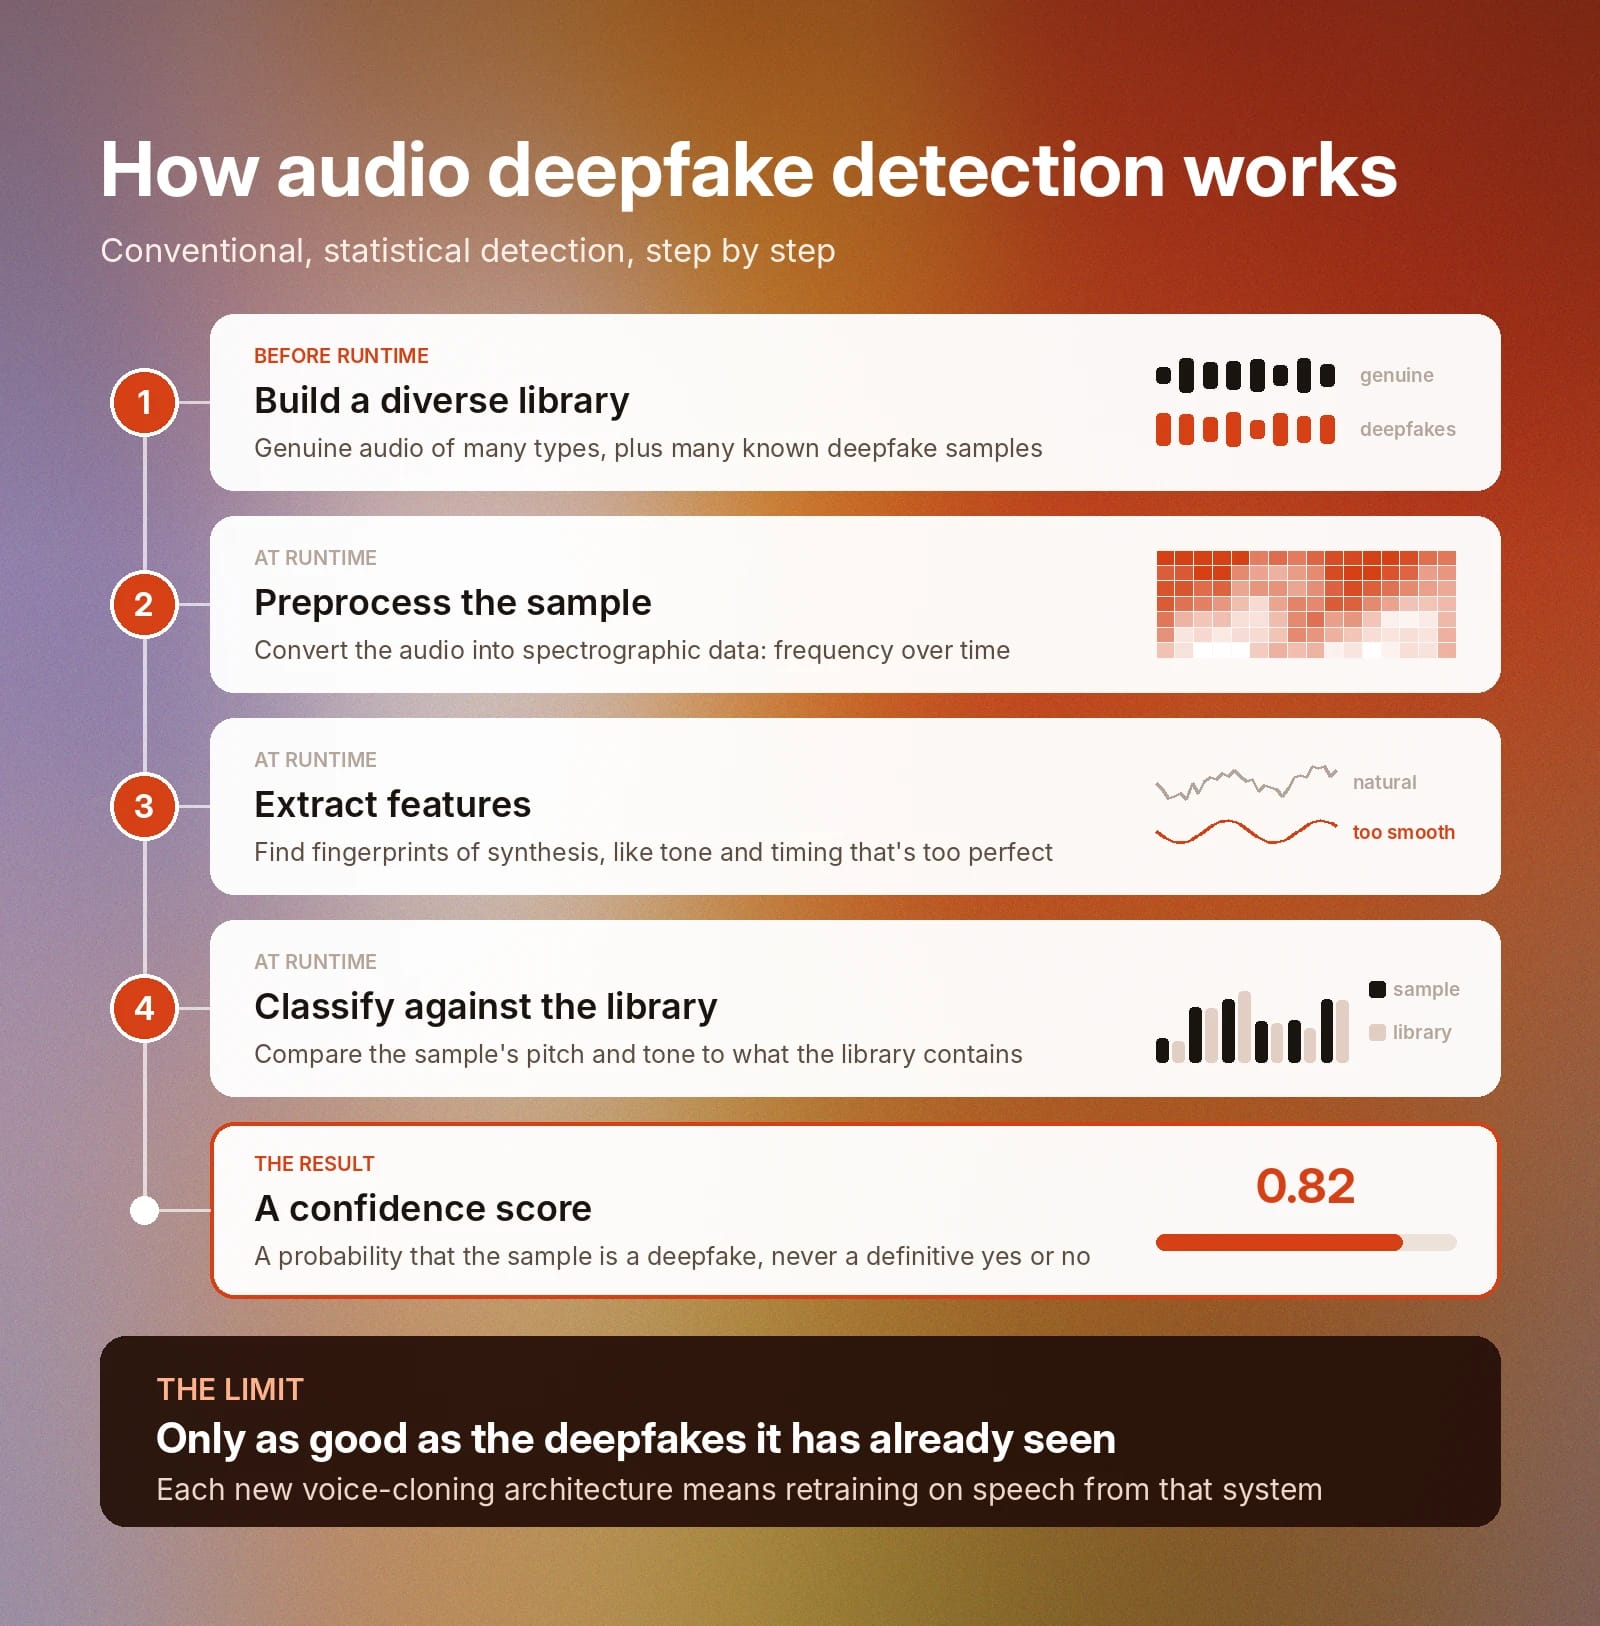
Der erste Schritt ist der Aufbau einer Audiobibliothek, mit der sich mutmaßliche Deepfakes vergleichen lassen. Sie sollte vielfältige Daten enthalten: echte Audioaufnahmen verschiedener Arten sowie zahlreiche bekannte Deepfake-Beispiele, um positive Erkennungen zu ermöglichen.
Zur Laufzeit folgt der Prozess drei Stufen: Vorverarbeitung, Merkmalsextraktion und Klassifizierung.
Audio-Vorverarbeitung
Wenn Sie einem trainierten Erkennungstool eine Audioaufnahme geben, wandelt es sie in spektrografische Daten um – eine mathematische Darstellung von Frequenzänderungen im Zeitverlauf.
Merkmalsextraktion
Anschließend extrahiert das Erkennungstool Merkmale aus den Probendaten, die wie Fingerabdrücke synthetisierter Sprache wirken. KI-Sprache ist beispielsweise manchmal zu perfekt und weist nicht die tonalen und zeitlichen Unregelmäßigkeiten natürlicher Sprache auf. Der Vergleich von Tonhöhe und Klangfarbe der Stimme mit der Bibliothek hilft dem Tool außerdem, weitere Warnsignale zu erkennen.
Klassifizierung
Da die herkömmliche Deepfake-Erkennung auf statistischen Analysen beruht, kann sie die Frage, ob eine Probe ein Deepfake ist, nicht eindeutig mit „Ja“ oder „Nein“ beantworten. Stattdessen erzeugt sie einen Konfidenzwert beziehungsweise eine Wahrscheinlichkeit dafür, dass die Probe ein Deepfake ist.
Da sie Ähnlichkeiten zwischen einer Probe und einer bestehenden Audiobibliothek misst, sind herkömmliche Tools durch die ihnen verfügbaren bekannten Deepfake-Beispiele begrenzt. Sobald jemand eine neue Architektur zum Klonen von Stimmen veröffentlicht, müssen Sie Ihr Erkennungstool mit Sprache trainieren, die in diesem neuen System synthetisiert wurde, um sie zuverlässig zu erkennen.
Was ist der Unterschied zwischen Wasserzeichen und statistischer Erkennung?
Wasserzeichen sind ein völlig anderer Ansatz zur Sprachklassifizierung. Ein Klassifikator für maschinelles Lernen schätzt anhand seines Trainingswissens über natürliche Sprache probabilistisch ein, ob eine Probe authentisch ist. Dazu gehören etwa das tatsächliche emotionale Gewicht und Betonungen in spektrografischen Daten sowie natürliche Arten tonaler und zeitlicher Veränderungen.
Wasserzeichen funktionieren deterministisch. Ein Wasserzeichen ist eine mathematische Signatur, die vom Synthesizer in Audiodaten eingebettet wird – in einem Bereich, den Menschen nicht hören können. Ein Wasserzeichen-Detektor prüft mit Ja oder Nein, ob er diese verborgene Signatur findet.
Ein Detektor arbeitet in drei einfachen Stufen:
- Extraktion: Das Tool extrahiert spektrografische Daten und isoliert die Frequenzen, in denen es ein Wasserzeichen erwartet.
- Schlüsselabgleich: Es versucht, die Signatur mit einem Schlüssel zu entschlüsseln.
- Verifizierung: Wenn das Signal korrekt dekodiert wird, bestätigt das Tool, dass der betreffende KI-Stimmen-Generator das Audio erzeugt hat.
Der Prozess zur Wasserzeichen-Erkennung von ElevenLabs
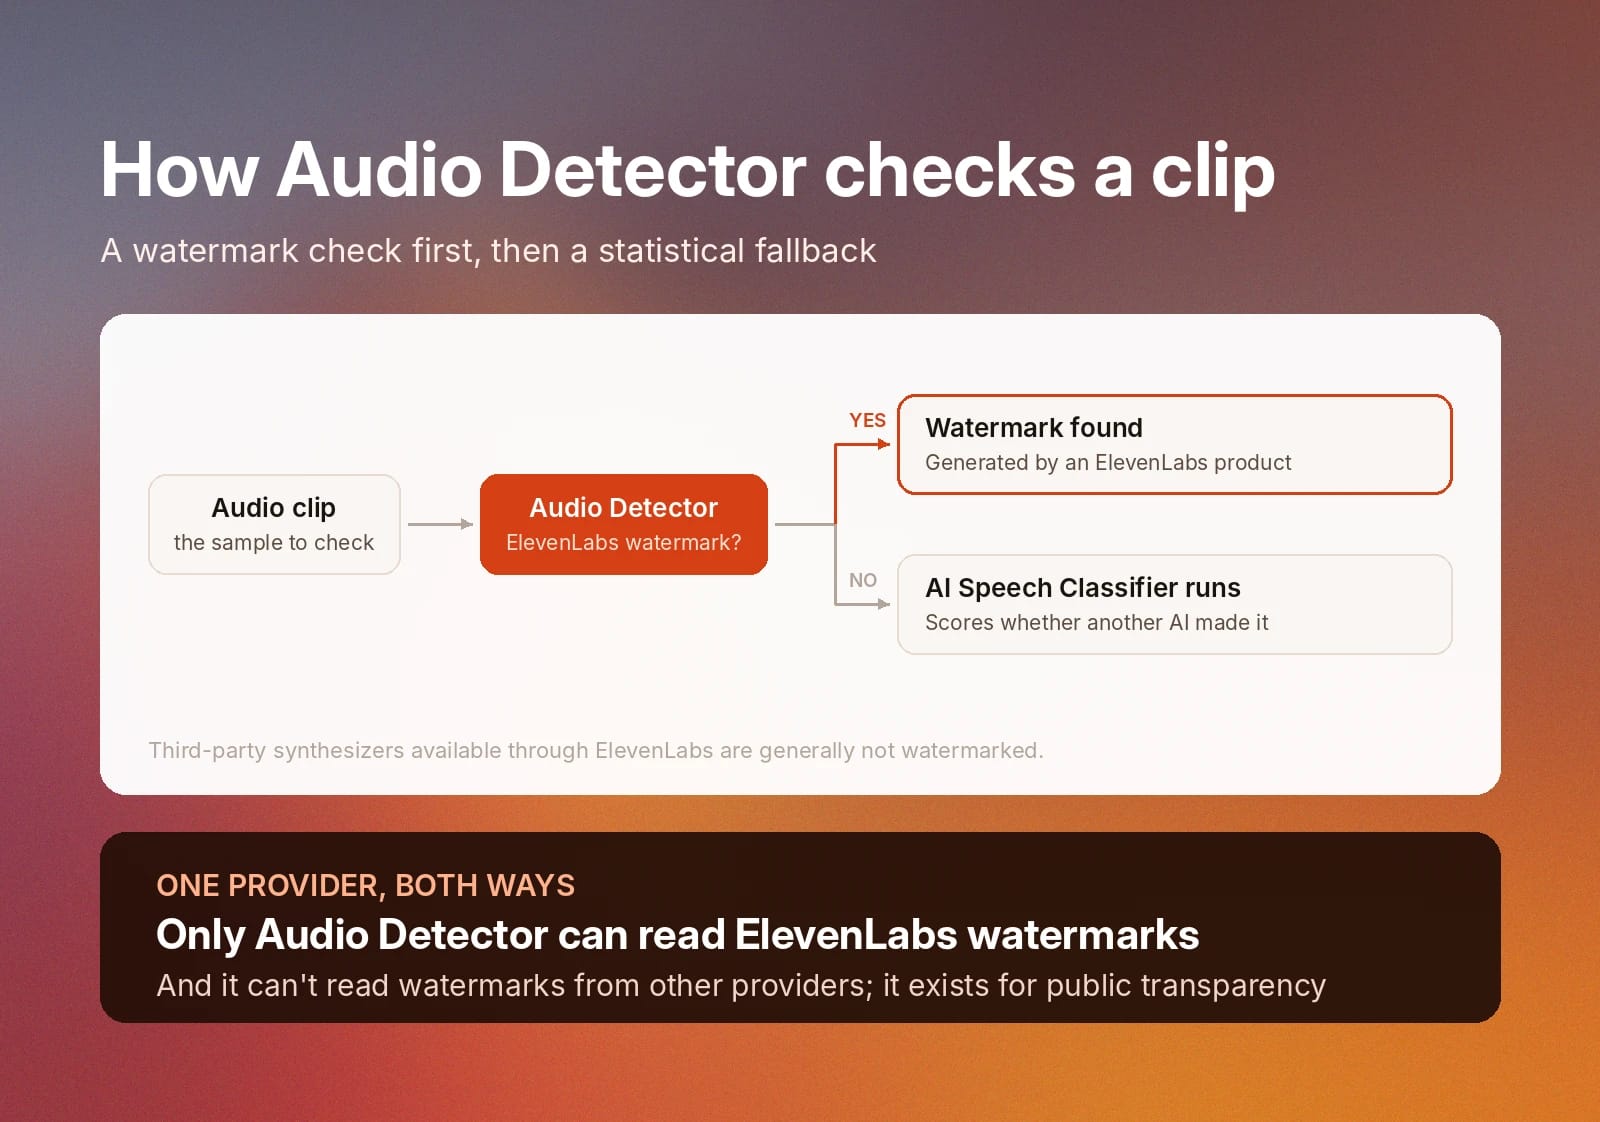
Das Wasserzeichen-Tool von ElevenLabs ist der Audio Detector. Er scannt Audioaufnahmen und prüft, ob die Inhalte von einem ElevenLabs-Produkt erzeugt wurden. Findet er kein Wasserzeichen, führt er anschließend den statistischen AI Speech Classifier aus, um zu bewerten, ob das Audio von einer anderen Quelle KI-generiert wurde.
Aufgrund der Funktionsweise von Wasserzeichen erkennt der ElevenLabs Audio Detector nur von ElevenLabs generiertes Audio. Wasserzeichen anderer KI-Stimmanbieter kann er derzeit nicht identifizieren.
Umgekehrt kann nur der Audio Detector von ElevenLabs Wasserzeichen von ElevenLabs erkennen.
Beachten Sie außerdem, dass Inhalte, die von über ElevenLabs verfügbaren Synthesizern von Drittanbietern erzeugt wurden, in der Regel kein Wasserzeichen enthalten.
Weitere Optionen zur Erkennung von mit ElevenLabs generiertem Audio
Der ElevenCreative AI Speech Classifier ist kostenlos und ohne Anmeldung verfügbar. Er analysiert die erste Minute einer Audioaufnahme und liefert einen Konfidenzwert dafür, wie wahrscheinlich das Audio von einem ElevenLabs-Modell erzeugt wurde.
Beachten Sie, dass er Eleven-v3-Audio nicht zuverlässig klassifizieren kann. Am effektivsten klassifiziert er Audio, das von älteren ElevenLabs-TTS-Modellen erzeugt wurde. Seine Genauigkeit sinkt auch bei stark komprimierten oder bearbeiteten Sprachinhalten.
Wie lassen sich synthetische Stimmen im großen Maßstab erkennen?
Einige Unternehmensteams müssen Deepfakes im großen Maßstab nahezu in Echtzeit erkennen können. Nehmen wir das Kundenservice-Team einer nationalen Bank. Dessen Mitarbeitende interagieren täglich mit Tausenden von Kunden. Teammitglieder müssen regelmäßig private Kontodaten teilen und aktualisieren.
Für die Leitung dieses Teams ist es äußerst wichtig, betrügerische Anrufer schnell zu erkennen und gleichzeitig legitimen Kunden zügig zu helfen. Sie benötigen einen Stack zur Stimmenerkennung, der Audio aller wichtigen Systeme zur Stimmgenerierung live während Kundengesprächen identifizieren kann.
Aufbau eines vollständigen Stacks zur Stimmenerkennung
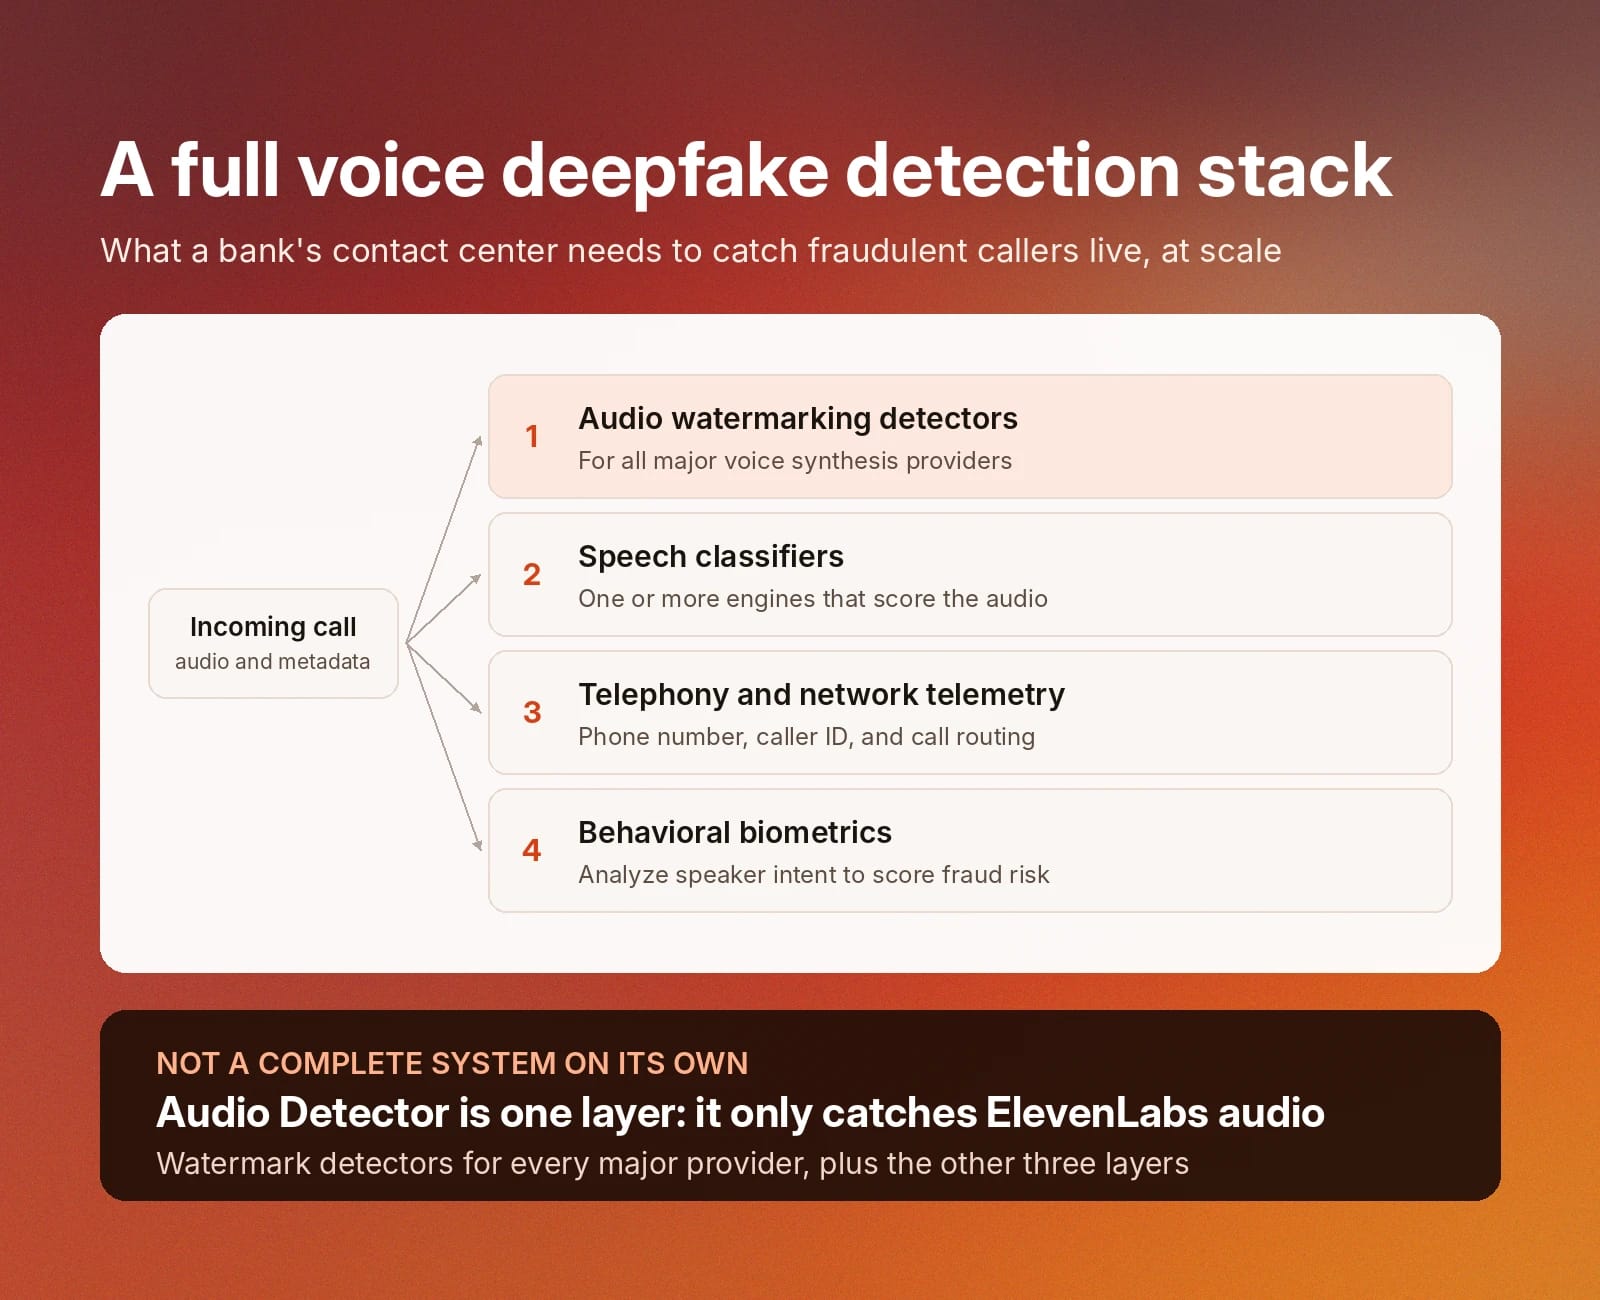
Der Audio Detector von ElevenLabs spielt dabei eine wichtige Rolle. Doch wichtig ist erneut: Er erkennt nur mit ElevenLabs-Wasserzeichen versehenes Audio. Allein ist er kein vollständiges System zur Stimmenerkennung. Organisationen, die umfassende Funktionen zur Stimmenerkennung benötigen, müssen mehrere Arten von Tools zusammenstellen:
- Audio-Wasserzeichen-Detektoren: Für alle wichtigen Anbieter von Sprachsynthese.
- Sprachklassifikatoren: Eine oder mehrere Klassifizierungs-Engines, die Audiodaten bewerten können.
- Telefonie- und Netzwerk-Telemetrie: Analysen von Anrufmetadaten wie Telefonnummer, Anrufer-ID und Anrufweiterleitung.
- Verhaltensbiometrie: Software zur Analyse der Absicht von Sprechern und zur Bewertung des Betrugsrisikos.
Starten Sie mit der Deepfake-Erkennung von ElevenLabs
ElevenLabs möchte einen positiven Beitrag zum öffentlichen Leben leisten – durch sinnvolle Dienste zur Stimmgenerierung und indem wir der Öffentlichkeit die Tools bereitstellen, die sie benötigt, um Deepfakes und andere böswillige Anwendungen KI-generierter Audiodaten zu erkennen.
Haben Sie einen Audioclip, den Sie auf Deepfakes prüfen möchten? Registrieren Sie sich, um den ElevenLabs Audio Detector zu testen, oder starten Sie noch heute mit dem AI Speech Classifier.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.