Wie Ihr Transkript erkennt, wo jedes Wort gesprochen wird
- Verfasst von
- Mike Murphy
- Veröffentlicht
AnhörenArtikel anhören
Wenn Sie schon einmal einen Film im Fernsehen gesehen haben, bei dem es eine Störung bei der Übertragung gab und die Dialoge der Schauspieler überhaupt nicht mit den Untertiteln synchron waren, wissen Sie, wie ablenkend das sein kann – und wie es einen aus der Geschichte reißt. Bei Videos und Software mit Stimmenmodellen gibt es dasselbe Problem: Ein Untertitel, der eine Sekunde zu spät erscheint, oder ein Transkript, das das falsche Wort hervorhebt, kann genauso fehlerhaft wirken.
„Menschen können Medien ziemlich gut abgleichen, zumindest auf Wortebene“, sagt Danila Kozlov, Forscher bei ElevenLabs im Bereich Alignment. „Wir haben oft ein intuitives Gefühl dafür, wo ein Wort beginnt. Auf Zeichenebene und mit einer Präzision im Submillisekundenbereich ist das jedoch viel schwieriger.“
Heute stellt ElevenLabs Cue genauer vor: ein Forced-Alignment-Modell, das jedes Zeichen in einer Audiodatei auf einer präzisen Zeitachse platziert. Cue unterstützt die Scribe-Modellfamilie von ElevenLabs und ist bei realen Aufnahmen genauer als alle von ElevenLabs getesteten Aligner – in allen 29 Benchmark-Sprachen. Es verarbeitet zudem Aufnahmen jeder Länge in einem einzigen Durchlauf und richtet eine Stunde Audio in weniger als einer Sekunde aus.
Was ist Forced Alignment?
Stellen Sie sich vor, jemand gibt Ihnen ein Video und ein Transkript und bittet Sie, jedes Wort dem Moment zuzuordnen, in dem es gesprochen wird. Das ist Forced Alignment. Wenn Sie in einem ElevenLabs-Transkript auf ein Wort klicken und der Player genau zu dieser Stelle springt, übernimmt ein Aligner diese Aufgabe.
Forced Alignment unterscheidet sich jedoch vom eher diffusen Konzept des KI-Alignments. Dabei geht es darum, KI-Systeme so zu entwickeln, dass ihr Verhalten den Wertesystemen und geschäftlichen Präferenzen von Menschen entspricht. Beim Forced Alignment geht es lediglich darum, Text und Ton aufeinander abzustimmen.
Cue ist der letzte Schritt in der Speech-to-Text-Pipeline. Scribe, das ElevenLabs-Speech to Text-Modell, transkribiert das Audio, und der Aligner legt die Zeitmarken fest. Jede Scribe-Anfrage durchläuft ihn. Dasselbe Modell unterstützt auch Untertitel, Synchronisation und die zeitliche Zuordnung von Liedtexten und ist separat über die Forced Alignment API verfügbar.
Da so viele Produkte davon abhängen, muss ein Aligner in jeder unterstützten Sprache präzise, extrem schnell und in der Lage sein, viele Anfragen gleichzeitig zu verarbeiten.
Wo herkömmliche Aligner an Grenzen stoßen
Vor dem neuen Modell entwickelte das Team das Aligner-Modell, das bis dahin in allen ElevenLabs-Produkten zum Einsatz kam. Es war leistungsstark, doch sie wussten, dass sich eine neue Version noch verbessern ließ. Als Kozlov zum Team stieß, befragten er und das Team zunächst Kunden und interne Nutzer bei ElevenLabs dazu, was sie bei der Arbeit mit dem bisherigen Aligner frustrierte. Ihre Beschwerden entsprachen den Grenzen der Open-Source-Tools, die das Team getestet hatte.
Die Länge ist das erste große Problem. Viele Aligner funktionieren heute gut bei Clips von etwa 30 Sekunden, längere Dateien müssen jedoch in Abschnitte zerlegt werden. Jeder neue Abschnitt kann einen kleinen Zeitfehler verursachen, und das Zusammenfügen der Abschnitte kann weitere Fehler hinzufügen. Bei vollständigen Aufnahmen beträgt Cues durchschnittlicher Zeitfehler nur 179 Millisekunden, während die Open-Source-Tools zwischen 283 ms und mehr als 6.000 ms lagen.
Audioaufnahmen aus der Praxis sind noch anspruchsvoller. Hintergrundgeräusche, überlappende Sprache und Hintergrundmusik führen dazu, dass viele Tools beim Abgleich von Text und Audio ihre Position verlieren. Doch genau solche Dateien möchten viele Menschen transkribieren lassen, denn wir leben selten an vollkommen ruhigen Orten. Bei englischen Aufnahmen mit Hintergrundstörungen beträgt Cues durchschnittlicher Fehler 57 ms, gegenüber 65 ms bis 920 ms bei den anderen Tools.
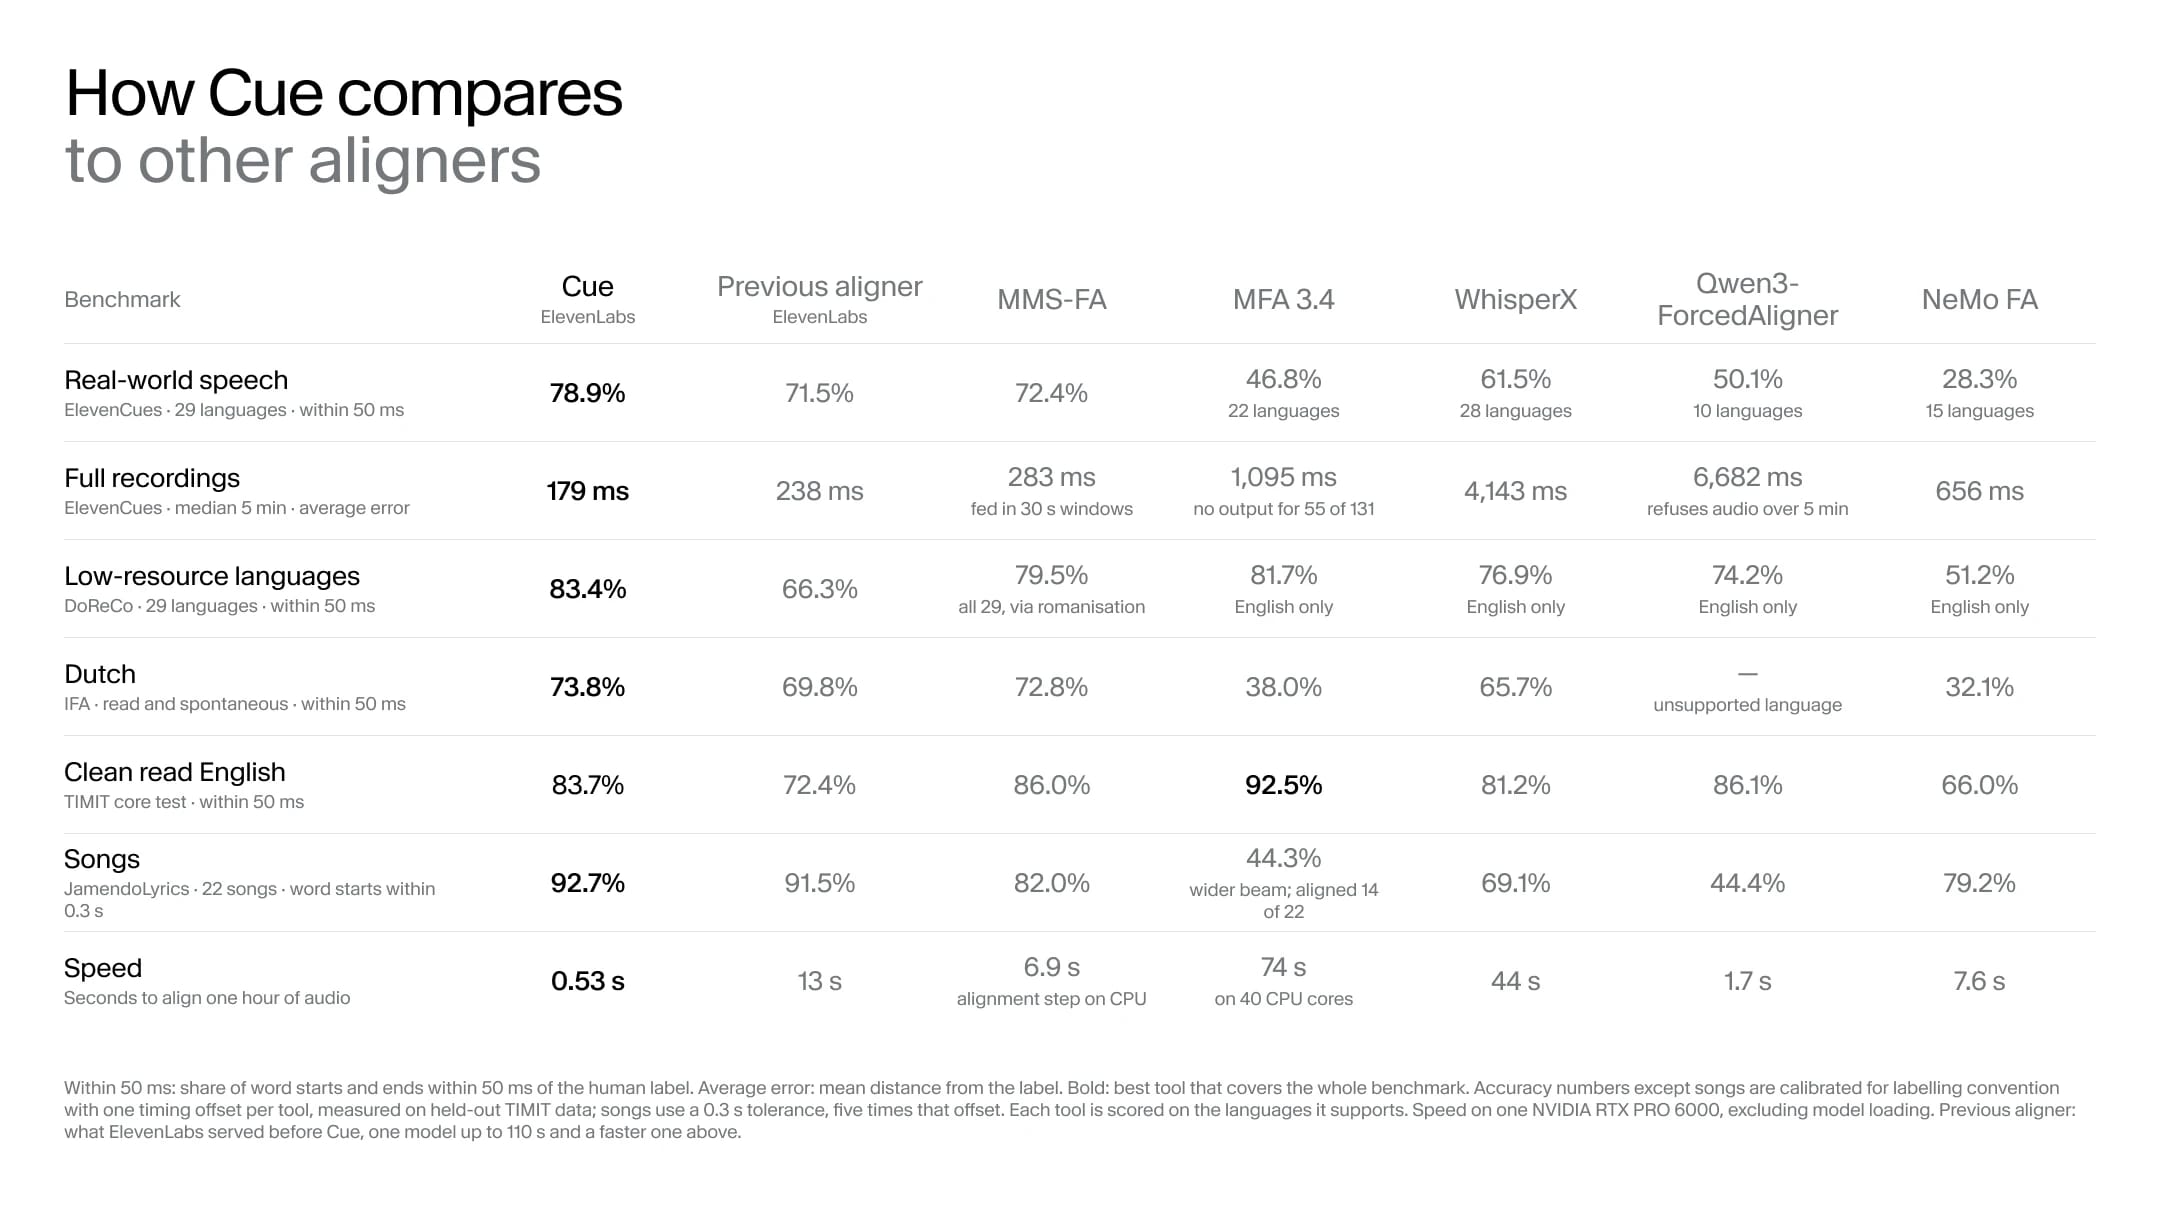
Auch die Sprachunterstützung ist eine Einschränkung. Die meisten Open-Source-Aligner benötigen für jede unterstützte Sprache ein separates Modell. Sprachen mit weniger Trainingsdaten schneiden daher oft schlechter ab oder werden gar nicht unterstützt. MMS-FA ist das einzige andere Tool, das alle 29 Benchmark-Sprachen unterstützt. Im Vergleich war Cue bei der Bestimmung der Wortgrenzen meist schneller.
Auch die Geschwindigkeit ist bei diesen Modellen ein Problem, da der Abgleich großer Audiomengen schnell teuer werden kann. Cue kann eine Stunde Audio auf unserer Produktions-GPU in etwa einer halben Sekunde ausrichten. Das zweitschnellste Tool, Qwen3-ForcedAligner, benötigt fast 2 Sekunden, das langsamste getestete Tool weit über eine Minute.
Was Cue anders macht
Im Gegensatz zu den meisten Wettbewerbern ist Cue ein einzelnes Modell, das mehr als 90 Benchmark-Sprachen abdeckt. Es kann zudem Aufnahmen jeder Länge in einem einzigen Durchlauf verarbeiten. Dadurch entfällt die Segmentierung, durch die sich Zeitfehler bei langen Dateien summieren.
Zum Zoomen ziehen Sie zwei Finger zusammen oder verwenden Sie Strg + Scrollen. Wischen Sie horizontal oder verwenden Sie Umschalt + Scrollen, um zu verschieben. Wenn ein Wort ausgewählt ist, zoomen Sie mit Plus und Minus oder verschieben Sie mit Umschalt und der linken oder rechten Pfeiltaste.
Wählen Sie ein Wort aus, um seine Zeichen zu sehen
Während die meisten Modelle mit steigender Leistungsfähigkeit größer geworden sind, ist Cue kleiner als der vorherige Aligner von ElevenLabs, so Kozlov. Es läuft weiterhin auf einer GPU, richtet aber eine Stunde Audio in etwa einer halben Sekunde aus.
Das Team entwickelte Cue für die Arten von Audio, die Menschen tatsächlich hochladen. Mit dem bisherigen Aligner als Grundlage erstellten sie aus realen Anfragen einen Benchmark und bewerteten jedes Tool auf dieselbe Weise: Jedes Wort, das ein Tool nicht platzieren konnte, zählte als Fehler. Cue arbeitet auf Zeichenebene, die feiner ist als die Wortebenen-Labels der meisten Benchmarks. Diese Werte unterschätzen seine Präzision daher vermutlich.
„Ab einem bestimmten Punkt erreicht man das Niveau menschlicher Fähigkeiten“, sagt Kozlov über Aligner-Modelle. „Unser aktueller Aligner übertrifft dieses Niveau. Daher ist es viel schwieriger zu prüfen, ob man vollständig korrekt liegt oder wie präzise man genau ist, weil es dafür keinen Goldstandard-Benchmark gibt. Wir mussten Wortebenen-Benchmarks nutzen, um ein System auf Zeichenebene zu bewerten. Das zeigt Cues volles Potenzial nicht unbedingt.“
Cues Qualität zeigt auch, wie schnell ElevenLabs auf Nutzerfeedback reagieren kann. Kurz nach der Einführung von Cue wies ein Kunde das Team darauf hin, dass Georgisch und einige weitere ressourcenärmere Sprachen schlechter abschnitten als erwartet. ElevenLabs hält die Forschung nah an den Teams und Kunden, die seine Produkte nutzen. So konnte das Team das Problem schnell erkennen, mögliche Modellverbesserungen untersuchen, eine neue Modellversion trainieren und veröffentlichen – und das alles innerhalb von weniger als 24 Stunden, nachdem der Kunde das Problem erstmals gemeldet hatte.
Lieder ausrichten
Musik ist schwierig, weil Gesang Wörter dehnt und verwischt, und nur wenige Modelle damit gut umgehen können. Das Team hatte nicht erwartet, dass Cue dies so gut bewältigt. Cue konnte eine Auswahl von Liedern aus dem unter Creative-Commons-Lizenz stehenden Datensatz JamendoLyrics MultiLang ausrichten. Das gelang in Englisch, Französisch, Spanisch und Deutsch – in einem Durchlauf – mit überraschender Genauigkeit. Cue platzierte 92,7 % der Wörter innerhalb von 0,3 Sekunden zum Label, verglichen mit 82,0 % beim nächstbesten Tool.
Cues durchschnittlicher Fehler beim Startzeitpunkt betrug 0,82 Sekunden, etwa halb so viel wie beim nächstbesten Wettbewerber. Bei mindestens 19 der 22 Lieder war es genauer als jedes andere Tool. Das Potenzial, Ihre neuen Lieblingslieder am Tag ihrer Veröffentlichung beim Karaoke zu singen, ist groß.
Cue heute testen
Cue steckt bereits hinter jeder Speech-to-Text-Transkription bei ElevenLabs. Um es direkt zu nutzen, testen Sie die Forced Alignment API.
Danksagungen
Die Arbeit an den Aligner-Modellen von ElevenLabs wäre ohne viele Menschen im gesamten Unternehmen nicht möglich gewesen. Das Team möchte allen danken, die an der vorherigen und der neuen Version des Modells gearbeitet haben, darunter Mitgründer und CTO Piotr Dąbkowski, die Forscher Danila Kozlov, Luca Lanzendörfer, Flavio Schneider, Max Levi, Tim von Känel und Angelos Perivolaropoulos sowie Ani Janelidze aus Data Operations, unsere Teams für Forward Deployed Engineering und Support und Lorenzo Dossi für seine Arbeit an der Visualisierung in diesem Blog.
Mike Murphy ist leitender Redakteur und Autor für den ElevenLabs-Blog. Dort macht er aus komplexer Forschung und Technologie klare, überzeugende Geschichten. Bevor er zu ElevenLabs kam, arbeitete er mehrere Jahre als Technologiejournalist, unter anderem bei Quartz, und leitete die Inhalte bei IBM Research. Er hat einen Masterabschluss in Journalismus von der Northwestern University.