So transkribieren Sie ein Interview: Präzise Transkripte mit Sprecherkennzeichnung
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Ein Interview manuell zu transkribieren, dauert Stunden. Wenn eine Artikelfrist naht oder Sie an einer zeitkritischen Forschungsstudie arbeiten, haben Sie diese zusätzliche Zeit möglicherweise nicht. KI-gestützte Speech-to-Text-Tools transkribieren Interviews in Minuten und schaffen Zeit für Bearbeitung und Analyse.
In diesem Leitfaden erfahren Sie, wie Sie ein Interview mit KI präzise transkribieren. Außerdem betrachten wir Tools, Stile und Formatierungen, mit denen Sie jedes Audiointerview in ein nutzbares schriftliches Transkript verwandeln.
Zusammenfassung
- Interviewtranskripte müssen für Journalismus oder akademische Forschung oft strenge Genauigkeitsstandards erfüllen.
- Die Transkription im wortgetreuen Modus erfasst alles Gesagte im Interview, einschließlich Wiederholungen und Füllwörtern.
- Um Fehler bei der Sprecherkennzeichnung zu vermeiden, nutzen Sie die Mehrkanaltranskription mit einem eigenen Mikrofon für jede sprechende Person. Diese Funktion transkribiert die Audiospur jeder Person separat, sodass sie auch bei gleichzeitigem Sprechen korrekt gekennzeichnet werden.
- Audioereignisse wie Lachen, Seufzen oder Klatschen liefern Kontext für eine Interviewaufnahme. ElevenCreative STT kennzeichnet sie standardmäßig, doch Sie können die Einstellung „Audioereignisse kennzeichnen“ deaktivieren, wenn Sie sie nicht benötigen.
- Enthält Ihr Interview Namen von Personen oder Unternehmen oder Fachjargon, nutzen Sie Keyterm-Prompting, um die Schreibweise vor Beginn der Transkription zu klären.
Was die Interviewtranskription von Transkripten für Meetings oder Anrufe unterscheidet
Wer Interviews für Journalismus oder akademische Forschung führt, muss direkte Zitate aus den Transkripten übernehmen. Bei Interviews von einer Stunde oder länger ist die manuelle Transkription nicht praktikabel – besonders, wenn hohe Genauigkeit erforderlich ist.
Diese Zitate erscheinen in veröffentlichten Artikeln, Berichten und Quellenangaben. Das Transkript muss alles Gesagte erfassen, ohne Wörter zu verändern oder etwas wegzulassen.
Bei Geschäftsmeetings ist das anders. Sie sind meist kürzer, und die meisten Teams benötigen nur die wichtigsten Punkte. Viele nutzen Tools, die Meetings zusammenfassen, statt sie Wort für Wort aufzuzeichnen.
Bei der Wahl einer Software für Interviewtranskription sollte Genauigkeit an erster Stelle stehen, aber nicht der einzige Punkt auf Ihrer Checkliste sein. Diese Funktionen sind besonders wichtig.
Wortgetreu oder bereinigt: Der passende Transkriptstil
Für die Transkription Ihrer Interviews stehen zwei Stile zur Auswahl: wortgetreu oder bereinigt.
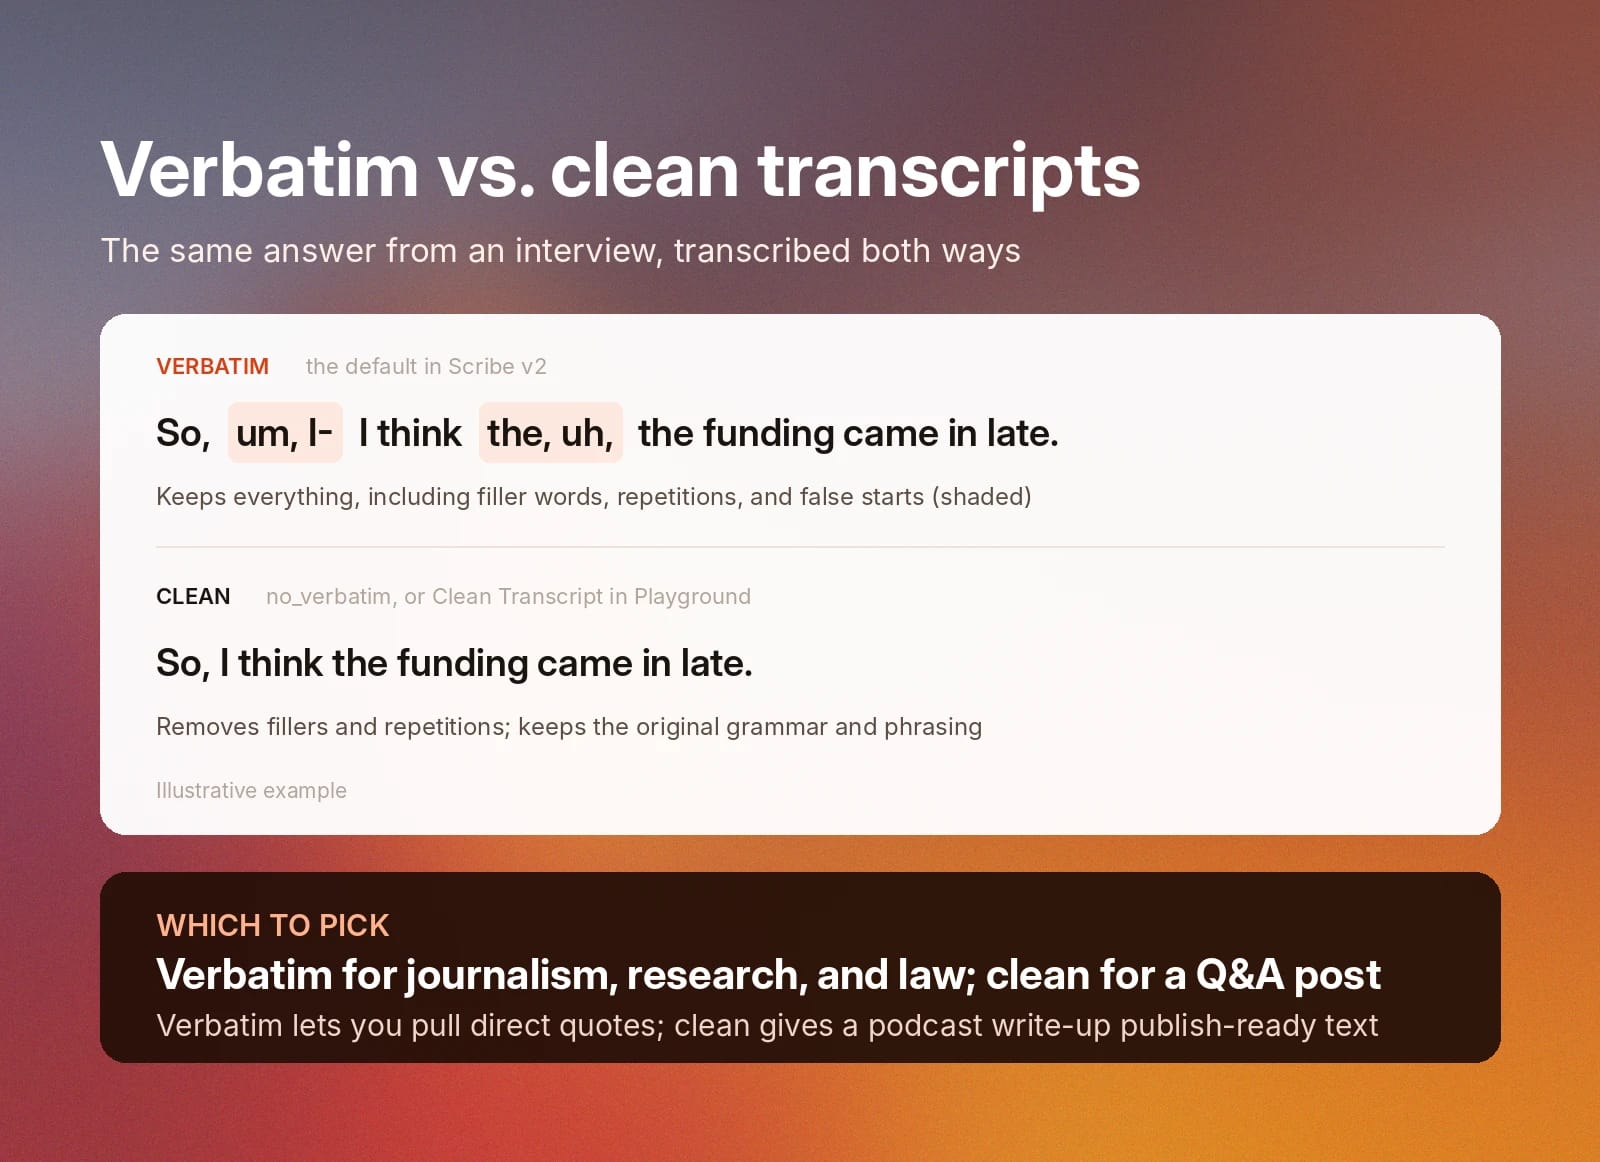
Ein wortgetreues Transkript erfasst jedes Wort und jeden Ausdruck aus Ihrem Gespräch, ohne etwas zu ändern oder zu entfernen. Dazu zählen Wiederholungen, abgebrochene Sätze und Füllwörter wie „ähm“ oder „äh“.
Ein bereinigtes Transkript entfernt Füllwörter und Wiederholungen, behält jedoch die ursprüngliche Grammatik und Formulierung bei. Bereinigte Transkripte verbessern die Lesbarkeit und bewahren zugleich die ursprüngliche Aussage des Gesprächs.
Für die meisten Interviews eignen sich wortgetreue Transkripte am besten. Da sie das gesamte Gespräch bewahren, erfüllen sie die strengen Genauigkeitsstandards für Journalismus, akademische Forschung oder Rechtswesen.
In manchen Situationen eignet sich für Interviews jedoch eine bereinigte Transkription. Angenommen, Sie haben ein Interview für Ihren Podcast geführt und möchten daraus einen Q&A-Blogbeitrag für Ihre Website machen. In diesem Fall liefert die bereinigte Transkription veröffentlichungsfertige Ergebnisse.
ElevenCreative Speech to Text unterstützt sowohl wortgetreue als auch bereinigte Transkription im ElevenLabs Playground und in ElevenAPI mit dem Modell Scribe v2. Wortgetreue Transkripte sind der Standard. Sie können jedoch bereinigte Transkripte erstellen, indem Sie im Einstellungsbereich des Playgrounds „Clean Transcript/No Verbatim“ aktivieren oder in ElevenAPI den Parameter no_verbatim einschalten.
Sprecherkennzeichnungen richtig setzen
Bei der Interviewtranskription zeigen Sprecherkennzeichnungen, wer was gesagt hat. Eine falsche Kennzeichnung kann dazu führen, dass ein Zitat der falschen Person zugeschrieben wird. Daher ist es wichtig, sie korrekt zu setzen.
KI-Speech-to-Text-Tools bieten zwei Methoden zur Kennzeichnung von Sprechenden. Welche Methode Sie nutzen, hängt davon ab, wie Sie Ihre Interviews aufnehmen.
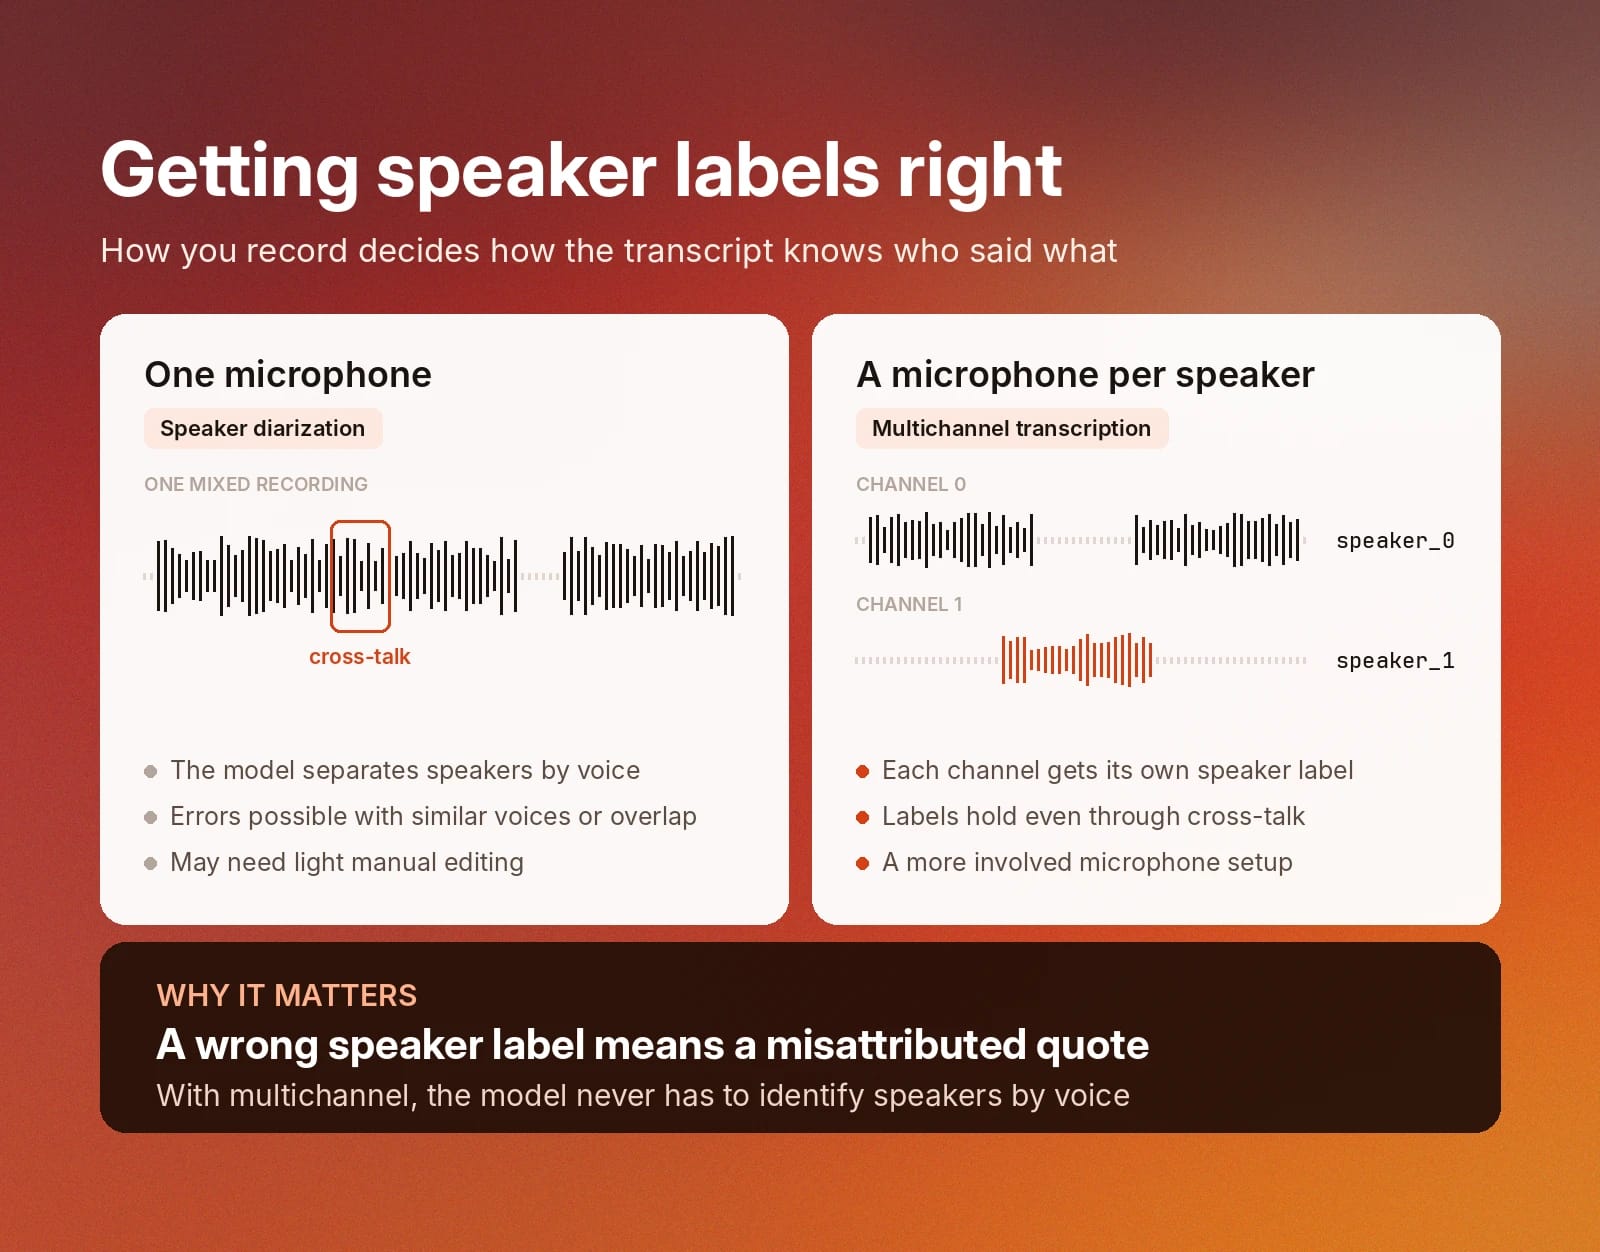
Wenn Sie beide Sprechenden mit einem einzigen Mikrofon aufnehmen, nutzt das Transkriptionsmodell die integrierte Sprecherdiarisierung, um sie automatisch zu identifizieren, zu trennen und zu kennzeichnen. Modelle mit Diarisierung können Fehler machen, besonders wenn Stimmen ähnlich klingen oder Personen gleichzeitig sprechen.
Wenn jede sprechende Person ein eigenes Mikrofon hat, können Sie Mehrkanaltranskription nutzen, um präzise Sprecherkennzeichnungen sicherzustellen. Bei dieser Transkriptionsmethode erhält jeder Audiokanal im Transkript eine eigene Sprecherkennzeichnung.
Die Mehrkanaltranskription erfordert ein komplexeres Mikrofon-Setup als eine gemeinsame Aufnahme für beide Sprechenden. Sie liefert jedoch klarere und genauere Sprecherkennzeichnungen. Da jede Person einen vorkonfigurierten Kanal hat, muss das Transkriptionsmodell Sprechende nicht anhand ihrer Stimme identifizieren.
Gleichzeitiges Sprechen und Unterbrechungen verarbeiten
Die Sprecherkennzeichnung ist nicht immer einfach. Es ist normal, dass sich Personen in einem Gespräch überschneiden oder gegenseitig unterbrechen.
Wenn Sie ein Interview für Journalismus oder akademische Forschung transkribieren, ist es entscheidend, gleichzeitiges Sprechen und Unterbrechungen präzise zu kennzeichnen. So wird jedes Zitat der richtigen Person zugeschrieben.
Verwenden Sie nach Möglichkeit für jede sprechende Person ein separates Mikrofon und transkribieren Sie im Mehrkanalmodus. In diesem Modus wird jede Person separat aufgenommen und transkribiert. Das verhindert Kennzeichnungsfehler, selbst wenn Personen gleichzeitig sprechen.
Wenn Sie für Ihr Interview ein einzelnes Mikrofon verwenden, nutzt das Transkriptionsmodell automatisch Sprecherdiarisierung, um zu kennzeichnen, wer wann spricht. Bei diesem Ansatz können Kennzeichnungsfehler auftreten, besonders wenn Personen gleichzeitig sprechen. Für die Genauigkeit kann eine leichte manuelle Nachbearbeitung des Transkripts nötig sein.
Tonfall bei der Interviewtranskription erfassen
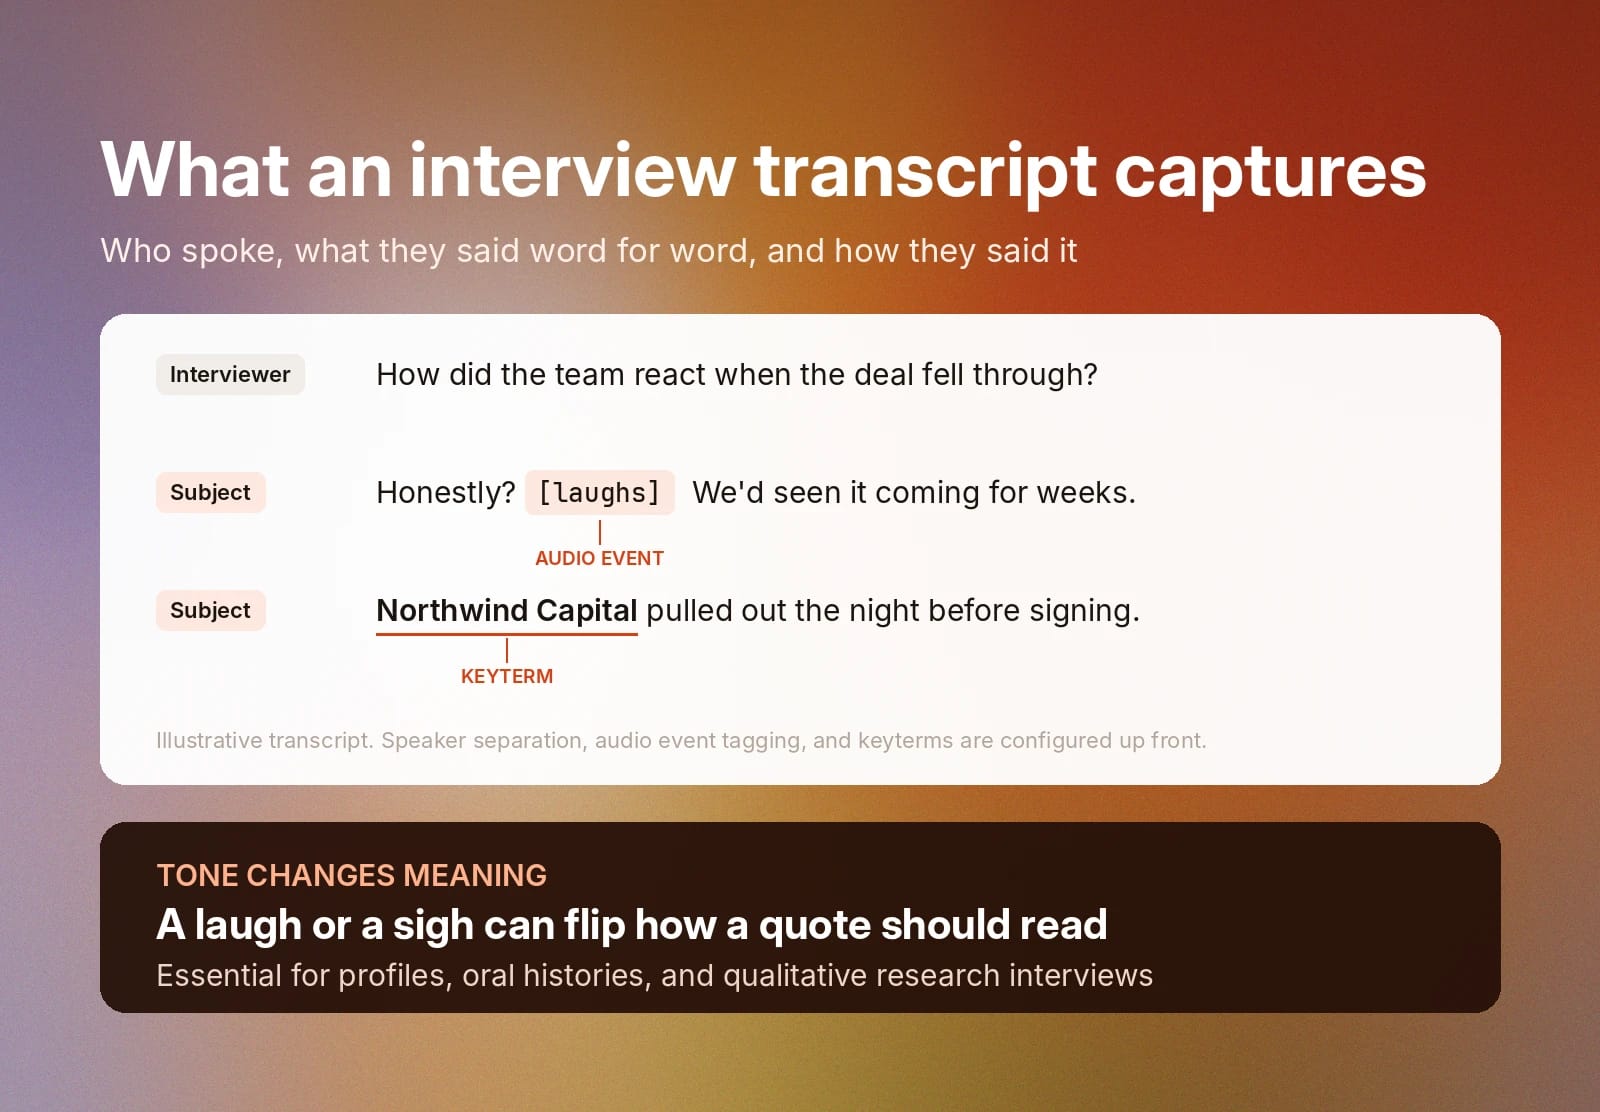
Der Tonfall einer Person kann die Bedeutung ihrer Aussage vollständig verändern. Stellen Sie daher sicher, dass diese Nuancen in Ihren Interviewtranskripten erhalten bleiben. Passen Sie dazu die Einstellungen Ihres Transkriptionstools an, damit es Lachen, Flüstern, Seufzen und andere nichtsprachliche Ereignisse erfasst.
Bei ElevenLabs verwenden Sie dafür den Parameter tag_audio_events. Diese Einstellung ist bei der Speech-to-Text-Umwandlung mit ElevenCreative und bei der Nutzung von ElevenAPI automatisch aktiviert.
Wenn Sie diese Ereignisse nicht in Ihrem Interviewtranskript erfassen möchten, deaktivieren Sie beim Erstellen eines Transkripts im Playground einfach „Audioereignisse kennzeichnen“. Verwenden Sie in ElevenAPI tag_audio_events="false", um diese Einstellung zu deaktivieren.
Die Kennzeichnung nichtsprachlicher Ereignisse ist besonders wichtig, wenn Sie eine Person für ein Porträt oder eine Oral History interviewen, da sie die vollständige Absicht und Ausdrucksweise der Person erfasst. Auch bei qualitativen Forschungsinterviews ist sie hilfreich, da nichtsprachliche Ereignisse die Endergebnisse beeinflussen können.
Namen und Begriffe richtig erfassen
Viele Interviews enthalten Namen und Fachjargon, die Transkriptionsmodelle allein nicht erkennen würden.
Mit Keyterm-Prompting können Sie Namen, Wörter oder Ausdrücke vor Beginn der Transkription klarstellen. So wird verhindert, dass das Transkriptionsmodell sie falsch schreibt oder mit anderen, geläufigeren Wörtern verwechselt.
ElevenLabs Scribe v2 unterstützt bis zu 1.000 Keyterms pro Transkript, während ElevenLabs Scribe v2 Realtime 50 Keyterms pro Transkript unterstützt.
Zwei Wege zur Transkription: No-Code-Upload oder API
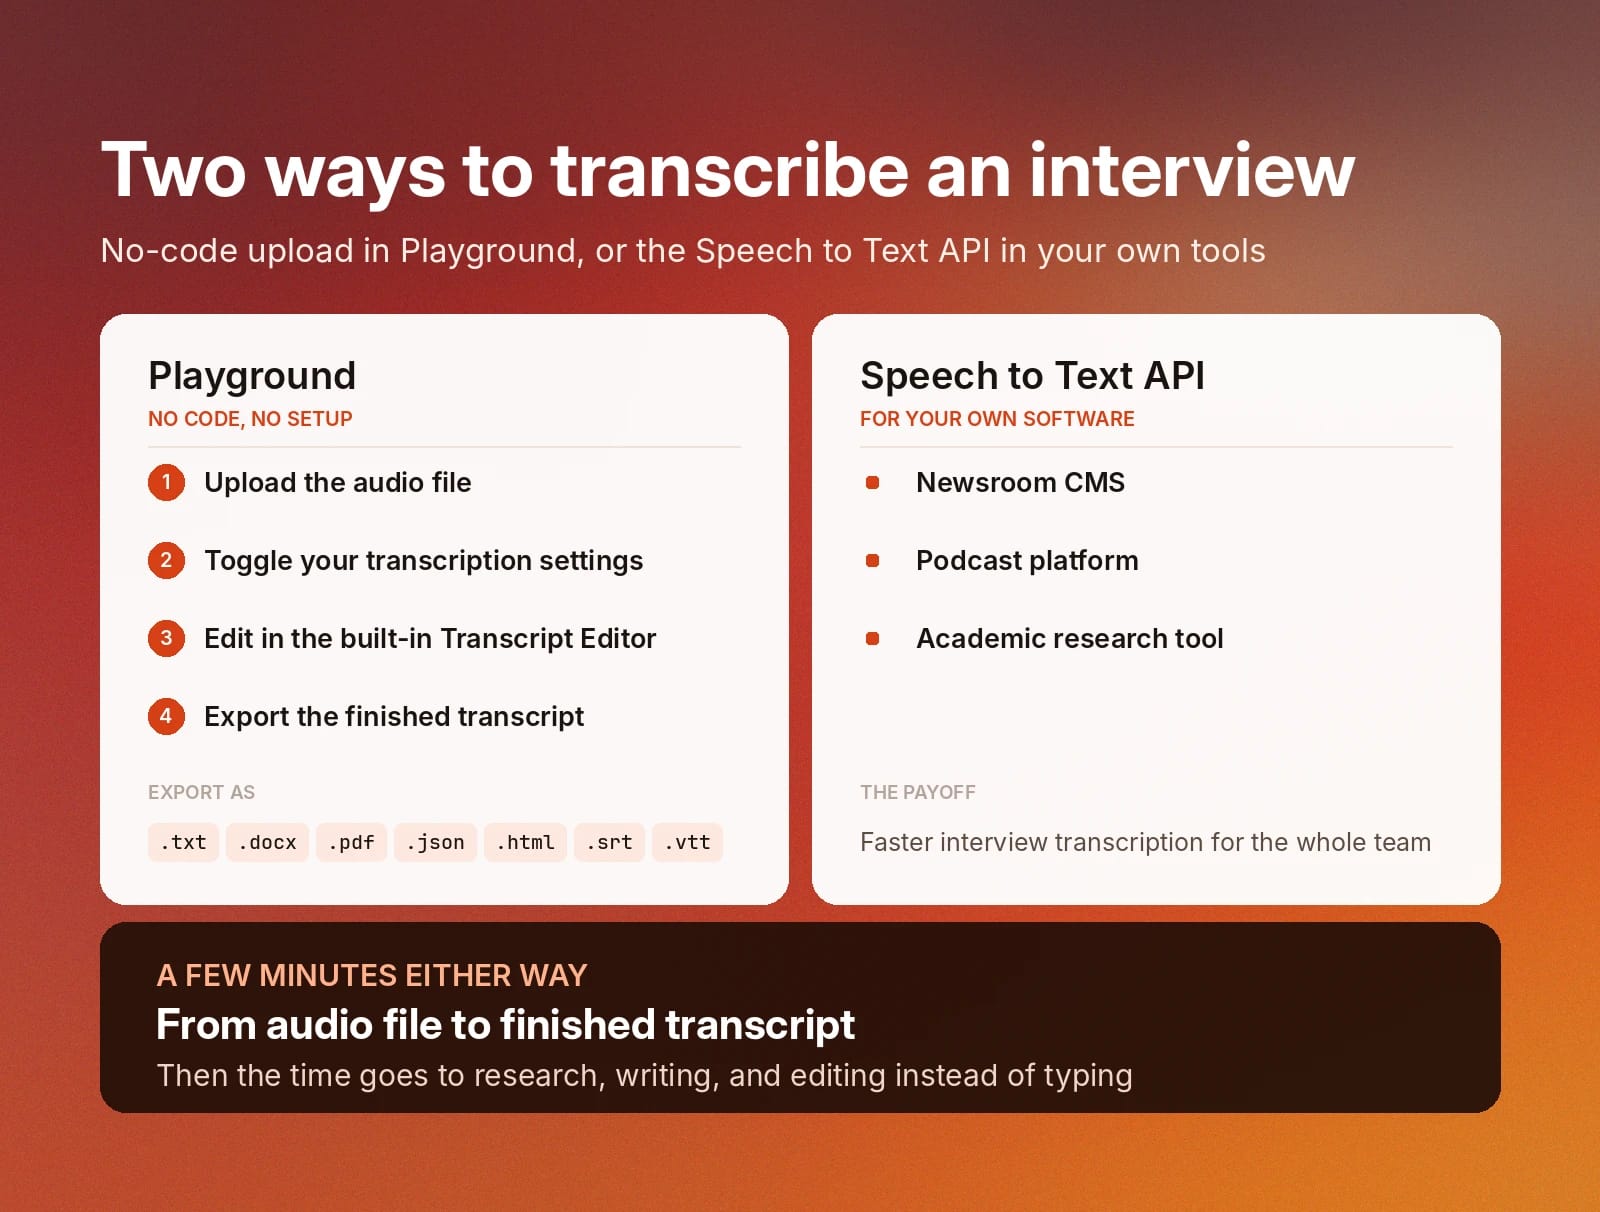
ElevenLabs bietet zwei Speech-to-Text-Methoden für die Transkription von Interviews. ElevenLabs Playground ist ein No-Code-Tool, während ElevenLabs Speech to Text API Transkriptionsfunktionen direkt in die digitalen Tools integriert, die Sie entwickeln.
Ein Interview mit ElevenLabs Playground zu transkribieren, dauert nur wenige Minuten und erfordert keine Einrichtung. Laden Sie die Audiodatei direkt ins Dashboard hoch und aktivieren Sie anschließend die gewünschten Transkriptionseinstellungen.
Vor Beginn der Transkription können Sie die Kennzeichnung nichtsprachlicher Ereignisse, den wortgetreuen Modus und den Mehrkanalmodus nach Ihren Wünschen anpassen. Außerdem können Sie relevante Keyterms hinzufügen.
Sobald das Transkript fertig ist, können Sie es direkt im integrierten Transcript Editor bearbeiten. Sie können das Transkript auch in verschiedene Dateiformate exportieren, darunter .txt, .docx, .pdf, .json, .html, .srt und .vtt.
Wenn Sie eigene Software entwickeln und Funktionen zur Interviewtranskription hinzufügen möchten, können Sie die ElevenLabs Speech to Text API nutzen. Indem Sie diese Funktion in Ihr CMS für Redaktionen, Ihre Podcast-Plattform oder Ihr Tool für akademische Forschung integrieren, beschleunigen Sie die Interviewtranskription für Ihr gesamtes Team.
Transkribieren Sie Ihre Interviews mit ElevenCreative
Bei der Transkription von Interviews ist Genauigkeit entscheidend. Funktionen wie wortgetreue Transkription, Mehrkanaltranskription, Kennzeichnung von Audioereignissen und Keyterm-Prompting erfassen jedes Detail Ihres Interviews und liefern präzise Ergebnisse.
Die Speech to Text-Tools von ElevenCreative erstellen Interviewtranskripte in Minuten und schaffen Zeit für Recherche, Schreiben, Bearbeitung und mehr. ElevenLabs Playground bietet eine benutzerfreundliche Oberfläche ohne Einrichtung, die Sie in wenigen Minuten von der Audiodatei zum fertigen Transkript führt. ElevenAPI integriert die Interviewtranskription direkt in Ihre Softwareplattform und beschleunigt so Ihre Workflows.
Registrieren Sie sich noch heute bei ElevenLabs, um Ihre Interviews zu transkribieren, oder erfahren Sie mehr über alles, was ElevenCreative bietet.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.