
Interaktionsmodelle: Natürlicher Dialog zwischen Mensch und KI
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Wer schon einmal versucht hat, einen KI-Sprachagenten mitten im Satz zu unterbrechen, weiß, wie es sich anfühlt, wenn ein System nicht für menschliche Gespräche ausgelegt ist. Der Rhythmus stimmt nicht, die Stimme ist vom Inhalt losgelöst, und selbst wenn die Informationen korrekt sind, fühlt sich die Interaktion seltsam an: nicht wie ein Gespräch mit einer sachkundigen Person, sondern wie die Navigation durch Software, die zufällig Worte verwendet.
Die Ursache für dieses unnatürliche Gefühl ist strukturell bedingt. Viele Voice-KI-Systeme wurden dafür entwickelt, Gesprächszüge zu verarbeiten, nicht den tatsächlichen Gesprächsfluss. Sie hören zu, verarbeiten und antworten jeweils auf einen Gesprächsbeitrag. Das funktioniert bei einfachen Demos, bricht aber zusammen, wenn das Gespräch emotional und unvorhersehbar wird.
Interaktionsmodelle sind KI-Systeme, die in Echtzeit über Audio und Text kommunizieren. Sie erfassen nicht nur, was gesagt wird, sondern auch, wann es gesagt wird und welche emotionale Reaktion der Moment erfordert. Dieser Artikel erklärt, was Interaktionsmodelle unterscheidet, warum sie für Unternehmen mit KI-Sprachsystemen wichtig sind und wie ElevenLabs sie entwickelt.
Zusammenfassung
- Die meisten KI-Sprachsysteme scheitern in echten Gesprächen, weil sie Unterbrechungen, Stille oder turnübergreifenden Kontext nicht verarbeiten können.
- Der Interaktions-Stack von ElevenLabs verarbeitet Unterbrechungen, Pausen und überlappende Sprache, ohne Kontext oder Gesprächsfluss zu verlieren.
- ElevenLabs entwickelt echte Interaktionsmodelle mit einer fortschrittlichen kaskadierten Architektur, eigenem Speech to Text (STT) und Text to Speech (TTS) sowie einem auf geringe Latenz und natürliche Gespräche abgestimmten Stack.
Warum die meiste Mensch-KI-Sprachkommunikation nicht natürlich wirkt
Die meisten KI-Sprachsysteme behandeln Gespräche als Abfolge diskreter Ein- und Ausgaben: Das System wartet auf einen Sprachabschnitt, wandelt ihn in Text um, verarbeitet diesen Text und antwortet. Das funktioniert bei Frage-Antwort-Interaktionen, aber ein echtes Gespräch ist keine saubere Abfolge von Textaustauschen. Es ist ein kontinuierliches Hin und Her mit Pausen und Einwürfen.
Wenn der Fluss zwischen Gesprächszügen und der darin fortgeführte Kontext fehlen, entstehen drei konkrete Probleme:
- Es unterbricht Sie oder lässt Sie warten: Das System kann eine Denkpause nicht von einem abgeschlossenen Gesprächszug unterscheiden. Daher fällt es Ihnen entweder ins Wort oder bleibt still, nachdem Sie aufgehört haben zu sprechen. Sammeln Sie mitten im Satz Ihre Gedanken, werden Sie unterbrochen; beenden Sie Ihren Punkt, warten Sie in einer Pause ohne Ton.
- Es kann nicht reagieren, sobald es spricht: Sobald das System zu antworten beginnt, hört es nicht mehr zu. Wenn Sie es unterbrechen, um das Gespräch umzulenken, liefert es weiter die Antwort auf eine Frage, die für Sie längst nicht mehr relevant ist, weil es Änderungen nicht erkennt.
- Es vergisst im Verlauf des Gesprächs: Jeder Gesprächszug wird isoliert verarbeitet, sodass Kontext aus fünf Austauschen zuvor nicht erhalten bleibt. Sie müssen sich wiederholen oder das System reagiert, als hätte das Gespräch gerade erst begonnen.
Das Ergebnis ist ein Gespräch, das funktional korrekt sein kann und sich dennoch falsch anfühlt.
Was Interaktionsmodelle leisten, was herkömmliche KI-Sprachsysteme nicht können
Während herkömmliche Sprach-KI einen Gesprächswechsel nach dem anderen verarbeitet, steuert ein Interaktionsmodell das gesamte Gespräch. Es berücksichtigt gleichzeitig, was gesagt wird und was als Nächstes geschehen muss. Der funktionale Unterschied besteht darin, dass ein Interaktionsmodell auf den tatsächlichen Stand des Gesprächs reagiert.
Interaktionsmodelle bieten:
- Echtzeitreaktion: Das System ist auf Reaktionen in Gesprächsgeschwindigkeit ausgelegt. Der End-to-End-Zyklus kann je nach Konfiguration unter einer Sekunde liegen.
- Natürlicher Umgang mit Unterbrechungen, Stille und Überlappungen: Es unterscheidet Denkpausen von abgeschlossenen Gesprächszügen, sodass es Menschen weder unterbricht noch Pausen ohne Ton entstehen lässt. Spricht der Kunde darüber, um das Gespräch umzulenken, verarbeitet es die Überlappung, ohne Kontext zu verlieren oder das Gespräch zu unterbrechen.
- Kontinuität über den gesamten Austausch: Statt den Kontext bei jedem Gesprächszug zurückzusetzen, führt das System den Gesprächsverlauf fort. Was es beim zehnten Gesprächszug sagt, berücksichtigt also alles, was seit dem ersten geschehen ist.
- Adaptive Sprechweise: Die Stimme kann je nach Aufgabe angepasst werden – ruhiger, direkter oder beruhigender.
- Parallele Aufgabenausführung: Das System ruft Informationen ab, führt Tool-Aufrufe aus und spricht gleichzeitig weiter, statt bei einer Suche still zu bleiben.
Der Test für ein Interaktionsmodell ist ein Gespräch, das schlecht läuft. In der folgenden Aufnahme ruft ein Kunde wegen einer Flugannullierung an. Er ist angespannt und braucht schnell eine Lösung für sein Problem.
Der Agent erkennt die Dringlichkeit und Frustration des Kunden sofort anhand seiner Wortwahl. Er passt seinen Ton an, verarbeitet die Unterbrechung, ohne den Faden zu verlieren, und nutzt seine verbundenen Tools, um konkrete Lösungen für den annullierten Flug anzubieten. Am Ende erhält der Kunde eine Lösung, ohne einen menschlichen Agenten zu benötigen.
Vergleichen Sie das mit den heute üblichen turnbasierten Agenten. Diese Systeme würden auf jede Pause warten, von einer neutralen Ausgangslage antworten und die Frustration des Kunden vollständig übersehen. Nach einigen Austauschen, die nicht auf das tatsächliche Empfinden des Anrufers eingehen, müsste das Gespräch wahrscheinlich an einen Menschen übergeben werden. Der Kunde wäre dann frustrierter als zu Beginn.
Wie ElevenLabs Interaktionsmodelle entwickelt
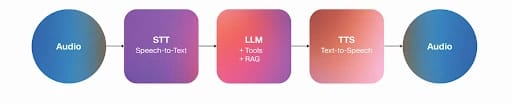
Unsere Gesprächspipeline nutzt eine fortschrittliche kaskadierte Architektur statt einer fusionierten Architektur. So verarbeitet nicht ein Modell alles, sondern jede Stufe ist eine spezialisierte Komponente.
Der Vorteil dieses Ansatzes: Wir können jede Stufe der Pipeline unabhängig optimieren und für jede Komponente ein besseres Modell einsetzen, ohne das gesamte System neu aufzubauen. Da wir diese Komponenten selbst entwickeln, sind sie darauf abgestimmt, umfangreichen Kontext miteinander auszutauschen. So verhält sich die Pipeline weiterhin wie ein zusammenhängendes Gespräch statt wie eine Kette separater Tools.
Struktur eines kaskadierten Modells
Struktur eines fusionierten Modells
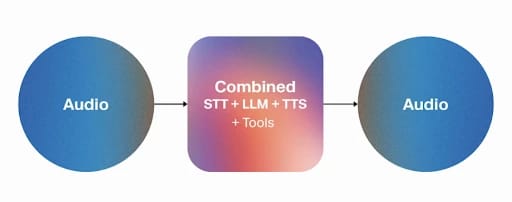
Bilder: Kaskadierte vs. fusionierte Modelle
Diese Technologien bilden derzeit die Pipeline:
- Scribe v2 Echtzeit: Unser eigenes STT-Modell transkribiert Sprache in rund 150 ms in über 90 Sprachen und bewältigt Hintergrundgeräusche, Akzente, Unterbrechungen sowie nonverbale Ereignisse wie Lachen und Pausen. Es verarbeitet auch fachspezifisches Vokabular – von medizinischen Begriffen bis zu Finanzjargon.
- Spekulative Gesprächsübergabe: Dieses System entscheidet, wann es sprechen, pausieren oder warten soll. Es liest den Gesprächsfluss, statt sich auf einen festen Stille-Schwellenwert zu verlassen. Verbesserungen an unserem Voice-Activity-Detection-Modell helfen dabei, Hintergrundsprache und kurze Antworten besser zu filtern, sodass Gesprächsübergaben natürlicher wirken.
- Eleven v3 Conversational: Eines unserer ausdrucksstärksten TTS-Modelle, entwickelt für Live-Dialoge im Wechsel. Es trägt die emotionale Stimmung des Gesprächs über die einzelnen Gesprächswechsel hinweg weiter, sodass die Ausdrucksweise des Agenten beim zehnten Gesprächswechsel alles widerspiegelt, was zuvor passiert ist.
- Expressive Mode: Aufbauend auf Eleven v3 Conversational und dem System für Gesprächsübergaben steuert Expressive Mode den Klang des Agenten im jeweiligen Moment. Er deeskaliert bei frustrierten Kunden, beruhigt bei Verwirrung und ist direkt, wenn Klarheit gefragt ist. Er erkennt auch Ausdrucks-Tags, sodass das Modell Hinweise wie [laughs], [whispers] oder [sighs] für bestimmte Momente der Sprechweise nutzen kann.
- Flash v2.5: Unser TTS-Modell mit geringer Latenz unterstützt 32 Sprachen und erzeugt Sprache in unter 75 ms. Wenn Latenz Priorität hat, hält es die Antwortzeit im Bereich eines natürlichen menschlichen Rhythmus.
- Speech Engine: Die verbindende Ebene des Stacks. Sie verbindet Ihren Server über WebSocket mit unserer ElevenAPI – eine Verbindung pro Gespräch. Wir übernehmen STT und TTS, während Ihr Server das LLM ausführt. So können technische Teams ihr eigenes Modell einbringen und die Gesprächslogik in ihrer eigenen Infrastruktur behalten.
Diese Modelle werden kontinuierlich verbessert und regelmäßig in neuen Versionen veröffentlicht. Jede neue Version verringert den Unterschied zwischen einem Gespräch mit Software und einem Gespräch mit einer Person – mit schnelleren Antworten, präziserer Emotionserkennung, mehr Sprachen und flüssigerer Sprechweise.
Sprechen und gleichzeitig denken
Nicht jeder Teil eines Interaktionsmodells muss in einer strikten Abfolge laufen. ElevenAgents kann im Hintergrund weiterarbeiten, während das Gespräch weitergeht, statt zwischen Frage und Antwort standardmäßig still zu bleiben.
Mehrere Kernsysteme ermöglichen gemeinsames Sprechen und Denken:
- Parallele Tool-Aufrufe: Der Agent kann eine Datenbank abfragen, ein Tool ausführen oder einen Bestellstatus prüfen, während er noch spricht. Der Abruf wirkt dadurch nie wie eine Pause ohne Ton im Gespräch.
- Soft Timeout: Wenn ein LLM länger als erwartet braucht, um eine Antwort zu erzeugen, sagt der Agent eine kurze Überbrückungsphrase wie „Lassen Sie mich nachdenken“ oder „hmmm“, statt eine unangenehme Stille entstehen zu lassen. Soft Timeout sorgt für einen natürlichen Gesprächsfluss und verringert die Wahrscheinlichkeit von Unterbrechungen.
- Begriffe zum Ignorieren von Unterbrechungen: Statt einen festen Stille-Schwellenwert zu verwenden, versucht das System, die Bedeutung des Gesagten zu erfassen und daraus zu schließen, wann ein Gesprächszug tatsächlich beendet ist. Ebenso können kurze Bestätigungen wie „okay“ oder „mhm“ so konfiguriert werden, dass sie passieren, ohne eine vollständige Unterbrechung auszulösen. So verliert der Agent nicht jedes Mal den Faden, wenn der Anrufer etwas einwirft.
Zusammen verhindern diese Systeme, dass der Agent wirkt, als würde er eine Antwort puffern oder laden. Sie bilden eine schlanke Gesprächs-Engine, die Lücken natürlich füllt wie ein Mensch und gleichzeitig im Hintergrund Informationen verarbeitet und Gedanken sammelt.
Wie ein Gespräch mit ElevenLabs tatsächlich abläuft
Die oben genannten Komponenten laufen nicht ordentlich nacheinander ab. Sie überlappen sich. So würde ein Agent von ElevenLabs mit einem Anrufer umgehen, der mitten in einem Supportgespräch fragt: „Wurde meine Bestellung schon versandt oder wird sie noch bearbeitet?“
- Der Anrufer spricht: Audio wird über die WebSocket-Verbindung an ElevenLabs gestreamt, und Scribe beginnt mit der Echtzeittranskription – rund 150 ms hinter der Stimme.
- Das System liest den Gesprächsfluss: Während Scribe noch transkribiert, beurteilt die spekulative Gesprächsübergabe bereits, ob der Anrufer fertig gesprochen hat oder noch mitten im Gedanken ist. Das abschließende „oder wird sie noch bearbeitet?“ wird als Übergabe statt als Pause erkannt. Daher löst es den nächsten Schritt aus, statt in Stille zu warten.
- Das LLM stellt Kontext zusammen und antwortet: Die transkribierte Frage geht zusammen mit dem Gesprächsverlauf, dem aus den eigenen Systemen des Unternehmens abgerufenen Bestelldatensatz über RAG, Tool-Ausgaben aus früheren Gesprächsabschnitten und den System-Prompt. Es verarbeitet all diese Informationen und erzeugt eine Antwort, die auf die Bestellung des Anrufers abgestimmt ist.
- Das TTS-Modell synthetisiert die Antwort: Der Text wird zu natürlich klingendem Audio. Ist Expressive Mode aktiv, enthält die Antwort Sprechhinweise, die zum Moment passen. Ein Routine-Update klingt dann leicht und gelassen statt flach. Wenn Latenz Priorität hat, übernimmt Flash die Synthese in unter 75 ms.
- Die Antwort wird zurückgestreamt: Die Audiowiedergabe beginnt, bevor die Synthese abgeschlossen ist. Der Anrufer hört also den Anfang der Antwort, während der Rest noch erzeugt wird.
- Der Zyklus wiederholt sich: Jeder neue Gesprächszug führt Ton, Kontext und Verlauf des Gesprächs weiter.
In diesem schnellen Prozess wirkt das Gespräch natürlich. Der Anrufer passt sich nicht mehr an die Maschine an: Er spricht nicht langsamer, artikuliert nicht überdeutlich und wartet nicht auf einen Signalton. Er spricht einfach, wie mit einer Person.
Setzen Sie natürlich klingende Sprachagenten im gesamten Unternehmen ein
Alles, was hier beschrieben wird, ist heute im Einsatz. Von der kaskadierten Architektur bis zur Pipeline mit Reaktionszeiten unter einer Sekunde nutzen Unternehmen weltweit bereits ElevenAgents für echte Kundengespräche im großen Maßstab.
Das gilt auch für regulierte Umgebungen mit hohen Anforderungen, denn unsere Agentenarchitektur unterstützt Guardrails, Audit-Logs und Compliance-Kontrollen. ElevenLabs ist nach SOC 2 Type II, ISO 27001, HIPAA und PCI DSS Level 1 zertifiziert und bietet Zero Retention Mode sowie regionale Datenresidenz für Teams, deren Daten innerhalb einer bestimmten Grenze bleiben müssen.
Bereit, einen Agenten einzusetzen? Sie können einen Agenten erstellen und mit dem Aufbau in der Konsole beginnen oder mit unserem Vertriebsteam sprechen über eine auf Ihre Umgebung zugeschnittene Bereitstellung.
FAQ zu Interaktionsmodellen

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


