
Was ist Latenz bei Conversational KI und was beeinflusst sie?
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Für Conversational AI ist die Latenz der Unterschied zwischen guten und großartigen Anwendungen.
Conversational AI ist von Natur aus anspruchsvoll. Sie soll das Gefühl eines Gesprächs mit einem Menschen nachbilden und dabei dieselbe emotionale Bandbreite, Tonhöhe und Sprechmelodie widerspiegeln. Berücksichtigt man zudem eine Verzögerung zwischen dem Ende Ihrer Äußerung und dem Beginn der Antwort eines KI-Agenten, die sich „natürlich“ anfühlt, ergibt sich ein Latenzziel, das auf menschlicher Kommunikation basiert.
Unternehmen, die Conversational-AI-Agenten im großen Maßstab einsetzen möchten, müssen diese Latenz möglichst stark reduzieren, um diese natürliche Illusion zu erzeugen. Dieser Artikel erklärt, was Conversational-AI-Latenz ist, wodurch Verzögerungen in der gesamten Pipeline entstehen und wie Sie sie auf hoher Ebene reduzieren können.
Zusammenfassung
- Conversational-AI-Latenz ist die gesamte End-to-End-Verzögerung zwischen dem Ende der Äußerung eines Nutzers und dem ersten Wort des Agenten.
- Agenten mit mehr als 700 ms können unnatürlich wirken. Bei über 1.200 ms sind die Abbruchraten hoch.
- Die Latenz summiert sich über jede Phase der Conversational-AI-Pipeline.
- ElevenAgents verarbeitet die gesamte Pipeline in einer einheitlichen Architektur und macht Conversational AI mit niedriger Latenz für Ihr Unternehmen zugänglich.
Was ist Conversational-AI-Latenz?
Conversational-AI-Latenz bezeichnet die gesamte Zeit, die ein System für eine Antwort benötigt, nachdem Sie gesprochen haben. Bei modernen KI-Modellen wird die Latenz in ms gemessen. Hinter diesem Gesamtwert stehen mehrere einzelne Prozesse, die jeweils einen Teil der End-to-End-Pipeline abdecken.
Eine typische Conversational-AI-Pipeline sieht so aus:
- Ein Nutzer spricht
- Das Audio wird von einem Speech-to-Text-Modell transkribiert
- Das Transkript wird an ein LLM übergeben, das eine Antwort erzeugt
- Der Text des LLM wird anschließend mit einem Text-to-Speech-Modell in Audio umgewandelt
- Das Audio wird dem Nutzer wiedergegeben
Jede dieser Phasen erhöht die Latenz eines Conversational-AI-Systems. Deshalb gibt es bei der Latenz einige Abkürzungen, die unterschieden werden müssen.
Modell-Inferenzlatenz
Die Modell-Inferenzlatenz ist die Zeit, die ein Modell intern für die Generierung einer Ausgabe benötigt, ohne externe Faktoren. Sie zeigt modellspezifisch, wie schnell Ihre Engine bei typischen Eingaben arbeitet. Flash v2.5 hat beispielsweise eine Modell-Inferenzlatenz von etwa 75 ms. Damit können Sie die Geschwindigkeit von Modellen verschiedener Anbieter vergleichen.
Beachten Sie jedoch, dass dies nicht die Latenz ist, die ein Nutzer tatsächlich erlebt. Sie bezieht sich ausschließlich auf die gesamte Zeit, die ein Modell zur Generierung einer Ausgabe benötigt.
LLM Time-to-First-Token
Die Time-to-First-Token (TTFT) eines Large Language Model (LLM) ist die gesamte Zeit, die ein LLM benötigt, um einen Prompt zu verarbeiten und sein erstes nutzbares Ausgabe-Token zu generieren.
Die TTS-Generierung beginnt, sobald das erste Token Ihres LLM eintrifft. Dies misst also, wie lange das LLM benötigt, um Ihr TTS-Modell zu starten. Bei den meisten End-to-End-Conversational-AI-Systemen macht die LLM-TTFT einen erheblichen Anteil der Gesamtlatenz aus.
TTS Time-to-First-Audio (TTFA)
TTS Time-to-First-Audio (TTFA) misst die Zeit von der ersten TTS-Anfrage bis zum tatsächlichen Verlassen des ersten Audio-Blocks aus dem Modell. Damit lässt sich die Modell-Inferenzlatenz speziell für TTS-Engines beschreiben.
End-to-End Time-to-First-Audio (TTFA)
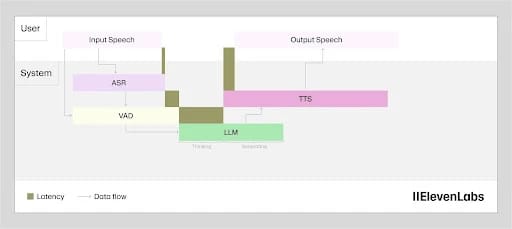
Die End-to-End-TTFA entspricht der gesamten Conversational-AI-Latenz. Sie ist die Summe aller Teile der Pipeline – von Spracherkennung, LLM-TTFT, TTS und TTFA bis zu allen Netzwerkübertragungen zwischen den Schritten. Wenn von Conversational-AI-Latenz insgesamt die Rede ist, ist dies die Kennzahl, die der Nutzer wahrnimmt.
Wenn Nutzer sprechen, warten sie auf die End-to-End-TTFA, bevor sie etwas von Ihrem Agenten hören. Sie ist ein ganzheitliches Maß. Das heißt: Jede Verbesserung in der Pipeline verbessert sie.
Warum Conversational-AI-Latenz wichtig ist
Wenn ein Nutzer mit Ihrem KI-Agenten spricht, wird die Latenz zu einem zentralen Faktor für seine Wahrnehmung der Erfahrung. Niedrige Latenz verkürzt die Wartezeit auf Antworten, damit sich das Gespräch natürlich anfühlt und Ihr Agent kompetent wirkt.
Agenten mit hoher Latenz wirken künstlich und weniger kompetent, selbst wenn ihre Antworten dieselbe Qualität haben. Für Unternehmen können schon wenige hundert ms wie eine Ewigkeit wirken und Ihren Kundensupport-Agenten schwerfällig und ineffektiv erscheinen lassen.
Die folgenden Szenarien zeigen, warum Conversational-AI-Latenz in der Praxis wichtig ist:
- Unter 500 ms: Ein Conversational Agent wirkt reaktionsschnell und effizient. Nutzer bemerken die Verzögerung zwischen dem Ende ihrer Äußerung und der ersten Antwort möglicherweise nicht. Das Gespräch bleibt flüssig.
- 500 ms bis 1.000 ms: Die Verzögerung zwischen dem Ende einer Äußerung und einer Antwort kann spürbar werden. Sie ist nur geringfügig zu lang, sodass Nutzer sich möglicherweise vorsorglich anpassen: Sie wiederholen sich oder warten ab, ob der Agent sie tatsächlich verstanden hat.
- Über 1.000 ms: Verzögerungen wirken langsam. Pausen können bei einigen Nutzern den Eindruck erzeugen, dass der KI-Agent dem Gespräch nicht vollständig folgt. Transkripte können gelegentliche Unterbrechungen oder Bitten um einen menschlichen Agenten zeigen. In manchen Fällen brechen Nutzer den Anruf ab.
Jeder dieser Schwellenwerte führt zu konkreten Geschäftsergebnissen.
Am unteren Ende des Latenzspektrums steht ein Kundenservice-Agent, der eingehende Fragen natürlich bearbeitet und Nutzern ohne zusätzliche Hilfe bei der Lösung ihrer Anliegen hilft. Das entlastet Ihre menschlichen Agenten und hält die Kundenzufriedenheit hoch. Am oberen Ende des Latenzspektrums frustrieren Sie Ihre Kunden mit einem Agenten, der zu lange zu zögern scheint.
In einem anderen Artikel haben wir die Benchmarks für das Latenzbudget von Voice Agents definiert. Sie zeigen, wie gute Latenz bei P50- und P95-Werten aussieht.
Was verursacht Conversational-AI-Latenz?
Conversational-AI-Latenz fasst mehrere verschiedene Prozesse zusammen, wobei jedes Segment zum Gesamtwert beiträgt. Der Engpass für geringe Latenz ist daher eher ein Problem auf Systemebene als etwas, das sich allein durch die Wahl eines besseren Modells lösen lässt. Schließlich interagieren mehrere Modelle innerhalb der Pipeline.
Für Entwickler haben wir einen ausführlichen technischen Leitfaden zur Optimierung der Voice-Agent-Latenz erstellt, mit dem Sie jede Phase der End-to-End Time-to-First-Audio (TTFA) verbessern können.
Neben der Kernpipeline erhöhen auch andere Faktoren wie Telefonie und Function Calling die Latenz, obwohl sie nicht Teil der Modellinfrastruktur sind.
Hier finden Sie einen Überblick über alle Faktoren, die zur Conversational-AI-Latenz beitragen.
Automatische Spracherkennung
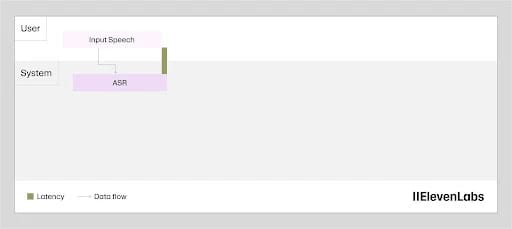
Die Latenz der Spracherkennung ist nicht die Zeit, die zum Erzeugen eines Transkripts benötigt wird. Die Transkription läuft im Hintergrund, während der Nutzer spricht. Wenn die Äußerung endet, ist der Text daher größtenteils bereits fertig.
Die Latenz ist hier vielmehr die Zeitspanne zwischen dem Ende der Äußerung und dem Abschluss sowie der Weitergabe des Transkripts an die nächste Phase. Scribe v2 Realtime verkürzt diese Lücke auf etwa 150 ms und streamt kontinuierlich, sodass die Ausgabe bereitsteht, sobald der Sprecherwechsel endet.
Sprecherwechsel und Endpunkterkennung
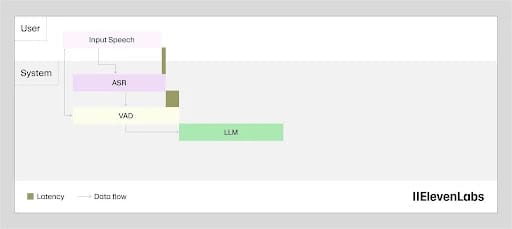
Ein Voice Activity Detector (VAD) sitzt zwischen der Spracherkennung und dem Sprachmodell. Er entscheidet, wann der Nutzer tatsächlich zu Ende gesprochen hat.
Um Fehler zu vermeiden, wartet der VAD eine bestimmte Dauer anhaltender Stille ab, bevor er den Sprecherwechsel für beendet erklärt. Diese Wartezeit erhöht die Latenz, bevor das Sprachmodell ein Wort verarbeitet. Die zusätzliche Latenz kostet zwar Zeit, verhindert aber auch, dass das System antwortet, während der Nutzer noch spricht.
Rein technisch wäre die dem Sprecherwechsel zugeschriebene Latenz positiv, wenn alle anderen Conversational-AI-Komponenten keine Latenz verursachten. Menschen halten kurz inne, bevor sie auf Gesprochenes antworten. Eine ähnliche Pause durch eine Maschine lässt die Interaktion realistischer wirken. Da andere Conversational-AI-Komponenten jedoch bereits Latenz verursachen, ist eine minimale Latenz ideal.
Verarbeitung durch das Sprachmodell
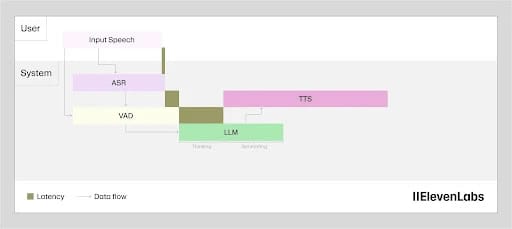
Sobald das Transkript von der Speech-to-Text-Engine (STT) bereitsteht, erzeugt das Sprachmodell eine Antwort. Die Latenz ist hier die Zeit bis zum Beginn der Token-Generierung, nicht bis zur vollständigen Antwort. Die Tokens werden direkt bei ihrem Eintreffen in die TTS-Phase gestreamt. Entscheidend ist daher die TTFT.
Neben der Modellwahl beeinflussen sowohl die Prompt-Länge als auch die Größe der Wissensdatenbank diese Phase. Je mehr Kontext das LLM berücksichtigen muss, desto länger dauert es. Bei der Entwicklung dieser Systeme im großen Maßstab müssen Sie die richtige Balance zwischen einer hilfreichen Wissensdatenbank und einem schlanken Prompt finden, um schnell zu bleiben.
Sprachsynthese
Die TTS-Latenz ist die Zeit zwischen dem Empfang der ersten Tokens vom Sprachmodell und dem Beginn der Audioausgabe. Da Tokens schneller eintreffen, als menschliche Sprache wiedergegeben wird, wartet das Synthesemodell nie auf die vollständige Antwort. TTS-Latenz ist ausschließlich die Zeit bis zum ersten Audio-Block.
Diese Phase war früher der größte einzelne Faktor der Conversational-AI-Latenz. Ältere Modelle benötigten 2–3 Sekunden, um mit der Sprachgenerierung zu beginnen. Flash v2.5 von ElevenLabs löst dieses Problem direkt: Es liefert Sprachsynthese mit etwa 75 ms Latenz und reduziert diesen Engpass von Sekunden auf einen Bruchteil einer Sekunde.
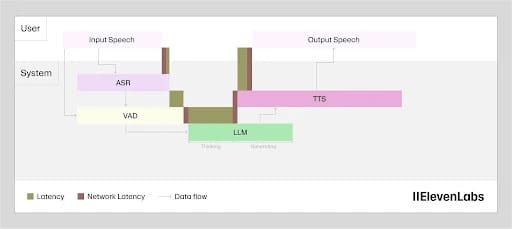
Netzwerklatenz
Das Senden von Daten von einem Ort zu einem anderen verursacht immer Latenz. Die geografische Entfernung verstärkt dabei nur die Netzwerk-Roundtrip-Latenz.
Da mehrere Komponenten für eine End-to-End-Antwort zusammenarbeiten, kann sich über mehrere Netzwerk-Hops hinweg erhebliche Latenz ansammeln.
Function Calling
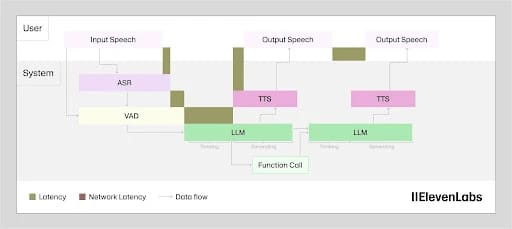
Funktionsaufrufe fügen in der LLM-Phase API-Roundtrips hinzu. Eine schnelle interne Abfrage benötigt einige zehn Millisekunden, während ein Zahlungsanbieter oder Warenwirtschaftssystem Sekunden hinzufügen kann. Die Latenz hängt vollständig vom aufgerufenen Dienst ab. Dadurch ist diese Phase am schwersten direkt zu optimieren.
Am effektivsten ist es, das LLM vor Abschluss des Tool-Aufrufs zu einer Antwort aufzufordern. Ein Satz wie „Lassen Sie mich das für Sie prüfen“ hält den Nutzer bei der Stange, während der externe Aufruf abgeschlossen wird, statt Stille zu erzeugen. Die Sprachantwort beginnt, während das Tool parallel ausgeführt wird.
So reduzieren Sie Conversational-AI-Latenz
Um Conversational-AI-Latenz zu reduzieren, müssen Sie jede Phase der Pipeline nach ihrem Einfluss angehen. Einzelne Verbesserungen wirken sich zwar auf die Latenz aus, die größte Veränderung erreichen Sie jedoch nur mit einem ganzheitlichen Ansatz für die gesamte Pipeline.
Die folgenden Prinzipien helfen Ihnen, Conversational-AI-Latenz auf hoher Ebene zu reduzieren:
- TTS-Modellauswahl: Auf Geschwindigkeit optimierte TTS-Modelle wie Flash v2.5 verwenden andere Architekturen als qualitätsoptimierte Modelle wie Eleven v3. Für Echtzeit-Voice Agents ist die richtige Wahl das qualitativ beste Modell, das Ihr Latenzziel erfüllt. Fast immer ist das ein auf Geschwindigkeit optimiertes Modell.
- LLM-Modellauswahl: Kleinere, schnellere LLMs erzeugen in der Regel eine niedrigere Time-to-First-Token als größere. Die Wahl des schnellsten LLM, das Ihren Qualitätsanspruch für die Aufgabe noch erfüllt, ist genauso wichtig wie die TTS-Modellauswahl.
- Streaming: Streaming-TTS gibt Audio während der Synthese in Blöcken zurück. Der Nutzer hört so das erste Wort, während das Modell den Rest noch generiert. Das Konzept gilt auch für die LLM-Ausgabe: Wenn die TTS-Synthese mit dem ersten Satz beginnt, während das Sprachmodell die folgenden generiert, lässt sich Latenz aus der Pipeline zurückgewinnen.
- System-Prompt-Design: Sie können System-Prompts verschlanken, indem Sie Anweisungen in Prozesse oder Workflows auslagern, statt sie in jedem Entscheidungsschritt beizubehalten. Dadurch verringert sich der Kontext, über den das Modell bei jedem Turn nachdenken muss.
- Guardrails: Wenn Guardrails im Streaming-Modell ausgeführt werden, kann die Ausgabe beginnen, bevor die Guardrail-Prüfung abgeschlossen ist, statt die Wiedergabe bis zu ihrem Abschluss zu blockieren.
- Modell-Kollokation: Kollokierte Modelle, etwa der ElevenLabs-Agents-Stack, halten Komponenten möglichst nah beieinander. So entsteht keine zusätzliche Latenz durch Hops zwischen separat gehosteten Modellen.
- Geografie: Eine geringe Entfernung zwischen Ihren Servern und Ihren Nutzern kann die Latenz erheblich reduzieren, da sie den Netzwerkanteil an der End-to-End-TTFA direkt verringert.
Neben diesen Faktoren finden Sie in diesem technischen Leitfaden zur Latenzoptimierung weitere Details.
Starten Sie mit Conversational AI mit niedriger Latenz auf ElevenAgents
Conversational-AI-Latenz ist ein wichtiger Faktor bei der Entwicklung und Bereitstellung von Agenten. Mit ElevenAgents ist die Latenzoptimierung in den Prozess integriert. Von Überlappungstechniken zur Zeitersparnis bis zur niedrigen Modell-Inferenzlatenz einzelner Komponenten erstellt ElevenAgents Conversational-AI-Stacks mit niedriger Latenz für Ihr Unternehmen.
Letztlich geht es darum, Realismus zu schaffen. Nutzer sollen die Leichtigkeit eines Gesprächs mit einem Menschen spüren und zugleich von einem Computerprogramm profitieren. Durch die Optimierung der Teilprozesse ist das jetzt möglich.
Erfahren Sie mehr über ElevenAgents oder kontaktieren Sie den Vertrieb, um heute zu starten.




