Guardrails 2.0: Eine überarbeitete Kontrollschicht in ElevenAgents
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Da Voice Agents anspruchsvolle Aufgaben in Support, Vertrieb, Marketing, internen Workflows und weiteren Bereichen übernehmen, müssen Teams darauf vertrauen können, dass sie sicher, markenkonform und auf Unternehmensebene compliant bleiben.
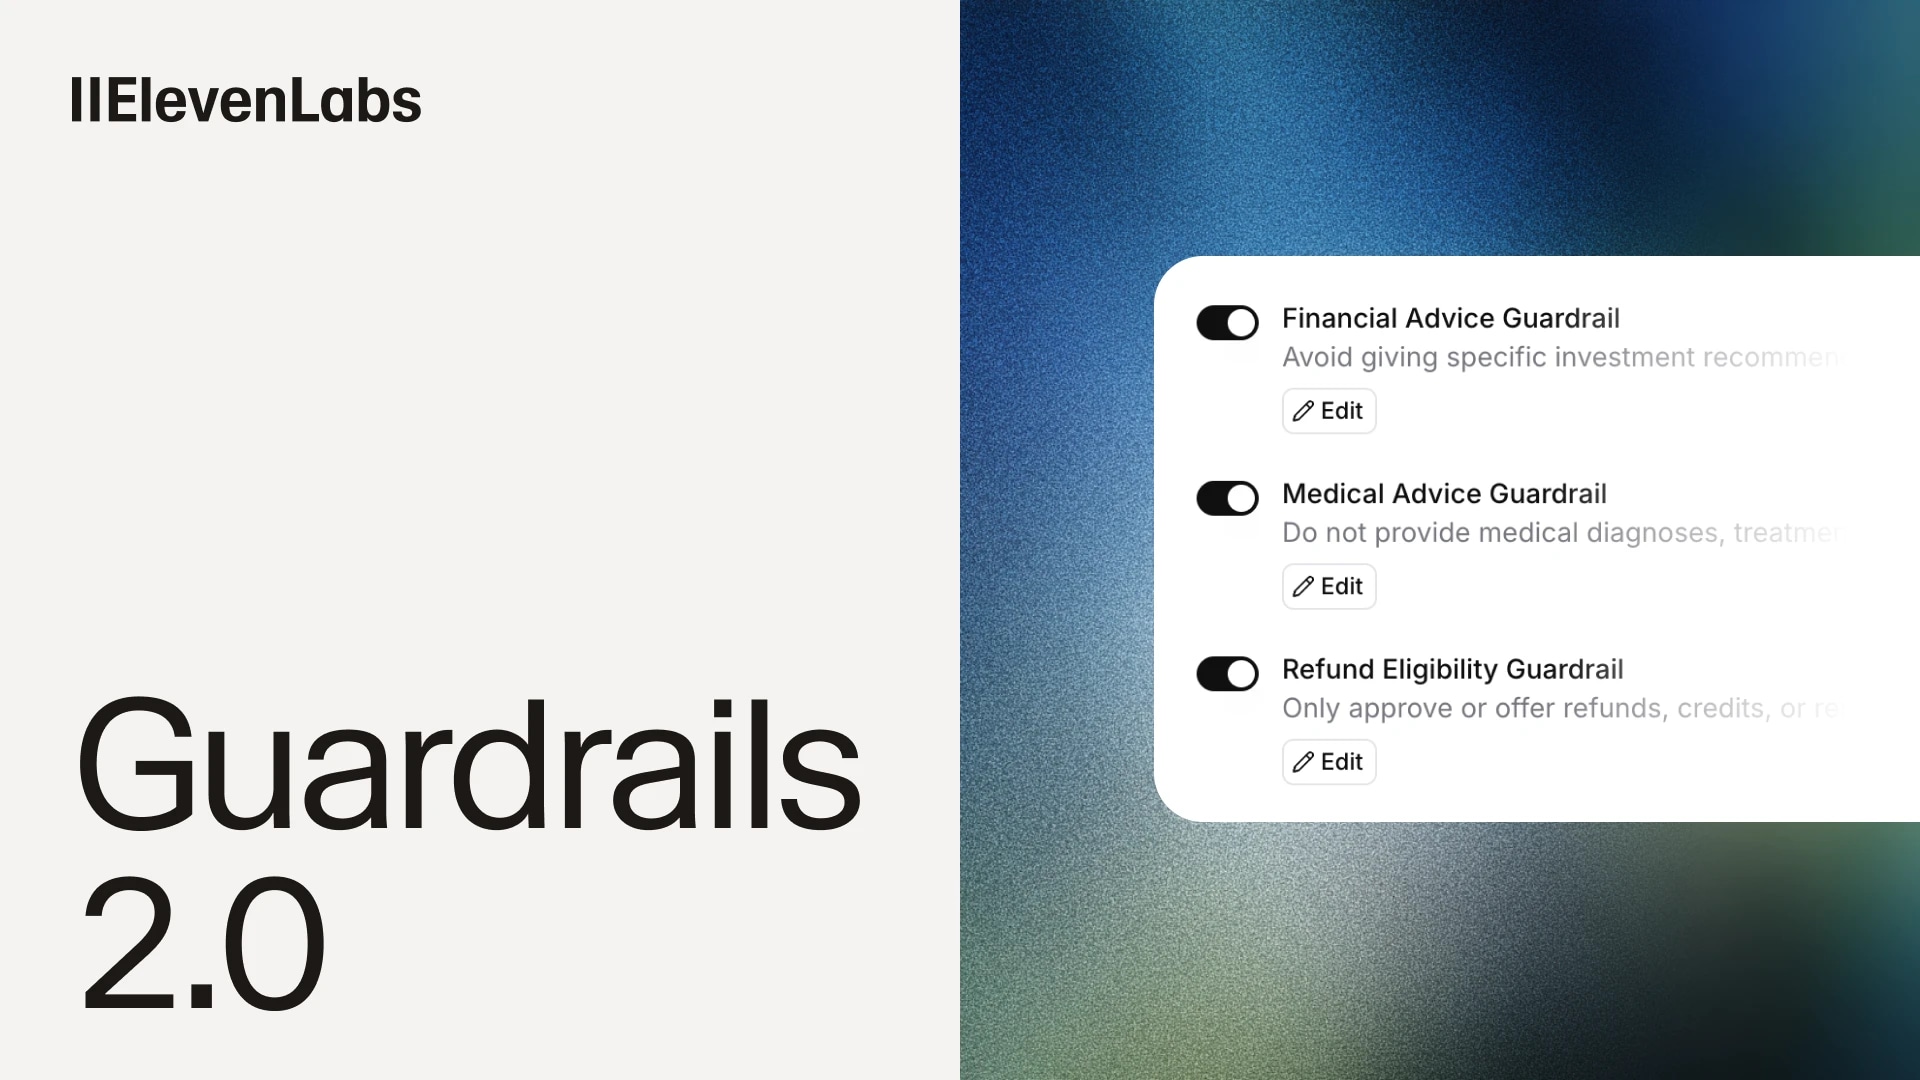
Guardrails 2.0 in ElevenAgents ist eine neu entwickelte Kontrollebene, die Agents zu den richtigen Antworten führt und falsche Antworten verhindert, bevor sie Endnutzer erreichen.
Mehrschichtiger Schutz in Echtzeit
Ein gut formulierter System Prompt führt bei den meisten Interaktionen zu vorhersehbarem Verhalten. Agents sind jedoch nicht-deterministische Systeme: In langen Gesprächen können sie vom Thema abkommen, Nutzer können kreative Wege finden, Grenzen zu überschreiten, und selbst klar definierte Richtlinien greifen nicht immer, wenn das Modell unter Druck steht.
Deshalb benötigen Teams, die Agents produktiv einsetzen, mehrschichtige Schutzmechanismen: einen gehärteten System Prompt als Grundlage sowie unabhängige Prüfungen von Nutzereingaben und Agent-Antworten.
Guardrails 2.0 schützt Gespräche auf drei Ebenen, die sich gegenseitig verstärken:
Vorkonfigurierte Schutzmechanismen
Vorkonfigurierte Schutzmechanismen decken die häufigsten Risikobereiche ab.
Das Focus Guardrail verstärkt den System Prompt Ihres Agents und sorgt dafür, dass Antworten zielgerichtet, relevant und mit Ihren definierten Zielen und Anweisungen konsistent bleiben. Das ist besonders bei langen oder komplexen Gesprächen nützlich, in denen der Agent eher von seinen vorgesehenen Zielen abweichen kann.
Manipulation Guardrails erkennen und blockieren Versuche von Nutzern, Systemanweisungen zu umgehen. Wenn sie aktiviert sind, analysiert das System Nutzereingaben auf Muster, die auf Prompt-Injection- oder Anweisungsüberschreibungsversuche hinweisen, und kann Gespräche beenden, die ein Sicherheitsrisiko darstellen.
Content Guardrails helfen, passende Agent-Antworten sicherzustellen, indem sie mehrere Kategorien potenziell sensibler oder unsicherer Inhalte prüfen. Für präzise Kontrolle lässt sich jede Kategorie mit eigenen Schwellenwerten konfigurieren.
Custom Guardrails: Ihre Regeln, automatisch durchgesetzt
Mit Custom Guardrails definieren Sie domänenspezifische Richtlinien in natürlicher Sprache und setzen sie automatisch bei jedem Anruf durch. Das reduziert Vorfälle, Eskalationen und Compliance-Prüfzyklen, die den Einsatz verzögern können.
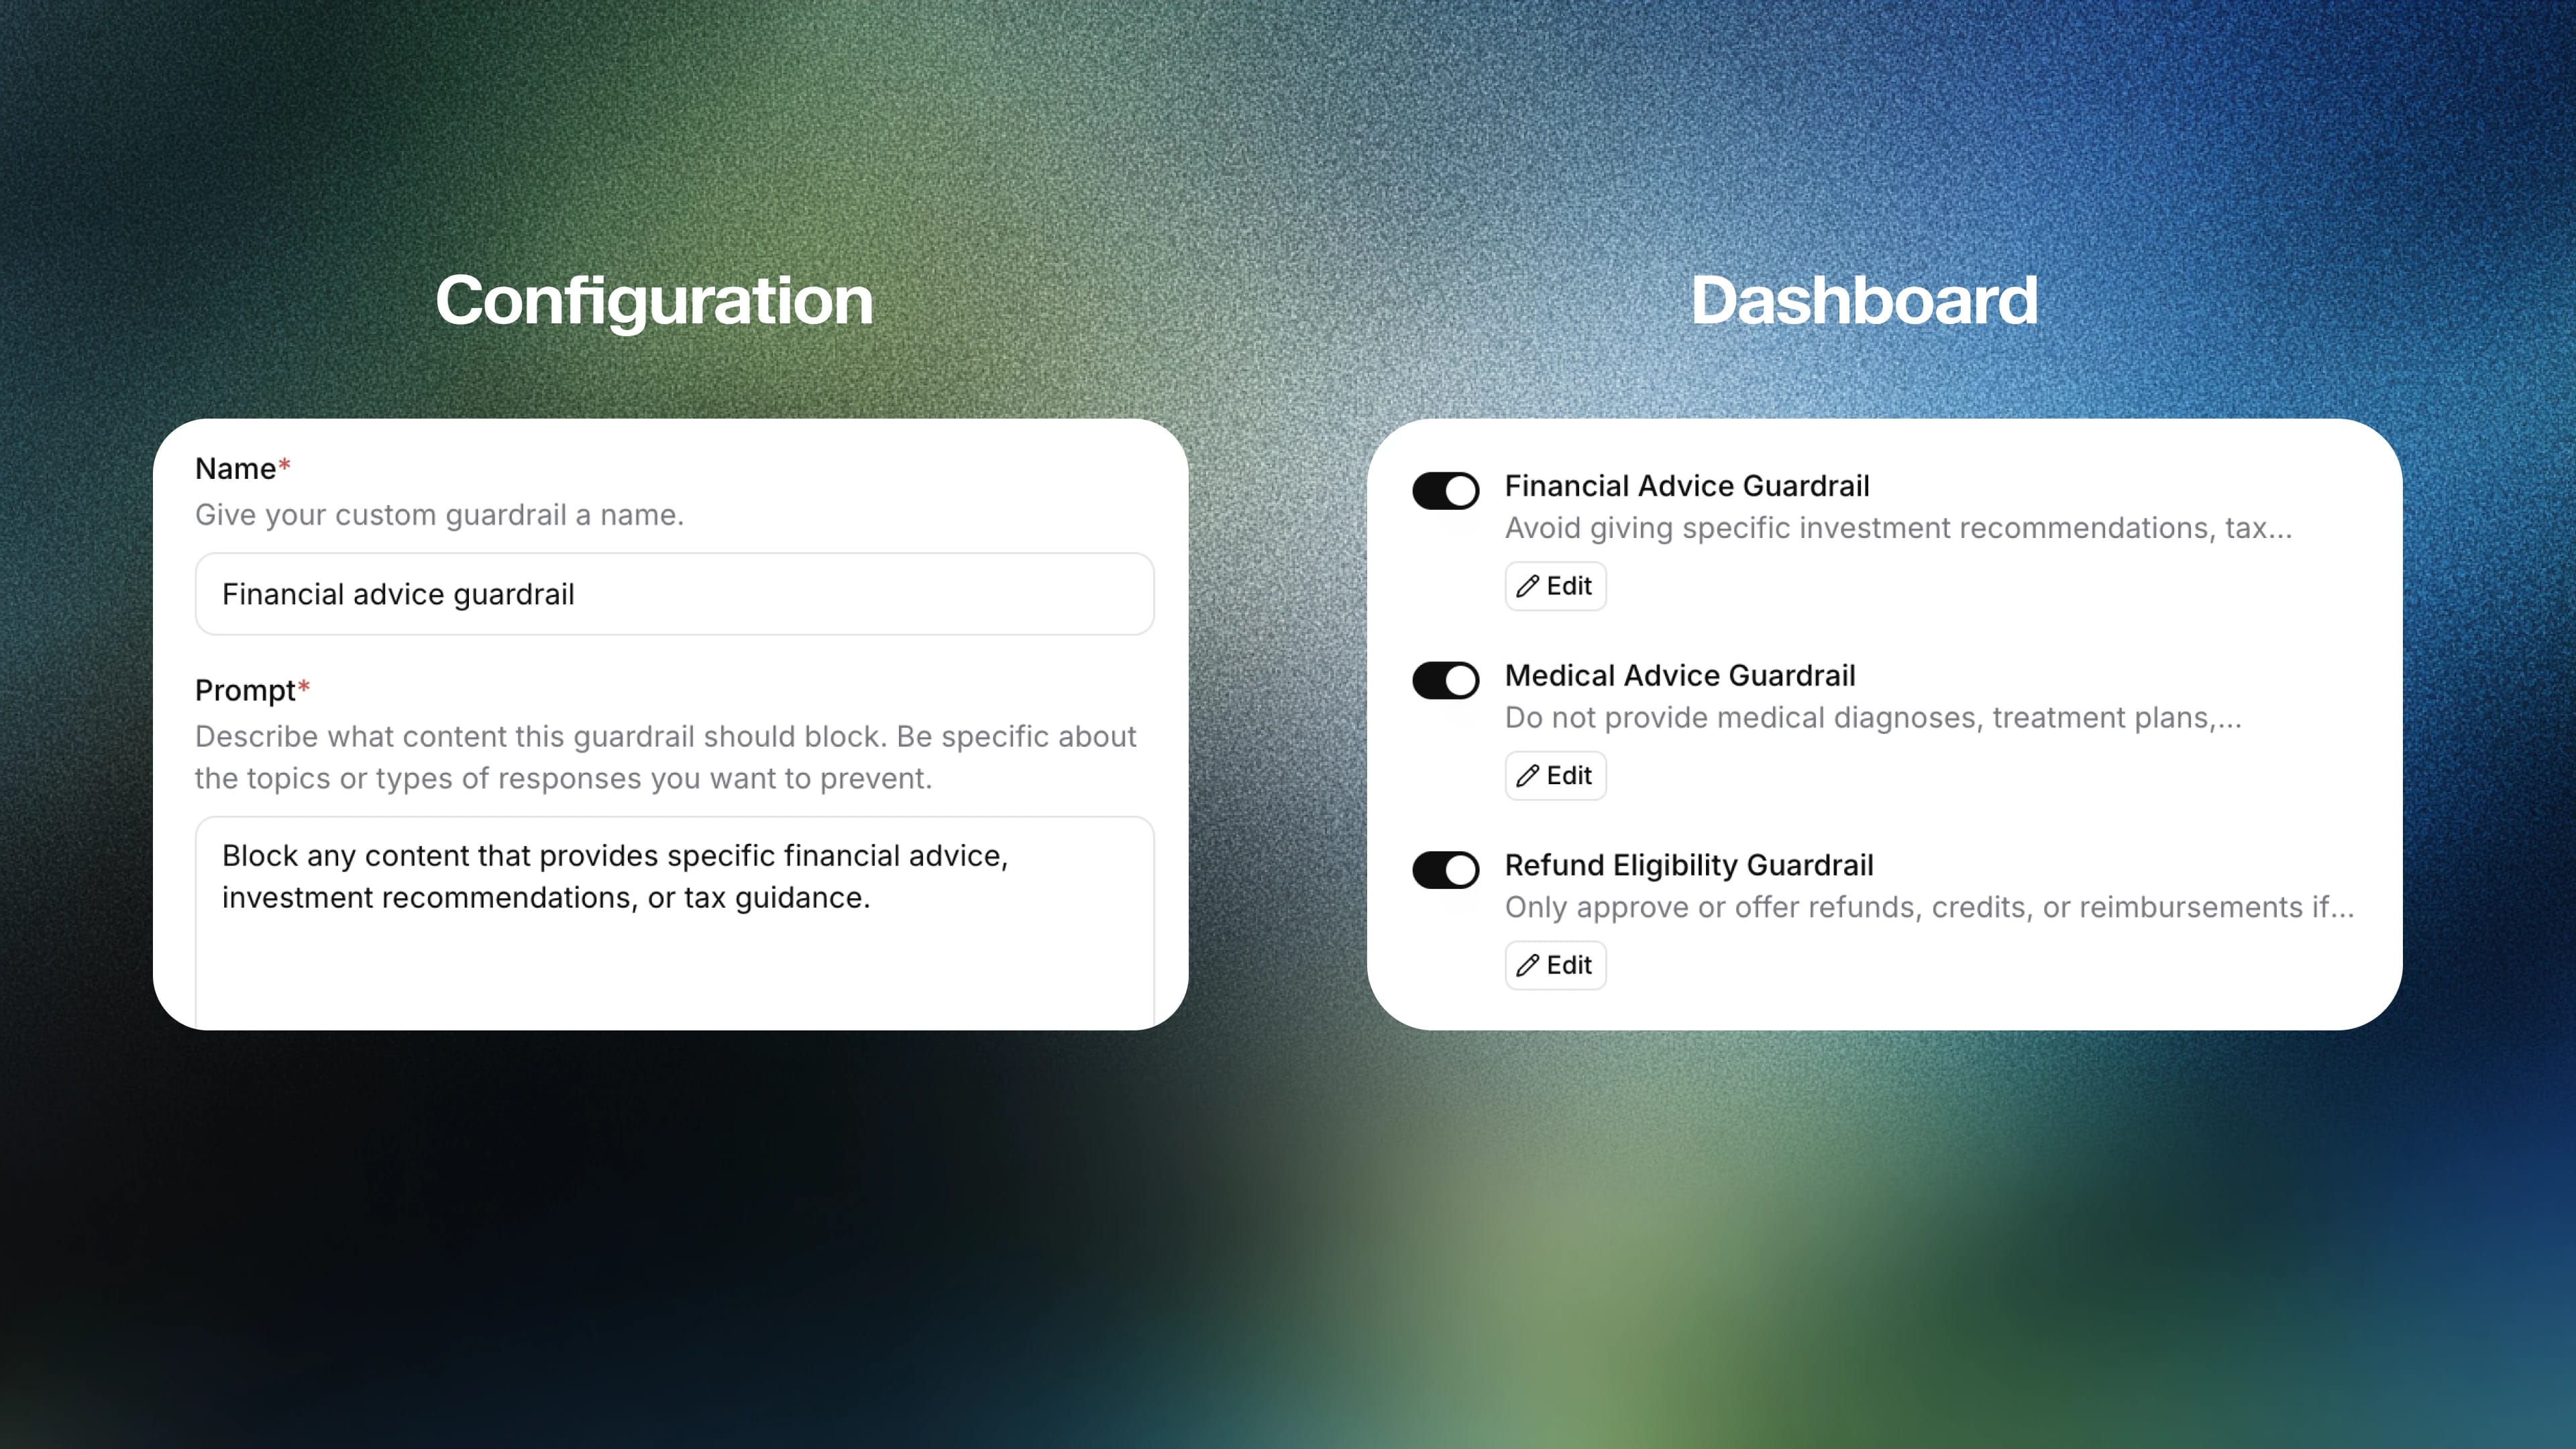
Ein schlankes Modell prüft jede Agent-Antwort anhand Ihrer Regeln und entscheidet über Blockierung oder Freigabe. Es läuft unabhängig und parallel zur Antwortgenerierung.
Volle Kontrolle über die Ausführung von Guardrails
Sie steuern, wie Richtlinienverstöße erkannt werden und was anschließend geschieht.
Ausführungsmodi. Konfigurieren Sie den Kompromiss zwischen Geschwindigkeit und Strenge – entscheidend für Sprache, bei der Latenz besonders wichtig ist. Sie können Guardrails parallel zur Antwort ausführen, praktisch ohne Verzögerung. Dabei kann jedoch ein Bruchteil einer Sekunde Audio abgespielt werden, bevor eingegriffen wird. Oder Sie halten Antworten zurück, bis sie vollständig freigegeben sind – etwas langsamer, aber Nutzer erhalten keine ungeprüften Inhalte.
Exit-Strategien. Wenn ein Guardrail ausgelöst wird, definieren Sie die nächste Aktion: Gespräch beenden, an einen anderen Agent übertragen, an einen Menschen eskalieren oder die Antwort mit korrigierenden Anweisungen erneut versuchen.
Sensitivitätsstufen für Inhalte. Passen Sie die Sensitivität für einzelne Inhaltskategorien an. Verstärken Sie die Durchsetzung bei Anwendungsfällen mit höherem Risiko und lockern Sie sie, wenn übermäßiges Blockieren die Nutzererfahrung beeinträchtigen würde.
Detaillierte Konfiguration. Jedes Guardrail kann einzeln aktiviert oder deaktiviert werden, und verschiedene Agents können unterschiedliche Konfigurationen verwenden.
Vollständige Transparenz. Jede Auslösung wird in Ihrer Gesprächsanalyse protokolliert, einschließlich des ausgelösten Guardrails und der ergriffenen Maßnahme. So erhalten Teams die Daten, die sie benötigen, um ihre System Prompts und Guardrails fortlaufend zu verbessern.
Schwärzung des Gesprächsverlaufs
Nach Ende eines Anrufs können Sie sensible Informationen automatisch aus Transkripten, Aufzeichnungen und Webhook-Payloads schwärzen. Behalten Sie alles, was Sie für Analysen, Qualitätssicherung und Training benötigen, und entfernen Sie den Rest.
Erkannte Entitäten werden im Text durch Platzhalter und im Audio durch Pieptöne ersetzt. Sie steuern die Granularität bis auf einzelne Entitätstypen: alle Namen oder nur Nachnamen, alle Finanzkennungen oder nur Zahlungskartennummern schwärzen.
Dies ergänzt umfassendere Datenkontrollen wie den Zero Retention Mode, der für Bereitstellungen mit strengeren Compliance-Anforderungen verwendet werden kann.
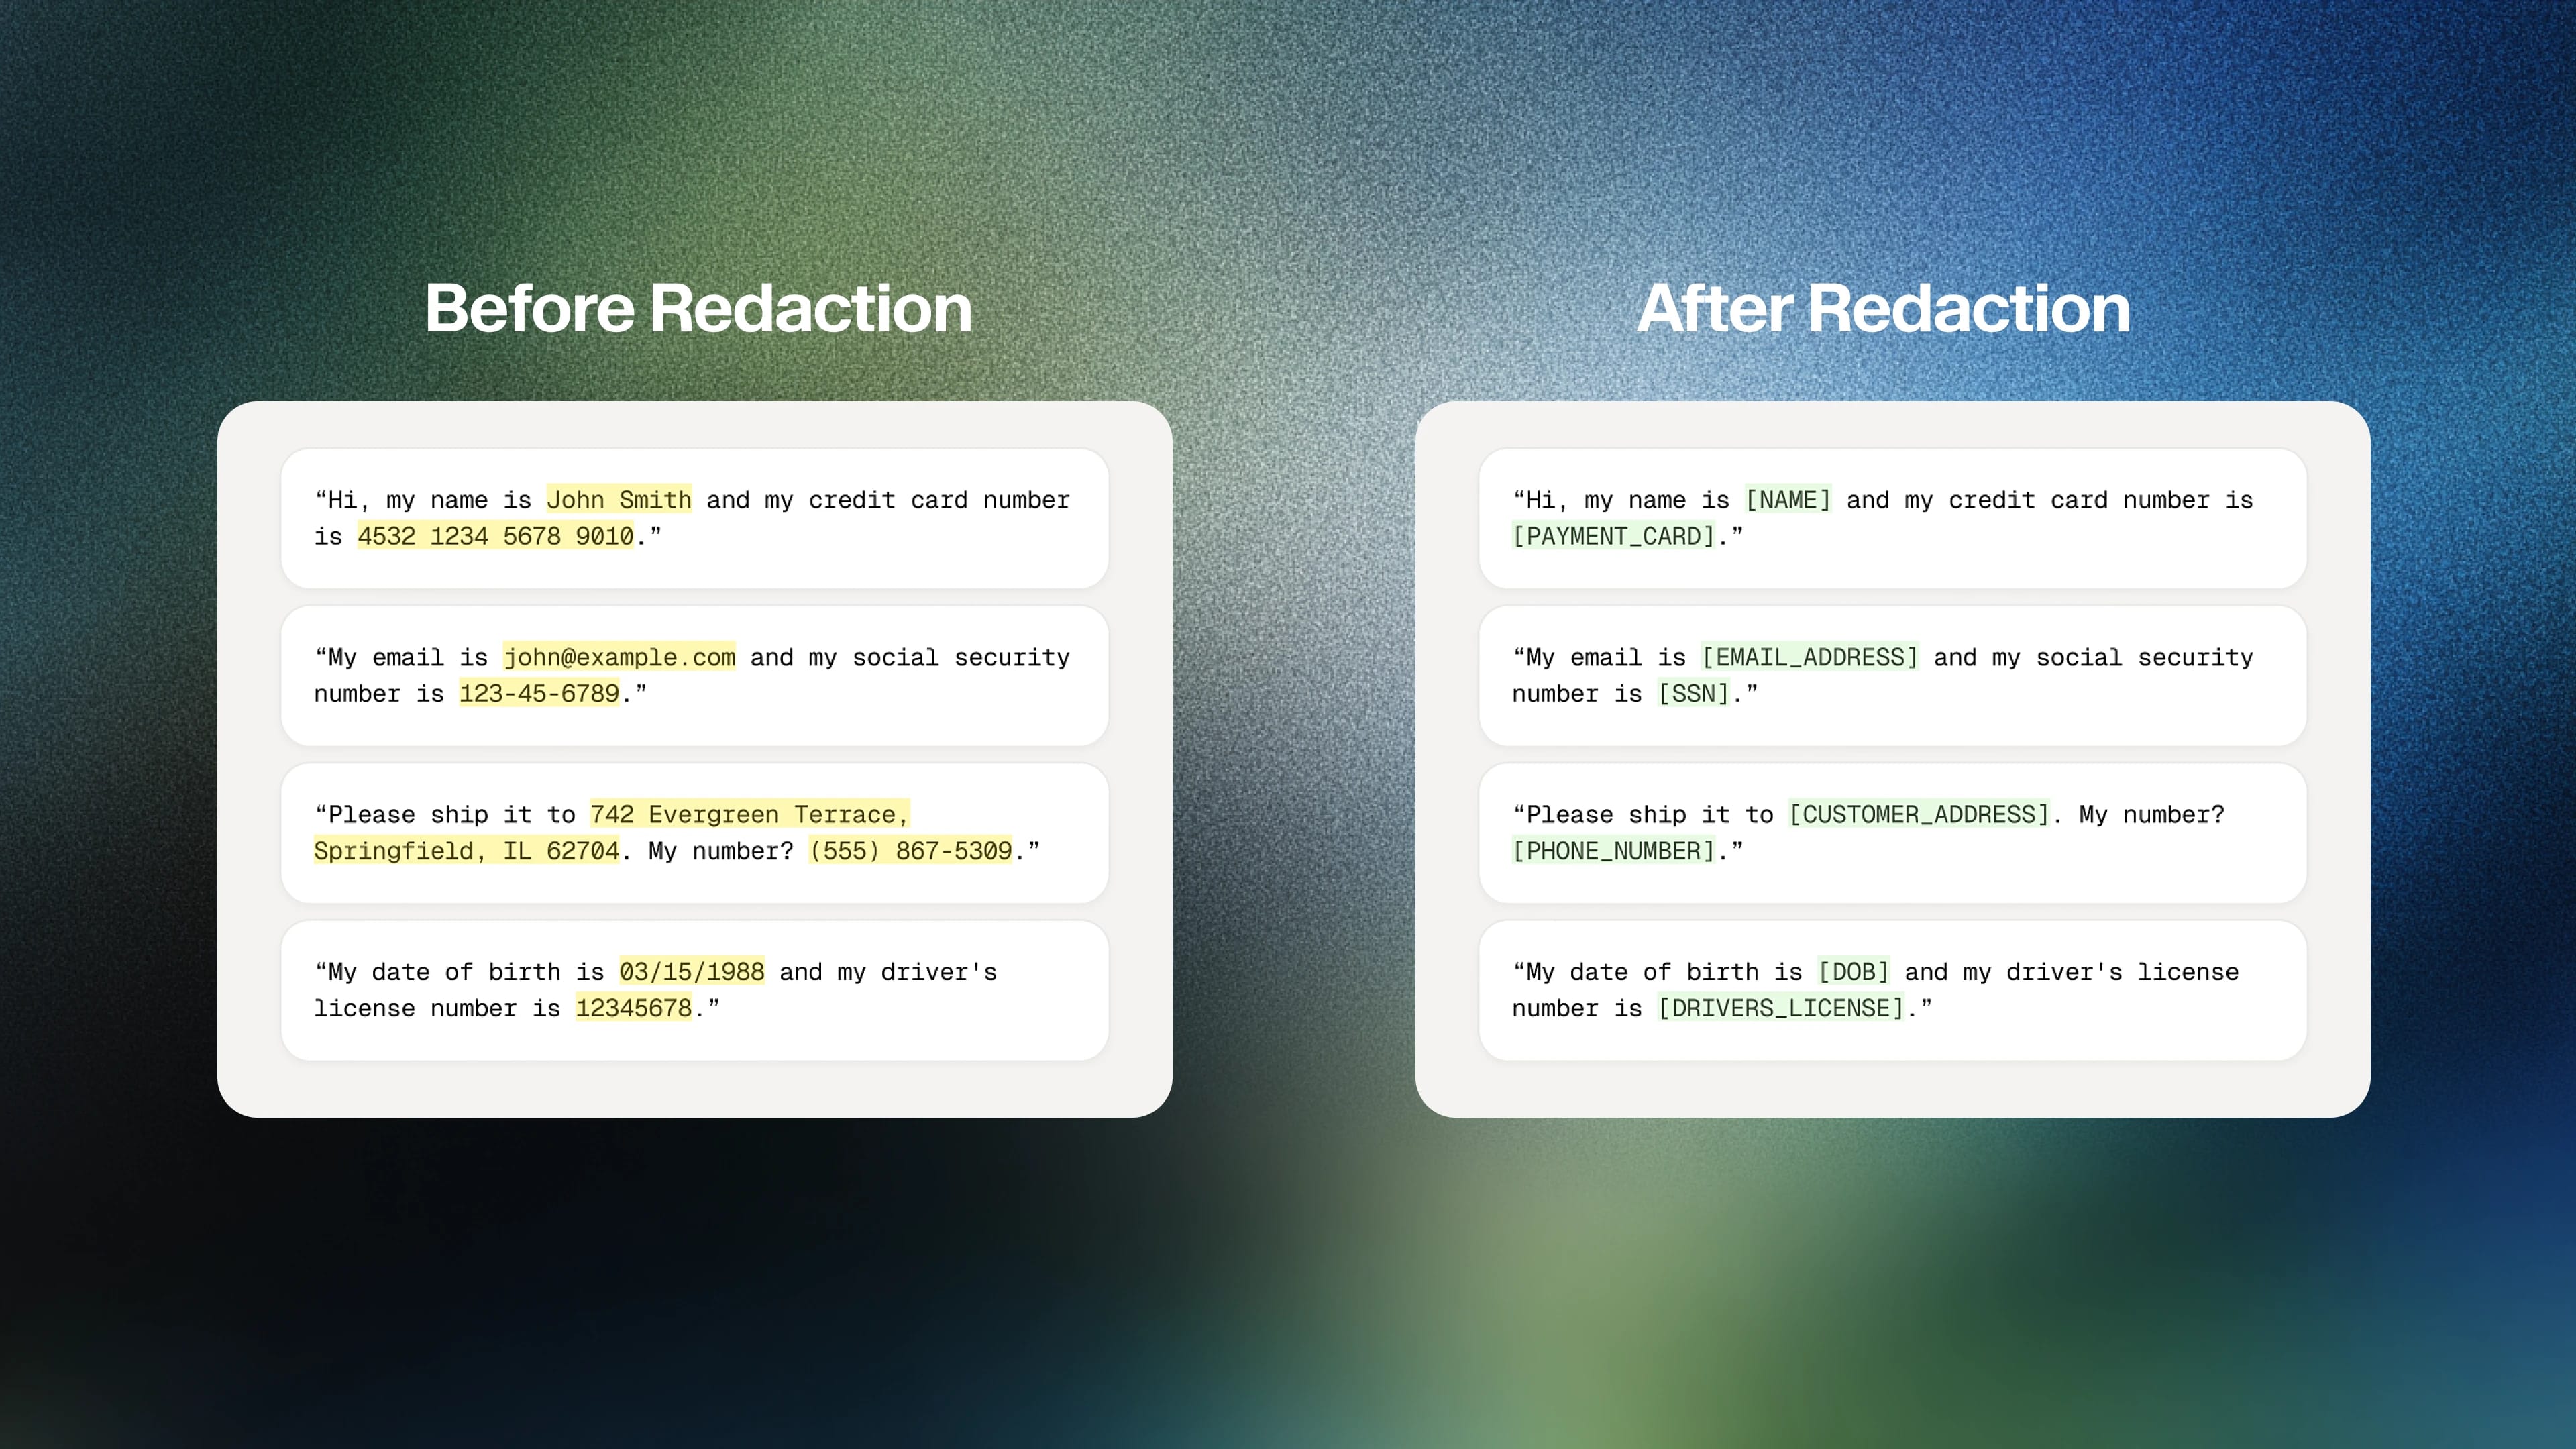
Die Schwärzung des Gesprächsverlaufs und der Zero Retention Mode sind für Unternehmenskunden verfügbar. Vertrieb kontaktieren für Zugang.
Teil einer umfassenderen Grundlage für Vertrauen und Sicherheit
Guardrails 2.0 und Datenschutzfunktionen unterstützen Unternehmensbereitstellungen von ElevenAgents – zusammen mit Sicherheitstools für jede Phase des Agent-Lebenszyklus:
Agent-Entwicklung
- System-Prompt-Design, Guardrail-Konfiguration, Red Teaming und Simulationen, um das Verhalten vor dem Produktivstart von Agents auf Belastbarkeit zu testen
Jedes Gespräch
- Währenddessen: Guardrails 2.0 (Focus, Manipulation, Content und Custom Guardrails), Protokollierung, optionaler Zero Retention Mode
- Danach: Bewertungskriterien, Monitoring, optionale Schwärzung des Gesprächsverlaufs
Zusammen geben diese Teams die Kontrolle, die sie benötigen, um mit weniger Vorfällen, schnelleren Genehmigungszyklen und konsistenterem Agent-Verhalten vom Pilotprojekt in die Produktion zu gehen. Diese Grundlagen der Plattform unterstützen außerdem die Eignung für eine AIUC-1-Zertifizierung und den Zugang zu den ersten Versicherungspolicen für Agents der Branche.
Guardrails noch heute nutzen
Wir haben in den vergangenen Monaten schrittweise Funktionen eingeführt. Die vollständige Guardrails-2.0-Suite ist jetzt als Alpha-Version in ElevenAgents verfügbar.
Aktivieren Sie sie im Tab Sicherheit in den Einstellungen Ihres Agents oder konfigurieren Sie sie über die API. Für weitere Informationen zu Unternehmensbereitstellungen kontaktieren Sie unser Vertriebsteam.
Anleitungen zur Einrichtung und Best Practices finden Sie hier:
Eli is on the ElevenAgents growth team, helping drive awareness and adoption of conversational agents. Previously, he was on the growth teams at Rippling and Spot AI, and studied Management Science & Engineering at Stanford University.