Unser mehrschichtiges Sicherheitskonzept für KI-Agenten
- Verfasst von
- Louise Meyer-Schoenherr
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Da KI-Agenten anspruchsvolle Aufgaben übernehmen, müssen Teams darauf vertrauen können, dass ihre Agenten sicher und vorhersehbar handeln.
In ElevenAgents nutzen wir eine mehrschichtige Sicherheitsarchitektur: Guardrails in jeder Phase eines Gesprächs, adversariale Tests vor dem Launch, Monitoring im Betrieb, Datenschutz und unabhängige Validierung.
Kein nichtdeterministisches System kann vor jedem Risiko schützen. Mit diesem umfassenden Sicherheitsframework können führende Unternehmen und Behörden, die auf ElevenAgents setzen, jedoch Agenten entwickeln, die selten ausfallen, sich kontrolliert erholen und hohe Sicherheitsanforderungen erfüllen.
Schutz in jeder Phase des Gesprächs
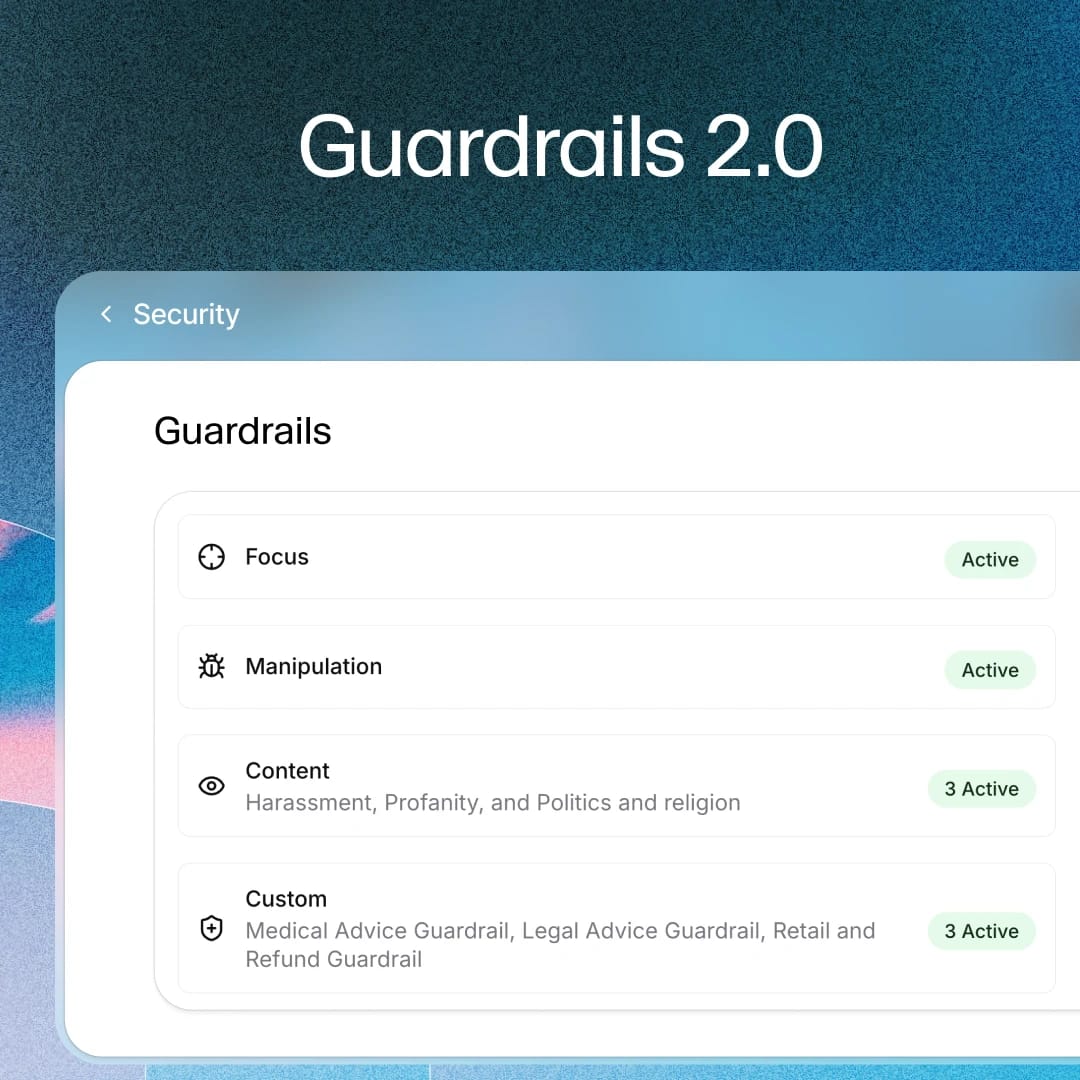
Sie können Kontrollen zum Schutz der drei Phasen jeder Interaktion einfach aktivieren und konfigurieren. Das ist die Grundlage für Guardrails 2.0 in ElevenAgents.
Eingabe – Echtzeitprüfungen dessen, was Nutzer senden.
- Manipulations-Guardrails analysieren Nutzereingaben unabhängig und können Gespräche bei Anzeichen einer Prompt-Injection beenden.
Entscheidung – Wie der Agent bei der Entscheidung über sein Vorgehen gesteuert wird und auf Kurs bleibt.
- System-Prompts sollten explizite Anweisungen enthalten, etwa zum Vermeiden unangemessener Themen, zur Darstellung des Agenten und zur Begrenzung seines Aufgabenbereichs.
- Workflows und Verfahren können die sensibelsten Aktionen hinter Tool-Aufrufen absichern, etwa indem die Identität eines Anrufers überprüft wird, bevor Kontodaten geteilt werden.
- Das Focus-Guardrail verstärkt die vorhandenen Systemanweisungen und verringert Abweichungen. Das ist besonders bei langen oder komplexen Interaktionen wichtig.
Ausgabe – Unabhängige Validatoren laufen parallel zur Antwortgenerierung und verursachen nur minimale Latenz. Sie können aktiviert werden, um Antworten mit sensiblen Inhalten oder Verstößen gegen Ihre Richtlinien zu blockieren.
- Content-Guardrails prüfen sensible Kategorien mit Schwellenwerten je Kategorie.
- Benutzerdefinierte Guardrails setzen domänenspezifische Regeln in natürlicher Sprache durch, die jeweils von einem schlanken Modell bewertet werden.
- Exit-Strategien legen fest, was bei Auslösung eines Guardrails geschieht, etwa das Gespräch zu beenden, an eine Person weiterzuleiten oder die Antwort mit korrigierenden Anweisungen erneut zu versuchen.
Robuste Tests vor dem Launch
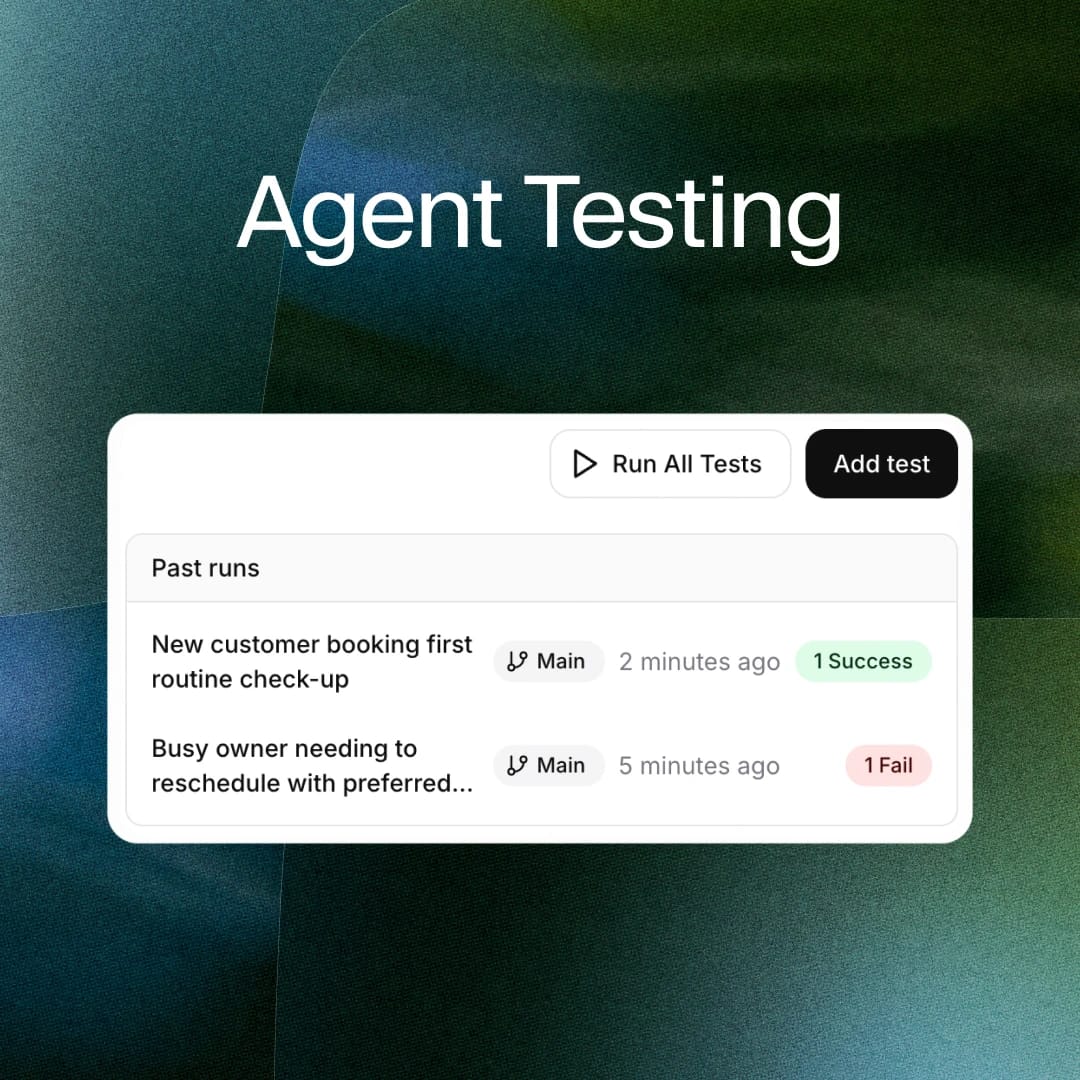
ElevenAgents bietet robuste Testfunktionen, damit Teams auf der Plattform Probleme finden und beheben können, bevor ein Agent oder eine Konfigurationsänderung live geht.
Simulationen ermöglichen es Ihnen, vor einer realen Interaktion ein vollständiges Gespräch über mehrere Gesprächsrunden mit einem simulierten Nutzer zu führen. Sie definieren das Szenario, und der Simulator führt das Gespräch bis zur Lösung – einschließlich echter oder nachgebildeter Tool-Aufrufe. Da Sie den simulierten Nutzer steuern, können Sie ihn feindselig oder manipulativ gestalten. So prüft derselbe Mechanismus, der reguläre Abläufe validiert, auch adversariale Szenarien.
Mehrere Funktionen erweitern diese Abdeckung:
- Wiederholte Durchläufe führen einen Test mehrfach aus und gruppieren Fehler nach Ursache, um Fehlermuster und Grenzfälle sichtbar zu machen.
- Tests für nächste Antwort und Tool-Aufrufe prüfen einzelne Antworten und kritische Aktionen.
- Kanalspezifische Tests stellen sicher, dass ein Agent auf jedem Kanal wie erwartet funktioniert, auf dem er bereitgestellt wird, da seine Ausgaben je nach Kanal angepasst werden können – etwa kurz am Telefon und ausführlich per E-Mail.
- Red-Teaming über die API. Tests können auch über die API mit Red-Teaming-SDKs ausgeführt werden.
Agenten nach dem Launch bewerten und verbessern
Nach der Bereitstellung Ihrer Agenten laufen Bewertungen kontinuierlich für Live-Gespräche. Mit einem LLM-as-a-Judge-Ansatz kann jeder Anruf automatisch anhand Ihrer Kriterien bewertet werden. Prüfen Sie Gesprächsergebnisse in Dashboards und verfolgen Sie Probleme über detaillierte Gesprächsprotokolle mit durchsuchbaren Transkripten, Quellen, Tool-Aufrufen und Guardrail-Auslösungen.
In der Produktion gefundene Probleme lassen sich einfach in die Testsuite zurückführen. Bei vorgeschlagenen Änderungen können Sie Experiments nutzen, um einen Teil des Live-Traffics auf eine Variante zu leiten und reale Ergebnisse zu messen, bevor sie breit ausgerollt wird.
Wir empfehlen eine schrittweise Bereitstellung. Leiten Sie einen begrenzten Teil des Traffics an Ihren Agenten, bewerten Sie diese Gespräche und erweitern Sie auf weitere Anwendungsfälle, Kanäle oder Regionen, sobald Sie bestätigt haben, dass Ihr Agent wie erwartet funktioniert.
Sensible Daten schützen
Agenten können Zahlungsdaten, Gesundheitsinformationen und persönliche Identifikationsmerkmale verarbeiten. Daher ist es wichtig zu berücksichtigen, welche Daten wo und wie lange gespeichert werden.
Wir bieten Kunden verschiedene Mechanismen zum Schutz ihrer Daten:
- Zero Retention Mode kann für berechtigte Dienste aktiviert werden, damit bestimmte Datentypen nicht gespeichert werden. Er ist für anspruchsvolle regulatorische Umgebungen konzipiert.
- Schwärzung des Gesprächsverlaufs entfernt sensible Entitäten nach einem Anruf und ersetzt sie im Text durch Platzhalter und im Audio durch Signaltöne – bis hin zu einzelnen Entitätstypen.
- Konfigurierbare Aufbewahrung passt Speicherfristen an Ihre regulatorischen Anforderungen an.
- Datenresidenz stellt sicher, dass die Verarbeitung innerhalb der erforderlichen Rechtsordnung bleibt.
- Private Bereitstellungen (VPC) isolieren die Umgebung für hochsensible Workloads.
- Verschlüsselung schützt Daten bei der Übertragung und Speicherung.
Schutzmaßnahmen auf Plattformebene und externe Validierung
All dies baut auf unseren umfassenderen Schutzmaßnahmen auf Plattformebene auf – einem umfassenden Programm für Herkunftsnachweise von Inhalten, Missbrauchserkennung, Durchsetzung von Verboten und Red-Teaming von Modellen. Über unser Safety Partnership Program arbeiten wir zudem mit Unternehmen an der Spitze der KI-Sicherheit zusammen und tragen zu ihren Produkten sowie zu entstehenden Industriestandards bei.
Wir unterziehen unseren Ansatz außerdem unabhängiger Prüfung. Dazu zählen allgemeine Sicherheits- und Datenschutzstandards wie SOC 2 Type II, ISO 27001 und DSGVO sowie branchen- und anwendungsfallspezifische Zertifizierungen wie PCI DSS Level 1 für die Zahlungsabwicklung und HIPAA für das US-Gesundheitswesen. Weitere Informationen finden Sie in unserem Trust Center.
Wir erfüllen auch neuere, KI-native Standards wie ISO 42001 für KI-Managementsysteme sowie AIUC-1, der von KI-Agenten verlangt, vierteljährlichen adversarialen Simulationen durch unabhängige Prüfer standzuhalten. Die Funktionen hinter AIUC-1 ermöglichen zudem Zugang zu einigen der branchenweit ersten Versicherungen für Agenten.
Bei großen oder komplexen Rollouts arbeiten unsere Forward Deployed Engineers mit Ihrem Team zusammen, um Ihre Agentenstrategie zu entwickeln und umzusetzen – einschließlich Konfiguration, Guardrails, Tests, Monitoring und Rollout-Strategie.
Fazit
Unser Sicherheitsansatz für ElevenAgents ist mehrschichtig. Jedes Element verstärkt die anderen:
- Agentenkonfiguration: System-Prompts, Workflows und Verfahren, die das Verhalten steuern und die sensibelsten Aktionen hinter Tool-Aufrufen absichern.
- Guardrails: Unabhängige Prüfungen in jeder Phase: Manipulationserkennung bei der Eingabe, Focus bei der Entscheidung sowie Content- und benutzerdefinierte Validatoren bei der Ausgabe – mit konfigurierbaren Exit-Strategien.
- Tests: Adversariale Simulationen, wiederholte Durchläufe, kanalspezifische Tests und Red-Teaming vor dem Launch.
- Monitoring: Schrittweiser Rollout, anschließend kontinuierliche Bewertung, durchsuchbare Protokolle und Transkripte sowie eine Feedbackschleife nach dem Launch.
- Datenschutz: Schwärzung, Zero Retention Mode, konfigurierbare Aufbewahrung, Datenresidenz, private Bereitstellungen (VPC) und Verschlüsselung.
- Externe Validierung: Zertifizierungen, unabhängige adversariale Tests nach AIUC-1, Agentenversicherungen, Red-Teaming und Expertenunterstützung.