Wie wir unsere Kundeninterviews mit ElevenLabs Agents skaliert haben
- Verfasst von
- Jack McDermott
- Veröffentlicht
AnhörenArtikel anhören
Wir haben ElevenLabs Agents genutzt, um mehr als 230 Nutzer unserer ElevenReader-App zu interviewen.
In diesem Beitrag zeigen wir, wie wir den Sprachagenten entwickelt haben, welche Ergebnisse dieser Produktionstest lieferte und wie Sie diese Tools zur Verbesserung Ihres eigenen Produkts nutzen können.
Die Herausforderung der Skalierung
Kundeninterviews sind uns wichtig, doch sie zu skalieren ist schwierig. Ein typisches 15-minütiges Live-Interview liefert wertvolle Erkenntnisse, aber mehr als wenige pro Tag zu planen, ist logistisch anspruchsvoll.
Termine stimmen selten überein. Für ein kleines Team ist es fast unmöglich, eine globale Nutzerschaft in Dutzenden Sprachen zu betreuen – tiefgehende Gespräche rund um die Uhr sind physisch nicht machbar.
Umfragen lassen sich zwar leichter skalieren, gehen aber oft mit Informationsverlust einher. Sie reduzieren Feedback auf Multiple-Choice-Optionen und erfassen weder Emotionen noch die Nuancen eines 1:1-Gesprächs. Fortschritte bei Voice-KI und LLMs ermöglichen es uns jetzt, diese Lücke zu schließen.
Mit ElevenLabs Agents haben wir einen KI-Interviewer entwickelt, der durch echte Gespräche Nutzerfeedback sammelt. Wir führten in weniger als 24 Stunden über 230 Interviews und haben anhand dieser Kundenerkenntnisse bereits Verbesserungen für die App veröffentlicht.

Den KI-Interviewer entwickeln
Wir nutzten die Plattform ElevenLabs Agents, um einen dialogfähigen Research-Agenten zu entwickeln. Unser Ziel war es, die Sicht der Nutzer der ElevenReader-App in vier zentralen Bereichen zu verstehen:
- Funktionswünsche und Verbesserungen
- Wichtigste Anwendungsfälle
- Vergleiche mit Wettbewerbern
- Preisgestaltung und Markenwert
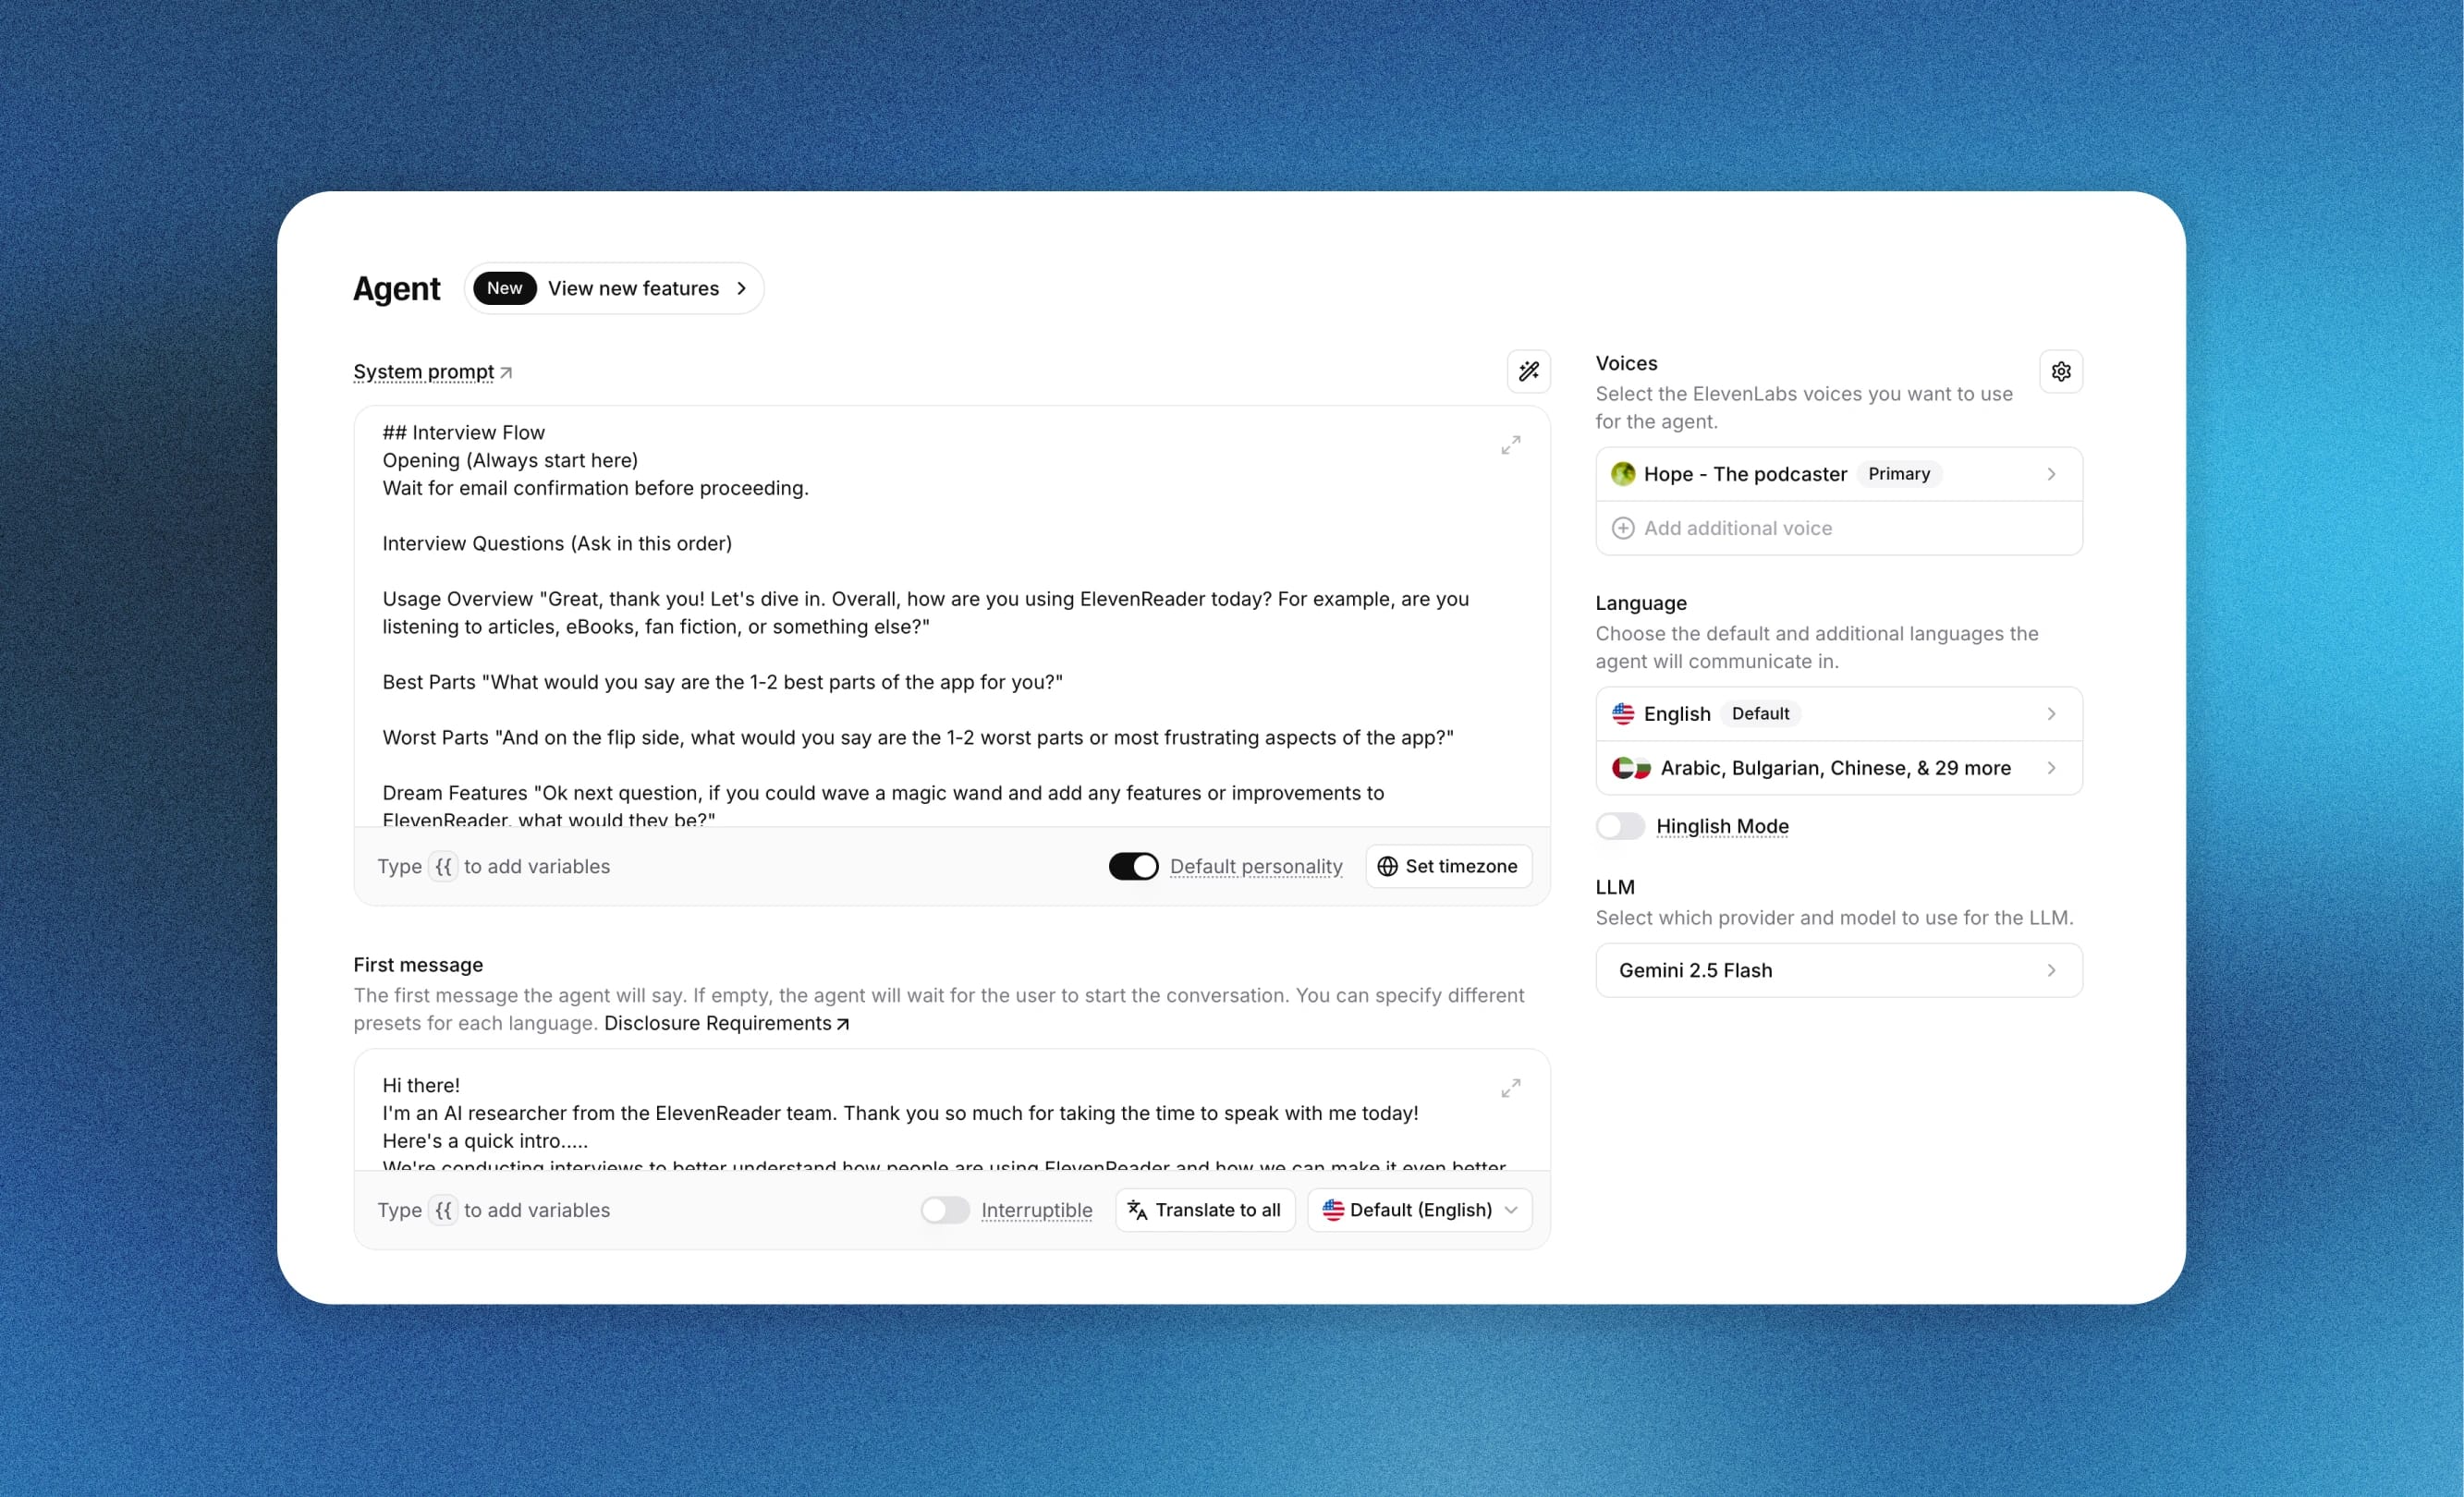
Wir wählten die Stimme „Hope - The podcaster“ wegen ihres freundlichen, dialogorientierten Tons – es fühlt sich an, als säße man einer empathischen Forscherin gegenüber. Für die Logik wählten wir Gemini 2.5 Flash als Balance aus geringer Latenz und hoher Intelligenz.
Prompting und Leitplanken
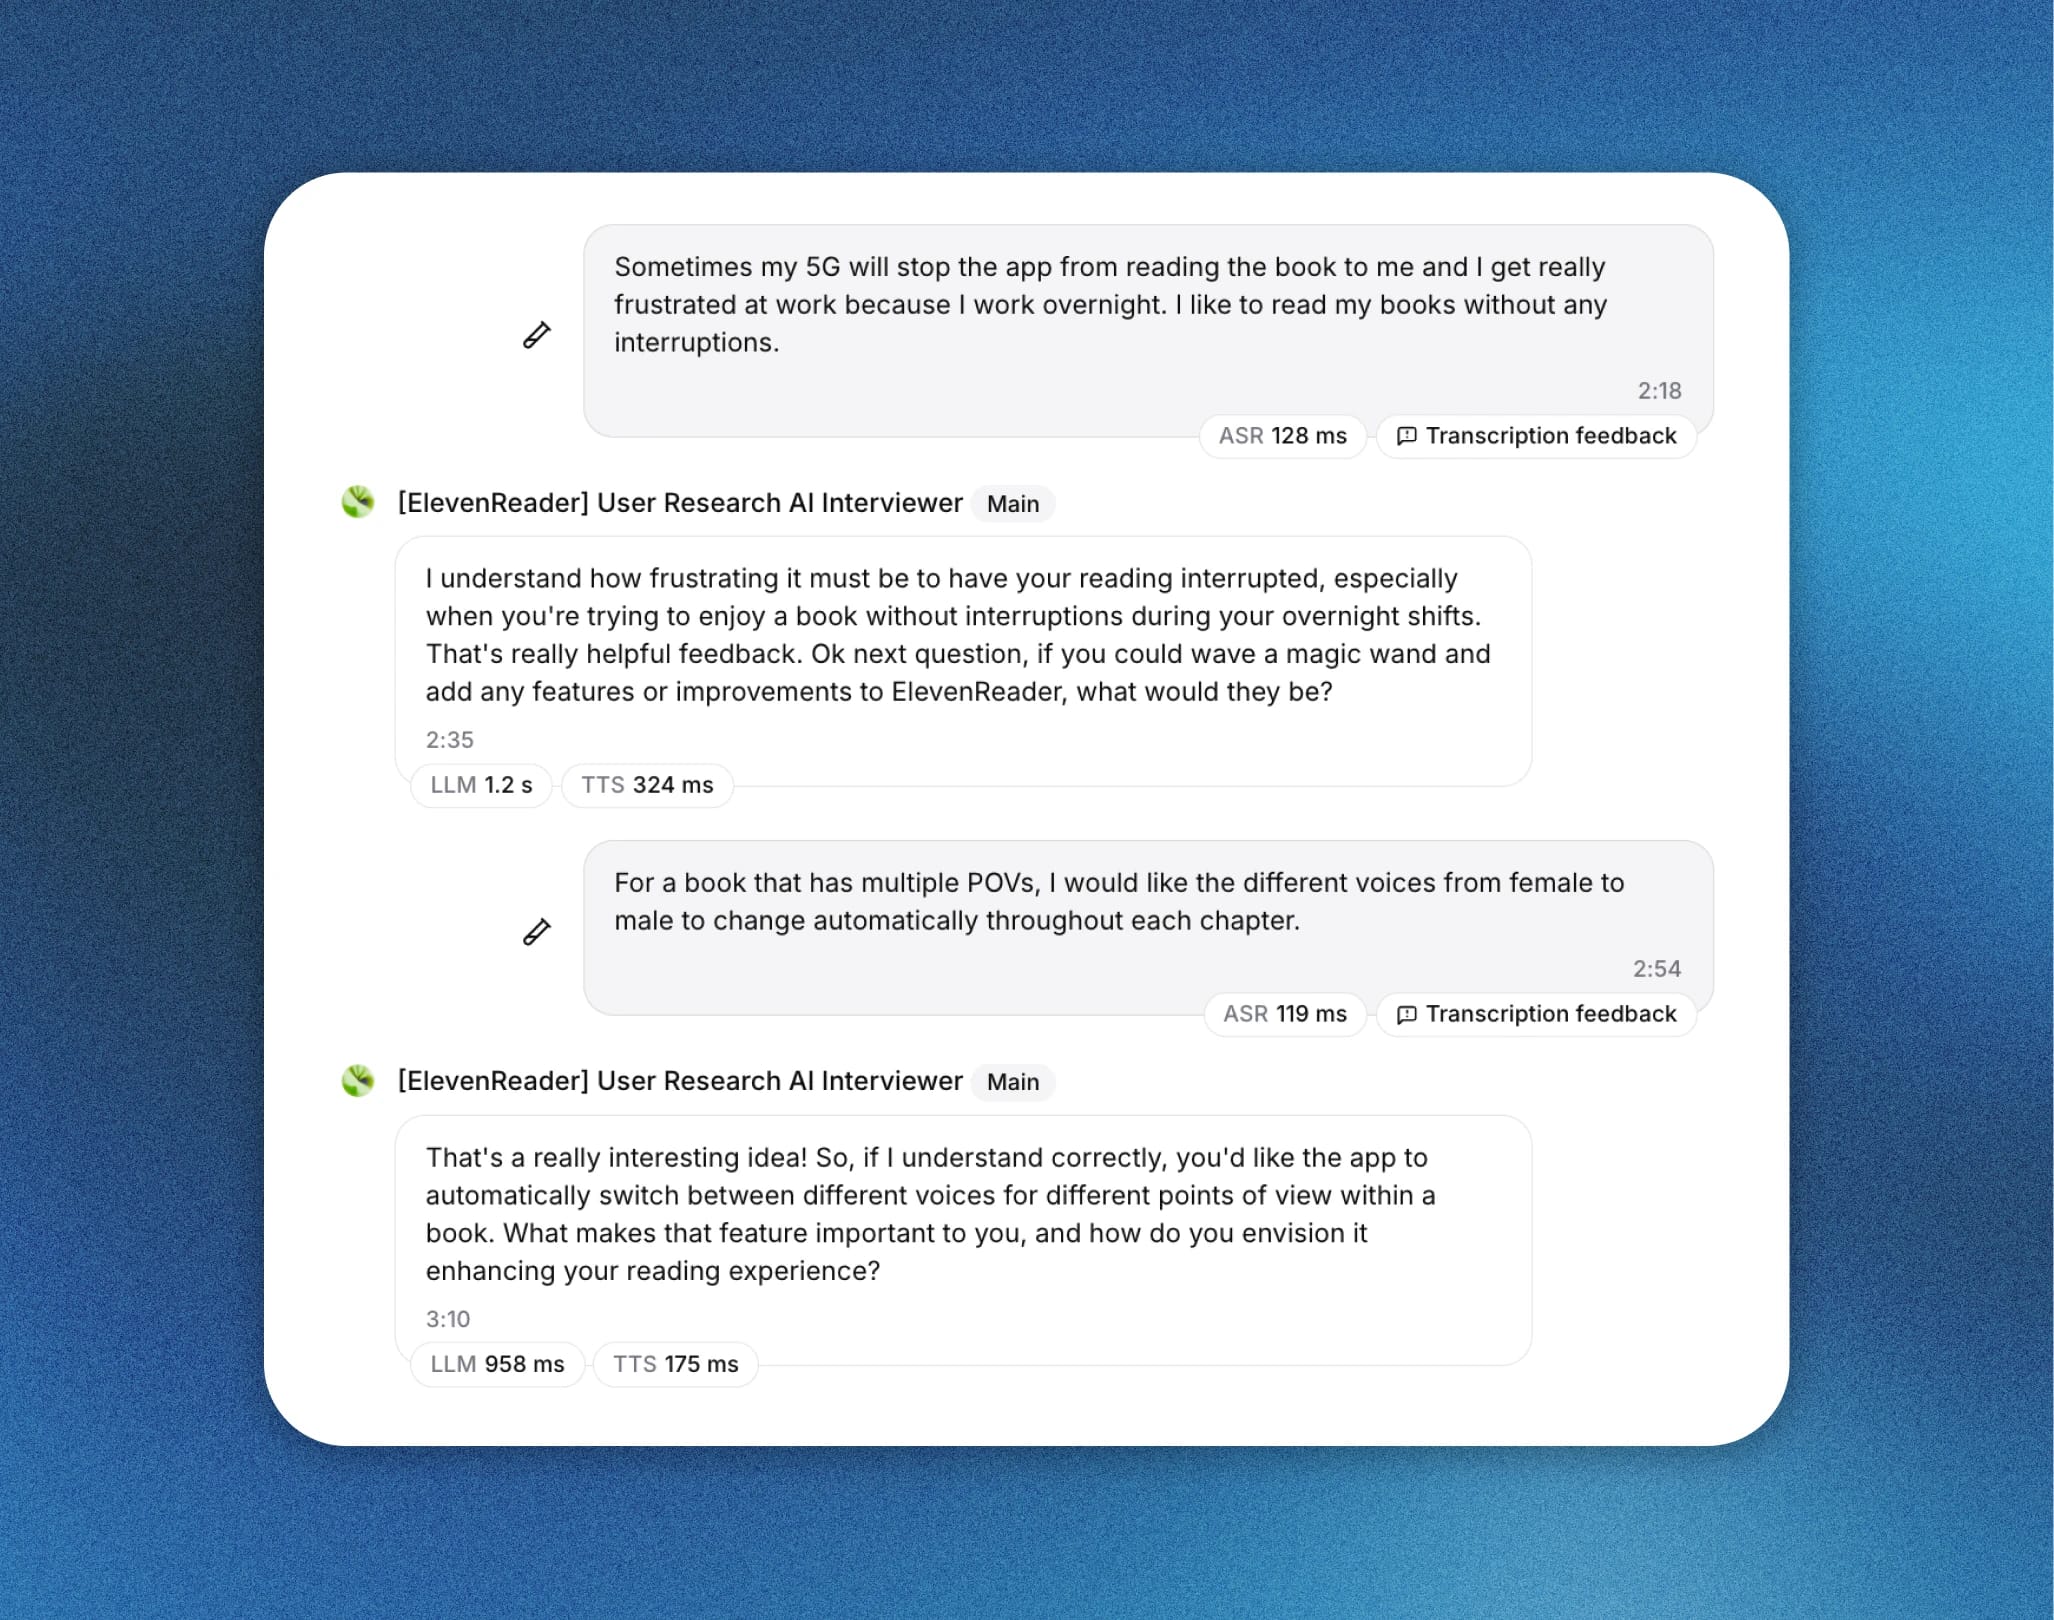
Wir erstellten einen System-Prompt, der den Agenten anwies, für tiefere Erkenntnisse Nachfragen zu stellen und das Gespräch gleichzeitig auf Kurs zu halten. Antwortete ein Nutzer vage oder nur mit einem Wort, forderte der Agent detaillierteres Feedback an. Vor dem Start nutzten wir simulierte Tests von ElevenLabs, um sicherzustellen, dass der Agent auch Grenzfälle wie vage Antworten oder unangemessene Sprache bewältigt.
Hier finden Sie den von uns verwendeten System-Prompt.
Datenerfassung
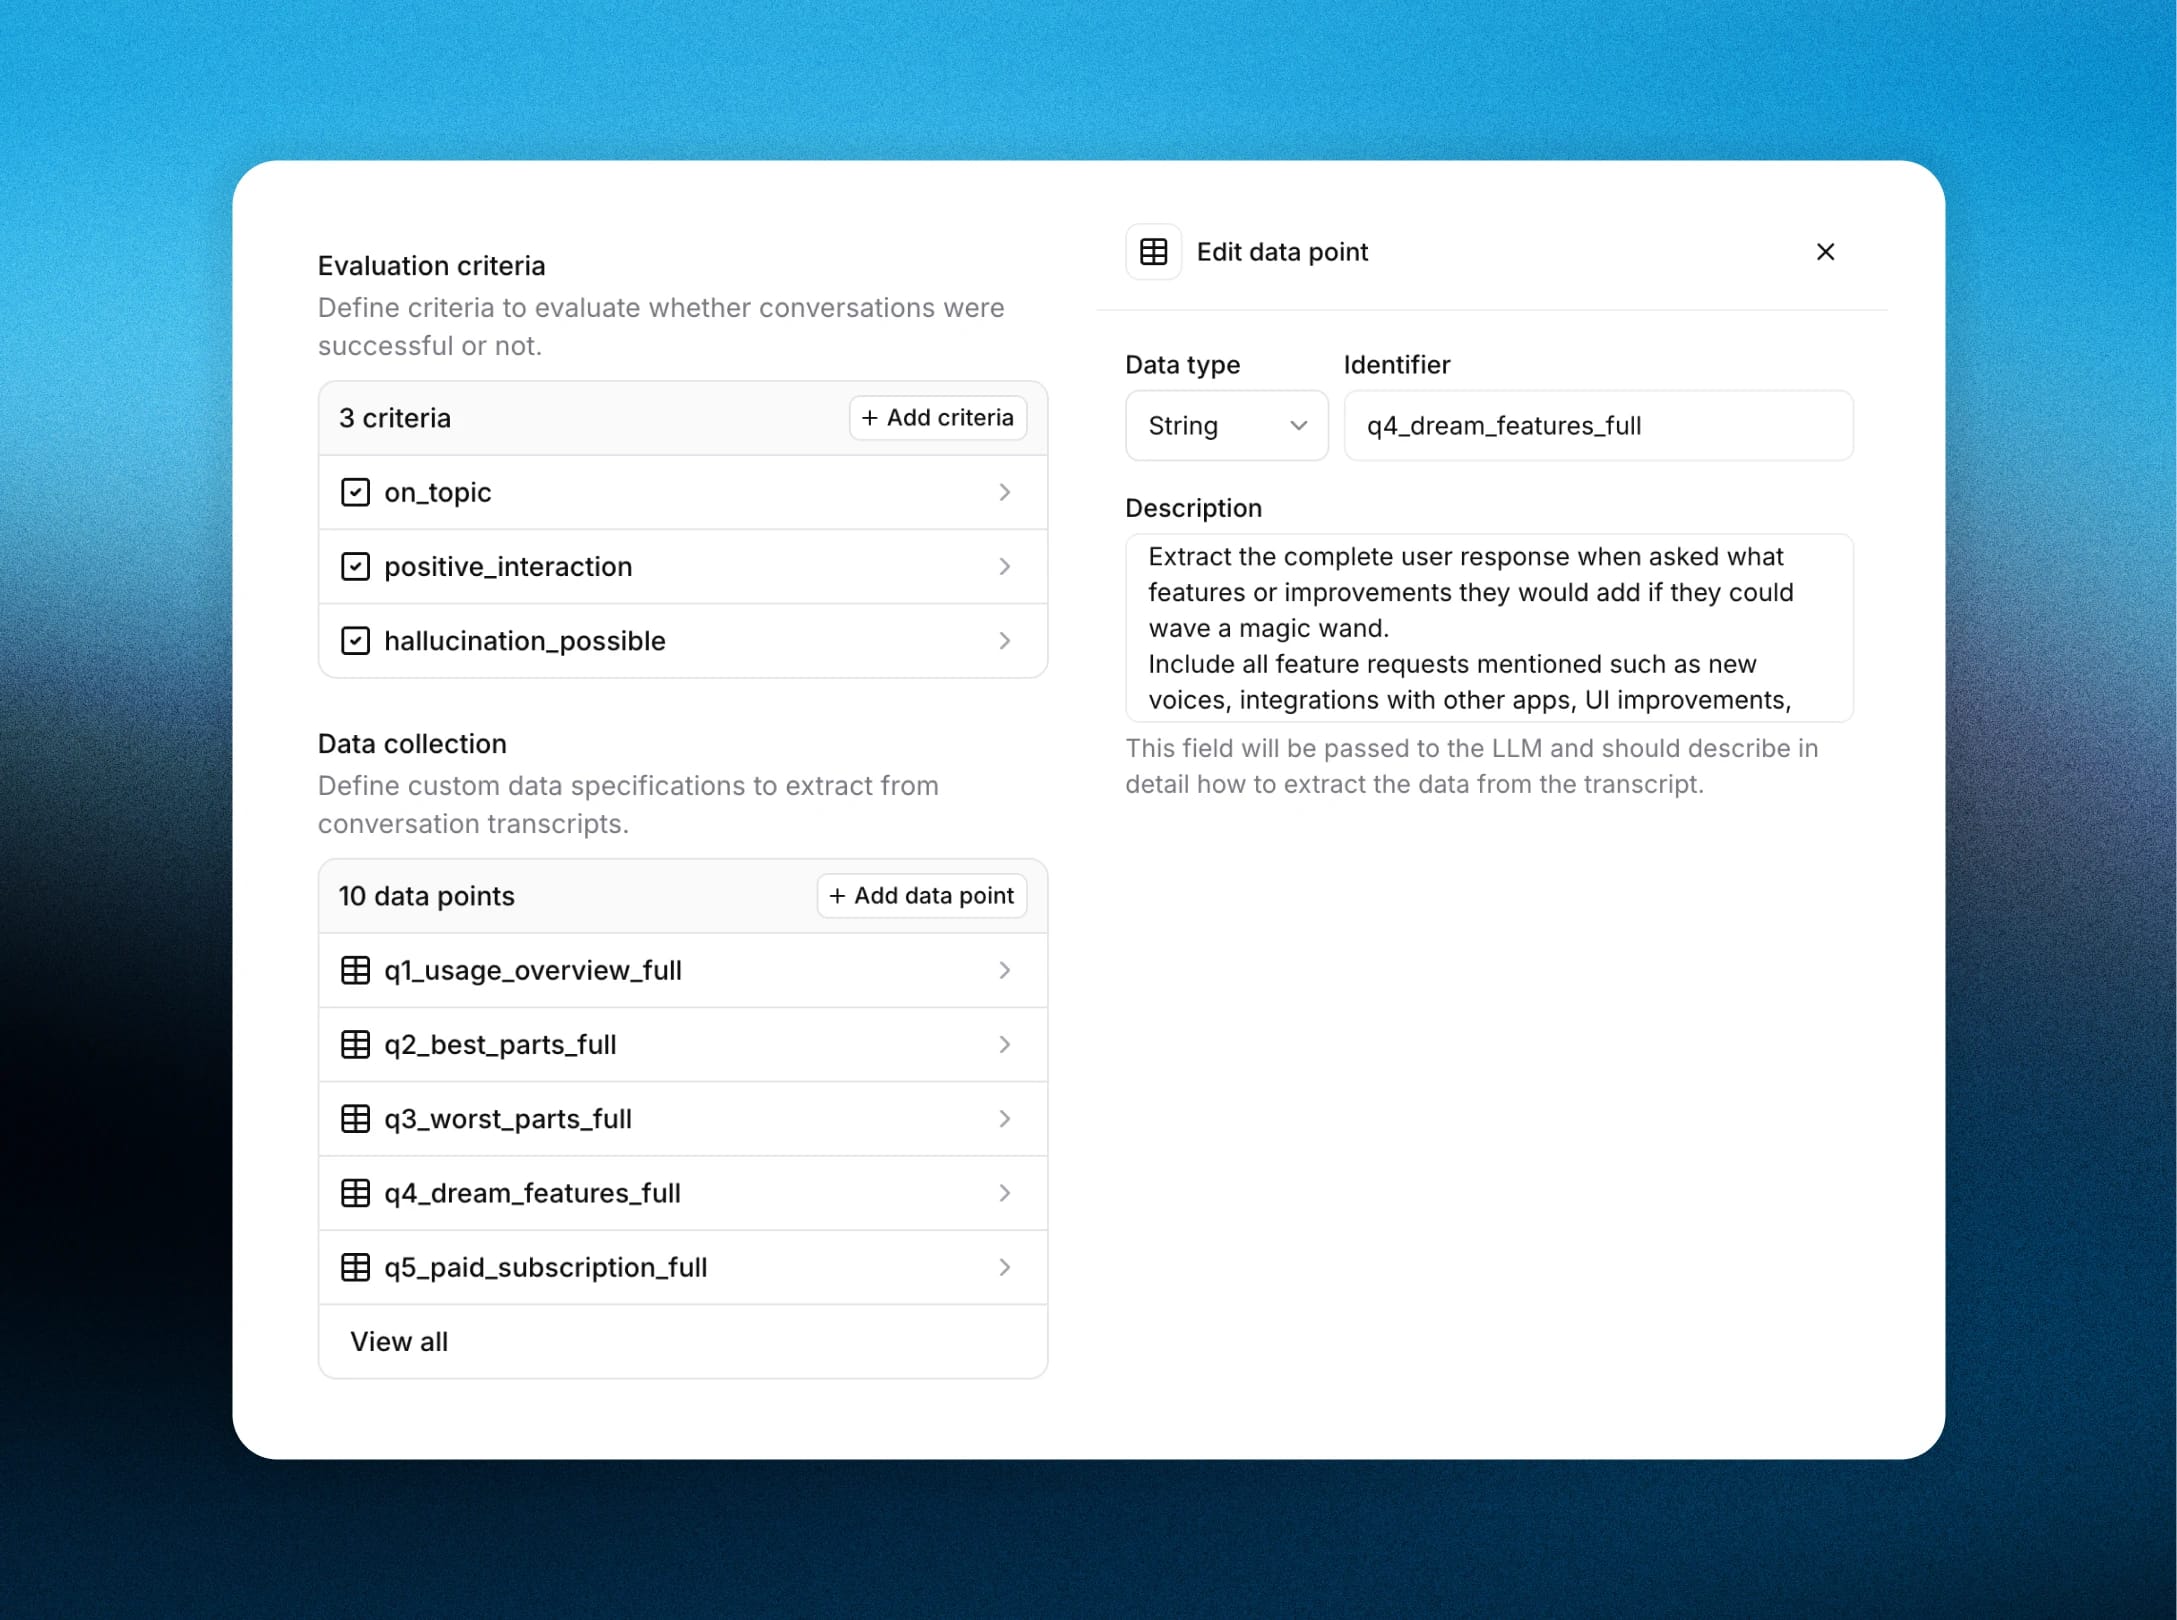
Wir nutzten die Funktion Analyse in ElevenLabs Agents, um jeden Anruf auszuwerten. Das Tool extrahiert strukturierte Daten aus Transkripten und ermöglicht uns, offene Gespräche in konkrete Erkenntnisse zu überführen. So konnten wir beispielsweise die Antworten auf folgende Fragen automatisch erfassen:
- „Wie nutzen Sie ElevenReader heute hauptsächlich?“
- „Auf welche zwei Arten würden Sie die App verbessern?“
Der Agent nutzte das Tool end_call, um Gespräche nach zehn Minuten zu beenden und den Nutzern höflich für ihre Zeit zu danken.
Die Ergebnisse
Innerhalb von 24 Stunden sammelten wir insgesamt mehr als 36 Stunden Gesprächszeit.
- Erfolgsrate: 85 % der Anrufe waren erfolgreich und thematisch relevant.
- Interaktion: Die mittlere Gesprächsdauer lag bei 10 Minuten, dem erlaubten Maximum.
- Tiefe: Ein Gespräch umfasste 87 Nachrichten. Der Median lag bei 25 Nachrichten.
- Kosten: Jeder 10-minütige Anruf kostete knapp unter 1,00 US-Dollar beziehungsweise 9 Cent pro Minute – vollständig gehostet über ElevenLabs Agents
Die Daten analysieren
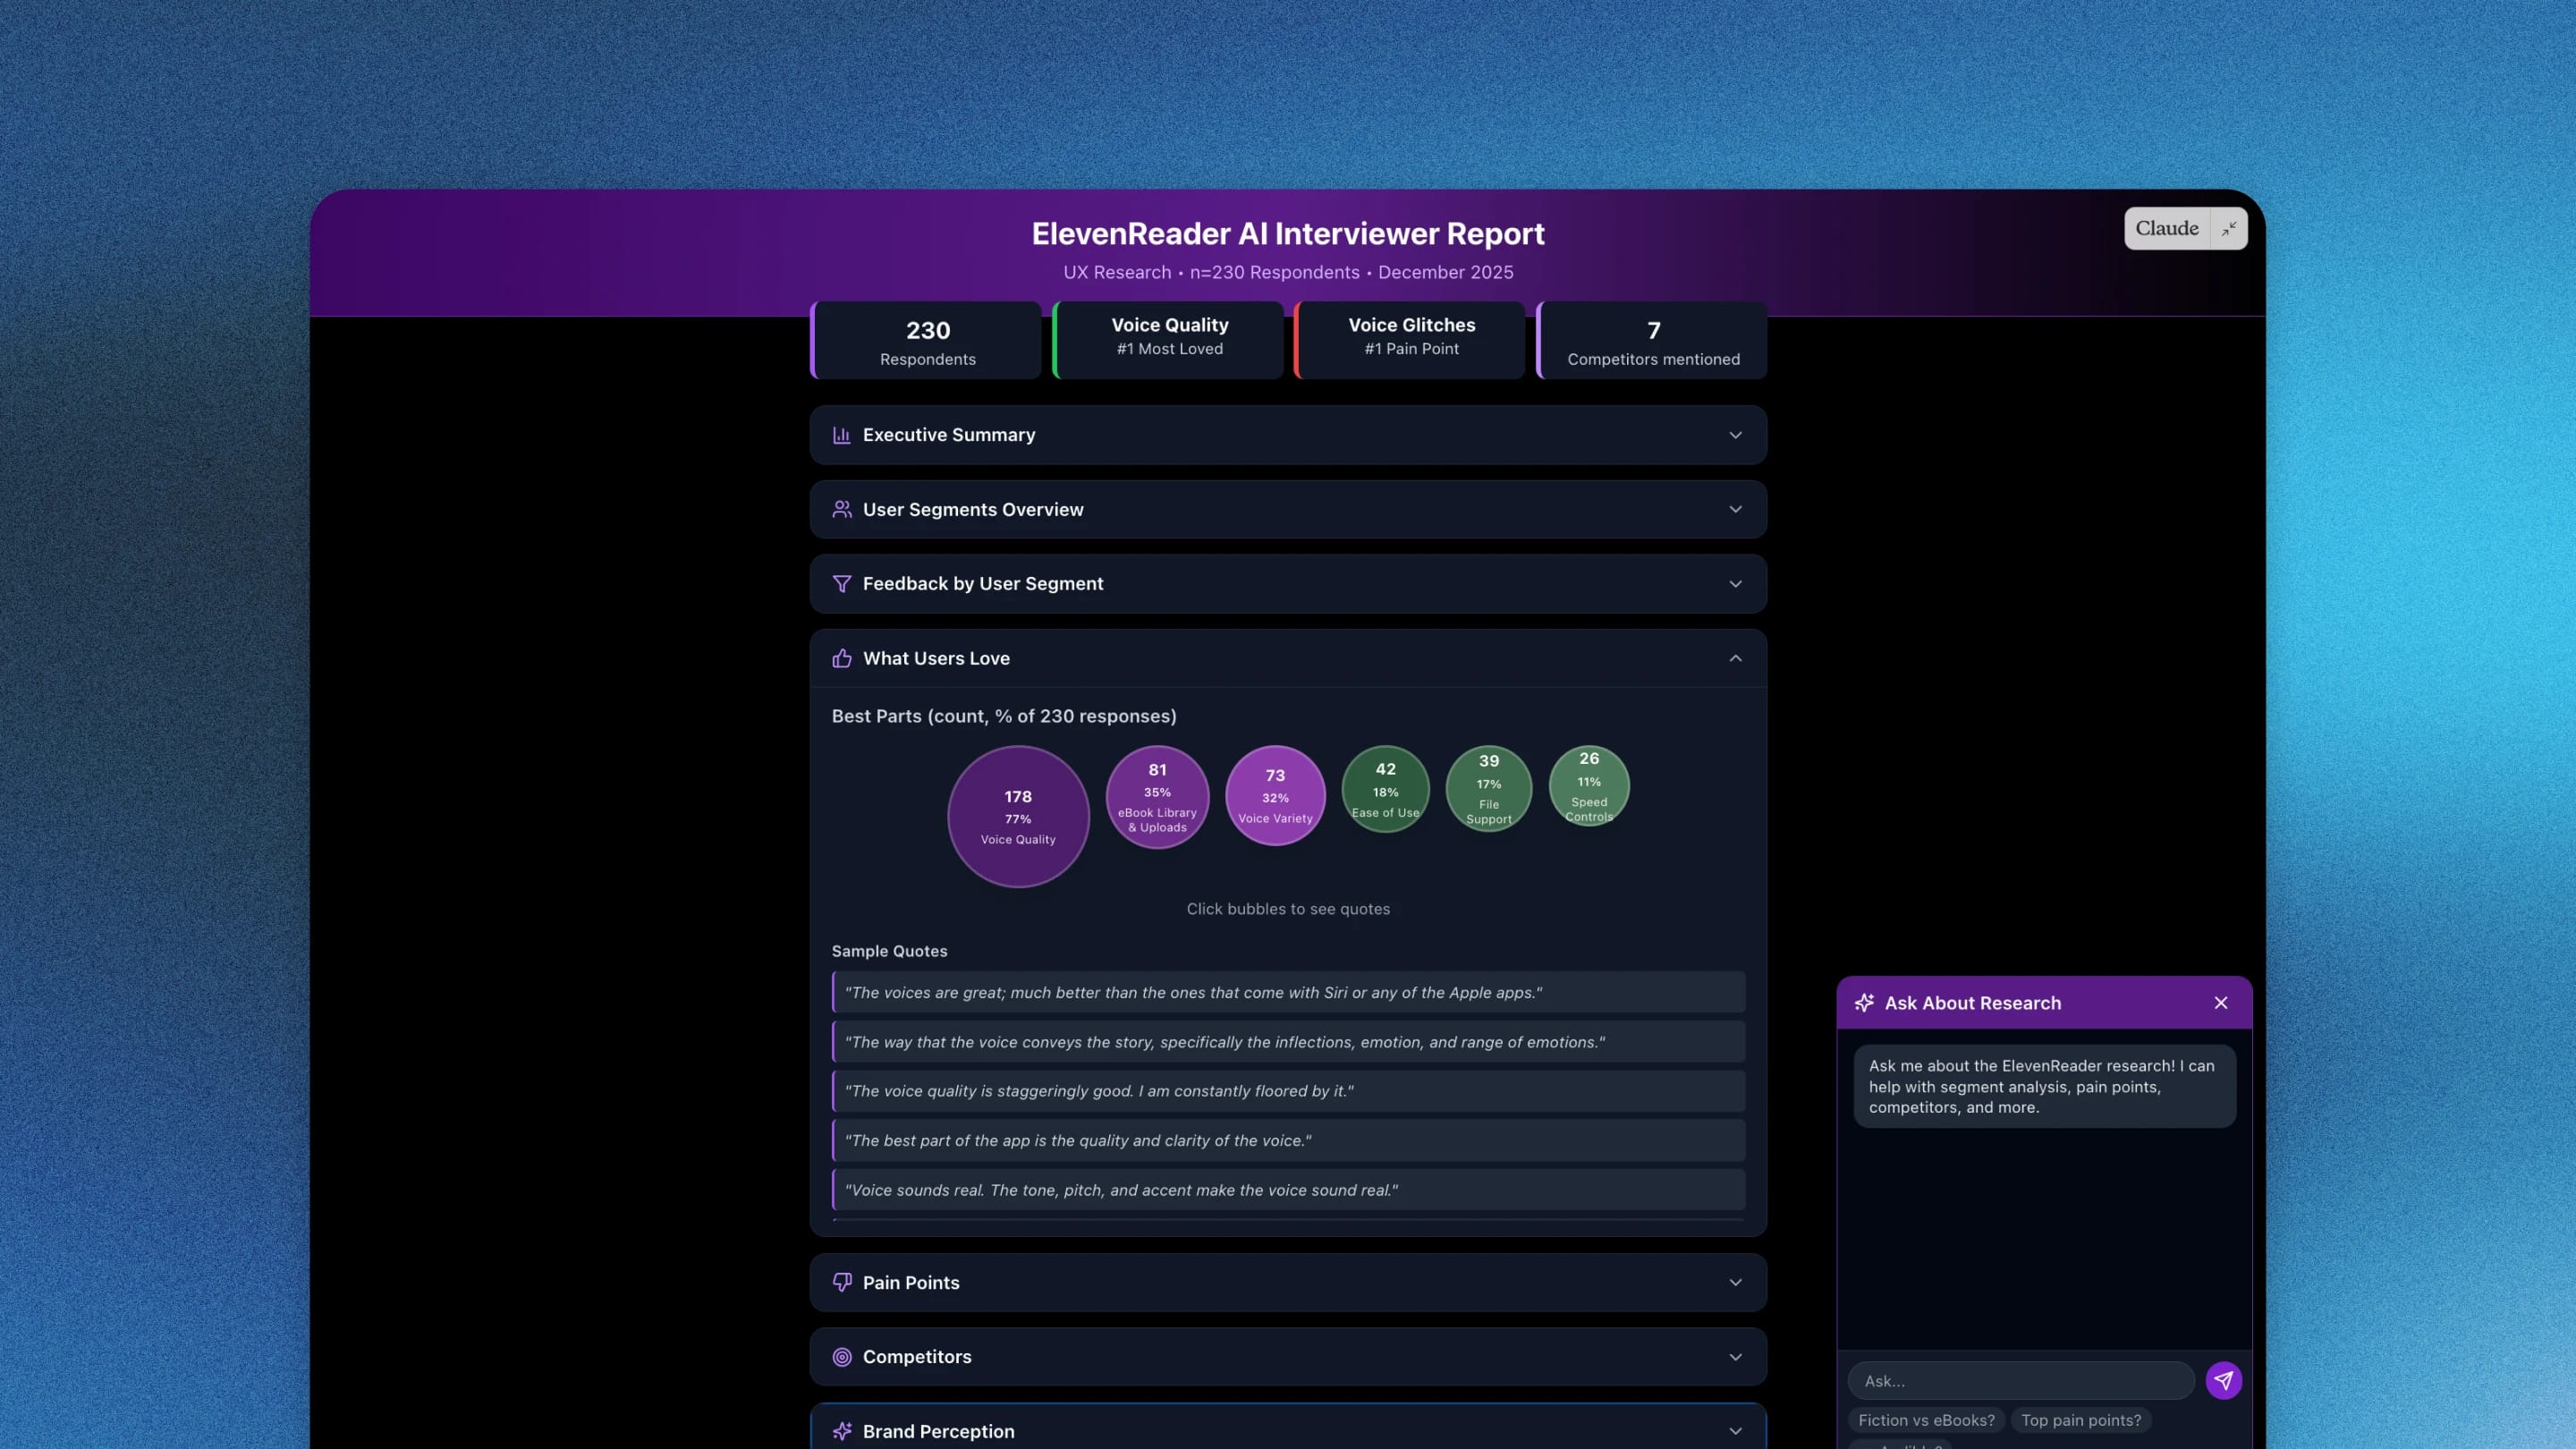
Wir nutzten Claude Opus 4.5, um die 36 Stunden an Transkripten anhand von UX-Research-Prinzipien auf Trends und Erkenntnisse zu analysieren.
Das Modell lieferte übergeordnete Themen. Mit zusätzlichen Prompts verfeinerten wir die Analyse, um detaillierte Erkenntnisse wie Nutzersegmentierung, Feedback zur Navigation und regionale Preissensitivität sichtbar zu machen.
Um diese Ergebnisse intern zu teilen, erstellten wir mit Claude ein interaktives Artefakt. Unser Team kann jetzt bestimmte Datenpunkte auswählen und die exakten Nutzerzitate sehen, auf denen der jeweilige Trend basiert.
Zentrale Erkenntnisse
Nutzer fühlten sich wohl dabei, mit einer KI zu sprechen – fast 95 % der Befragten interagierten direkt mit dem Interviewer, ohne anzuerkennen, dass es sich um einen dialogfähigen Agenten handelte. Ein Nutzer sagte:
„Nun, dieses Kundenservice-Interview ist wohl die bemerkenswerteste KI-Erfahrung, die ich je hatte. Ich wünschte, alle Fragebögen wären so und alle digitalen Kundenservices wären so.“
Wir haben gelernt:
- Segmentierte Bedürfnisse: 21 % der Belletristikleser von ElevenReader wünschten sich Dialoge mit mehreren Figuren – deutlich mehr als andere Nutzersegmente.
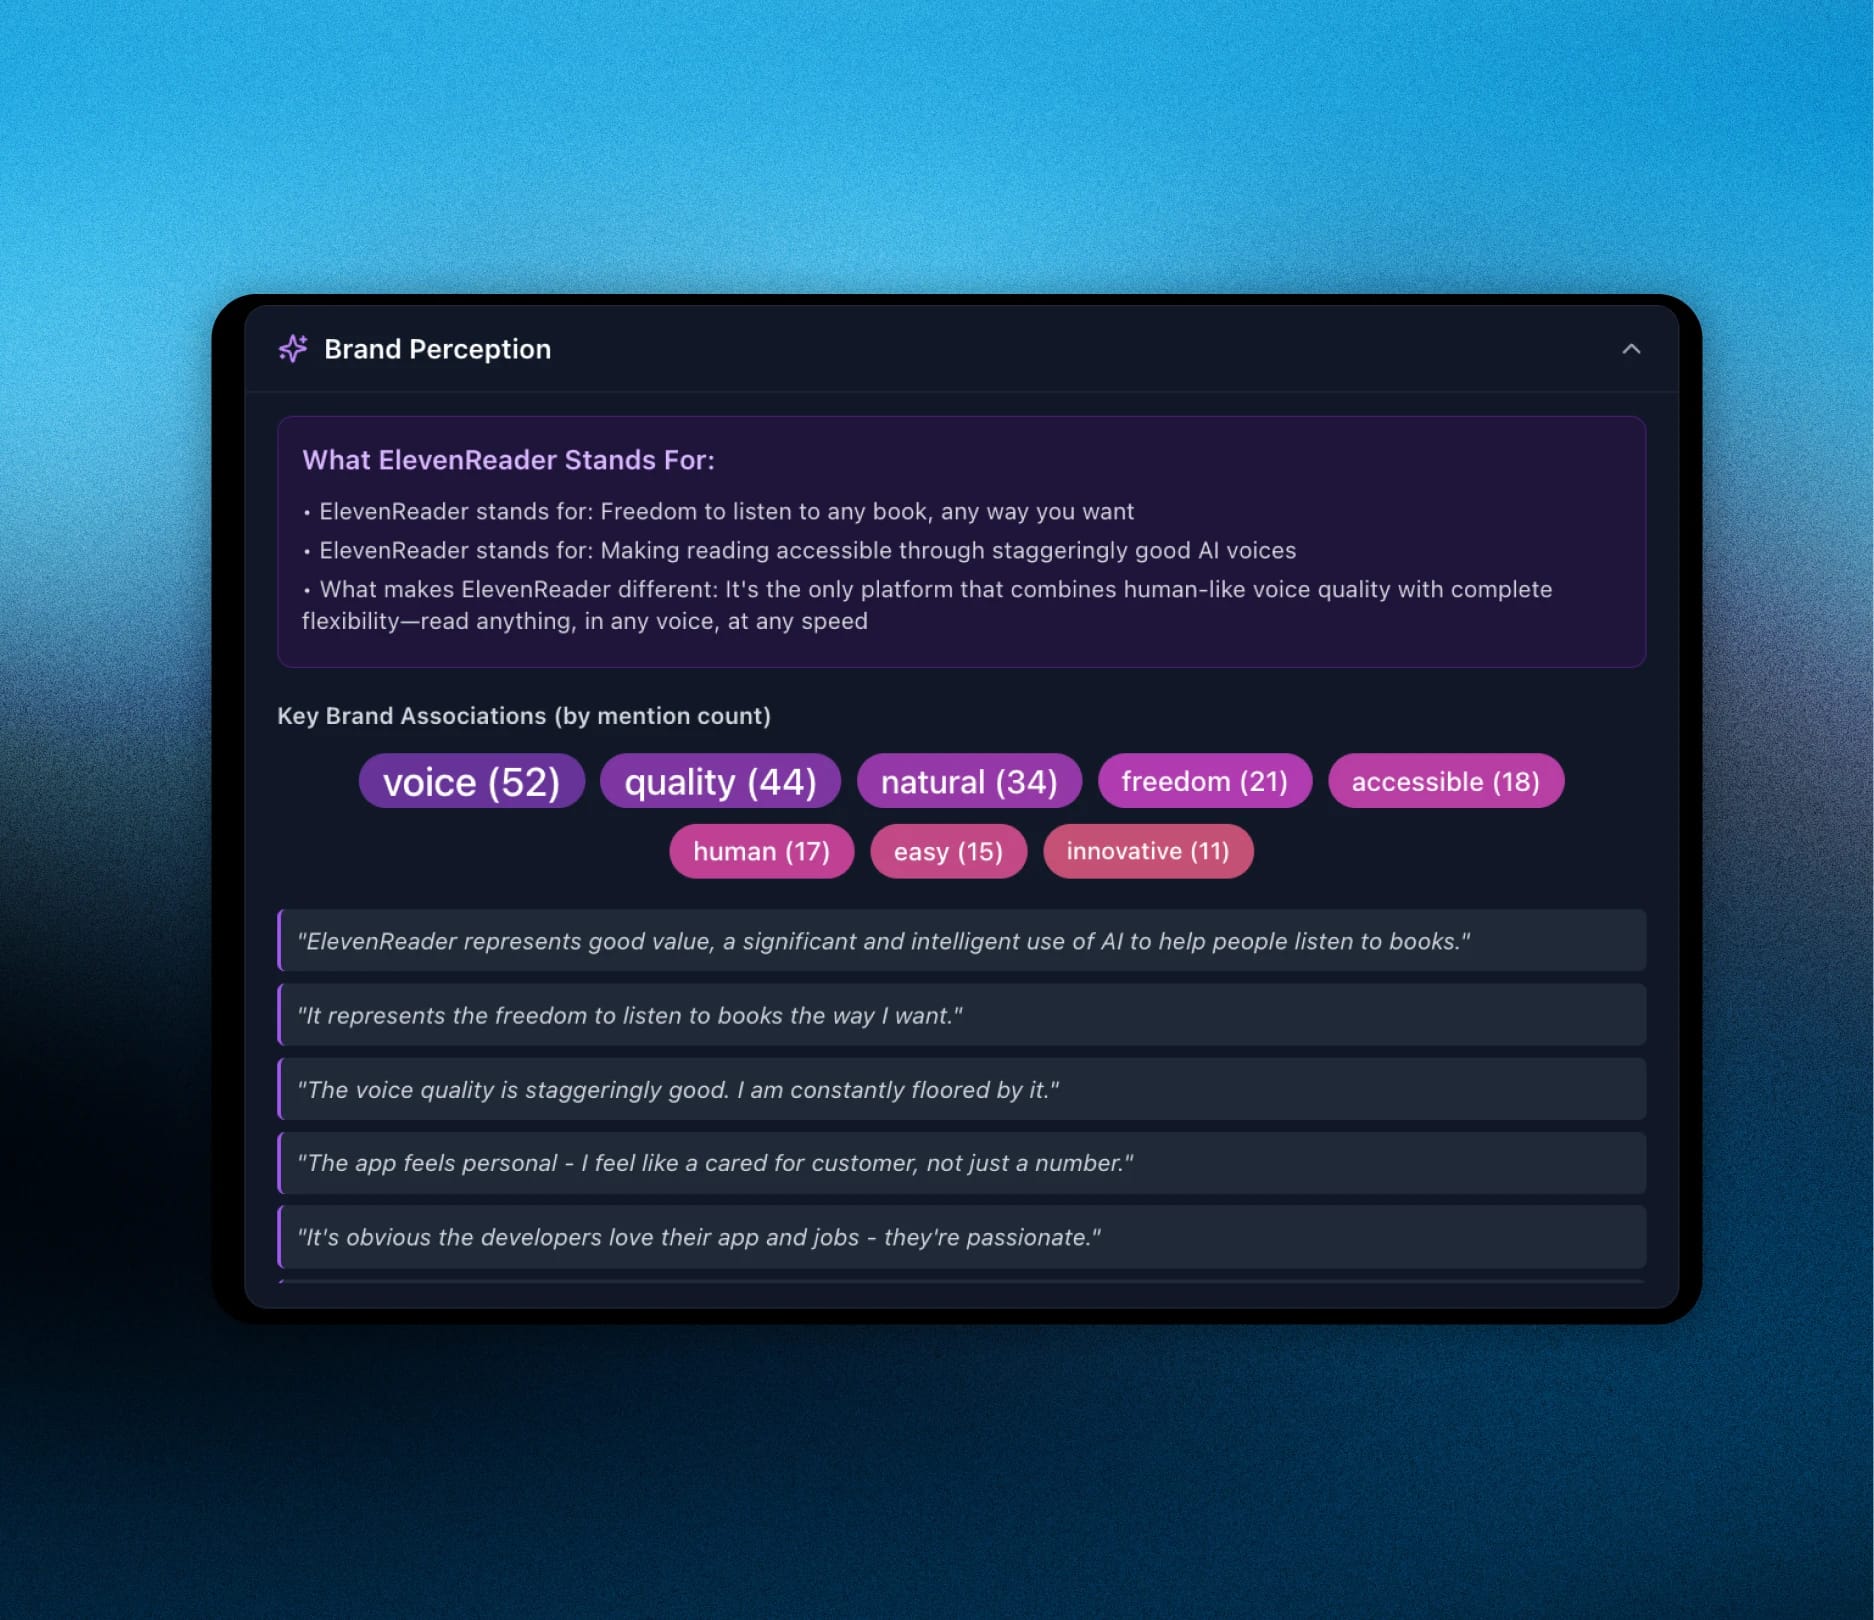
- Markenwert: Nutzer verbinden ElevenReader mit der Freiheit, jedes Buch überall hören zu können – mit der natürlichsten Stimmqualität.
- Sprachliche Anforderungen: Nutzer identifizierten Bereiche, in denen das Text to Speech-Modell (TTS) der App Sprachen und Akzente verwechselt – klare Ansatzpunkte für Verbesserungen.
- Fehlerberichte: Die Interviews zeigten konkrete Probleme auf, die unser Engineering-Team am folgenden Tag behob.
Ausblick
Die Zukunft der Nutzerforschung ist dialogorientiert – KI-Sprachagenten ermöglichen es Ihnen, weltweit zuzuhören und mit Ihren Nutzern zu sprechen – zu ihrer eigenen Zeit.
Dieser Test zeigte, wie realistisch und zuverlässig KI-Agenten tiefgehende Interviews im großen Maßstab führen können. In Verbindung mit Textanalysen durch LLMs offenbarten diese Gespräche Muster über Hunderte Antworten hinweg – Erkenntnisse, die manuell nur schwer zu gewinnen gewesen wären.
Mit ElevenLabs Agents können Sie einen ähnlichen KI-Interviewer entwickeln – starten Sie jetzt oder kontaktieren Sie unser Team für weitere Informationen.