
Was ist ein LLM? Ein praktischer Leitfaden zu Sprachmodellen
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Ein Large Language Model (LLM) ist ein System der Künstlichen Intelligenz, das anhand eines riesigen Datensatzes trainiert wurde, um natürliche Sprache zu analysieren, vorherzusagen und zu generieren. Bekannte LLMs sind die GPT-Modelle von OpenAI, Claude von Anthropic und Gemini von Google. Sie werden häufig zum Schreiben, Bearbeiten und Programmieren eingesetzt.
Anfangs enthielten LLM-Datensätze vor allem Texte aus Quellen wie Büchern, Blogs und sogar Onlineforen. Moderne LLMs nutzen heute multimodale Daten, um Anwendungsfälle zu erweitern, etwa für konversationelle Sprachagenten oder zum Erstellen von Musik.
Bevor Organisationen diese Technologie einsetzen, benötigen sie oft Antworten auf Fragen wie: Was ist ein LLM, wie funktioniert ein LLM und welche Architekturen sollte das Team nutzen? Dieser Leitfaden beantwortet diese Fragen und zeigt zugleich reale Anwendungen der Technologie und ihre konkreten Vorteile.
Zusammenfassung
- Ein Large Language Model (LLM) ist ein Modell der Künstlichen Intelligenz, das auf riesigen Text- und multimodalen Datensätzen trainiert wird, um Ergebnisse zu analysieren, vorherzusagen und zu generieren.
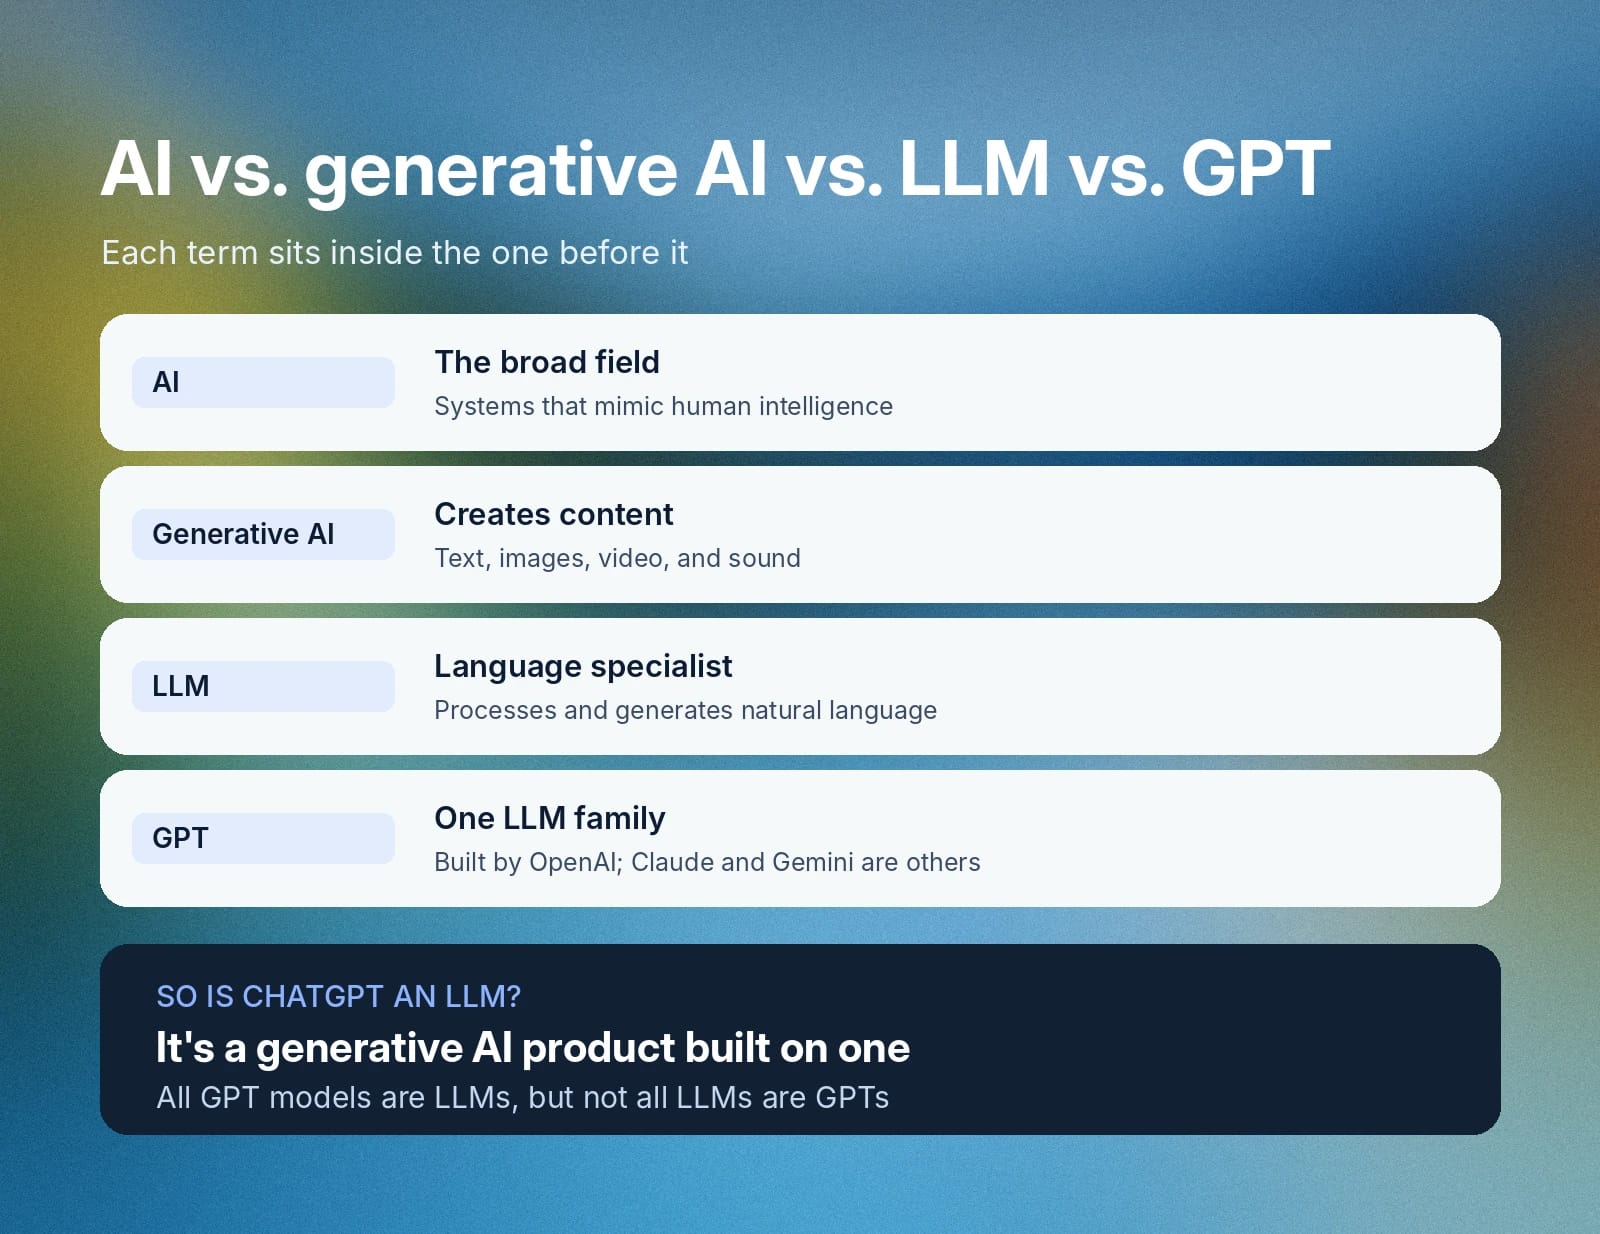
- Der Hauptunterschied zwischen GPTs und LLMs besteht darin, dass GPT (Generative Pre-trained Transformer) eine von OpenAI entwickelte spezifische LLM-Familie ist, während LLM der Oberbegriff für Modelle wie Claude und Gemini ist.
- Generative KI ist die übergeordnete Kategorie für Modelle, die auf Grundlage von Trainingsdaten verschiedenste Inhalte erstellen. LLMs sind eine spezialisierte Untergruppe der generativen KI mit Fokus auf die Verarbeitung natürlicher Sprache.
- LLMs nutzen Transformer-Netzwerke, um Text in kleinere Einheiten, sogenannte Tokens, zu zerlegen. Anschließend sagen sie anhand von Kontextinformationen aus dem Prompt und dem bisherigen Chatverlauf das nächste Token voraus.
- Praktische Beispiele für Large Language Models sind Kundenservice-Chatbots, automatisierte Schreibtools, Codegeneratoren und Ebenen zur Verarbeitung natürlicher Sprache für Sprachanwendungen.
Was ist ein LLM? Die Definition von Large Language Models
Ein Large Language Model ist ein KI-Programm auf Basis neuronaler Deep-Learning-Netzwerke, das natürliche Sprache analysiert, vorhersagt und generiert. Entwickler trainieren diese Modelle mit Datensätzen, die Milliarden von Werken aus Büchern, wissenschaftlichen Artikeln, Websites und Blogs enthalten. Der Begriff „Large“ bezieht sich sowohl auf die enorme Datenmenge für das Training als auch auf die Milliarden interner Parameter, die das Verhalten steuern.
Large Language Models unterscheiden sich grundlegend von früherer Software: Herkömmliche Software stützte sich auf explizite Syntaxbefehle, LLMs nicht. Statt jedes Wort isoliert zu verarbeiten, nutzen LLMs Kontextbeziehungen, um komplexe Sprachmuster und Grammatik zu erkennen. Sie interpretieren unstrukturierte menschliche Sprache und reagieren weiterhin auf offene Nutzereingaben, auch wenn sich der Kontext mitten im Gespräch ändert.
Diese Fortschritte in der Verarbeitung natürlicher Sprache ermöglichen ElevenAgents, komplexe Kundenanliegen zu verstehen und automatisierte Workflows auszuführen.
Wie funktionieren Large Language Models?
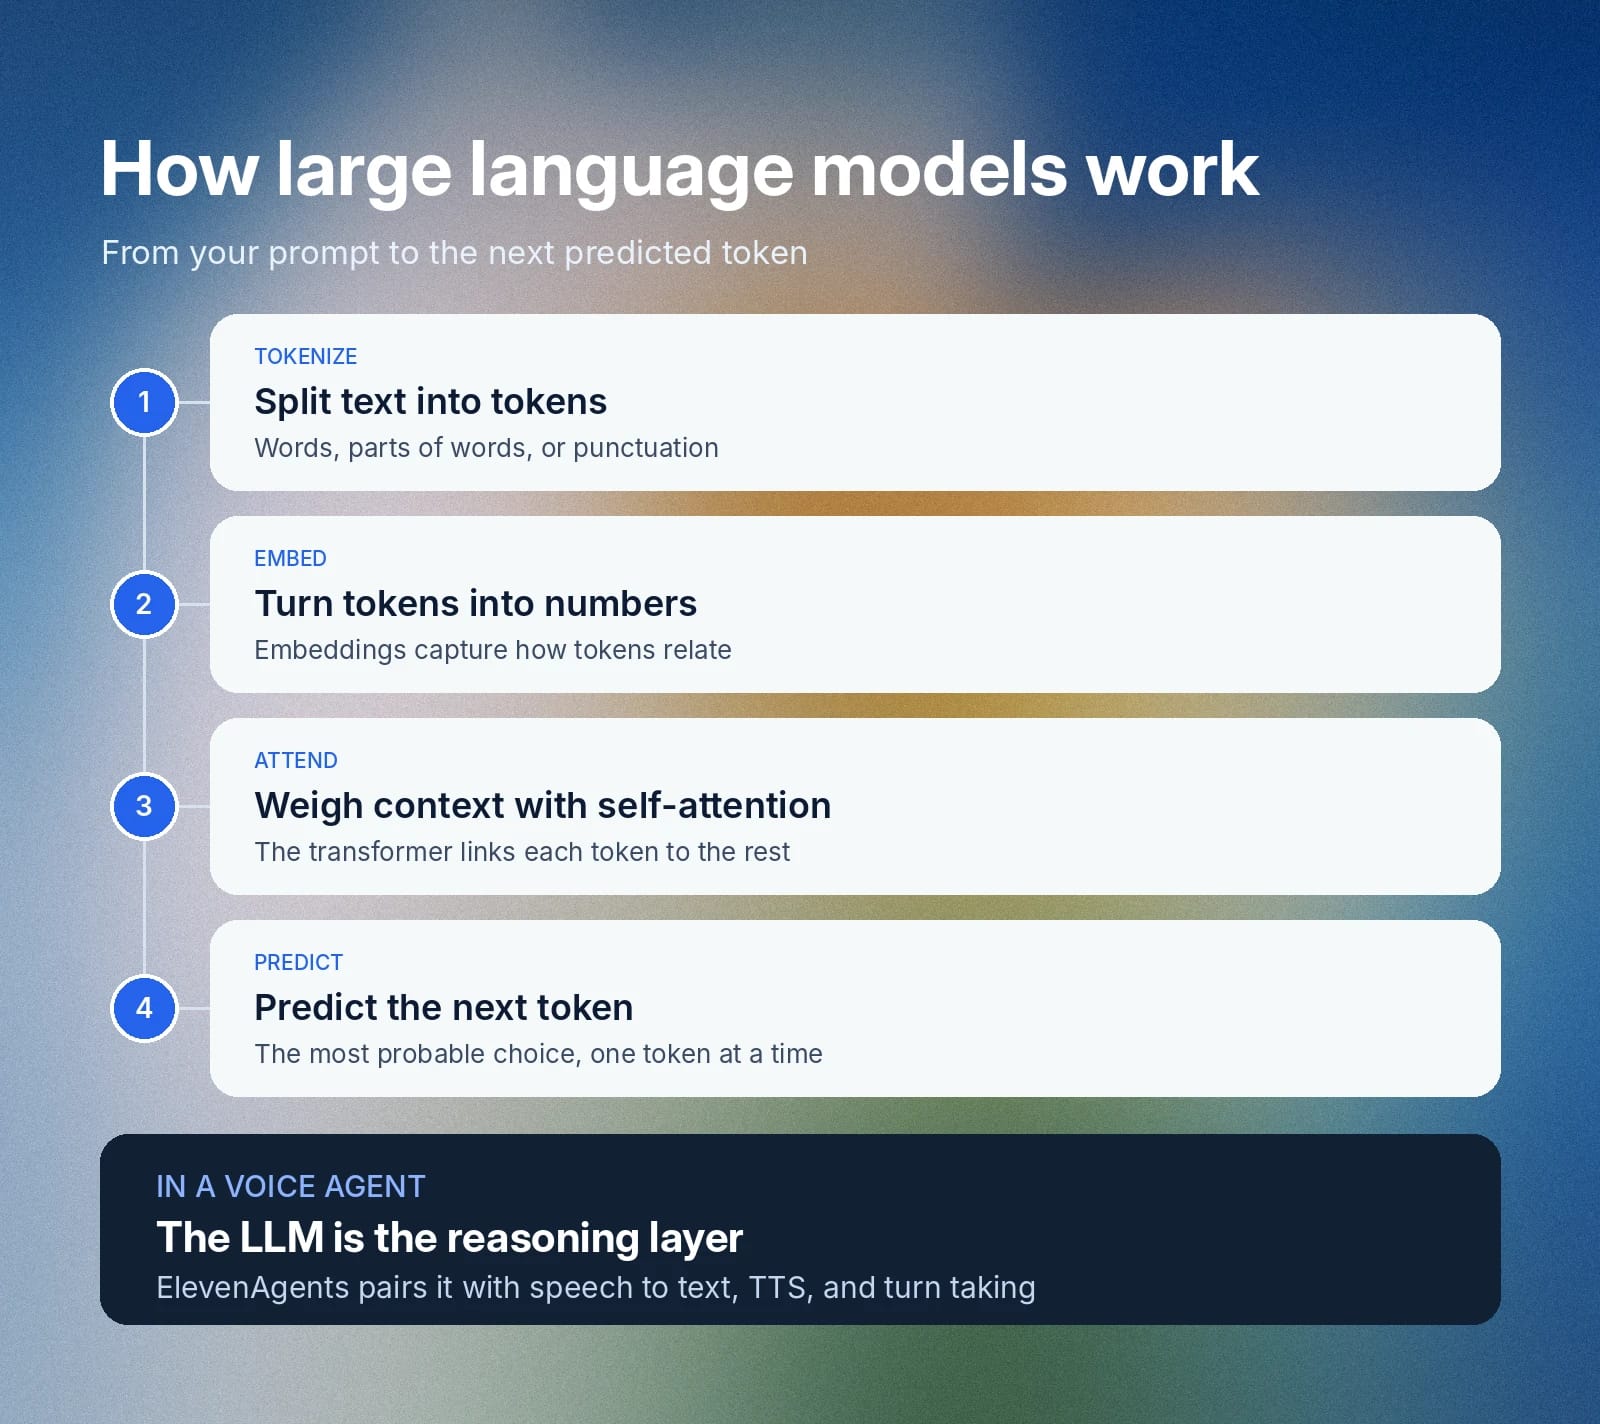
Large Language Models verarbeiten Text mit künstlichen neuronalen Netzwerken, um Eingaben in natürlicher Sprache zu analysieren und relevante Inhalte zu generieren. Der Prozess beginnt mit der Tokenisierung, bei der das Modell Eingabetext in kleinere Einheiten, sogenannte Tokens, aufteilt. Anschließend übersetzt das Modell diese Tokens in numerische Repräsentationen, sogenannte Embeddings, um mathematische oder statistische Beziehungen zwischen Tokens zu bewerten.
Die meisten modernen LLM-Systeme basieren auf der Transformer-Architektur neuronaler Netzwerke. Transformer nutzen Self-Attention-Mechanismen, die Kontextbeziehungen zwischen Tokens bewerten. Das Modell sagt das statistisch wahrscheinlichste Token zur Vervollständigung einer Sequenz voraus, indem es gelernte Muster nutzt, um Wahrscheinlichkeitsverteilungen zu berechnen.
Self-Attention ermöglicht Modellen zur Verarbeitung natürlicher Sprache, weitreichenden Kontext beizubehalten und sich an Veränderungen mitten im Gespräch anzupassen. Plattformintegrationen mit ElevenAgents bauen auf diesen Fähigkeiten auf und liefern relevante Antworten mit niedriger Latenz, die natürliche menschliche Gespräche widerspiegeln.
Was ist die Temperatur bei einem LLM?
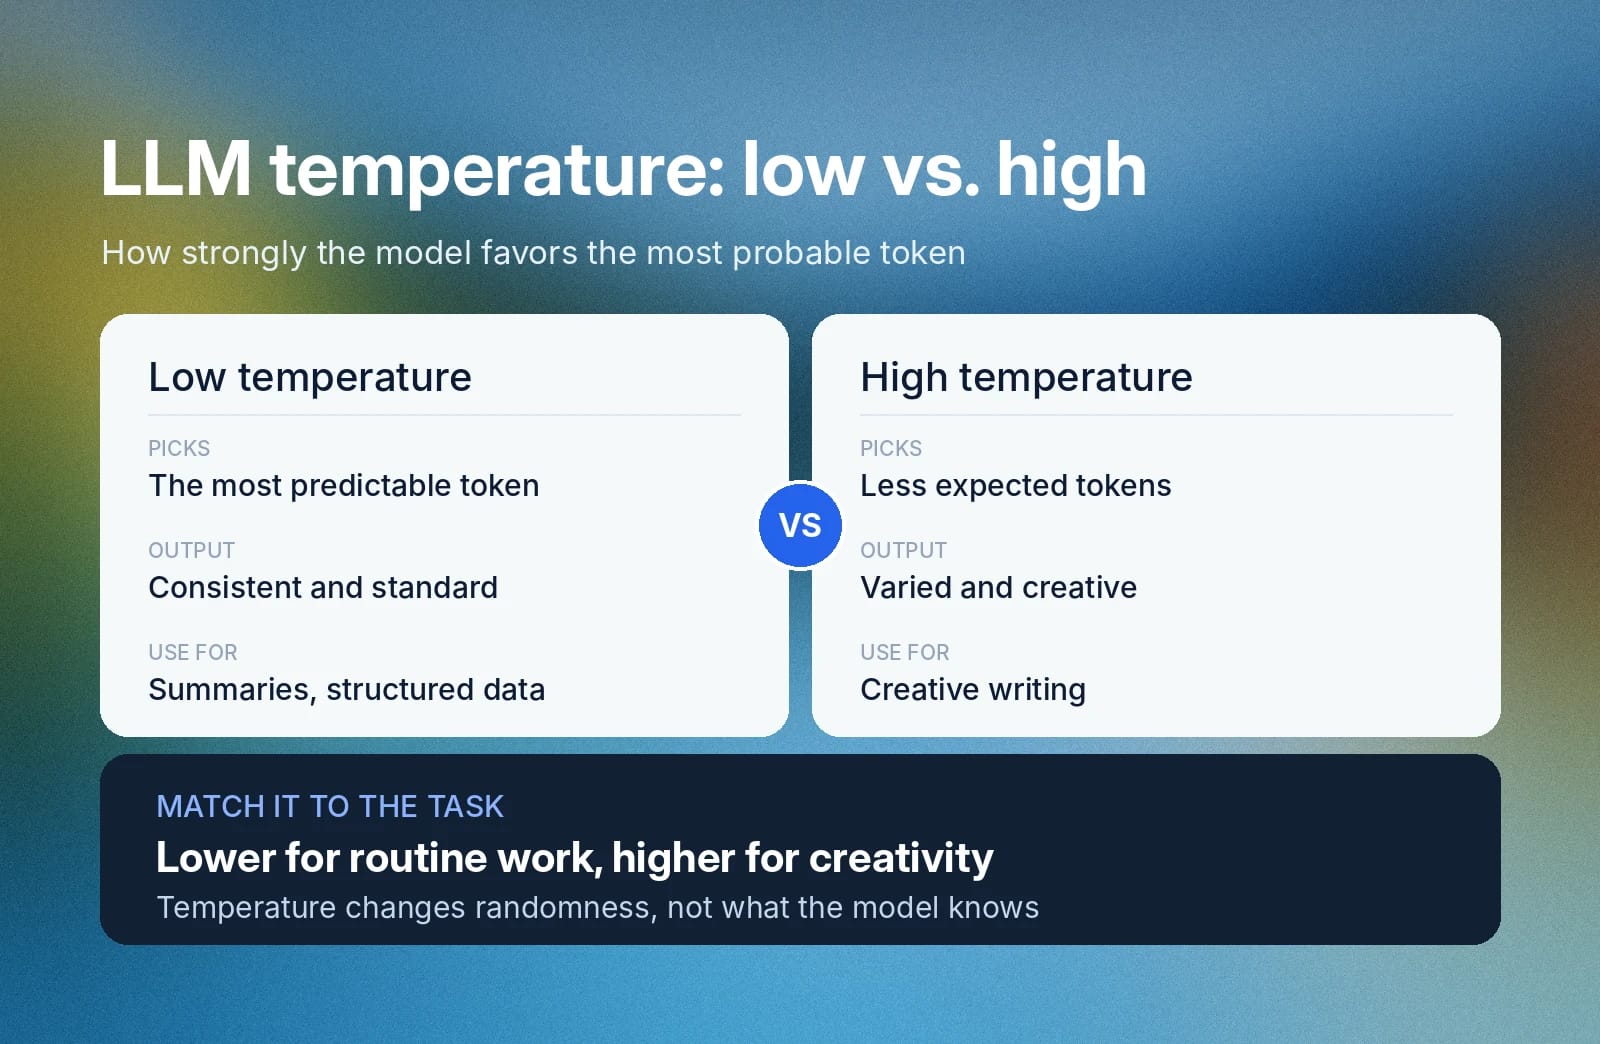
Die LLM-Temperatur ist eine variable Einstellung, mit der Entwickler festlegen können, wie zufällig die Ausgaben eines LLMs ausfallen. LLMs generieren das nächste Token in einer Wortfolge, indem sie die häufigste Option auswählen. Für jede Entscheidung eines LLMs kann es jedoch mehrere Alternativen mit ähnlicher Gewichtung geben.
Durch das Anpassen der LLM-Temperatur ändern Sie, wie stark ein LLM die wahrscheinlichste Option bevorzugt. Eine niedrige Temperatur erzeugt standardisierte und konsistente Ausgaben, da das Modell stets eher das vorhersehbarste nächste Token in einer Folge wählt. Eine hohe Temperatur weicht dagegen häufiger von der erwarteten Wahl ab und erzeugt kreativere, vielfältigere Ausgaben.
Passen Sie den Temperaturwert Ihres LLMs an die gewünschte Aufgabe an. Aufgaben mit kreativem Anteil sollten höhere Temperaturen nutzen, während Routineaufgaben oder strukturierte Ausgaben wie Datenzusammenfassungen niedrigere Werte erfordern.
Wie werden LLMs trainiert und feinabgestimmt?
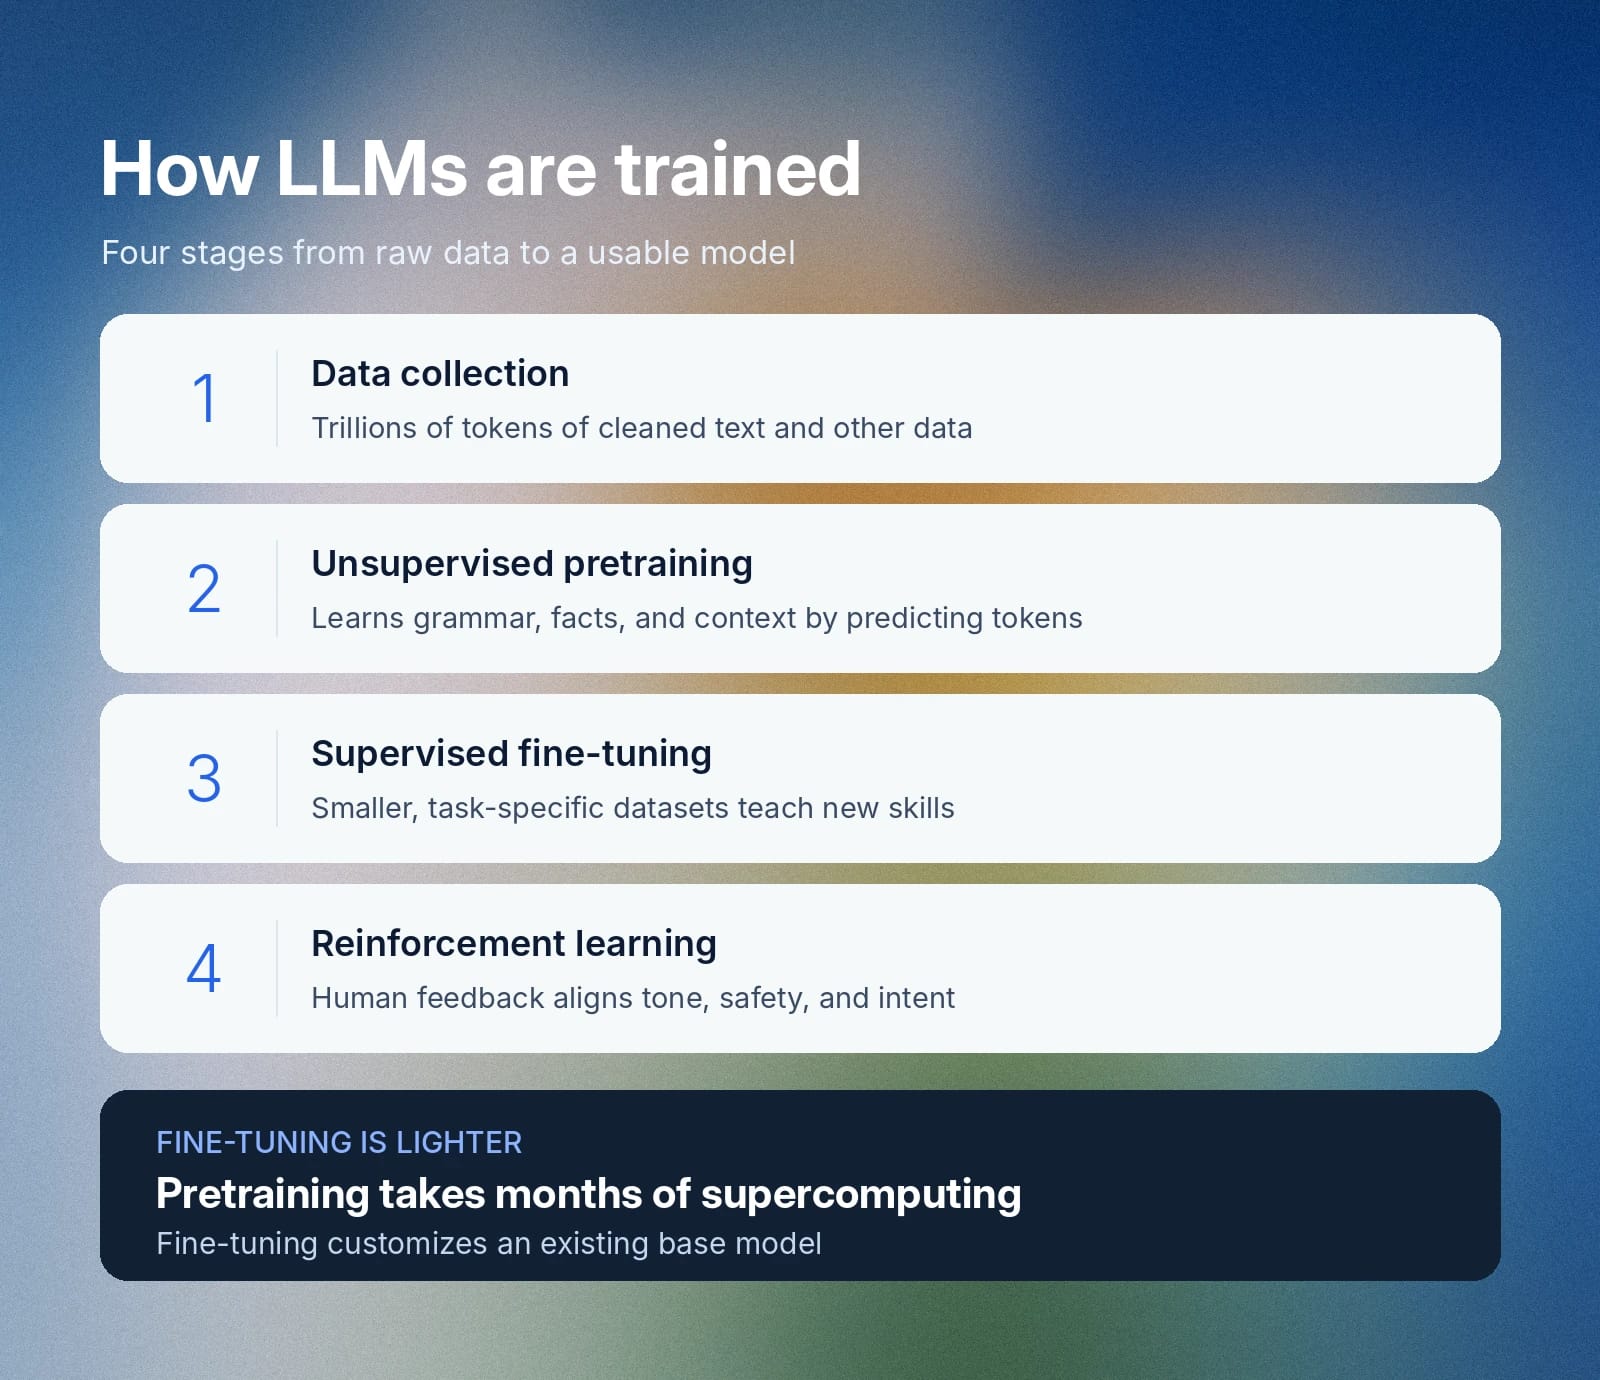
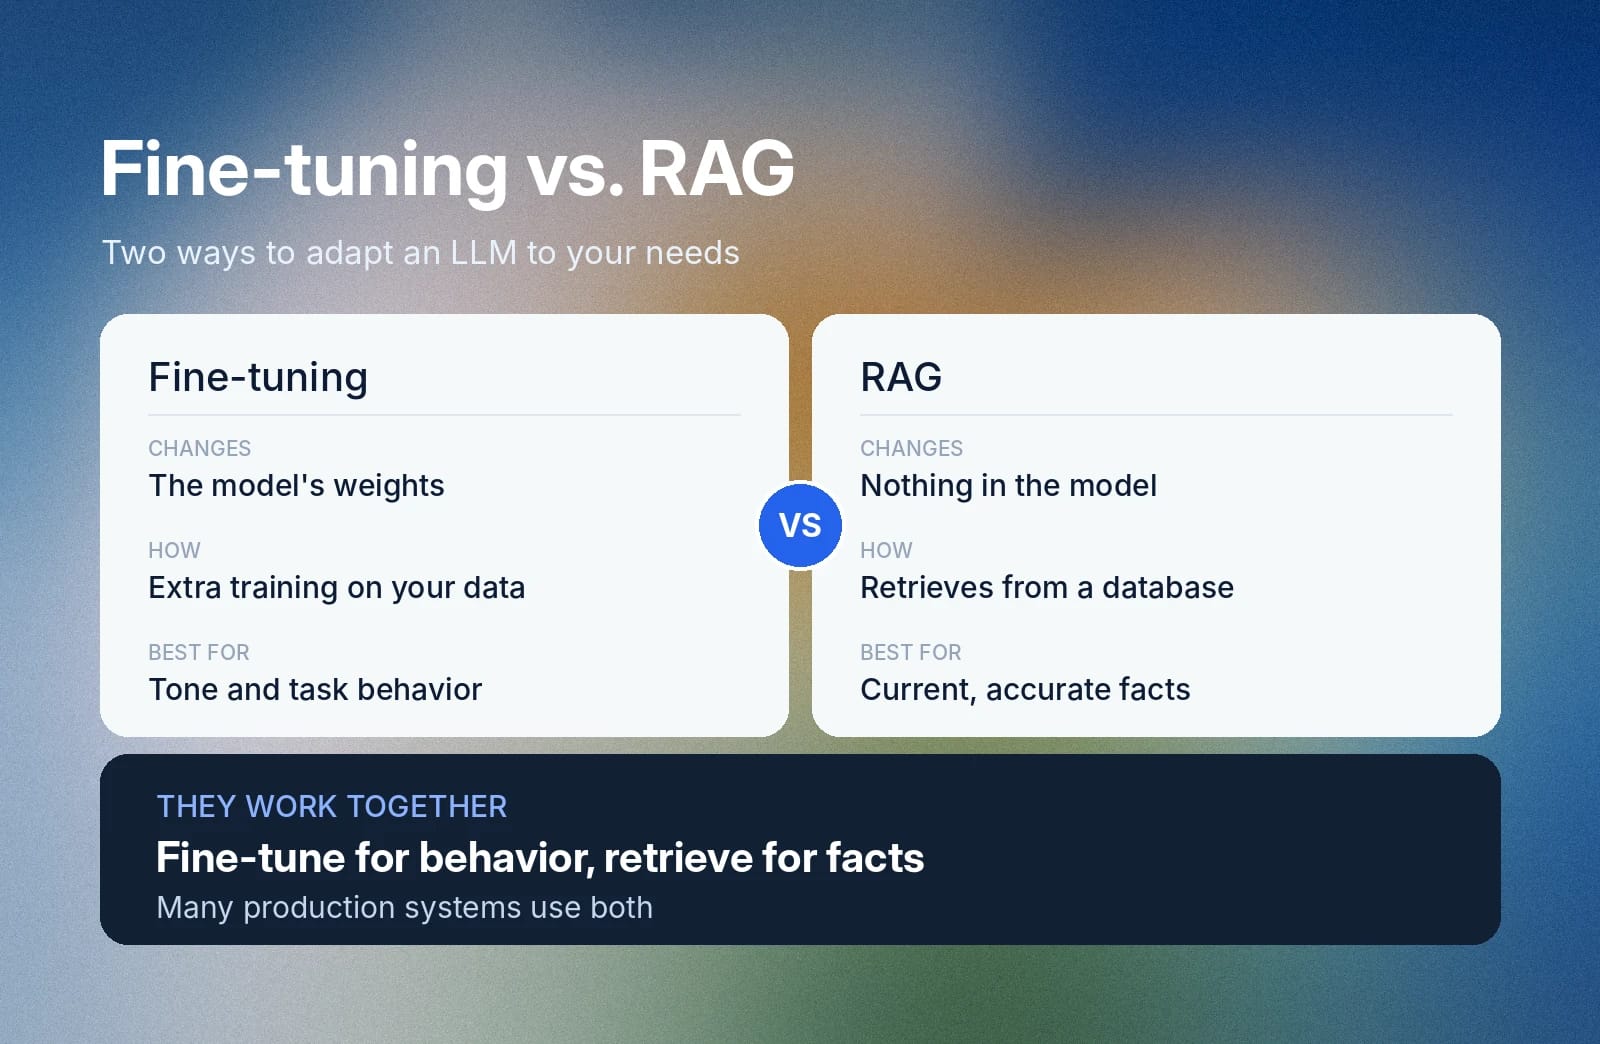
Das Training von LLMs erfordert einen mehrstufigen Prozess, der Rohtext und multimodale Daten in funktionale Sprachsysteme überführt. Unternehmen benötigen dafür fortschrittliche Supercomputing-Kapazitäten über mehrere Monate. Fine-Tuning ist dagegen ein weniger aufwendiger Prozess, der das vorhandene Basismodell anpasst.
Führende KI-Unternehmen behandeln ihren genauen Trainingsprozess meist als geschützte Information. Die meisten veröffentlichen weder Quellcode noch Gewichte. Dennoch folgt das Training im Allgemeinen diesem Prozess:
- Datenerfassung und Vorverarbeitung: Entwickler erstellen Datensätze aus mehreren Quellen mit Pre-Training-Korpora, die Billionen von Tokens aus Terabytes bereinigter Texte enthalten. Das Scraping oder Mining von Texten aus Internetquellen ist eine der wichtigsten Methoden, mit denen Unternehmen diese Datensätze erstellen.
- Unüberwachtes Pre-Training: Das Large Language Model liest Billionen von Tokens, um Grammatikregeln, faktische Zusammenhänge und sprachlichen Kontext zu lernen. Es trainiert sich im Wesentlichen selbst durch autoregressives Sprachmodellieren, das von Self-Attention-Mechanismen unterstützt wird, welche das statistisch wahrscheinliche nächste Token in einer Sequenz berechnen.
- Überwachtes Fine-Tuning: Ingenieure nutzen kleinere und aufgabenbezogenere Datensätze, um das vortrainierte Modell anzupassen. Dieser Schritt vermittelt dem Modell spezifische Fähigkeiten – von der Beantwortung allgemeiner Fragen über das Erstellen von Logos bis hin zur Durchführung von Laborforschung.
- Reinforcement Learning und Alignment: Entwickler verfeinern das Verhalten des Modells mithilfe von Feedback menschlicher Prüfer und Belohnungsmodellen. In dieser Phase werden die Modellausgaben an Sicherheitsrichtlinien, Tonvorgaben und menschliche Absichten angepasst.
Arten von LLM-Architekturen: Encoder, Decoder und Hybridmodelle
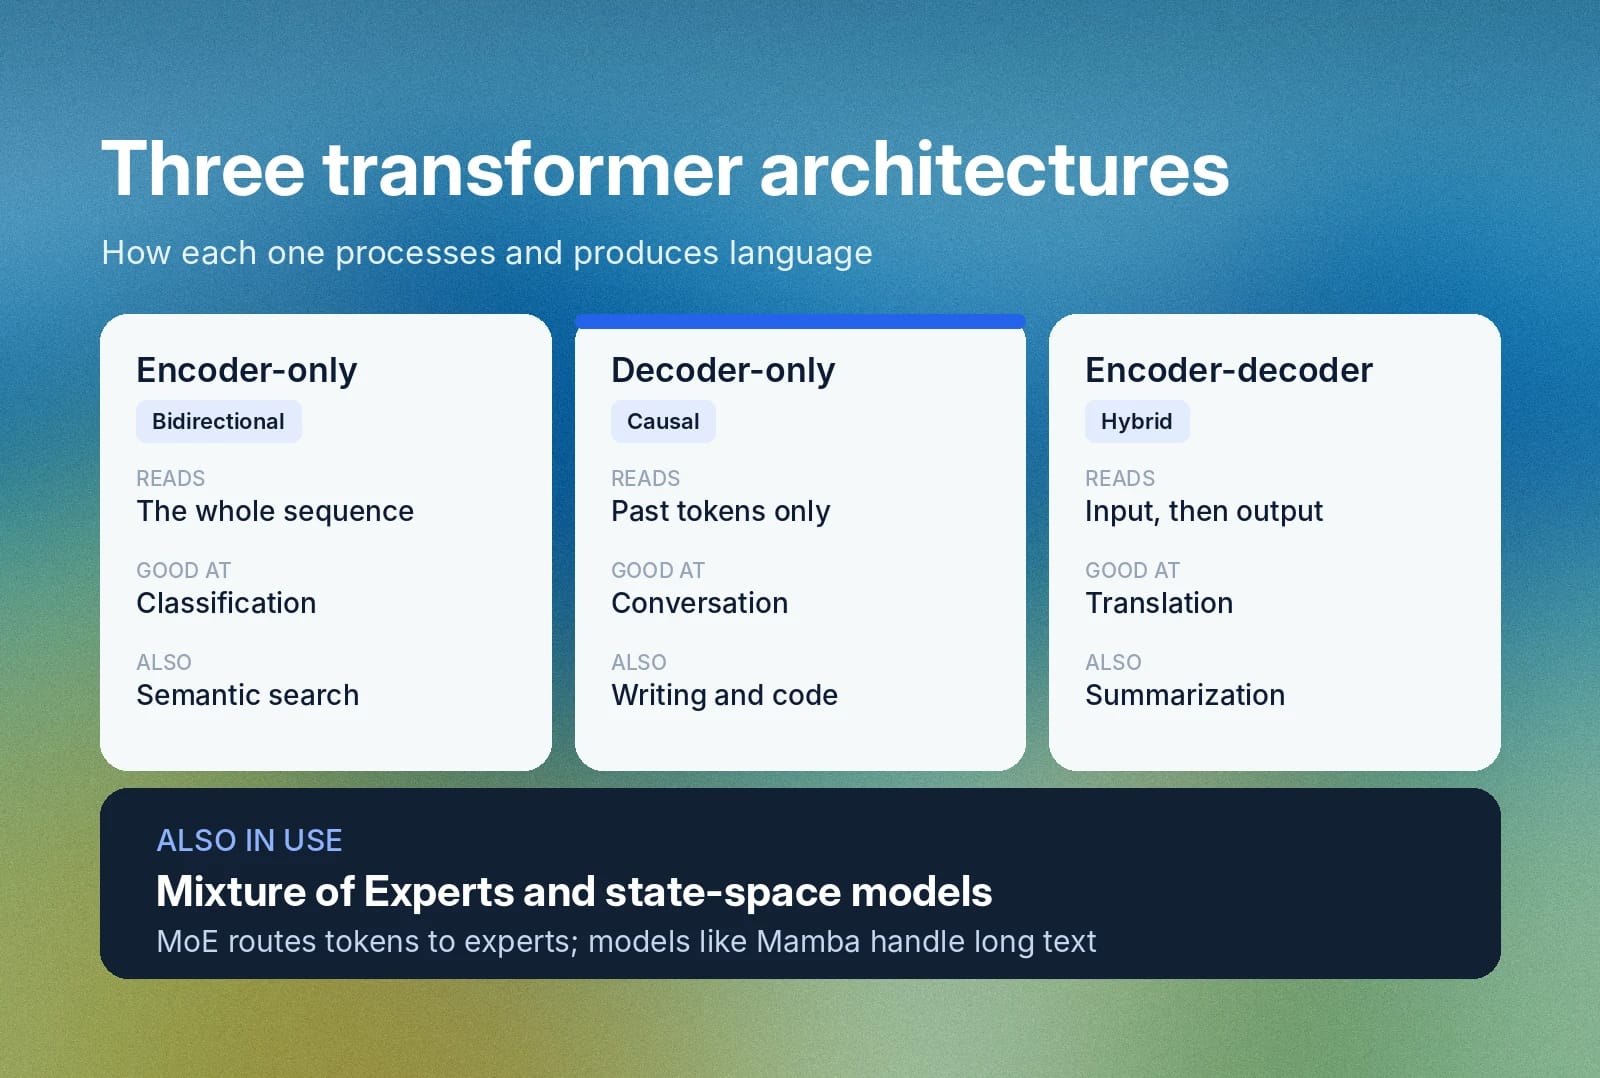
Transformer-Architekturen organisieren Schichten neuronaler Netzwerke auf unterschiedliche Weise, um Eingaben zu verarbeiten und Inhalte zu erzeugen. Klassische Transformer lassen sich in drei Hauptkategorien einteilen: reine Encoder-, reine Decoder- und Encoder-Decoder-Modelle (Hybridmodelle). Moderne Systeme integrieren jedoch auch effizienzorientierte Architekturen, um die Leistung zu skalieren.
Reine Encoder-Modelle
Reine Encoder-Architekturen verarbeiten ganze Sequenzen gleichzeitig mithilfe bidirektionaler Self-Attention. Dadurch kann die Maschine die Beziehung jedes Tokens zu anderen vergangenen und zukünftigen Tokens gewichten. In der Praxis optimiert dies Modelle für Aufgaben wie:
- Textklassifizierung
- Sentimentanalyse
- Informationsabruf
- Semantische Suche
Solche Aufgaben kommen auch in Sprach-Workflows vor. Das Scribe-Speech to Text-Modell von ElevenLabs transkribiert Sprache in über 90 Sprachen. Seine Funktion zur Entitätserkennung kennzeichnet sensible Details und beleidigende Sprache in Transkripten.
Reine Decoder-Modelle
Reine Decoder-Architekturen nutzen kausale Attention zur Verarbeitung von Tokens und sagen jedes Wort anhand vorheriger Tokens voraus. Diese Modelle erzeugen flüssige Gespräche und bilden die Hauptarchitektur moderner konversationeller Chatbots, offener Schreibassistenten und Tools zur Codegenerierung.
In ElevenAgents generiert das von Ihnen gewählte LLM, das in der Regel ein reines Decoder-Modell ist, die Antworten des Agenten. Ein proprietäres Modell für Sprecherwechsel steuert dabei das Gesprächstiming.
Encoder-Decoder-Modelle (Hybridmodelle)
Encoder-Decoder-Modelle nutzen einen Encoder zur Verarbeitung von Eingaben und einen Decoder zur Generierung von Ausgaben. Durch diesen dualen Aufbau eignen sich Hybridmodelle besser für Aufgaben, die eine strikte Erhaltung des Kontexts erfordern, etwa Dokumentzusammenfassungen, Sprachübersetzung und Datenformatierung.
Übersetzung ist eine klassische Encoder-Decoder-Aufgabe, und Dubbing von ElevenLabs unterstützt über 90 Sprachen.
Mixture of Experts (MoE) und State-Space-Modelle
Statt für jedes Wort alle Parameter des neuronalen Netzwerks zu aktivieren, leitet Mixture of Experts (MoE) einzelne Tokens an kleinere Teams spezialisierter „Experten“-Subnetzwerke weiter. Das bietet eine mit großen Modellen vergleichbare Tiefe beim Schlussfolgern, jedoch bei höherer Geschwindigkeit und niedrigeren Rechenkosten. State-Space-Modelle wie Mamba verarbeiten unterdessen auch extrem lange Texte effizient.
ElevenAgents umfasst Open-Source-LLMs, die ElevenLabs in der eigenen Infrastruktur hostet.
Beispiele für Large Language Models und alltägliche Anwendungen
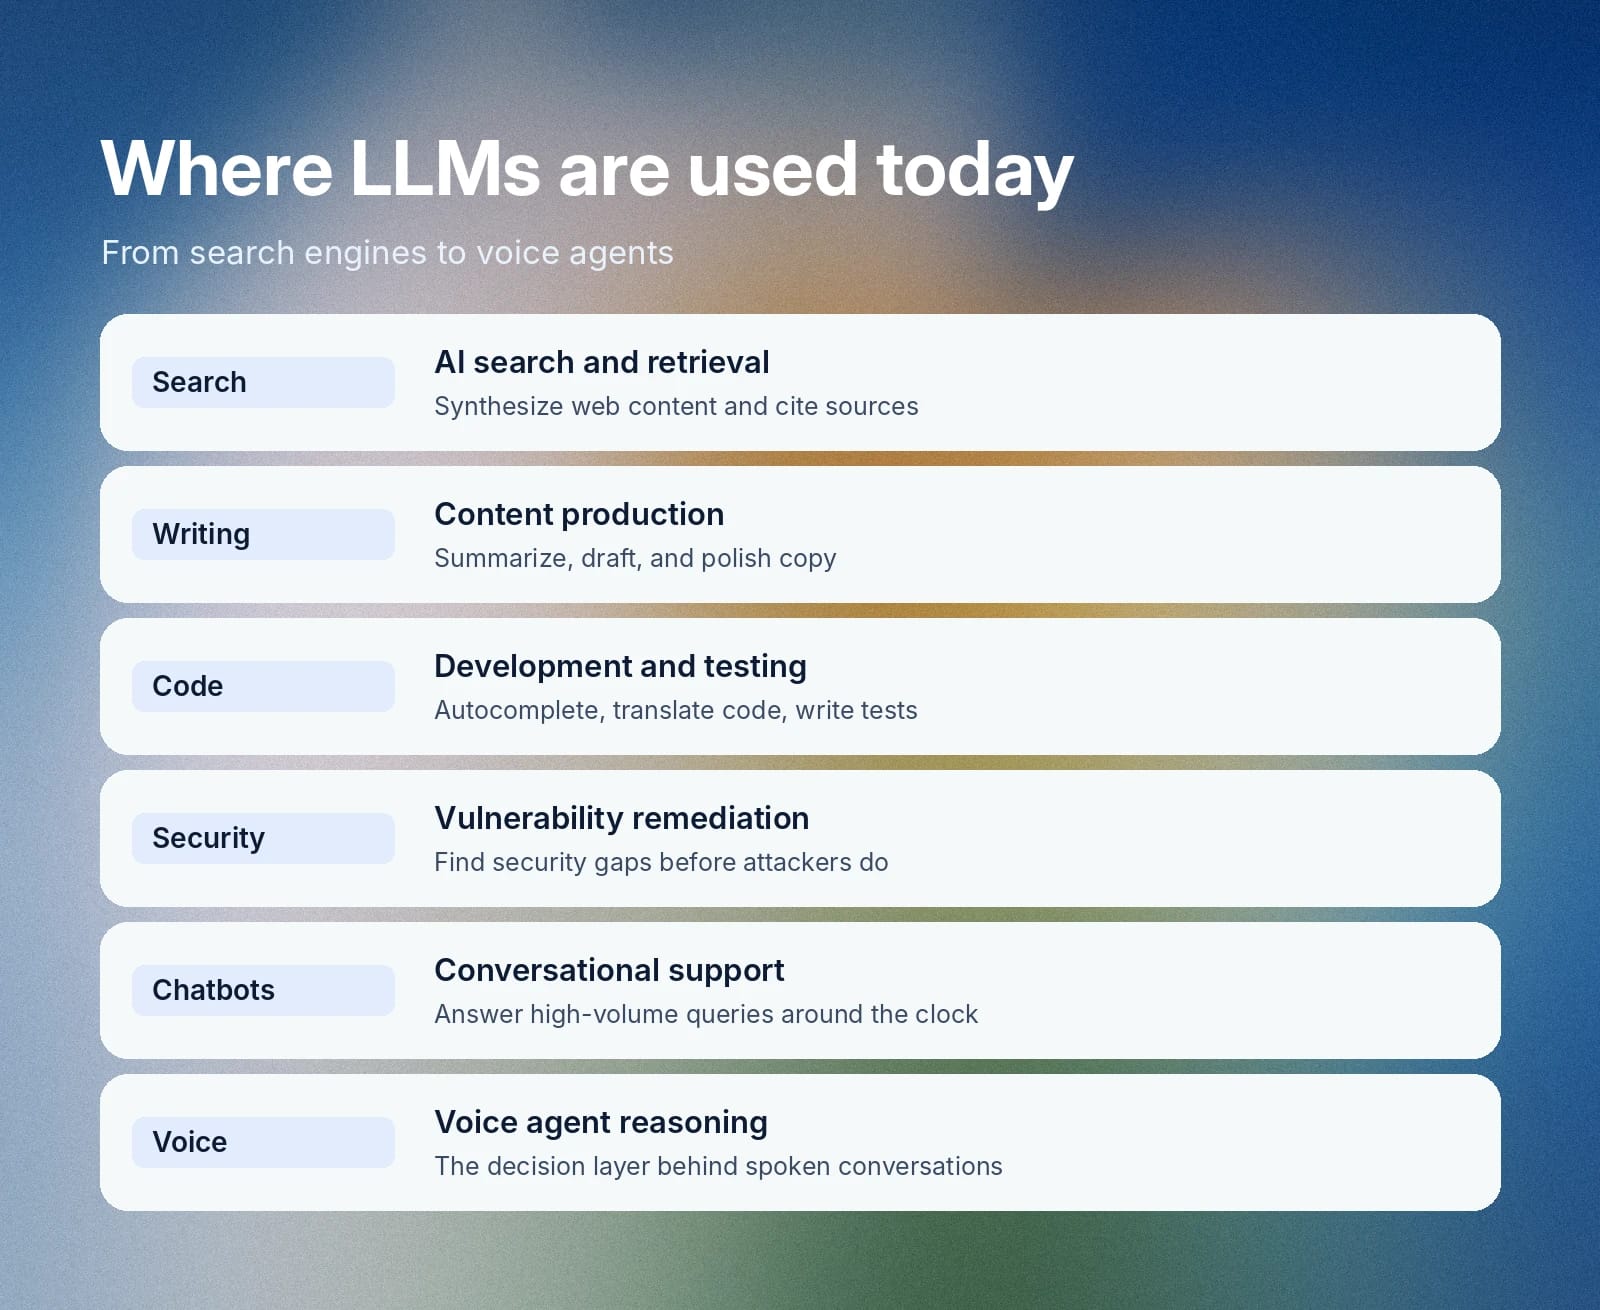
Organisationen haben zahlreiche Anwendungsfälle für Large Language Models gefunden. Diese zeigen, wie KI von experimenteller Forschung zu einer Standardfunktion im Web, in Softwareanwendungen und Alltagsgeräten wurde. Während KI-Forscher die zugrunde liegende Architektur weiter untersuchen und optimieren, zeigen reale LLM-Beispiele, wie Teams sie bisher eingesetzt haben:
- KI-Suche und Informationsabruf: Konversationelle Suchmaschinen wie Bing, Google AI Overviews und Perplexity nutzen LLMs, um Webinhalte in Echtzeit zu analysieren. Die Modelle fassen Informationen zusammen, zitieren Quellen direkt und ermöglichen Nutzern, Folgefragen zu stellen.
- Schreiben, Bearbeiten und Content-Produktion: LLMs und andere KI-gestützte Tools erleichtern das Schreiben und Bearbeiten von Materialien für den internen und externen Einsatz. Beispielsweise fasst NotebookLM lange Berichte zusammen, Jasper AI erstellt Anzeigen und Grammarly optimiert Texte.
- Codegenerierung, Entwicklung und Tests: KI unterstützt Coding-Tools wie GitHub Copilot beim automatischen Vervollständigen von Funktionen und beim Übersetzen von Code zwischen Programmiersprachen. Teams können damit auch automatisierte Testsuiten erstellen, um Fehler vor der Bereitstellung einfach zu erkennen und zu beheben.
- Cybersicherheit und Behebung von Schwachstellen: Führende KI-Unternehmen haben spezialisierte Modelle zur Erkennung von Sicherheitslücken veröffentlicht. So können Organisationen Korrekturen bereitstellen, bevor Angreifer die Lücken finden und ausnutzen.
- Chatbots und konversationelle Assistenten: Organisationen setzen konversationelle Schnittstellen ein, um rund um die Uhr Kundensupport zu bieten. Die Integration von Plattformen wie ElevenAgents ermöglicht Unternehmen, Anfragen in hohem Volumen mit konversationellen Lösungen zu automatisieren, statt sich auf FAQs zu verlassen.
- Reasoning Engine für Sprachagenten: LLMs dienen auch als zentrale Reasoning-Schicht für Voice-KI-Systeme. ElevenAgents kombiniert das LLM Ihrer Wahl mit Speech to Text, Text to Speech mit niedriger Latenz und einem proprietären Modell für Sprecherwechsel, um natürliche Gespräche in Echtzeit zu führen.
Welche Einschränkungen haben Large Language Models?
LLMs bilden das Rückgrat der meisten KI-Produkte, mit denen Verbraucher interagieren. Sie sind eine leistungsstarke Architekturkomponente für zahlreiche Workflows und Anwendungsfälle. Wenn Sie jedoch mit LLMs entwickeln oder ein eigenes Modell trainieren möchten, sollten Sie ihre wichtigsten Einschränkungen kennen:
- Halluzinationen: Es gibt keine Garantie, dass die von einem LLM generierten Inhalte korrekt sind. Eine Antwort kann leicht erfundene oder schlicht falsche Informationen enthalten.
- Statisches Wissen: Ohne RAG ist ein LLM auf den Wissensumfang beschränkt, der ihm während des Trainings vermittelt wurde.
- Verzerrungen: Wenn Ihre Trainingsdaten Verzerrungen enthalten, wird Ihr Modell diese widerspiegeln. Das ist besonders wichtig, wenn Sie ein LLM zur Klassifizierung von Daten oder für Entscheidungen über Informationen einsetzen: Implizite Verzerrungen in Ihren Daten können die Ausgaben unbemerkt negativ beeinflussen.
- Begrenztes Kontextfenster: LLMs arbeiten in der Regel nur mit einer festen Textmenge. Daher können längere Gespräche mit der Zeit Details verlieren und weniger effektiv werden.
- Kosten und Latenz: Je größer das LLM, desto mehr Rechenleistung wird für seinen Betrieb benötigt. Wenn Sie leistungsfähigere Modelle wählen, zahlen Sie wahrscheinlich einen Aufpreis für diesen besseren Service.
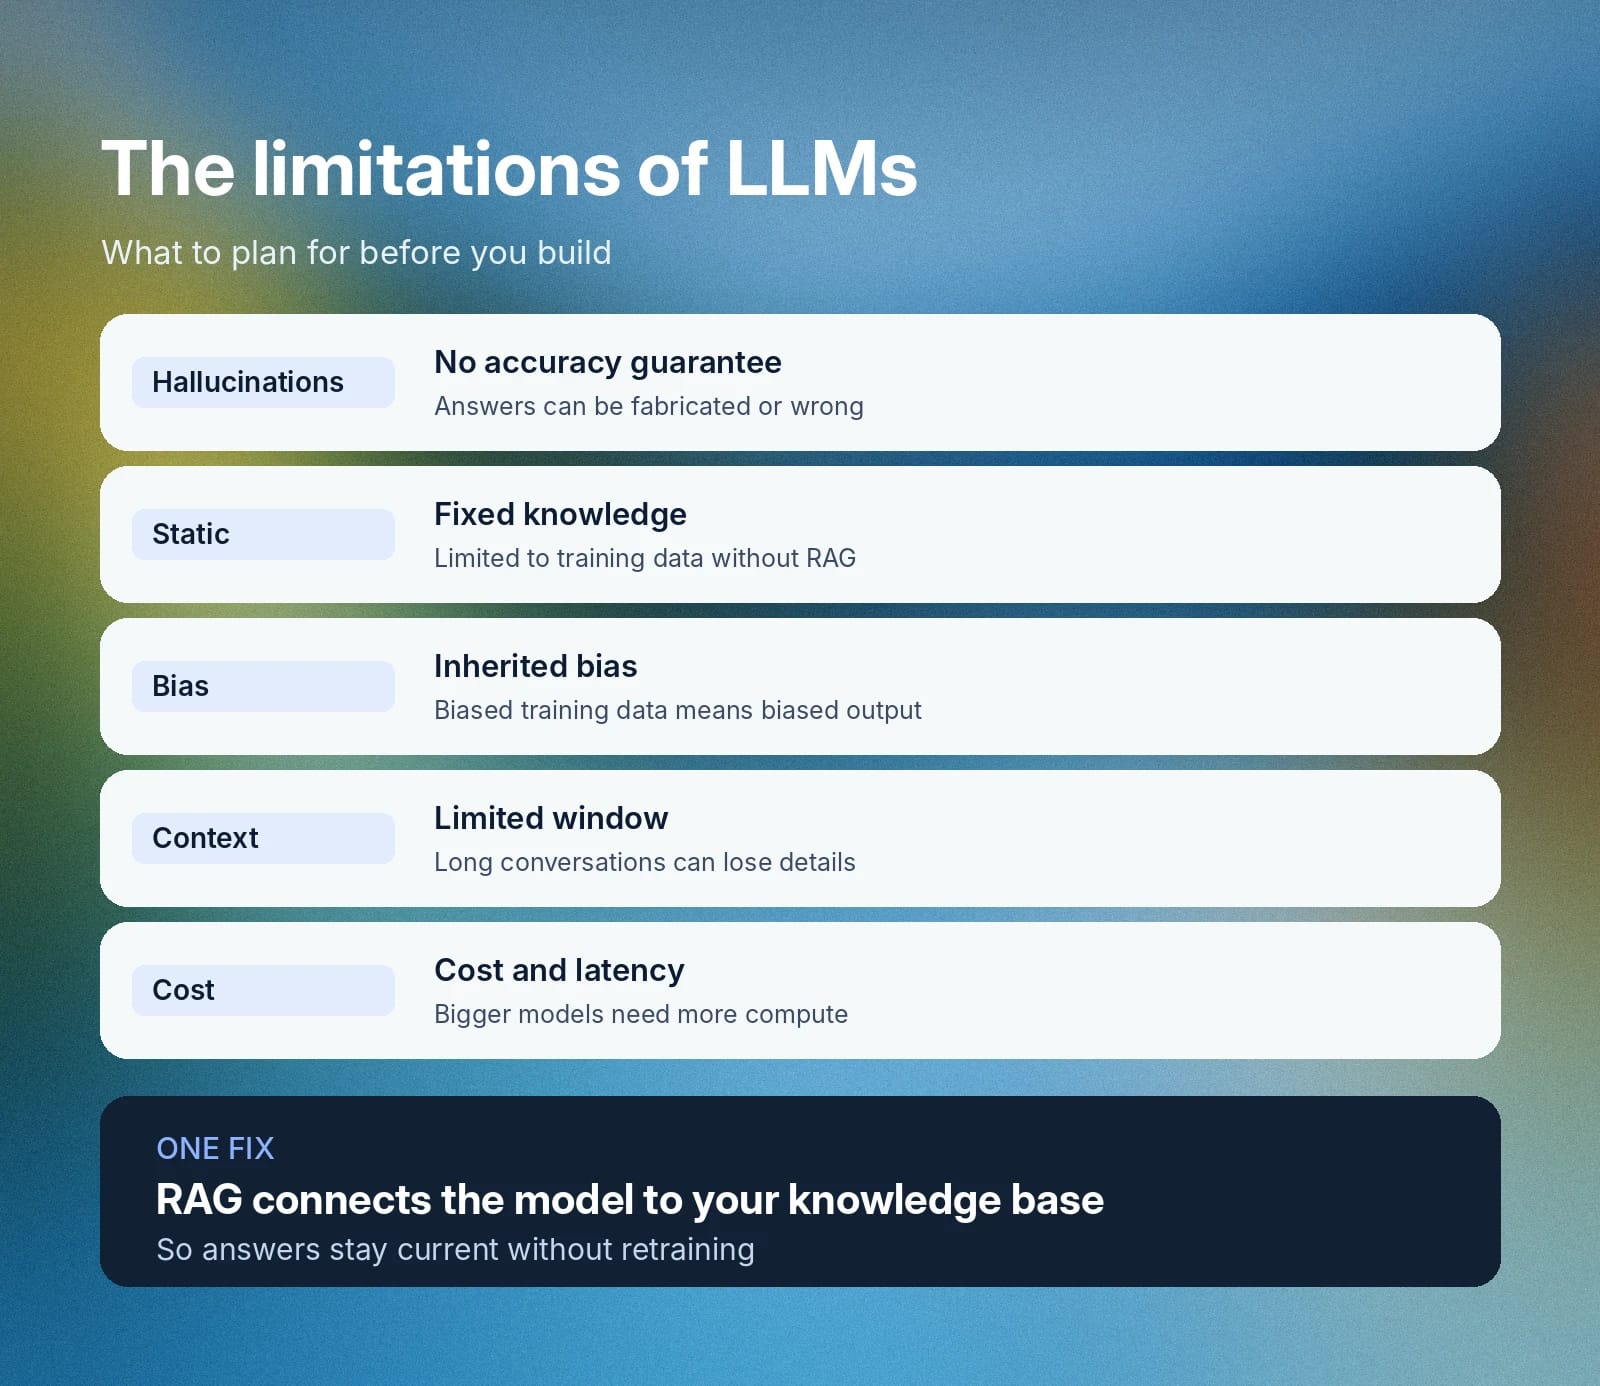
Sie können verschiedene Strategien oder Implementierungen nutzen, um die Auswirkungen dieser Einschränkungen zu verringern. Beispielsweise würde die Aktivierung von RAG in einem LLM und die Anbindung einer stetig wachsenden Wissensdatenbank das Problem des statischen Wissens lösen.
Entwickeln Sie sprachfähige LLM-Erlebnisse mit ElevenAgents
Die Wahl eines Large Language Models für Ihren Anwendungsfall ist eine entscheidende Entscheidung, die Sie möglicherweise anpassen müssen, wenn sich Ihre Geschäftsanforderungen oder regulatorische Vorgaben ändern. Die Vermeidung von Vendor Lock-in erhält die Agilität und Flexibilität Ihres Unternehmens beim Aufbau konversationeller Voice-KI-Lösungen.
Mit ElevenAgents können Sie aus unterstützten LLMs von Anbietern wie OpenAI, Anthropic und Google wählen oder über einen OpenAI-kompatiblen Endpunkt ein eigenes benutzerdefiniertes Modell anbinden. So finden Sie einfach die optimale Balance aus Geschwindigkeit, Reasoning-Fähigkeit und Kosten für Ihre spezifischen Anforderungen.
Entdecken Sie ElevenAgents, um zu sehen, wie gehostete LLMs Sprach-Workflows vereinfachen, oder kontaktieren Sie den Vertrieb, um noch heute mit der Entwicklung Ihrer Sprachagenten mit niedriger Latenz zu beginnen.
Häufig gestellte Fragen zu LLMs

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


