
Was ist RAG? So funktioniert Retrieval-Augmented Generation
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
KI-Modelle generieren Antworten auf Basis dessen, was sie im Training gelernt haben. Daher kennen sie Unternehmensrichtlinien, Produkte oder andere Informationen, die erst nach dem Training entstanden sind, nicht automatisch. RAG (Retrieval-Augmented Generation) löst dieses Problem, indem es relevante externe Informationen abruft und dem Modell vor der Antwort bereitstellt.
RAG verankert die Antworten einer KI in den tatsächlichen Dokumenten eines Unternehmens. Ein Kundenservice-Agent mit RAG kann vor seiner Antwort die aktuelle Rückgaberichtlinie oder Produktspezifikation abrufen. Das senkt das Risiko von Halluzinationen.
Dieser Leitfaden erklärt, was RAG in der KI bedeutet, wie Abruf und Generierung zusammenarbeiten und worin sich RAG von einem eigenständigen LLM unterscheidet. Außerdem behandeln wir die Grenzen von RAG, seine Einsatzbereiche in generativen KI-Anwendungen und wie RAG den Wissensabruf in KI-Agenten unterstützt.
Zusammenfassung
- RAG kombiniert ein Abrufsystem mit einem generativen Modell, damit das Modell Informationen über seine Trainingsdaten hinaus nutzen kann.
- Das von RAG abgerufene Wissen liegt außerhalb des Modells und kann daher ohne erneutes Training aktualisiert werden.
- ElevenAgents nutzt RAG automatisch, wenn eine Wissensdatenbank zu groß ist, um direkt in den Kontext des Modells zu passen. So bleiben Antworten auch bei großen, komplexen Wissensdatenbanken schnell und präzise.
Was ist RAG in der KI?
RAG ist eine Systemarchitektur rund um ein LLM, die es mit externen Informationen wie Markenrichtlinien, Produkthandbüchern, Wissensdatenbank-Artikeln oder internen Datenbanken versorgt. So kann KI mit unternehmensspezifischen Informationen arbeiten und Antworten geben, die aktuelle Richtlinien, privates Wissen und Unternehmensdetails berücksichtigen, auf die ein Modell nie trainiert wurde.
Ein LLM kann außerdem nur eine begrenzte Menge an Informationen gleichzeitig berücksichtigen, das sogenannte Kontextfenster. Eine große Wissensdatenbank eines Unternehmens kann diese Grenze schnell überschreiten. RAG hält die Informationen daher außerhalb des LLM und ruft nur die für die aktuelle Frage benötigten Abschnitte ab.
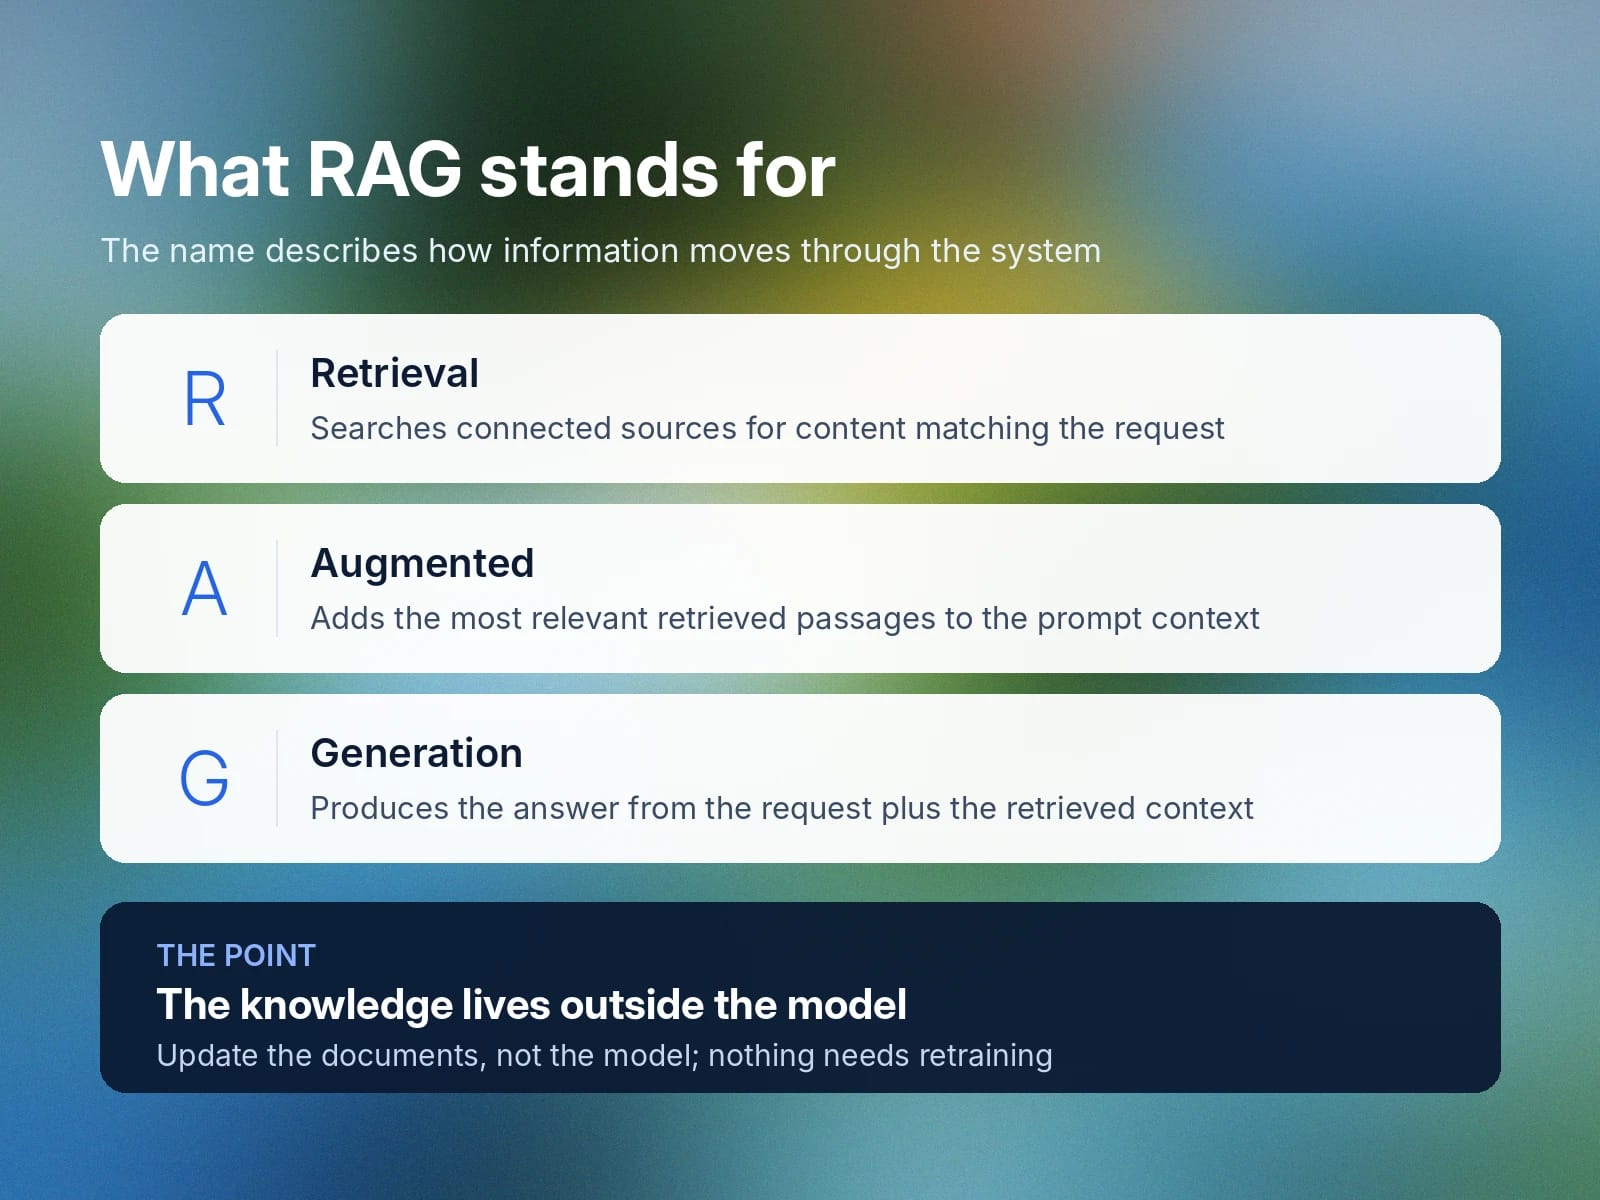
Der Name beschreibt, wie Informationen durch das System fließen:
- Retrieval: Durchsucht verbundene Quellen wie Richtliniendokumente, Helpdesk-Protokolle oder Inventardateien nach Inhalten, die zur Anfrage des Nutzers passen.
- Augmented: Fügt dem Prompt-Kontext die relevantesten abgerufenen Abschnitte hinzu.
- Generation: Nutzt die Anfrage des Nutzers und den abgerufenen Kontext, um die Antwort zu erstellen.
RAG unterstützt auch Grounding: Dabei wird eine KI-Antwort mit bestimmten Quellinformationen verknüpft. Dazu erhält das LLM relevantes Material für die Generierung einer Antwort. Fragt ein Kunde beispielsweise nach einer Garantierichtlinie, ruft das RAG-System die relevanten Bedingungen aus der Unternehmensdokumentation ab und stellt sie dem LLM für die Antwort bereit.
Wie funktioniert Retrieval-Augmented Generation?
Ein RAG-System bereitet externes Wissen für die Suche auf, ruft die für die Frage eines Nutzers relevantesten Informationen ab und gibt sie dem LLM als Kontext, bevor es eine Antwort generiert.
RAG-Implementierungen unterscheiden sich in ihrer Komplexität. Einfaches RAG nutzt einen direkten Abruf-und-Generierungs-Prozess, während fortgeschrittenere Ansätze Query-Rewriting, Filterung, Reranking oder andere Abruftechniken ergänzen können.
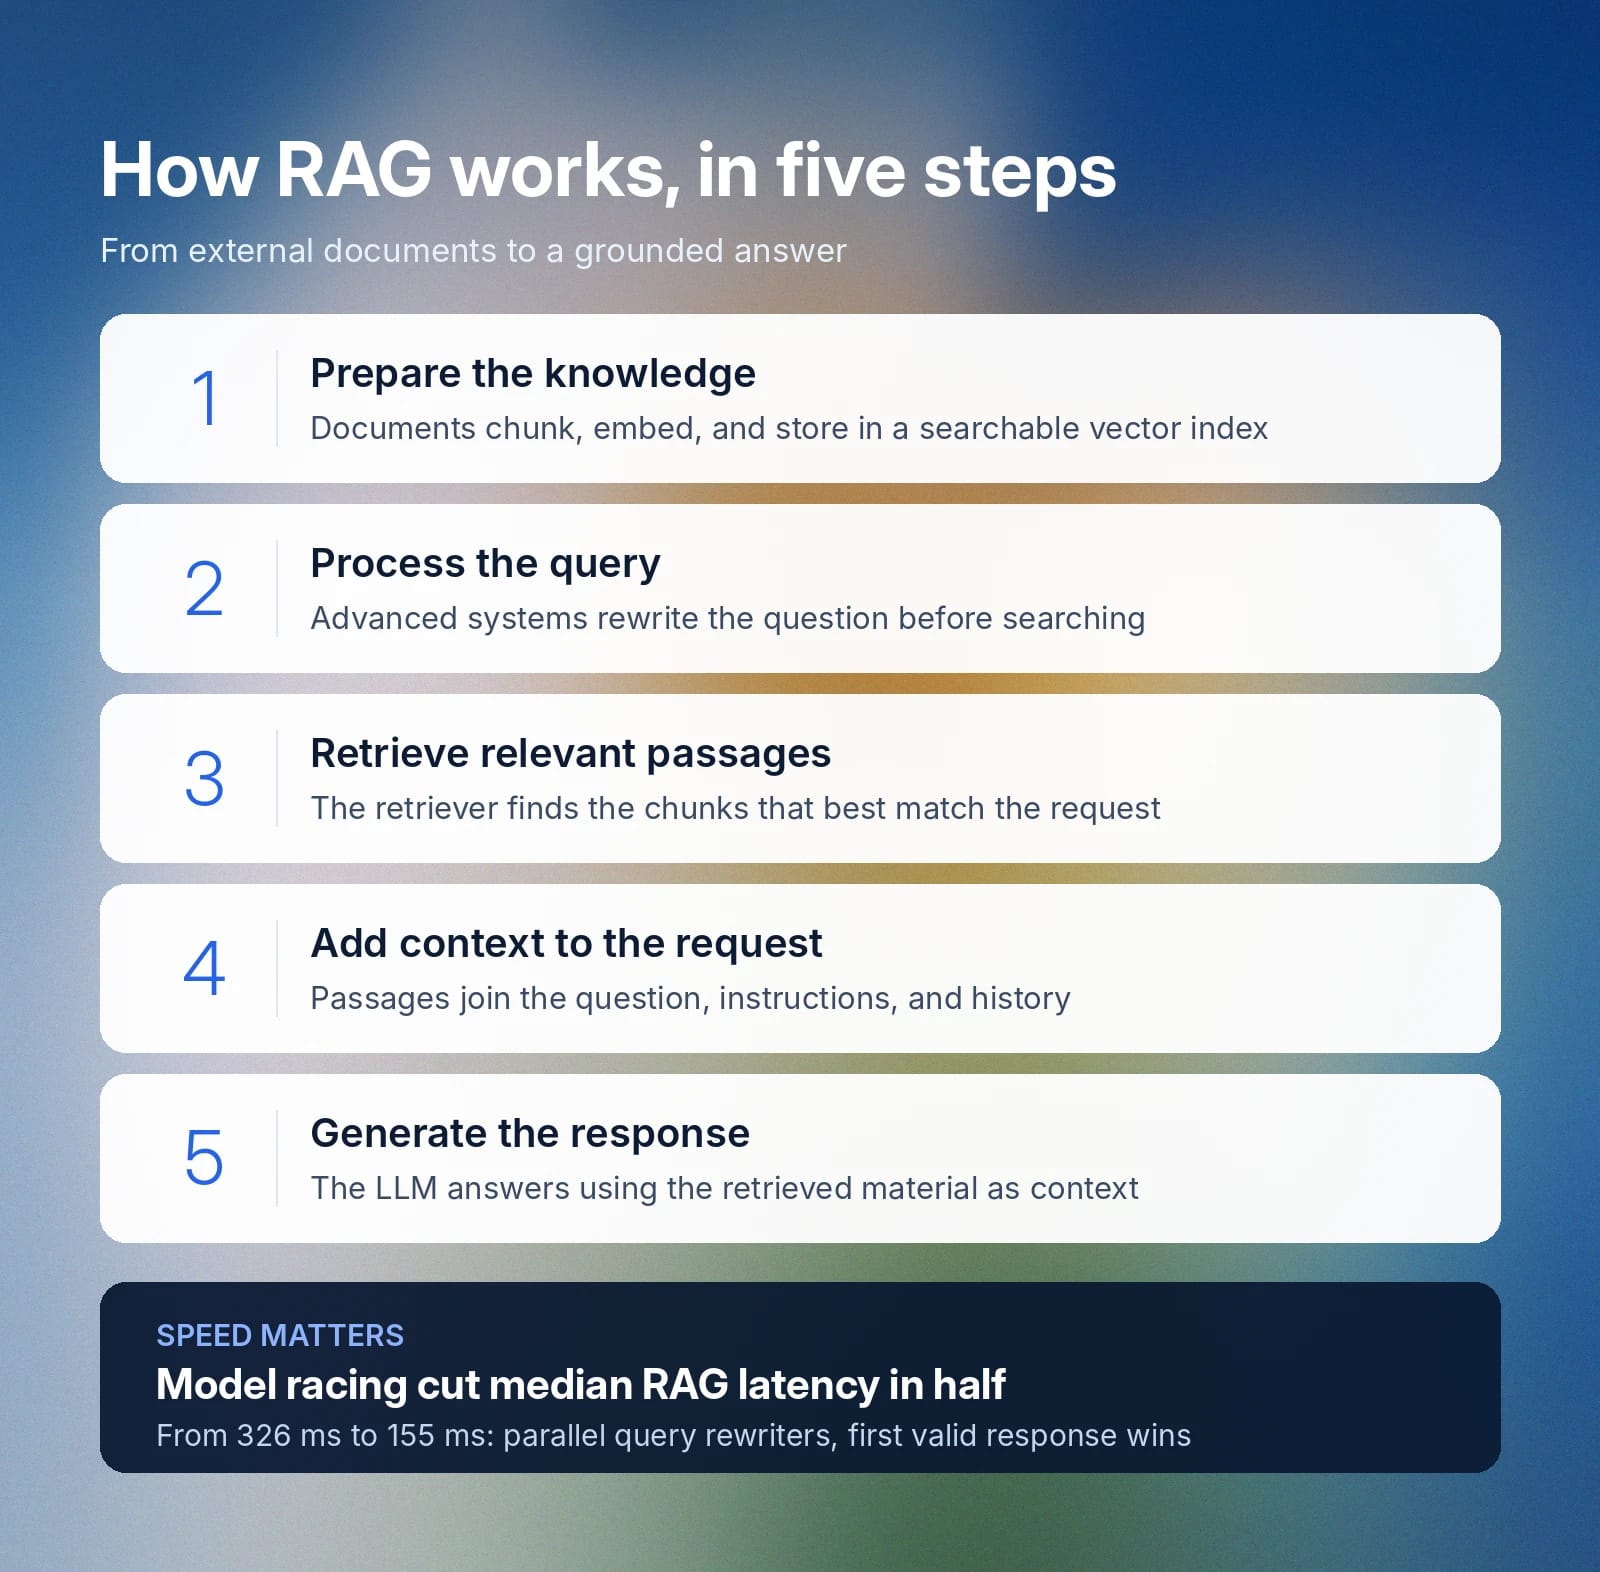
Der RAG-Prozess folgt üblicherweise fünf Schritten:
- Wissen vorbereiten: Dokumente werden in kleinere Abschnitte unterteilt (ein Prozess namens „Chunking“), in mathematische Darstellungen namens Embeddings umgewandelt und in einem durchsuchbaren Index oder einer Vektordatenbank gespeichert.
- Anfrage verarbeiten: Das System interpretiert die Frage des Nutzers und schreibt oder präzisiert sie in fortgeschritteneren RAG-Systemen vor der Suche um.
- Relevante Abschnitte abrufen: Der Retriever durchsucht die indexierte Wissensdatenbank nach den Text-Chunks, die am besten zur Anfrage passen.
- Kontext zur Modellanfrage hinzufügen: Die ausgewählten Abschnitte werden zusammen mit der Frage des Nutzers, relevanten Anweisungen und dem Gesprächsverlauf an das LLM gesendet.
- Antwort generieren: Das LLM erstellt eine Antwort und nutzt dabei das abgerufene Material als Teil seines Kontexts.
Viele RAG-Systeme lösen den Abruf selektiv als externes Tool aus. Mit ElevenAgents können Teams RAG für eine Wissensdatenbank direkt in den Agent-Einstellungen aktivieren. Das System nutzt Query-Rewriting, um vorherige Dialoge und vage Verweise bei Folgefragen in eine präzise, eigenständige Suchanfrage umzuwandeln.
Um zeitnahe Antworten zu gewährleisten, entwickelte ElevenLabs außerdem eine Model-Racing-Architektur. Sie sendet jede Anfrage parallel an mehrere Rewriting-Modelle und nutzt die erste gültige Antwort. Dieser Ansatz halbierte die mediane RAG-Latenz von 326 ms auf 155 ms. So bleibt der Abruf schnell genug, um auch bei einer großen Wissensdatenbank einen natürlichen Gesprächsfluss zu erhalten.
Was ist der Unterschied zwischen LLMs und RAG-Modellen?
Ein LLM ist ein Modell, das Sprache versteht und generiert. RAG ist eine Architektur rund um das LLM, die bei Bedarf der Anwendung externe Informationen abruft.
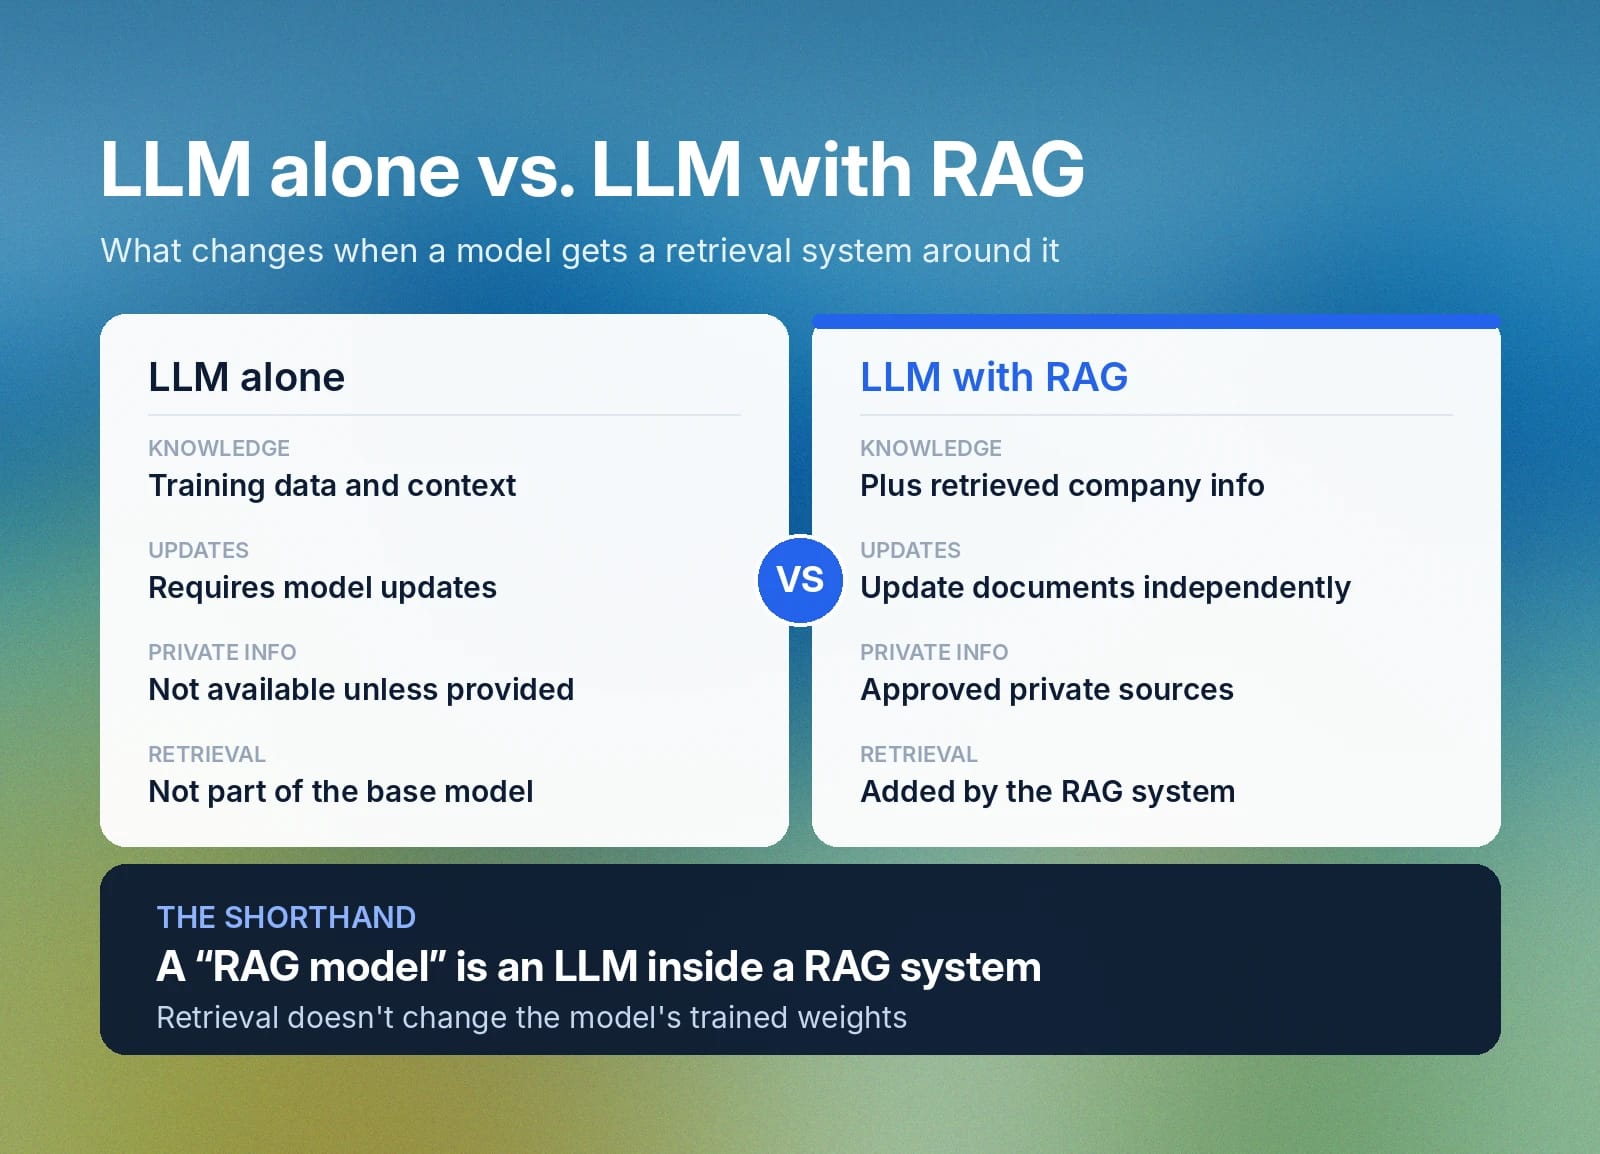
Das ändert sich, wenn ein LLM mit RAG kombiniert wird:
Merkmal | LLM allein | LLM mit RAG |
Wissen | Trainingsdaten und aktueller Kontext | Trainingsdaten, aktueller Kontext und abgerufene Unternehmensinformationen wie Richtlinien, Produktdokumentation oder Wissensdatenbank-Inhalte |
Aktualisierungen | Neue Informationen müssen im Kontext oder durch Modellaktualisierungen bereitgestellt werden | Externes Wissen kann unabhängig vom Modell aktualisiert werden |
Private Informationen | Nicht verfügbar, sofern nicht bereitgestellt | Kann aus freigegebenen privaten Quellen abrufen |
Abruf | Kein Teil des Basismodells | Wird durch das umgebende RAG-System ergänzt |
„RAG-Modell“ wird manchmal als Kurzbezeichnung für ein LLM verwendet, das innerhalb eines RAG-Systems eingesetzt wird. Beispielsweise könnte ein Unternehmen sagen, es nutze ein „RAG-Modell“ für den Kundenservice, obwohl die tatsächliche Konfiguration ein LLM ist, das vor der Generierung einer Antwort relevante Inhalte aus dem Help Center oder Richtlinien abruft.
Grenzen von RAG-Modellen in realen Anwendungen
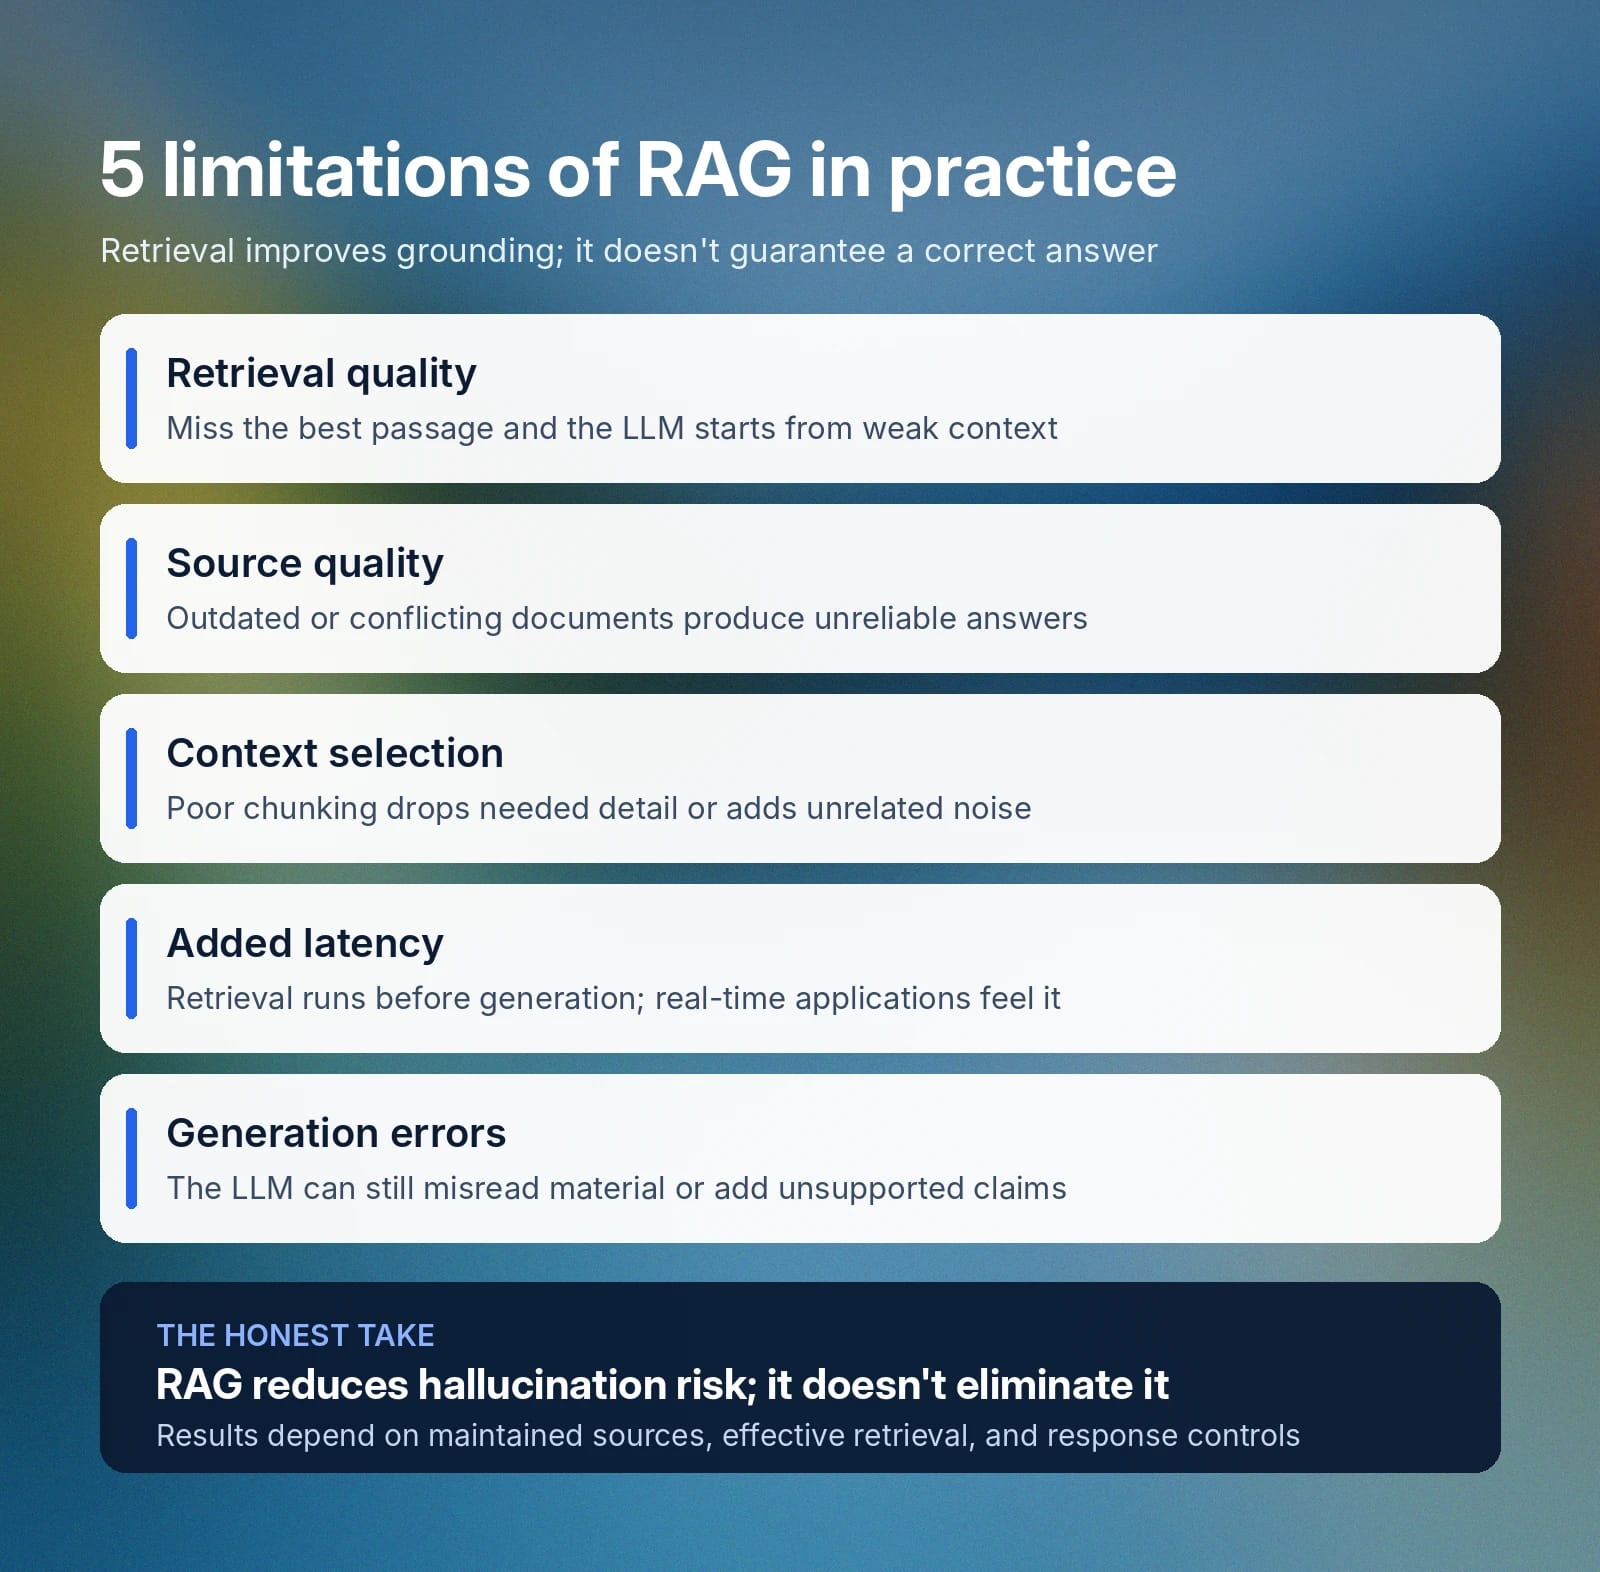
RAG verbessert den Zugriff auf relevantes Geschäftswissen außerhalb des LLM. Der Abruf bringt jedoch eigene Einschränkungen mit sich und garantiert keine richtige Antwort. Die wichtigsten Einschränkungen betreffen, was das System abruft, was es an das Modell sendet und wie das Modell antwortet:
- Abrufqualität: Wenn dem System der relevanteste Abschnitt entgeht, beginnt das LLM mit unvollständigem oder schwachem Kontext. Ungenau formulierte Anfragen, schwache semantische Übereinstimmungen oder mehrdeutige Formulierungen können den Abruf in die falsche Richtung lenken.
- Quellqualität: Veraltete, widersprüchliche oder unvollständige Dokumente können zu unzuverlässigen Antworten führen.
- Kontextauswahl: Ungeeignetes Chunking oder schlechte Abrufentscheidungen können erforderliche Details entfernen oder irrelevante Informationen einführen.
- Zusätzliche Latenz: Abruf und Anfrageverarbeitung erfolgen vor der Generierung und können Antworten in Echtzeitanwendungen verlangsamen.
- Generierungsfehler: Das LLM kann abgerufene Informationen weiterhin falsch interpretieren oder unbelegte Behauptungen aufstellen.
RAG kann das Risiko von Halluzinationen senken, beseitigt es aber nicht vollständig. Präzise Ergebnisse hängen weiterhin von gut gepflegten Quellen, effektivem Abruf und Kontrollen der finalen Antwort ab.
RAG in generativer KI: Praktische Anwendungsfälle und Vorteile
RAG ist besonders nützlich, wenn eine KI-Anwendung Informationen benötigt, die sich häufig ändern, zur Organisation gehören oder zu umfangreich sind, um sie jeder Modellanfrage hinzuzufügen.
Hier macht RAG den größten Unterschied:
Mit häufig aktualisierten Informationen Schritt halten
RAG hilft Teams, KI-Antworten an aktuellen Produktdetails, Preisen, Richtlinien und Beständen auszurichten. Teams können die Quellinformationen unabhängig aktualisieren, und RAG ruft bei einer Frage die relevante Version ab. Beispielsweise kann ein Agent zur Lead-Qualifizierung bei der Qualifizierung eines eingehenden Anrufers die neuesten Preis- oder Tarifdetails abrufen.
Privates oder spezialisiertes Wissen nutzen
Manches Wissen ist privat oder spezialisiert statt öffentlich, etwa interne Richtlinien, technische Dokumentation oder Support-Inhalte für ein bestimmtes Team. Mit RAG kann ein Agent direkt aus diesen Quellen abrufen, statt sich nur auf öffentlich verfügbare oder im Modell hinterlegte Informationen zu verlassen.
So kann ein interner IT- oder HR-Helpdesk-Agent aus einer HR-spezifischen Wissensdatenbank abrufen, um Fragen zu Mitarbeiterleistungen zu beantworten, statt öffentliche Dokumentation zu durchsuchen, die diese Informationen nicht enthält.
Große Wissensdatenbanken durchsuchen
RAG hilft, wenn ein Unternehmen wesentlich mehr Dokumentation hat, als ein LLM in einer Anfrage berücksichtigen kann. Statt die gesamte Sammlung an das Modell zu senden, ruft es nur die für die aktuelle Frage relevanten Abschnitte ab. Im Vertrieb kann ein technischer Assistent während eines Gesprächs Produkthandbücher nach relevanten Anforderungen durchsuchen.
Starten Sie mit ElevenAgents für fortschrittliche RAG-Lösungen
ElevenAgents ermöglicht Teams, KI-Sprach- und Chat-Agenten zu entwickeln, die RAG mit verbundenen Wissensquellen nutzen – über die No-Code-Webplattform oder die API für Teams, die Agenten direkt in ihre eigenen Produkte einbetten möchten.
Für RAG-fähige Agenten können Teams Dokumente, URLs oder Text zu einer Wissensdatenbank hinzufügen und nur die für jede Anfrage relevanten Informationen abrufen.
ElevenLabs hat den Abruf auch für Echtzeitgespräche optimiert und die mediane RAG-Latenz in seiner ElevenAgents-Architektur von 326 ms auf 155 ms reduziert. Teams, die mit ElevenAgents entwickeln, erhalten diese Abruffunktionen direkt integriert – unabhängig davon, ob sie einen Agenten über das Dashboard konfigurieren oder über die API darauf aufbauen.
Jetzt starten mit ElevenAgents oder kontaktieren Sie unser Team, um die passende Konfiguration für Ihre Anwendung zu besprechen.


