
Was ist ein Kontextfenster? Was jeder LLM-Nutzer wissen sollte
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Ein Kontextfenster ist die Menge an Informationen, die ein Large Language Model (LLM) in einer einzelnen Anfrage verarbeiten kann. Es wird in Tokens gemessen und kann Ihren Prompt, den Gesprächsverlauf, Systemanweisungen, abgerufene Dokumente, Tool-Ergebnisse und die generierte Antwort des Modells umfassen.
Ein größeres Kontextfenster ermöglicht einem Modell, mehr Informationen in einer einzelnen Anfrage zu verarbeiten. Ein Coding-Agent, der einen Bug untersucht, kann beispielsweise gleichzeitig mit relevanten Quelldateien, Dokumentation, Testergebnissen und aktuellen Codeänderungen arbeiten, statt jedes Element einzeln zu analysieren und zwischen Anfragen nützlichen Kontext zu verlieren.
Ein größeres Kontextfenster ist jedoch nicht mit perfektem Gedächtnis gleichzusetzen. Längere Prompts erfordern mehr Rechenleistung, verbrauchen mehr Tokens und können es einem Modell erschweren, die wirklich relevanten Details zu erkennen. Untersuchungen zu Long-Context-Modellen, darunter die Studie Lost in the Middle und NVIDIAs RULER-Benchmark, zeigen wiederholt, dass Modelle mit wachsendem Kontext weniger von den verfügbaren Informationen nutzen – insbesondere wenn relevante Informationen zwischen weniger nützlichem Material verborgen sind.
Dieser Artikel erklärt, wie Kontextfenster funktionieren, wie sie gemessen werden, was passiert, wenn sie voll sind, und wie Entwickler sie effektiv verwalten können.
Zusammenfassung
- Ein Kontextfenster ist das gesamte Token-Budget, das ein LLM für eine einzelne Anfrage nutzt. Es umfasst den Nutzer-Prompt, den Gesprächsverlauf, abgerufene Inhalte und die Ausgabe.
- Größere Kontextfenster ermöglichen längere Dokumente, Codebasen und Gespräche, garantieren aber nicht, dass das Modell jeden Teil davon gut nutzt.
- Modelle rufen Informationen aus der Mitte langer Prompts am unzuverlässigsten ab. Dieses Muster ist in der Lost-in-the-Middle-Studie und der RULER-Benchmark dokumentiert.
- Effektives Kontextmanagement – Abruf, Zusammenfassung und Caching – ist meist besser, als einfach möglichst viele Tokens zu senden.
- Die beste Kontextstrategie passt zu Ihrer tatsächlichen Arbeitslast, nicht zum größten beworbenen Kontextfenster.
Was ist ein Kontextfenster in einem KI-Modell?
Ein Kontextfenster ist der aktive Arbeitsbereich eines Modells. Dort kommt alles zusammen, was für die aktuelle Anfrage relevant ist, bevor das Modell eine Antwort generiert.
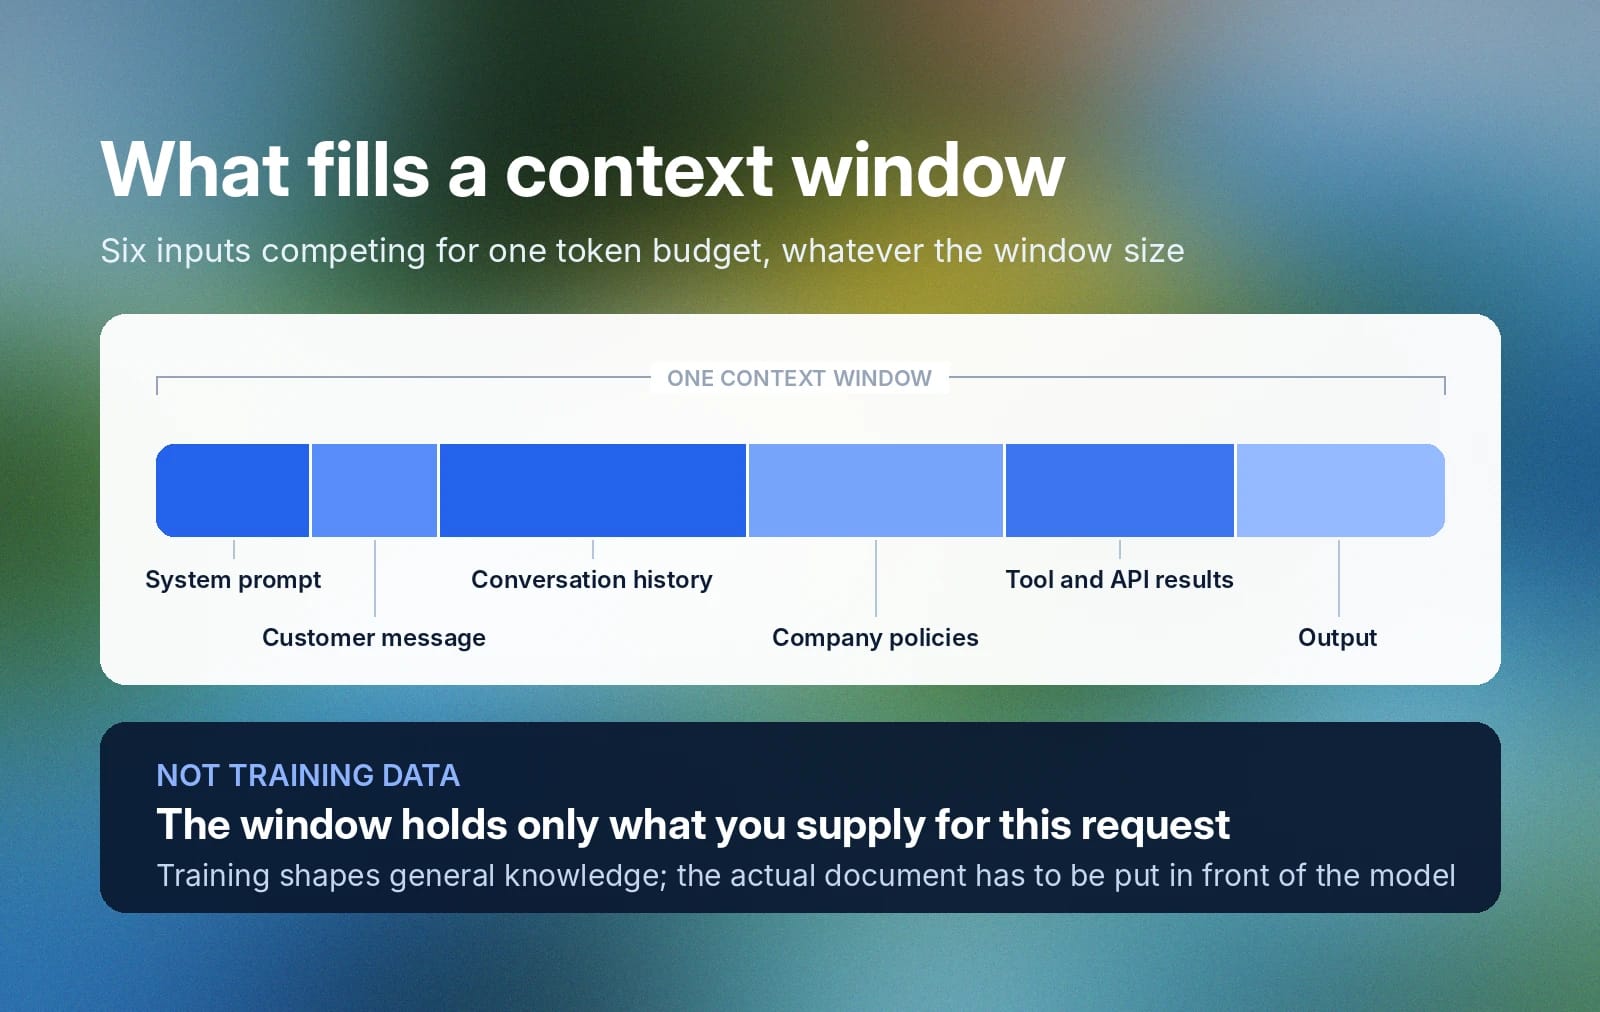
Stellen Sie sich einen KI-Agenten vor, der ein Gespräch im Kundensupport zusammenfasst und eine Lösung empfiehlt. Dafür muss das Modell Folgendes verarbeiten:
- Den System-Prompt
- Die Nachricht des Kunden
- Den Gesprächsverlauf
- Die Unternehmensrichtlinien
- Die Ergebnisse von Tools und APIs
- Die Ausgabe
All das konkurriert um Platz im selben Kontextfenster, unabhängig von dessen Größe.
Kontextfenster enthalten keine Trainingsdaten. Beim Training werden Informationen dauerhaft in die Parameter eines Modells eingebracht und prägen, was es allgemein „weiß“. Ein Kontextfenster enthält dagegen nur Informationen, die für die aktuelle Aufgabe bereitgestellt werden.
Dieser Unterschied ist in der Praxis wichtig: Muss eine Anwendung ein Modell über eine bestimmte Richtlinie, einen Kundendatensatz oder ein technisches Dokument schlussfolgern lassen, sind diese Informationen nicht allein deshalb verfügbar, weil das Modell mit ähnlichem Material trainiert wurde. Sie müssen normalerweise direkt über den Prompt oder ein Abruf- oder Toolsystem in den Arbeitskontext des Modells gelangen. Andernfalls schlussfolgert das Modell anhand von Allgemeinwissen statt anhand des tatsächlich vorliegenden Dokuments.
Tokenisierung und Kontextfenster: So werden Daten verarbeitet
Bevor ein LLM Text verarbeitet, zerlegt ein Tokenizer ihn in kleinere Einheiten, die Tokens genannt werden. Ein Token kann ein ganzes Wort, einen Wortteil, ein Satzzeichen oder einen anderen kurzen Textabschnitt darstellen.
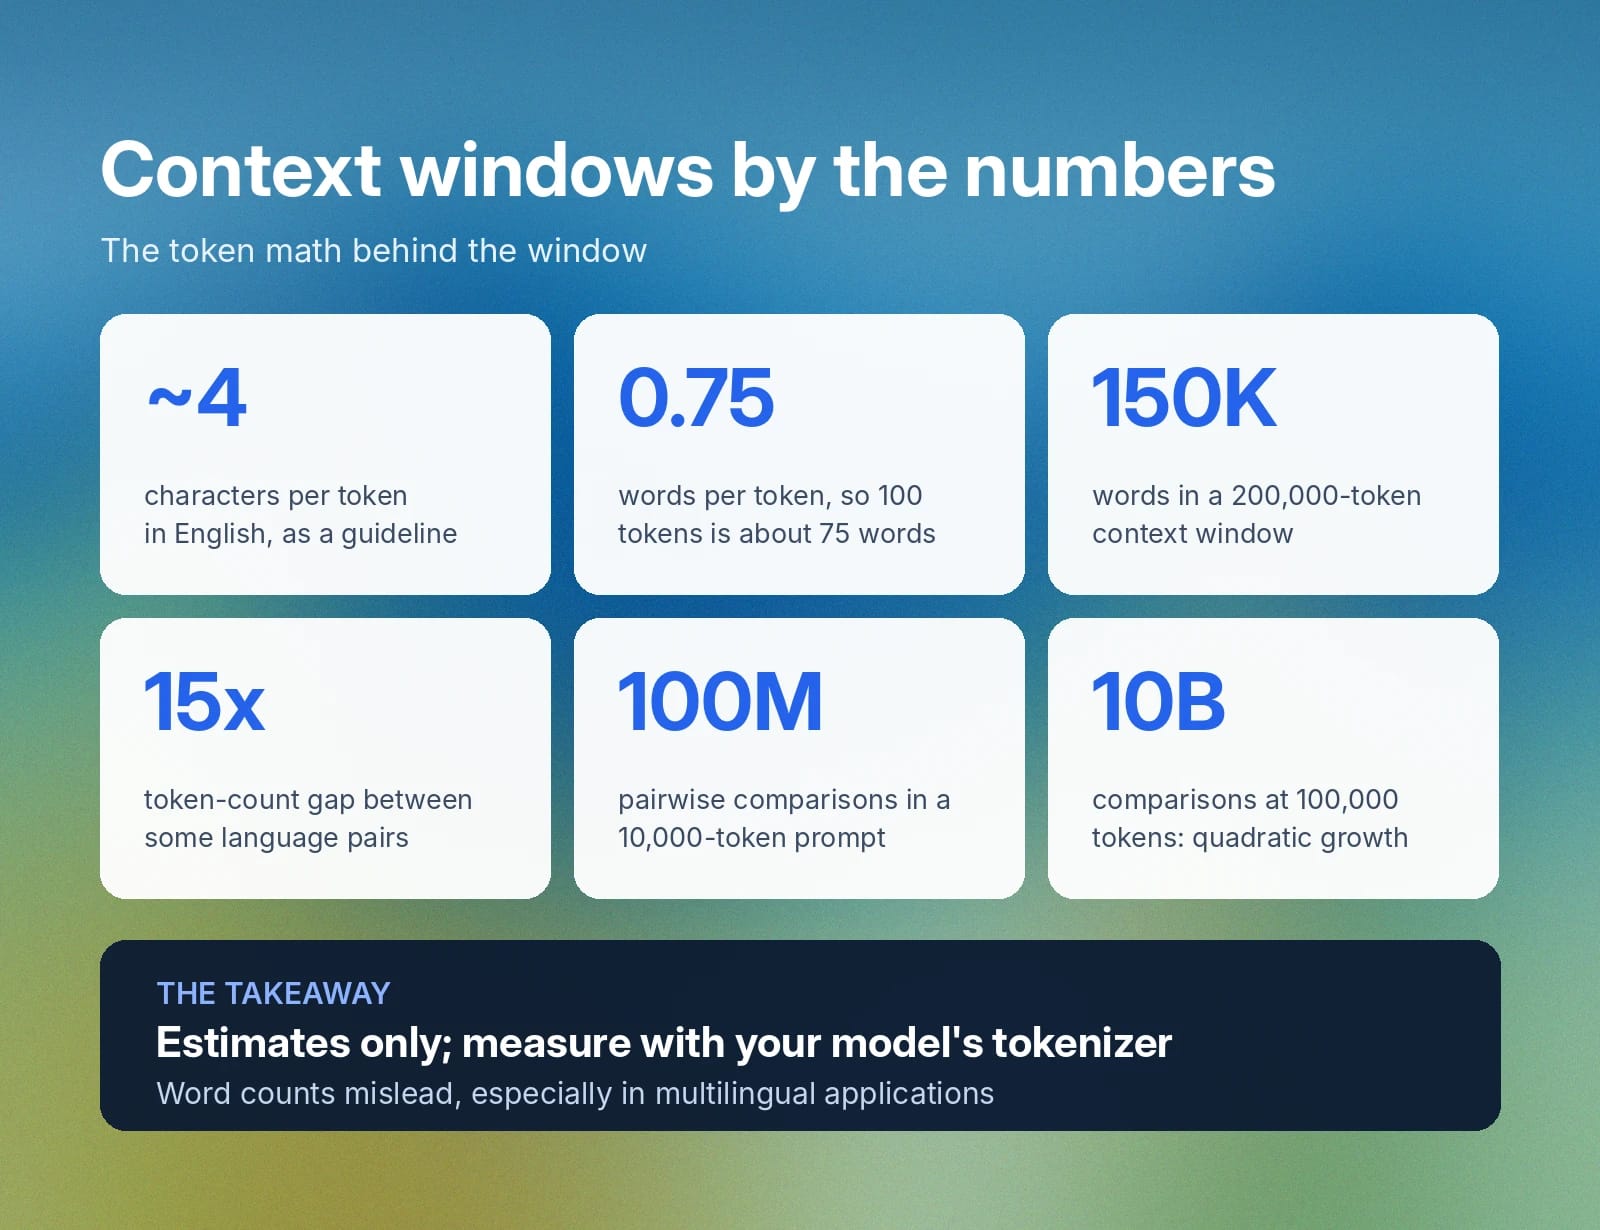
Für Englisch gilt als hilfreiche Faustregel: Ein Token entspricht ungefähr vier Zeichen oder etwa drei Vierteln eines Wortes. Nach dieser Schätzung entsprechen 100 Tokens etwa 75 Wörtern. Das ist jedoch nur eine Annäherung. Betrachten Sie den Satz „Kontextfenster beeinflussen die Performance von Anwendungen.“ Ein Tokenizer stellt ihn nicht unbedingt als fünf vollständige Wörter dar; je nach Tokenizer können ein oder mehrere Wörter in mehrere Subword-Tokens aufgeteilt werden.
Auch zwischen Sprachen unterscheidet sich die Tokenisierung erheblich. Zwei Sätze mit ähnlicher Bedeutung und ähnlicher sichtbarer Länge können je nach Sprache und Tokenizer sehr unterschiedliche Mengen an Tokens verbrauchen. Forschung zur Fairness von Tokenizern hat ergeben, dass sich einige Sprachpaare bei gleichwertigem Text um bis zu das 15-Fache in der tokenisierten Länge unterscheiden – selbst bei Tokenizern mit mehrsprachiger Unterstützung. Entwickler mehrsprachiger Anwendungen sollten den Tokenverbrauch mit dem tatsächlichen Tokenizer ihres Modells messen, statt ihn anhand der Wortanzahl zu schätzen.
Ein Kontextfenster mit 200.000 Tokens klingt möglicherweise riesig. Eine Anwendung, die fortlaufend Gesprächsverlauf, abgerufene Dokumentation, Tool-Antworten und Systemanweisungen anhängt, kann dieses Limit jedoch schneller erreichen als erwartet. Deshalb überwachen produktive Anwendungen oft den Tokenverbrauch und nutzen Techniken wie Zusammenfassungen, das Kürzen des Verlaufs, Abruffilterung und Prompt-Komprimierung, damit die relevantesten Informationen im aktiven Kontext bleiben.
Wie funktioniert ein Kontextfenster in Sprachmodellen?
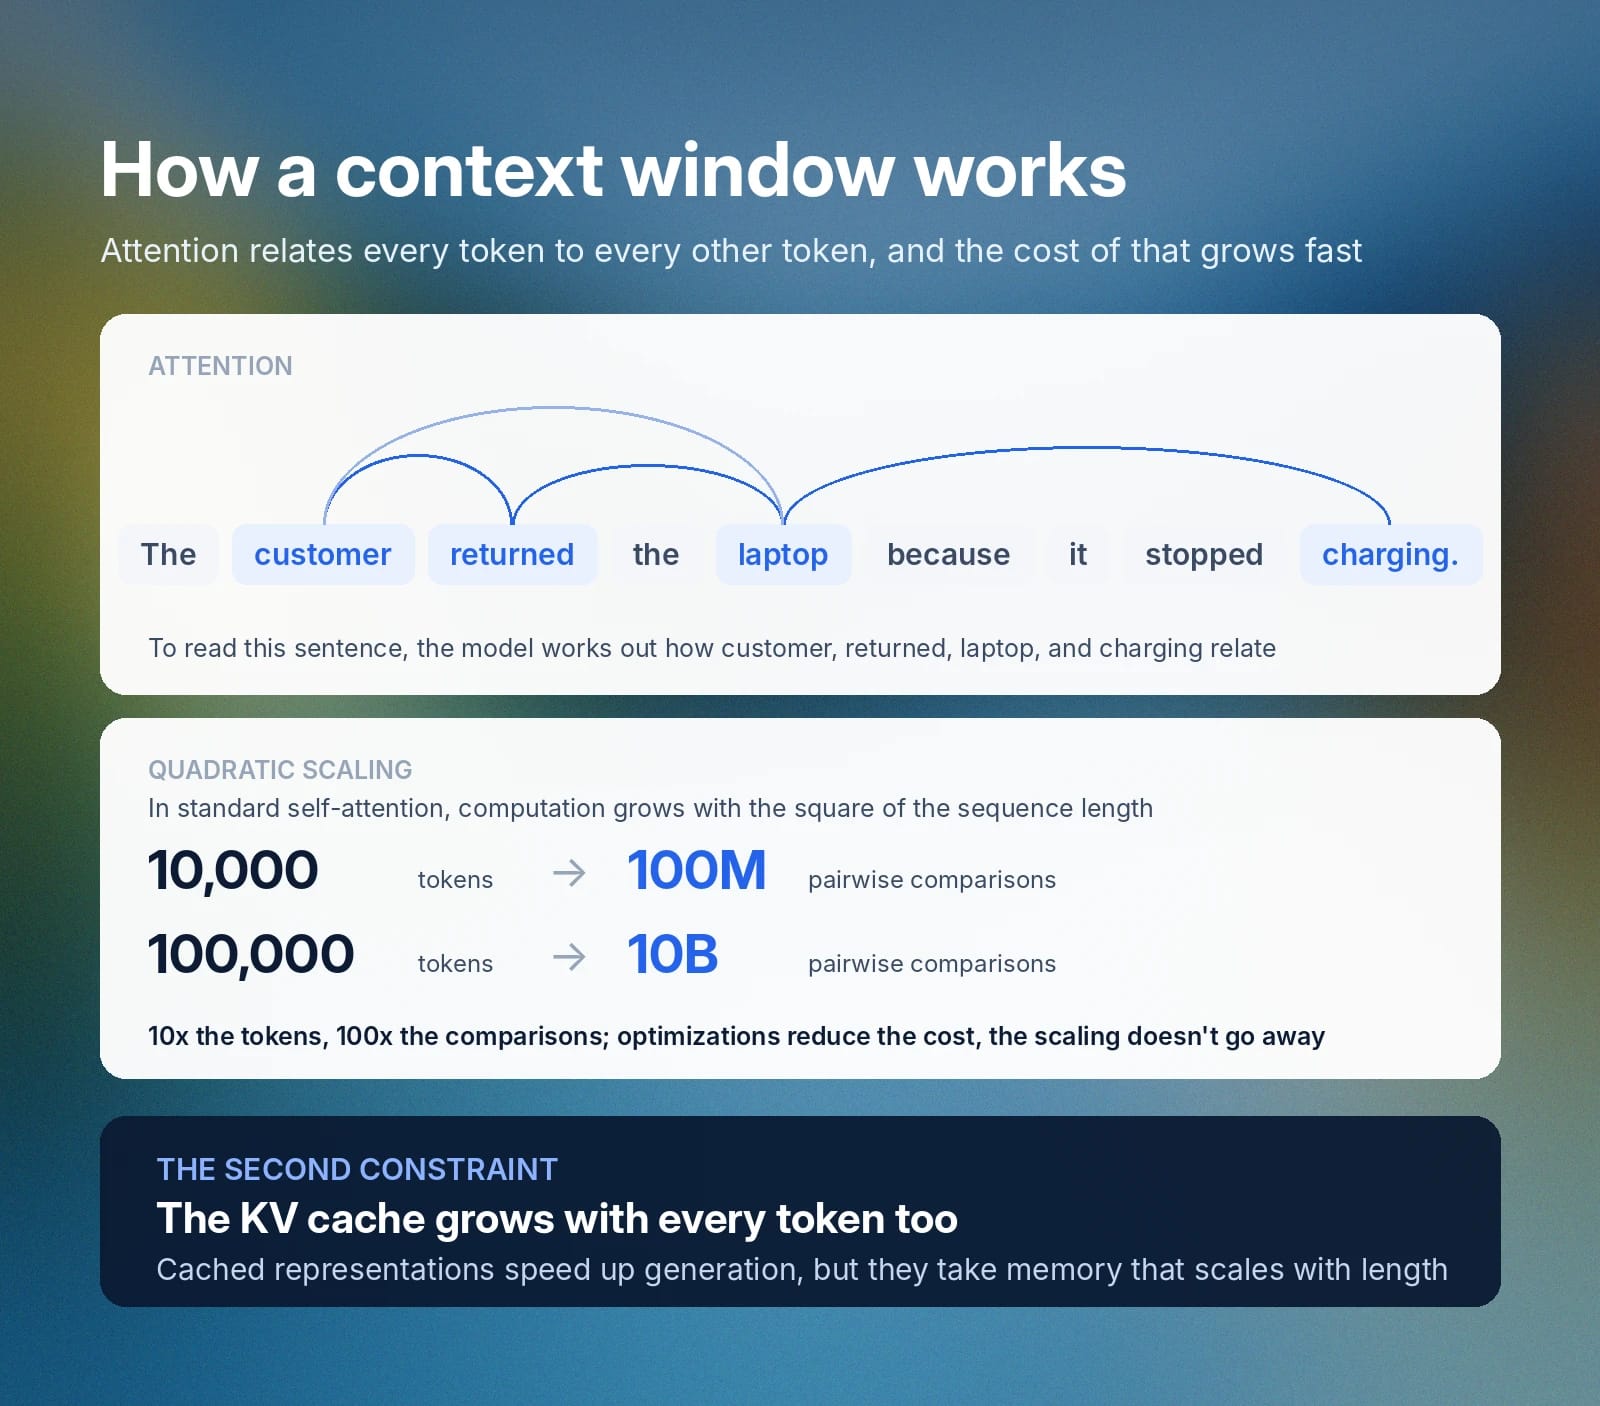
Ein Kontextfenster funktioniert über den Attention-Mechanismus der Transformer-Architektur. Dieser berechnet, wie jedes Token einer Eingabe mit jedem anderen Token zusammenhängt, bevor das Modell eine Antwort erzeugt.
Betrachten Sie den Satz „Der Kunde gab den Laptop zurück, weil er nicht mehr geladen wurde.“ Um ihn richtig zu interpretieren, muss das Modell ermitteln, wie Kunde, Laptop, zurückgegeben und geladen zusammenhängen. Mit zunehmender Sequenzlänge wächst die Anzahl dieser Beziehungen schnell.
Bei Standard-Self-Attention wächst der erforderliche Rechenaufwand ungefähr quadratisch mit der Sequenzlänge. Ein Prompt mit 10.000 Tokens erfordert beispielsweise rund 100 Millionen paarweise Vergleiche, ein Prompt mit 100.000 Tokens rund 10 Milliarden. Moderne Modelle nutzen verschiedene Architektur- und Infrastruktur-Optimierungen, um diese Kosten in der Praxis zu senken. Das zugrunde liegende Skalierungsproblem bleibt jedoch bestehen.
Lange Gespräche bringen eine zweite Einschränkung mit sich: den Key-Value- oder KV-Cache. Bei der Generierung speichern Modelle Zwischenrepräsentationen früherer Tokens, statt sie für jedes neue Token neu zu berechnen. Das beschleunigt die Inferenz erheblich. Der Cache benötigt jedoch selbst Speicher und wächst mit zunehmender Sequenzlänge.
Maximale Kontextlänge in KI-Modellen und warum sie wichtig ist
Die maximale Kontextlänge eines Modells definiert, wie viele Informationen es in einer einzelnen Anfrage annehmen und verarbeiten kann. Ob das Modell ein großes Kontextfenster effektiv nutzt, ist jedoch eine andere Frage.
Längere Kontextfenster ermöglichen Anwendungsfälle, die mit früheren LLMs schwierig oder unpraktisch waren. Entwickler können einem Modell ein vollständiges Code-Repository, ein langes Rechtsdokument, eine Forschungsarbeit, ein Besprechungsprotokoll oder einen umfangreichen Gesprächsverlauf bereitstellen, ohne das Material zuvor auf einige Tausend Tokens reduzieren zu müssen.
Das ist wichtig, weil der Erhalt von mehr Originalkontext die Fähigkeit eines Modells verbessern kann, Fragen präzise zu beantworten, Beziehungen zwischen weit auseinanderliegenden Informationen zu erkennen und Aufgaben zu erledigen, die vom gesamten Dokument abhängen. Ein Coding-Assistent muss beispielsweise mehrere Dateien untersuchen, um zu verstehen, wie eine Funktion aufgerufen wird. Ein Assistent für Rechtsdokumente muss möglicherweise Definitionen in einem Abschnitt mit Verpflichtungen vergleichen, die viel später im Dokument beschrieben werden.
Ein größeres Kontextfenster führt jedoch nicht automatisch zu besseren Ergebnissen. Sehr lange Eingaben können Kosten und Latenz erhöhen, und Modelle beachten Informationen in der Mitte eines großen Kontexts möglicherweise weniger. Entwickler sollten relevante Informationen daher gezielt auswählen, lange Eingaben klar strukturieren und bei Bedarf Techniken wie Abruf, Zusammenfassung und Kontextbereinigung einsetzen.
Vergleich der Kontextfenstergrößen nach Modell
Die Kontextfenster der führenden Modellfamilien reichen heute von einigen Hunderttausend bis zu 10 Millionen Tokens. So vergleichen sich die aktuellen Flaggschiffmodelle:
Modell | Kontextfenster | Hinweise |
10 Millionen Tokens | Metas Modell mit offenen Gewichten; zum Zeitpunkt der Veröffentlichung das größte öffentlich verfügbare Fenster | |
1,05 Millionen Tokens | OpenAIs aktuelles Flaggschiffmodell für Coding und agentenbasiertes Schlussfolgern | |
1 Million Tokens | Googles aktuelles Pro-Modell für die Analyse langer Dokumente und mehrerer Dateien | |
1 Million Tokens | Anthropics aktuelles Modell der Sonnet-Stufe; das Fenster gilt standardmäßig für die gesamte Claude API |
Beworbene Limits ändern sich schnell, wenn Anbieter neue Modelle veröffentlichen und ihre Obergrenzen erhöhen. Betrachten Sie eine solche Tabelle daher als Momentaufnahme, nicht als dauerhafte Rangliste. Die Kontextgröße ist zudem nur ein Faktor bei der Modellwahl. Sie sagt allein nichts über Qualität beim Schlussfolgern, Ausgabelimits, Latenz oder Kosten aus.
Auswirkungen eines kleinen gegenüber einem großen Kontextfenster
Ein kleines Kontextfenster zwingt Entwickler zur Auswahl. Lange Dokumente werden in Abschnitte unterteilt, ältere Gesprächsverläufe zusammengefasst und externes Wissen nur bei tatsächlichem Bedarf abgerufen.
Ein großes Kontextfenster beseitigt einige dieser Einschränkungen. Sie können mehr Beispiele bereitstellen, mehr Gesprächsverlauf erhalten oder einen größeren Dokumentensatz analysieren, ohne zunächst alles aufzuteilen.
Ein größeres Fenster bringt jedoch ein anderes Problem mit sich: Attention-Verdünnung. Enthält ein Prompt große Mengen an Informationen, kann das Modell Schwierigkeiten haben, die für die aktuelle Anfrage relevantesten Details zu bestimmen. Wichtige Anweisungen oder Belege können zwischen weniger relevanten Inhalten untergehen. Das erhöht das Risiko unvollständiger, inkonsistenter oder unpräziser Antworten.
Warum Modelle in der Mitte den Überblick verlieren
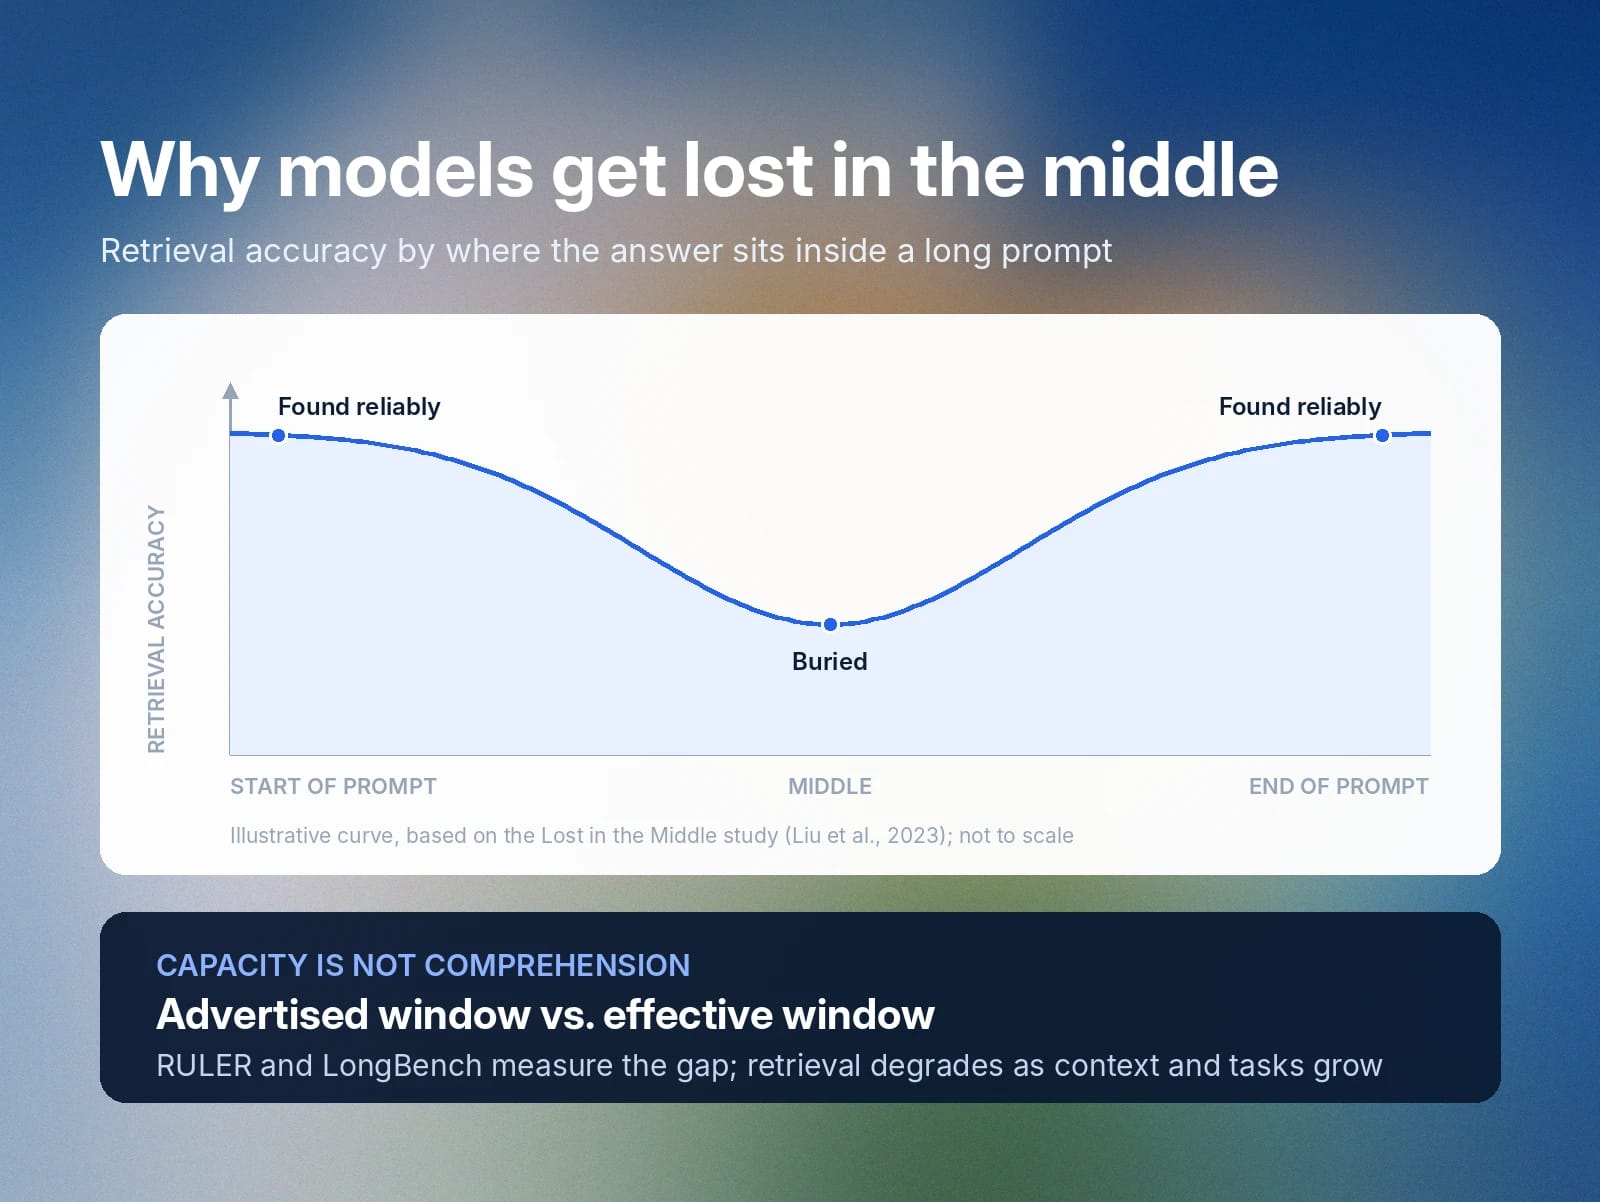
Modelle rufen Informationen in der Nähe des Anfangs oder Endes eines langen Prompts meist am besten ab – und am schlechtesten, wenn sie in der Mitte verborgen sind. Die einflussreiche Lost in the Middle-Studie testete dies direkt. Dafür platzierte sie die Antwort auf eine Frage an unterschiedlichen Stellen in einem langen Prompt und maß, wie häufig Modelle sie fanden. Die Genauigkeit war am Anfang und Ende des Kontexts durchgehend am höchsten und in der Mitte am niedrigsten.
Das bedeutet, dass ein Modell ein Dokument technisch annehmen kann, ohne jeden Teil davon zuverlässig zu nutzen. Geben Sie einem LLM 100 Support-Dokumente, weil eines davon die Antwort auf die Frage eines Kunden enthält, kann ein größeres Kontextfenster zwar alle 100 aufnehmen. Das Modell muss jedoch weiterhin eine relevante Passage unter 99 irrelevanten herausfiltern – und ein längeres Fenster garantiert nicht, dass es das schafft.
Daher lohnt es sich, zwischen dem beworbenen Kontextfenster eines Modells und seinem effektiven Kontextfenster für eine bestimmte Arbeitslast zu unterscheiden. Benchmarks wie RULER und LongBench versuchen, diese Lücke zu messen. RULER zeigte, dass sich selbst Modelle mit nahezu perfekten Ergebnissen bei einfachen Abruf-Tests verschlechterten, wenn Kontextlänge und Aufgabenkomplexität zunahmen. LongBench bewertet breitere Aufgaben, darunter Fragen und Antworten zu Dokumenten, Schlussfolgern über mehrere Dokumente, Zusammenfassung, Few-Shot-Learning und Code-Vervollständigung.
Langer Kontext bietet weiterhin echten Mehrwert. Kapazität und Verständnis sind einfach unterschiedliche Eigenschaften, und beide sind bei der Wahl eines Modells für eine bestimmte Aufgabe wichtig.
Kontextlimits verwalten: Best Practices für Entwickler
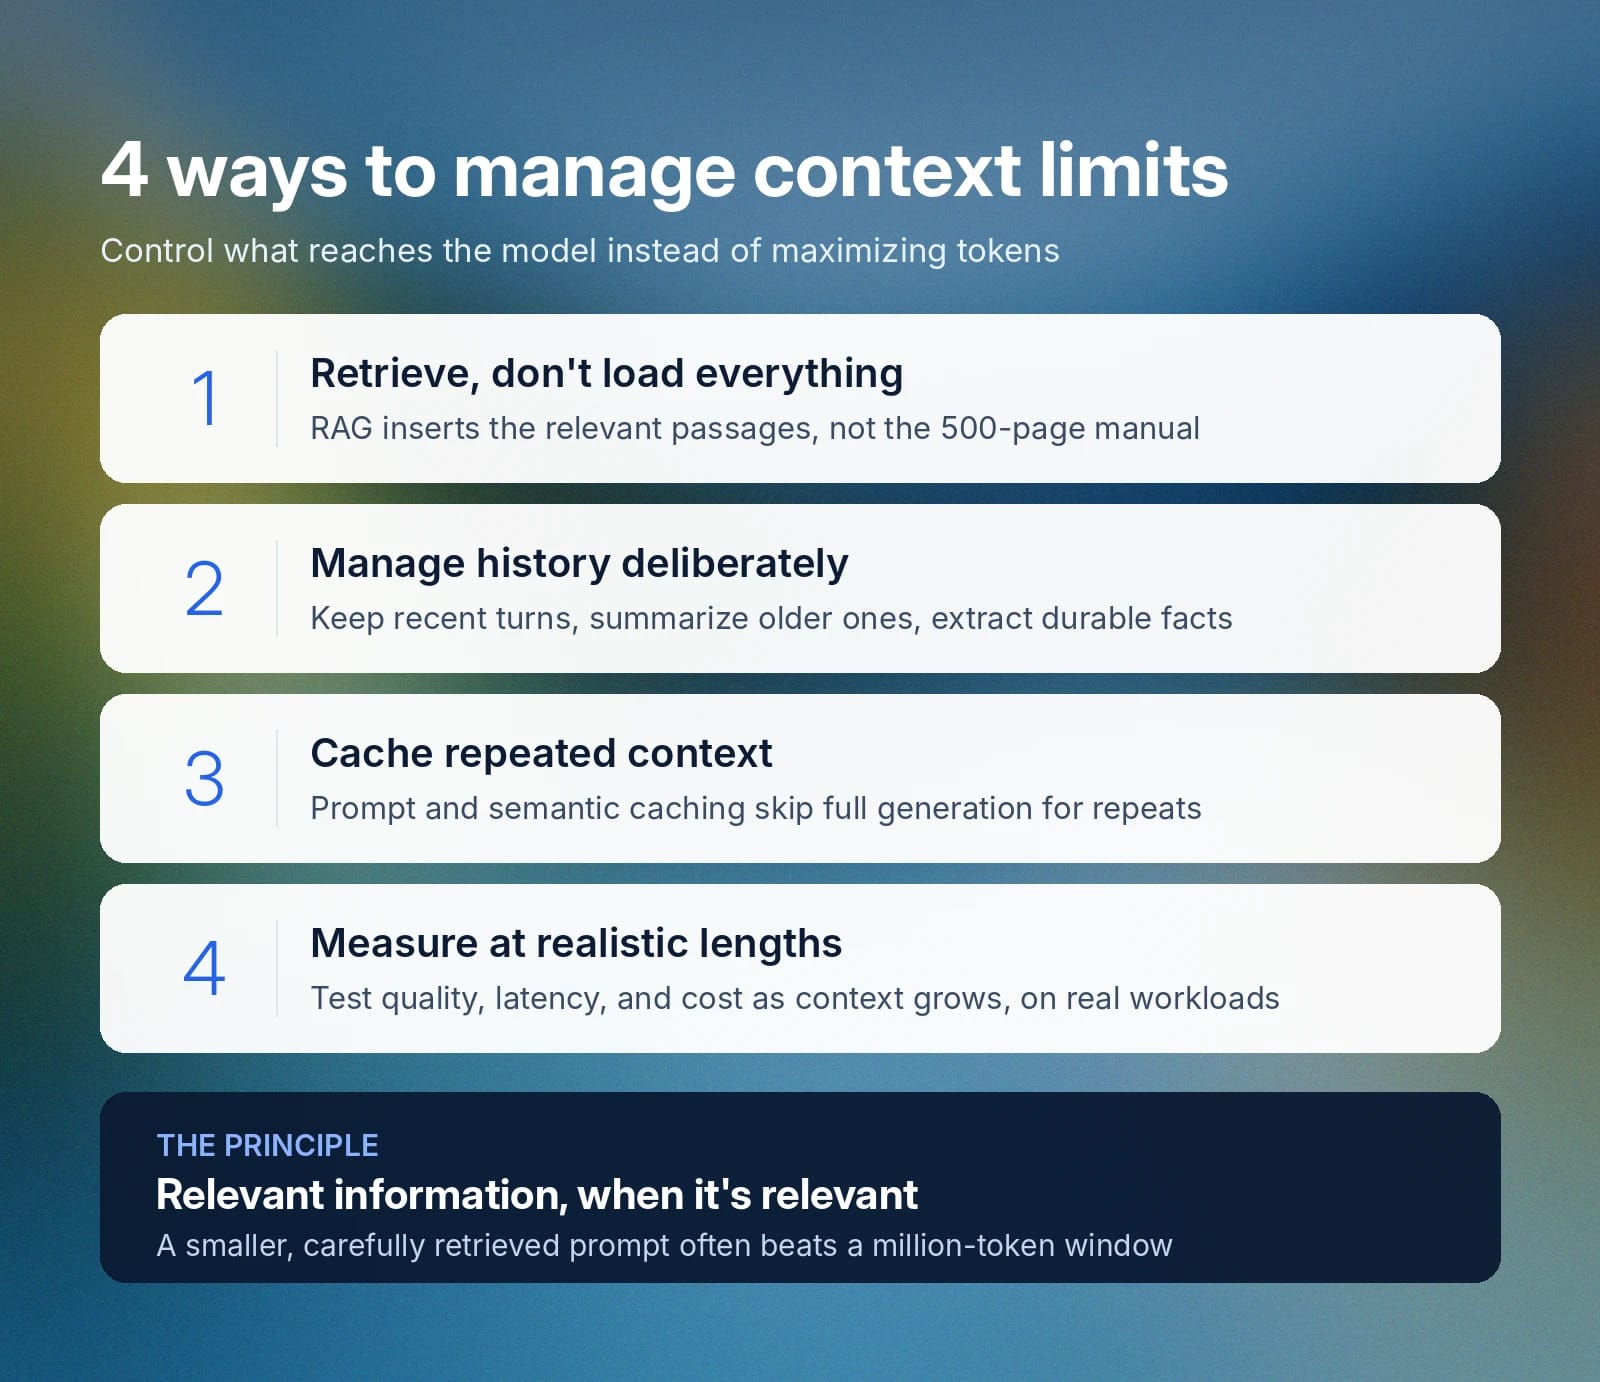
Gutes Kontextmanagement bedeutet, zu kontrollieren, was das Modell erreicht: die für die Aufgabe relevanten Informationen dann bereitzustellen, wenn sie relevant sind, statt die Token-Anzahl in jeder Anfrage zu maximieren. Die folgenden Praktiken helfen Entwicklern, unnötigen Kontext zu reduzieren, die Antwortqualität zu verbessern und Kosten sowie Latenz zu kontrollieren.
1. Relevante Informationen abrufen, statt alles zu laden
Retrieval-Augmented Generation (RAG) ermöglicht einer Anwendung, eine externe Wissensbasis zu durchsuchen und nur die relevanten Passagen in den Kontext des Modells einzufügen. Statt ein vollständiges Handbuch mit 500 Seiten in jede Support-Anfrage aufzunehmen, ruft die Anwendung die wenigen Passagen ab, die der tatsächlichen Frage des Kunden am nächsten kommen.
Das senkt den Tokenverbrauch und gibt dem Modell ein viel klareres Signal, was wichtig ist. Die Abrufqualität bleibt entscheidend: Produktive RAG-Systeme verbessern ihre Ergebnisse typischerweise, indem sie Dokumente sorgfältig in Abschnitte unterteilen, mehrere Kandidatenpassagen abrufen, diese neu gewichten und alles Irrelevante herausfiltern, bevor sie den finalen Prompt erstellen. ElevenLabs hat beispielsweise seine RAG-Pipeline überarbeitet und Query-Rewriting sowie parallele Modellaufrufe ergänzt. Dadurch halbierte sich die mediane Abruflatenz.
2. Gesprächsverlauf gezielt verwalten
Konversationsanwendungen sammeln schnell Kontext an. Jede vorherige Nachricht unbegrenzt anzuhängen, verschwendet Tokens und kann irrelevante Details in spätere Gesprächsrunden ziehen.
Anwendungen lösen dies, indem sie die neuesten Gesprächsrunden behalten, ältere Austausche zusammenfassen, dauerhafte Fakten in einem strukturierten Speicher extrahieren und ältere Details nur erneut abrufen, wenn sie wieder relevant werden. So entsteht eine hilfreiche Trennung zwischen kurzfristigem Gesprächskontext, den das Modell sofort benötigt, und langfristigem Anwendungsspeicher, der später wieder eingebunden werden kann.
3. Caching verwenden, wenn sich Kontext wiederholt
Viele Anwendungen senden wiederholt dieselben umfangreichen Anweisungen oder beantworten Fragen, die bereits bearbeiteten semantisch ähnlich sind. Caching reduziert diesen Aufwand.
Prompt- oder Kontext-Caching ermöglicht die effizientere Wiederverwendung wiederholter Eingaben. Semantisches Caching geht noch einen Schritt weiter, indem es erkennt, wenn eine neue Frage ungefähr dasselbe bedeutet wie eine bereits vom System beantwortete. „Wie lauten Ihre Rückgabebedingungen?“ und „Wie lange kann ich einen Artikel zurückgeben?“ sind unterschiedliche Zeichenfolgen, die ein semantischer Cache als dieselbe Frage behandeln kann. So wird ein vollständiger Generierungsaufruf übersprungen und sowohl Latenz als auch Tokenkosten werden gesenkt.
4. Performance bei realistischen Kontextlängen messen
Wählen Sie eine Kontextstrategie nicht allein anhand des beworbenen Tokenlimits eines Modellanbieters. Testen Sie repräsentative Produktionslasten und messen Sie Antwortqualität, Abrufgenauigkeit, Latenz, Tokenverbrauch, Kosten und Fehlerraten mit zunehmender Kontextlänge.
Vergleichen Sie Strategien wie mehr Kontext bereitzustellen, weniger Passagen abzurufen, Gesprächsverläufe zusammenzufassen oder Abruf und Zusammenfassung zu kombinieren. Ein Modell mit einem Kontextfenster von einer Million Tokens kann Ihre Anwendung technisch unterstützen, während ein kleinerer, sorgfältig abgerufener Prompt schnellere und präzisere Ergebnisse zu geringeren Kosten liefert.
Starten Sie mit ElevenAgents für skalierbare Sprachlösungen
Kontextmanagement ist besonders bei Konversationsagenten wichtig. Sie müssen die aktuelle Äußerung mit vorherigen Gesprächsrunden, Geschäftsanweisungen, Kundeninformationen, Wissensbasis-Inhalten und Tool-Ergebnissen kombinieren und dabei schnell genug antworten, damit sich das Gespräch natürlich anfühlt.
ElevenAgents vereint diese Komponenten auf einer Plattform zum Erstellen und Bereitstellen von KI-Sprachagenten. Die Orchestrierungs-Engine koordiniert Spracherkennung, ein LLM und Text to Speech, während Entwickler Prompts, Wissensdatenbanken, Tools, Workflows und das zugrunde liegende Sprachmodell konfigurieren. Ausdrucksstarke Wiedergabe, einschließlich der Art, wie ein Agent emotionalen Kontext in Sprache vermittelt, hängt von demselben Kontext ab, der von Anfang an prägt, was der Agent sagt.
Für das Wissensmanagement unterstützt ElevenAgents sowohl Dokumente mit vollständigem Kontext als auch RAG, direkt auf der Plattform konfigurierbar. Kleine Dokumente gelangen direkt in den Prompt eines Agenten, sodass ihre Inhalte während des gesamten Gesprächs verfügbar bleiben. Größere Wissensdatenbanken werden stattdessen indexiert. RAG ruft dann für jede Abfrage die relevanten Passagen ab, statt alles gleichzeitig in das Kontextfenster zu laden.
Starten Sie noch heute, indem Sie sich bei ElevenAgents registrieren oder mit unserem Team sprechen, um mehr über Ihre Bereitstellungsoptionen zu erfahren.
FAQ: Was ist ein Kontextfenster?

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.

