
Was ist eine Vektordatenbank? Wie KI-Suche Bedeutung erkennt
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Eine Vektordatenbank ist ein Speichersystem, mit dem KI-Modelle unstrukturierte Daten anhand semantischer Ähnlichkeit abfragen und abrufen können. Sie hilft KI, Antworten mit Wissen über ihre Trainingsdaten hinaus zu generieren.
Vektordatenbanken speichern Informationen in einem Format, das LLMs leicht verarbeiten können. Sie liefern KI-Modellen zusätzliche Informationen, um relevante und präzise Antworten zu generieren.
Dieser Leitfaden erklärt, was eine Vektordatenbank ist, wie sie funktioniert, welche typischen Anwendungsfälle, Arten und Beispiele es gibt und wie sie sich von relationalen Datenbanken und Graphdatenbanken unterscheidet.
Zusammenfassung
- Eine Vektordatenbank speichert gelernte Merkmalsdarstellungen als Vektoreinbettungen in einem mehrdimensionalen Raum.
- Im Gegensatz zu herkömmlichen Datenbanken, die auf Schlüsselwortabgleich beruhen, rufen Vektordatenbanken bei Abfragen semantisch ähnliche Daten ab.
- Eine Vektor-DB speichert interne Dokumente, die Voice AI und den Kundenservice mithilfe eines RAG-Systems dabei unterstützen, kontextbezogene Antworten zu geben.
- Anwendungen wie Chatbots, KI-Suchmaschinen und konversationelle KI profitieren von der semantischen Suche und den unstrukturierten Datentypen, die Vektordatenbanken unterstützen.
- Vektor-DBs unterscheiden sich von Graphdatenbanken. Graphdatenbanken verbinden verwandte Entitäten, um mehrstufige Abfragen mit Graph-Traversierungsalgorithmen zu unterstützen, während Vektordatenbanken für einfache Abfragen geeignet sind, die zusätzlichen Kontext erfordern.
Was ist eine Vektordatenbank und was speichert sie?
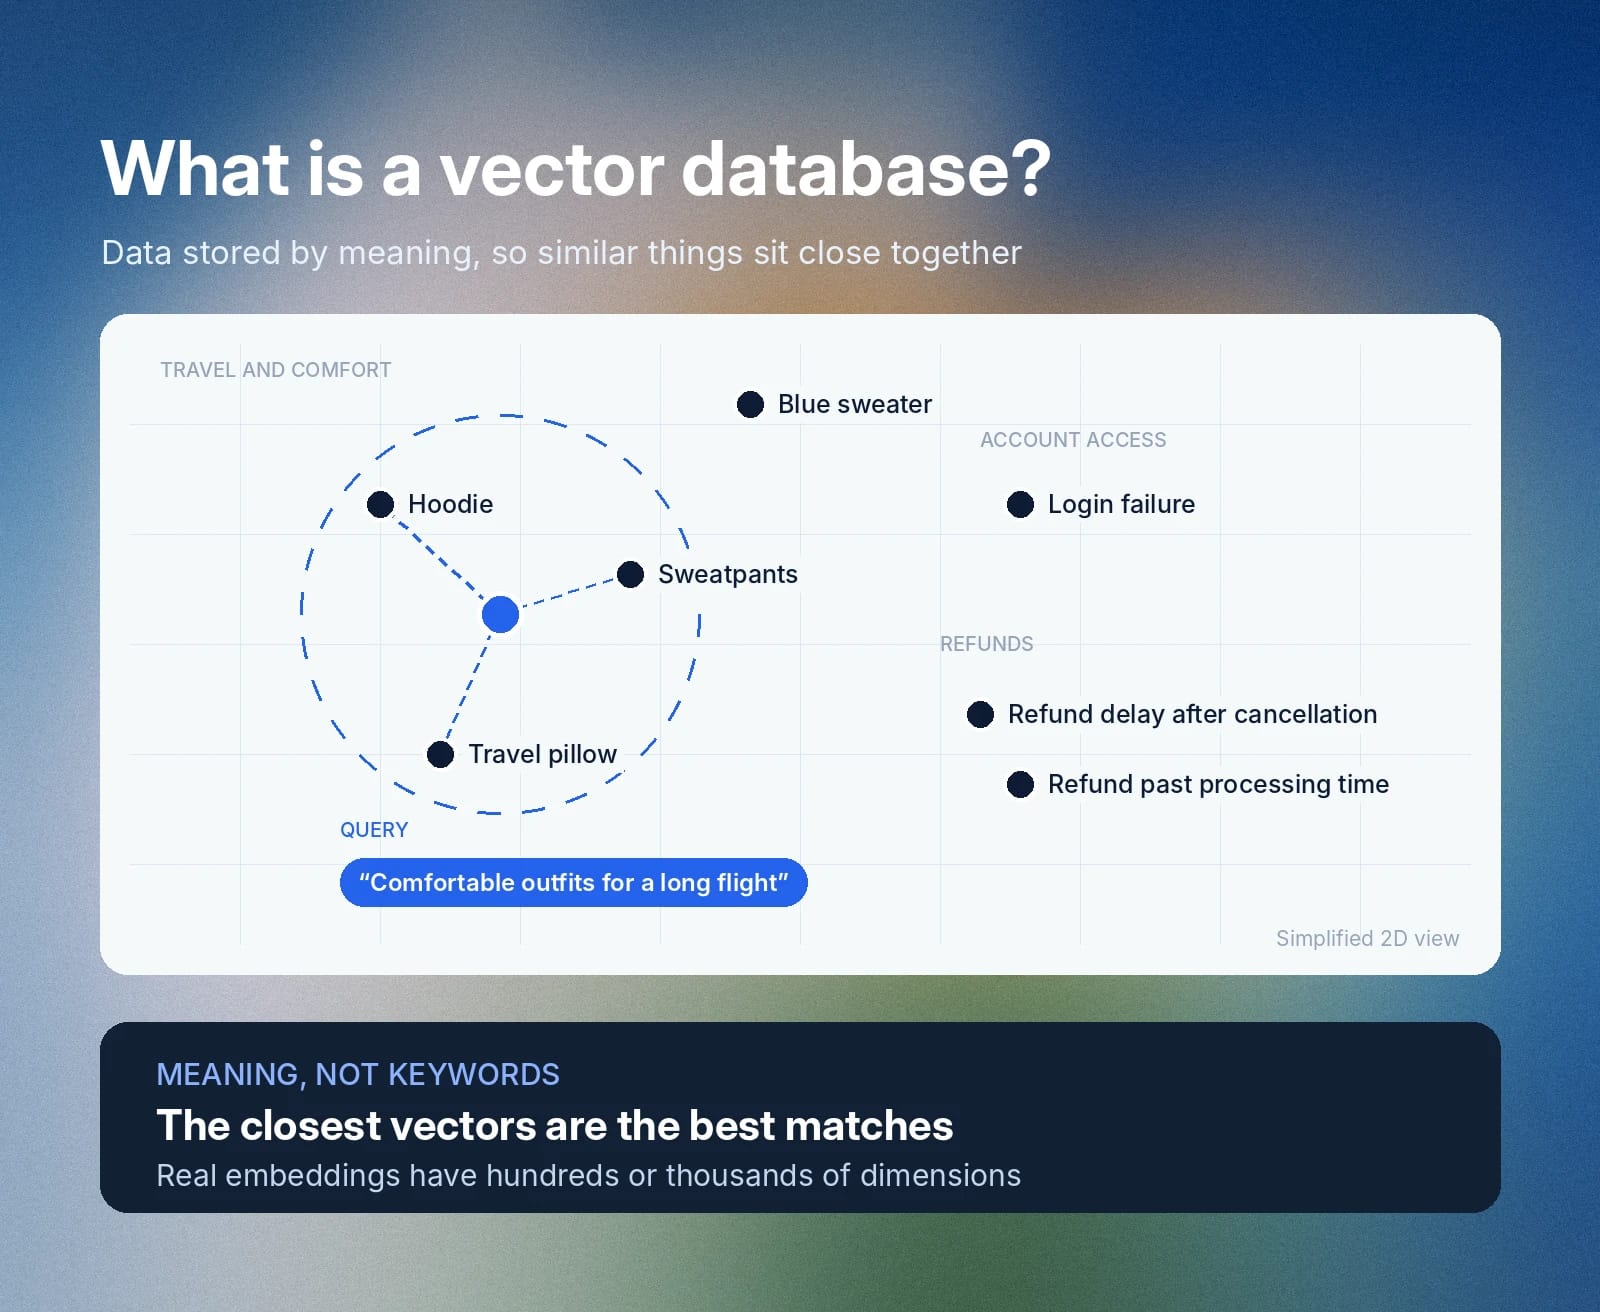
Eine Vektordatenbank speichert Daten als numerische Darstellungen, sogenannte Einbettungen, und ermöglicht KI-Modellen semantische Suche mit geringer Latenz. Im Gegensatz zu einer herkömmlichen Datenbank, die Informationen in Zeilen und Spalten speichert, gruppiert eine Vektor-DB Einbettungen anhand semantischer Ähnlichkeiten in einem mehrdimensionalen Raum.
In der KI beschreibt der Begriff „Dimension“ gelernte Merkmale oder Eigenschaften eines bestimmten Objekts. Sie können sich beispielsweise vorstellen, dass ein Hund Dimensionen wie Fellfarbe und Rasse hat. In der Praxis entsprechen einzelne Dimensionen einer gelernten Einbettung selten einem klar lesbaren Merkmal.
Generative KI-Anwendungen, insbesondere solche mit Verbindung zu einer externen Wissensquelle, nutzen eine Vektordatenbank, um den Abruf zu beschleunigen. Statt in einer herkömmlichen Datenbank nach einer direkten Schlüsselwortübereinstimmung zu suchen, findet das Retriever-System die ähnlichsten Einbettungen in der Vektor-DB.
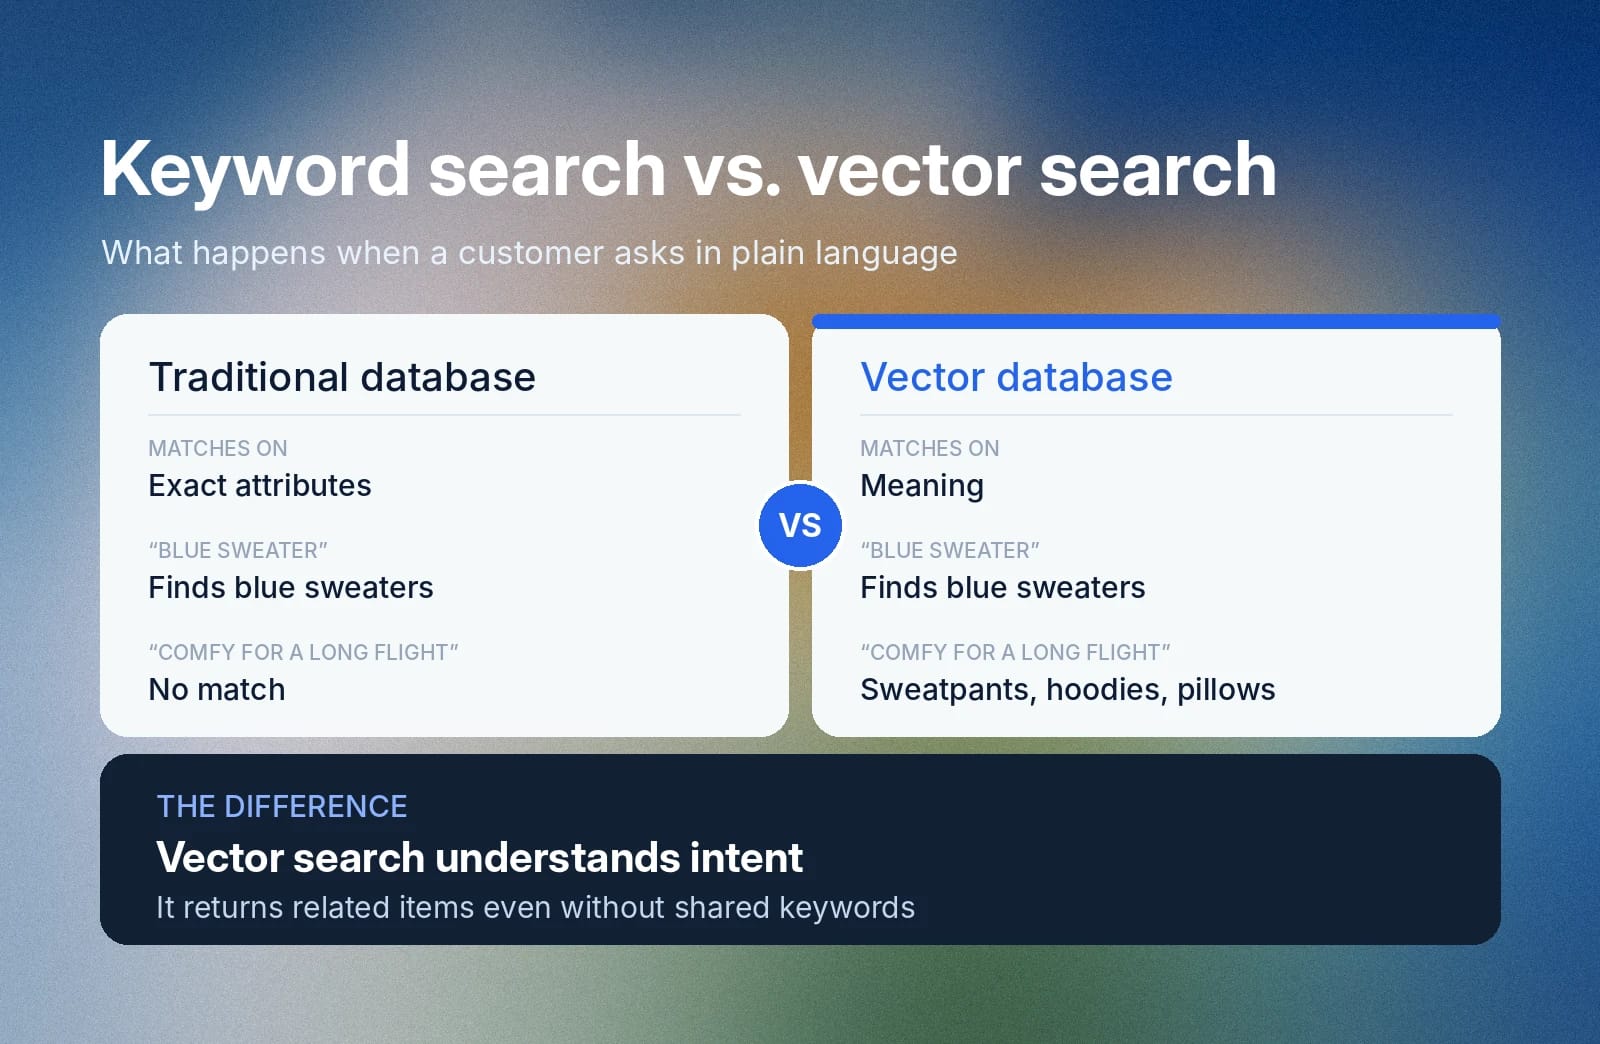
Angenommen, ein Kunde ruft an und bittet Sie, einen „blauen Pullover“ zu empfehlen. Mit einer herkömmlichen Datenbank suchen Sie nach Produkten, die den Attributen „blau“ und „Pullover“ entsprechen. Möchte der Kunde jedoch „Outfits, die sich auf einem langen Flug bequem anfühlen“, könnte eine herkömmliche Datenbank keine Antwort liefern.
Eine Vektordatenbank erfasst hingegen die semantische Bedeutung der Anfrage. Durch die Abbildung im Vektorraum gibt das System Outfits wie Jogginghosen, Hoodies und Reisekissen zurück, die eng verwandte Merkmalsdarstellungen haben. Diese Fähigkeit, Bedeutung abzugleichen, unterscheidet eine Vektor-DB von einer herkömmlichen Datenbank.
Vektoreinbettungen: Stimme, Text und Bilder in Zahlen umwandeln
Vektoreinbettungen sind Zahlenarrays, die unstrukturierte Daten wie Text, Bilder und Videos darstellen, damit KI-Modelle sie leicht verarbeiten können.
Ein Vektor ist die mathematische Darstellung von Zahlen über verschiedene Dimensionen hinweg. Ein Vektor erfasst jedoch nicht den Kontext, die Struktur und die Bedeutung eines bestimmten Datensatzes.
Beispielsweise ist eine Liste von Gleitkommazahlen [0.82, 0.14, 0.67] ein Vektor, doch was sie darstellt, bestimmt das Einbettungsmodell.
Einbettungen erfassen Eigenschaften der Daten und speichern sie als Vektor in einem mehrdimensionalen Raum. Sie verleihen dem, was sonst nur eine Zahlenliste wäre, Bedeutung. Jede Zahl im Vektor ist eine Dimension der gelernten Darstellung.
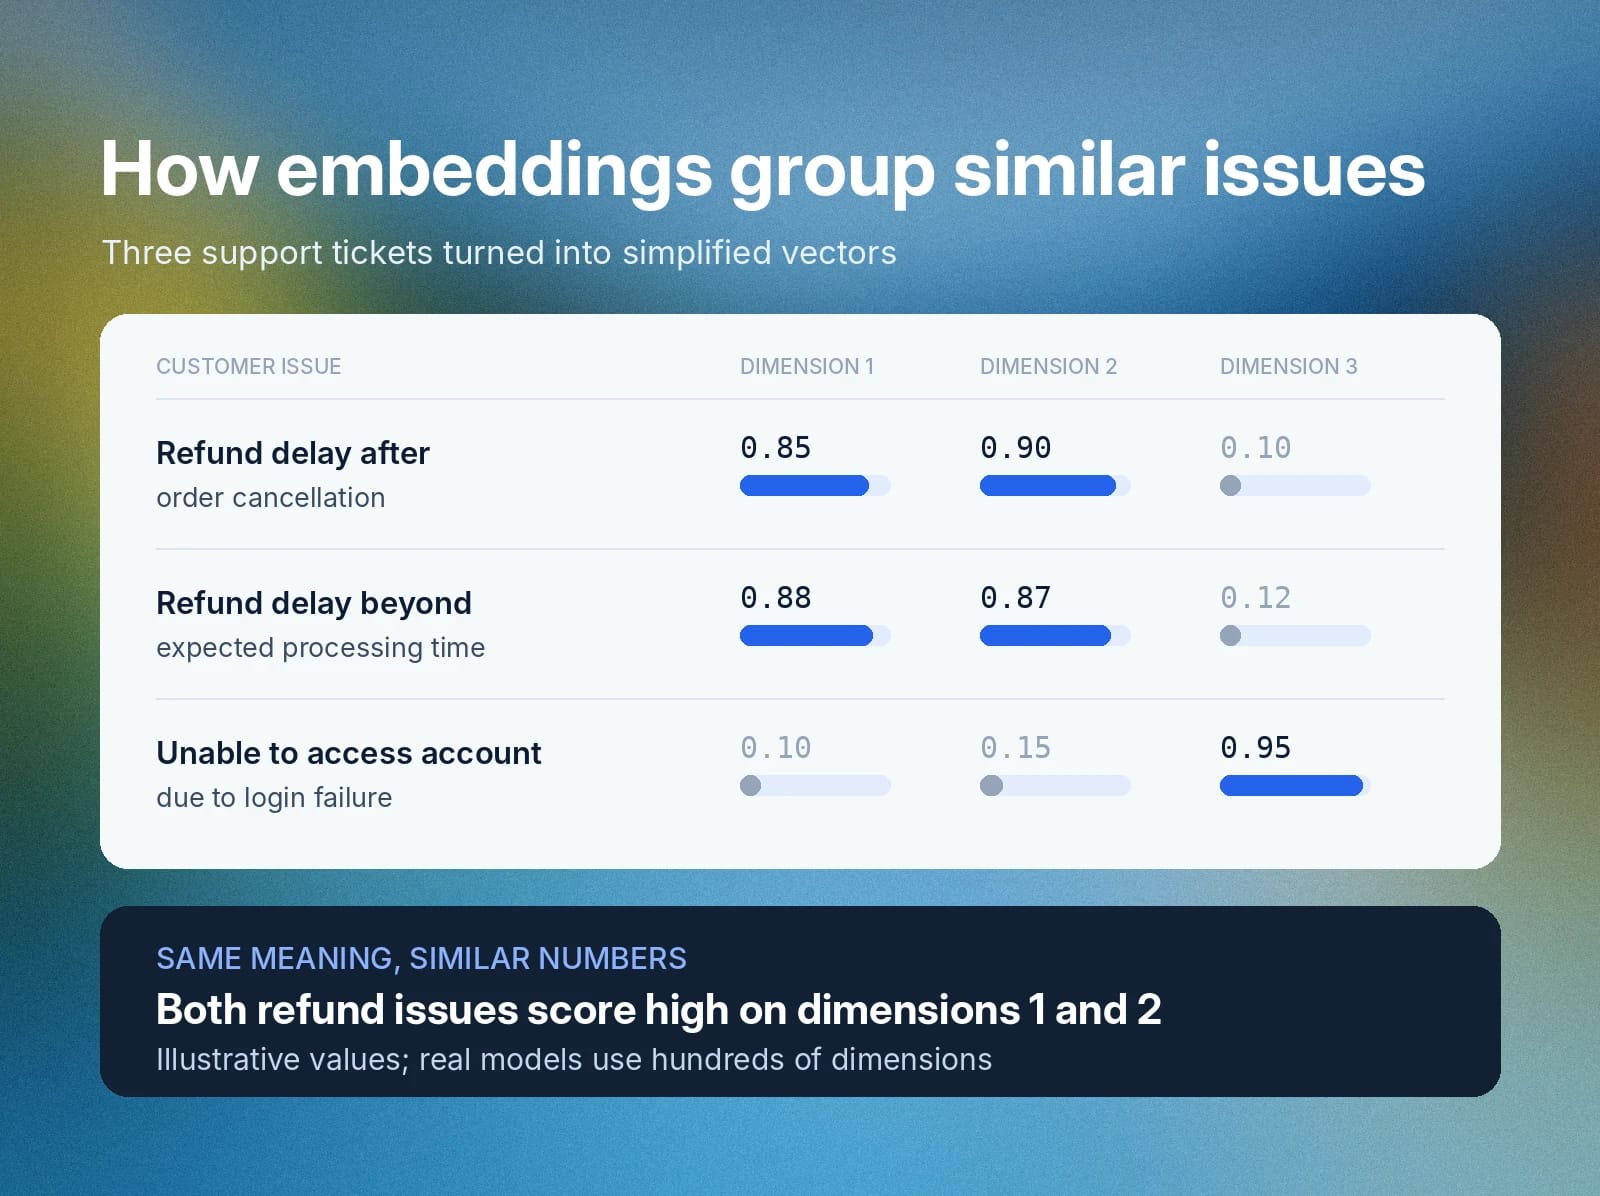
Angenommen, Sie möchten Kundenfälle in einer Vektor-DB speichern. Mit einem Einbettungsmodell wandeln Sie Tickettypen in Einbettungen mit unterschiedlichen Werten über die Dimensionen hinweg um. Die folgenden Werte sind zur Veranschaulichung vereinfacht.
Kundenanliegen
Einbettungen
Verzögerte Rückerstattung nach Bestellstornierung
[0.85, 0.90, 0.10]
Rückerstattung verzögert sich über die erwartete Bearbeitungszeit hinaus
[0.88, 0.87, 0.12]
Kein Kontozugriff aufgrund eines fehlgeschlagenen Logins
[0.10, 0.15, 0.95]
Beide Erstattungsprobleme haben trotz unterschiedlicher Ursachen höhere Werte in der ersten und zweiten Dimension, während das Login-Problem seinen höchsten Wert in der dritten hat. Einbettungsmodelle erzeugen typischerweise Hunderte oder Tausende Dimensionen. Deshalb sind Vektordatenbanken darauf ausgelegt, sie schnell zu vergleichen.
Wie funktionieren Vektordatenbanken?
Vektordatenbanken wandeln unstrukturierte Daten in Einbettungen um, speichern sie in einem mehrdimensionalen Raum und ermöglichen die Suche nach semantischer Ähnlichkeit. Einbettungen, die eng miteinander verbunden sind, haben im Vektorraum tendenziell einen geringeren Abstand.
Wenn die Vektordatenbank eine Abfrage erhält, verwendet sie Algorithmen für approximative nächste Nachbarn (ANN), um die ähnlichsten Einbettungen abzurufen, ohne die gesamte Datenbank zu durchsuchen.
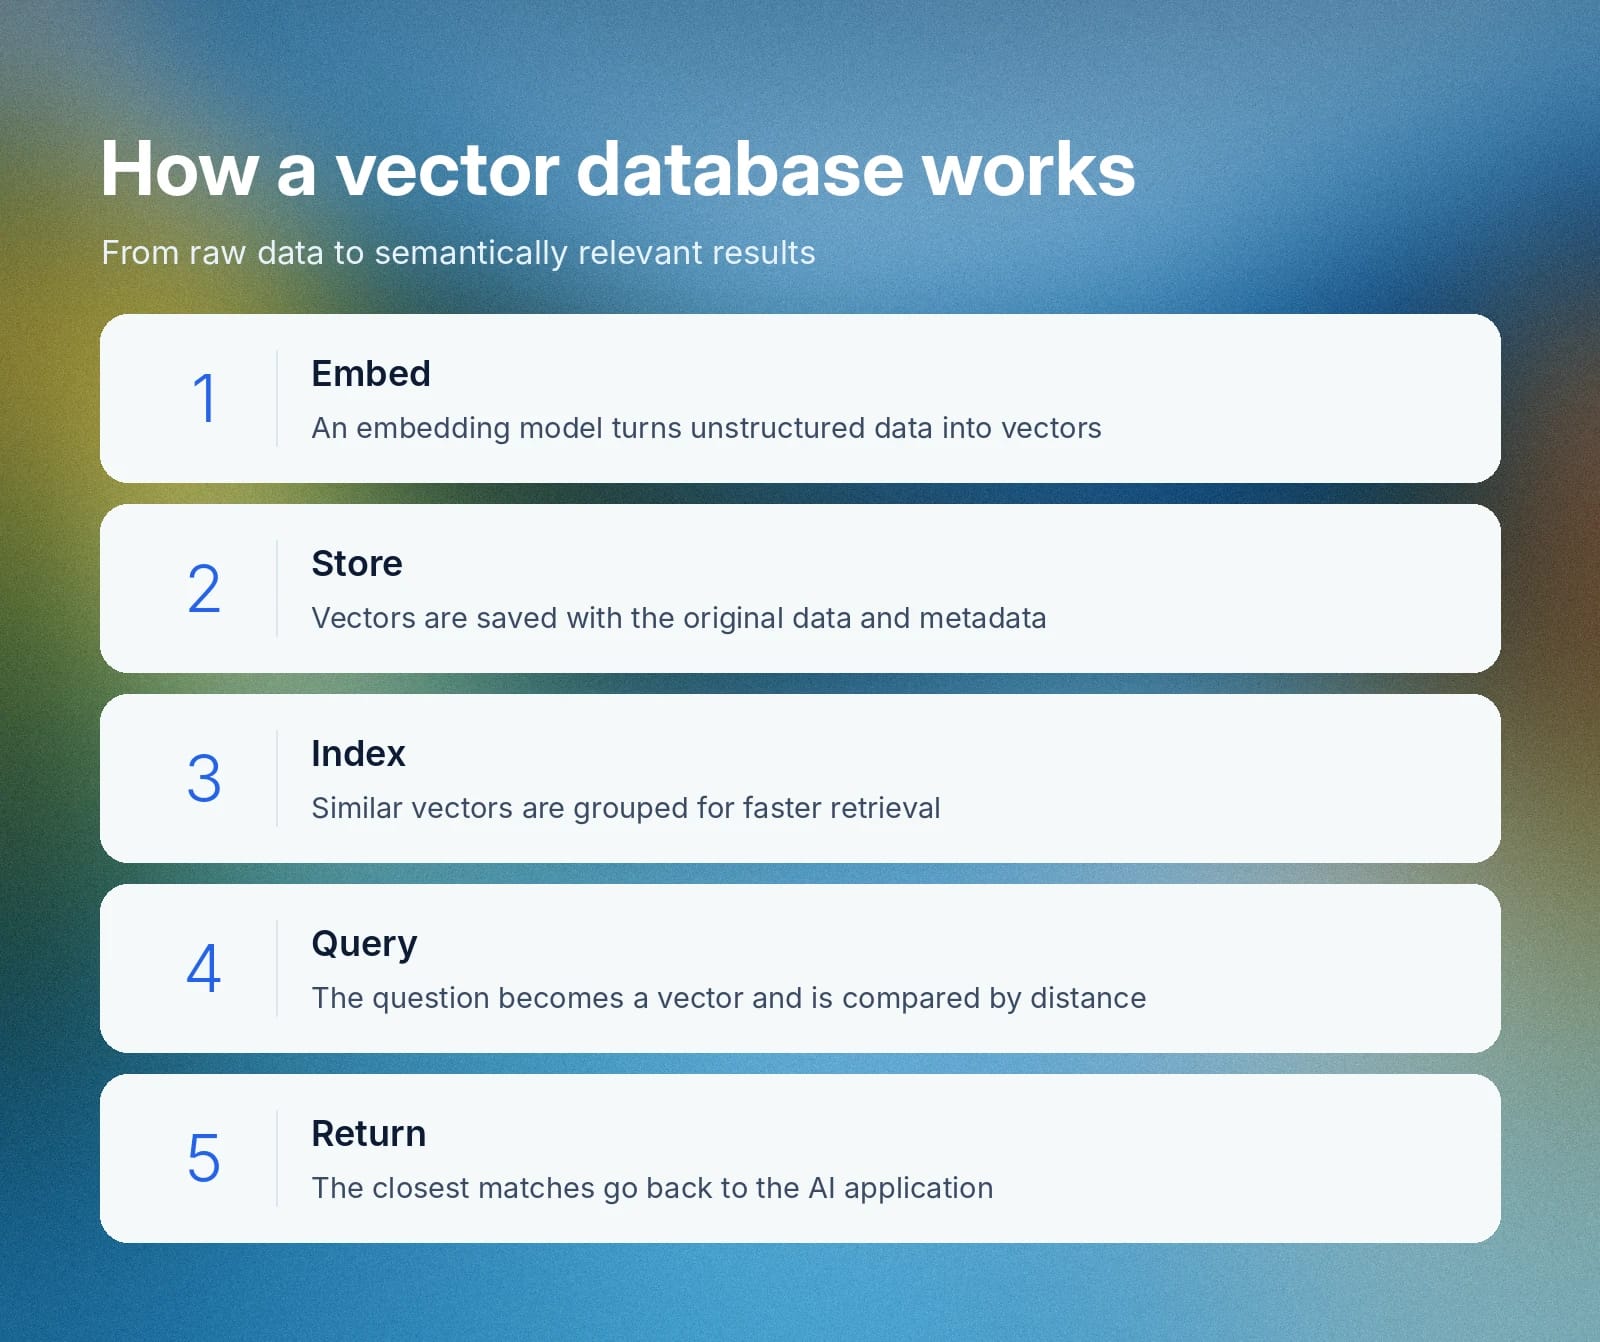
Dies sind die Schritte zum Einrichten und Abrufen aus einer Vektordatenbank.
Speicherung von Einbettungen
Zunächst wandelt ein Einbettungsmodell unstrukturierte Daten in Einbettungen um. Jede Einbettung repräsentiert Merkmale, die die semantische Bedeutung des realen Objekts tragen. Anschließend speichert das System die Einbettungen zusammen mit den Originaldaten und Metadaten in der Vektor-DB.
Da Einbettungen mit ähnlicher Bedeutung im Vektorraum nah beieinander liegen, kann die Datenbank relevante Treffer abrufen, indem sie den Abstand zwischen Vektoren misst.
Indexierung für schnelleren Abruf
Die Indexierung organisiert Vektoreinbettungen, um die Effizienz des Abrufs zu verbessern. Vektordatenbanken nutzen verschiedene Indexierungstechniken, um eng verwandte Einbettungen zu gruppieren. Je nach Abrufanforderungen kann eine Vektor-DB beispielsweise eine Listen-, Graph- oder Baumstruktur verwenden.
Neben der Indexierung kann die Vektor-DB die Daten mit einer Technik namens Produktquantisierung komprimieren. Die Produktquantisierung komprimiert Einbettungen in kompakte Codes. Das spart Speicher, geht jedoch mit einem kleinen Verlust an Suchgenauigkeit einher.
Semantisch relevante Daten abfragen
Bei einer Abfrage wandelt die Vektordatenbank diese in eine Einbettung um. Anschließend vergleicht sie die Einbettung der Abfrage mit den in der mehrdimensionalen Datenbank des Vektors gespeicherten Einbettungen. Dafür nutzt sie Verfahren wie Kosinusähnlichkeit, Skalarprodukt und euklidische Distanz.
Auf Grundlage der Ergebnisse gibt die Vektordatenbank Einbettungen mit dem ähnlichsten semantischen Ähnlichkeitswert zurück, die generative KI-Anwendungen zur Ergänzung ihrer Antworten nutzen. Speicherung, Indexierung und Abfragen ermöglichen es der Datenbank gemeinsam, relevante Ergebnisse schnell zurückzugeben.
Wie Vektorsuche und Ähnlichkeitssuche relevante Ergebnisse liefern
Die Ähnlichkeitssuche ist eine breite Kategorie von Systemen zum Abgleich von Informationen. Sie umfasst schlüsselwortbasierte Ansätze, die exakte Wörter in einer Abfrage abgleichen, sowie die Vektorsuche, die nach Bedeutung abgleicht.
Die Vektorsuche nutzt eine Vektordatenbank, um semantisch verwandte Antworten zurückzugeben. Statt eine exakte Schlüsselwortsuche durchzuführen, vergleicht sie den Abstand zwischen der Abfrage und möglichen Antworten, um das passendste Ergebnis auszuwählen.
Oft nutzt die Vektor-DB Metadaten, um die Einbettungen vor der Ähnlichkeitssuche vorzufiltern. Beispielsweise grenzt sie die Suche ein, indem sie Einbettungen innerhalb eines bestimmten Zeitraums filtert. Dadurch erfolgt der Abruf schneller.
Anwendungsfälle für Vektordatenbanken in Voice AI und im Kundenservice
Vektordatenbanken helfen Kundenservice-Teams, Voice AI und Chatbots einzusetzen, die mit präzisem Produktwissen antworten können. In einem KI-gestützten Kundenservice-System speichert die Vektordatenbank proprietäre Wissensdatenbanken wie Produkthandbücher, Unternehmensrichtlinien und Kundenfälle.
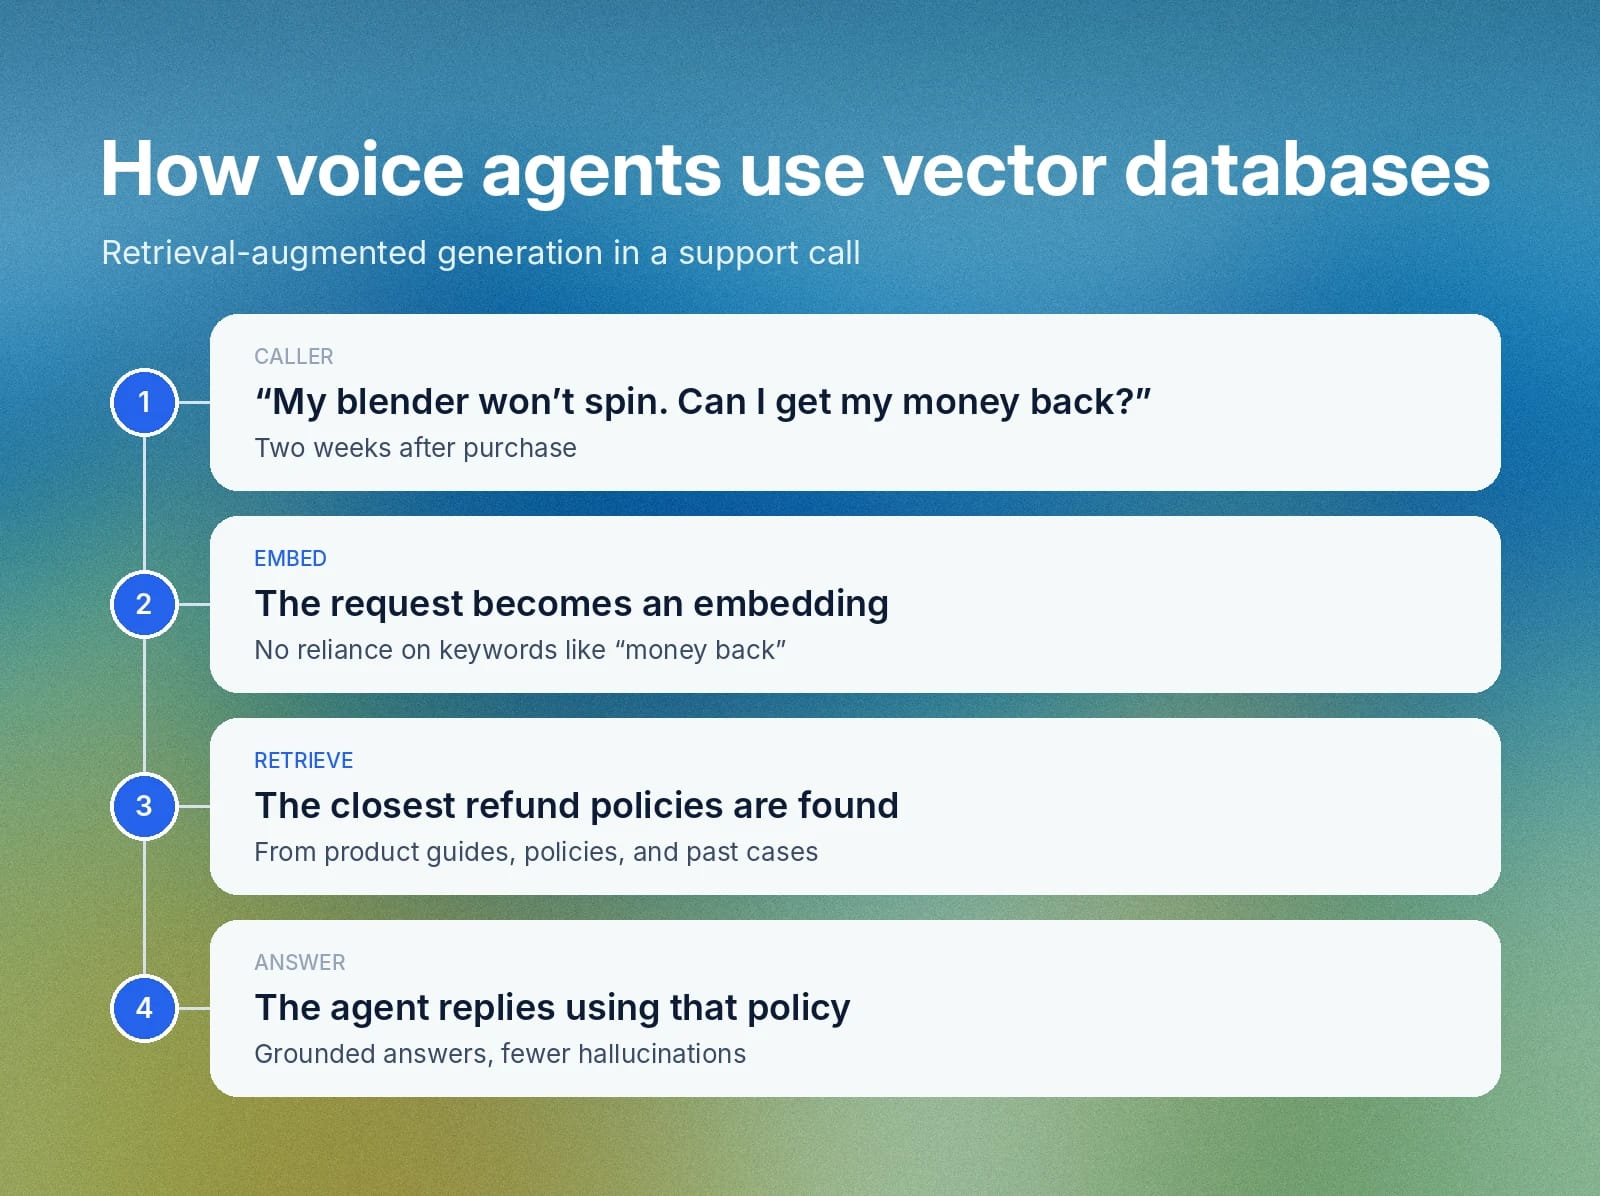
Der KI-Agent verbindet sich über ein Retrieval-Augmented Generation (RAG) -System mit der Vektor-DB.
Wenn der KI-Voice-Agent eine Abfrage erhält, prüft er, ob ihm ausreichend Informationen zur Beantwortung der Kundenfrage vorliegen. Fehlen ihm aktuelle oder ausreichende Daten, ruft RAG semantisch passende Daten ab, um die Antwort zu ergänzen.
Angenommen, ein Voice Agent erhält folgende Beschwerde: „Mein Mixer dreht sich nach zwei Wochen nicht mehr. Kann ich mein Geld zurückbekommen?“ Statt nach exakten Schlüsselwörtern wie „dreht sich nicht“ und „Geld zurück“ zu suchen, wandelt RAG die Anfrage in eine Einbettung um. Anschließend ruft es Erstattungsrichtlinien mit der ähnlichsten Bedeutung ab.
Durch den Abruf relevanter interner Dokumente trägt ein von einer Vektordatenbank gestütztes RAG-System dazu bei, Halluzinationen bei Voice Agents zu reduzieren, auch wenn es sie nicht vollständig verhindert. Statt zu raten, können sowohl KI- als auch menschliche Agents interne Dokumente nutzen, um Kundenanfragen zu lösen.
Vektordatenbank vs. relationale Datenbank: zentrale Unterschiede
Eine relationale Datenbank verwendet Zeilen und Spalten sowie ein festes Schema, um ihre Daten zu speichern. Eine Vektor-DB verwendet dagegen Einbettungen, die unstrukturierte Daten darstellen.
Relationale Datenbanken eignen sich für exakte Übereinstimmungen und strukturierte Abfragen, etwa um alle an einem bestimmten Datum aufgegebenen Bestellungen zu finden. Vektordatenbanken rufen hingegen die gespeicherten Einbettungen ab, die einer Abfrage in ihrer Bedeutung am nächsten kommen. Das ist bei Fragen in natürlicher Sprache effektiver.
Meistens nutzen Teams beide, da beide bei der Arbeit mit Daten ihren Platz haben.
Vektordatenbank vs. Graphdatenbank: Wann welche einsetzen
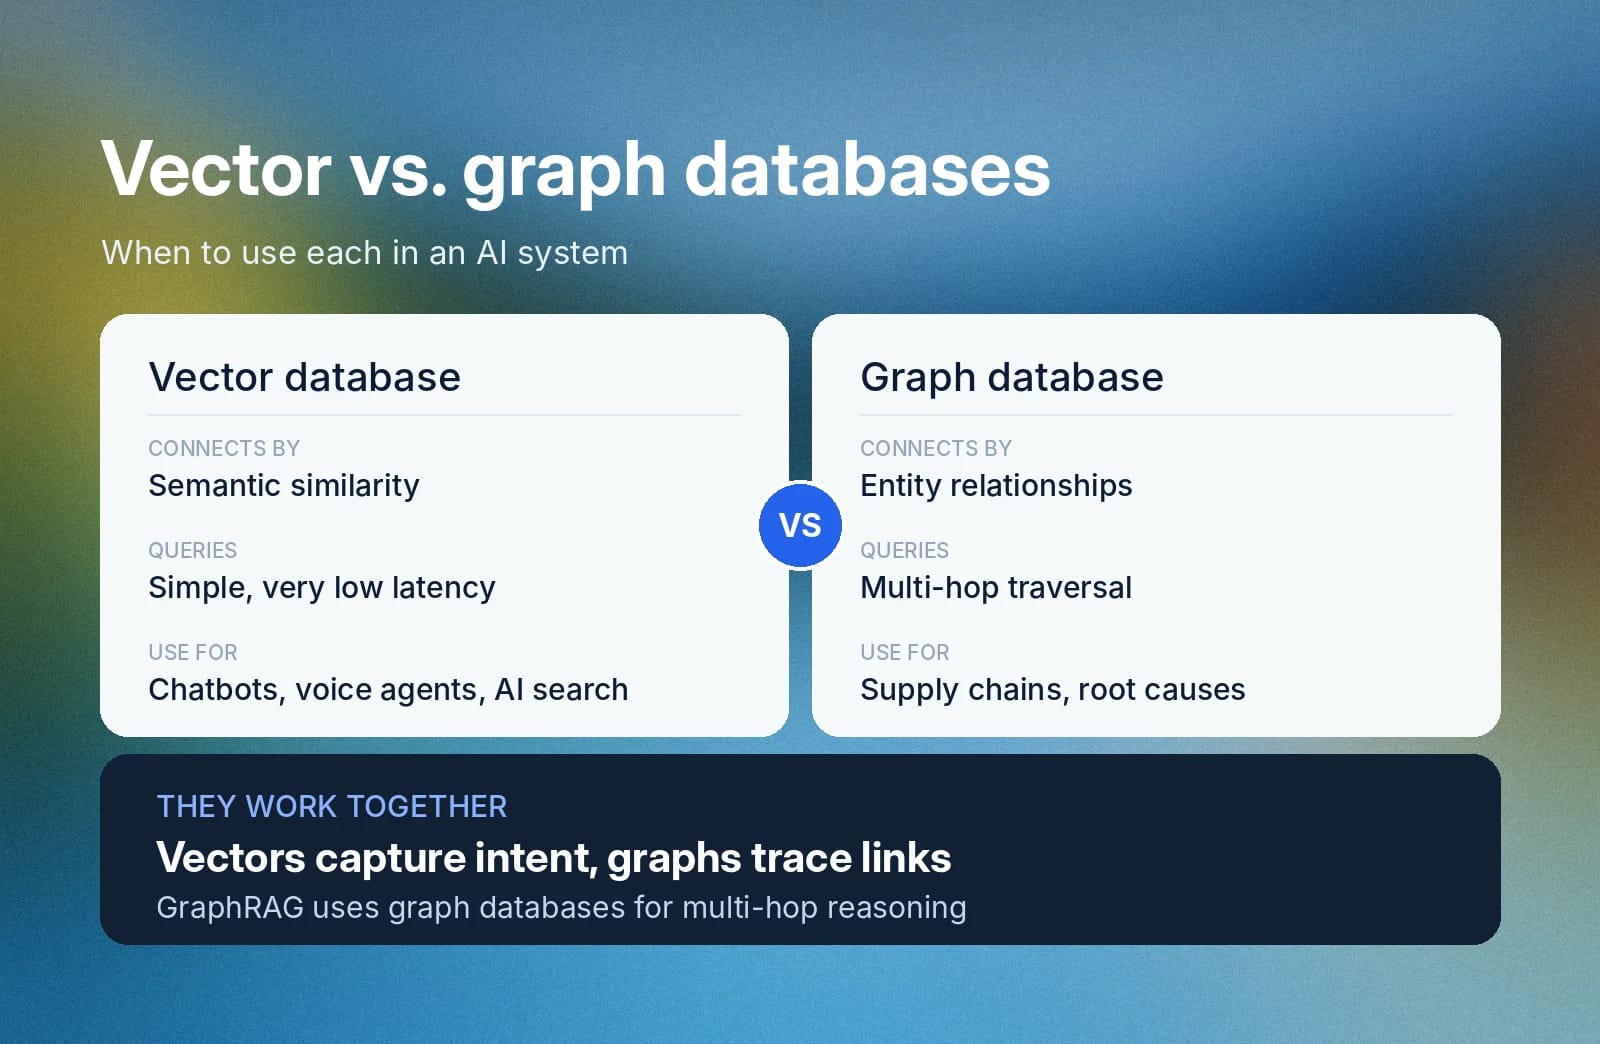
Graphdatenbanken verwenden Wissensgraphen, um verschiedene Entitäten auf eine Weise zu verbinden, die ihre Hierarchie und Beziehungen widerspiegelt. KI-Systeme wie GraphRAG nutzen Graphdatenbanken, um Abfragen zu beantworten, die mehrstufiges Schlussfolgern erfordern.
Wenn Sie eine Graphdatenbank abfragen, findet sie den Ausgangsdatenpunkt und verwendet einen Graph-Traversierungsalgorithmus, um verwandte Entitäten zu finden. So können Kundennamen beispielsweise nacheinander mit Verlängerungsdaten und Support-Tickets verknüpft sein.
Vektordatenbanken speichern hingegen unstrukturierte Daten als numerische Darstellungen auf Grundlage ihrer semantischen Bedeutung. Sie ermöglichen RAG-Systemen einen einfachen Abgleich von Abfragen bei sehr geringer Latenz. So liefert eine Vektor-DB beispielsweise die Erstattungsrichtlinie, wenn sie „Ich möchte eine Rückerstattung“ verarbeitet.
Sowohl Vektor- als auch Graphdatenbanken sind für KI-Systeme nützlich. Sie können beide zusammen einsetzen:
- Verwenden Sie eine Vektor-DB, wenn Sie einen Chatbot, Voice Agent oder eine KI-Suchmaschine betreiben möchten, die Absichten in menschlicher Sprache erfassen muss.
- Verwenden Sie eine Graphdatenbank, wenn Sie Abhängigkeitsprobleme lösen möchten, etwa Lieferketten nachzuverfolgen, relevante Produkte zu empfehlen oder Ursachenanalysen durchzuführen.
Welche Arten von Vektordatenbanken gibt es?
Grundsätzlich gibt es zwei Arten von Vektordatenbanken, die sich durch ihren Architekturstil unterscheiden.
- Eigenständige Vektor-DB: Dies sind unabhängige, speziell entwickelte Datenbanken, die mehrdimensionale Ähnlichkeitssuchen mit geringer Latenz unterstützen. Viele generative KI-Anwendungen verbinden sich mit eigenständigen Vektor-DBs, um umfangreiche Abfragelasten zu skalieren.
- Vektordatenbank-Erweiterung: Bestehende Datenbanken können Funktionen für die Vektorsuche einführen, um KI-Modellen einen semantikbasierten Abruf zu ermöglichen. Diese Datenbanken behalten ihre ursprüngliche Architektur bei, etwa ein zeilenbasiertes SQL-Schema, unterstützen jedoch Vektordatentypen.
Die Wahl hängt vor allem davon ab, ob Sie ein dediziertes System für große Abfragelasten benötigen oder ein Element für semantische Suche in einer bereits betriebenen Datenbank wünschen.
Beispiele für Vektordatenbanken
Hier sind zwei Beispiele für Vektor-DBs:
- Eigenständige Vektor-DBs: Pinecone ist ein verwalteter Vektordatenbankdienst. Milvus, Weaviate, Qdrant und Chroma sind Open-Source-Vektordatenbanken.
- Vektor-DB-Erweiterungen: pgvector ergänzt PostgreSQL um die Vektor-Ähnlichkeitssuche und MongoDB Atlas Vector Search ergänzt MongoDB darum.
Welche Lösung passt, hängt von Ihrem Umfang und davon ab, wie viel Infrastruktur Sie verwalten möchten.
Starten Sie mit ElevenAgents für abrufbereite Voice Agents
ElevenAgents ermöglicht Voice Agents, Informationen aus Ihrer eigenen Wissensdatenbank abzurufen und so konversationelle, kontextbezogene Antworten zu geben. Mit RAG ruft der Agent die semantisch ähnlichsten Inhalte aus den Dokumenten, URLs oder Texten ab, die Sie zur Wissensdatenbank hinzufügen. Sie können den Abruf auf „Bei Bedarf“ setzen, sodass der Agent die Wissensdatenbank nur durchsucht, wenn er es für nötig hält.
Die Implementierung von RAG erhöht verständlicherweise die Latenz bei der Antwortgenerierung. Dank unserer technischen Fortschritte haben wir jedoch die mediane RAG-Latenz von ElevenAgents von 326 ms auf 155 ms reduziert.
Starten Sie mit ElevenAgents und erfahren Sie hier, wie Sie Ihre Wissensdatenbank einrichten.
Häufig gestellte Fragen

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


