Was ist Sprecherwechsel in Conversational AI: Ein Leitfaden für natürliche Gespräche
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Guter Kundenservice erfordert ausgeprägte Gesprächsfähigkeiten. Eine der wichtigsten ist, zuhören zu lernen und zu wissen, wann man sprechen sollte. Andernfalls riskieren Servicemitarbeiter, bereits frustrierte Kunden zu unterbrechen, die möglicherweise schon mehrmals angerufen haben, um ihr Anliegen zu erklären.
Derselbe Maßstab gilt für Sprecherwechsel in Conversational AI. Agenten müssen sorgfältig abwägen: Sie müssen lange genug still sein, damit die Person sprechen kann, dürfen aber auch nicht so lange schweigen, dass Latenz und Stille die Gesprächsqualität beeinträchtigen.
Deshalb müssen Modelle beim modernen Sprecherwechsel die Sprechabsicht schnell bewerten, statt starre Stille-Timer zu verwenden. Unsere einheitliche Architektur bei ElevenLabs analysiert fortlaufend Tonfall, Rhythmus und Wortkontext, damit Gespräche im Fluss bleiben und natürlich wirken.
Zusammenfassung
- Kundenserviceteams setzen Sprachagenten ein, die auf Sprecherwechsel trainiert sind, um Anliegen schnell und mit weniger Reibung zu lösen.
- Sprecherwechsel hilft Modellen zu bestimmen, wann sie antworten oder interagieren, das Wort behalten sowie zuhören oder still sein sollen.
- KI-Agenten nutzen adaptives Timing, Sprachaktivitätserkennung und semantische Analyse, um einen natürlichen Gesprächsfluss aufrechtzuerhalten.
- Entwicklungsteams verfolgen Antwortlatenz und Unterbrechungsraten, um den Gesprächsfluss zu messen und Workflows zu optimieren.
Was ist Sprecherwechsel in Conversational AI?
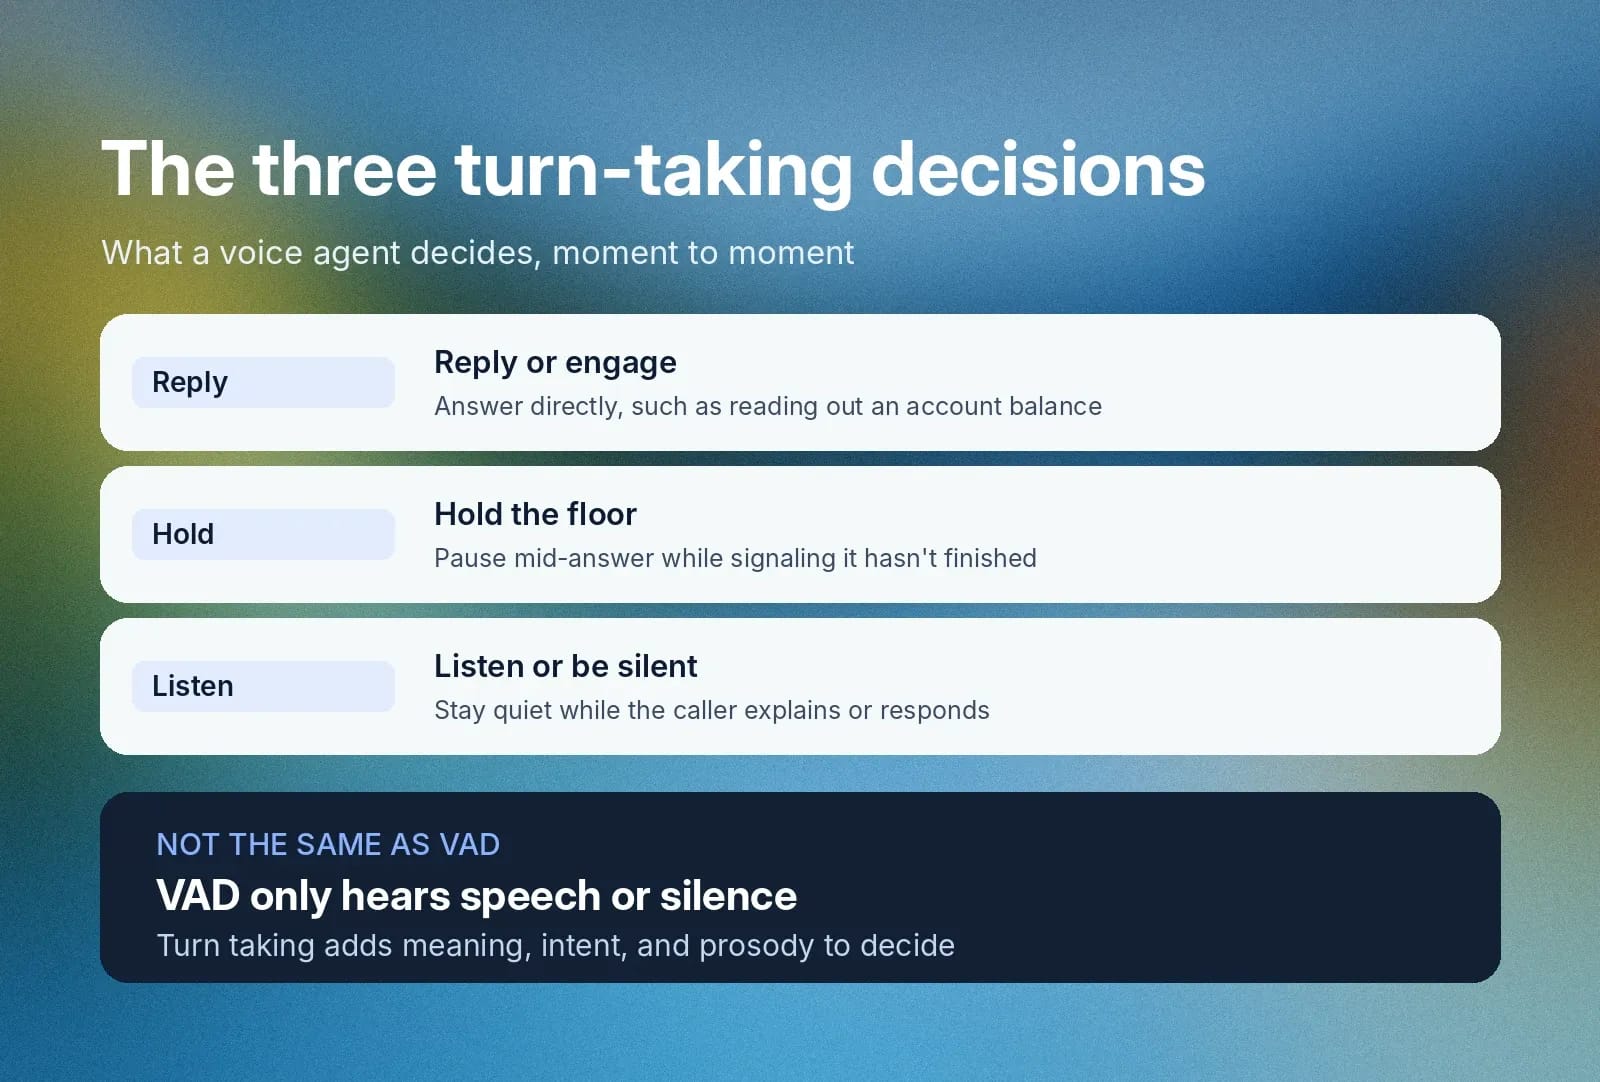
Wenn Conversational-AI-Modelle Sprecherwechsel steuern, folgen sie einem Regelwerk, das den optimalen Zeitpunkt bestimmt, um:
- Zu antworten oder zu interagieren: Hier beantwortet der KI-Agent die Frage direkt. Beispielsweise fragt ein Kunde nach seinem Kontostand und das System antwortet: „Der Kontostand beträgt 57,34 $.“
- Das Wort zu behalten: In diesem Fall spricht das Modell weiter und signalisiert auch während einer Pause, dass es noch nicht fertig ist. Beispielsweise fragt ein Kunde nach seinem Kontostand und erhält die Antwort: „Lassen Sie mich zunächst anhand Ihrer Angaben Ihr Konto aufrufen … [pause]. Der Kontostand beträgt 57,34 $, aber … [pause] ich sehe auch eine ausstehende Zahlung in dieser Höhe. Rufen Sie an, um zu erfahren, wann diese Zahlung eingeht, ohne dass Ihnen eine Verspätungsgebühr berechnet wird?“
- Zuzuhören oder still zu sein: In diesem Fall bleibt der Agent still und wartet darauf, dass der Kunde seine Situation erklärt oder antwortet. Beispielsweise bestätigt der Kunde, dass er wissen wollte, ob die Zahlung eingegangen ist, da er sie bereits vor mehreren Tagen überwiesen hat. Das KI-Modell antwortet: „Ja, ich sehe, dass Sie die Zahlung vor zwei Tagen eingereicht haben. Die Bearbeitung dauert normalerweise drei Tage, daher sollte sie bis morgen früh eingehen. Ihnen wird keine Verspätungsgebühr berechnet. Benötigen Sie noch Hilfe bei etwas anderem?“
In der Entwicklerdokumentation wird dies oft als Turn Detection oder End-of-Turn Detection bezeichnet. Systeme, die Sprachaktivitätserkennung mit Sprachverständnis kombinieren, um zu beurteilen, ob ein Sprecher fertig ist, werden oft als semantische VAD beschrieben.
Diese flüssige Art, einen Dialog mit Kunden zu führen, ersetzt starre Nachrichten im Walkie-Talkie-Stil durch natürliche Gespräche mit Sprachagenten.
Wichtig ist auch, dass sich diese dreistufige Entscheidungsebene für Conversational AI von der reinen Sprachaktivitätserkennung (VAD) unterscheidet. Während VAD Audio als Sprache oder Stille klassifiziert, berücksichtigt der Sprecherwechsel zusätzlich zum Rohsignal semantischen Kontext, Absicht und Prosodie. Lesen Sie unseren Leitfaden zu VAD für eine ausführlichere Erklärung, wie Spracherkennungsalgorithmen funktionieren und warum Sie sie benötigen.
Warum natürlicher Sprecherwechsel für Sprachagenten unverzichtbar ist
Schlechter Sprecherwechsel ist der schnellste Weg, Kunden zu verärgern – insbesondere jene, die ohnehin ungern mit weniger fortschrittlichen Bots sprechen. Veraltete Conversational-AI-Agenten reden Anrufern ins Wort, machen lange, unangenehme Pausen oder können dem Gespräch nicht folgen.
ElevenAgents nutzt adaptives Timing, damit Ihre automatisierten Agenten einen natürlichen Gesprächsrhythmus beibehalten. Dieses präzise Timing schafft Vertrauen der Kunden in die Fähigkeiten des Modells. Dadurch wächst auch das Vertrauen in die von Ihnen eingesetzte Technologie und in das Engagement Ihrer Marke für Kundenzufriedenheit.
Bei Verwendung von Eleven v4 Turbo mit ElevenAgents erreichen Agenten eine mediane Zeit von 142 ms von der Anfrage bis zur hörbaren Ausgabe.
Zudem sorgt gut getakteter Sprecherwechsel dafür, dass Kunden lange genug eingebunden bleiben, um ihr Problem beim ersten Versuch zu lösen, ohne an einen menschlichen Agenten eskalieren zu müssen.
So funktioniert Sprecherwechsel in Echtzeit
Sprecherwechsel in Echtzeit nutzt eine mehrschichtige Pipeline, die Live-Audio fortlaufend analysiert. Modelle stützen sich zudem auf eine Kombination von Regeln, um die besten Maßnahmen für flüssige Gespräche zu bestimmen. ElevenAgents verarbeitet dies in drei separaten Phasen, damit jeder Austausch reaktionsschnell und natürlich bleibt.
Sprache, Stille und Absicht erkennen
Die Sprachaktivitätserkennung interpretiert und klassifiziert eingehende Audiostreams dutzendfach pro Sekunde als Sprache oder Stille. Nachdem VAD das Rohsignal liefert, bestimmt die Absichtserkennung, ob der menschliche Sprecher tatsächlich aufgehört hat oder lediglich zum Nachdenken pausiert. Faktoren zur Bestätigung eines abgeschlossenen Sprecherwechsels können eine fallende Intonation oder ein syntaktisch vollständiger Satz sein. Dagegen können eine ausklingende Tonhöhe oder Füllwörter wie „ähm …“ oder „also …“ auf eine vorübergehende Pause hindeuten.
Entscheiden, wann geantwortet wird
Da verzögerte Antworten dazu führen können, dass Anrufer das Gespräch abbrechen, ist die Entscheidung eines Modells über den Antwortzeitpunkt einer der wichtigsten Erfolgsfaktoren. Herkömmliche Spracharchitekturen stützen sich oft auf restriktive Timer, um festzustellen, ob eine Person wirklich aufgehört hat zu sprechen. Das kann jedoch dazu führen, dass Anrufer unterbrochen werden, wenn sie erneut sprechen möchten, oder einfach unangenehme Stille entsteht. Moderner Sprecherwechsel in Conversational AI nutzt Deep Learning, um Signale wie Prosodie, Sprechtempo und Füllwörter vollständig zu verstehen.
Antwortlatenz vom Zuhören bis zur Sprachausgabe steuern
Laut sprachwissenschaftlicher Forschung im Journal of Cognition betragen die Pausen zwischen Sprecherwechseln bei Menschen im Durchschnitt etwa 200 ms kulturübergreifend. Modelle, die deutlich länger antworten, erzeugen daher unangenehme Pausen. Das führt zu Ungeduld und höheren Abbruchraten bei Anrufen.
Unterbrechungen, Rückmeldesignale und überlappende Sprache verarbeiten
Anbieter und die Art, wie sie ihre Conversational-AI-Modelle programmieren, bestimmen, wie gut Agenten Unterbrechungen, Rückmeldesignale und überlappende Sprache verarbeiten.
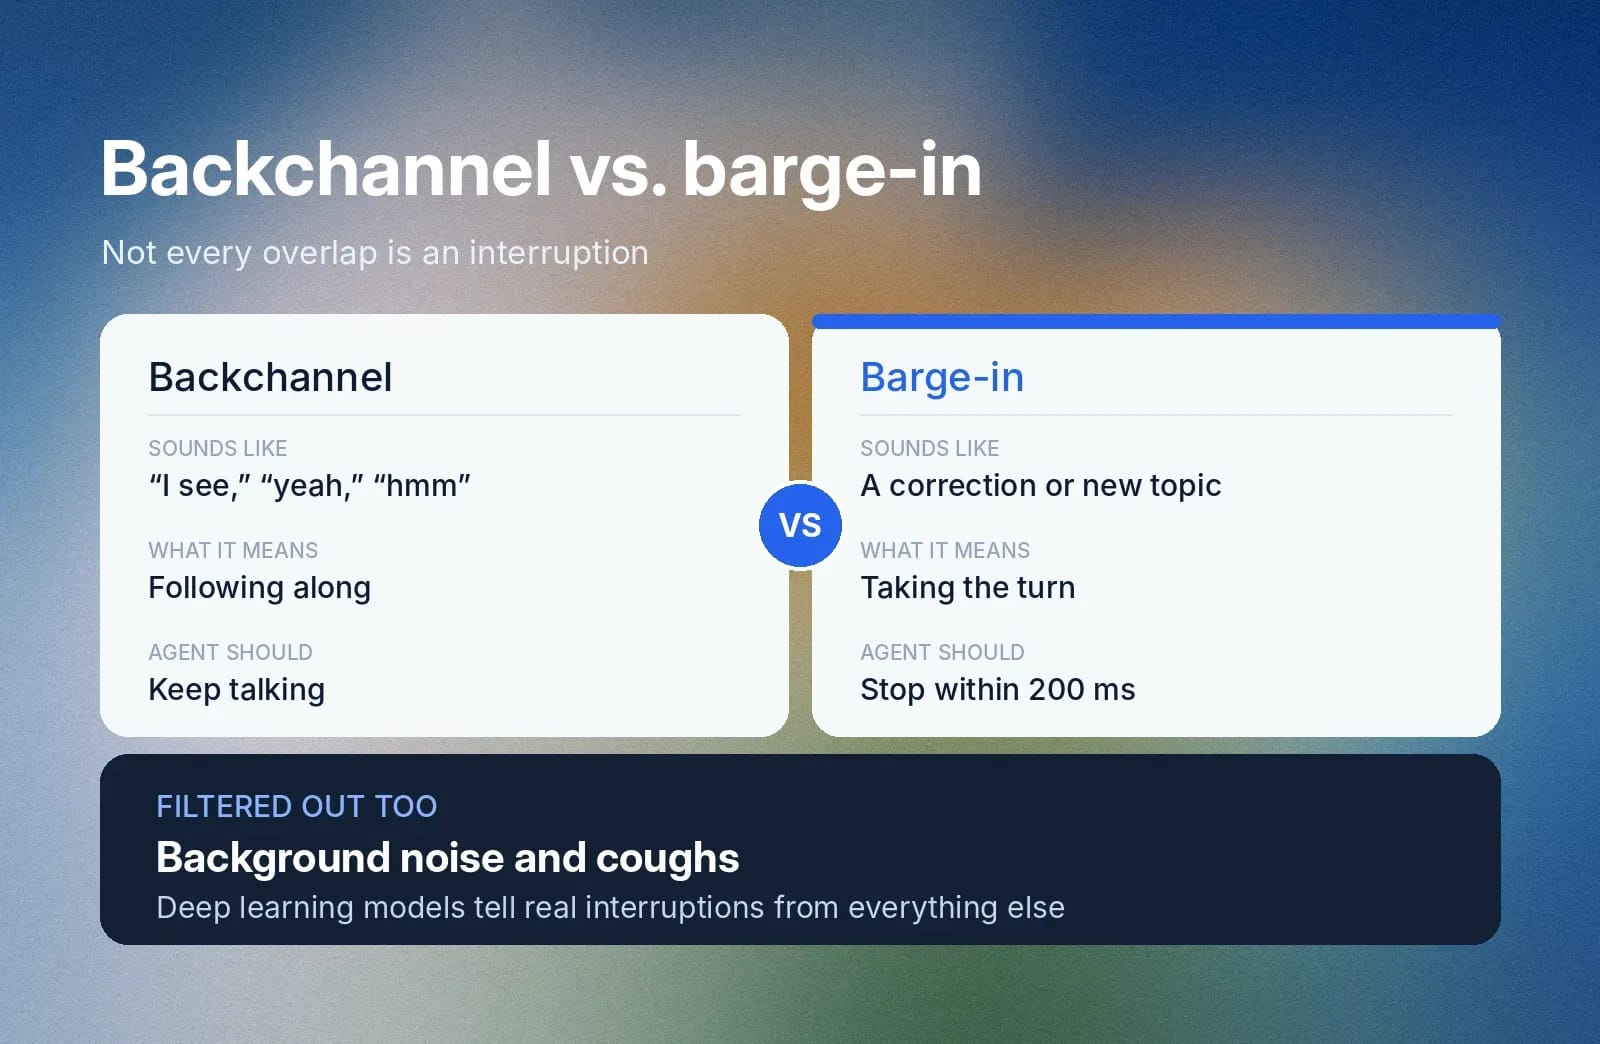
Backchanneling liegt vor, wenn Zuhörende kurze Bestätigungslaute oder -wörter wie „Ich verstehe“ oder „ja“ verwenden, um zu zeigen, dass sie folgen, ohne das Wort zu übernehmen. Ein Sprachagent muss diese Signale verstehen, damit er weiterspricht, statt sie als Unterbrechung zu deuten.
ElevenAgents verarbeitet Live-Überlappungen, indem es sofort das Wort abgibt, wenn ein Anrufer tatsächlich unterbricht. Fällt ein Anrufer ins Wort, etwa um Kontodaten zu korrigieren oder das Gespräch zu ändern, sendet ElevenAgents in unter 200 ms ein Stoppsignal. Dadurch hört der Agent mitten im Satz auf zu sprechen, statt den geplanten Satz zu Ende zu führen.
Unsere Deep-Learning-Modelle filtern zudem fortlaufend Hintergrundgeräusche und unterscheiden echte Unterbrechungen von Füllwörtern zur Bestätigung oder zum Nachdenken. Sagt ein Nutzer beispielsweise „Ich verstehe …“ oder „hmmm …“, während ein Agent spricht, entsteht überlappende Sprache, doch der Nutzer versucht nicht, sich einzuschalten.
Funktionen wie diese helfen unseren Sprachagenten, selbst bei Unterbrechungen mit klarer Absicht präzise Antwortzeiten und einen natürlichen Gesprächsfluss beizubehalten.
Häufige Fehler beim Sprecherwechsel und wie Sie sie vermeiden
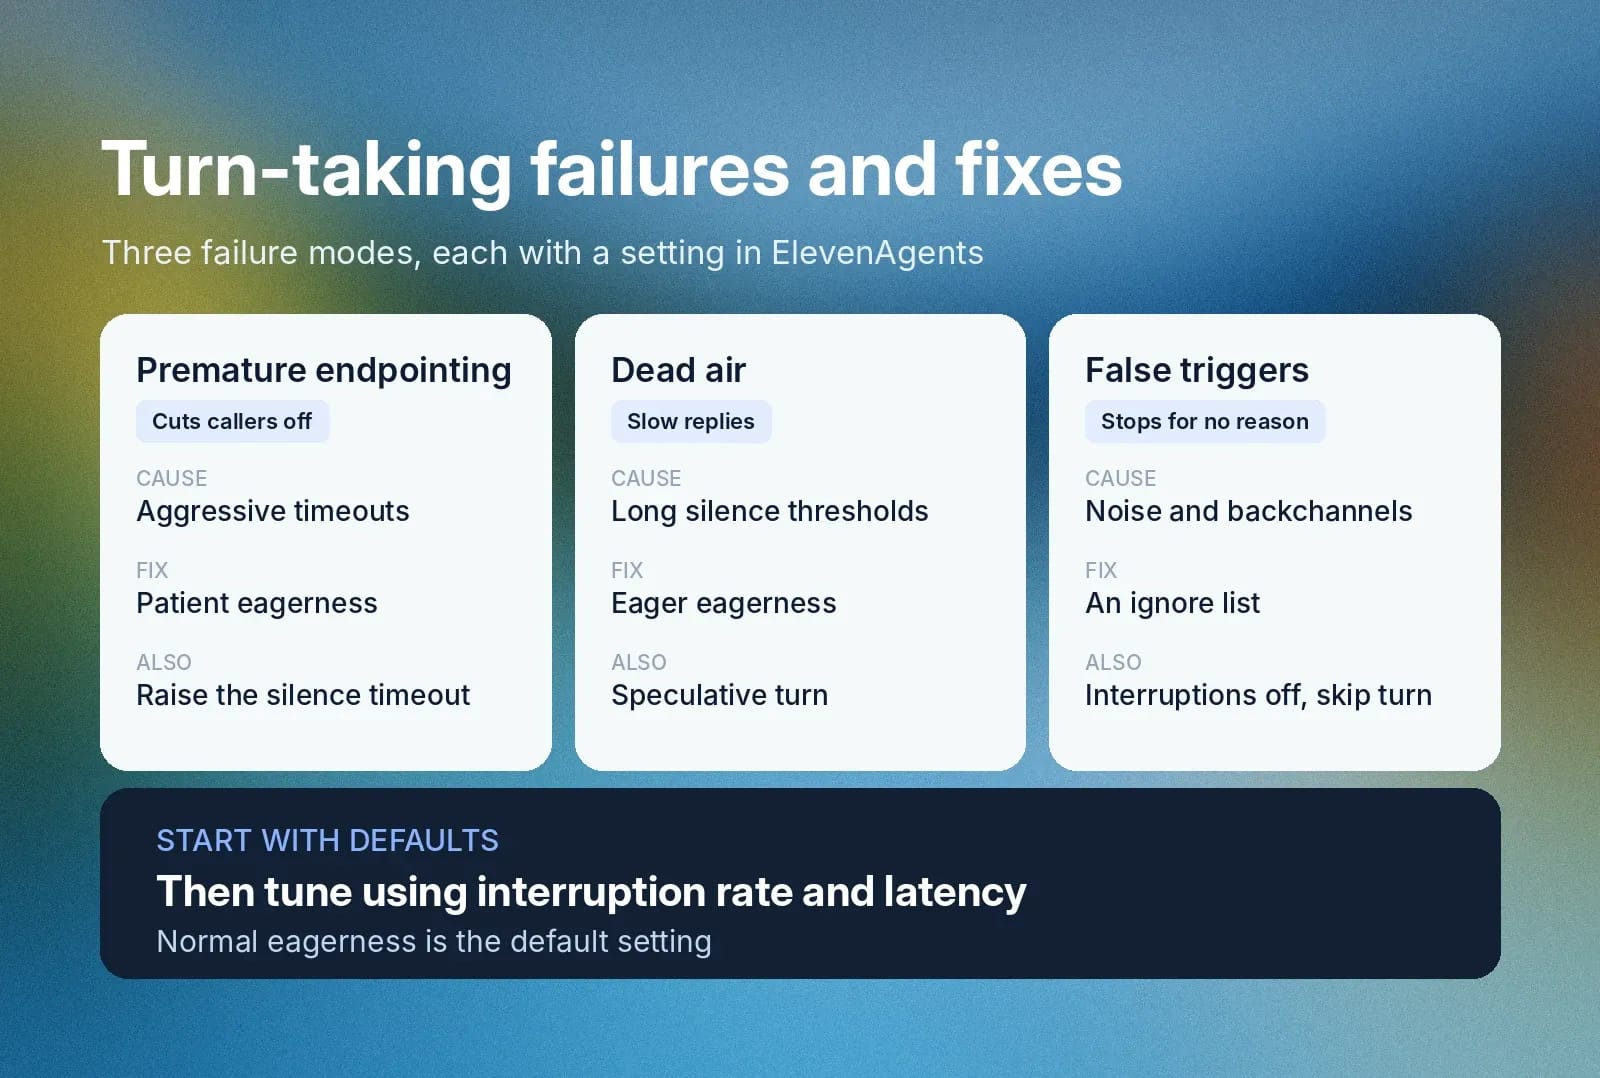
Conversational-AI-Modelle haben drei zentrale Fehlermodi, die Entwicklungsteams bei der Einrichtung von Sprachagenten berücksichtigen müssen:
- Verfrühtes Endpointing: Zu aggressive Timeouts können dazu führen, dass Modelle Pausen mitten im Satz, in denen Anrufer nur nachdenken oder Informationen suchen, als abgeschlossene Gesprächszüge missverstehen. Dadurch unterbricht der Sprachagent häufig und frustriert Kunden.
- Stille und verzögerte Antworten: Zu hohe Schwellenwerte für Stille führen zu langen, unangenehmen Pausen, die die Abbruchrate erhöhen können. Diese Verzögerungen lassen Sprachagenten langsam und nicht reaktionsfähig wirken, was die Kundenerfahrung und Ihr Markenimage beeinträchtigt.
- Fehlauslösungen durch Füllwörter und Geräusche: Schlecht abgestimmte Modelle können Umgebungsgeräusche, Husten und Rückmeldesignale von Zuhörenden als echte Unterbrechungen interpretieren. Dadurch pausiert oder stoppt das Modell unnötig, obwohl der Kunde tatsächlich zuhört und nicht unterbrechen möchte.
Entwicklungsteams können diese Probleme vermeiden, indem sie ElevenAgents mit kontextbezogenen Sprachmodellen einsetzen. Dieser adaptive Ansatz beseitigt in Kombination mit VAD falsche Gesprächsabbrüche, zu langsame Antworten und eine übermäßige Empfindlichkeit gegenüber Hintergrundgeräuschen.
Sprecherwechsel in ElevenAgents konfigurieren
Die richtigen Einstellungen für Sprecherwechsel hängen vom Anwendungsfall und den typischen Anrufen ab, die Ihr Agent erhält. Mit ElevenAgents können Teams jeden der oben genannten Fehlermodi in den Agenteneinstellungen fein abstimmen.
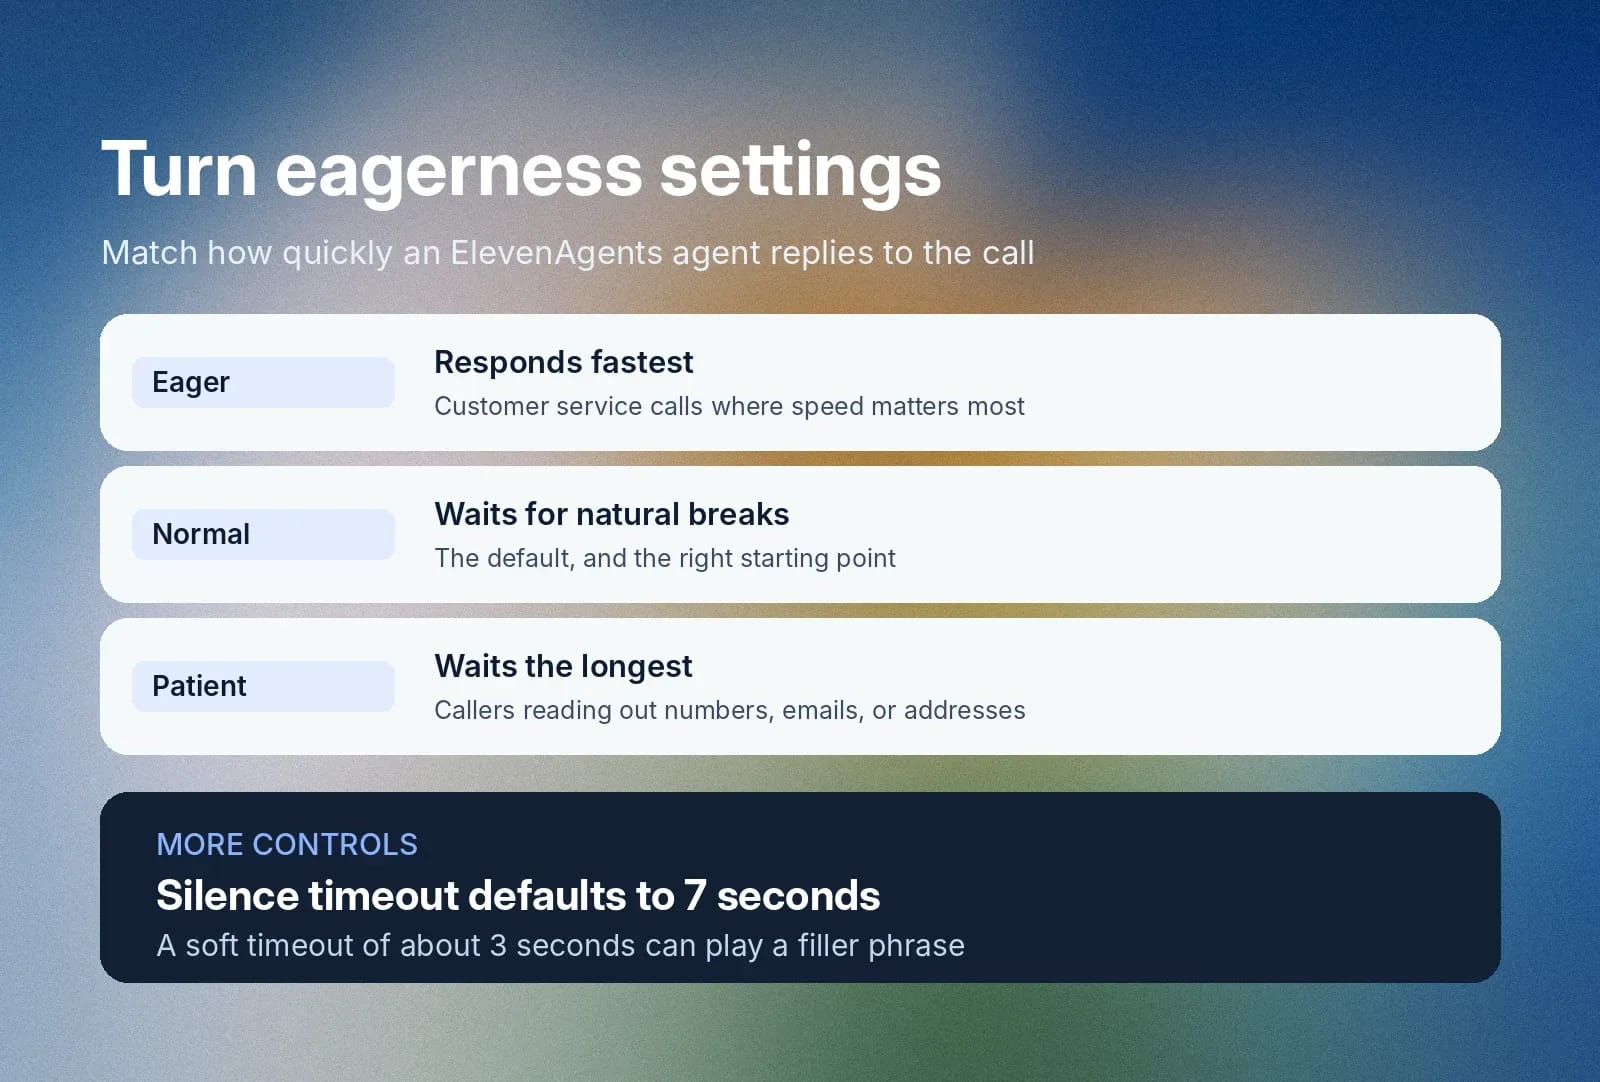
- Verfrühtes Endpointing: Setzen Sie die Turn Eagerness auf Patient, wenn Anrufer Telefonnummern, E-Mail-Adressen, Anschriften oder andere sensible Angaben vorlesen. Eagerness hat drei Stufen. Eager antwortet schneller, Normal (Standard) wartet auf natürliche Pausen und Patient wartet am längsten. Sie können auch das Stille-Timeout an den Anwendungsfall anpassen, etwa auf 5–10 Sekunden für reaktionsschnellen Kundenservice oder 15–30 Sekunden für Haftungsausschlüsse. Standard- und empfohlene Bereiche unterscheiden sich je nach Kanal und Szenario.
- Stille und verzögerte Antworten: Nutzen Sie Eager Eagerness für Kundendienstanrufe, bei denen Geschwindigkeit wichtig ist. Speculative Turn startet die Antwort des Sprachmodells, bevor der Agent sicher weiß, dass der Anrufer fertig ist. Das senkt die Latenz, kann aber auch die LLM-Kosten erhöhen. Ein Soft Timeout kann außerdem eine kurze Füllphrase abspielen, wenn das Modell langsam ist; empfohlen werden 3 Sekunden.
- Fehlauslösungen und unerwünschte Unterbrechungen:Fügen Sie Bestätigungswörter wie „Richtig“ einer Ignorierliste hinzu, damit sie den Agenten nicht unterbrechen. Deaktivieren Sie Unterbrechungen, wenn jedes Wort gehört werden muss, etwa beim Vorlesen eines rechtlichen Haftungsausschlusses. Der Agent kann weiterhin transkribieren, was der Anrufer sagt, und es im nächsten Gesprächszug weitergeben. Bei Aussagen wie „Geben Sie mir eine Minute“ hält das Skip-Turn-Tool den Agenten still und kann sich nach einer festgelegten Zeit wieder melden.
Am wirkungsvollsten nutzen Sie diese Einstellungen in Kombination mit Workflows. Damit kann der Agent seine Turn Eagerness dynamisch ändern – etwa von Normal bei ungezwungenen Gesprächen zu Patient, wenn er einen Schritt erreicht, in dem eine Telefonnummer abgefragt wird. Beginnen Sie mit den Standardeinstellungen und passen Sie Eagerness und Timeouts anhand der unten genannten Kennzahlen für Unterbrechungsrate und Antwortlatenz an.
Qualität des Sprecherwechsels in Conversational AI messen
Qualitätssicherungsteams benötigen konkrete operative Kennzahlen, um Sprecherwechsel in Conversational AI zu bewerten. Dafür muss der Fokus von Technologie und Konfigurationen auf die tatsächliche Wirkung verlagert werden. Einfach gesagt: Sie müssen mehr messen als nur, was sich „natürlich anfühlt“ und was nicht.
Unterbrechungsrate und Antwortlatenz sind die zwei wichtigsten Kennzahlen. Die Unterbrechungsrate misst, wie oft das Modell einen Anrufer fälschlicherweise unterbricht, während die Antwortlatenz erfasst, wie lange das Modell antwortet, wenn eine Person aufgehört hat zu sprechen und eine Antwort erwartet. ElevenAgents protokolliert beide Kennzahlen für jeden Anruf, damit Teams die Daten nutzen können, um Schwellenwerte der Sprachaktivitätserkennung ohne manuelle Prüfung von Transkripten zu optimieren. Lesen Sie unseren Leitfaden zum Messen von Conversational AI für eine vollständige Übersicht über Bewertungsframeworks.
QA-Teams sichern eine hohe Genauigkeit durch einen strukturierten Rhythmus zur Bewertung des Modells. Hier ist ein Beispiel für den Zeitplan eines typischen Teams.
Bewertungsaktivität
Rhythmus
QA-Ziel
Operatives Monitoring
Wöchentlich
Verfolgt die Echtzeit-Performance und erkennt Timing-Probleme bei aktiven Sprachagenten
Bewertungen der Nutzerzufriedenheit
Monatlich
Analysiert die Stimmung der Anrufer, um Konfigurationen für Sprecherwechsel fein abzustimmen
Umfassende System-Benchmarks
Vierteljährlich
Bewertet End-to-End-Genauigkeit, Sprecherwechsel und Schwellenwerte für die Antwortlatenz
Auch wenn automatisierte Kennzahlen verfügbar sind, sollten QA-Teams schließlich weiterhin einige Daten manuell prüfen. Genauere Daten erhalten sie, wenn sie Roh-Audiodateien statt nur Texttranskripte untersuchen. Denn Texttranskripte fügen eine weitere Automatisierungsebene hinzu und können Fehler des Transkriptionstools übersehen, insbesondere bei überlappender Sprache.

Starten Sie mit ElevenAgents für natürliche Sprachgespräche
Menschenähnliche Sprachagenten, die Anliegen schnell lösen, senken Kosten und steigern die operative Effizienz. Dafür benötigen Sie jedoch fortschrittliche KI-Modelle, die Sie für die korrekte Steuerung von Sprecherwechsel fein abstimmen können. Entwicklungsteams erreichen dies mit ElevenAgents. Unsere einheitliche Architektur kombiniert Sprachaktivitätserkennung mit semantischem Verständnis, um einen natürlichen Gesprächsfluss zu erhalten und Latenz zu reduzieren.
Entdecken Sie unsere ElevenAgents-Dokumentation zur Turn Detection, um natürlichen Sprecherwechsel für Ihr Kundenservice-Team zu konfigurieren, oder registrieren Sie sich, um zu starten.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.