Konversations-KI messen: Wichtige Kennzahlen für den Erfolg
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Tools für konversationelle KI senken die Kosten für Kundensupport rund um die Uhr drastisch. Dafür müssen Sie weder Nachtschichten besetzen noch Datenschutzrisiken durch die Auslagerung von Aufgaben ins Ausland eingehen.
Doch Kosteneinsparungen zählen nur, wenn ein KI-Agent Kundenprobleme lösen kann. Die Messung konversationeller KI anhand der richtigen Leistungskennzahlen zeigt Ihnen, ob sie funktioniert – besonders in Unternehmen mit einem hohen Volumen an Kundenanfragen.
Dieser Artikel zeigt, wie die Bewertung von Gesprächsverlauf und Antwortgenauigkeit sowohl das Kundenerlebnis als auch Ihre Marke schützt. Wir erklären, wie Customer-Experience-Teams effektive A/B-Tests für Begrüßungen von Anrufenden durchführen. Außerdem erfahren Sie, wie Sie eine zuverlässige, mehrsprachige Plattform für konversationelle KI betreiben.
Zusammenfassung
- Die systematische Messung konversationeller KI anhand von Qualitäts-, Erlebnis- und Betriebskennzahlen liefert die Daten, die Sie zum Schutz des Kundenerlebnisses benötigen.
- Automatisierte Bewertungstools verfolgen und verbessern Kennzahlen für konversationelle KI kontinuierlich und im großen Maßstab, während Mitarbeitende regelmäßige Stichproben durchführen.
- Wenn Sie bei A/B-Tests jeweils nur eine Variable isolieren, können Sie genau feststellen, was schiefgelaufen ist, und Korrekturen einsetzen, die identifizierte Probleme direkt beheben.
- Kontinuierliche Verbesserung ist nötig, da KI-Unternehmen die zugrunde liegenden Modelle häufig aktualisieren. Dadurch verhalten sich zuvor zuverlässige Chatbots in der Produktion oft anders.
Was die Messung konversationeller KI bedeutet und warum sie wichtig ist
Die Messung von konversationeller KI umfasst die systematische Bewertung, wie gut Ihre getesteten oder eingesetzten KI-Agenten Kundenanfragen bearbeiten und Probleme lösen. Ziel ist es, anhand Ihrer festgelegten Leistungsstandards zu bestimmen, wie effektiv Ihre automatisierten Systeme mehrstufige Gespräche in der Praxis führen. Diese Standards spiegeln meist wider, wie gut die Modelle die Nutzerabsicht verstehen, markenkonform bleiben, präzise Antworten liefern und das Anliegen erfolgreich lösen.
Modellbewertungen mögen für ein System, das die Aufgaben Ihres Teams reduzieren soll, wie viel Zusatzaufwand wirken. Ohne kontinuierliche Bewertung lässt sich jedoch kaum erkennen, wie gut das Modell in realen Anwendungsfällen funktioniert. Mit anderen Worten: Sie wissen, dass Ihr KI-System die Betriebskosten des Kundensupports senkt – aber können Sie bestätigen, dass es Kunden zufriedenstellt, statt sie zu anderen Lösungen zu treiben?
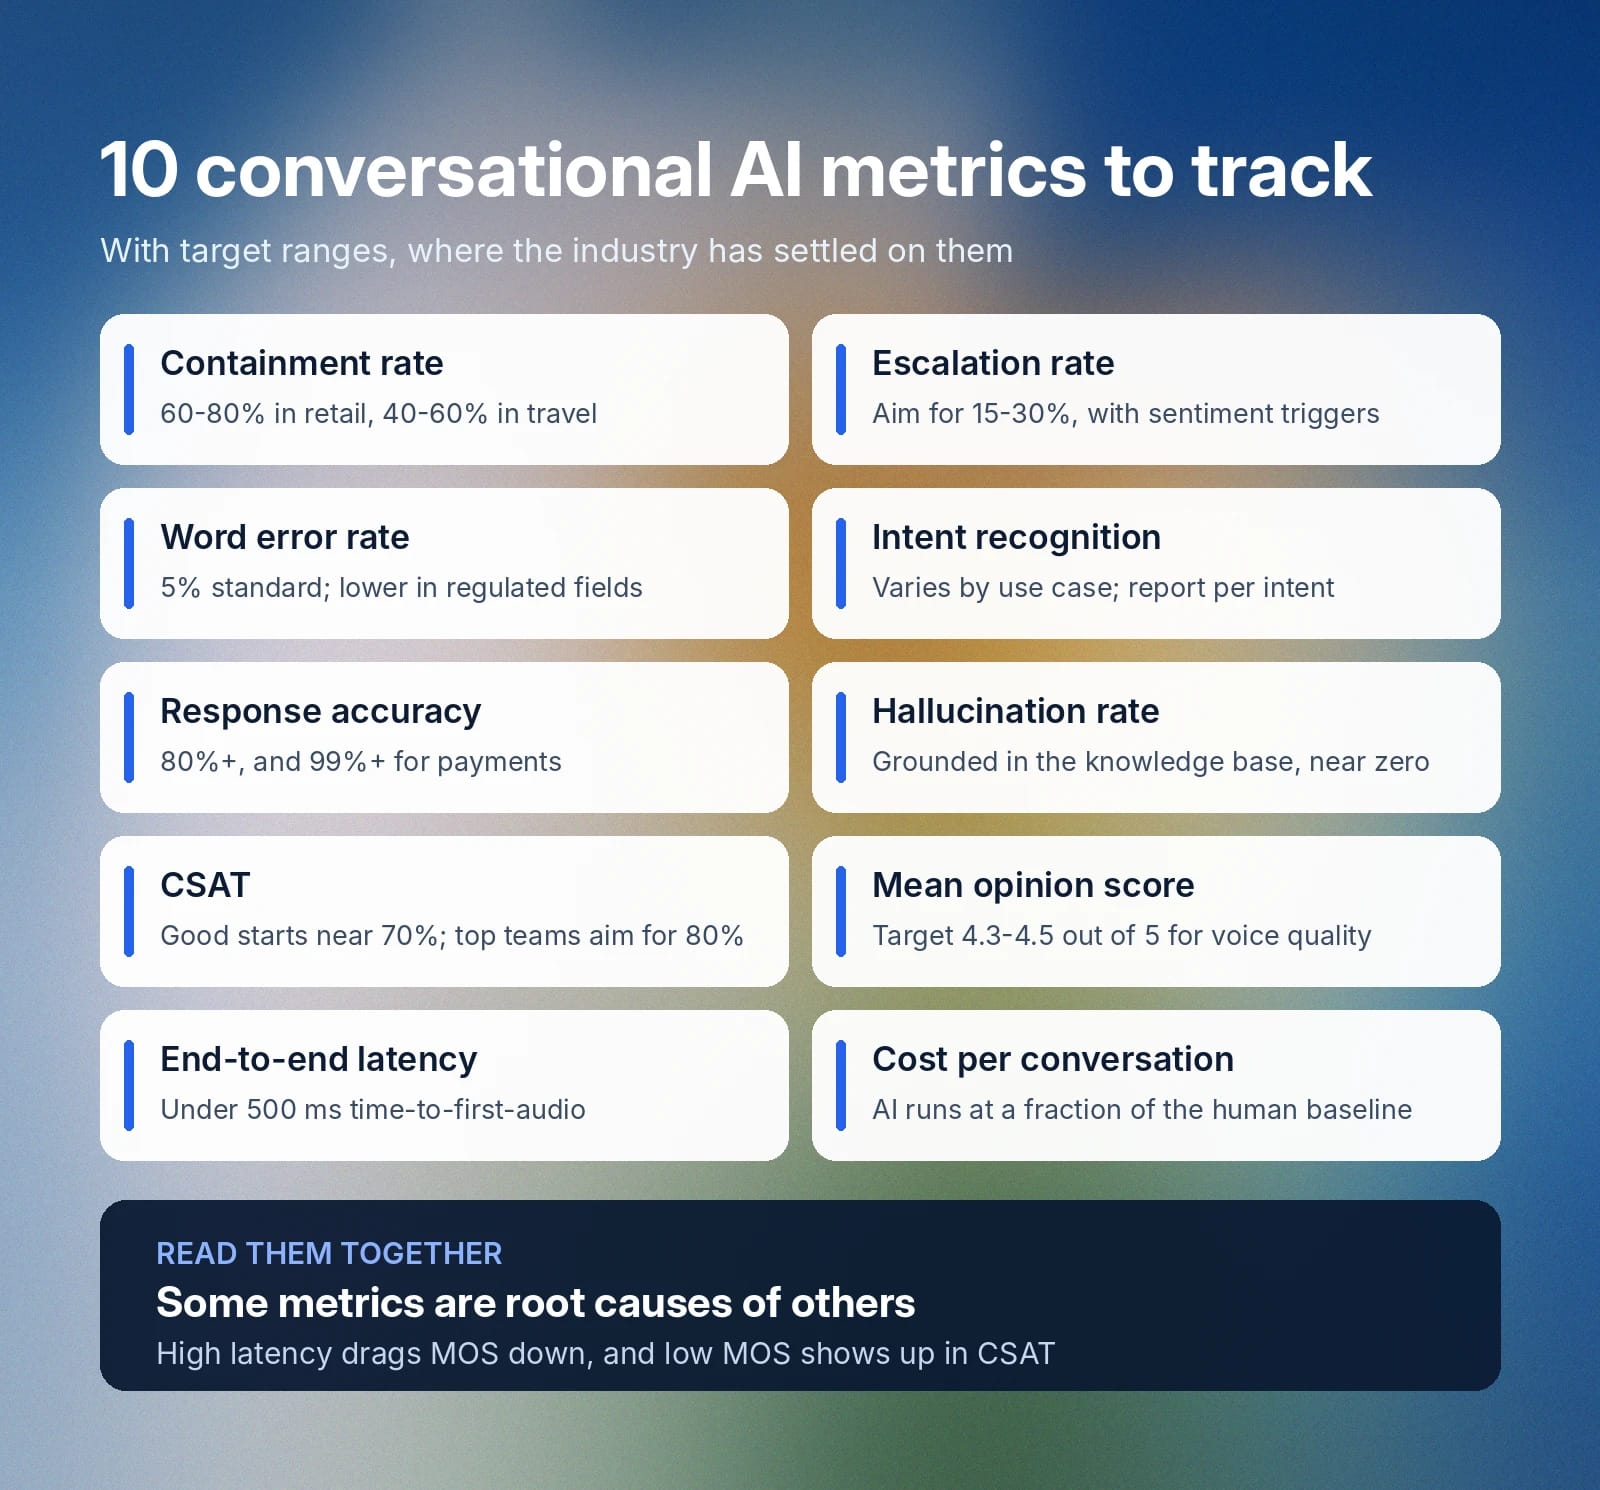
Eine umfassende Messung erfordert die Betrachtung des Modells in drei Hauptkategorien:
- Qualität: Bewerten Sie, wie präzise, kohärent und relevant die Antworten einer KI im Hinblick auf die ursprüngliche Anfrage des Nutzers sind. Die zentrale Frage lautet: Liegt die KI richtig und gibt sie Nutzern die korrekten Antworten, oder halluziniert sie und macht Fehler?
- Erlebnis: Bewerten Sie das Kundenerlebnis, etwa ob die KI schnell geantwortet hat und wie viele Gesprächsschritte sie für eine zufriedenstellende Antwort benötigte. Die zentrale Frage lautet: Fühlt sich das Erlebnis für Nutzer natürlich und hilfreich an oder eher roboterhaft und frustrierend?
- Betrieb: Stellen Sie fest, ob das System zuverlässig arbeitet und eine kosteneffiziente Lösung für Ihren Kundensupport bleibt. Häufige Fragen sind: Hat das System eine hohe Verfügbarkeit und liefert es den nötigen Return on Investment, der seinen Einsatz rechtfertigt?
Erfolg sieht für jedes Team anders aus. Ihre ursprünglichen Probleme vor der Automatisierung des Supports spielen dabei eine entscheidende Rolle. Hatte Ihr Team beispielsweise zunächst Schwierigkeiten, einen Kundensupport rund um die Uhr aufrechtzuerhalten, steigert die ständige Verfügbarkeit von KI-Agenten die Leistung des Kundensupports deutlich. Alle diese Kategorien sind jedoch wichtig für den Gesamterfolg. Ein System, das immer online ist und selten ausfällt, hilft Kunden wenig, wenn es roboterhaft wirkt und Antworten halluziniert.
Wichtige Kennzahlen für konversationelle KI
Verfolgen Sie klare, umsetzbare Kennzahlen, um die Leistung von Agenten im Kundenkontakt und den tatsächlichen Geschäftswert Ihrer aktuellen Implementierung zu beurteilen. Kontinuierliche Bewertung schafft zudem die Grundlage für regelmäßige Verbesserungen. Wenn Sie genau erkennen, wo Engpässe in Ihren Abläufen bestehen oder Anpassungen nötig sind, verfügen Sie über die Daten, um die Ursache wirksam zu beheben.
Nutzen Sie diese Kennzahlen für konversationelle KI als Ausgangspunkt für die Bewertung von Sprachanrufen und der Chatbot-Leistung:
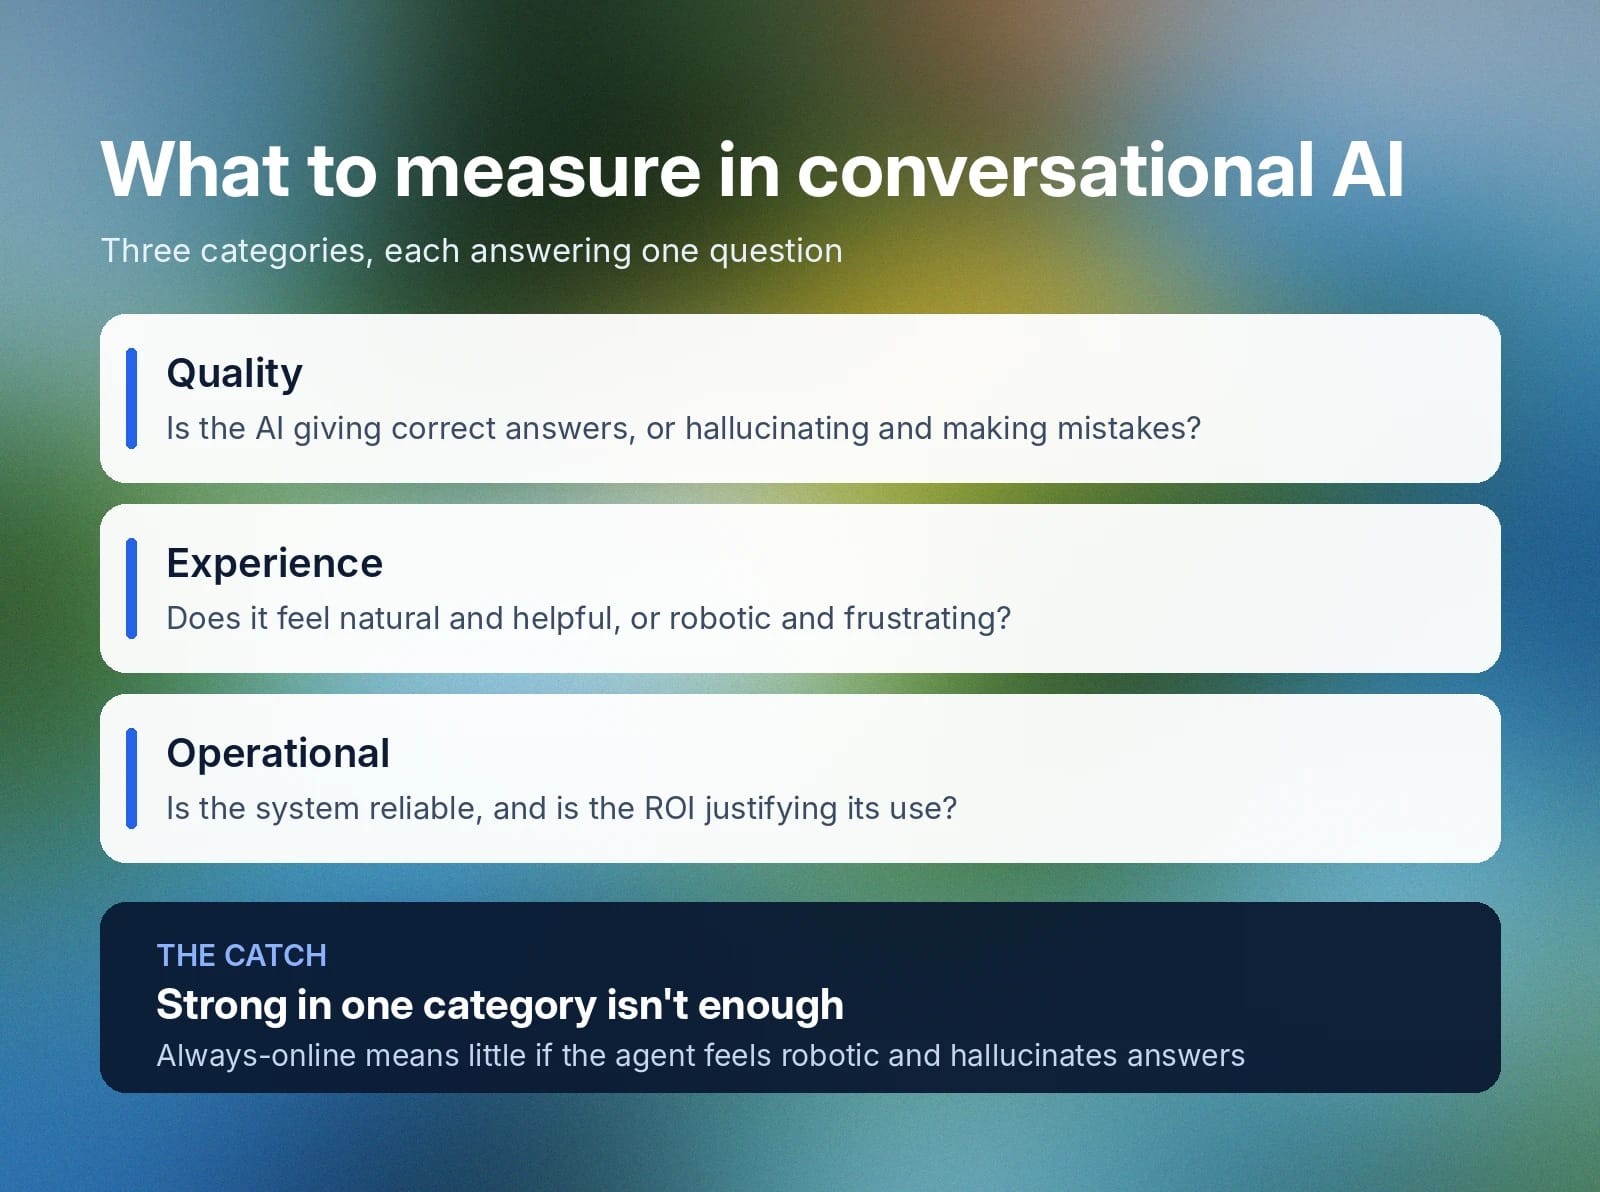
- Containment-Rate: Verfolgen Sie den Anteil der Anfragen, die vollständig im automatisierten Kanal gelöst werden. Ziele unterscheiden sich je nach Branche, Kontext, Anwendungsfall und Bot-Typ. Beispielsweise sind 60–80 % durchaus Standard im Einzelhandel, während Reisewebsites Werte zwischen 40–60 % erreichen.
- Eskalationsrate: Messen Sie, wie häufig KI-Agenten Anrufe ohne Eskalation an einen Menschen bearbeiten. Proaktive Unternehmen legen automatische Schwellenwerte fest, um Anrufe an Menschen zu übergeben, sobald die Stimmung negativ wird. Gute Eskalationsraten variieren nach Branche und Aufgabenkomplexität, sollten aber bei 15–30 % liegen.
- Wortfehlerrate (WER): Verfolgen Sie, wie gut die KI Wörter während eines Anrufs oder einer Transkription korrekt „hört“. Ein guter Branchenstandard liegt bei 5 %, doch Sie benötigen eine niedrigere WER für Anwendungsfälle in regulierten Bereichen oder bei der Verarbeitung sensibler Daten, etwa im Gesundheitswesen, in der Finanzbranche und im Rechtswesen.
- Genauigkeit der Absichtserkennung: Erfolgreiche KI-Agenten müssen nicht nur Wörter erkennen, sondern auch das Problem und den Bedarf des Nutzers präzise verstehen. Genauigkeitsziele variieren je nach Anwendungsfall und Absichtskategorie.
- Antwortgenauigkeit: Ermitteln Sie, wie zuverlässig das Modell wahrheitsgemäße und sinnvolle Antworten gibt. Dies ist entscheidend, damit Kunden ihre Probleme lösen können. Allgemeine Kundensupportanfragen erfordern 80 % oder mehr, sensible Anwendungsfälle wie Zahlungen 99 % oder mehr.
- Halluzinationsrate: Sie hängt eng mit der Antwortgenauigkeit zusammen, misst aber speziell die faktische Richtigkeit von Antworten auf Grundlage der Wissensdatenbank. Niedrige Halluzinationsraten sind entscheidend für hilfreiche Antworten und dafür, dass Modelle keine Versprechen machen, die das Unternehmen nicht halten kann.
- Kundenzufriedenheit (CSAT): Erfassen Sie die Kundenstimmung mit Umfragen nach dem Anruf, um die Zufriedenheit zu bestimmen. Unternehmen erfassen diese Daten auf einer Fünf-Punkte-Skala, drücken die Ergebnisse jedoch häufig in Prozent aus. Laut SurveyMonkey beginnen gute CSAT-Werte in der Regel bei etwa 70 %, wobei einige Unternehmen 80 % oder mehr anstreben.
- Mean Opinion Score (MOS): Diese nutzerorientierte Kennzahl nutzt ebenfalls eine Fünf-Punkte-Skala. Sie misst jedoch, wie natürlich die KI-Antwort klingt und wie klar die synthetische Stimme ist. Streben Sie einen MOS von etwa 4,3–4,5 an.
- End-to-End-Sprachlatenz: Messen Sie die gesamte Verzögerung zwischen dem Abschluss einer Anfrage durch den Nutzer und dem Beginn der Agentenantwort. Produktionsreife Agenten streben eine End-to-End-Zeit bis zum ersten Audio (TTFA) von unter 500 Millisekunden an. Das Modell ElevenLabs Flash v2.5 erreicht derzeit eine interne Modell-Inferenzlatenz von etwa 75 ms. Die tatsächliche End-to-End-Latenz hängt von Faktoren wie Ihrem Standort und dem verwendeten Endpunkttyp ab.
- Kosten pro Gespräch: Messen Sie die gesamten Betriebskosten jeder automatisierten Kundeninteraktion im Vergleich zu Gesprächen mit Menschen. Gespräche mit ElevenLabs beginnen bei 10 Cent pro Minute, während das durchschnittliche Stundenentgelt von Kundendienstmitarbeitern nahelegt, dass menschliche Gespräche etwa 32 Cent pro Minute kosten. Das führt zu Kosteneinsparungen von rund 70 %, wobei die Preise je nach Plan und Nutzung variieren können. Aktuelle Preise finden Sie auf der ElevenLabs-Preisseite.
Berücksichtigen Sie bei der Auswahl der Kennzahlen zur Messung Ihrer Modellleistung die Bereiche, die für Ihre Branche und Ihr Geschäftsmodell am wichtigsten sind. So sind Genauigkeit und faktische Richtigkeit besonders wichtig für Bereiche wie Bankwesen und Patienteninformationen, während Latenz, MOS und Eskalationsraten für Unternehmen mit Fokus auf das Kundenerlebnis am wichtigsten sind.
Beachten Sie, dass einige Kennzahlen die Ursachen für andere liefern. Hohe Latenz führt beispielsweise wahrscheinlich zu einem niedrigen MOS und damit zu einer niedrigen Kundenzufriedenheit, ausgedrückt als CSAT.
So messen Sie die Genauigkeit konversationeller KI
Messen Sie die Modellgenauigkeit, indem Sie einen Ground-Truth-Testsatz aus etwa 500 bis 1.000 echten historischen Gesprächen erstellen. Reale Protokolle erfassen unordentliche, natürliche Formulierungen, die synthetische Daten oft nicht enthalten, etwa Tippfehler, Umgangssprache und Nutzerfehler. Bewerten Sie Ihr System dann anhand dieser realen Protokolle in Bezug auf Absichtserkennung, Antwortgenauigkeit und Halluzinationsrate.
Führen Sie für diese Interaktionen automatisierte Bewertungen mit einer LLM-as-a-Judge-Bewertungsmethode durch. Validieren Sie die automatisierten Bewertungen jedoch immer anhand von menschlich gelabelten Systemen, um ihre Übereinstimmung sicherzustellen. Menschliche Prüfer führen anschließend wöchentliche Stichproben zur Bewertung der Chatbot-Leistung anhand eines einfachen Drei-Punkte-Schemas durch:
- Korrekt: Die Antwort ist faktisch richtig, kontextbezogen relevant und erfüllt direkt die primäre Absicht des Nutzers.
- Akzeptabel: Die Antwort ist technisch korrekt und hilfreich, weist jedoch einige kleinere stilistische Probleme, ungeschickte Formulierungen oder nicht markenkonforme Formatierungen auf.
- Falsch: Die Antwort muss sofort korrigiert werden, weil sie Fehler in der faktischen Richtigkeit, schwerwiegende Halluzinationen enthält oder die Nutzerabsicht vollständig missversteht.
Idealerweise verwenden Sie für die Modellbewertung eine Methode pro Nutzerabsicht, denn KI-Agenten funktionieren in manchen Kontexten gut und versagen in anderen völlig. Aggregierte Zahlen können dazu führen, dass leistungsstarke Bereiche kritische Schwachstellen verdecken.
Wir haben diesen Workflow vereinfacht, indem wir Next Reply (Scenario)-Tests direkt in unsere ElevenAgents-Tests integriert haben. Die Funktion Next Reply bewertet die Folge-Nachricht eines Agenten statt des vollständigen mehrstufigen Gesprächs. Sie geben jedoch den Chatverlauf bis zum Bewertungspunkt an und bewerten die Antwort anhand von Richtlinien, Tonalität und Qualitätsstandards.
So führen Sie A/B-Tests für Antworten konversationeller KI durch
A/B-Tests erfassen Feedback aus der Praxis, damit Sie nicht raten müssen, was Kunden bevorzugen. Anschließend nutzen Sie diese empirischen Daten, um die Leistung des KI-Modells zu optimieren. Nach dem Tracking von Kennzahlen hat Ihr Team wahrscheinlich eine Liste mit gewünschten Änderungen oder Experimenten. Wenn Sie jedoch mehrere Dinge gleichzeitig ändern, ist schwer zu erkennen, was funktioniert hat und was nicht.
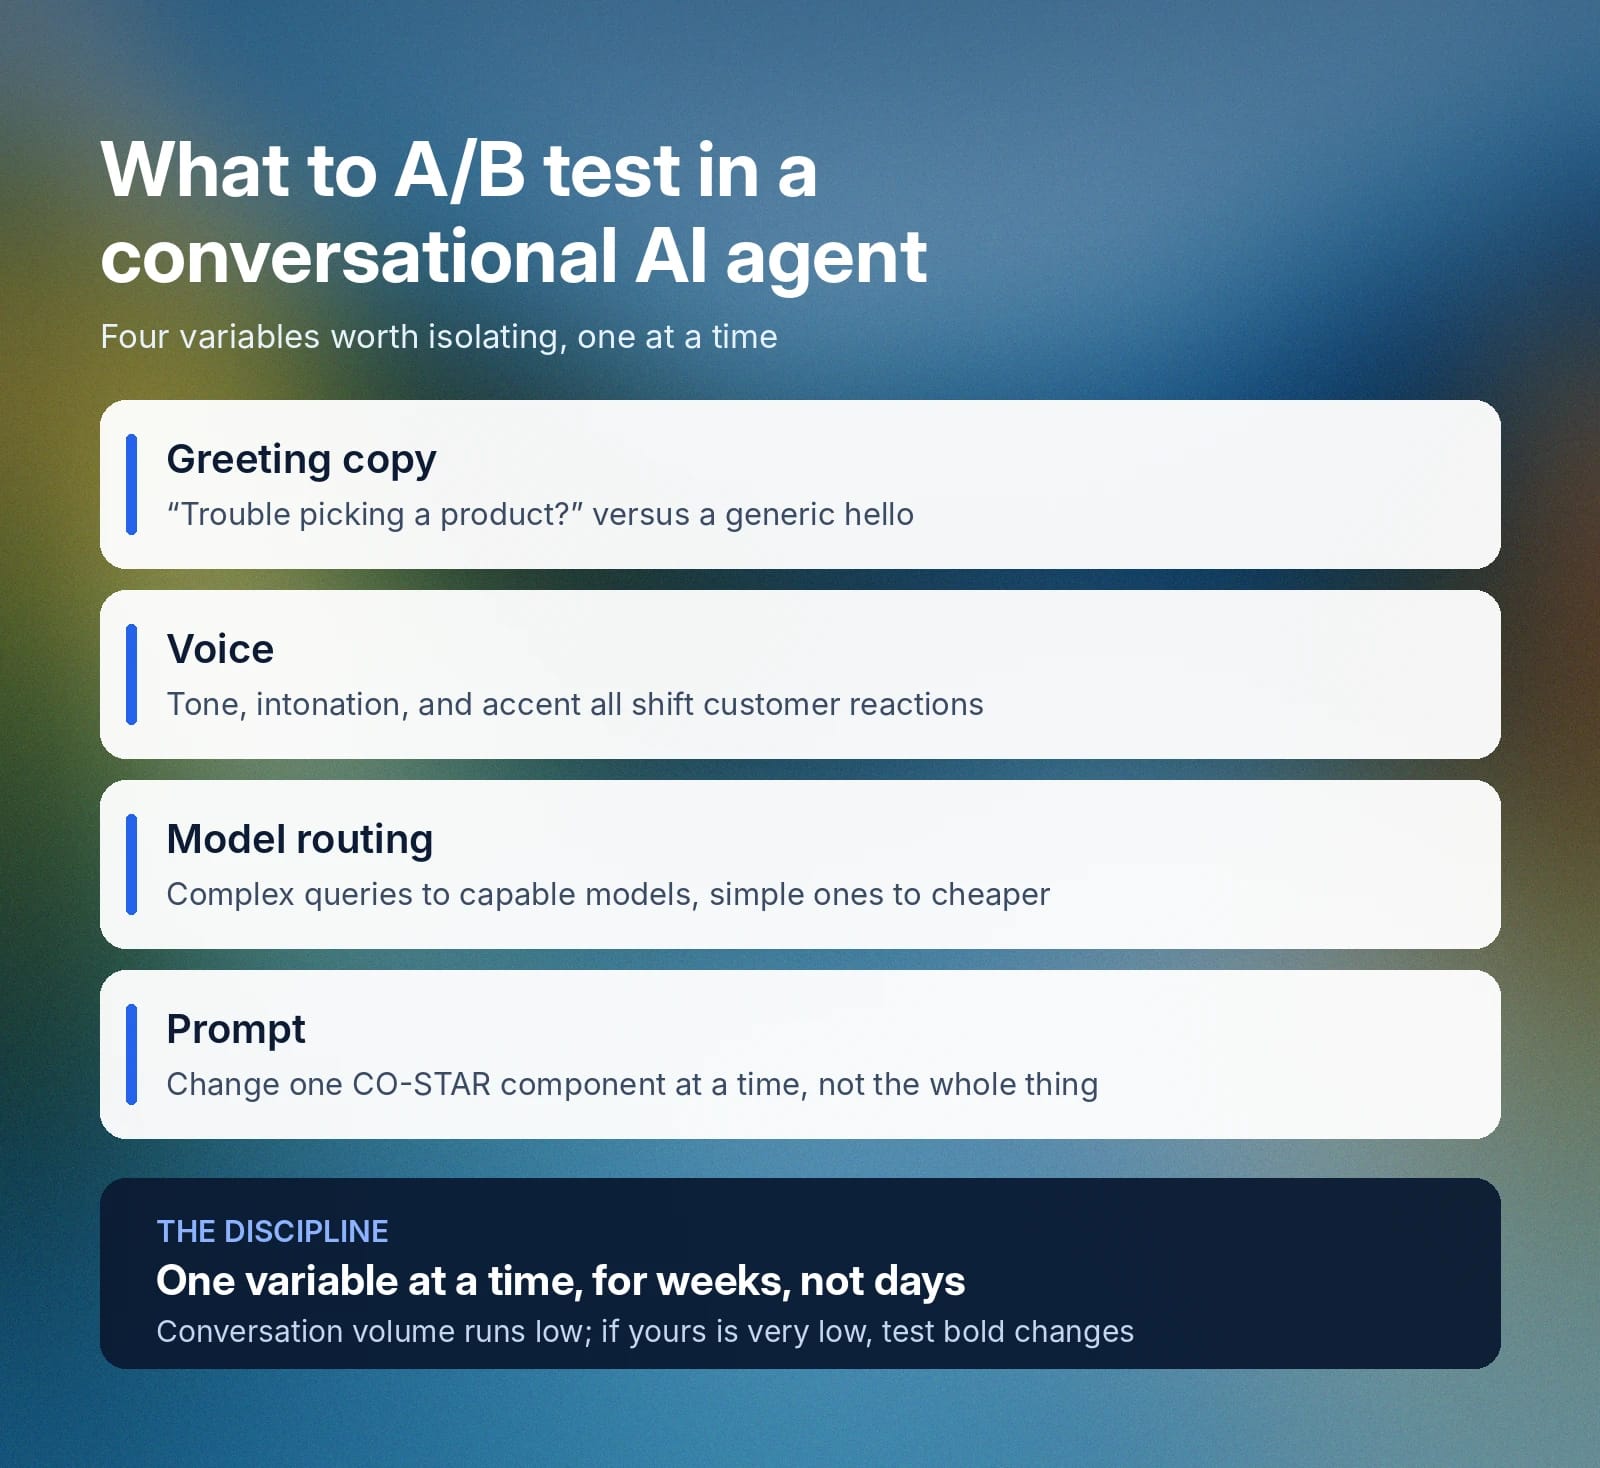
Ein valider Test erfordert daher, jeweils eine konkrete Variable zu isolieren und den Rest der zugrunde liegenden Wissensdatenbank konstant zu halten. Mögliche zu variierende Elemente sind:
- Begrüßungstext: Ändern Sie die anfängliche Begrüßung in etwas Spezifisches wie „Hallo. Schwierigkeiten bei der Produktauswahl?“ statt nur „Hallo, wie kann ich helfen?“ zu sagen.
- Stimme: Kunden reagieren je nach Situation möglicherweise positiver auf bestimmte Stimmen als auf andere – abhängig von männlich oder weiblich wirkendem Klang, Tonfall, Intonation und sogar Akzent.
- Modell-Routing: Leistungsstarke Modelle kosten meist mehr. Daher ist es effizient und kosteneffizient, komplexe und einfache Anfragen entsprechend weiterzuleiten.
- Prompt: Prompts haben mehrere Komponenten. Ändern Sie daher jeweils nur einen Aspekt, etwa Kontext, Ziel, Stil, Tonalität, Zielgruppe oder Antwortvorlage (CO-STAR).
Teams sollten auch den Testzeitraum anpassen. Das Gesprächsvolumen ist typischerweise deutlich niedriger als Seitenaufrufe, daher müssen Sie den Test Wochen statt Tage lang durchführen, um statistische Signifikanz zu erreichen. Bei extrem geringem Volumen sollten Sie große, deutliche Änderungen statt kleiner Anpassungen testen.
Ein praktischer Workflow erfordert außerdem Agenten-Versionierung, Vergleichs- und Rollback-Tools. Diese haben wir direkt in ElevenAgents integriert.
So testen Sie einen KI-Agenten vor der Bereitstellung
Der Kundenservice ist ein direkter Kontaktpunkt zu den Menschen, die Ihren Geschäftserfolg beeinflussen. KI reagiert manchmal unvorhersehbar auf kleine Änderungen. Testen Sie deshalb einen neuen oder überarbeiteten KI-Agenten für konversationelle KI immer vor dem Produktionsstart. Reines „Vibe-Testing“ reicht nicht aus.
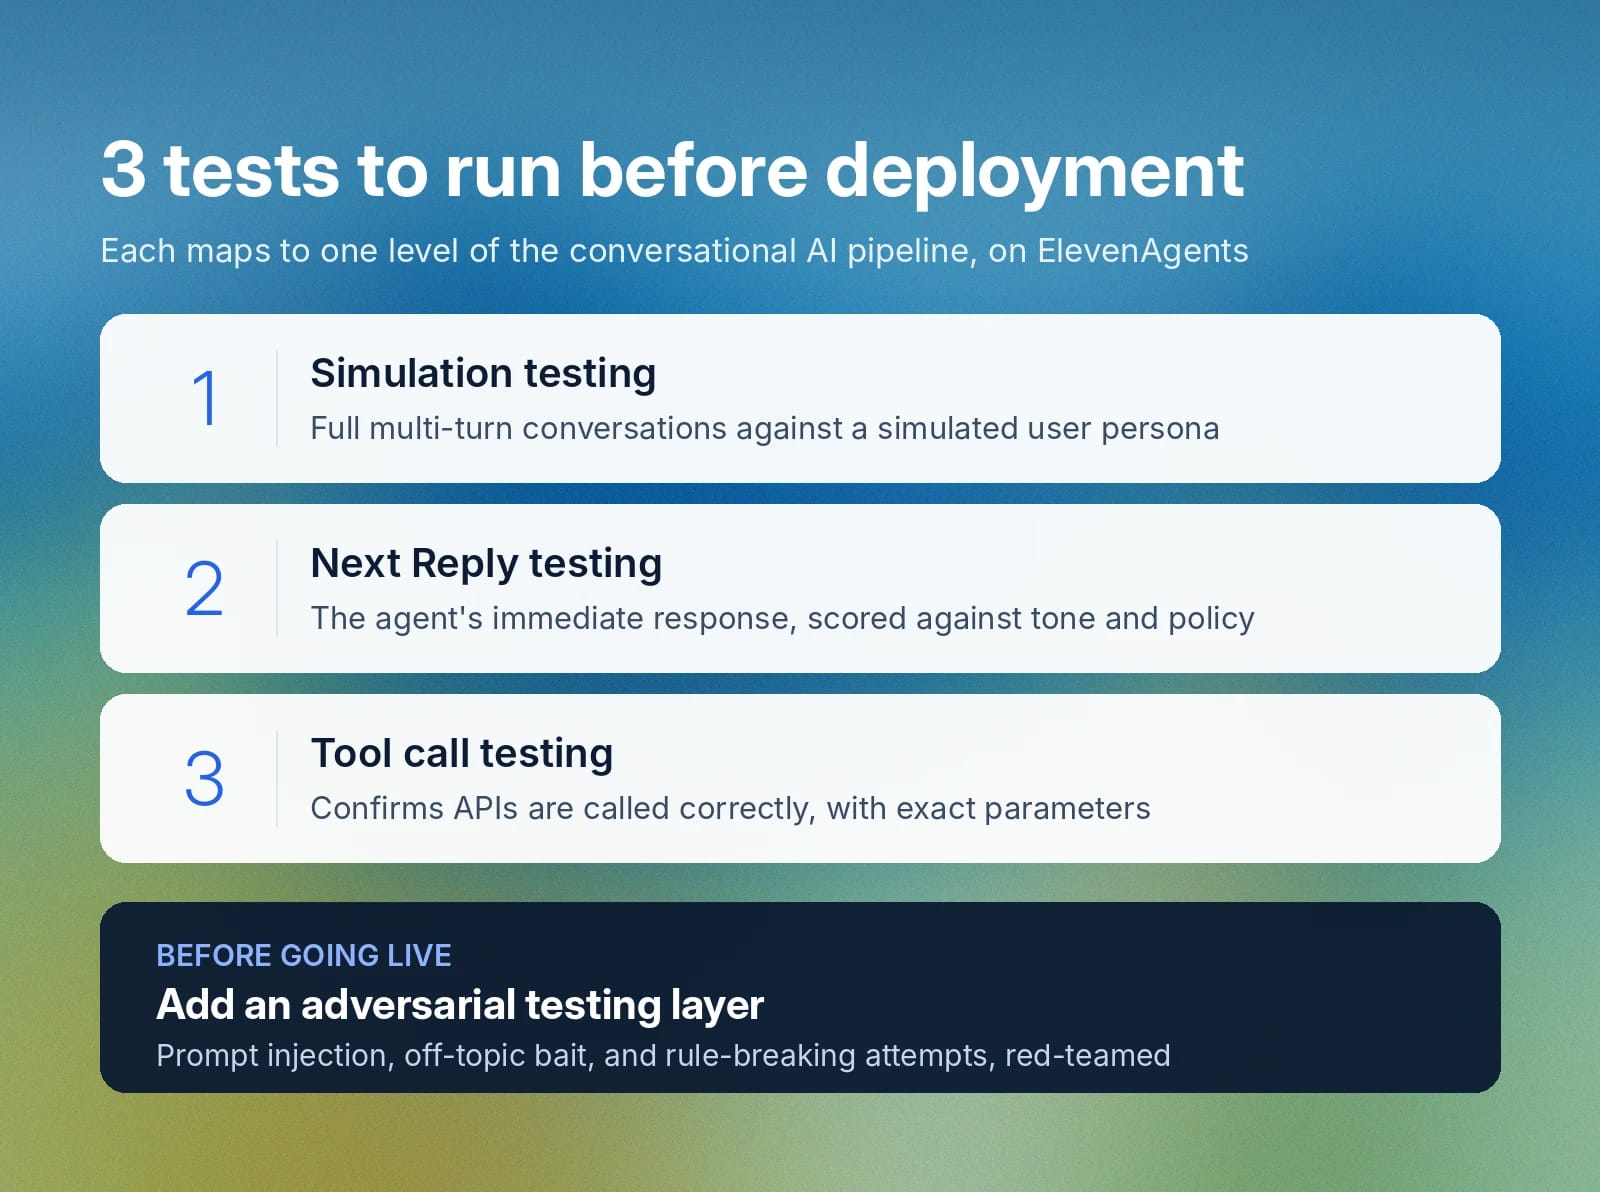
Wir haben unser ElevenAgents-Testframework auf drei Haupttesttypen ausgerichtet, die bestimmte Ebenen Ihrer Pipeline für konversationelle KI prüfen:
- Simulationstests: Führt ein vollständiges mehrstufiges Gespräch mit einer simulierten Nutzerpersona durch, um zu bestätigen, dass der Dialog die gewünschten Leistungsniveaus erfüllt.
- Next Reply-Tests: Testet nur die unmittelbaren Antworten des Agenten anhand bestimmter Tonalitäts-, Richtlinien- oder anderer Vorgaben, um Angemessenheit und Genauigkeit der Antworten zu bestätigen.
- Tool-Call-Tests: Stellt sicher, dass Agenten verbundene APIs korrekt aufrufen und die exakten Parameter für kritische Datenbankabfragen oder Übertragungen übergeben.
Da so viele Angreifer versuchen, Modelle für böswillige Zwecke zu jailbreaken, benötigen Sie vor dem Go-live zusätzlich eine Schicht für adversariale Tests. Arbeiten Sie mit QA-Teams, Prompt Engineers und Red-Team-Cybersicherheitsexperten zusammen, um Prompt-Injection, themenfremde Köder und Versuche zur Regelverletzung zu testen.
Abschließend sollten Sie eine schrittweise Einführung wählen: Stellen Sie Pilotversionen einer kleinen Nutzergruppe bereit und überwachen Sie ihr Verhalten in der Praxis. Definieren Sie strenge Kriterien, die das Modell erfüllen muss, bevor Sie es für eine größere Gruppe oder Ihren gesamten Kundenstamm freigeben. Benennen Sie eine einzelne verantwortliche Person für die Freigabe und schaffen Sie einen Rollback-Pfad, falls eine Anpassung zu schlechteren Leistungskennzahlen führt.
Chatbot-Leistung in der Produktion bewerten
Definieren Sie vor dem Start Ihres Modells für konversationelle KI, wie Erfolg für jeden Anwendungsfall aussieht. Dies ist besonders wichtig für Anwendungen in stark regulierten Bereichen, in denen Genauigkeit und Datenschutz höheren Maßstäben und strengeren Anforderungen unterliegen.
Automatisierte Antworten ermöglichen A/B-Tests von Modellen im großen Maßstab. Objektive Tests erfordern jedoch zusätzlich die spontane Prüfung von Transkripten und Feedback menschlicher Tester. Menschen im Prozess erkennen Gesprächsnuancen, die KI-Modelle übersehen, sowie Eigenheiten in den Daten, die in aggregierten Zahlen sonst verlorengehen. Eine umfassende Bewertungsstrategie umfasst zudem Sentiment-Analyse und direktes Nutzerfeedback.
Kontinuierliche Verbesserung unterscheidet reife Systeme mit hohem Return on Investment zusätzlich. Während Wettbewerber Tests und Monitoring als getrennte Aufgaben behandeln, vereint eine reife Pipeline beides. In diesem Fall fließen Fehler aus der Produktion direkt in Ihren Testsatz ein, um den nächsten optimierten Agenten zu trainieren.
Regelmäßige Anpassungen werden auch nötig, wenn KI-Unternehmen die Basismodelle aktualisieren, auf denen Ihr Agent läuft. Diese Änderung führt häufig dazu, dass ein zuvor effektiver Prompt plötzlich unzuverlässige oder sogar unangemessene Antworten begünstigt.
Wir haben diese Feedbackschleife direkt in unsere Plattform integriert. Nutzen Sie unsere Tools zur Gesprächsanalyse, um die strukturierte Datenerfassung zu automatisieren und die Stimmung einfach zu bewerten. Große Unternehmen nutzen auch unsere Enterprise-Infrastruktur für konversationelle KI, um ihre Agenten weltweit zuverlässig zu überwachen und zu skalieren.
Starten Sie mit ElevenAgents für Kundensupport-Kennzahlen
Die erfolgreiche Einführung konversationeller KI im großen Maßstab erfordert mehr als hochwertige Stimmen und Modelle mit niedriger Latenz. Sie benötigen ein integriertes Ökosystem zum Entwerfen, Erstellen, Testen, Bereitstellen und Anpassen von Multi-Agent-Workflows.
ElevenAgents bietet Ihnen die skalierbare Infrastruktur, die Sie benötigen. Ihr Team erhält Zugriff auf Tools wie Next Reply-Verifizierung, Sentiment-Tracking und automatische Datenerfassung, um Modelle kontinuierlich zu überwachen und für optimale Ergebnisse zu verbessern. Noch besser: Sie erkennen Regressionen, bevor sie Ihre Kunden erreichen.
Möchten Sie die Messung konversationeller KI vereinfachen? Entdecken Sie unsere Funktionen für Agententests und erfahren Sie, wie unsere Enterprise-Teams zuverlässige Agenten bereitstellen, die Ihre Kennzahlen für den Kundensupport verbessern.
Erfahren Sie mehr über ElevenAgents oder registrieren Sie sich, um noch heute zu starten.
Häufig gestellte Fragen zur Messung konversationeller KI

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.