
Was ist Voice Activity Detection und wie funktioniert sie?
- Verfasst von
- Jack Limebear
- Veröffentlicht
AnhörenArtikel anhören
Voice Activity Detection klassifiziert, ob kurze Audio-Frames im Millisekundenbereich menschliche Sprache enthalten. Sie wird in vielen Anwendungen zur digitalen Audioverarbeitung eingesetzt, darunter Transkription, Telefonie und Sprachagenten.
In diesem Artikel erläutern wir, was Voice Activity Detection leistet, was nicht und wie sie in wichtige Unternehmensanwendungen passt.
Zusammenfassung
- Voice Activity Detection (VAD) ist ein grundlegender Bestandteil moderner Audio-Workflows. Sie analysiert kontinuierlich einen Audiostream und gibt für jeden Audio-Frame im Millisekundenbereich eine Ja/Nein-Entscheidung aus, ob menschliche Sprache vorhanden ist.
- VAD teilt nachgelagerten Audiotools mit, wann sie arbeiten und wann sie warten sollen. Sie wird von LLMs, Transkriptionsdiensten und anderen Unternehmens-Audiopipelines eingesetzt.
- Algorithmen zur Voice Activity Detection laufen in einer kontinuierlichen Schleife mit fünf Phasen: Audio erfassen, Frames bilden, Sprachmerkmale extrahieren, die Wahrscheinlichkeit für Sprache bewerten und eine Entscheidung an nachgelagerte Dienste weitergeben.
- Ursprünglich nutzte VAD rein mathematische Signalverarbeitung, um Ja/Nein-Entscheidungen über das Vorhandensein von Sprache zu treffen. Moderne KI-basierte Systeme nutzen neuronale Netze für dieselbe Aufgabe, verstehen Hintergrundgeräusche und semantische Hinweise jedoch besser im Kontext.
- VAD-Systeme klassifizieren nur, ob ein Audio-Frame Sprache enthält. Sie sagen nicht, wann jemand fertig gesprochen hat. Endpoint-Systeme nutzen VAD und andere heuristische Analysewerkzeuge, um zu entscheiden, ob ein Sprecher seinen Gedanken abgeschlossen hat.
- In Unternehmensumgebungen hilft VAD Sprachagenten dabei, natürlich mit Kunden zu sprechen, ohne sie zu unterbrechen, optimiert die VoIP-Bandbreitennutzung, senkt KI-Transkriptionskosten für Speech to Text (STT) und hat weitere Einsatzbereiche.
- Testen Sie VAD-Systeme unter realen Bedingungen. Einwandfreie Studioaufnahmen sind kein wirksames Mittel, um ihre Fähigkeiten zu bestimmen.
Was ist Voice Activity Detection (VAD)?
Voice Activity Detection (VAD) ist ein Softwareprozess, der klassifiziert, ob kleine Audioabschnitte, sogenannte Frames, Sprache enthalten. VAD-Algorithmen laufen Dutzende bis Hunderte Male pro Sekunde auf einem Audiostream und geben eine binäre „Ja“- oder „Nein“-Antwort aus, ob sie Sprache erkennen.
Sie werden in umfassenderen digitalen Audiopipelines eingesetzt, etwa in der Telekommunikation oder Sprachtranskription. Sie teilen anderen nachgelagerten Systemen wie ASR/STT, LLMs und Turn-Planern mit, ob sie den Audiostream aktiv abhören oder warten sollen.
VAD ist nicht dasselbe wie Automatic Speech Recognition (ASR). Ein VAD-System gibt lediglich eine probabilistische Ja/Nein-Antwort darauf aus, ob es Sprache erkennt. Es gibt keine tatsächlichen Wörter aus. Seine Hauptaufgabe ist es, nachgelagerten Systemen mitzuteilen, ob sie einen bestimmten Audio-Frame verarbeiten sollen.
Wie funktionieren Algorithmen zur Voice Activity Detection?
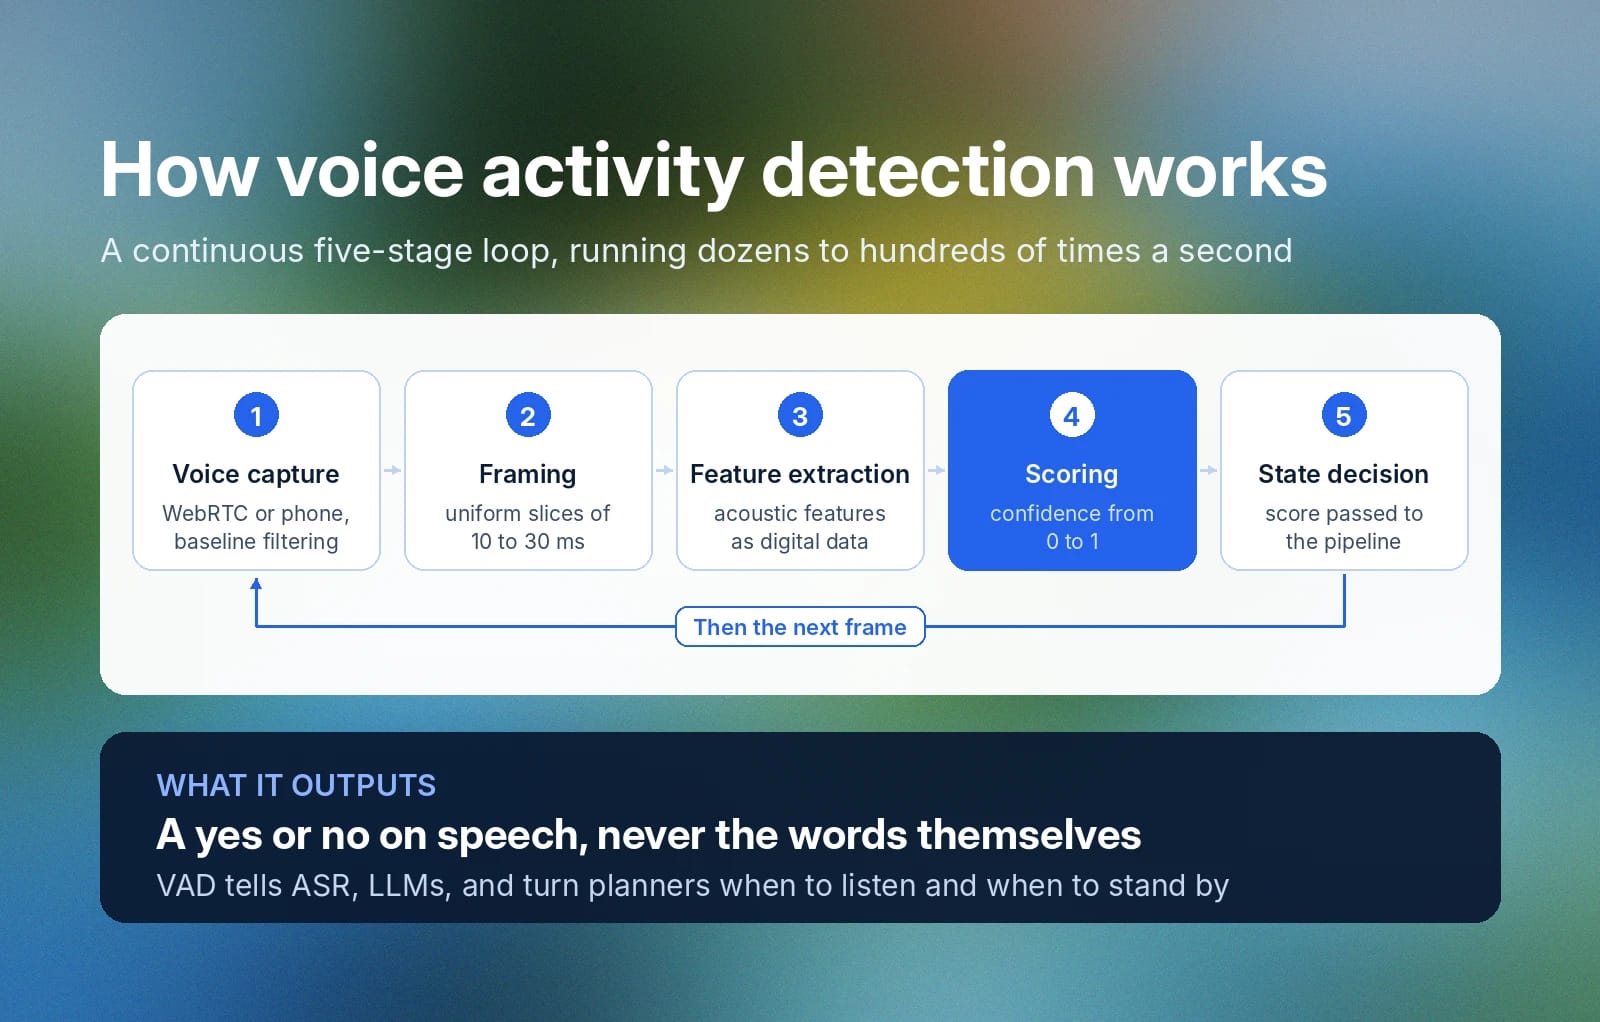
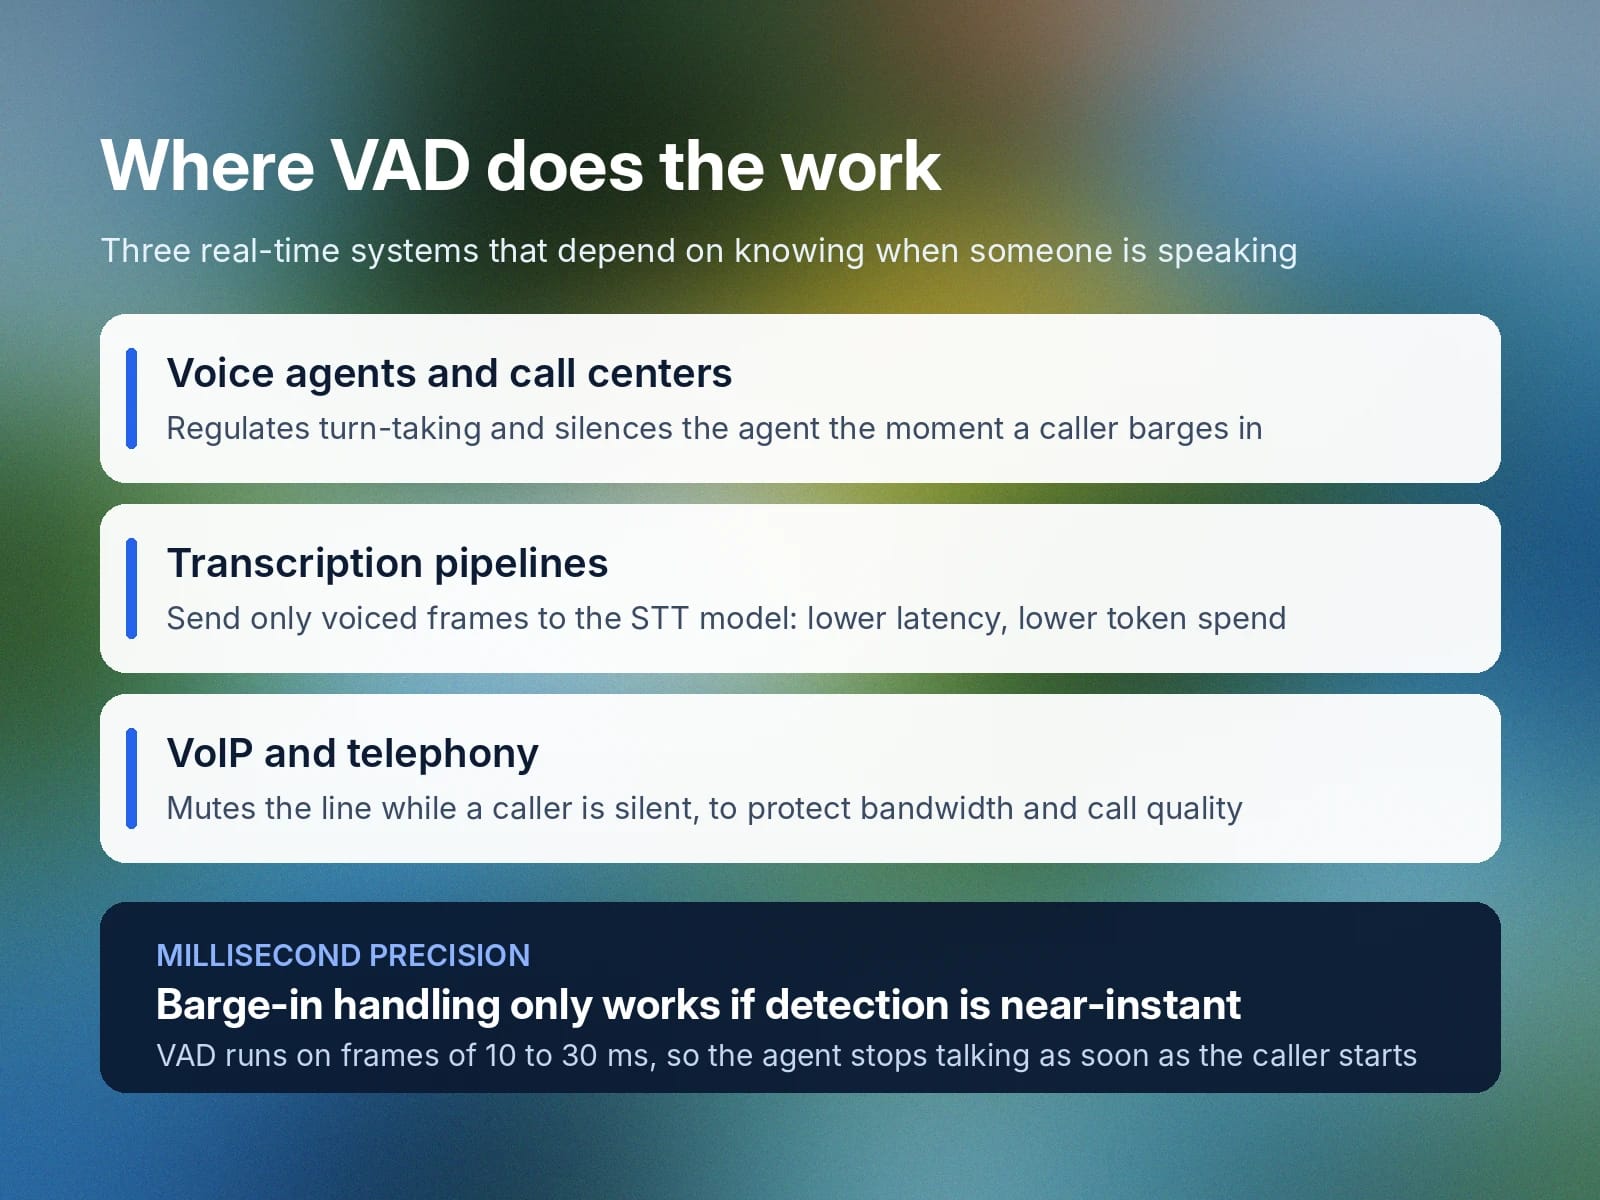
Ein VAD-Algorithmus verarbeitet einen Audiostream und trifft eine Ja/Nein-Entscheidung, ob ein bestimmter Audio-Frame, typischerweise 10–30 Millisekunden lang, Sprache enthält.
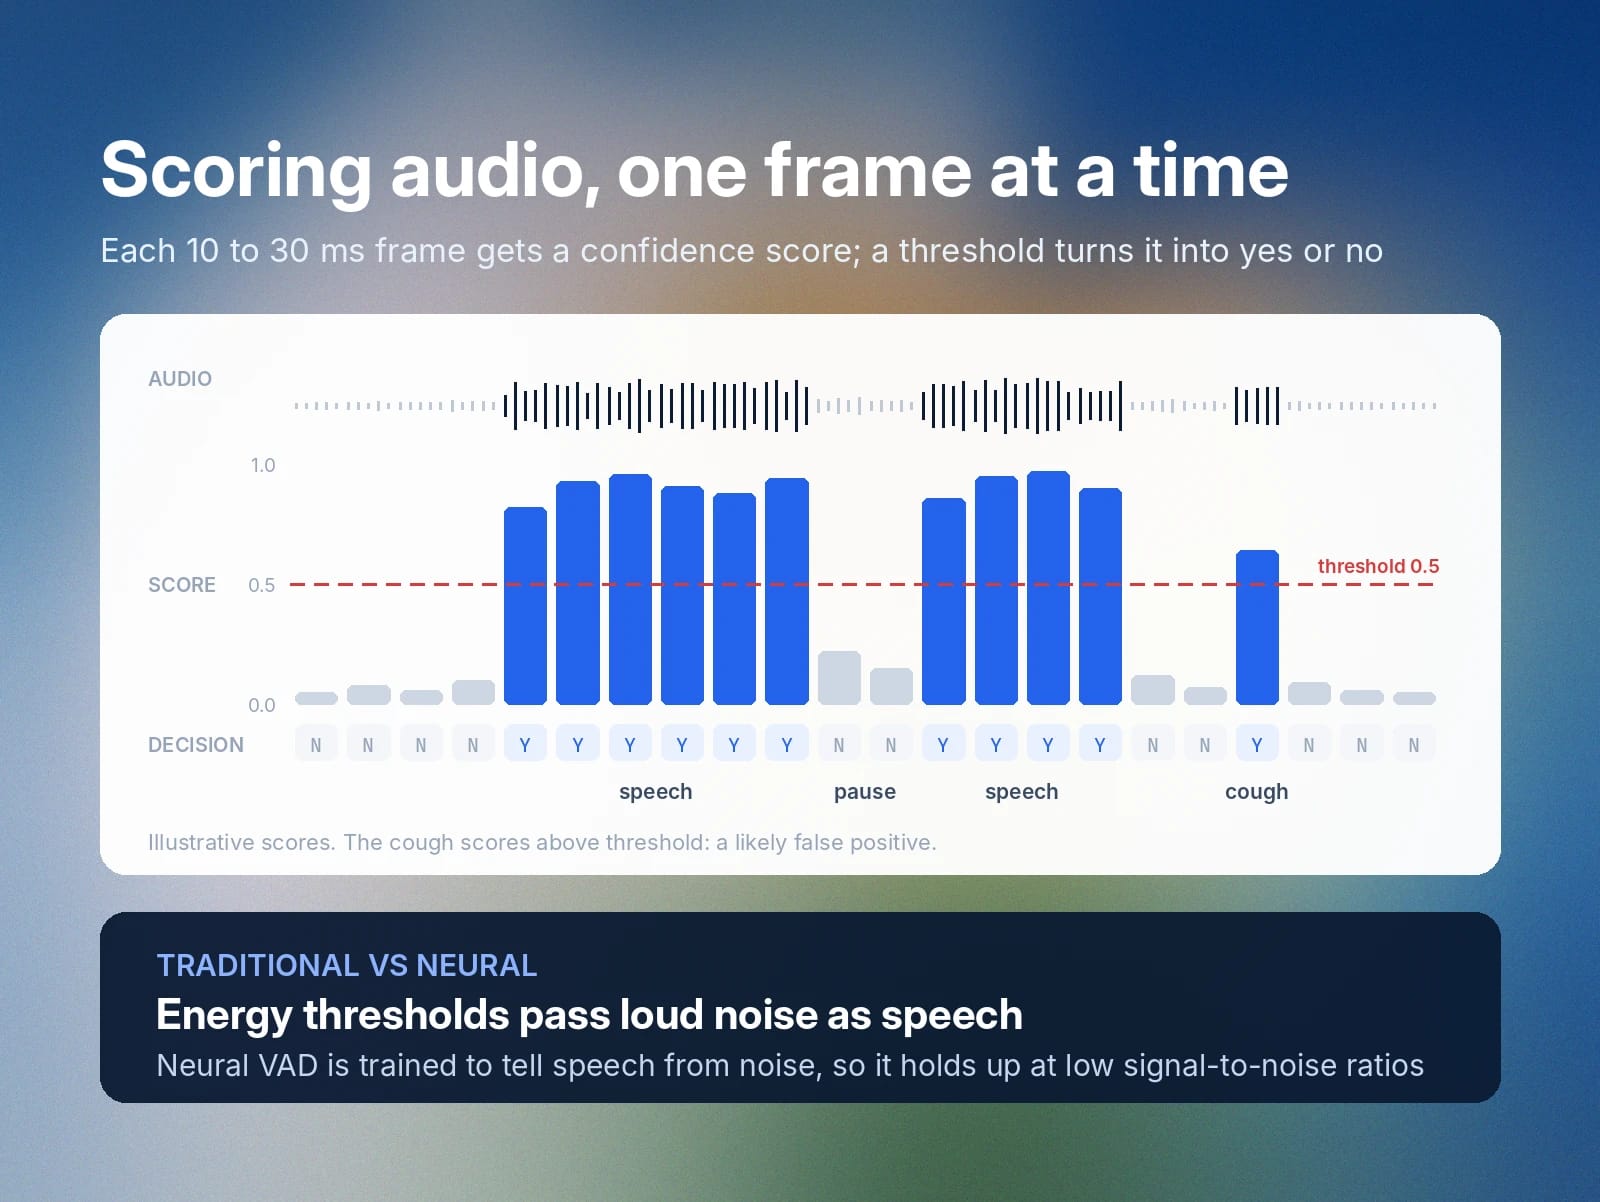
Sie arbeiten kontinuierlich in einer Schleife mit fünf Phasen:
- Audioerfassung: Das System, auf dem VAD läuft, empfängt einen Audiostream über WebRTC oder Telefonie und wendet eine grundlegende Rauschfilterung auf die Daten an.
- Framing: Der Algorithmus zerlegt den Roh-Audiostream in einheitliche Frames.
- Merkmalsextraktion: Der Algorithmus extrahiert akustische Merkmale aus dem Stream, die er mathematisch als digitale Daten darstellen kann.
- Bewertung: Das System verarbeitet die extrahierten Merkmale eines Frames mit dem eigentlichen VAD-Algorithmus und erzeugt einen Konfidenzwert zwischen 0 und 1 dafür, ob er Sprache enthält (0 = „keine Sprache“, 1 = „Sprache“).
- Zustandsentscheidung: Das VAD-System übergibt den Konfidenzwert an die Audiopipeline, in der es läuft, damit diese entscheiden kann, wie sie damit umgeht.
Traditionelle vs. KI-basierte Voice Activity Detection
VAD fällt in zwei große Kategorien: Signalverarbeitung und KI.
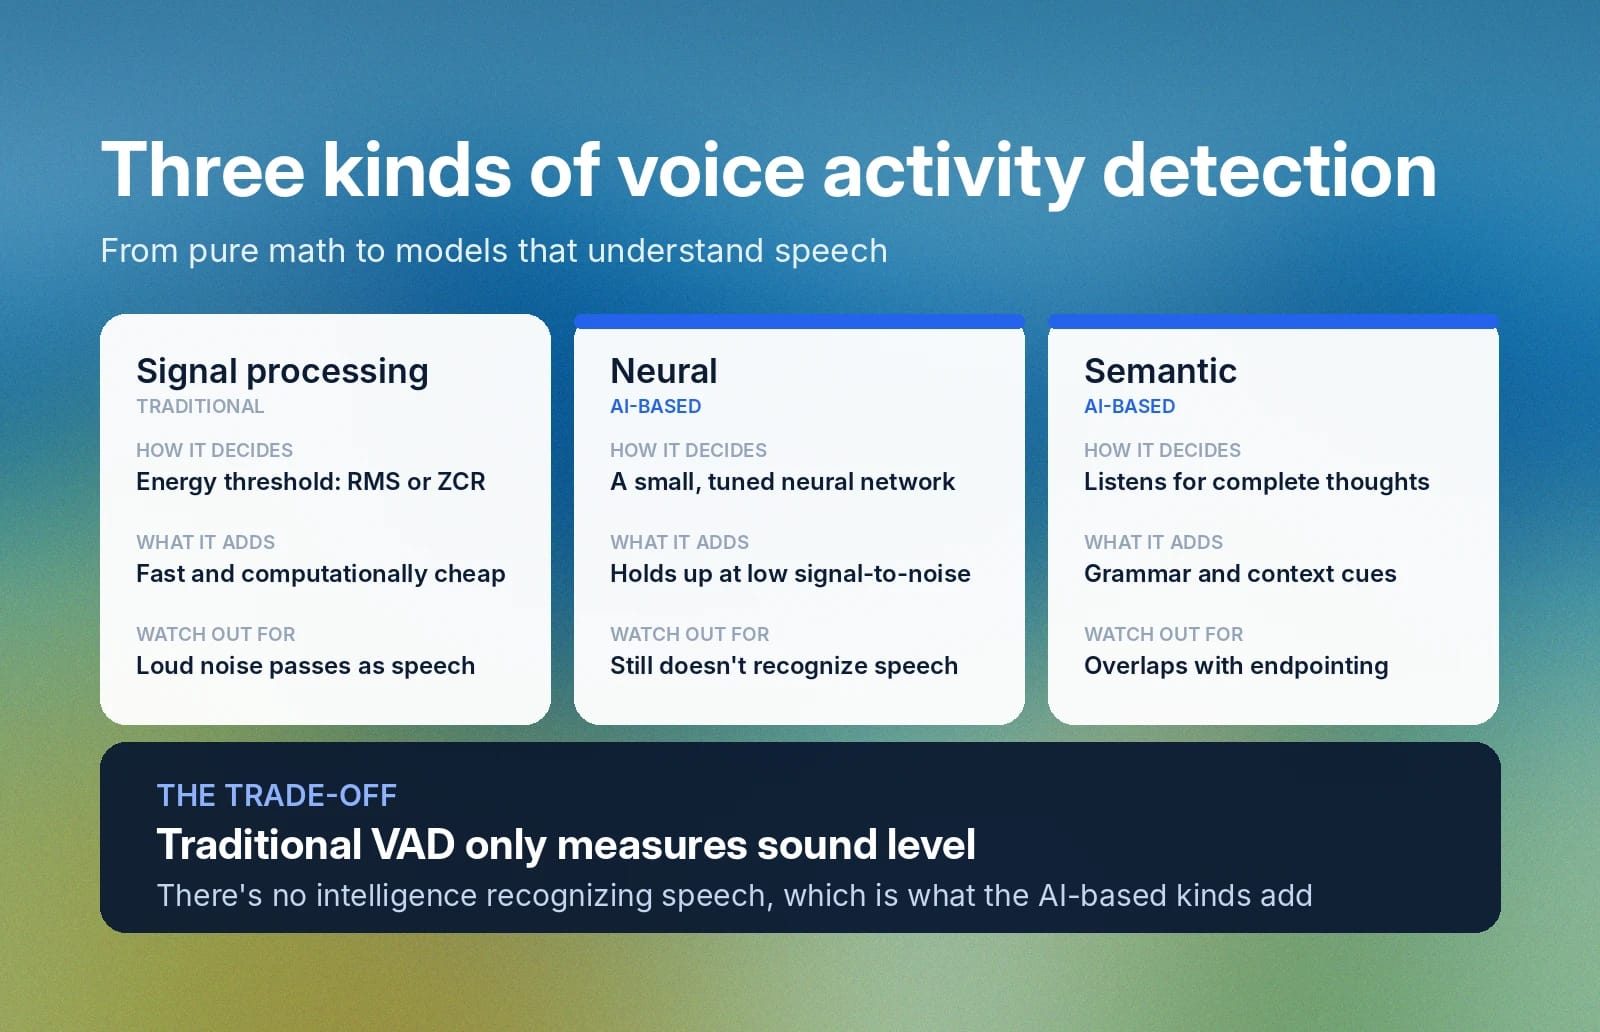
Innerhalb der KI-basierten VAD gibt es zwei unterschiedliche Ansätze. Insgesamt ergeben sich damit drei Arten der Voice Activity Detection.
Sehen wir uns diese genauer an.
Traditionelle VAD (Signalverarbeitung)
Traditionelle VAD-Technologie misst den Energiepegel eines Audiostreams und bestätigt Sprache, wenn dieser einen bestimmten Schwellenwert überschreitet. Sie ist rein mathematisch und basiert oft auf einer Root-Mean-Square- (RMS) oder Zero-Crossing-Rate-Berechnung (ZCR). Liegt ein Frame über dem Schwellenwert, wird er als Sprache weitergegeben. Liegt er darunter, nicht.
Traditionelle VAD ist schnell und rechenarm, misst aber nur den Schallpegel im Audio. Laute Hintergrundgeräusche können falsch positive Ergebnisse verursachen. Es gibt keine eigentliche Intelligenz, die Sprache erkennt.
KI-basierte VAD
Es gibt zwei neuere Arten KI-basierter VAD: neuronale und semantische. Statt eines rein mathematischen Schwellenwerts nutzt neuronale VAD ein kleines, hochoptimiertes neuronales Netz, um festzustellen, ob ein Audio-Frame Sprache oder Stille enthält. Durch ihr Training verstehen diese Systeme den Unterschied zwischen Sprache und Geräuschen. Daher arbeiten sie bei einem niedrigen Signal-Rausch-Verhältnis (SNR) in einem Audiostream, also bei starken Hintergrundgeräuschen, besser als traditionelle VAD.
Der Nachteil neuronaler VAD ist, dass sie Sprache selbst weiterhin nicht erkennen. Semantische KI-VAD kann das. Sie überschneidet sich mit Endpointing, da sie einen Audiofeed darauf prüft, ob gesprochene Gedanken vollständig sind. Sie kann grammatikalisch und kontextuell verstehen, ob weitere Sprache folgen könnte.
VAD vs. Endpointing
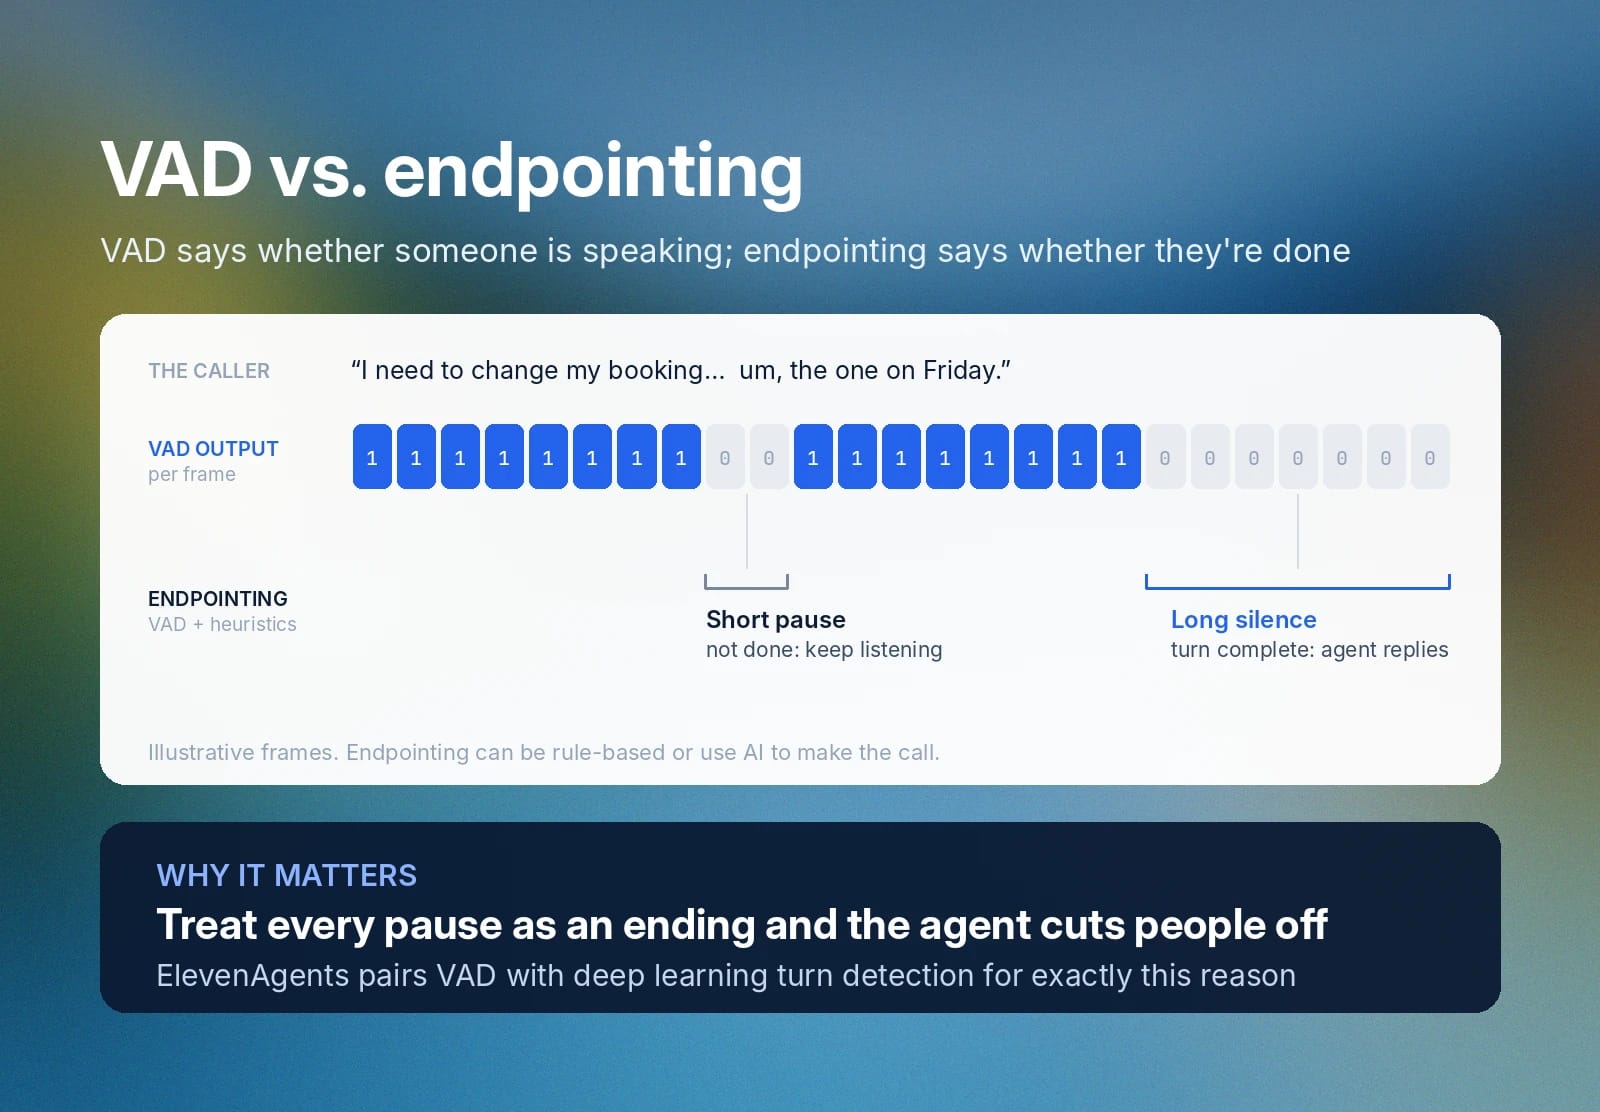
VAD und Endpointing sind ergänzende Technologien. Ein System zur Voice Activity Detection entscheidet lediglich, ob jemand in jedem verarbeiteten Audio-Frame spricht. Es trifft eine binäre Ja/Nein-Entscheidung und gibt sie an den Rest der Audioverarbeitungspipeline weiter.
Ein Endpointing-System nutzt VAD-Ausgaben in Verbindung mit heuristischer Analyse, um festzustellen, ob ein Sprecher seinen Gedanken abgeschlossen hat. Es kann dafür regelbasierte Signalverarbeitung oder KI nutzen.
Anwendungen der Voice Activity Detection in Echtzeit-KI
Voice Activity Detection ist für zahlreiche Anwendungsfälle wichtig.
Autonome Sprachagenten und Callcenter
Ein autonomer Agent zur Prüfung von Kundenanrufen muss wissen, wann eine Antwort angemessen ist. Der Agent soll einen Kunden nicht mitten im Satz unterbrechen oder weiter über ihn hinwegsprechen, wenn er früh antwortet. VAD hilft, Gesprächswechsel zu steuern und einen natürlichen Gesprächsfluss zu gewährleisten. Da sie bis auf Millisekundenebene arbeitet, verwaltet sie auch effektiv Kundeneinwürfe und schaltet den Agenten stumm, wenn der Kunde ihn unterbricht.
Transkriptionspipelines
Wenn Sie einen Speech to Text-Transkriptions-API-Dienst wie ElevenAPI verwenden, können Sie die gesendeten Audiodaten mit Voice Activity Detection filtern, sodass das Modell nur Frames mit Sprache verarbeitet. Das reduziert die Netzwerklatenz und, wichtiger noch, senkt Ihren Tokenverbrauch für das Transkriptionsmodell. Sie geben keine KI-Budgets für Hintergrundgeräusche aus.
VoIP- und Telefonieoptimierung
Latenz kann auch die Anrufqualität in Unternehmens-VoIP-Netzwerken beeinträchtigen. Um die Leistung zu optimieren, schalten diese digitalen Audiosysteme eine Leitung mithilfe von VAD vorübergehend stumm, wenn ein Anrufer nicht spricht.
Warum ist Voice Activity Detection anspruchsvoll?
Traditionelle Voice Activity Detection stützt sich auf mathematische Algorithmen, um zu entscheiden, ob Sprache vorhanden ist. Menschliche Sprachmuster sind jedoch unregelmäßig. Gespräche sind oft sprunghaft, unterbrochen und finden in realen Umgebungen mit Hintergrundgeräuschen und sogar Nebengesprächen statt. Die zentrale Herausforderung für VAD besteht darin, bedeutungsvolle Stille in verrauschtem Audio zu erkennen.
Das zeigt sich in einigen konkreten Herausforderungen.
Pausen mitten im Satz
Menschen sprechen nicht über ein ganzes Gespräch hinweg in gleichmäßigem Tempo. Sie machen Pausen, sammeln ihre Gedanken, überlegen während des Sprechens um und verlieren den Faden. Keine dieser Pausen bedeutet, dass ein Sprecher fertig gesprochen hat. Für menschliche Zuhörer ist das meist leicht zu verstehen, für Software jedoch schwierig – selbst für neuere KI-Modelle.
Wenn VAD-Systeme diese Pausen mit abgeschlossener Sprache verwechseln, kann es dazu kommen, dass Aussagen mitten im Satz abgeschnitten werden oder ein Sprachagent einen menschlichen Sprecher unterbricht.
Stimmgeräusche
Leise Sprache, abfallende Endkonsonanten – häufig am Satzende – und Merkmale wie Vocal Fry können dazu führen, dass VAD-Systeme tatsächliche Sprache übersehen.
Unvorhersehbare Akustik
Kontinuierliches weißes Hintergrundrauschen, etwa von einem Ventilator oder fließendem Wasser, können VAD-Systeme relativ einfach herausfiltern. Sporadische Geräusche wie ein bellender Hund könnten dagegen als Phantom-Sprache markiert werden.
Starke Audiokomprimierung verringert den Dynamikbereich und kann es VAD erschweren, zwischen stillen Frames und Sprach-Frames zu unterscheiden.
So bewerten Sie die VAD-Leistung
Menschliche Sprache ist unregelmäßig, besonders in dynamischen realen Umgebungen. Einwandfreie Audioaufnahmen eignen sich nicht gut zum Testen der VAD-Leistung. Auch reine Speech-to-Text-Genauigkeit misst die Wirksamkeit eines VAD-Systems nicht direkt, da sie nachgelagert zu dem liegt, was VAD erkennt.
Falsch positive vs. falsch negative Ergebnisse
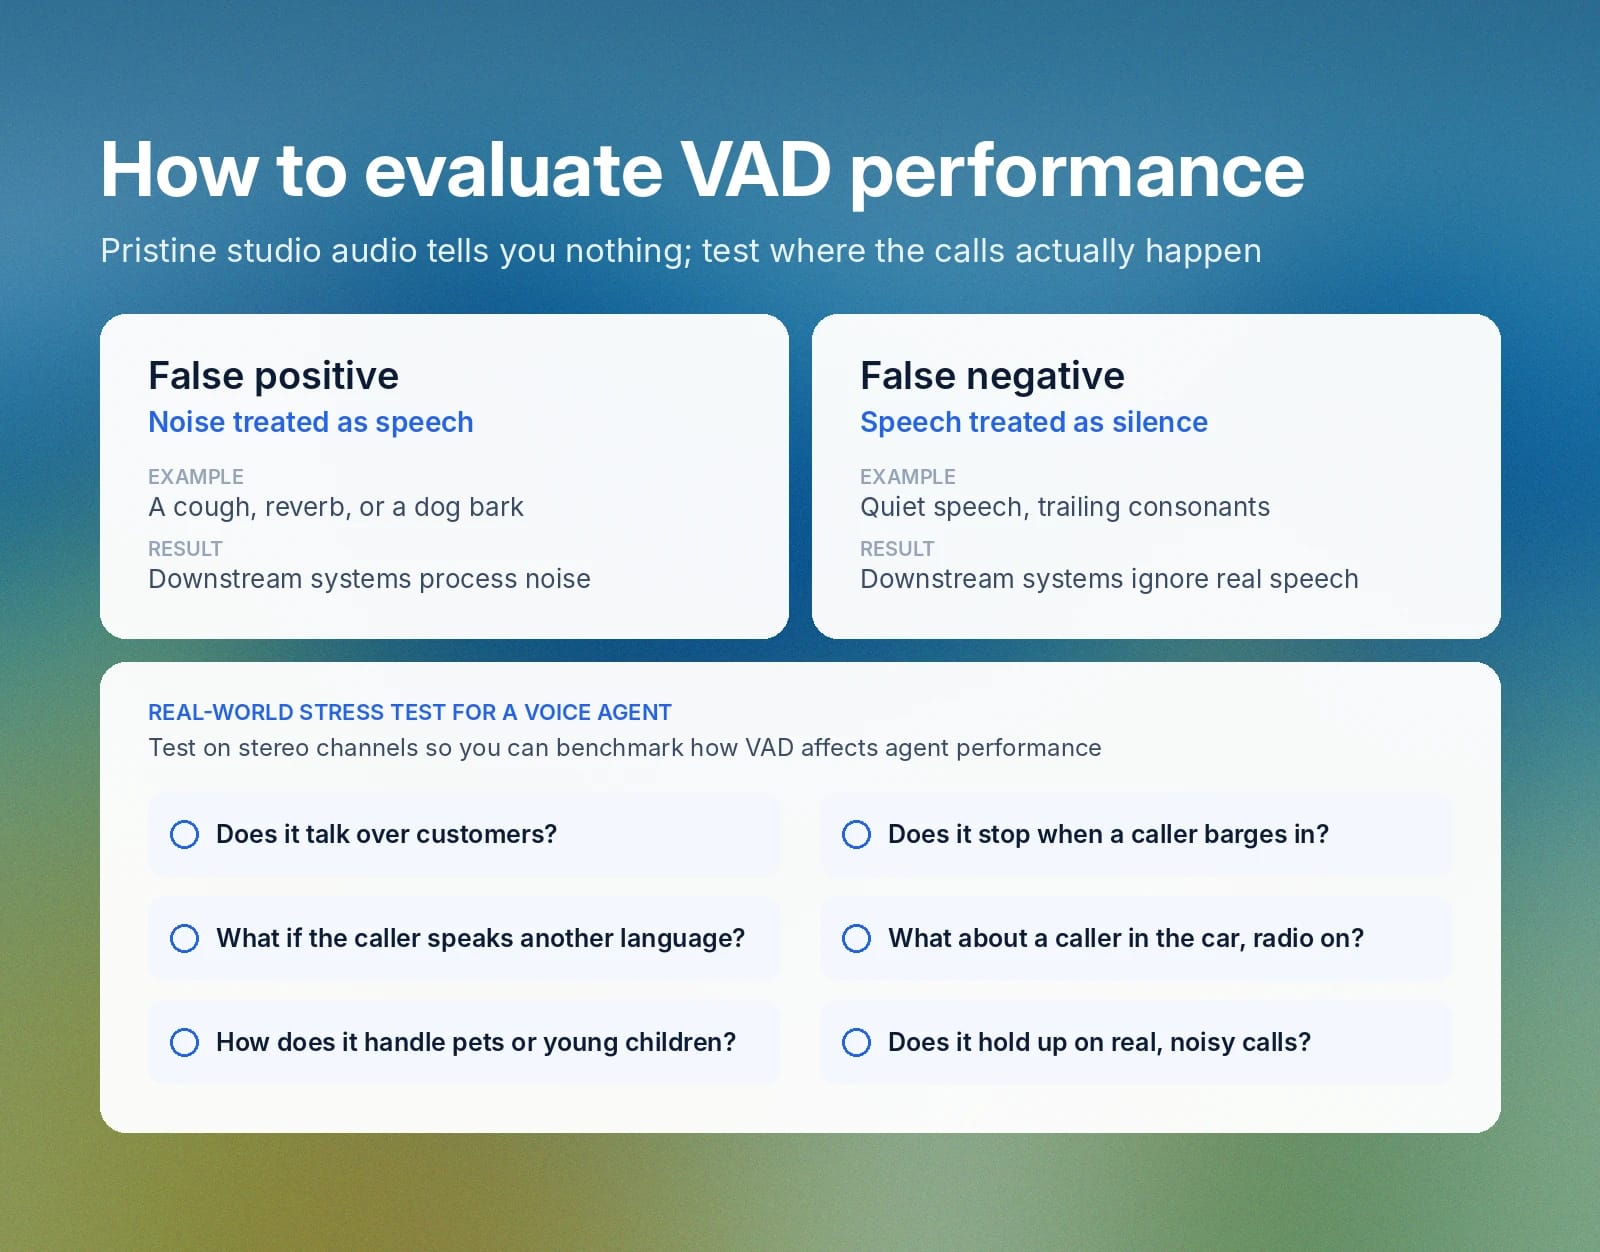
Bei falsch positiven VAD-Ergebnissen werden Geräusche als Sprache behandelt. Husten, Hall, Hundegebell und andere plötzliche Hintergrundgeräusche können ein solches Ergebnis auslösen und versehentlich als Sprach-Frames weitergegeben werden.
Falsch negative Ergebnisse sind Sprache, die als Stille behandelt wird. VAD weist nachgelagerte Dienste dann fälschlicherweise an, Audio-Frames zu ignorieren.
Stresstests unter realen Bedingungen
Um einen VAD-Dienst zu bewerten, müssen Sie sehen, wie er sich in den Umgebungen und unter den realen Bedingungen verhält, unter denen Audio aufgezeichnet wird.
Wenn Sie VAD beispielsweise für einen Sprachagenten einsetzen möchten, testen Sie mit Stereokanälen, um die Auswirkungen auf die Agentenleistung zu messen. Dabei könnten Fragen wie diese entstehen:
- Gibt es falsch negative Ergebnisse, durch die der Agent über Kunden hinweg spricht?
- Hält es den Agenten vom Sprechen ab, wenn ein Nutzer ihn unterbricht?
- Was passiert, wenn der Anrufer eine Fremdsprache spricht?
- Wie funktioniert es bei Sprechern, die aus realen Umgebungen anrufen?
- Was passiert, wenn ein Kunde aus dem Auto anruft, aber sein Radio nicht leiser stellt?
- Wie gut funktioniert es bei Hintergrundgeräuschen von Haustieren oder kleinen Kindern?
All diese Bedingungen treten bei Kundengesprächen wahrscheinlich auf. VAD muss sie bewältigen und unter Belastung zuverlässig funktionieren.
Starten Sie mit ElevenAgents für den Kundenservice
ElevenAgents nutzt ein hybrides System aus VAD und Deep-Learning-basierter Turn-Erkennung, damit agentische Gespräche flüssig und natürlich bleiben.
Beginnen Sie noch heute mit dem Aufbau eines neuen Kundenservice-Agenten mit ElevenAgents. Registrieren Sie sich, um zu starten.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.



