
Probleme mit der Speech-to-Text-Genauigkeit mit einem intelligenteren Workflow beheben
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Die Genauigkeit von Speech to Text (STT) hängt von drei Faktoren ab: der Qualität Ihres Audios, der Sprechweise und den verwendeten Wörtern. Rauschen und starke Komprimierung nehmen einer Aufnahme Details. Selbst leistungsstarke Modelle haben dann Schwierigkeiten mit überlappenden Stimmen oder unbekanntem Fachjargon. Dieser Leitfaden zeigt, wo die einzelnen STT-Probleme entstehen und wie Sie sie beheben.
Transkriptionsfehler bleiben selten im Transkript. Ein falsch verstandener Medikamentenname in einer klinischen Notiz oder eine falsche Kontonummer in einem Anrufprotokoll gelangt in jedes System, das diesen Text nutzt – von Suche und Analysen bis zu KI-Agenten, die auf Grundlage des Gesagten handeln. Geringe Genauigkeit erhöht auch den Prüfaufwand, weil jemand die Fehler manuell finden und korrigieren muss.
Die gute Nachricht: Die meisten Probleme mit der STT-Genauigkeit lassen sich beheben. Viele Lösungen erfordern nur kleine Änderungen an Ihren bestehenden Konfigurationen oder Aufnahme-Setups. So können Sie das Problem lösen, ohne Ihre Modelleinstellungen ändern zu müssen.
Dieses Thema wird auch als Genauigkeit der Spracherkennung, ASR-Genauigkeit oder Transkriptionsgenauigkeit bezeichnet. Speech to Text, Spracherkennung und automatische Spracherkennung (ASR) beschreiben alle denselben Prozess: gesprochene Audiodaten in geschriebenen Text umzuwandeln. Die Lösungen in diesem Leitfaden gelten unabhängig vom verwendeten Begriff.
Zusammenfassung
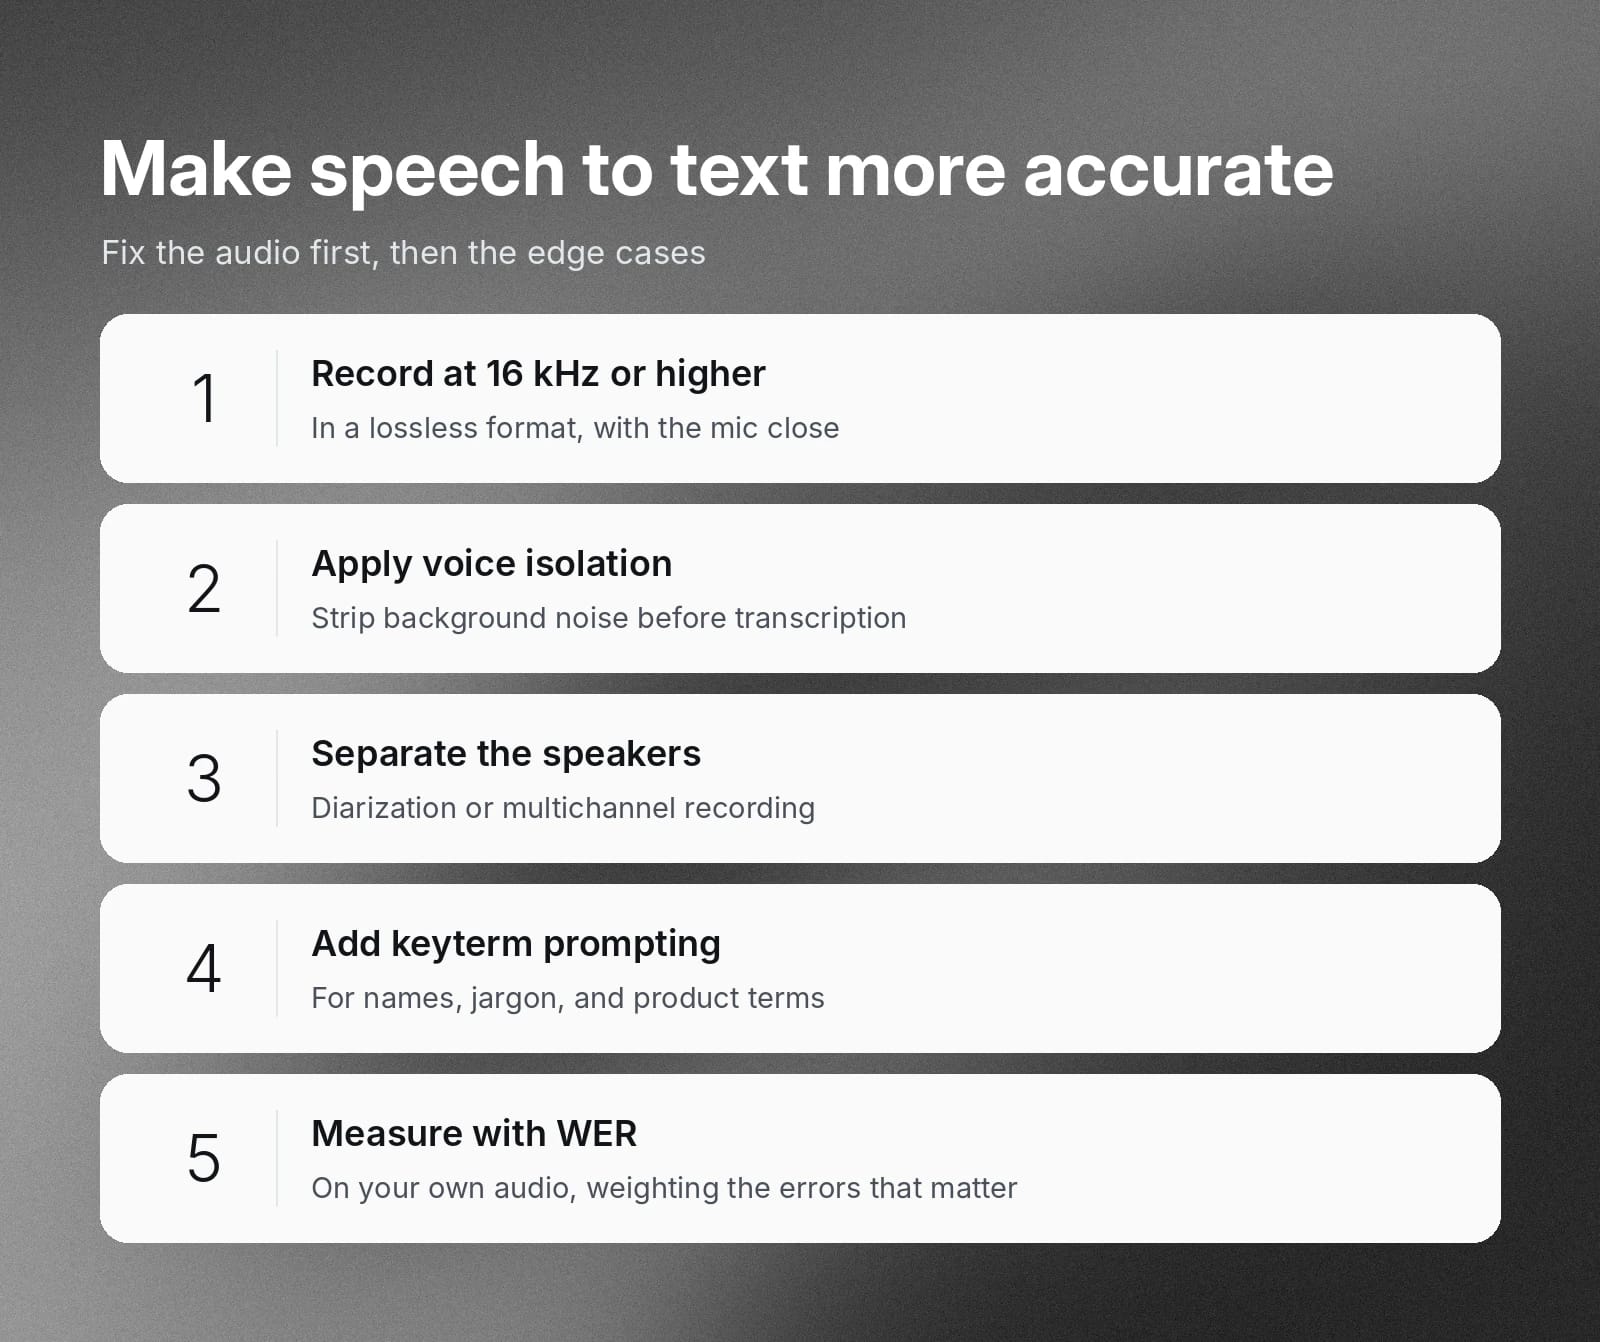
- Die Speech-to-Text-Genauigkeit hängt von der Qualität der Audioeingabe, der Sprecherdynamik sowie lexikalischen und kontextuellen Faktoren ab.
- Um ein Genauigkeitsproblem zu beheben, ermitteln Sie, an welcher Stelle der Pipeline – Eingabe, Verarbeitung oder Ausgabe – Sie etwas ändern können.
- Nehmen Sie mit 16 kHz oder höher auf, verwenden Sie verlustfreie Formate und platzieren Sie Mikrofone vier bis sechs Zoll vom Sprecher entfernt.
- Nutzen Sie Stimmenisolator, Sprecherdiarisierung oder Mehrkanalaufnahmen sowie Keyterm Prompting für Rauschen, überlappende Sprecher und Fachvokabular.
- Messen Sie die Genauigkeit mit der Word Error Rate (WER) und prüfen Sie, welche Fehler für Ihren Anwendungsfall am wichtigsten sind.
Was verursacht Probleme mit der Speech-to-Text-Genauigkeit?
Stellen Sie sich vor, Sie sollen eine Audioaufnahme eines Professors mit starkem Akzent transkribieren, der komplexe theoretische Physik beschreibt. Die Aufnahme entstand in einem vollen Restaurant mit Hintergrundmusik und Umgebungsgeräuschen. Digitale Computersysteme sind nicht von Natur aus auf akustische Variabilität abgestimmt. Es braucht umfangreiches Training und Finetuning, damit STT effektiv funktioniert. Moderne KI-Tools sind zwar sehr leistungsfähig, dennoch können viele Faktoren die Ausgabe beeinträchtigen. Wenn Sie diese verstehen, können Sie sie in Ihren Transkriptions-Workflows angehen.
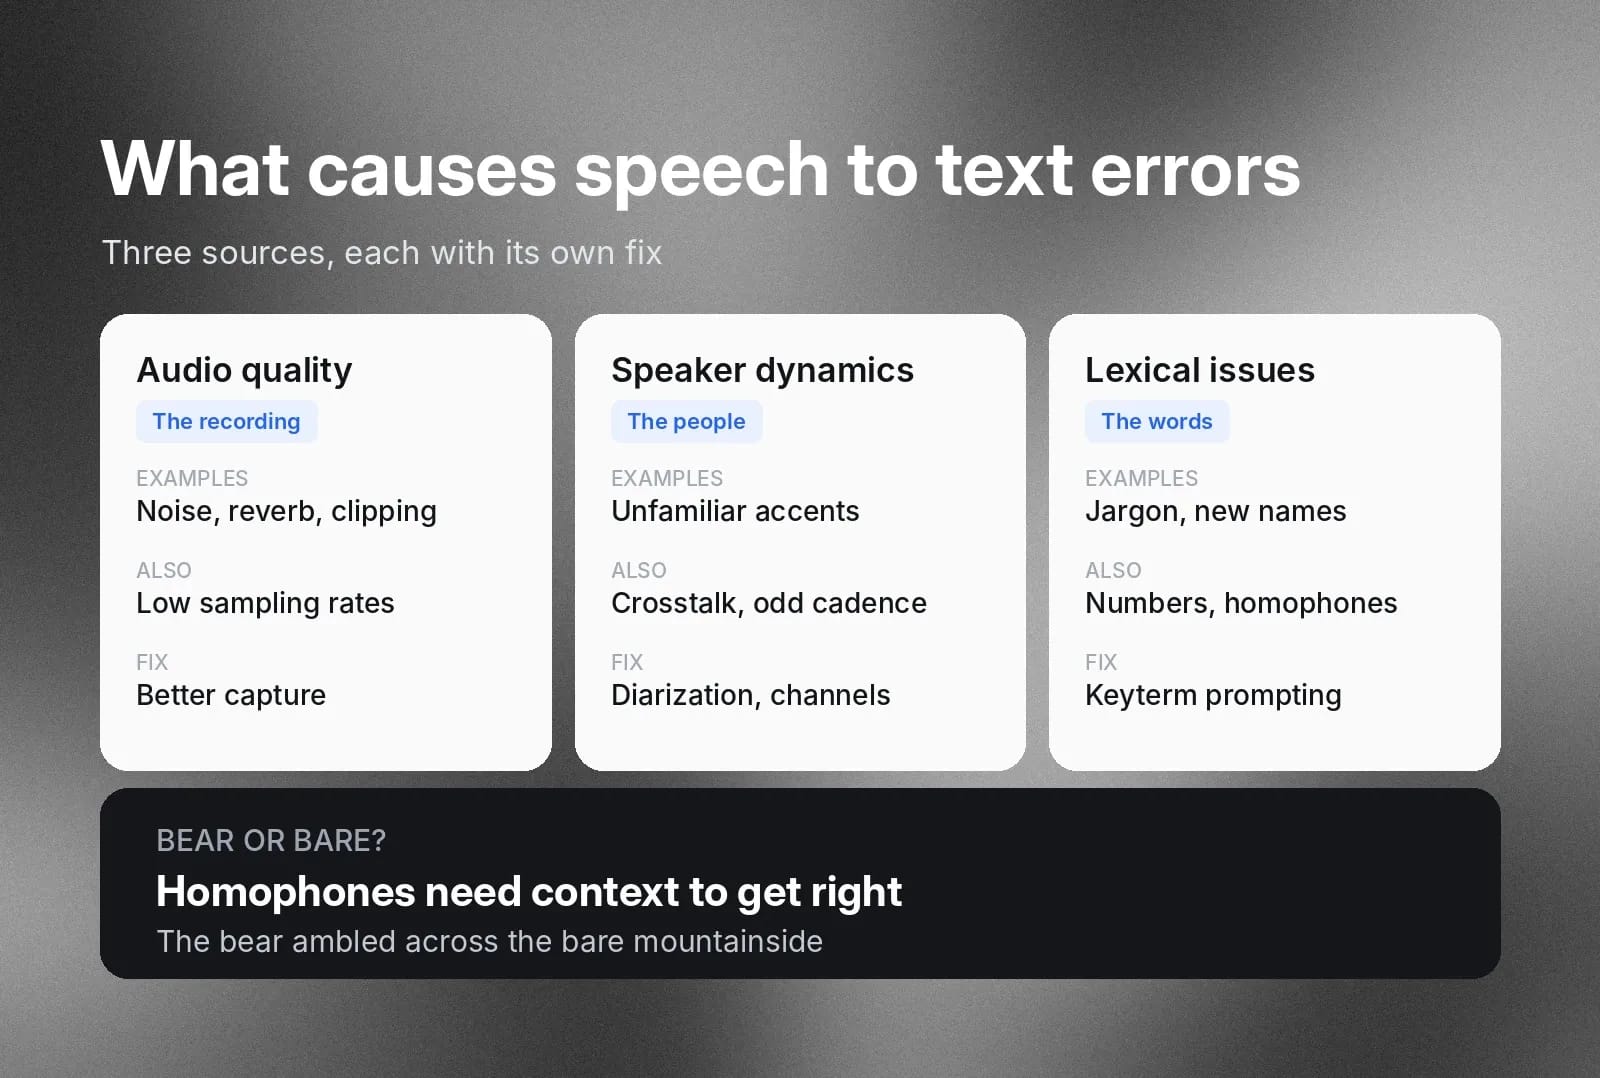
Es gibt drei Hauptursachen für ungenaue Speech-to-Text-Umwandlung:
- Probleme mit der Qualität der Audioeingabe
- Sprecherdynamik
- Lexikalische und kontextuelle Probleme
Jede Ursache erfordert eine andere Lösung, die in den folgenden Abschnitten behandelt wird.
Probleme mit der Audioqualität
Zunächst kann die Audioaufnahme selbst Probleme aufweisen. Probleme mit dem Mikrofon können zu verzerrter oder abgeschnittener Sprache führen. Hall durch die Raumakustik, ein schlechtes Signal-Rausch-Verhältnis (SNR) oder eine niedrige Abtastrate können wichtige phonetische Informationen aus Aufnahmen entfernen.
Sprecherdynamik
Ein einzelner Sprecher mit neutralem Akzent in einer ruhigen Umgebung ist relativ einfach zu transkribieren. Doch das ist selten die Art von Aufnahme, die wir transkribieren möchten. Unbekannte Akzente sowie abgehackter oder ungewöhnlicher Sprachrhythmus können ein auf standardisierte Sprache trainiertes STT-Modell aus dem Tritt bringen. Übersprechen oder überlappende Sprecher können zudem die Fähigkeit des Modells beeinträchtigen, Gesagtes korrekt zu erfassen.
Lexikalische und kontextuelle Probleme
Auch der Sprachinhalt kann manche STT-Modelle herausfordern. Fachjargon und neue Produktnamen sind möglicherweise Begriffe, denen ein STT-Modell im Training nicht begegnet ist. Da es die statistisch wahrscheinlichste Ausgabe auswählt, ist unbekannte Sprache möglicherweise keine vorrangige Vorhersage. Auch numerische oder mathematische Ausdrücke sowie Gesprochenes, das üblicherweise als Zahl geschrieben würde, werden möglicherweise nicht eindeutig transkribiert.
Homophone sind Wörter, die gleich klingen, aber unterschiedlich geschrieben werden. Ein STT-Modell braucht ausreichend Kontextverständnis, um zwischen ihnen zu unterscheiden. Zum Beispiel: „Der Bär wanderte über den kahlen Berghang.“ Das Modell muss wissen, dass das Tier „Bär“ heißt und die Bezeichnung für eine unbedeckte Oberfläche „kahl“ lautet.
Probleme mit der Speech-to-Text-Genauigkeit von Audio bis Ausgabe beheben
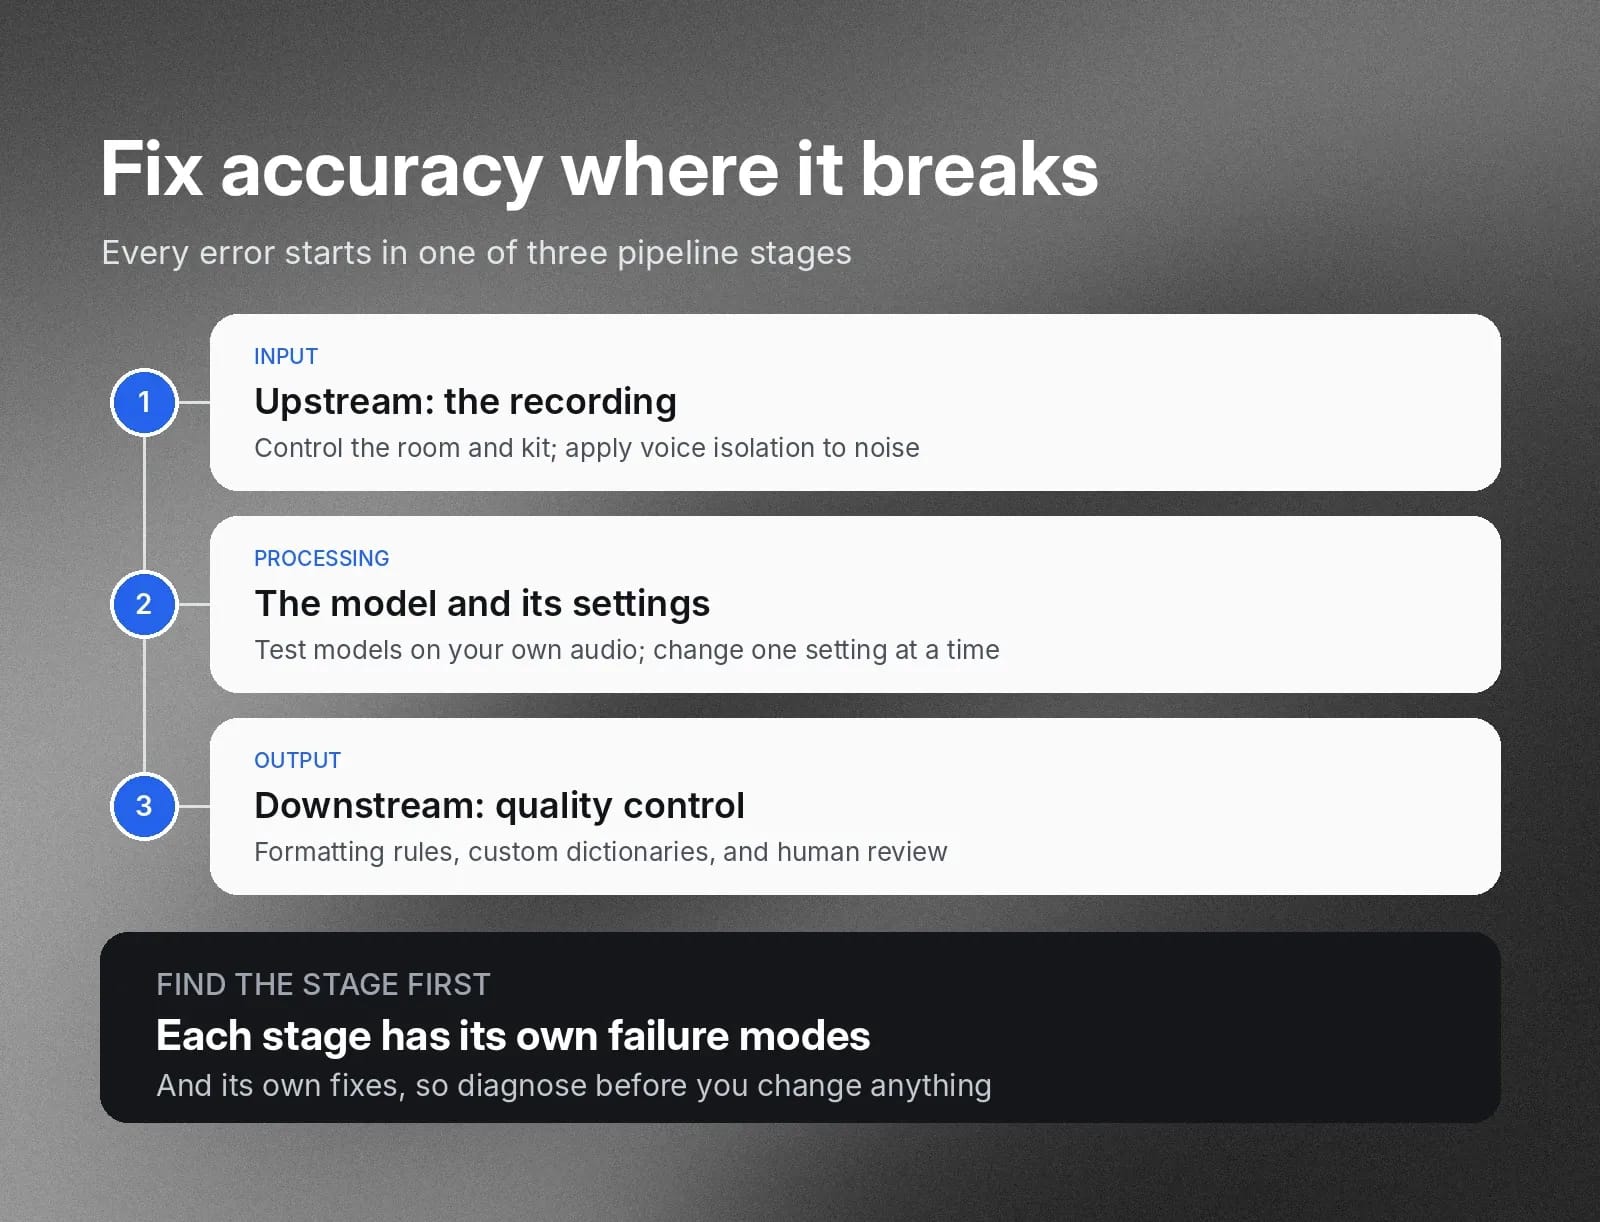
Speech-to-Text-Verarbeitung erfolgt in einer Reihe klar definierter Schritte. Um ein Genauigkeitsproblem zu beheben, müssen Sie erkennen, wo in dieser Pipeline Sie etwas ändern können. Grundsätzlich gliedert sich der STT-Prozess in:
- Eingabe
- Verarbeitung
- Ausgabe
Jede Phase hat eigene Fehlerquellen und eigene Lösungen.
Probleme mit der Genauigkeit bei der Eingabe
Möglicherweise gibt es Probleme mit der Aufnahmeumgebung. Häufige Ursachen sind Hintergrundgeräusche oder Echos. Auch defekte Aufnahmegeräte können Probleme verursachen.
Probleme in dieser Phase beheben Sie meist, indem Sie ihre Ursache isolieren und beseitigen. Wenn Sie etwa wissen, dass das STT-Tool Schwierigkeiten mit lauten Hintergrundgeräuschen hat, sollten Sie Gespräche in einer Umgebung führen, die Sie besser kontrollieren können.
Wenden Sie bei unvermeidbarem Rauschen Stimmenisolierung an, bevor das Audio das Modell erreicht.
Genauigkeitsprobleme bei der Verarbeitung
Die Konfiguration Ihrer API für eine STT-Engine kann die Verarbeitung beeinflussen. Auch die Prompt-Struktur und das gewählte Modell wirken sich auf Qualität und Anzahl der Fehler aus.
Probleme in dieser Phase beheben Sie, indem Sie Ihr Setup mit eigenen Audiodaten testen. Lassen Sie dieselben Beispielaufnahmen durch jedes in Frage kommende Modell laufen, vergleichen Sie deren Word Error Rates und ändern Sie anschließend jeweils nur eine Einstellung zur Optimierung.
Wenn ein Modell eine bestimmte Art von Sprache immer wieder falsch erfasst, etwa einen verrauschten Anruf oder einen bestimmten regionalen Akzent, testen Sie verschiedene Modelle im exakten Umfeld, in dem Sie sie einsetzen werden.
Genauigkeitsprobleme bei der Ausgabe
Dies ist Ihre Ebene der Qualitätskontrolle. Hier bereinigen spezialisierte Prozesse Transkriptionsfehler und Mehrdeutigkeiten, die Ihre primäre Engine möglicherweise übersehen hat. STT-Pipelines nutzen regelmäßig regelbasierten Musterabgleich, um Formatierungen zu standardisieren, etwa indem sie „zehn Dollar“ in „$10.00“ ändern. Dieser Prozess heißt inverse Textnormalisierung (ITN). Verwendet ein Sprecher einen solchen Begriff jedoch unüblich oder spricht ihn falsch aus, erkennt ein starres Suchen-und-Ersetzen-Tool dies nicht.
Auch die Frage, ob ein Mensch im Regelkreis (HITL) die Qualität der Ausgabe prüft, ist relevant. Wenn nicht, können Ungenauigkeiten in die Produktionsausgabe gelangen. Wie bei jeder Tätigkeit besteht die Möglichkeit menschlicher Fehler, wenn ein Mensch sie ausführt.
In dieser Phase bedeutet Fehlerbehebung, die Fehler aufzufangen, die Ihre primären Engines hinterlassen. Vergleichen Sie Transkripte mit einer Referenzprobe, um wiederkehrende Fehler zu finden. Ergänzen Sie dann gezielte Regeln oder ein benutzerdefiniertes Wörterbuch für diese Begriffe. Fügen Sie insbesondere bei Transkriptionen mit hohem Risiko immer einen menschlichen Prüfschritt hinzu.
So verbessern Sie die Genauigkeit der Spracherkennung mit besserem Audio
Eine bessere Audioqualität bei der Aufnahme kann viele nachgelagerte Genauigkeitsprobleme verringern. Nutzen Sie eine höhere Abtastrate, wenig oder keine Komprimierung und eine möglichst klare Aufnahmeumgebung.
Abtastqualität
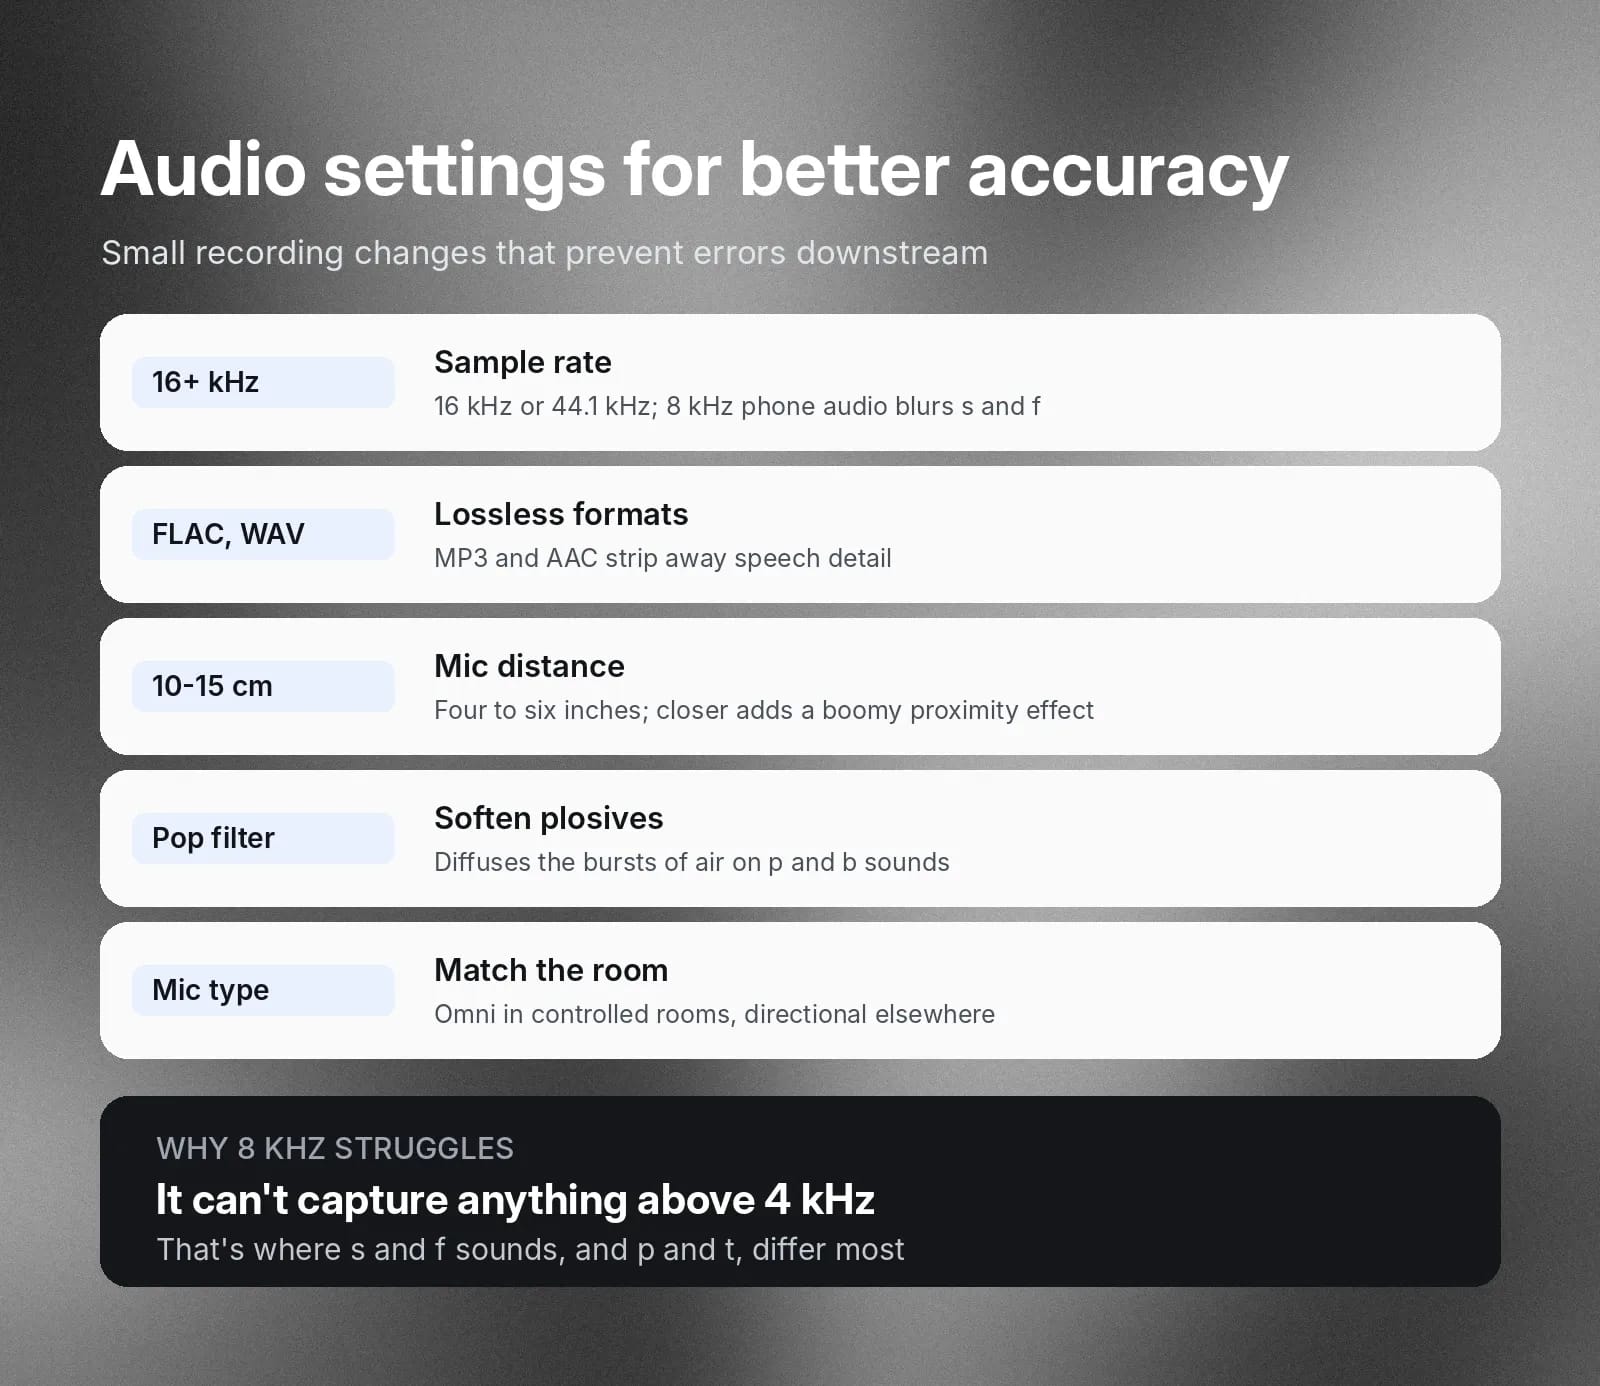
Verwenden Sie für Aufnahmen Audio mit 16 kHz oder 44,1 kHz. Die Abtastung von älterem Telefon-Audio mit 8 kHz oder weniger kann für STT-Modelle schwer zu verarbeiten sein. Für die Modelle klingt es gedämpft und undeutlich, und sie können Sprecher nicht wie Menschen in einem Gespräch um Wiederholung bitten.
Eine Abtastrate kann nur Frequenzen bis zur Hälfte ihrer Abtastrate wiedergeben. Dies wird Nyquist-Frequenz des Systems genannt. Bei nur 8 kHz würden alle Frequenzen über 4 kHz abgeschnitten. Insbesondere fällt es einem STT-Modell dann schwer, zwischen Frikativen („s“- und „f“-Lauten) und Plosiven („p“- und „t“-Lauten) zu unterscheiden.
Komprimierung
Auch Aufnahmen in verlustbehafteten Formaten wie MP3 und AAC können feine Sprachdetails entfernen. Dem Modell steht dann weniger Signal zur Verfügung. Verwenden Sie verlustfreie oder unkomprimierte Formate wie FLAC oder PCM WAV.
Aufnahmeumgebung
Befolgen Sie bei der Mikrofonverwendung bewährte Verfahren der Audiotechnik. Kugelmikrofone funktionieren am besten in kontrollierten Umgebungen. Andernfalls eignen sich Richtmikrofone besser, um Sprache zu isolieren. Platzieren Sie Mikrofone vier bis sechs Zoll (10–15 cm) vom Mund des Sprechers entfernt. Verhindern Sie, dass Sprecher näher heranrücken, da dies einen Nahbesprechungseffekt erzeugt und die Aufnahme durch verstärkte tiefe Frequenzen verfälscht.
Verwenden Sie außerdem nach Möglichkeit einen Popfilter am Mikrofon. Popfilter dämpfen Luftstöße, die beim Sprechen von Plosivlauten entstehen, etwa bei „p“ und „b“.
Hintergrundgeräusche für bessere Spracherkennung reduzieren
Wie im vorherigen Abschnitt erwähnt, sollten Sie nach Möglichkeit mit Nahmikrofonierung aufnehmen, idealerweise vier bis sechs Zoll vom Mund eines Sprechers entfernt. Vermeiden Sie weißes Rauschen und Hintergrundgeräusche, die Aufnahmen trüben. Häufige Quellen, die ohne Erfahrung mit Außenaufnahmen leicht unbemerkt bleiben, sind das Brummen von HLK-Anlagen, Tastaturklicken und allgemeiner Straßenlärm. All dies kann die Fähigkeit eines STT-Modells beeinträchtigen, Sprache zu erfassen.
Hintergrundgeräusche lassen sich jedoch oft nicht vermeiden. Wenden Sie in diesem Fall Stimmenisolierung als Vorverarbeitung an, bevor Sie Ihr Audio an ein STT-Modell senden. Stimmenisolierung nutzt Softwarealgorithmen oder ein leichtgewichtiges, spezialisiertes neuronales Modell, um Hintergrundgeräusche aus Sprachaufnahmen zu filtern.
Akzente, überlappende Sprecher und Fachvokabular verarbeiten
Moderne mehrsprachige Modelle werden mit vielfältigen Sprachdaten trainiert. Ihre Genauigkeit variiert jedoch weiterhin bei realem Audio. Führen Sie eigene Benchmarks für verschiedene Modelle mit Beispielaudio aus Ihren relevanten Zielgruppen durch. Falls Sie historische Serviceanrufe nutzen können, lassen Sie diese durch Transkription laufen – insbesondere Anrufe mit den Akzenten, Sprachrhythmen und Sprechmustern, die Sie in der Praxis transkribieren möchten.
Prüfen Sie die Ausgaben auf Fehler und erkennen Sie relevante Muster. Hat das Modell Schwierigkeiten mit Slang jüngerer Altersgruppen? Stolpert es über einen bestimmten regionalen Akzent, der Ihnen häufig begegnet?
Überlappende Sprecher behandeln
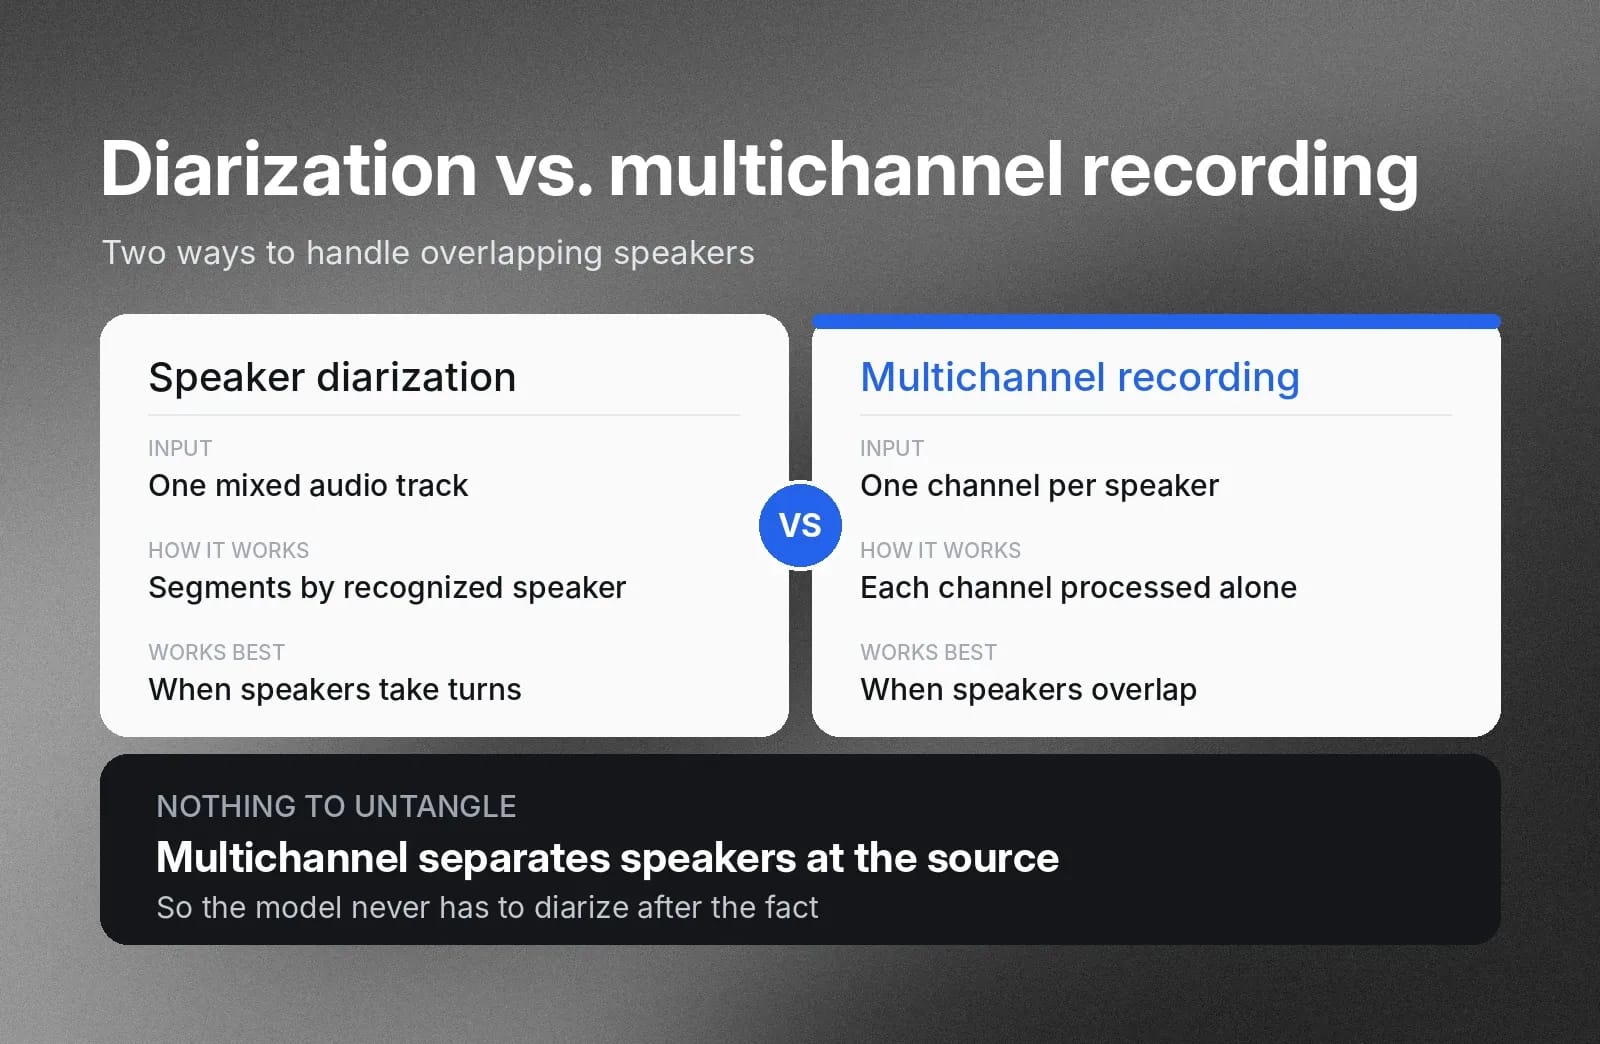
Ihre beiden wichtigsten Werkzeuge für die genaue Transkription überlappender Sprache sind Sprecherdiarisierung und Mehrkanalaufnahme. Bei der Sprecherdiarisierung wird eine Roh-Audioeingabe nach einzelnen erkannten Sprechern segmentiert. Sie funktioniert gut, wenn Sprecher klar abgegrenzte Redeanteile haben.
Statt alle Sprachspuren zu einer Audiospur zu mischen, können Sie bei nativen Mehrkanalaufnahmen jeden Sprecher auf einem separaten Kanal speichern. Das STT-Modell kann diese unabhängig erkennen und verarbeiten. Jeder Sprecher ist bereits in der Aufnahme separat angelegt, sodass ein Sprachmodell nichts nachträglich diarisiert muss.
Keyterm Prompting erzeugt einen positiven Bias
Markennamen, neue Produktnamen, Fachjargon und andere einzigartige Begriffe werden oft nicht korrekt transkribiert, wenn sie nicht in den Trainingsdaten eines STT-Modells enthalten waren. Keyterm Prompting bedeutet, einem STT-Modell bestimmte Schreibweisen bereitzustellen, die es bevorzugen soll. Dabei handelt es sich meist nicht um Eins-zu-eins-Ersetzungs-Prompts. Sie lenken das Modell anhand des Kontexts lediglich in Richtung der gewünschten benutzerdefinierten Schreibweise.
Zahlen, IDs und Medikamentennamen korrekt transkribieren
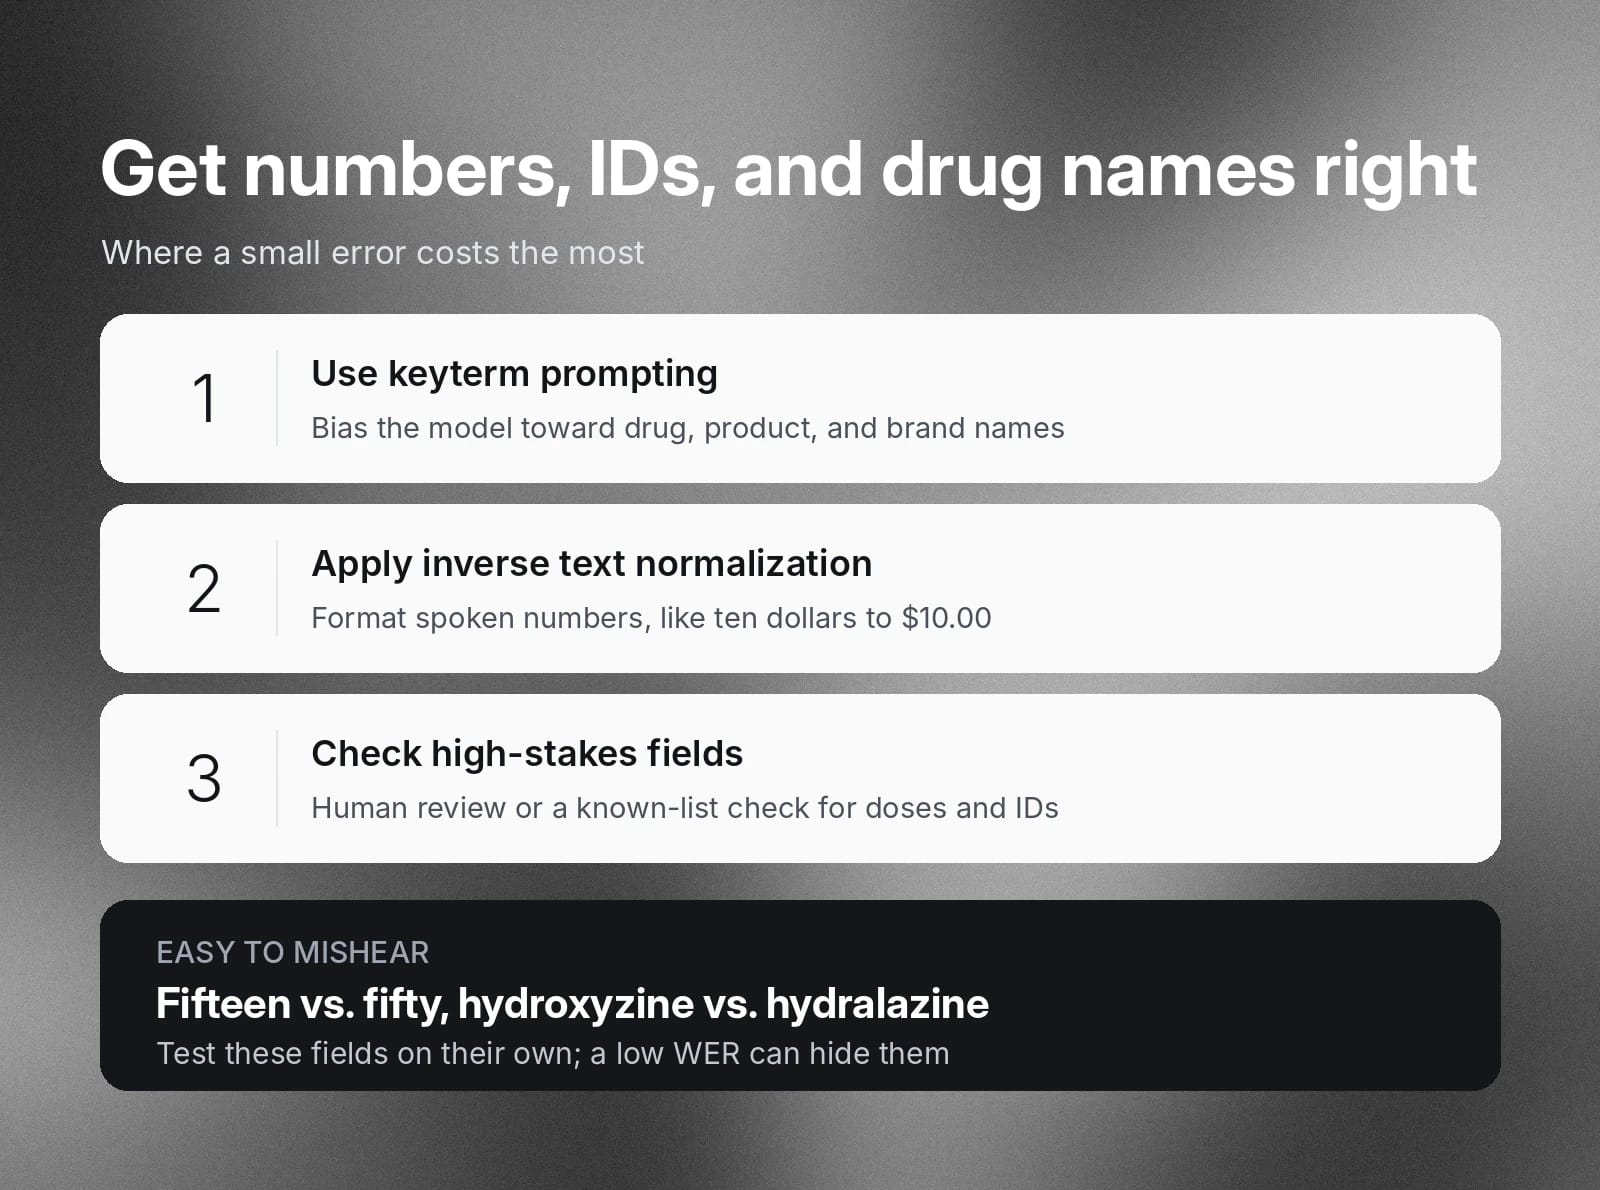
Bei Zahlen, Konto-IDs, Postleitzahlen und Medikamentennamen hat ein kleiner Fehler die größten Folgen. Ein Modell kann „fünfzehn“ als „fünfzig“ missverstehen oder zwei Medikamentennamen verwechseln, die sich nur um eine Silbe unterscheiden, etwa Hydroxyzin und Hydralazin.
Drei Schritte helfen:
- Keyterm Prompting verwenden: Lenken Sie das Modell auf die Schreibweisen von Medikamentennamen, Produktnamen und anderen erwarteten Begriffen.
- Inverse Textnormalisierung (ITN) anwenden: Formatieren Sie gesprochene Zahlen einheitlich, etwa indem Sie „zehn Dollar“ in „$10.00“ ändern.
- Prüfung für kritische Felder hinzufügen: Nutzen Sie für Felder wie Medikamentendosierungen und Kontonummern eine menschliche Prüfung oder einen automatisierten Abgleich mit einer bekannten Liste.
Testen Sie diese Felder separat, denn eine niedrige Gesamt-WER kann Fehler gerade bei den wichtigsten Wörtern verbergen.
Qualität der Spracherkennung mit Word Error Rate messen
Die Word Error Rate (WER) ist eine nützliche Kennzahl zur Bewertung der Genauigkeit einer STT-Engine. Sie können die WER verschiedener Modelltests vergleichen, um ihre relative Genauigkeit einzuschätzen.
So wird die WER berechnet:
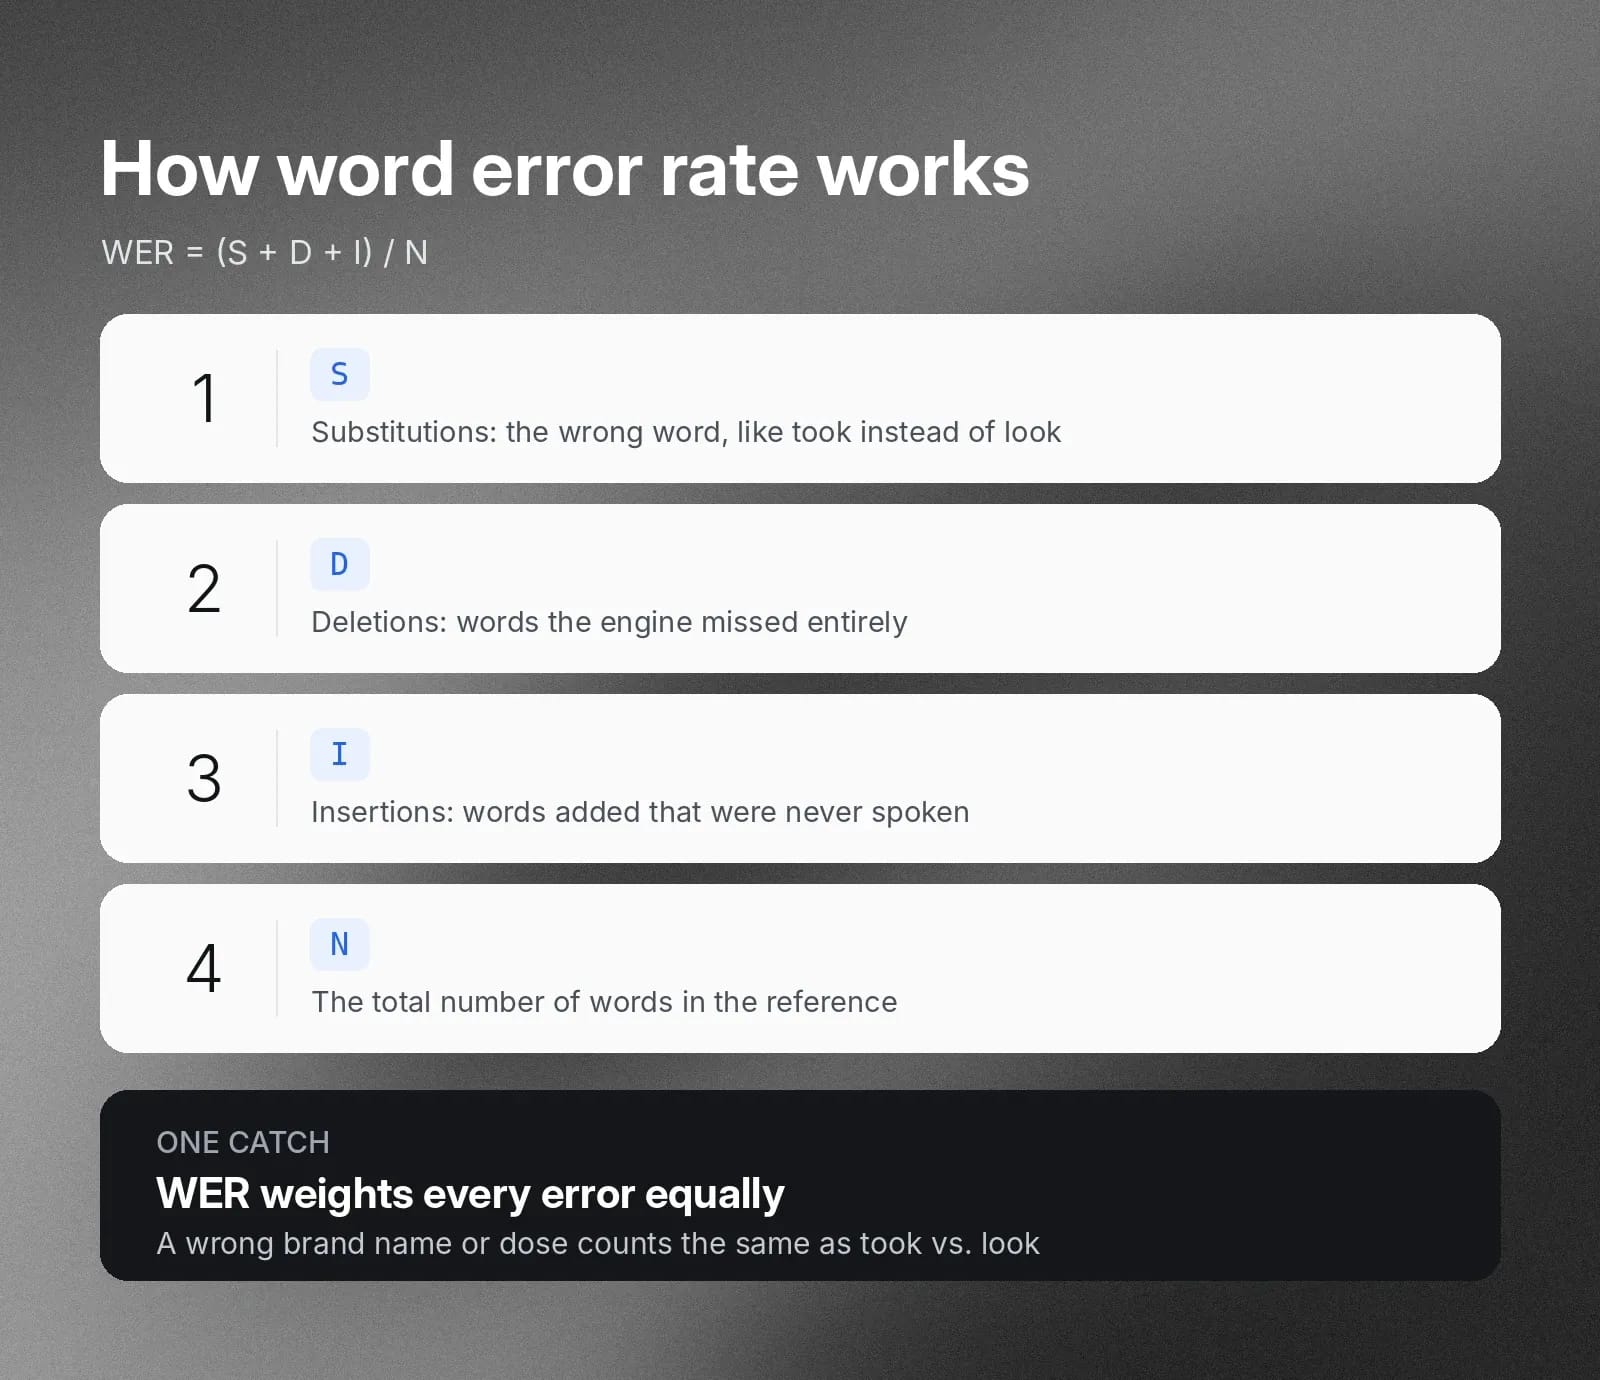
WER = (S + D + I) / N
- Ersetzungen (S): Die Anzahl der Fälle, in denen die STT-Engine in einem Transkript das falsche Wort ausgibt, beispielsweise „Tuch“ statt „Buch“.
- Löschungen (D): Die Anzahl der Wörter, die vollständig fehlen.
- Einfügungen (I): Die Anzahl der Wörter, die hinzugefügt wurden, obwohl sie nie gesprochen wurden.
- Referenzwörter insgesamt (N): Die Gesamtzahl der Wörter in der Sprachprobe.
Wichtig ist, dass die WER alle Fehler gleich gewichtet. So zählt die Ersetzung von „Tuch“ durch „Buch“ genauso viel wie die falsche Erkennung Ihres Markennamens oder einer wichtigen Angabe wie der Höhe einer Medikamentendosis. Prüfen Sie die WER verschiedener Modelle.
Was gilt als gute Word Error Rate?
Es gibt keine allgemein gute WER, denn das richtige Ziel hängt von Ihrem Audio und Ihrem Anwendungsfall ab. Sauberes Audio mit einem einzelnen Sprecher erzeugt deutlich niedrigere Fehlerraten als verrauschte Anrufe mit überlappenden Sprechern. Vergleichen Sie Modelle anhand Ihrer eigenen Aufnahmen, statt sich auf eine prominente Kennzahl zu verlassen.
Als Referenz für spezialisiertes Audio zählt Scribe v2 Medical bei öffentlichen medizinischen ASR-Benchmarks zu den leistungsstärksten Modellen. Prüfen Sie aktuelle Benchmark-Ergebnisse für die neuesten Werte.
Benchmark-Ergebnisse ändern sich mit der Veröffentlichung neuer Modelle. Prüfen Sie aktuelle Ergebnisse, bevor Sie vergleichen.
Genauigkeit vs. Präzision: Was Transkriptionsteams messen sollten
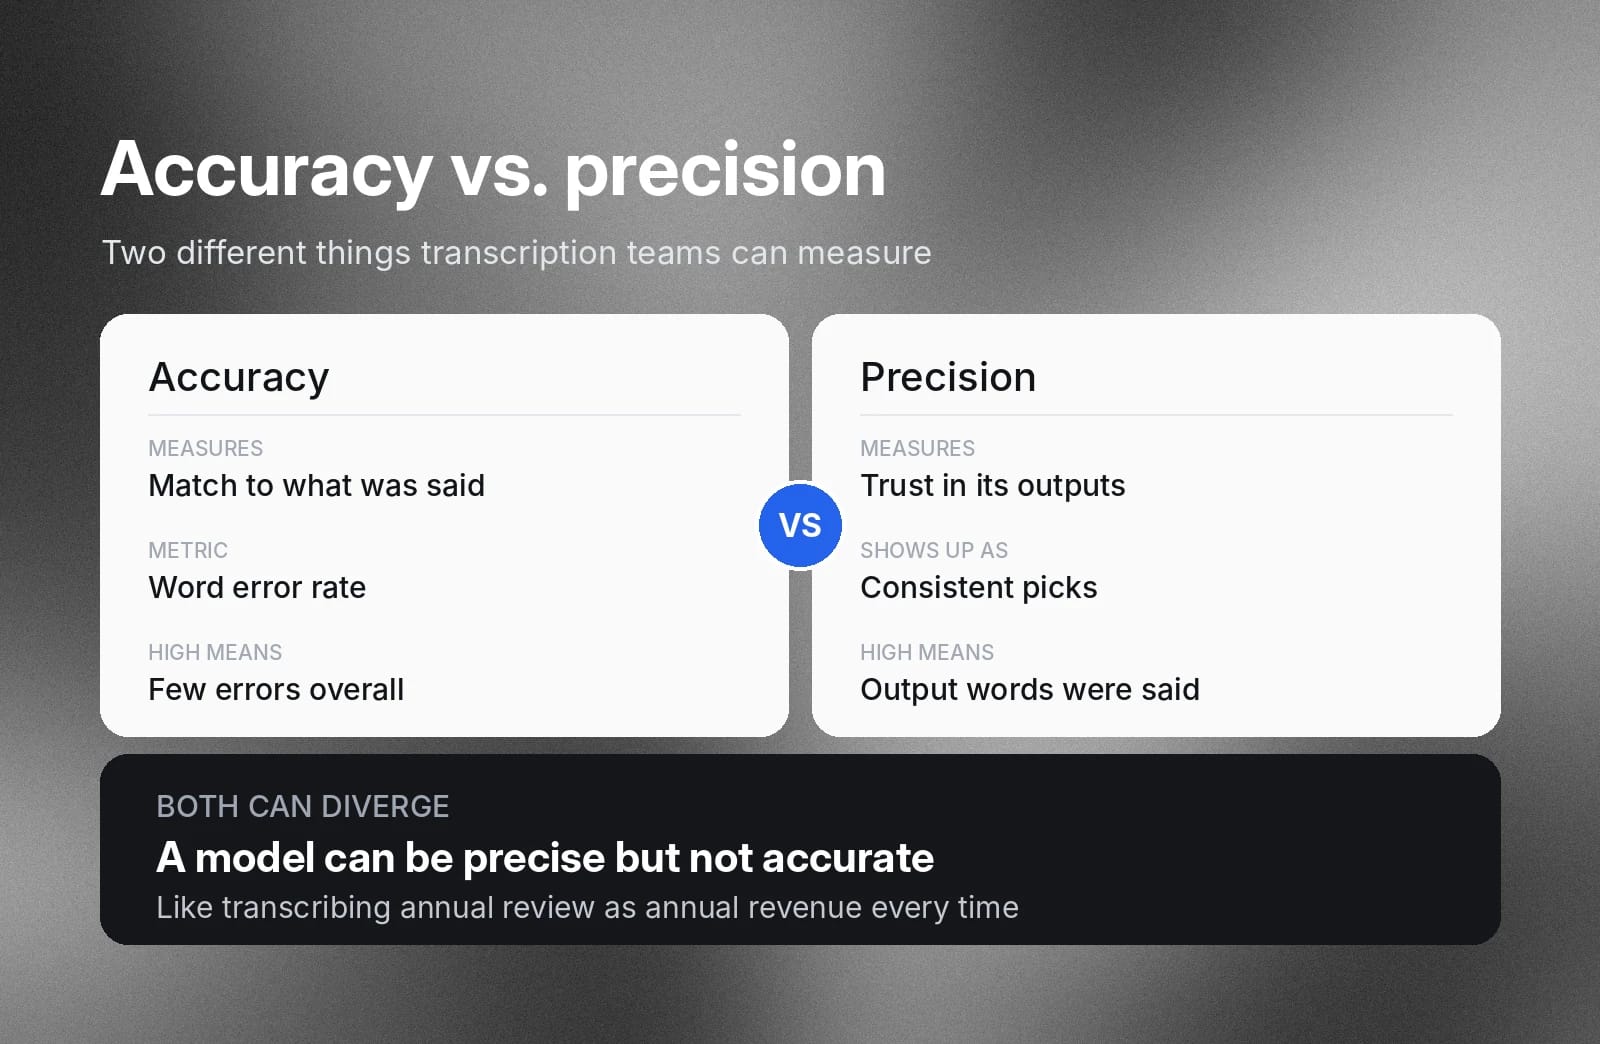
Genauigkeit beschreibt, wie stark die Transkriptionsausgabe mit der gesprochenen „Ground Truth“ übereinstimmt. Die Word Error Rate misst die Genauigkeit.
Präzision beschreibt, wie zuverlässig die positiven Vorhersagen eines STT-Modells sind. Ein sehr präzises Modell wählt bei komplexer Sprache über mehrere Durchläufe hinweg dasselbe Wort. Gibt das Modell ein Wort aus, können Sie darauf vertrauen, dass dieses Wort gesprochen wurde. Ein sehr präzises Modell kann dennoch eine geringe Genauigkeit haben, wenn es viele Wörter auslässt.
Mit ElevenAPI für genauere Transkription starten
ElevenAPI bietet Ihnen Zugriff auf Scribe v2, das Speech-to-Text-Modell von ElevenLabs, sowie auf Funktionen für die in diesem Leitfaden behandelten Genauigkeitsprobleme: Keyterm Prompting für Namen und Fachjargon, Mehrkanaltranskription für überlappende Sprecher und Sprecherdiarisierung.
Wenn Sie ohne API transkribieren möchten, können Sie auch auf ElevenCreateive STT zugreifen.
Starten Sie noch heute mit ElevenAPI und erstellen Sie hochwertiges Speech to Text, oder erfahren Sie mehr über die Speech-to-Text-Funktionen von ElevenAPI.
Häufig gestellte Fragen zur Speech-to-Text-Genauigkeit

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.


