Was ist mehrsprachige Transkription und wie funktioniert sie?
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Ob Sie eine internationale Konferenz veranstalten oder präzise Aufzeichnungen von Kundensupport-Gesprächen in jeder Sprache benötigen: Mehrsprachige Transkription ist wichtiger denn je.
Indem sie Audiodaten in präzisen, durchsuchbaren Text umwandeln, machen mehrsprachige Transkriptionstools aus Gesprächen nutzbare Aufzeichnungen. Die Technologie für sprachübergreifende Transkription hat sich parallel zur zunehmenden Forschung an Speech-to-Text-Modellen (STT) weiterentwickelt. Entwickler können leistungsstarke STT-APIs inzwischen auch in ihre Workflows für komplexe mehrsprachige Transkriptionspipelines einbetten.
In diesem Artikel erklären wir, was mehrsprachige Transkription ist, wie sie per Desktop-App und API funktioniert und warum sie für Unternehmen weltweit unverzichtbar ist.
Zusammenfassung
- Mehrsprachige Transkription wandelt eine Audiodatei in geschriebenen Text in mehreren Sprachen um.
- Die besten Tools für mehrsprachige Transkription bieten zusätzliche Funktionen wie Sprecherdiarisierung, Schlüsselwort-Prompting und Entitätenerkennung.
- Sie können Tools für mehrsprachige Transkription online verwenden oder eine Speech-to-Text-API integrieren für Entwicklungsworkflows.
- Automatische Transkription bietet Geschwindigkeit und Skalierbarkeit, während menschliche Transkription bei komplexen Fällen mit mehreren überlappenden Sprechern hilfreich sein kann.
- Die Genauigkeit mehrsprachiger Transkription wird anhand der Word Error Rate (WER) gemessen, die je nach Sprache variiert.
Was ist mehrsprachige Transkription und warum ist sie wichtig?
Mehrsprachige Transkription wandelt gesprochene Audiodaten in geschriebenen Text in mehr als einer Sprache um. Systeme der künstlichen Intelligenz erkennen automatisch die gesprochene Sprache oder Sprachen und transkribieren die Audiodaten. Das Ergebnis von mehrsprachigem STT kann ein wortgetreues Transkript sein oder eine Übersetzungsebene enthalten, die die Eingabesprachen in einer gemeinsamen Ausgabesprache zusammenführt.
Bei einer globalen Konferenz können beispielsweise Sprecher Fragen in ihrer Muttersprache erhalten. Das mehrsprachige Speech-to-Text-Tool kann entweder direkt transkribieren, was jeder Sprecher in seiner eigenen Sprache sagt, oder eine einheitliche Ausgabe in einer Zielsprache für das Publikum erstellen. Mit diesen STT-Tools können Organisationen den Zugang zu ihren Veranstaltungen verbessern.
ElevenLabs integriert mehrsprachige STT-Funktionen direkt in unser Speech to Text-Scribe v2-Modell. Scribe v2 unterstützt die automatische Spracherkennung, sodass eine einzelne Datei mehrere Sprachen enthalten kann. Sie können angeben, welche Sprachen in einem Audioclip vorkommen, oder die Einstellung auf „Erkennen“ lassen. Unser System erkennt dann alle Sprachen in der hochgeladenen Datei.
Bei der Verwendung von ElevenAPI ist der Parameter language_code standardmäßig auf automatische Erkennung eingestellt. Wenn Sie bereits wissen, welche Sprachen vorkommen, verbessert die vorherige Angabe die Leistung.
Warum mehrsprachige Transkription wichtig ist
Aktuelle Studien deuten darauf hin, dass der globale Markt für Transkriptionsdienste bis 2035 6 Milliarden US-Dollar erreichen wird. Das breite Spektrum an Anwendungsfällen für mehrsprachiges STT treibt dieses Wachstum mit an.
Mehrsprachige Transkription ist aus mehreren praktischen Gründen wichtig:
- Barrierefreiheit: Untertitel und Beschriftungen benötigen präzise mehrsprachige Transkripte, bevor Übersetzung oder Synchronisation beginnen kann. Mehrsprachiges STT kann die Barrierefreiheit für Nutzer deutlich verbessern.
- Durchsuchbarkeit: Transkribierte Audiodaten werden zu indexierbarem Text. So können Ihre Supportanrufe oder Meetings zu nützlichen Ressourcen für andere werden. Durchsuchbarkeit ist besonders wichtig, da KI-Systeme zunehmend Daten aus internen Dokumenten erschließen. Klare Transkriptionen helfen dabei, eine umfassende Wissensgrundlage aufzubauen.
- Compliance: Viele regulierte Branchen benötigen prüfbare schriftliche Aufzeichnungen gesprochener Interaktionen. Mit mehrsprachigem STT können Sie dies in jeder Sprache unterstützen, die Ihre Kunden verwenden. So schreibt etwa die Financial Conduct Authority vor, dass Finanzinstitute Aufzeichnungen und Transkripte von Telefongesprächen aufbewahren müssen.
- Globale Content-Pipelines: Ob Synchronisation oder Untertitelung: Workflows beginnen immer mit einem hochpräzisen Ausgangstranskript. Hochwertige Tools für mehrsprachige Transkription ermöglichen den ersten Schritt dieser umfassenderen globalen Content-Distributionsworkflows.
Mehrsprachige Transkription ist in zahlreichen Branchen unverzichtbar: Telekommunikationsanbieter transkribieren Supportanrufe, Finanzdienstleister erfüllen Compliance-Anforderungen, Gesundheitsteams dokumentieren Patienteninteraktionen und Filmstudios lokalisieren Inhalte. Ob SaaS, Reisen oder Versorgungswirtschaft – ein leistungsstarkes System stellt sicher, dass Ihre Transkripte stets hochwertig und präzise sind.
Wichtige Funktionen für Lösungen zur mehrsprachigen Transkription
Tools für mehrsprachige Transkription müssen sich an die verarbeiteten Audiodaten anpassen, Sprachen dynamisch erkennen und sie hochpräzise transkribieren können.
Auf diese zentralen Funktionen sollten Sie bei einer hochwertigen Lösung für mehrsprachige Transkription achten:
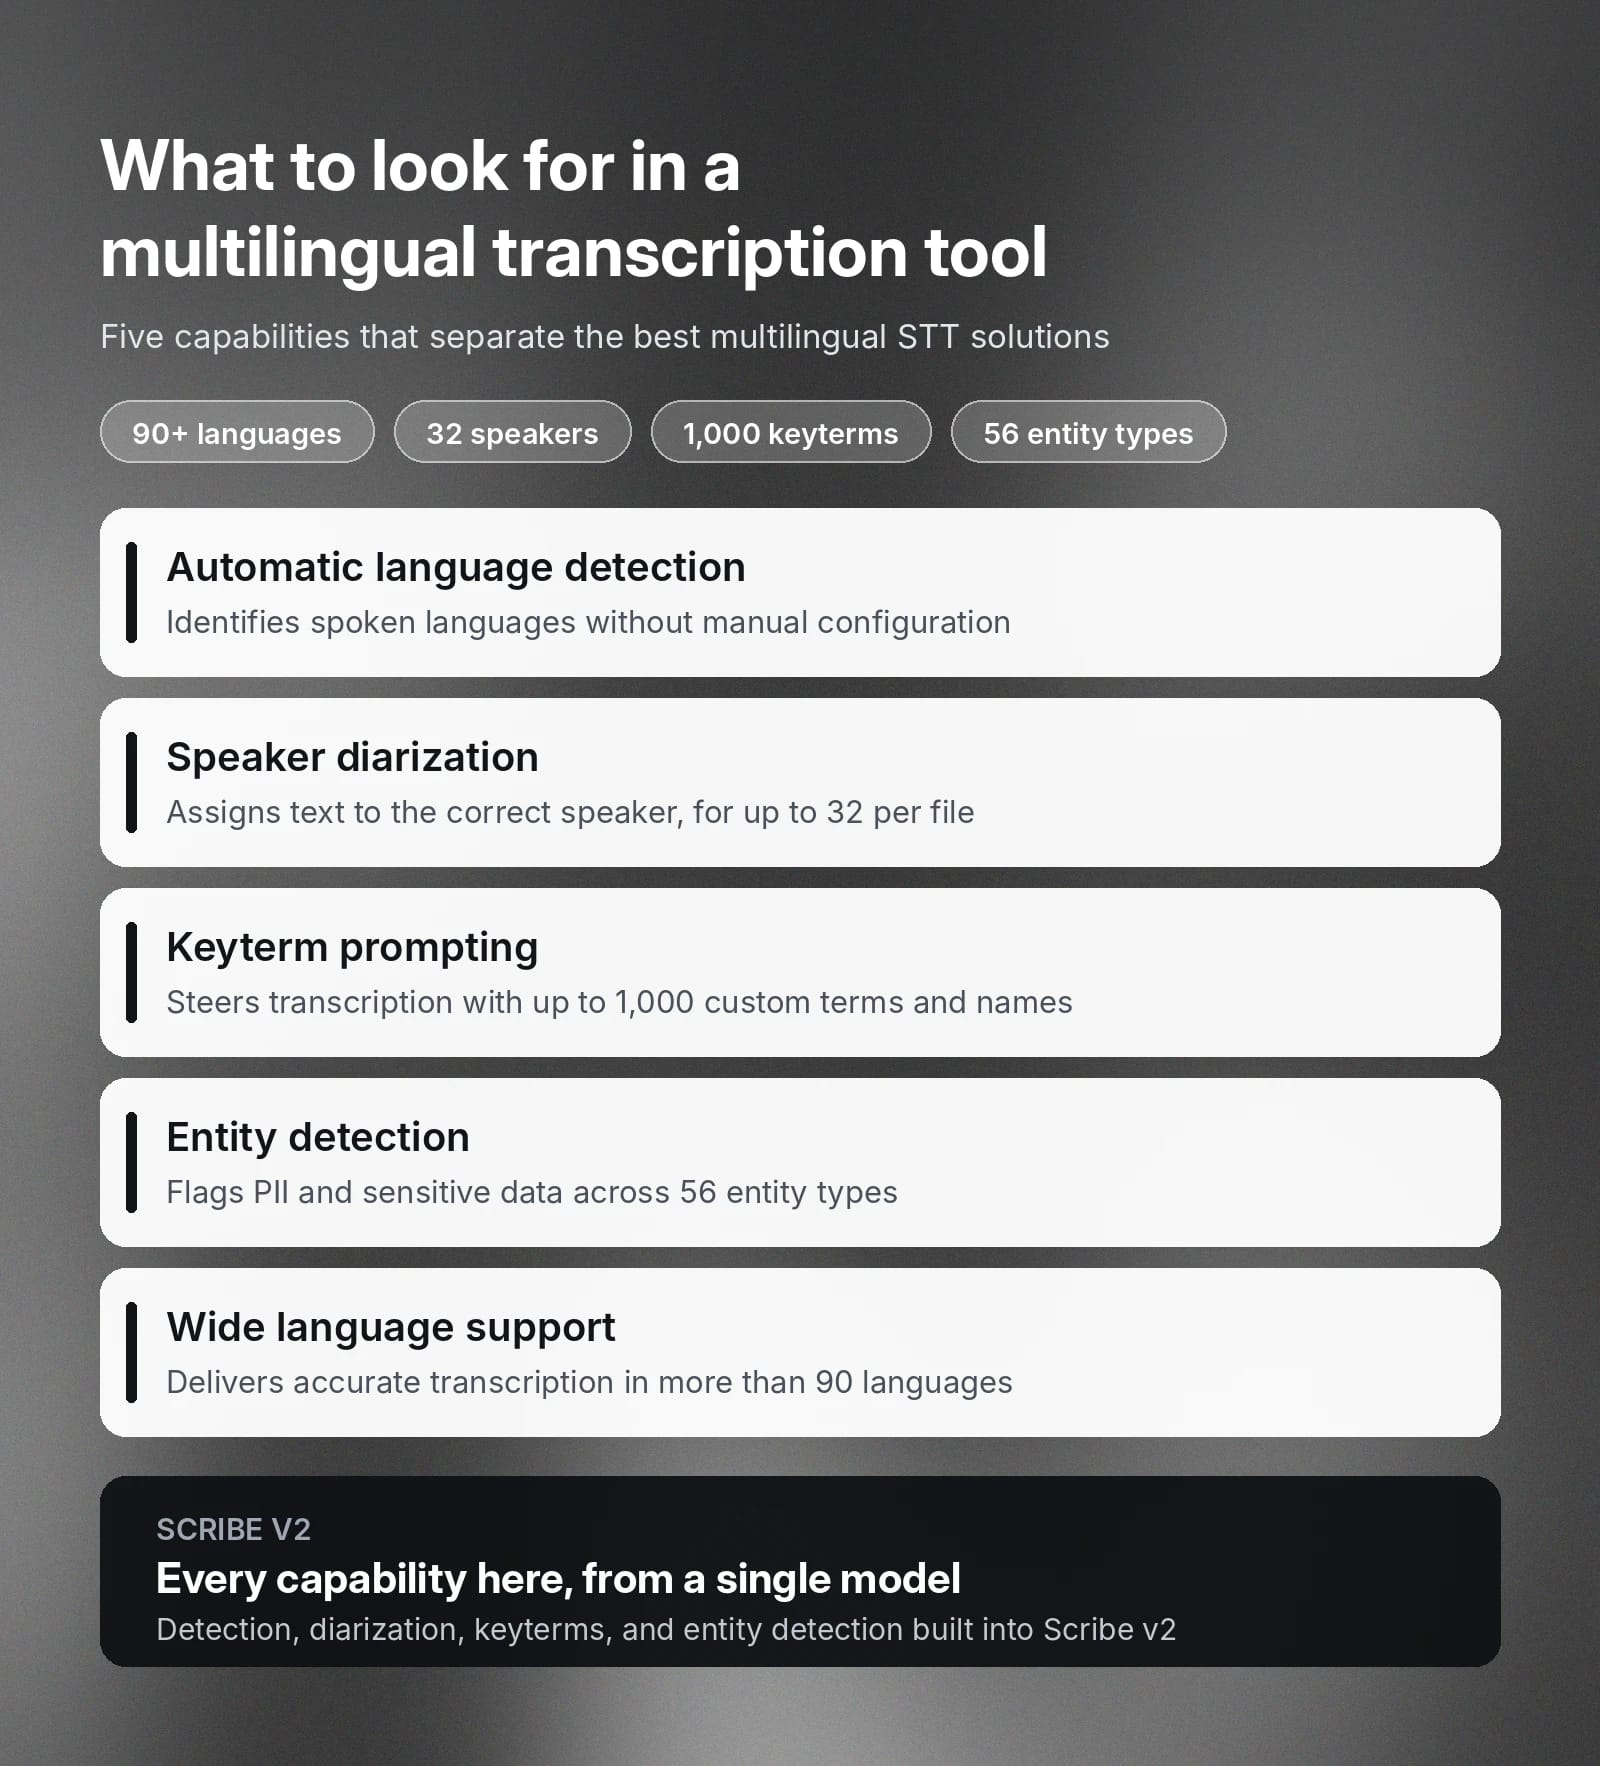
- Automatische Spracherkennung: Das System sollte die gesprochene Sprache selbst erkennen, statt die Transkription zu verhindern, bis der Nutzer eine Ausgangssprache angibt. Besonders wenn die Eingabesprache unbekannt ist oder ein Clip mehrere Sprachen enthält, ermöglicht die automatische Spracherkennung die Verwaltung mehrerer Sprachen ohne manuelle Konfiguration.
- Sprecherdiarisierung: Die Diarisierung ordnet transkribierten Text dem richtigen Sprecher in einer Datei zu. Das ist bei Transkriptionen mit mehreren Sprechern wichtig. Beispielsweise kann ein Panel aus mehreren Personen bestehen, die Sie unterscheiden müssen, oder Sie benötigen eine klare Abgrenzung zwischen Kunden und Supportmitarbeitern. Scribe v2 unterstützt die Diarisierung von bis zu 32 Sprechern in einer einzelnen Datei.
- Schlüsselwort-Prompting: Schlüsselbegriffe ermöglichen es Nutzern, spezifisches Vokabular wie Produktnamen oder Eigennamen manuell einzugeben, um die korrekte Transkription festzulegen. In Batch-Systemen erlaubt Scribe v2 bis zu 1.000 Schlüsselbegriffe, während Scribe v2 Realtime für Live-Transkription bis zu 50 bietet.
- Entitätenerkennung: Die Entitätenerkennung identifiziert bestimmte Wörter in einem Transkript. Das ist für Compliance- und Sicherheitsmaßnahmen zum Schutz sensibler Daten essenziell. Lesen Sie die ElevenLabs-Dokumentation zur Entitätenerkennung für eine vollständige Übersicht der 56 unterstützten Entitätstypen.
- Breite Sprachunterstützung: Die besten mehrsprachigen STT-Lösungen unterstützen erwartungsgemäß die Transkription in einer sehr großen Zahl von Sprachen. Scribe v2 bietet beispielsweise präzise Transkription in über 90 Sprachen.
Zusammen ermöglichen diese Funktionen ein breites Spektrum an Anwendungsfällen. Sie können ein zuverlässiges STT-System nutzen, das mehrere Sprachen präzise abdeckt.
So transkribieren Sie Audiodaten in verschiedenen Sprachen effizient
Die effektivste Methode zur Transkription von Audiodaten in verschiedenen Sprachen hängt von Ihrem Arbeitsvolumen ab. Bei einzelnen Batch-Dateien können Sie auf der ElevenLabs-Seite für Speech to Text eine Datei hochladen und schnell das Transkript erhalten.
In ElevenCreative ist das Transkribieren von Audiodaten ganz einfach:
- Audiodaten hochladen: Navigieren Sie zu Speech to Text und klicken Sie auf „Dateien transkribieren“.
- Optionen auswählen: Wählen Sie die primäre Sprache aus oder lassen Sie die Einstellung auf „Erkennen“. Aktivieren Sie Audioereignisse, wenn Sie Lachen oder andere nichtsprachliche Ereignisse markieren möchten, und fügen Sie bei Bedarf Schlüsselbegriffe hinzu.
- Ergebnisse anzeigen: Nach dem Hochladen Ihrer Dateien können Sie auf den Namen der Audiodatei klicken, um ihre Transkription anzuzeigen. Dort können Sie das Transkript direkt im Transcript Editor prüfen und überarbeiten und anschließend in das von jedem nachgelagerten Workflow benötigte Format exportieren.
Für programmatische Transkription oder große Volumen verwenden Sie die Speech-to-Text-API. Mit diesen Details können Sie Ihre Produktionspipelines gestalten:
- Modellauswahl: Der Parameter model_id wählt zwischen scribe_v2 und scribe_v1. So kann die Pipeline ein bestimmtes Modell festlegen, statt sich auf einen Standardwert zu verlassen, der sich im Laufe der Zeit ändern kann.
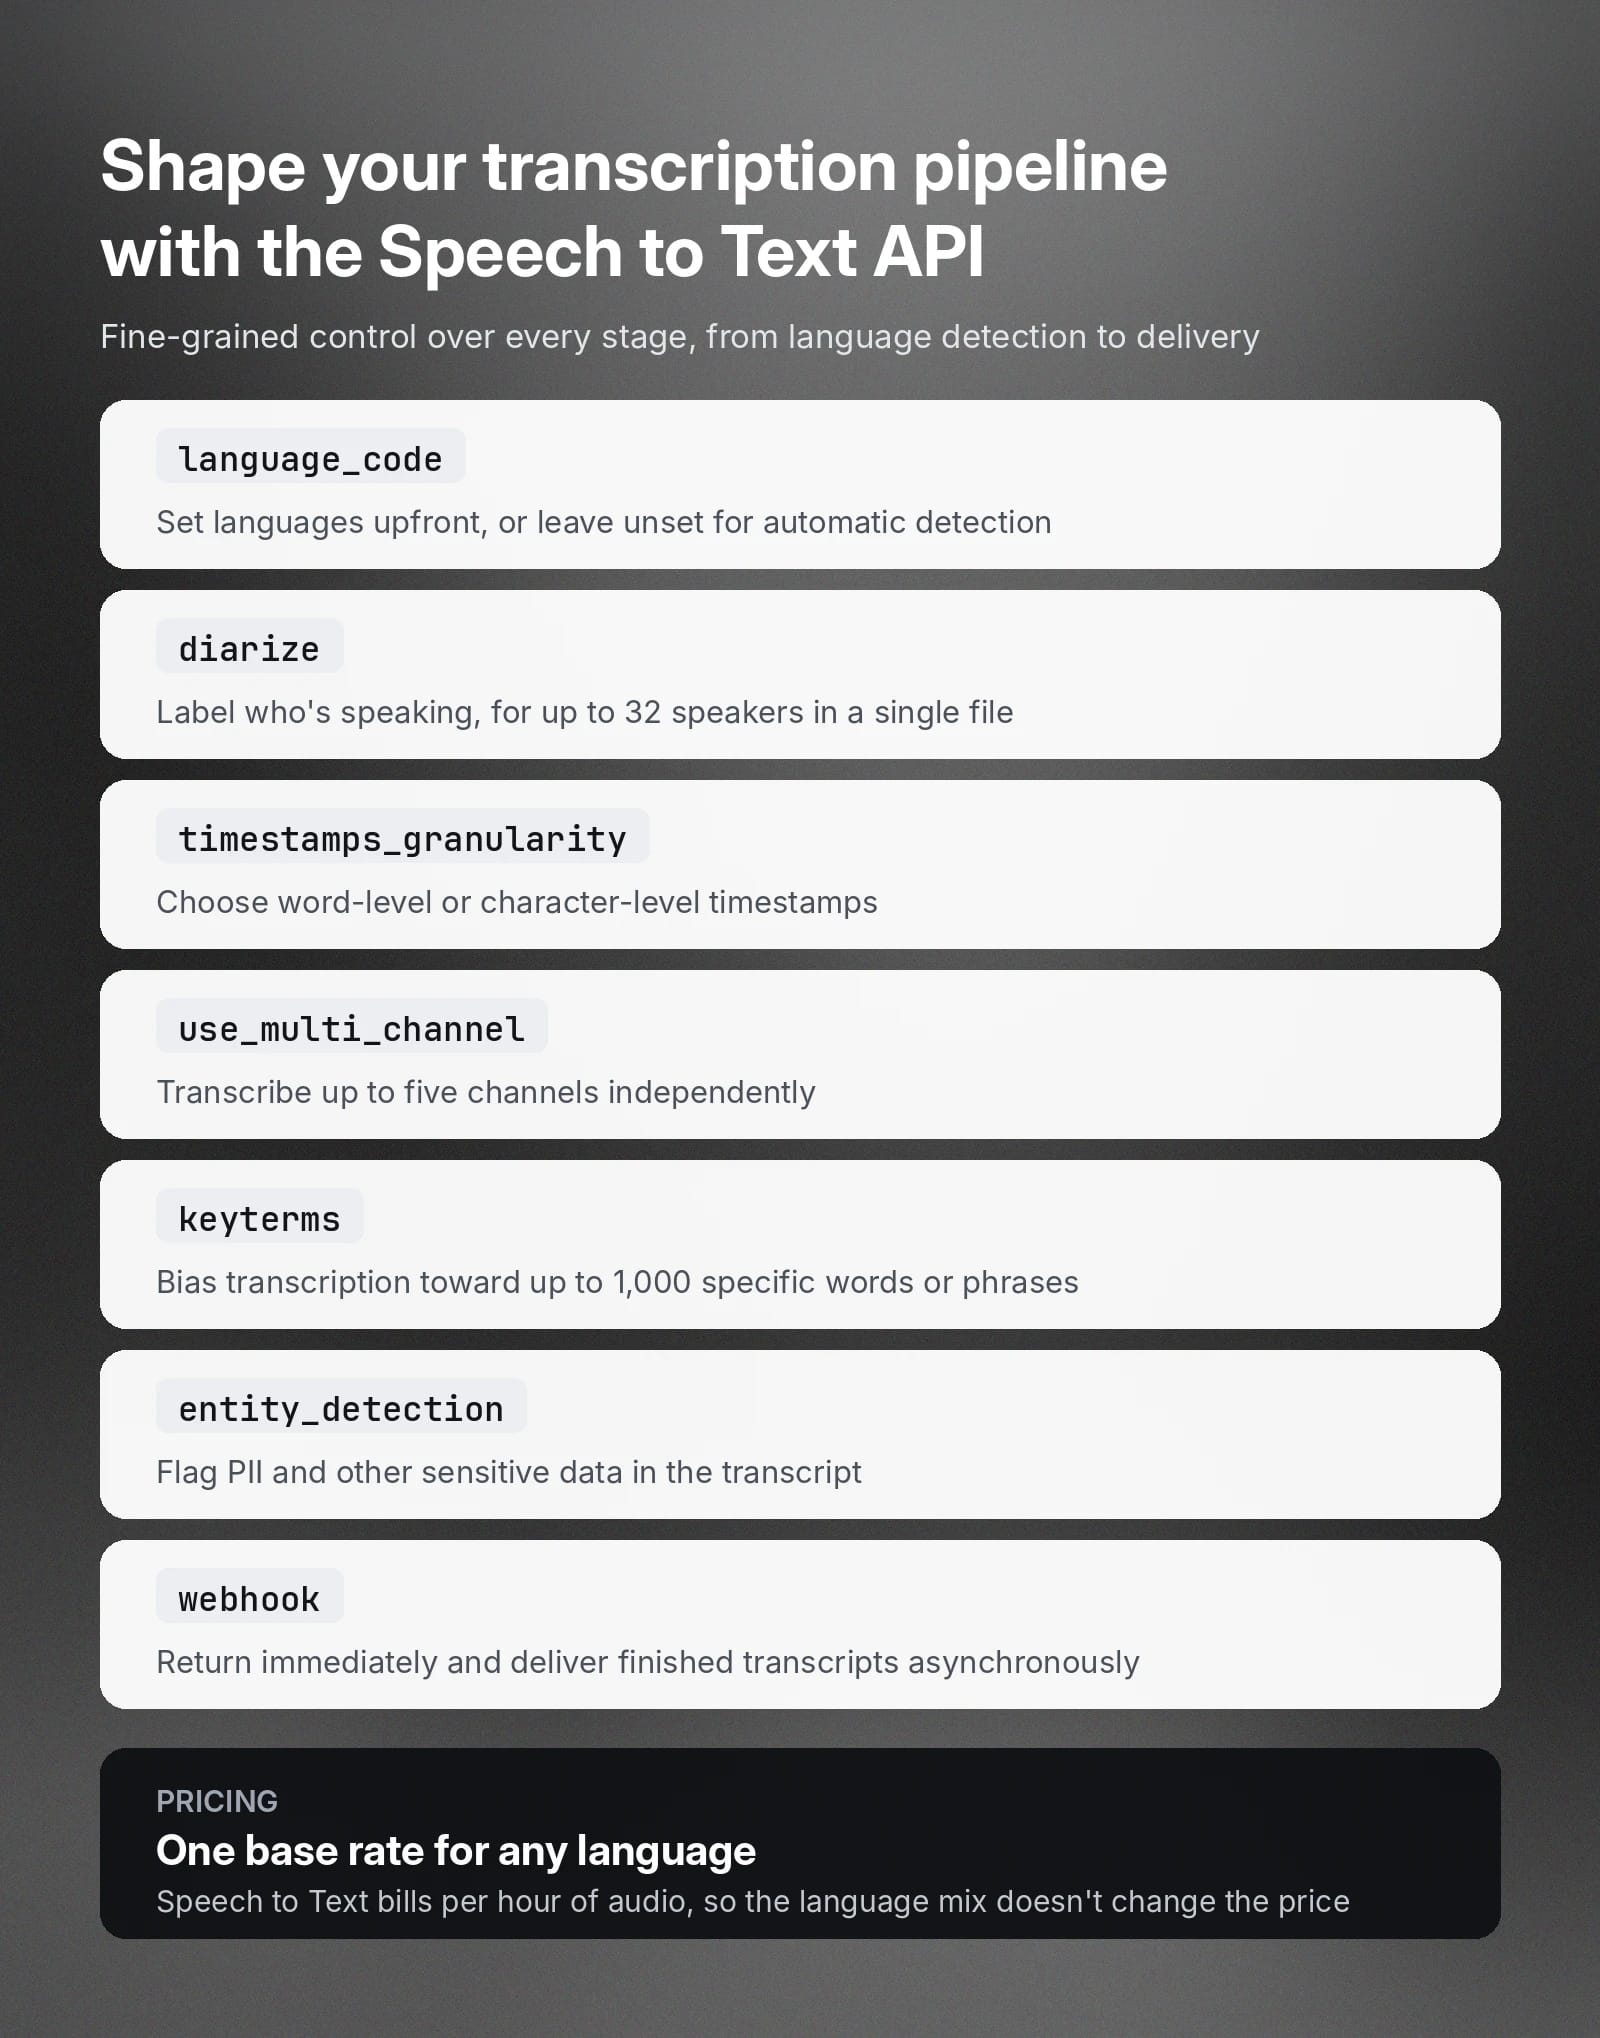
- Sprachverarbeitung: Der Parameter language_code akzeptiert einen ISO-639-1- oder ISO-639-3-Code und verwendet automatisch die Spracherkennung, wenn er nicht gesetzt ist. Die direkte Angabe einer Sprache kann die Leistung verbessern.
- Steuerung der Sprecherdiarisierung: Wenn diarize auf true gesetzt wird, wird markiert, welcher Sprecher gerade spricht. Der Parameter num_speakers begrenzt die Anzahl auf 1 bis 32. Für eine detailliertere Steuerung können Sie mit dem Parameter diarization_threshold den Kompromiss zwischen der Unterscheidung einzelner Sprecher anpassen.
- Zeitstempelpräzision: Der Parameter timestamps_granularity steuert den Detailgrad der Ausgabe und bietet Optionen für Zeitstempel auf Wort- oder Zeichenebene Zeitstempel oder keine.
- Asynchrone Verarbeitung im großen Maßstab: Wenn webhook auf true gesetzt wird, erhalten Sie die Antwort sofort. Das fertige Transkript wird nach Abschluss der Verarbeitung an Ihren konfigurierten Webhook gesendet. Das Feld webhook_metadata fügt jeder Webhook-Antwort benutzerdefinierte Tracking-Daten hinzu, etwa Ihre interne Job-ID.
- Mehrkanal-Audio: Wenn use_multi_channel auf true gesetzt wird, wird jeder Kanal unabhängig transkribiert. Dabei sind bis zu fünf Kanäle möglich und jedes Wort wird mit einem Feld channel_index versehen.
- Verarbeitung spezialisierter Inhalte: Der Parameter keyterms priorisiert bei der Transkription bis zu 1.000 bestimmte Wörter oder Phrasen, entity_detection kennzeichnet PII und andere sensible Daten und no_verbatim entfernt Füllwörter und Satzabbrüche aus der Ausgabe.
Zusammen geben Ihnen diese Parameter detaillierte Kontrolle über jede Phase der Pipeline. Von Spracherkennung und Sprecherkennzeichnung bis zu Ausgabeformatierung und Bereitstellung passt sich die Speech-to-Text-API Ihren Produktionsanforderungen an.
Unterstützte Sprachen für Transkriptionsdienste erklärt
Die Sprachabdeckung ist ein wesentlicher Unterschied zwischen den besten Tools für mehrsprachige Transkription. ElevenLabs Scribe v2 und Scribe v2 Realtime unterstützen beide über 90 Sprachen. In der Speech-to-Text-Dokumentation finden Sie die vollständige Liste der unterstützten Sprachen.
Sprachen wie Englisch, Spanisch, Italienisch, Polnisch, Französisch und Deutsch verfügen über größere Mengen an Trainingsdaten. Daher ist STT in diesen Sprachen oft präziser. Einige Sprachen wie Amharisch, Ganda, Yoruba und Zulu haben niedrigere Genauigkeitsraten als die genannten Sprachen.
ElevenLabs-Scribe-Modelle erreichen eine Word Error Rate von unter 5 % für 36 verschiedene Sprachen und eine WER von unter 10 % für weitere 21. In der ElevenLabs-Übersicht zur Sprachunterstützung finden Sie weitere Details zu unterstützten Sprachen und ihren WERs.
Was kostet mehrsprachige Transkription?
Die Preise für automatische Transkription richten sich in der Regel nach der Dauer einer Audiodatei und nicht nach Wortanzahl oder Anzahl der Sprachen. ElevenLabs berechnet Speech to Text nach Audiodauer, abgerechnet pro Audiostunde. Die konkreten Preise variieren je nach Tarif und Modell.
Diese Faktoren beeinflussen die Preise für mehrsprachige Transkription:
- Zusätzliche Transkriptionsfunktionen: Einige Anbieter berechnen zusätzliche Gebühren für bestimmte Funktionen wie die Entitätenerkennung.
- Mehrkanal-Audio wird pro Kanal abgerechnet: Wenn Sie use_multi_channel aktivieren, wird jeder Kanal unabhängig abgerechnet. Eine Aufnahme mit zwei Kanälen kostet daher etwa doppelt so viel wie eine Aufnahme mit einem Kanal.
- Die Sprache ändert den Grundpreis nicht: Eine zeitbasierte Preisgestaltung bedeutet, dass mehrsprachiges STT jede Sprache zum gleichen Stundensatz unterstützt. Das vereinfacht die Budgetplanung für Teams, die mit mehreren Sprachen arbeiten.
Weitere Informationen zu den Kosten von ElevenLabs Speech to Text finden Sie auf unserer Preisseite.
Starten Sie mit ElevenAPI für präzise mehrsprachige Transkription
ElevenAPI integriert mehrsprachige Transkription in wenigen Schritten in jeden Produktionsworkflow. Ob Sie Inhalte für globale Medienarchive, Kundensupport-Interaktionen, Meetings oder Forschungsinterviews transkribieren oder einfach eine präzise Spracherkennung für Dutzende Sprachen suchen – unsere leistungsstarke mehrsprachige STT-Engine hilft Ihnen dabei.
Entdecken Sie die ElevenAPI Speech-to-Text-API mit allen Funktionen oder erstellen Sie ein ElevenLabs-Konto, um noch heute mehrsprachige Audiodaten zu transkribieren.
FAQ zur mehrsprachigen Transkription

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.