
Speech to Text für Content Creator: Ein Workflow-Leitfaden für Untertitel und Content-Recycling
- Verfasst von
- Jack Limebear
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Ein präzises Speech-to-Text-Tool gehört in den Tech-Stack jedes Content Creators. Mit KI-gestütztem Speech to Text können Sie vorhandenes Audio in Videountertitel, Podcast-Shownotes, Blogbeiträge und mehr umwandeln. So verwerten Sie Inhalte kanalübergreifend weiter und erreichen ein größeres Publikum.
Speech to Text spart viel Zeit für vielbeschäftigte Content Creator. Die manuelle Transkription jedes Voiceovers und Podcasts kann Stunden dauern. Speech-to-Text-Modelle erledigen die Aufgabe jedoch in Minuten, damit Sie Ihren Veröffentlichungsplan einhalten können.
In diesem Artikel erfahren Sie, wie Speech to Text für Content Creator funktioniert, warum es so effektiv ist und wie Sie es in Ihre Content-Workflows integrieren.
Zusammenfassung
- Content Creator nutzen Speech-to-Text-Modelle, um Videountertitel und Podcast-Shownotes zu erstellen sowie Audioinhalte in schriftlichen Formaten weiterzuverwenden.
- KI-gestützte Speech-to-Text-Modelle liefern präzisere Transkriptionen und Formatierungen als automatische Untertitel in sozialen Medien.
- Indem Sie Podcasts mit Speech to Text transkribieren, erstellen Sie schnell Shownotes oder verwerten sie als Blogs und Newsletter weiter.
- Mit Keyterm Prompting können Sie Namen und branchenspezifische Begriffe präzisieren, um genauere Transkripte zu erhalten.
- Um Ihre Untertitel zu übersetzen, synchronisieren Sie das Video zunächst in Ihre gewünschte Sprache und transkribieren dann das synchronisierte Audio mit Speech to Text.
Was sind die wichtigsten Einsatzbereiche von Speech to Text für Content Creator?
Content Creator nutzen Speech to Text für zahlreiche Aufgaben, darunter:
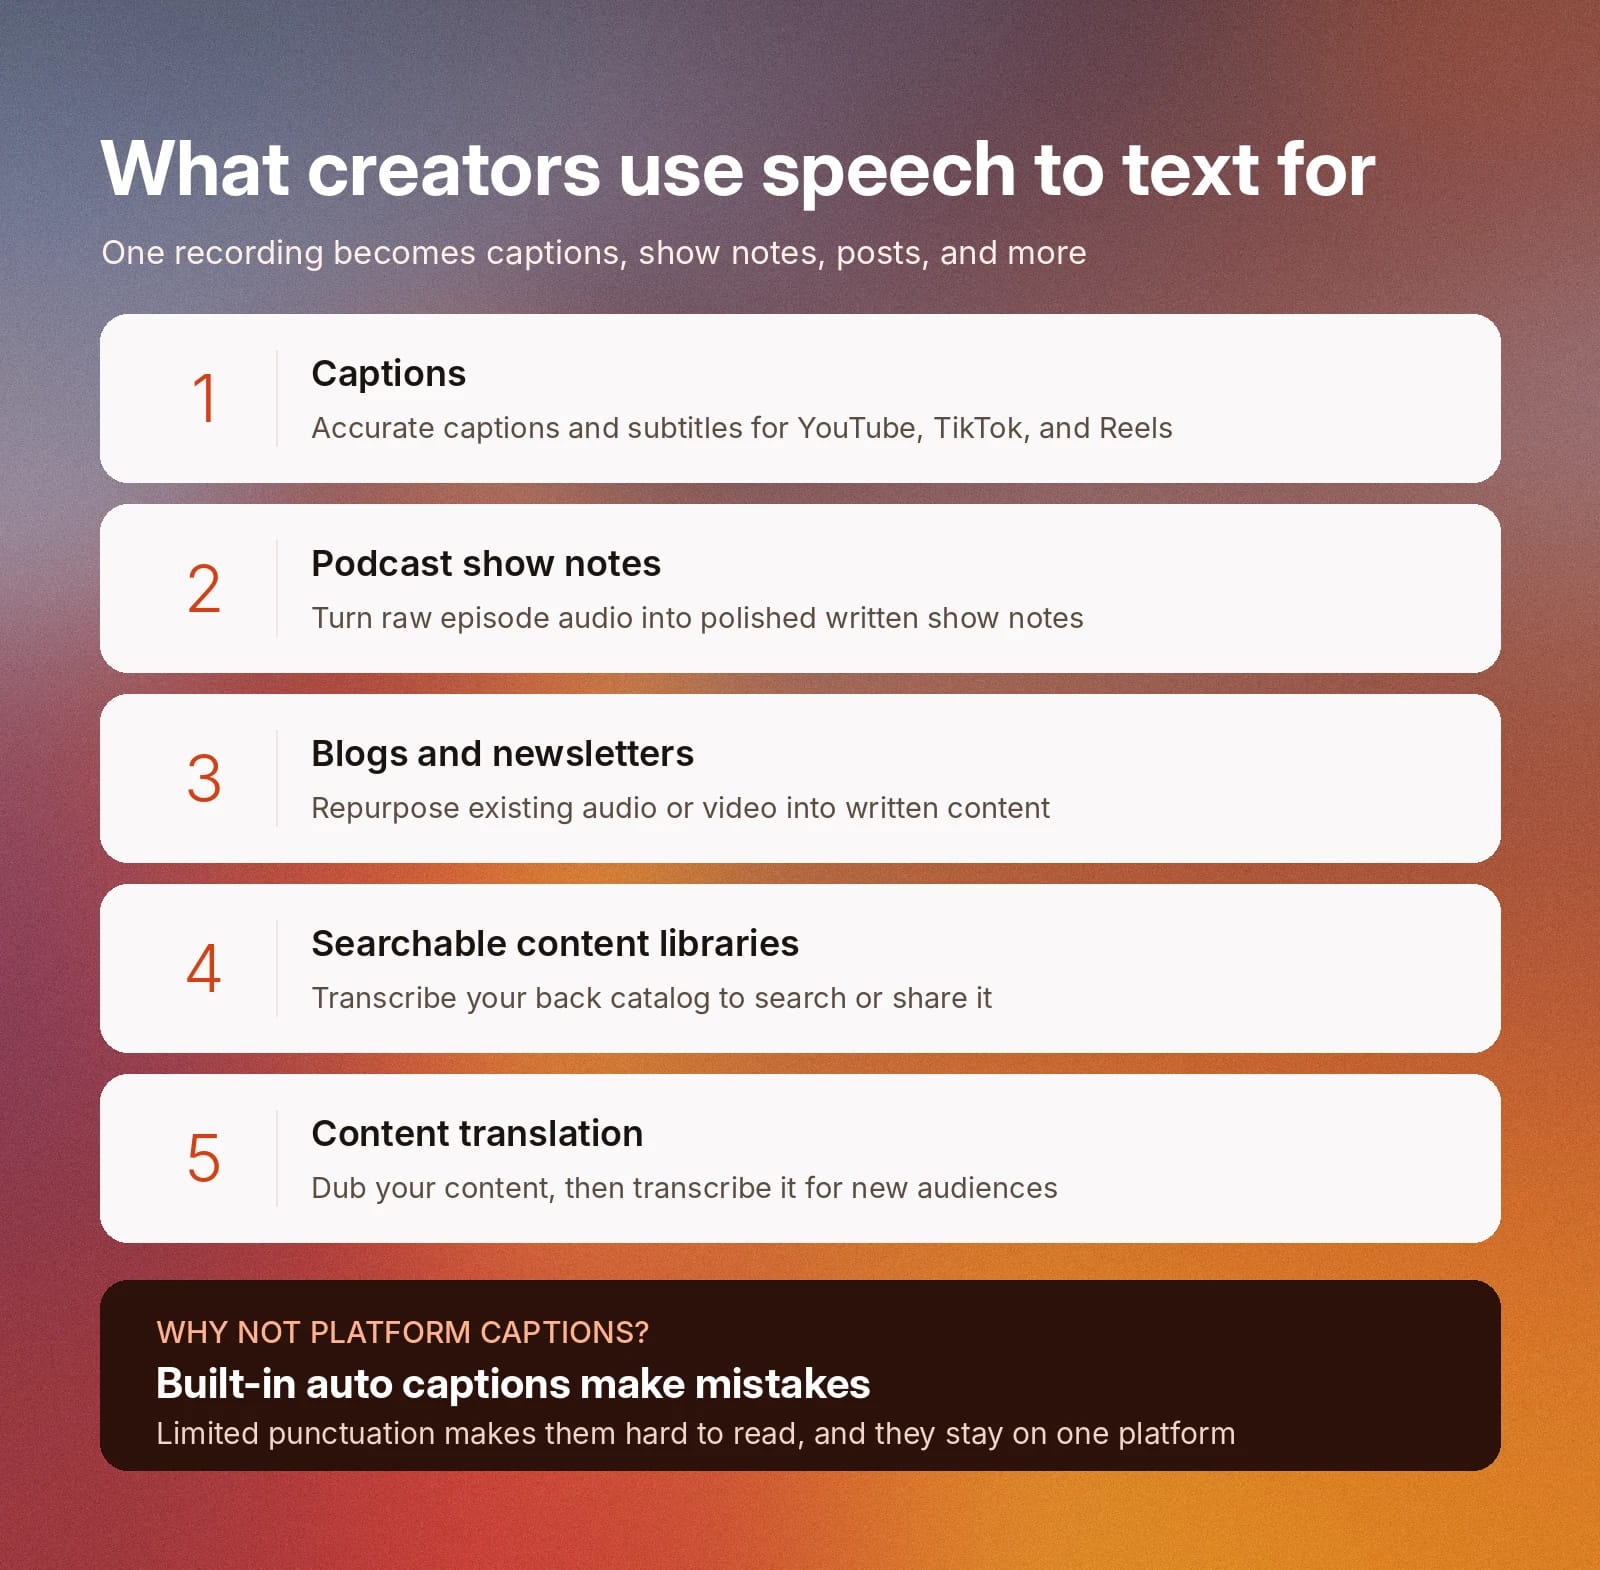
- Untertitel: Speech to Text erstellt präzise Captions und Untertitel für kurze und lange Videos auf Plattformen wie YouTube, TikTok und Instagram Reels.
- Podcast-Shownotes: Speech to Text hilft Ihnen, das Roh-Audio einer Episode in ausgearbeitete schriftliche Shownotes umzuwandeln.
- Blogs und Newsletter: Mit Speech to Text können Sie vorhandene Audio- oder Videoinhalte in Blogs, Newsletter und andere schriftliche Inhalte verwandeln.
- Durchsuchbare Inhaltsbibliotheken: Automatisierte Speech-to-Text-Tools transkribieren Ihre bestehende Inhaltsbibliothek und machen sie durchsuchbar. Das hilft Ihnen bei der internen Organisation oder beim Aufbau einer externen Ressourcenbibliothek für Ihr Publikum.
- Inhaltsübersetzung: Speech to Text übersetzt Ihre Inhalte in verschiedene Sprachen, damit Sie Zielgruppen weltweit erreichen.
Viele Social-Media-Plattformen bieten Funktionen zur automatischen Untertitelerstellung für Videoinhalte. Diese Tools können jedoch Fehler machen und verwenden nur begrenzt Satzzeichen, wodurch Untertitel schwer lesbar werden.
Mit einem dedizierten Speech-to-Text-Modell erstellen Sie saubere, präzise Untertitel für Ihre Videos. Sie können das Transkript außerdem herunterladen und plattformübergreifend weiterverwenden.
Ein Transkript in Captions und Untertitel umwandeln
Captions und Untertitel sind für Social-Media-Videos nicht mehr optional. Sie machen Videos für alle zugänglich, unabhängig vom Hörvermögen. Außerdem können Zuschauer Ihre Videos ohne Ton ansehen.
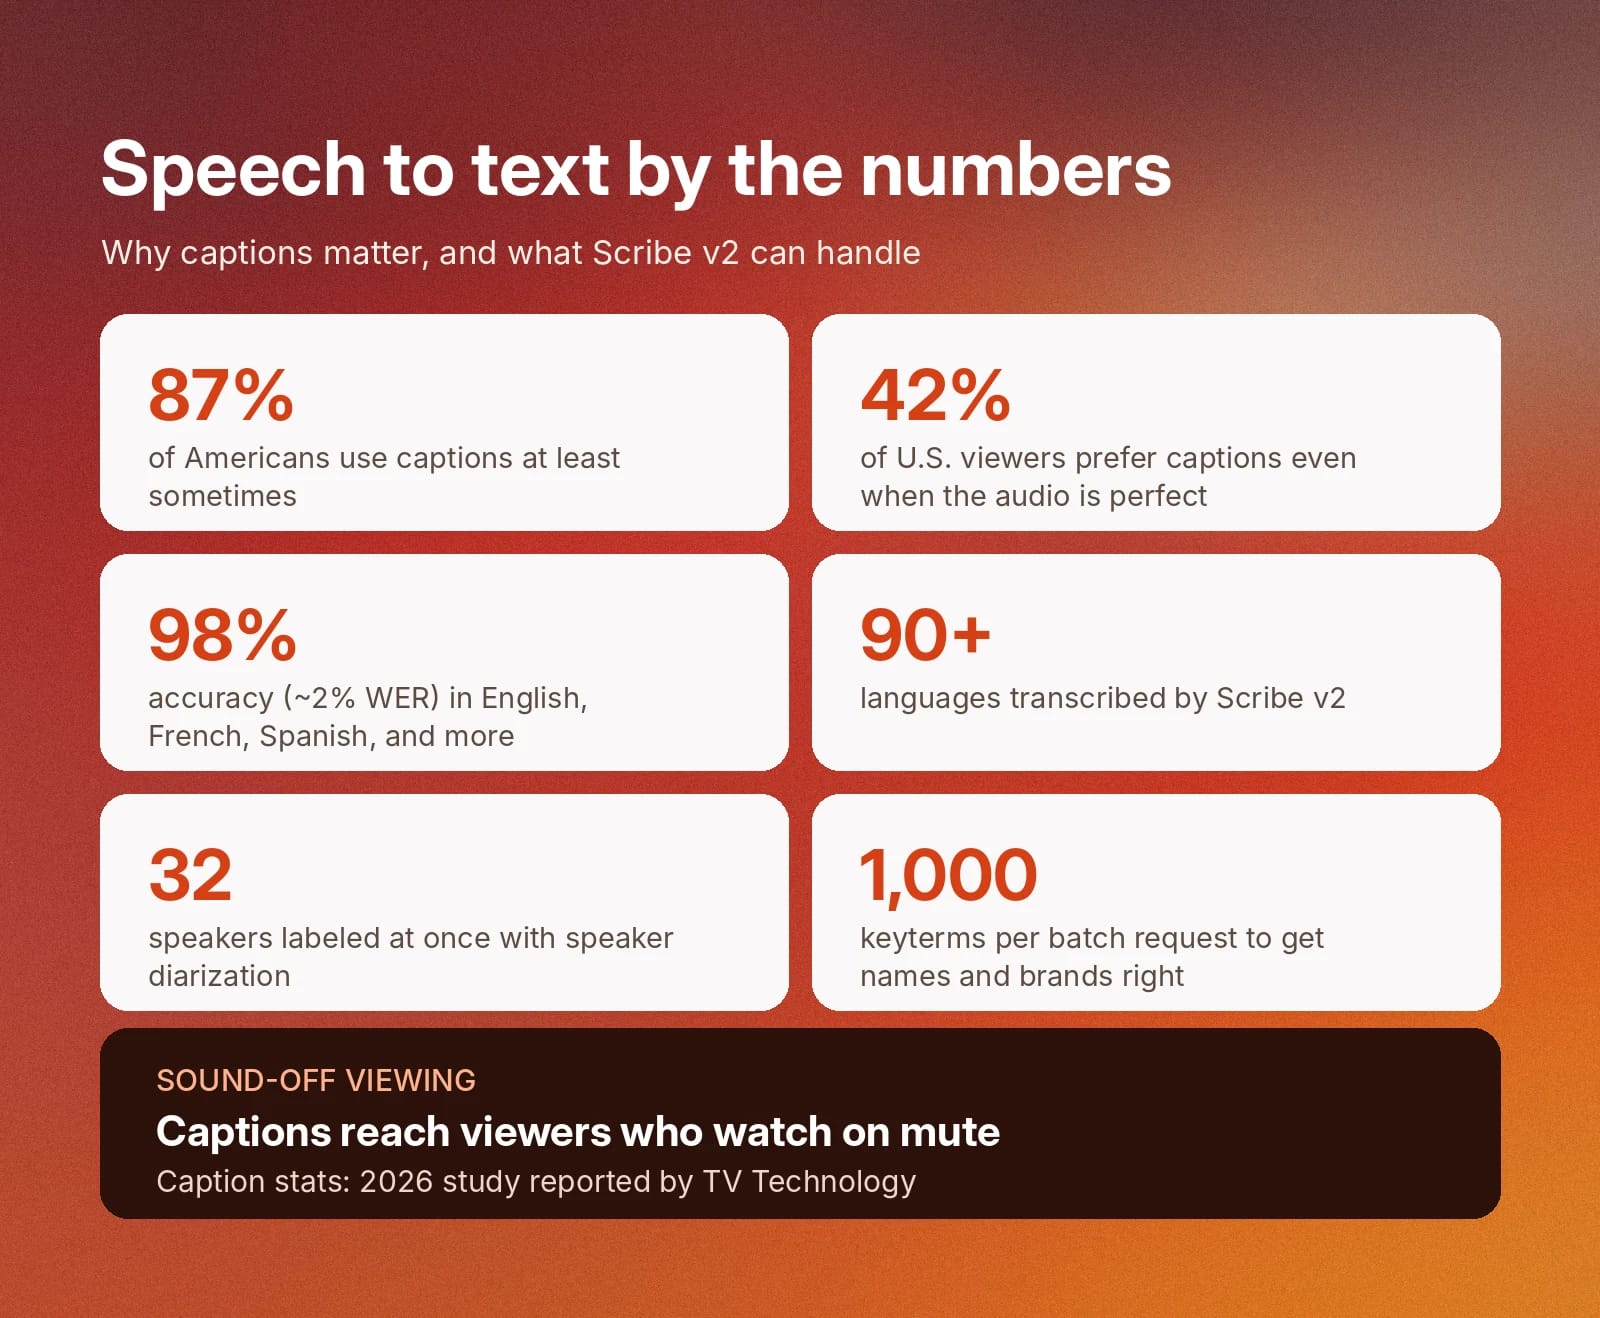
Das Ansehen ohne Ton ist für viele Social-Media-Nutzer zum Standard geworden, besonders in der Öffentlichkeit oder wenn keine Kopfhörer verfügbar sind. Eine Studie aus dem Jahr 2026 ergab, dass 87 % der Amerikaner beim Ansehen von Videos zumindest gelegentlich Untertitel nutzen.
Tatsächlich bevorzugen 42 % der US-Zuschauer Untertitel, selbst wenn der Ton eines Videos bereits perfekt ist. Das zeigt, wie sehr Untertitel für jedes Video Ihre Inhalte attraktiver machen.
Speech to Text-Modelle transkribieren Ihre Social-Media-Videos für die Erstellung von Captions und Untertiteln. ElevenLabs Caption Generator erstellt Transkripte mit Zeitstempeln auf Wort- und Zeichenebene, damit sie mit der Sprache in Ihrem Video synchronisiert sind. Diese Zeitstempel bleiben erhalten, selbst wenn Sie das Originalvideo für verschiedene Plattformen in kürzere Clips schneiden.
Untertitel lassen sich auch als SRT- und VTT-Dateien exportieren. So können Sie sie direkt in soziale Medien oder auf Ihre bevorzugte Videobearbeitungsplattform hochladen. Achten Sie bei der Videobearbeitung darauf, die Zeilenumbrüche an den Fluss des Gesprächs anzupassen.
SRT vs. VTT: Welche Untertiteldatei sollten Sie exportieren?
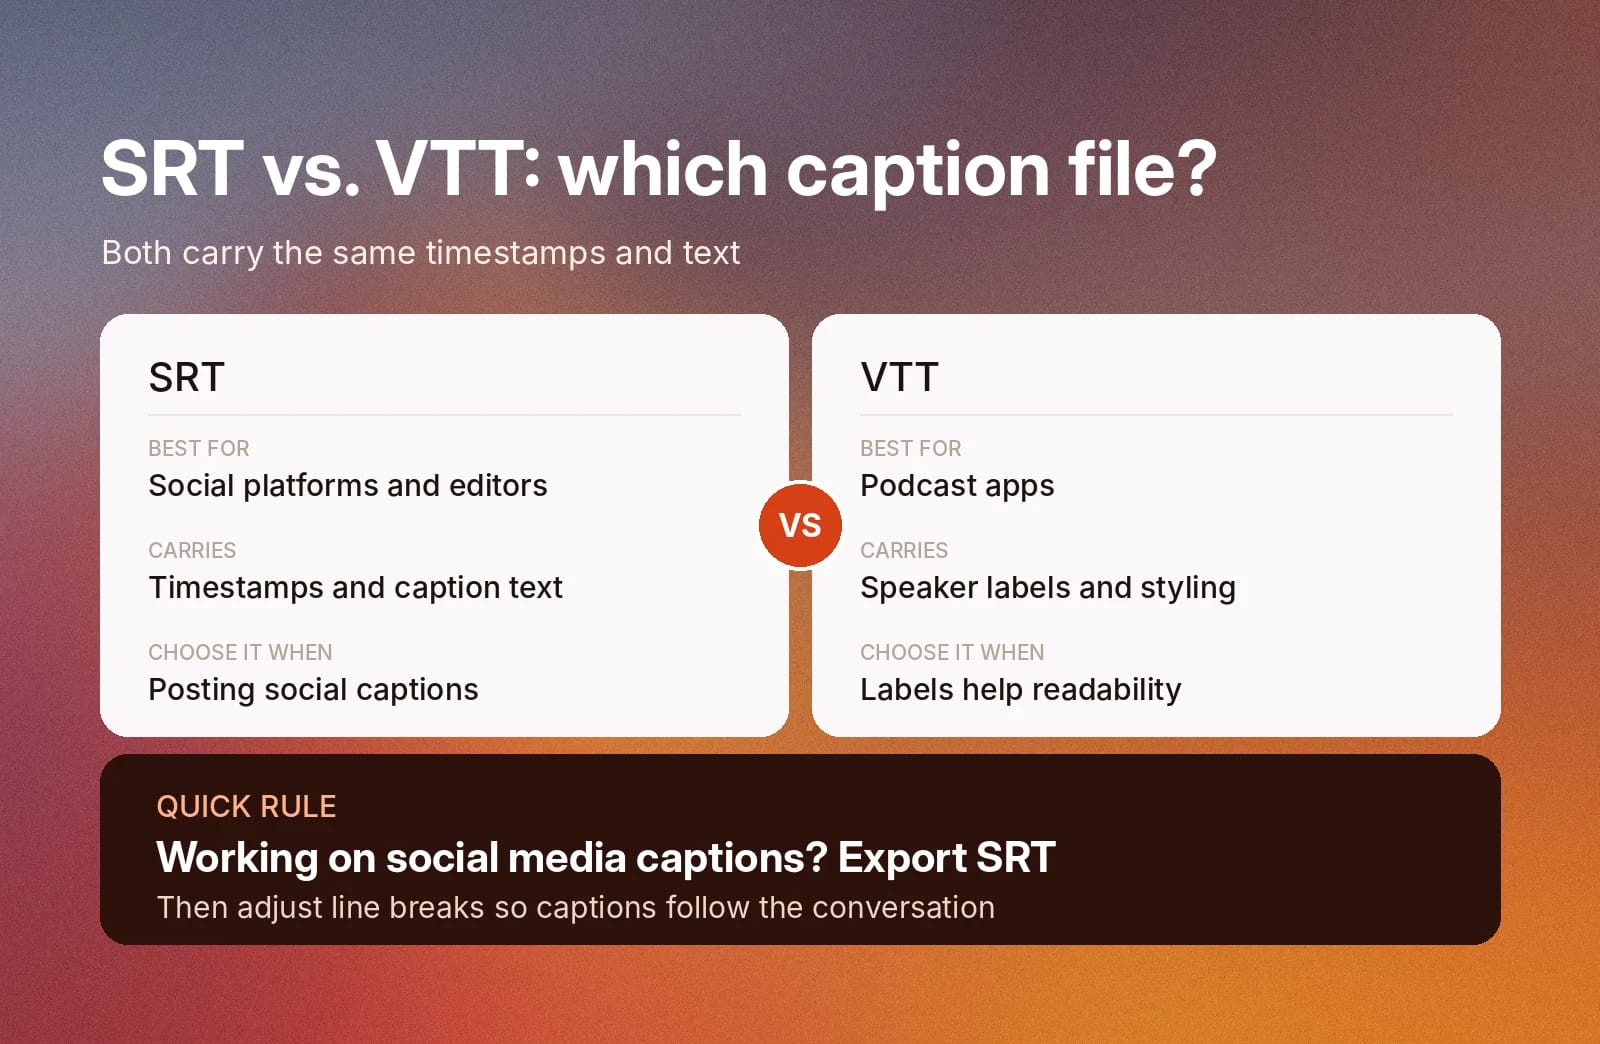
SRT und VTT enthalten dieselben Zeitstempel und Texte.
Wann Sie welches Format wählen sollten:
- Exportieren Sie SRT, wenn Sie eine einfache Datei benötigen, die von den meisten sozialen Plattformen und Videobearbeitungsprogrammen unterstützt wird.
- Exportieren Sie VTT, wenn Sie Captions oder Transkripte in Podcast-Apps veröffentlichen. Das Format kann Sprecherkennzeichnungen und einfache Formatierungen hinzufügen, die die Lesbarkeit verbessern.
Für Social-Media-Untertitel ist SRT wahrscheinlich die richtige Wahl.
Bereinigte vs. wörtliche Transkription für Social-Media-Untertitel
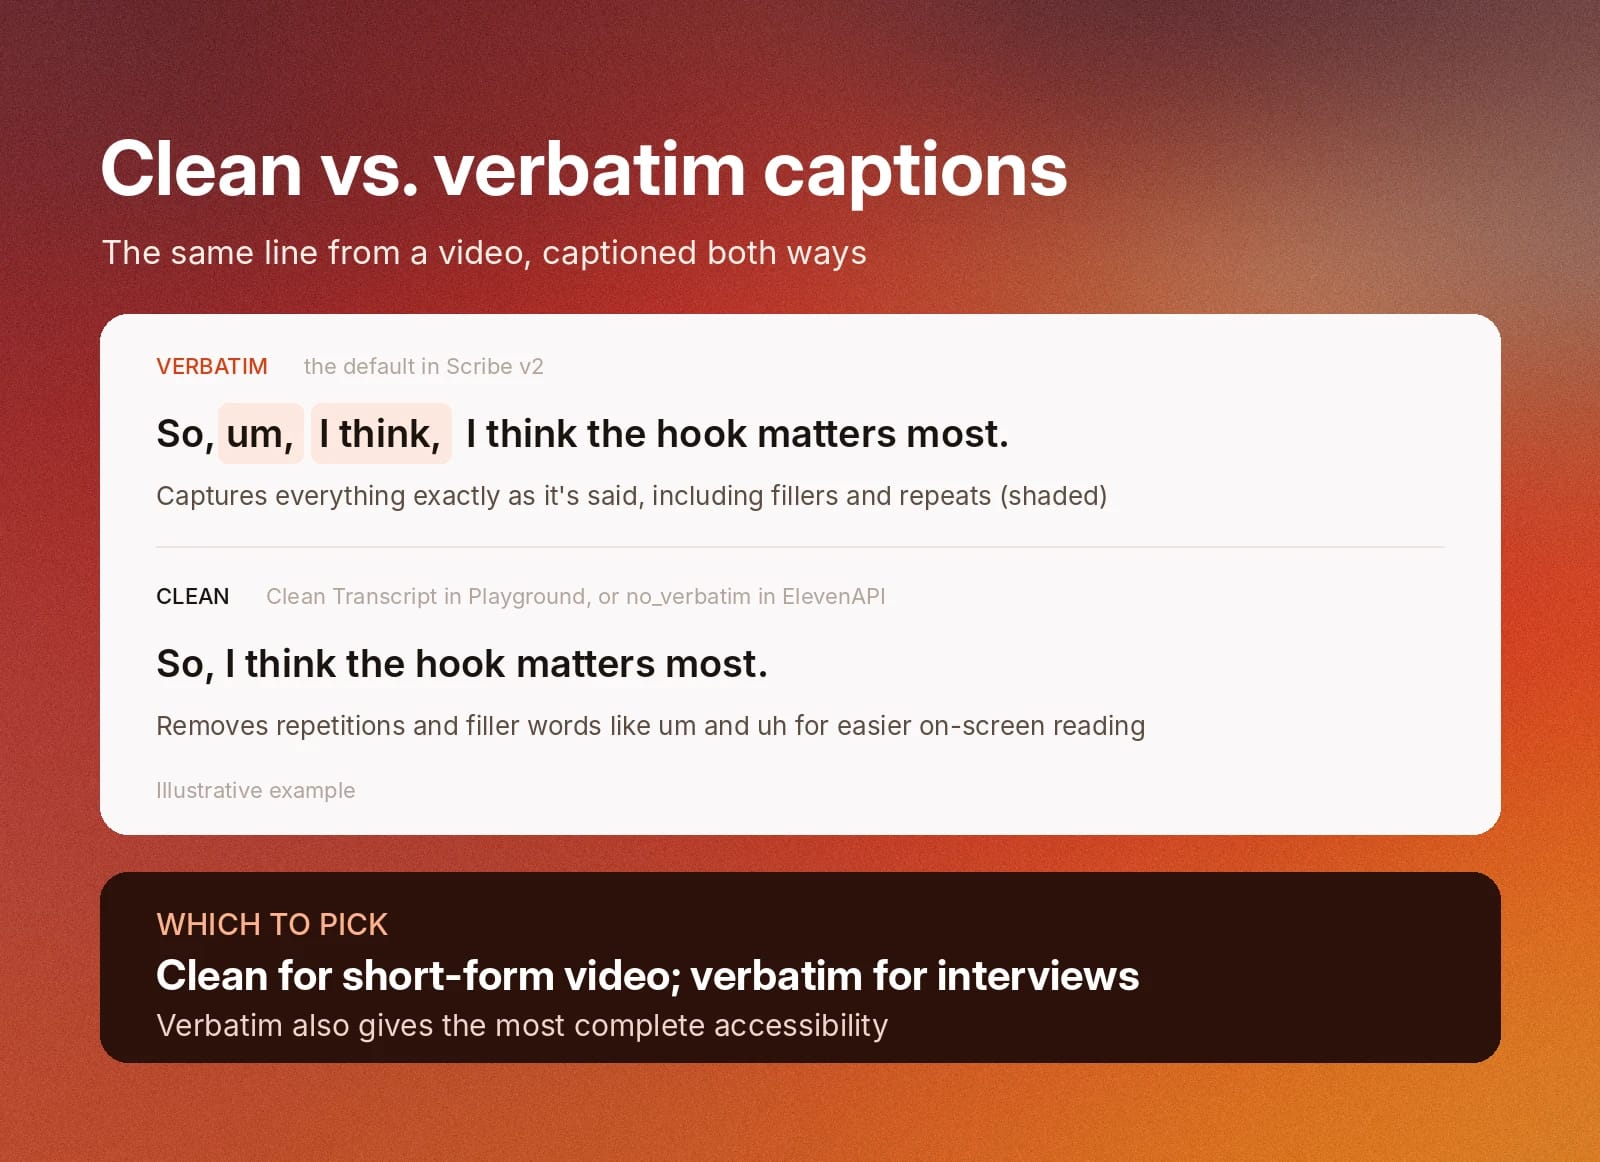
Bei Social-Media-Untertiteln können Sie zwischen bereinigter und wörtlicher Transkription wählen. Die bereinigte Transkription entfernt Wiederholungen und Füllwörter wie „ähm“, während die wörtliche Transkription alles genau so erfasst, wie es gesagt wird.
Bereinigte Untertitel lassen sich auf dem Bildschirm leichter lesen, wörtliche Untertitel sind jedoch besser für vollständige Barrierefreiheit. Welche Option richtig ist, hängt von Ihrem Publikum und dessen individuellen Bedürfnissen ab.
ElevenLabs Scribe v2 verwendet standardmäßig die wörtliche Transkription. Sie können jedoch zur bereinigten Transkription wechseln, indem Sie in ElevenLabs Playground „Clean Transcript“ aktivieren oder den Parameter no_verbatim mit ElevenAPI verwenden.
Wählen Sie die bereinigte Transkription für Kurzvideos, bei denen Zuschauer Ihre Inhalte wahrscheinlich beim Durchsehen eines Videos lesen. Die wörtliche Transkription eignet sich am besten für längere Interviews oder Forschungsszenarien, in denen der genaue Wortlaut wichtig ist.
Podcasts für Shownotes transkribieren und weiterverwenden
Ihr Podcast ist die Grundlage Ihrer gesamten Content-Strategie. Um ein größeres Publikum zu erreichen, verwandeln Sie die Ideen aus jeder Episode in Shownotes, Blogs, Newsletter und kurze Social-Media-Inhalte.
Speech-to-Text-Tools helfen Ihnen, Ihre Podcast-Episoden für die einfache Weiterverwendung zu transkribieren. Nach der Transkription können Sie daraus Shownotes erstellen, auf die Ihr Publikum jederzeit zurückgreifen kann.
Sie können auch Abschnitte jedes Transkripts in Blog- und Newsletter-Inhalte verwandeln, statt Artikel von Grund auf zu schreiben. So erreichen Sie Zielgruppen, die lieber lesen als zuhören.
Schriftliche Inhaltsbibliotheken sind leicht durchsuchbar. Wenn Ihr Publikum eine Idee aus einer früheren Episode noch einmal aufgreifen möchte, muss es nur Ihre Shownotes oder Ihren Blog durchsuchen. Schriftliche Inhalte erscheinen außerdem eher in Suchergebnissen als Audioinhalte und erhöhen damit Ihre Online-Sichtbarkeit.
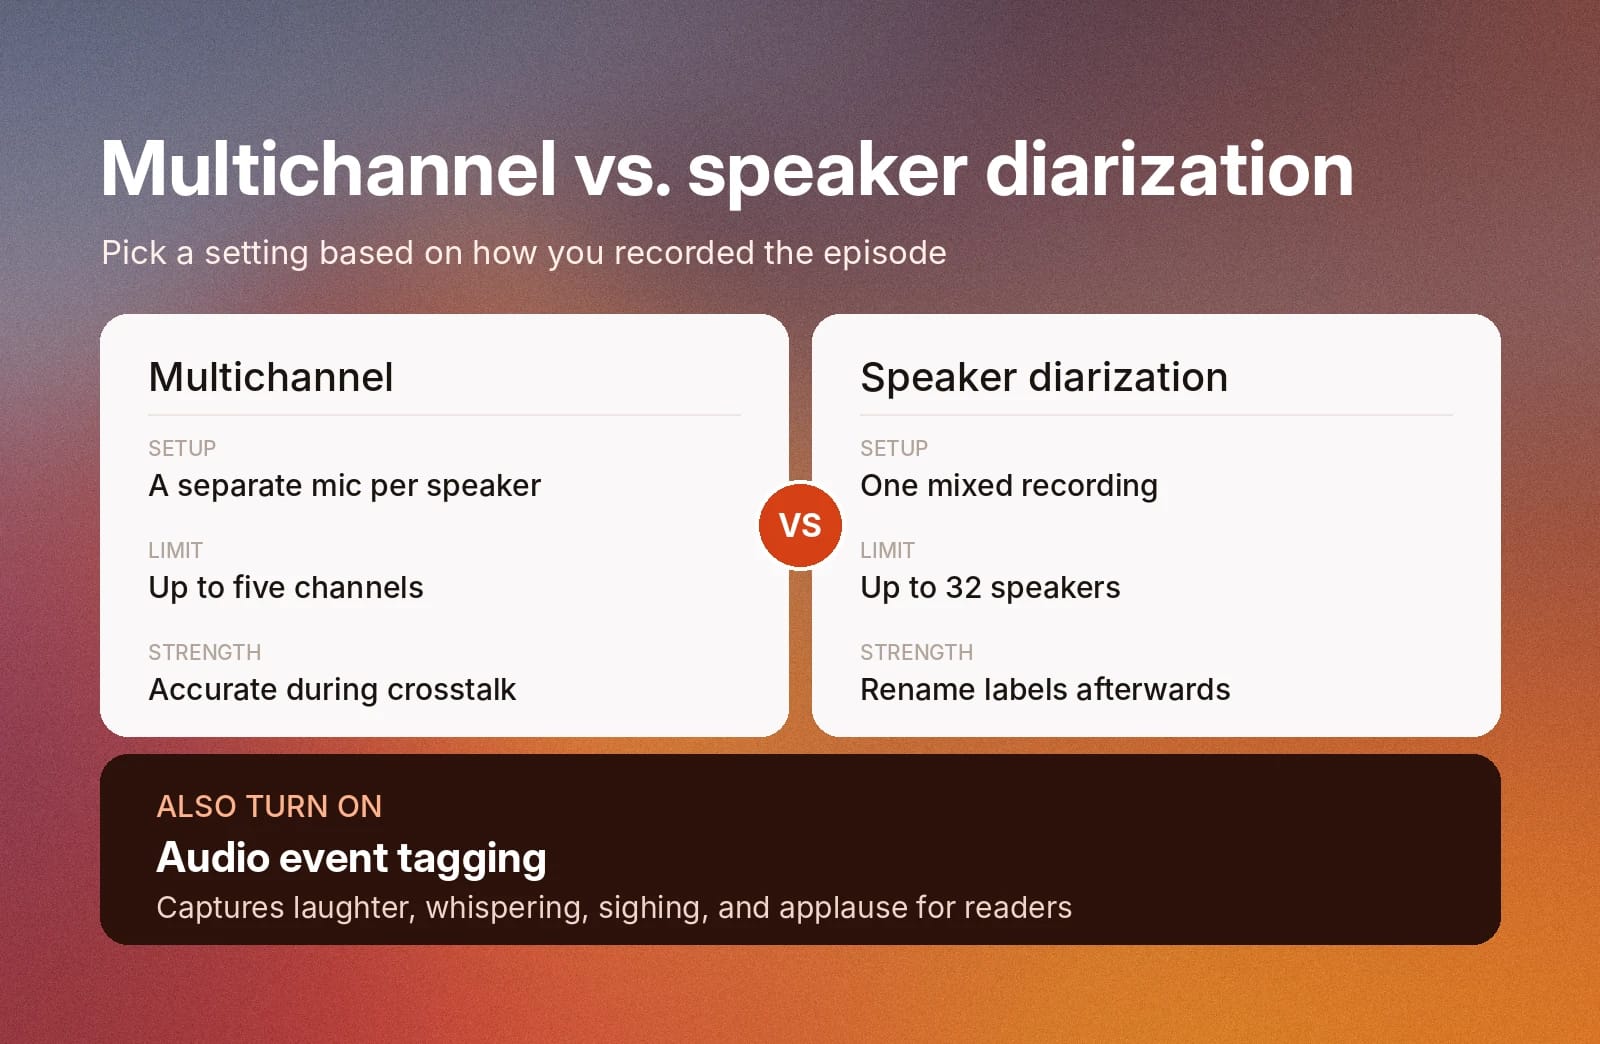
Podcasts transkribieren Sie am effizientesten mit einer Einrichtung für Mehrkanal-Transkription. Verwenden Sie dafür ein separates Mikrofon pro Sprecher. Das Transkriptionsmodell transkribiert jeden Sprecher getrennt, sodass Sie auch bei überlappenden Beiträgen präzise Ergebnisse erhalten.
Aktivieren Sie beim Transkribieren von Podcasts außerdem die Kennzeichnung von Audioereignissen. Diese Einstellung erfasst Lachen, Flüstern, Seufzen oder Applaus, damit Leser den vollständigen Kontext erhalten. Aktivieren Sie dazu in ElevenLabs Speech to Text „Tag Audio Events“ oder verwenden Sie den Parameter tag_audio_events mit ElevenAPI.
Sprecher in einer einzelnen Aufnahme identifizieren
Die Mehrkanal-Transkription unterstützt bis zu fünf Kanäle. Wenn Sie alle Stimmen auf einer gemischten Spur aufnehmen oder mehr Stimmen als Kanäle haben, aktivieren Sie stattdessen Sprecherdiarisierung. Scribe v2 kennzeichnet jeden Sprecher im Transkript und unterstützt bis zu 32 Sprecher gleichzeitig. Nach der Transkription können Sie Sprecher umbenennen, indem Sie im ElevenLabs-Dashboard auf die Schaltfläche zum Bearbeiten neben der Sprecherbezeichnung klicken.
Aufnahmen in Clips, Blogs und Newsletter weiterverwerten
Ein Interview transkribieren Sie einmal und verwenden Sie es für jeden Kanal weiter, auf dem Sie veröffentlichen.
Dasselbe Transkript liefert die Untertitel und das Rohmaterial für Clips und schriftliche Inhalte. Creator und Unternehmen auf der ganzen Welt nutzen ElevenLabs STT, um den Prozess vom Podcast zu schriftlichen Inhalten zu beschleunigen.
Jeder Podcast, jede Keynote und jedes Interview, das ich mache, läuft durch Speech to Text. Ein Transkript liefert mir präzise Untertitel für alles, die besten Momente für kurze Videoclips und zentrale Zitate, die ich in schriftliche Inhalte verwandle.
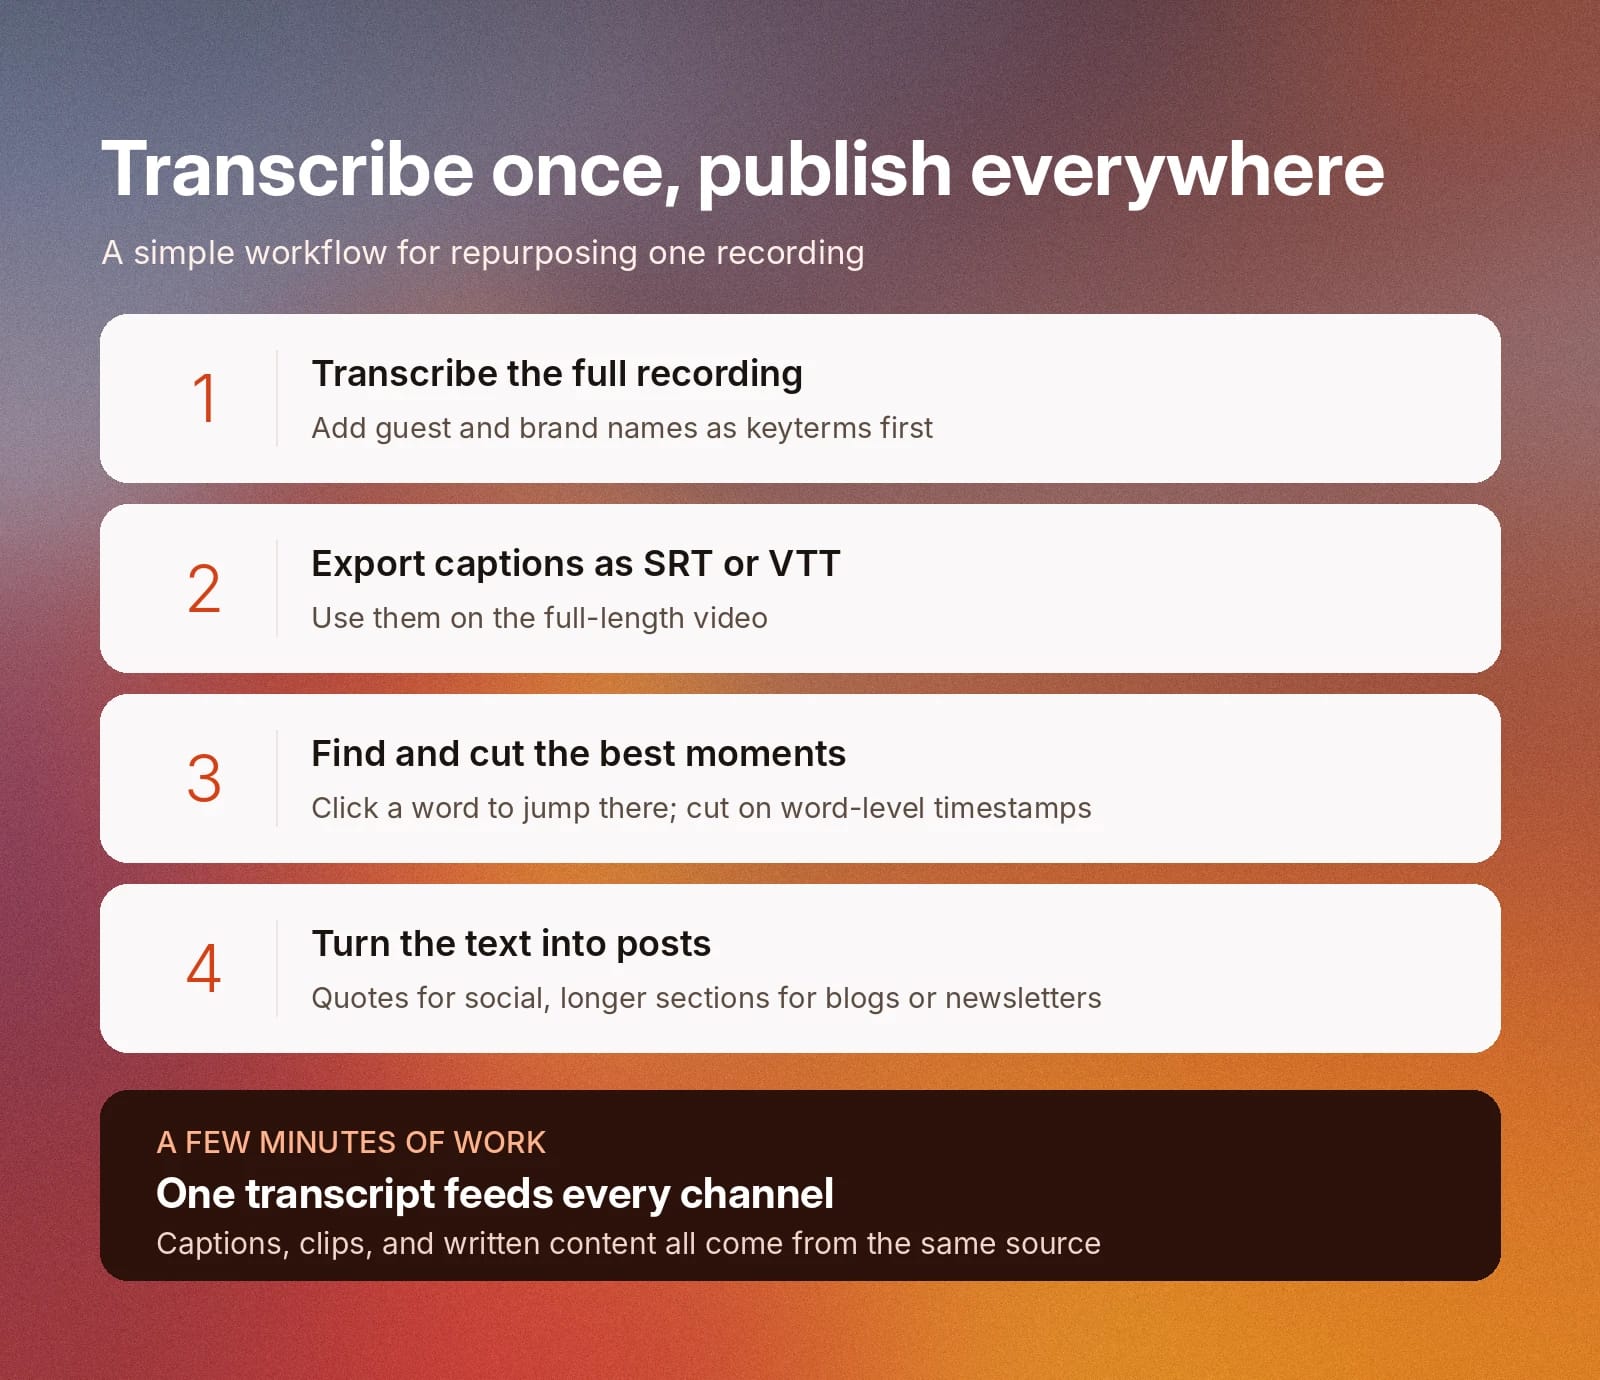
Hier ist ein einfacher Workflow zur Weiterverwertung:
- Transkribieren Sie die vollständige Aufnahme und ergänzen Sie Namen von Gästen und Marken in Ihrem Aussprachewörterbuch.
- Exportieren Sie die Untertitel als SRT oder VTT und verwenden Sie sie für das vollständige Video.
- Lesen Sie das Transkript auf die stärksten Momente hin durch. Klicken Sie auf ein Wort im Transkript, um zu dieser Stelle im Audio zu springen. Verwenden Sie dann die Zeitstempel auf Wortebene, um jeden Clip exakt am Anfang und Ende zu schneiden.
- Kopieren Sie zentrale Zitate in Social-Media-Posts und bearbeiten Sie längere Abschnitte zu einem Blogbeitrag oder Newsletter.
Aus Ihren STT-Podcast-Transkriptionen erstellen Sie in wenigen Minuten Inhalte im Langformat.
Videos für LLM-Analysen in Transkripte umwandeln
Nachdem Sie Ihre Videos in Text umgewandelt haben, können Sie Ihre Inhalte gesammelt zur Analyse in ein LLM hochladen. Identifizieren Sie neue Ideen, heben Sie Gesprächspunkte für die Weiterverwertung hervor oder finden Sie einfach heraus, was an Ihren Inhalten funktioniert.
Alles, was ich erstelle, beginnt mit meiner Stimme, aber die meisten meiner KI-Tools funktionieren immer noch am besten mit Text. ElevenLabs Scribe ist meine Übersetzungsschicht: Es verwandelt meine Videos in Transkripte, damit jedes LLM analysieren kann, was funktioniert und was nicht. Meiner Meinung nach schließt das eine der größten Lücken der KI.
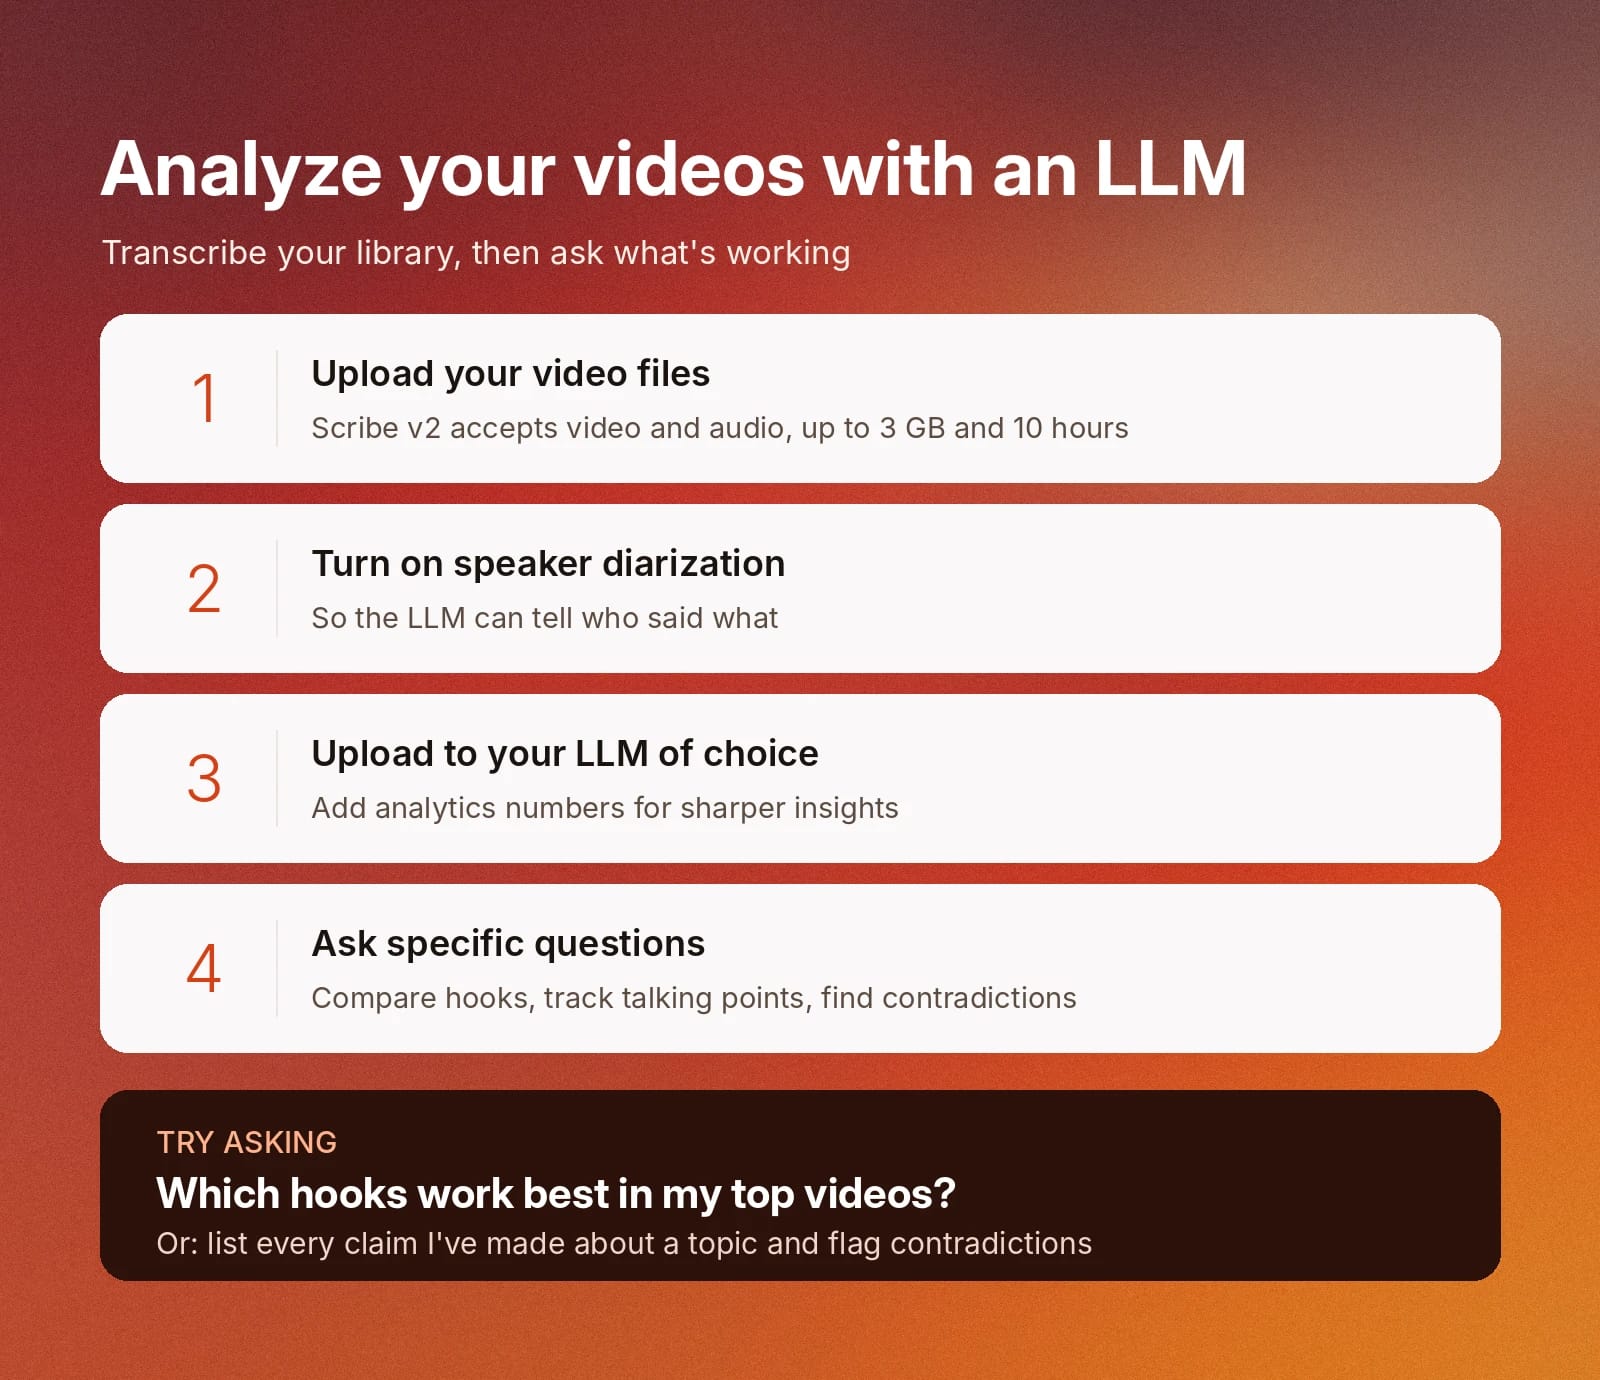
So richten Sie einen ähnlichen Workflow ein:
- Videodateien zur Transkription hochladen: ElevenLabs STT akzeptiert Video- ebenso wie Audiodateien mit bis zu 3 GB und einer Länge von bis zu 10 Stunden.
- Sprecherdiarisierung aktivieren: Wenn mehr als eine Person spricht, aktivieren Sie die Diarisierung, damit das LLM erkennen kann, wer was gesagt hat.
- In Ihr bevorzugtes LLM hochladen: Fügen Sie Analysezahlen oder weitere Informationen hinzu, um bessere Erkenntnisse zu gewinnen.
- Stellen Sie konkrete Fragen zu Ihren Inhalten: Fragen wie „Vergleiche die ersten 20 Sekunden meiner erfolgreichsten Videos, um herauszufinden, welche Hooks bei meinem Publikum am besten funktionieren“ oder „Liste jede Aussage auf, die ich zu Thema X gemacht habe, und markiere Widersprüche“ können neue Erkenntnisse liefern.
Prompts und Notizen diktieren
Mit Spracheingabe können Sie einem KI-Tool den Hintergrund und die Nuancen geben, die Sie beim vollständigen Tippen vielleicht auslassen würden. Speech to Text wandelt Gesagtes in Text um, den Sie direkt in einen Prompt, ein Briefing oder Ihre Notizen einfügen können. Einige Autoren nutzen STT inzwischen, um schneller zu schreiben, indem sie Sprache transkribieren, statt alles abzutippen.
Ich kann mir nicht vorstellen, ohne sie zu arbeiten, besonders beim Prompting. In jede Interaktion mit KI müssen so viele Nuancen einfließen, und ich möchte das nicht alles tippen.
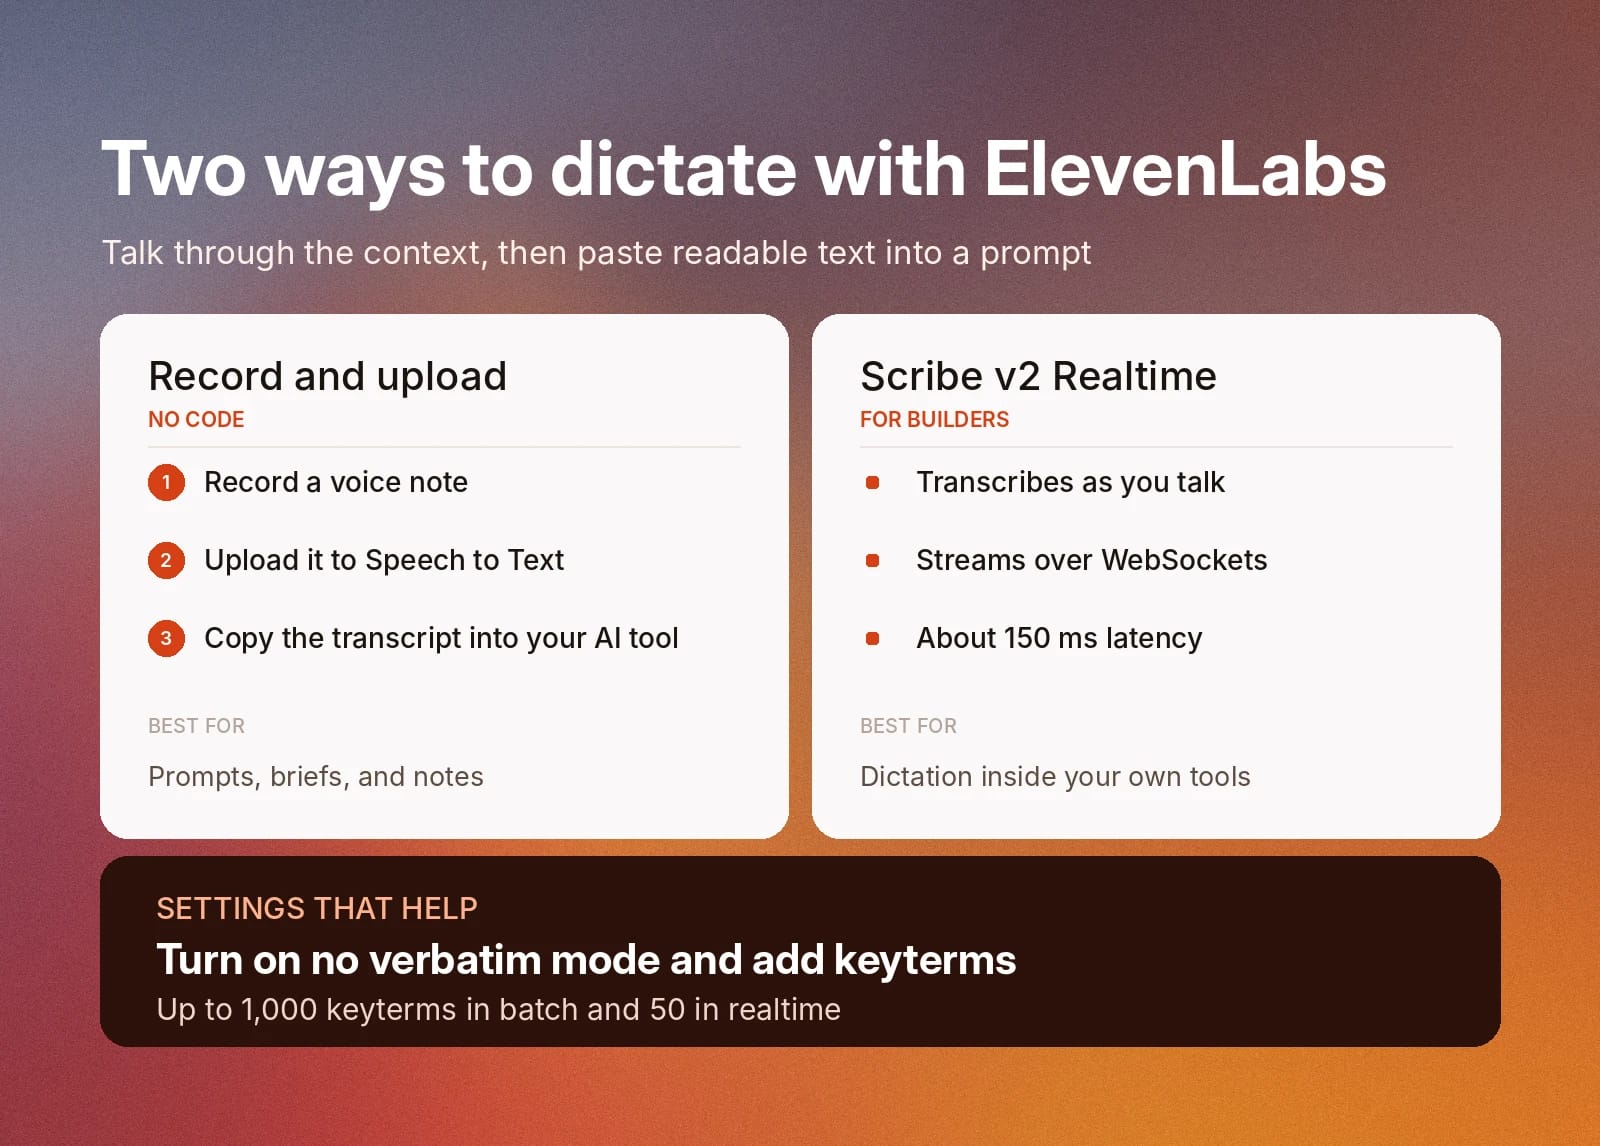
Es gibt zwei Möglichkeiten, mit ElevenLabs zu diktieren:
- Aufnehmen und hochladen: Nehmen Sie eine Sprachnotiz auf, laden Sie sie auf die ElevenLabs-Speech-to-Text-Seite hoch und kopieren Sie das Transkript in Ihr KI-Tool.
- In Echtzeit streamen: Wenn Sie eigene Tools entwickeln, Scribe v2 Realtime transkribiert Sprache während des Sprechens über WebSockets, laut Dokumentation mit einer geringen Latenz von etwa 150 ms.
Aktivieren Sie den Modus no verbatim, der Füllwörter, Fehlstarts und Sprechunflüssigkeiten entfernt, damit eine ausschweifende Sprachnotiz als lesbarer Text ankommt. Ergänzen Sie anschließend Produktnamen und Fachjargon, die Sie häufig verwenden, mit Keyterm Prompting, damit sie jedes Mal korrekt transkribiert werden. Die Batch-Transkription unterstützt bis zu 1.000 Keyterms, die Echtzeittranskription bis zu 50.
Namen, Marken und Nischenbegriffe mit STT korrekt erfassen
Speech-to-Text-Modelle erkennen Namen von Sprechern, Markennamen oder branchenspezifische Begriffe nicht immer. Nutzen Sie beim Transkribieren Ihrer Inhalte Keyterm Prompting, um Schreibweise und Formatierung zu präzisieren.
Mit Keyterm Prompting können Sie vor Beginn der Transkription die korrekte Schreibweise für Namen oder Nischenbegriffe angeben. Fügen Sie für jedes Video oder jede Podcast-Episode die Namen von Gästen, Kanälen oder Marken hinzu, die Sie häufig erwähnen. Möglicherweise müssen Sie auch Fachjargon oder andere Nischenbegriffe ergänzen.
Keyterm Prompting macht Ihre Transkripte präziser und für Ihr Publikum leichter lesbar. Außerdem beschleunigt es die Bearbeitung, weil Sie diese Begriffe nicht manuell korrigieren müssen.
Zielgruppen in anderen Sprachen erreichen
Speech-to-Text-Modelle leisten mehr als Transkription. Als Content Creator können Sie sie auch nutzen, um Ihre Inhalte zu lokalisieren und Zielgruppen zu erreichen, die andere Sprachen sprechen.
ElevenLabs Scribe v2 transkribiert Inhalte in über 90 Sprachen. Kombinieren Sie es mit dem ElevenLabs Synchronisationsstudio, um einen vollständigen Lokalisierungs-Workflow aufzubauen.
Laden Sie dazu das Audio in das Synchronisationsstudio hoch, um Inhalte in Ihrer gewünschten Sprache zu synchronisieren. Transkribieren Sie anschließend das synchronisierte Audio, um lokalisierte Untertitel, Shownotes oder andere schriftliche Inhalte zu erstellen.
Was Speech to Text nicht für Sie erledigt
Speech to Text ist ein leistungsstarkes Tool, hat aber Grenzen. Speech-to-Text-Modelle transkribieren Audio zwar mit präzisen Zeitstempeln, sind jedoch keine Videoeditoren. Für das Endprodukt benötigen Sie eine separate Videobearbeitungsplattform.
Beginnen Sie bei der Content-Erstellung mit Speech to Text, um das Audio zu transkribieren. Exportieren Sie dann sowohl das Rohtranskript als auch die Untertitel zur Verwendung in Ihren Inhalten. Laden Sie die Untertitel in Ihren Videoeditor oder direkt in soziale Medien hoch und nutzen Sie das Transkript als Grundlage für Shownotes, Blogbeiträge und andere schriftliche Assets.
Prüfen Sie jedes Transkript vor der Veröffentlichung, insbesondere Namen und Passagen, in denen Sprecher gleichzeitig sprechen. Im Transcript Editor können Sie Fehler direkt in der App einfach korrigieren.
So wählen Sie als Content Creator das beste Speech-to-Text-Tool
Das richtige STT-Tool verwandelt Ihre Aufnahme in sauberen, korrekt geschriebenen Text mit Zeitstempeln, die die Weiterverwertung von Inhalten so einfach wie möglich machen.
Achten Sie bei der Suche nach der besten Speech-to-Text-Plattform auf diese fünf Punkte:
- Genauigkeit in Ihrer Sprache: Die STT-Leistung kann je nach Sprache variieren, insbesondere bei Sprachen mit weniger verfügbaren Daten. Achten Sie auf veröffentlichte Angaben zur Genauigkeit. Zum Beispiel hat ElevenLabs Scribe v2 eine Genauigkeit von 98 % (~2 % WER) in Sprachen wie Englisch, Französisch, Italienisch, Spanisch und weiteren.
- Umgang mit Namen und Fachjargon: Ihr STT-Modell muss den Kontext Ihrer Gespräche verstehen und sie präzise transkribieren können. Suchen Sie nach STT-Plattformen mit Keyterm Prompting und Aussprachewörterbüchern.
- Zeitstempel und Exportformate: Sie benötigen Zeitstempel auf Wortebene sowie die Möglichkeit, Untertitel als SRT oder VTT zu exportieren.
- Sprechererkennung: Besonders bei Audio mit mehreren Sprechern sorgt die präzise Unterscheidung der einzelnen Stimmen für klare Transkripte.
- Dateilimits: Bei größeren Audio- oder Videoprojekten wie Podcasts müssen Sie möglicherweise mit größeren Dateigrößen arbeiten. ElevenLabs akzeptiert Dateien bis zu 3 GB und im Standardmodus bis zu 10 Stunden Länge.
So schneidet ein dediziertes STT-Modell wie Eleven Scribe v2 im Vergleich zu den automatischen Untertiteltools sozialer Plattformen ab:
Was Sie benötigen
Automatische Plattformuntertitel
Dediziertes Modell wie Scribe v2
Korrekte Schreibweise von Namen und Marken
Kann Fehler enthalten
Keyterm Prompting, bis zu 1.000 Begriffe pro Batch-Anfrage
Lesbare Zeichensetzung
Oft eingeschränkt
Saubere Ausgabe mit no-verbatim-Modus
Text anderweitig weiterverwenden
Untertitel bleiben auf der Plattform
Transkript und Untertitel herunterladen und überall verwenden
Zeitsteuerung
An den Player dieser Plattform gebunden
Zeitstempel auf Wortebene, die Sie in Clips übernehmen können
Sprachen
Je nach Plattform unterschiedlich
Über 90 Sprachen
Zwei Wege für den Einstieg: Upload ohne Code oder API
Mit ElevenLabs können Sie Ihre Videoinhalte auf zwei Arten mit Speech to Text transkribieren.
Die erste Möglichkeit ist, Ihre Audiodatei in das Dashboard von ElevenLabs Playground hochzuladen. Passen Sie Ihre Transkriptionseinstellungen an, bearbeiten Sie die Ausgabe direkt im Transcript Editor und exportieren Sie sie dann im benötigten Dateiformat. Der Prozess ist schnell und einfach und erfordert keinen Code.
Wenn Sie einen eigenen Workflow für die Veröffentlichung von Inhalten entwickeln, können Sie auch mit ElevenAPI transkribieren. Fügen Sie die API direkt zu den Tools hinzu, die Sie bereits entwickeln, um dieselben präzisen Transkriptionen zu erhalten, ohne zwischen Tools wechseln zu müssen.
Bei ElevenLabs registrieren, um noch heute mit STT zu beginnen, oder mehr erfahren darüber, wie Speech to Text für Creator neue Möglichkeiten schafft.
FAQ

Jack Limebear ist Teil des Growth-Teams und arbeitet als Content Writer und Stratege für Blog- und Insights-Seiten. Vor ElevenLabs leitete er über zehn Jahre die Content-Strategie für Unternehmen – von schnell wachsenden SaaS-Startups bis zu Fortune-500-Konzernen. Er hat einen Masterabschluss in Englischer Literatur von der University of Cambridge.



