Scribe v2 Medical ist jetzt für alle verfügbar
- Verfasst von
- Min Kim
- Veröffentlicht
- Zuletzt aktualisiert
AnhörenArtikel anhören
Klinische Audiodaten sind eine der größten Herausforderungen für präzise Spracherkennung. Medikamentennamen sind lang, selten und leicht zu verwechseln (zwischen Hydroxyzin und Hydralazin liegt nur eine falsch verstandene Silbe). Das Vokabular ist dicht: Dosierungen, Einheiten sowie Begriffe aus Anatomie und Pathologie können in schneller Folge auftreten. Außerdem steht mehr auf dem Spiel, denn ein Transkriptionsfehler könnte in der Patientenakte landen.
Deshalb veröffentlicht ElevenLabs heute Scribe v2 Medical, unser für klinische Audiodaten feinabgestimmtes Speech-to-Text-Modell, das jetzt allgemein über die ElevenAPI verfügbar ist. In den unten dargestellten Evaluierungen erzielt es durchgehend eine der niedrigsten Wortfehlerraten (WER) unter den verglichenen Modellen und senkt die WER bei klinischen Audiodaten gegenüber unserem Basismodell Scribe v2 um etwa 35 %.
Allzweckmodelle verarbeiten Alltagssprache gut, können aber gerade dort an Leistung verlieren, wo klinische Arbeitsabläufe sie am dringendsten benötigen. Wir haben ein medizinisches Finetune von Scribe v2 für Medikamentennamen und klinische Diktate trainiert – auf öffentlichen Benchmarks, die jeder reproduzieren kann.
Scribe v2 Medical ist für klinische Anwendungsfälle optimiert
Klinische Diktate (MedDictate)
Cortis MedDictate testet die Transkription diktierter klinischer Notizen, die auf Englisch, Französisch und Deutsch unmittelbar aufeinanderfolgende Medikamentennamen, Dosierungen und Einheiten enthalten. In unserer Evaluierung erzielt Scribe v2 Medical die niedrigste Gesamt-WER unter den getesteten Modellen und eine gegenüber Scribe v2 um etwa 35 % niedrigere WER.
Modell
EN
FR
DE
Gesamt-WER
Scribe v2 Medical
3.0%
8.3%
7.2%
4.9%
OpenAI GPT Transcribe
3.9%
7.8%
9.6%
5.9%
Scribe v2 (Basis)
5.0%
10.7%
11.7%
7.6%
Muse Voice Transcribe 1.0
4.5%
11.0%
13.3%
7.8%
Deepgram Nova-3 Medical*
5.5%
-
-
-
*Nur Englisch (24 Clips) – Deepgram Nova-3 Medical unterstützt weder Französisch noch Deutsch.
Medizinische Terminologie (MedTerm)
MedTerm ist ebenfalls ein von Corti veröffentlichter Datensatz. Er umfasst einen Benchmark zur klinischen Terminologie mit 600 Beispielen in denselben drei Sprachen, bei dem die medizinischen Begriffe in jedem Beispiel annotiert sind. Diese Annotation ermöglicht die Bewertung von Modellen in zwei Dimensionen zusätzlich zur WER des gesamten Transkripts. Die Begriffserkennung ist der Prozentsatz annotierter medizinischer Begriffe, die im Transkript korrekt erscheinen (höher ist besser). Die Term-WER ist die Fehlerrate nur für diese Begriffe, ohne die umgebende Alltagssprache zu berücksichtigen (niedriger ist besser).
Scribe v2 Medical führt bei beiden Dimensionen unter allen getesteten Modellen und liegt in allen drei Sprachen vor allen anderen Anbietern:
Modell
Begriffserkennung ↑
Term-WER ↓
Scribe v2 Medical
77.7%
10.4%
Scribe v2 (Basis)
77.1%
10.7%
OpenAI GPT Transcribe
74.0%
12.3%
Muse Voice Transcribe 1.0
73.4%
12.9%
Deepgram Nova-3 Medical*
72.5%
13.6%
Eka Medical ASR-Benchmark
Der Eka Medical ASR-Benchmark enthält 3.619 englischsprachige klinische Audiobeispiele – von einzelnen Medikamenten- und Krankheitsnamen über klinische Sätze bis zu Gesprächen zwischen medizinischem Personal und Patienten – mit Annotationen pro Begriff und einer veröffentlichten Bestenliste auf der Datensatzkarte.
Da der veröffentlichte Datensatz ältere Modelle wie Gemini 2.5 Flash und GPT-4o enthält, führten wir die Evaluierung mit neueren Modellen durch. SemWER (semantische WER) bewertet, ob das Modell den richtigen Inhalt erkannt hat, unabhängig von der Formatierung („mg“ und „Milligramm“ gelten als dieselbe Antwort). kwWER (Keyword-WER) wendet dieselbe Bewertung nur auf die annotierten medizinischen Schlüsselwörter an.
Modell
semWER
kwWER
Scribe v2 Medical
6.50%
6.02%
Scribe v2 (Basis)
7.35%
7.04%
Deepgram Nova-3 Medical
7.79%
7.65%
Muse Voice Transcribe 1.0
8.85%
8.99%
OpenAI GPT Transcribe
13.90%
13.20%
Eka annotiert die medizinischen Begriffe in jedem Beispiel. So lassen sich die Verbesserungen von Scribe v2 Medical gegenüber dem Basismodell allein bei den medizinischen Begriffen detaillierter bewerten. Scribe v2 Medical macht 15 % weniger Fehler als das Basismodell (9,5 % gegenüber 11,1 %), wobei die Verbesserungen am größten sind, wenn Begriffe in vollständigen klinischen Sätzen vorkommen (7,5 % gegenüber 9,9 %).
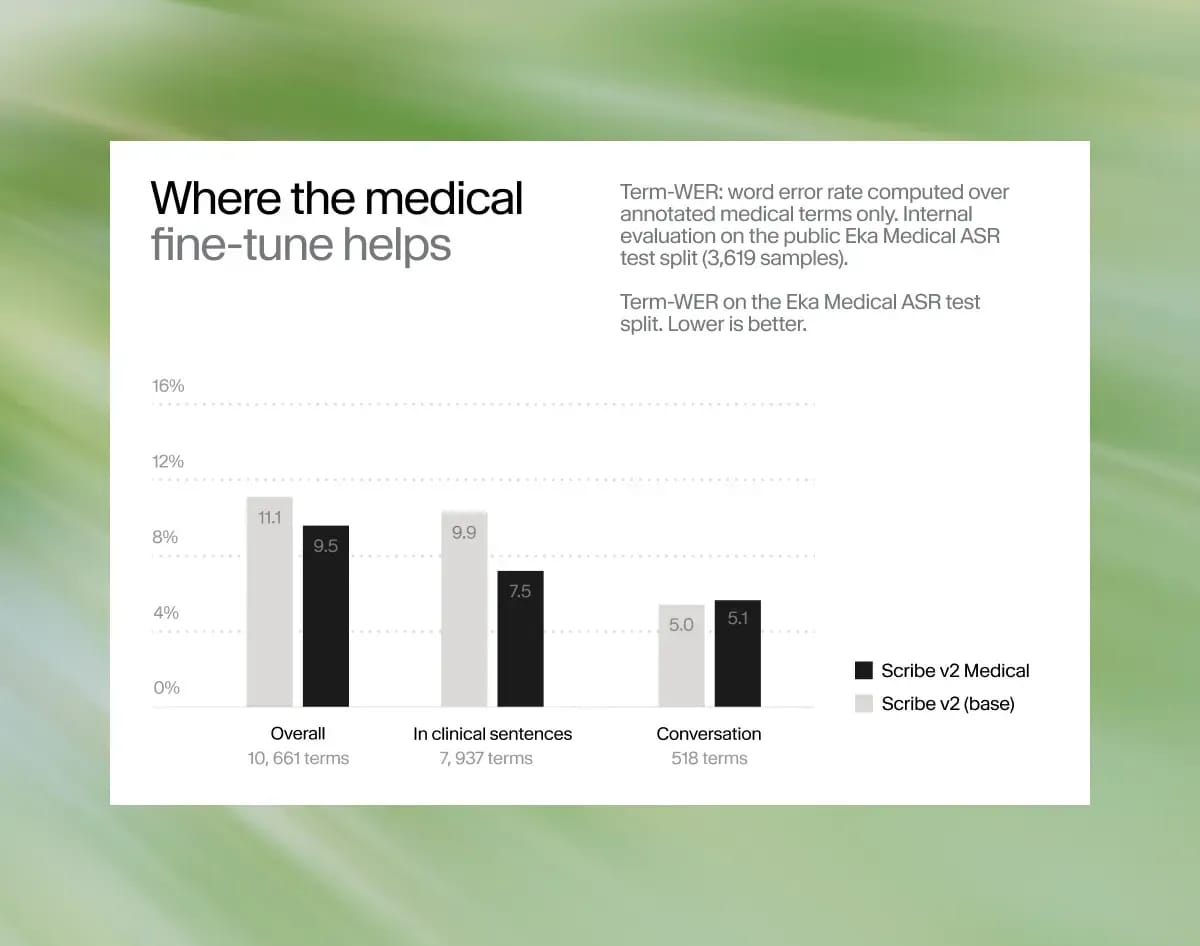
Ein Vorbehalt aus denselben Daten: Isolierte Clips mit einzelnen Wörtern – ein einzelner Medikamentenname ohne Kontext – bleiben für jedes Modell auf der Bestenliste, einschließlich Scribe v2 Medical, der schwierigste Fall. Bei isolierten Begriffen erzielte es eine WER von 14,3 %, gegenüber 7,5 %, wenn diese Begriffe in Sätzen vorkommen. Ohne Kontext kann eine falsch verstandene Silbe zu auffälligen Fehlern führen:
- etodolac (ein NSAR) → „It'll do the luck“
- levomilnacipran (ein Antidepressivum) → „Leave me alone now, Sephora.“
- methdilazine (ein Antihistaminikum) → „Let's play our scene.“
Eine Möglichkeit, diese Fehler zu reduzieren, ist Keyterm Prompting. Damit können Sie Medikamentennamen oder medizinische Formulierungen hervorheben, um das Modell auf ihre erfolgreiche Transkription auszurichten.
Kunden im Produktionseinsatz
Kunden setzen Scribe v2 Medical bereits produktiv ein und erzielen Verbesserungen bei klinischen Audiodaten.
„Seit wir von Deepgram zu ElevenLabs Scribe v2 Medical gewechselt sind, erreichen wir bei klinischer Terminologie eine deutlich höhere Genauigkeit. Das hat die Arbeitsweise des Teams verändert“, sagt Mendel Erlenwein, CEO und Gründer von CareCo. „Wenn unsere Koordinatoren den Transkripten vertrauen, verbringen sie weniger Zeit mit der Korrektur von Notizen und mehr Zeit am Telefon mit Patienten. Unsere Patienten haben komplexe Behandlungspläne, und die Notiz, die das Behandlungsteam liest, muss stimmen.“
Starke Leistung bei allgemeiner Sprache
Das Team hat außerdem bestätigt, dass das medizinische Finetune die Leistung in anderen Bereichen nicht beeinträchtigt. Bei 6.000 Beispielen alltäglicher, nicht medizinischer Sprache aus Common Voice erzielt Scribe v2 Medical nach Rundung dasselbe Ergebnis wie Scribe v2: in beiden Fällen eine WER von 5,3 %. Mit v2 Medical erhalten Sie also die Vorteile eines spezialisierten medizinischen Modells, ohne bei diesem Benchmark an Genauigkeit einzubüßen.
Entwickelt für geschützte Gesundheitsdaten
Scribe v2 Medical ist für Unternehmenskunden mit bestehendem Business Associate Agreement und aktiviertem Zero Retention Mode (ZRM) HIPAA-geeignet.
Ist ZRM für Anfragen an die Speech to Text API aktiviert, werden Audioeingabe und Textausgabe sofort nach Abschluss jeder Anfrage gelöscht. ElevenLabs speichert keines von beiden. Ihre Anwendung erhält die vollständige API-Antwort und steuert, wie Transkripte gespeichert werden.
Erste Schritte
Scribe v2 Medical ist über die Speech to Text API verfügbar. Übergeben Sie einfach die neue Modell-ID: scribe_v2_medical
Das Modell läuft auf dem Batch-Speech to Text-Endpunkt.