
AI音声アシスタントの構築方法:ブランドに合った音声AI
- 公開日
- 最終更新日
小売店に電話して返金を依頼すると、人間のようなAIが応対し、数分以内に銀行口座へ返金される場面を想像してみてください。人間のサポート担当者を介さず、すべてのやり取りがシームレスに進みます。かつては空想の話でしたが、複雑なユースケースにも対応できるAI音声アシスタントは、今や現実のものとなっています。
顧客向けアプリケーションにAI音声アシスタントを導入する企業が増えています。最先端の音声エージェントと生成AIを活用し、幅広いユースケースで意図の照合、低遅延の応答、各種機能とのインテグレーションに対応します。
ElevenAgentsのようなツールを使えば、音声アシスタントをカスタマーサポートのワークフローにこれまで以上に簡単に組み込めます。AI音声アシスタントを構築するには、まず役割を定義し、スピーチtoテキスト、LLM、テキスト読み上げを1つのリアルタイムパイプラインに接続します。ナレッジベースと業務ツールを追加し、システム指示とフォールバックルールを作成して、遅延とセーフティをテストし、リリース後の成果を測定します。
このガイドでは、ブランドにしっかり合ったAI音声アシスタントの構築方法を紹介します。
要約
- AI音声アシスタントは、スピーチtoテキスト、LLM、テキスト読み上げを接続し、アクションを実行できる会話型AIを構築します。
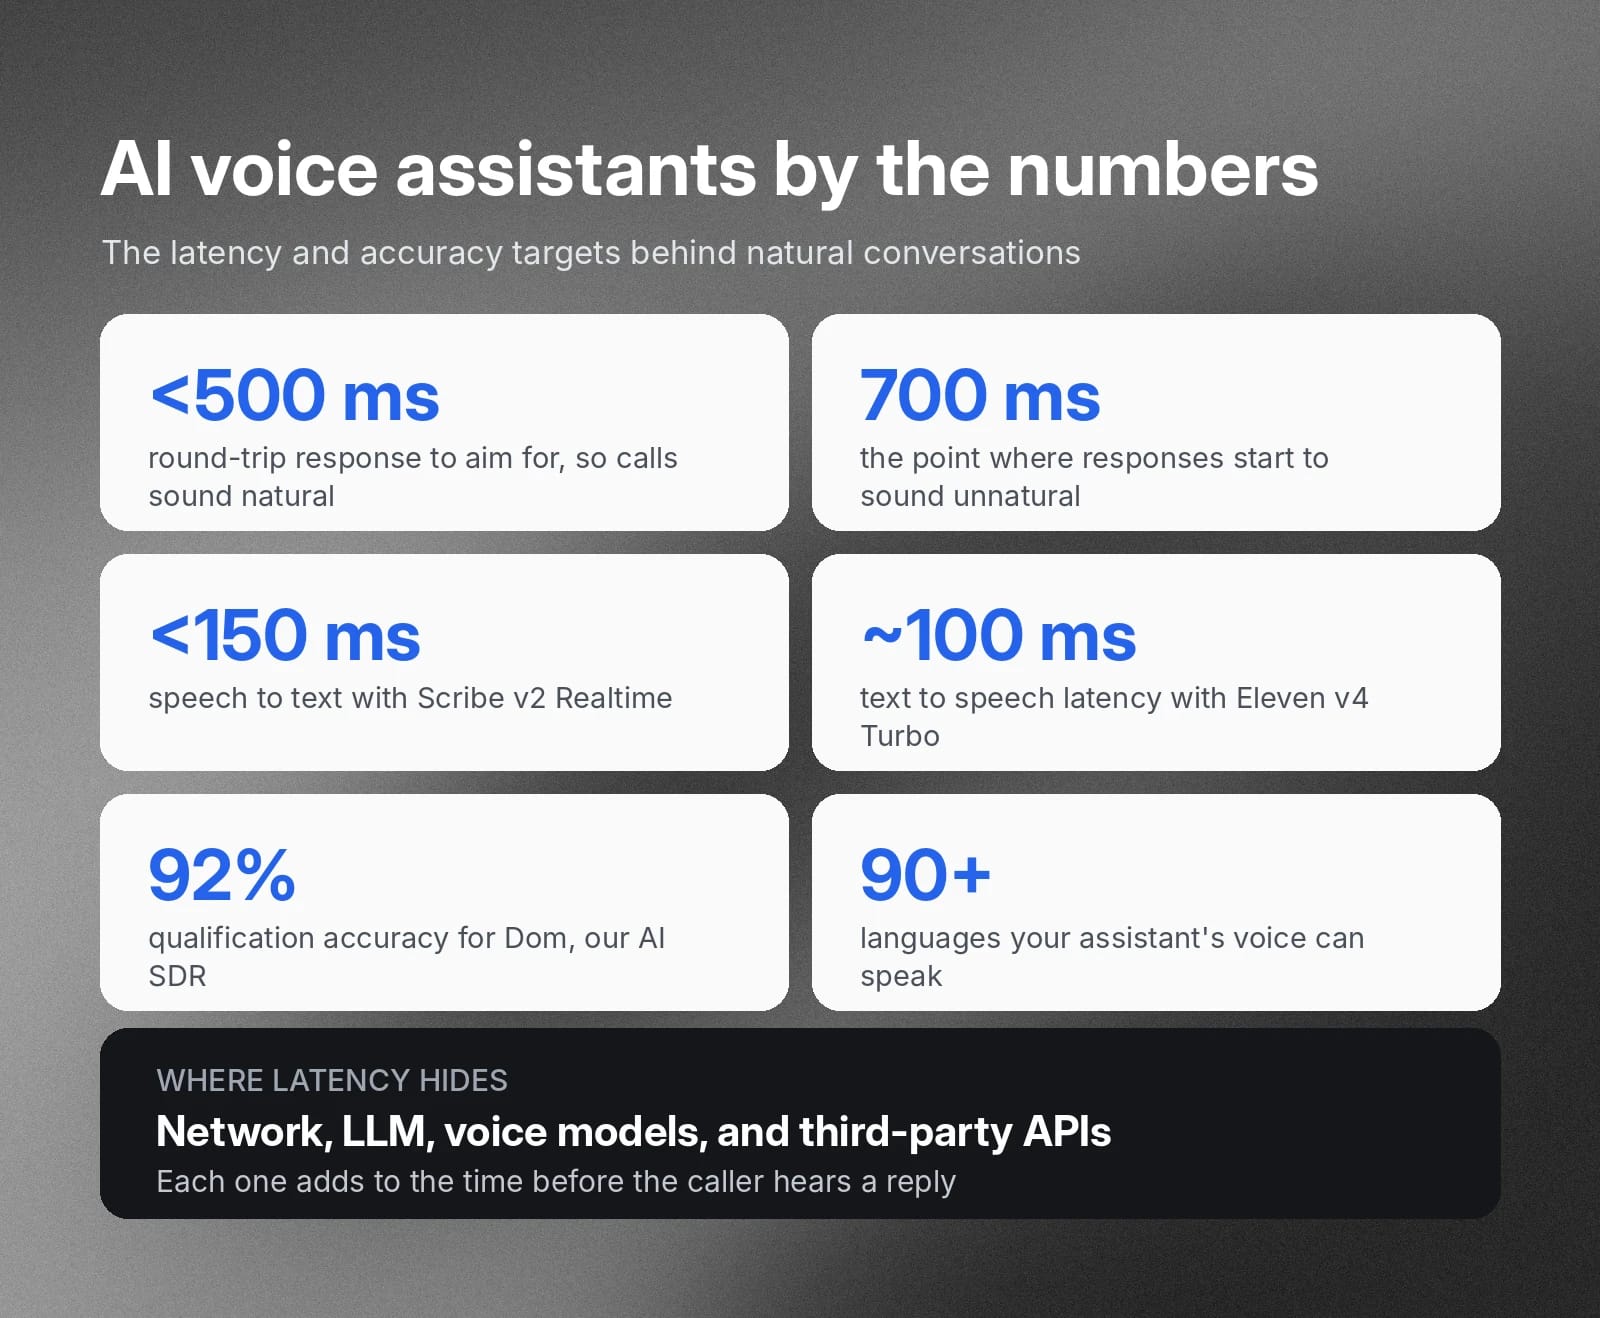
- 音声アクティビティ検出(VAD)を使って往復の応答時間を500ms未満に抑えると、音声AIが自然に聞こえ、通話離脱も減らせます。
- 社内のナレッジベースやツールと連携し、さまざまな状況で文脈に沿った正確で役立つAI応答を実現します。
- 感情的または複雑な問い合わせを扱う際は、明確な口頭確認を必須とし、必要に応じて人間の担当者へ引き継ぐセーフガードを設けます。
- ElevenAPIを使うと、ライブ対話向けに設計された高精度なインタラクティブ音声・オーディオモデルを利用できます。
AI音声アシスタントとは?
AI音声アシスタントは、話し言葉を理解し、接続されたシステムをユーザーが操作できるようにするソフトウェアです。スピーチtoテキスト、AIモデル、テキスト読み上げ技術を組み合わせ、会話をアクションに変換します。
AI音声アシスタントは文字起こしだけでなく、アプリの起動、データの取得、機械の制御といったタスクも実行できます。使用する音声モデルによっては、人間の録音とほとんど区別できないほど自然に聞こえます。
ただし、AI音声アシスタント自体は新しい技術ではありません。多くの人が、簡単な指示に応答する市販の音声アシスタントであるSiri、Alexa、Google Assistantを利用しています。しかしAI技術の進化に伴い、より複雑な企業ワークフロー向けのAI音声アシスタントを構築する組織が増えています。
たとえば、保険会社のAdmiralは、数百万人の顧客をサポートするAI音声アシスタントを構築しました。このAIアシスタントは問い合わせに回答し、文書を取得することで、人間の担当者を反復作業から解放します。
商用または産業用のワークフロー向けにAI音声アシスタントを構築する予定なら、このまま読み進めてください。Python AI音声アシスタントの例を使い、実装時の重要なポイントを押さえながら構築手順を説明します。
AI音声アシスタントの構築方法:AI音声エージェントの役割を定義する
音声AIは、コールセンターのカスタマーサポート自動化によく使われます。しかし、AI音声エージェントは幅広い機能を備えているため、営業、プロダクト、人事など、ほぼあらゆるユースケースに対応するAI音声アシスタントを構築できます。
音声エージェントの用途を問わず、ビジネスロジックに沿っていることを確認してください。高性能な音声アシスタントを構築するには、エンドユーザーが直面しやすい課題について分野の専門家に相談します。そのうえで、顧客とのやり取りの流れを整理し、測定可能な指標を設定します。
たとえば、営業ファネルに音声AIを導入する場合、エージェントは事前評価の質問ができる必要があります。
ElevenLabsのAIセールス開発担当(SDR)であるDomは、これを実践して92%の見込み客判定精度を達成しました。
成功指標、チャネル、エスカレーション経路を決める
企業環境に導入する場合、エージェントは具体的な目標に対して一貫した性能を発揮する必要があります。目標を絞るほど、評価や微調整がしやすくなります。
そのため、開発の早い段階で次のような点を確認してください。
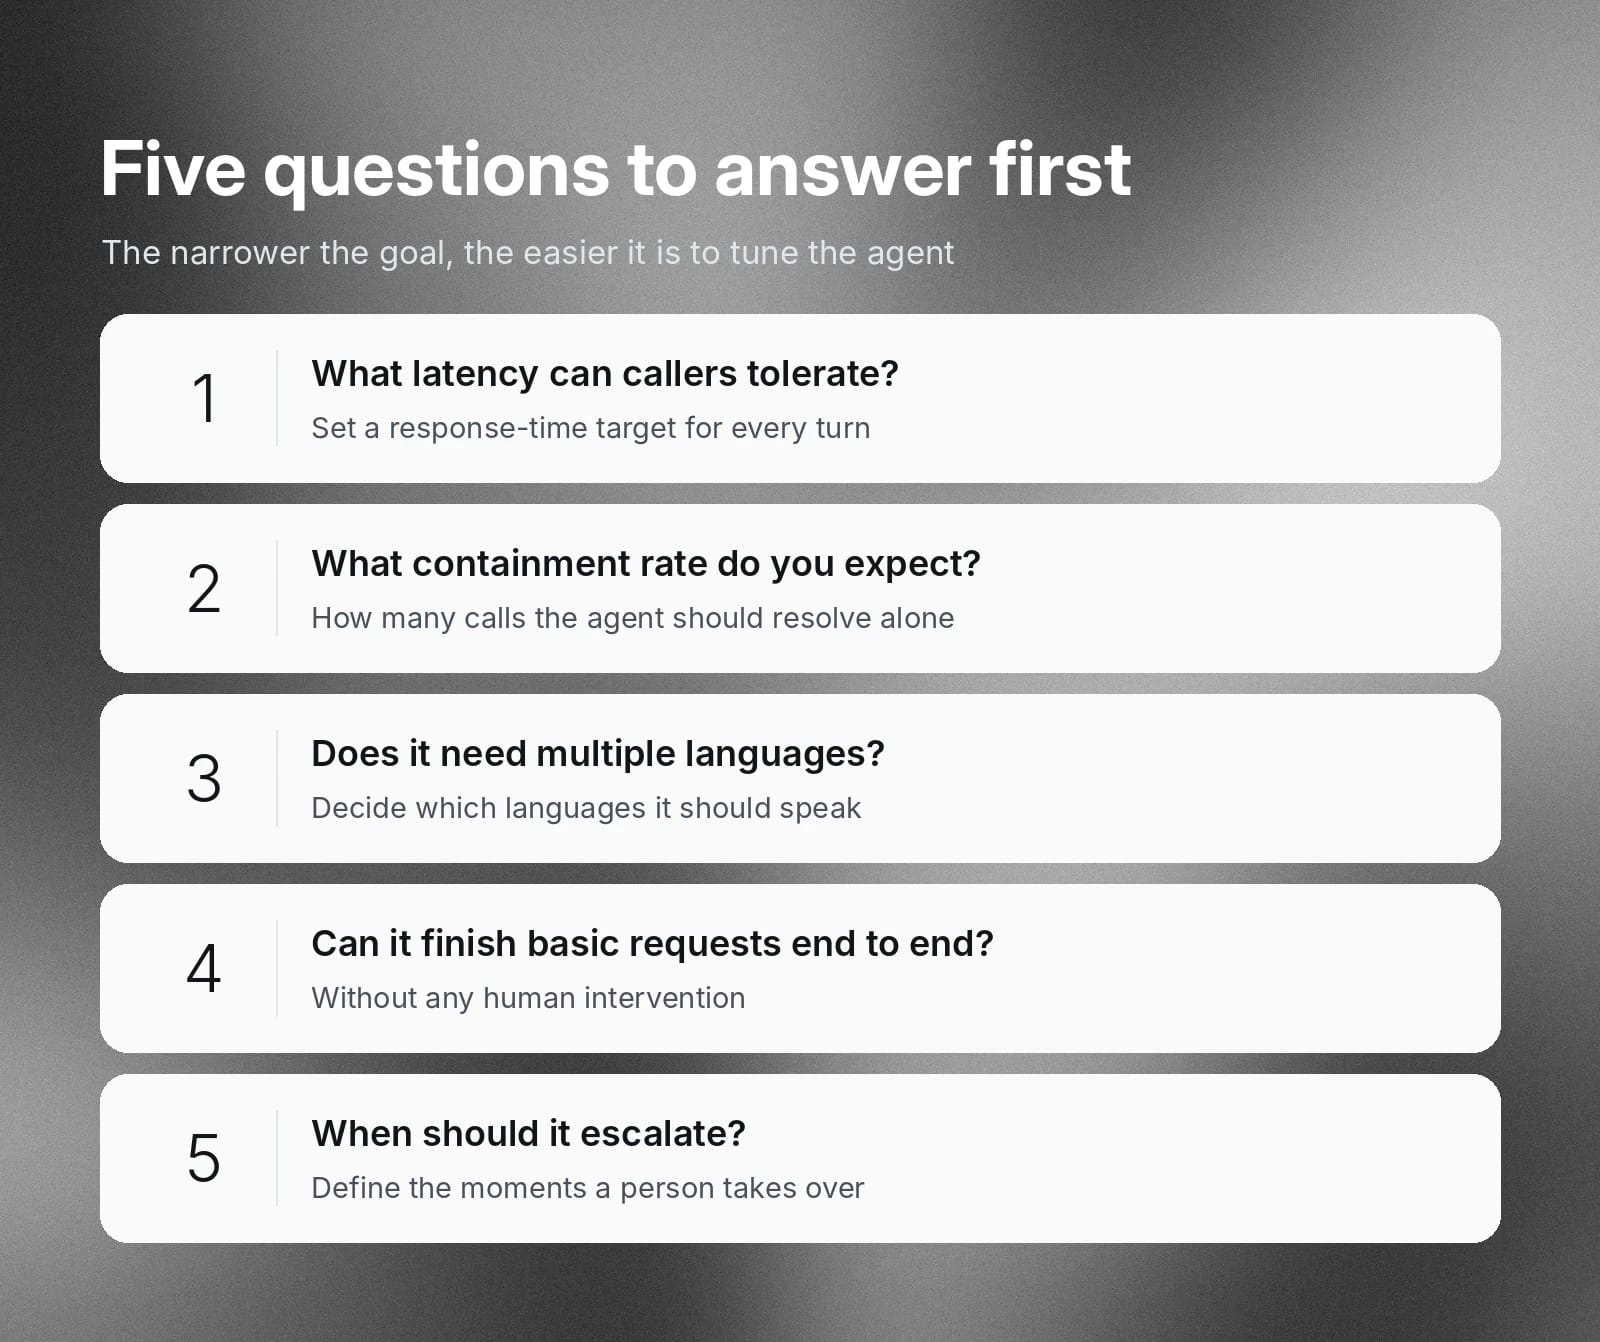
- 許容できる応答遅延はどの程度か?
- 想定する自己完結率はどの程度か?
- エージェントは複数言語で会話する必要があるか?
- AIアシスタントは、人間の介入なしで基本的なリクエストを最初から最後まで処理できるか?
- どのような状況で人間のサポートへエスカレーションすべきか?
基本APIから構築するか、ElevenAgentsを使うか?
コードを書く前に、音声スタックをどこまで自社で管理するかを決めます。ElevenAPIを通じてスピーチtoテキスト、LLM、テキスト読み上げを自分で接続することも、これらをまとめて提供するマネージドプラットフォームのElevenAgentsを使うこともできます。
基本APIから構築すると、すべてのレイヤーを完全に制御できます。LLMの選定、オーケストレーションコードの作成、話者交替、割り込み処理、電話連携、モニタリングをすべて自社で担います。特定のアーキテクチャ要件があるチームに適しており、このガイドのPythonチュートリアルもこの方法を採用しています。
ElevenAgentsでは、モデル、ツール、ナレッジベース、ワークフローを1つのダッシュボードに集約できます。TwilioやAmazon Connectなどの電話サービス事業者に加え、Salesforce、Zendesk、HubSpotなどの業務ツールにも接続できます。リリース前のシミュレーションと自動テスト、リリース後の成功率、CSAT、文字起こしの分析機能も含まれます。
次の観点から選びましょう。
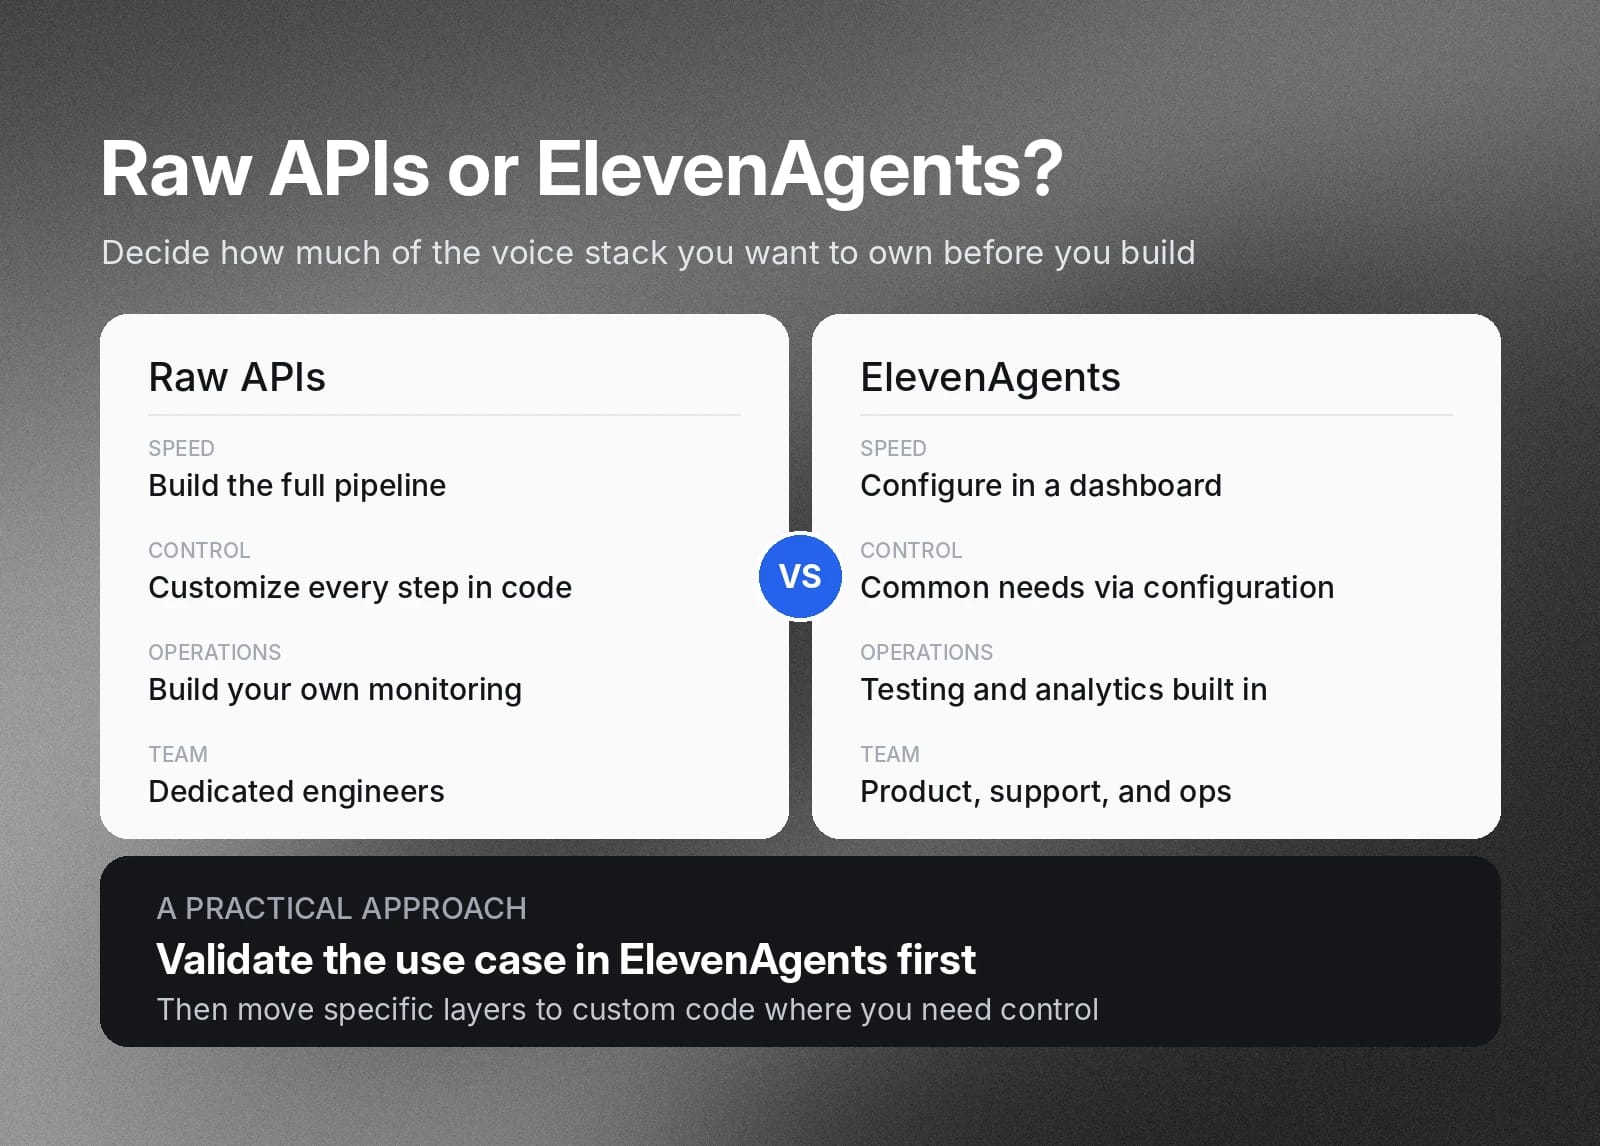
- スピード:ElevenAgentsなら、チームはダッシュボードからエージェントを設定してリリースできます。一方、基本APIではパイプライン全体の構築と保守が必要です。
- 制御性:基本APIではコードですべての工程をカスタマイズできます。一方、ElevenAgentsは一般的なニーズを設定だけでカバーします。
- 運用:ElevenAgentsにはテストと分析機能が含まれます。一方、基本APIでは独自のモニタリングを構築する必要があります。
- チーム:ElevenAgentsはプロダクト、サポート、運用担当者からなる混成チームに、基本APIは専任エンジニアがいるチームに適しています。
実践的な方法は、まずElevenAgentsでユースケースを検証し、さらに細かく制御したいレイヤーだけをカスタムコードへ移行することです。
AI音声アシスタントのアーキテクチャを設計する
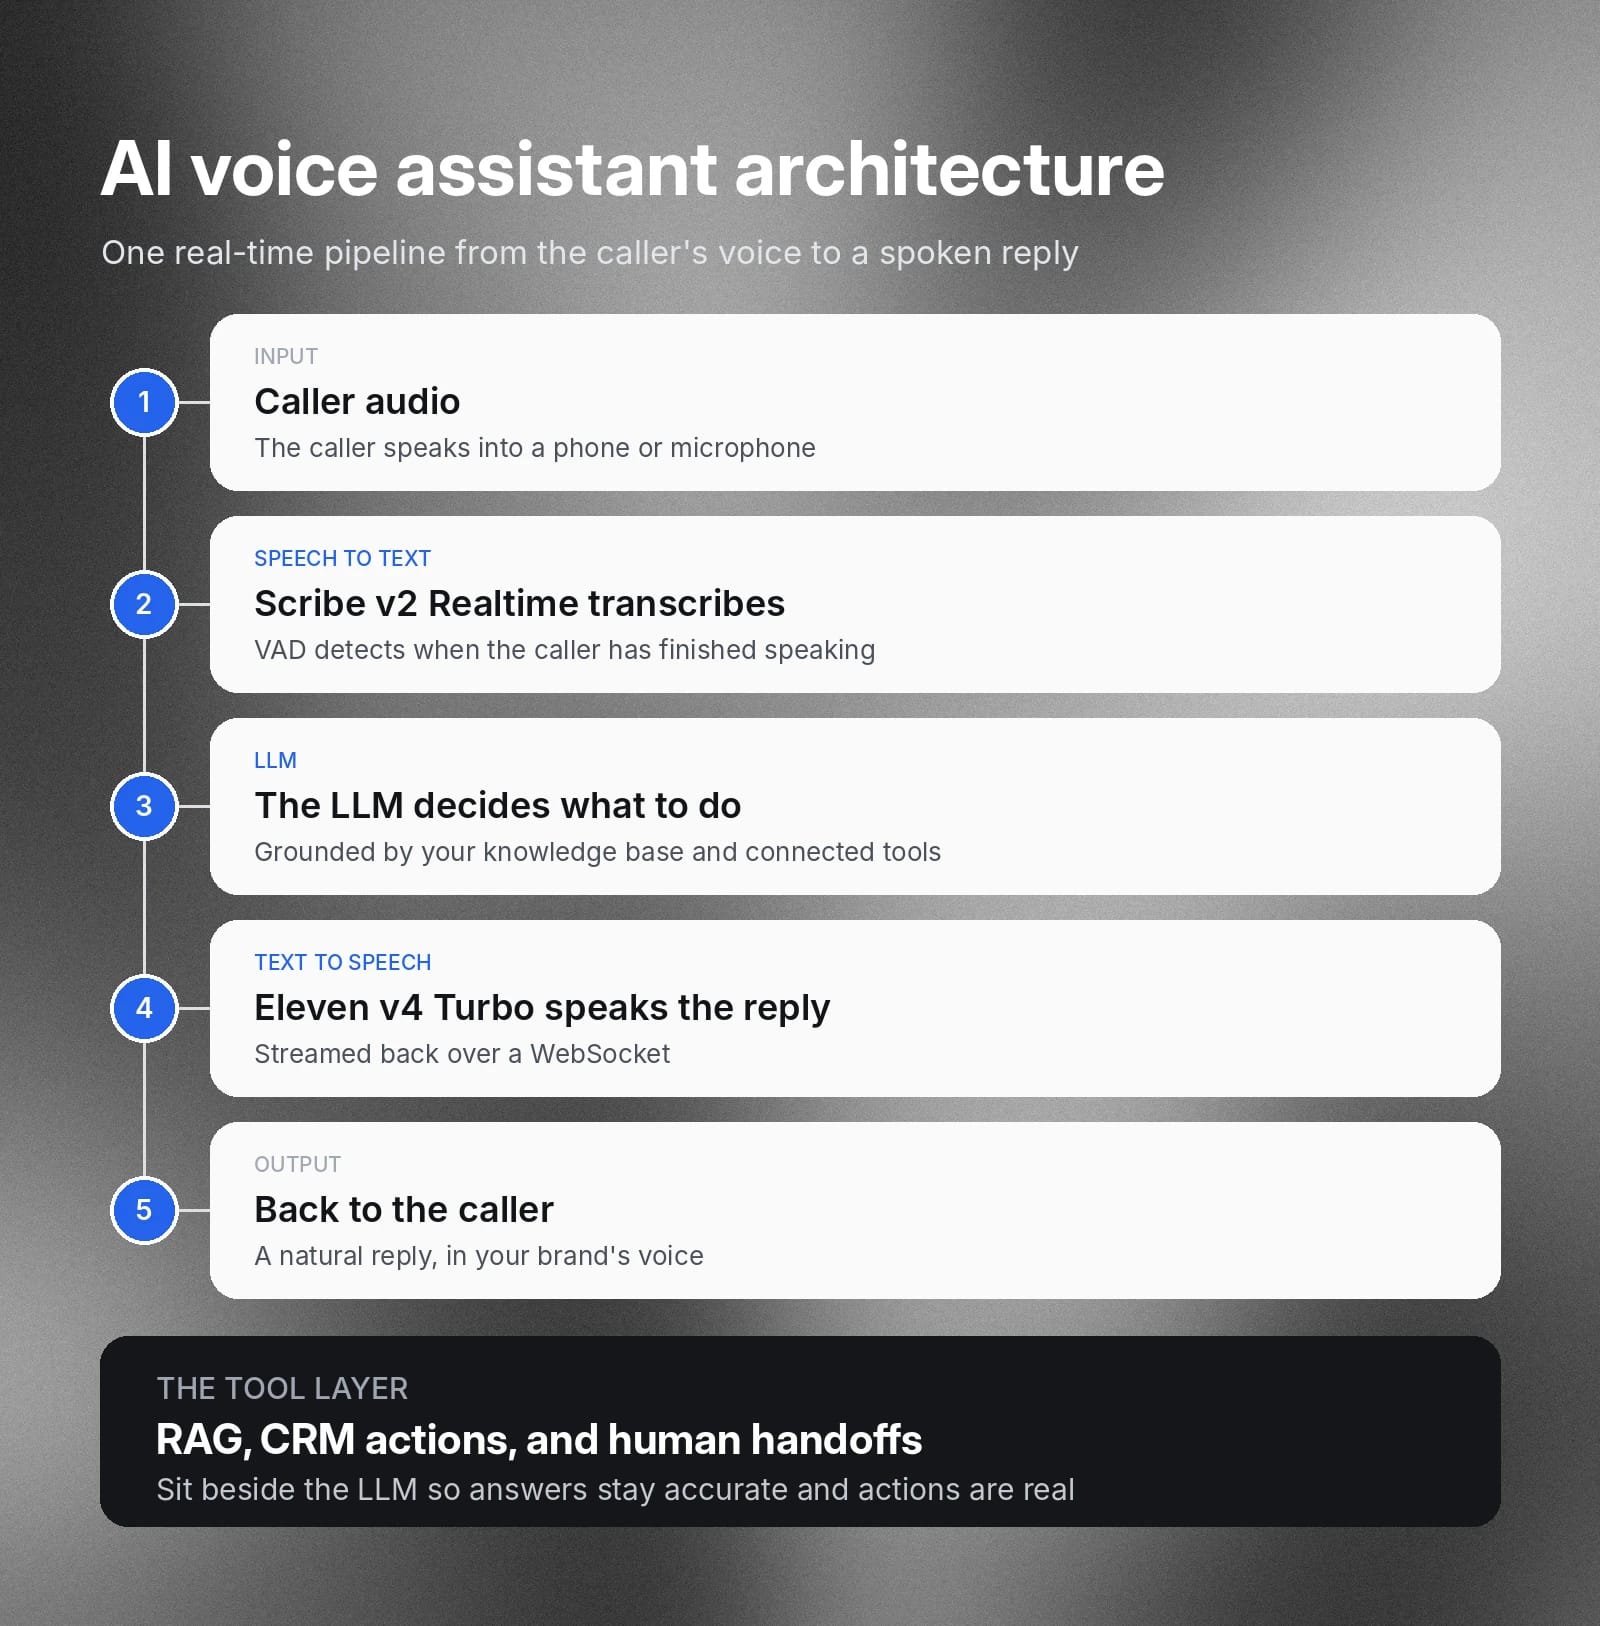
ビジネス目標を定義したら、エージェントの機能を適切な技術に割り当てます。AI音声アシスタントは、音声をテキストに変換し、アクションを実行して一貫性のある応答を返すために、連携して動作する複数の主要コンポーネントを使用します。
- スピーチtoテキストモデルは発話を取り込み、音素を特定して、会話の文字起こしを生成します。
- 単純なルールベースのアルゴリズムや自然言語処理ライブラリから大規模言語モデル(LLM)まで、AIエンジンが音声アシスタントの頭脳として機能します。
- テキスト読み上げモデルは、人間らしい音声で会話の応答を合成し、ブランドガイドラインに従います。
ElevenLabsは、プロダクトチームやエンジニアリングチームによるAI音声アシスタントの設計を支援する、スピーチtoテキストとText to Dialogueの音声・オーディオモデルを提供しています。これらのモデルは、繊細なイントネーション、感情認識、低遅延応答に対応しています。音声モデルにはElevenAPIからアクセスできます。
AIモデルの選択は、音声アシスタントの目標と要件に大きく左右されます。OpenAIのGPTモデル、Gemini、ClaudeなどのLLMは推論に優れていますが、特定分野のニーズを満たすには追加の微調整が必要です。より単純なニューラルネットワークやルールベースのパーサーを使う方が実用的な場合もあります。
音声モデルやAIモデルに加えて、会話やユーザーのリクエストから特定のエンティティを抽出するカスタムソフトウェアも必要です。たとえば、発信者が「営業部門と話したい」と言った場合、コードは「営業部門」を特定し、適切なアクションを実行する必要があります。
APIキーを作成し、スピーチtoテキスト、LLM、ツール、テキスト読み上げを接続する
まず、音声モデルと言語モデルに接続します。同様に、外部サービスのツールを音声アシスタントに組み込んでAPIリクエストを送信するには、APIキーが必要です。
- ElevenLabsのAPIキーを作成するには、こちらをクリックしてください。
- OpenAIのLLMを使用する場合は、こちらでキーを取得してください。
- 外部のCRM、ERP、その他のツールに接続する場合は、公式ドキュメントを参照してAPIキーを作成し、対応しているAPIを確認してください。
APIキーを取得したら、開発環境に保存します。
次に、適切な引数をAPIに渡して、ツール、LLM、オーディオモデルを初期化し、アクセスします。
1. まず、ElevenLabs Scribe v2 Realtimeに接続し、自動音声認識を実行します。ElevenLabs Scribe v2 Realtimeを使用すると、会話を150ミリ秒未満でテキストに変換する低遅延の音声エージェントを作成できます(ネットワークとアプリケーションの処理時間を除く)。
以下は、ElevenLabs Scribe v2 Realtimeを使ってマイク録音を取り込むPythonコードの例です。
2. 次に、文字起こしを高度な推論能力を持つLLMへ送信して、応答を生成します。この例ではOpenAI GPT-4o miniを使用します。
Pythonコードで文字起こしをLLMへ送信する方法は次のとおりです。
3. LLMの出力を受け取ったら、ElevenLabs v4 Turboを使ってリアルな音声応答に変換します。ElevenLabsのテキスト読み上げモデルは感情表現が豊かで、リアルタイムの対話向けに設計されており、約100ミリ秒という超低遅延を実現しています(モデルの推論時間のみ。実際のエンドツーエンドの遅延は、現在地や使用するエンドポイントの種類などによって異なります)。
以下のコードは、エージェントがWebSocketを使い、ElevenLabs Text to Dialogue APIで音声応答をストリーミングする方法を示しています。
自動音声認識エージェントは、複数ターンの会話をスムーズに処理できる必要があります。そのためには、発話の開始と終了を認識できる音声エージェントが必要です。
自然で本題から外れない会話を設計する
従来の自動音声応答(IVR)システムは、プログラムされたシナリオ以外には対応できません。ルールに定義されていない問題の解決を求められると、IVRは満足のいく応答を返せません。また、必ずしも自然に聞こえるとは限らず、顧客体験を損ないます。
高度なAIと音声モデルを使えば、音声アシスタントはより自然に応答し、例外的なケースにも対処できます。エージェントが予測すべきさまざまなシナリオと、解決できない場合のエスカレーション経路を設計できます。たとえば、配送状況を尋ねる顧客もいれば、不良品に不満を感じ、CXマネージャーとの会話を強く求める顧客もいます。
システム指示、話者交替ルール、フォールバック応答を作成する
さまざまなシナリオに対応するため、AI音声エージェントのアプリケーションに専用のロジック処理コードとシステムプロンプトを作成します。
たとえば、以下のシステムプロンプトは不満を検出し、より共感的に応答するようLLMに指示します。
AIとの会話で、急かされたり遮られたりしていると感じさせてはいけません。音声モデルは、ユーザーが話し終えたことを検出し、適切なタイミングで応答する必要があります。ElevenLabs Scribe v2 Realtimeでは、マイク入力をリスニングする際にVADを有効にできます。無音時間だけに依存する従来のVADとは異なり、ElevenLabs Scribe v2 Realtimeはディープラーニングアルゴリズムを使って、顧客が話し終えたかどうかを判断します。
VADを有効にするには、スピーチtoテキストAPIを使用するコード内でパラメーターを設定します。
次に、エージェントが顧客のリクエストに十分回答できない場合に備え、丁寧で配慮のあるフォールバック応答を用意します。また、AIエージェントが会話の文字起こし中にエラーに遭遇することもあります。コード側で技術的な問題に対処し、顧客に状況を率直に伝える必要があります。
フォールバック応答を提供するには、コードで条件分岐を使います。たとえば、以下のコードはスピーチtoテキストAPIからエラーステータスを取得し、適切な応答を実行します。
信頼できる回答のためのナレッジとツールのレイヤーを構築する
LLMは高度な推論能力を備えているため、AI音声アシスタントは自然に応答できます。ただし、会話が自然だからといって、必ずしも正確とは限りません。根拠となるデータがなければ、LLMがハルシネーションを起こし、もっともらしくても不正確な回答を音声エージェントが返す可能性があります。
たとえば、最近リリースしたプロダクトについてGPT-4o miniに尋ねても、確信を持って回答することはできません。回答できるようにするには、検索拡張生成(RAG)システムを使って、LLMを社内ナレッジベースに接続する必要があります。RAGを使うと、LLMは社内のプロダクトガイドを参照して正確な回答を生成できます。
検索、APIアクション、権限、人間への引き継ぎを追加する
RAGを使用するには、ベクトルデータベースを作成する必要があります。ベクトルデータベースは、ドキュメントを多次元空間内の数値表現として保存します。次のコードスニペットは、LLMに問い合わせる前に、音声エージェントがベクトルストアから関連ドキュメントを取得する方法を示しています。
RAGに加え、AI音声アシスタントはCRM、ERP、その他の企業システムへのアクセスも必要になるでしょう。これにより、顧客データ、過去の取引、市場動向などの必要な情報を取得し、応答作成時の文脈として利用できます。
たとえば、APIを使ってElevenLabsをHubSpotと連携できます。これにより、CRMのナレッジベースを使って一般的な問題を解決し、チケットを作成し、会話の文脈をすべて引き継いでサポートをエスカレーションできます。
以下は、音声エージェントがHubSpotでサポートチケットを作成するためのコード例です。
AI音声エージェントは問題解決を迅速化できますが、特に変更がアカウントに大きな影響を及ぼす可能性がある場合、顧客が選択肢を把握できるようにする必要があります。テキストベースのチャットボットとは異なり、選択肢を口頭で提示する場合は、より多くのセーフガードが必要です。一度選択すると、通話中に元へ戻すのが難しい場合があります。
この場合、発信者の本人確認を行い、口頭で確認を取ることをおすすめします。たとえば、顧客が購入をキャンセルしたい場合、音声エージェントは「注文をキャンセルしてもよろしいですか?」と明確に尋ね、回答を待つ必要があります。
以下に例を示します。
AI音声エージェントで発信者の本人確認を行う方法
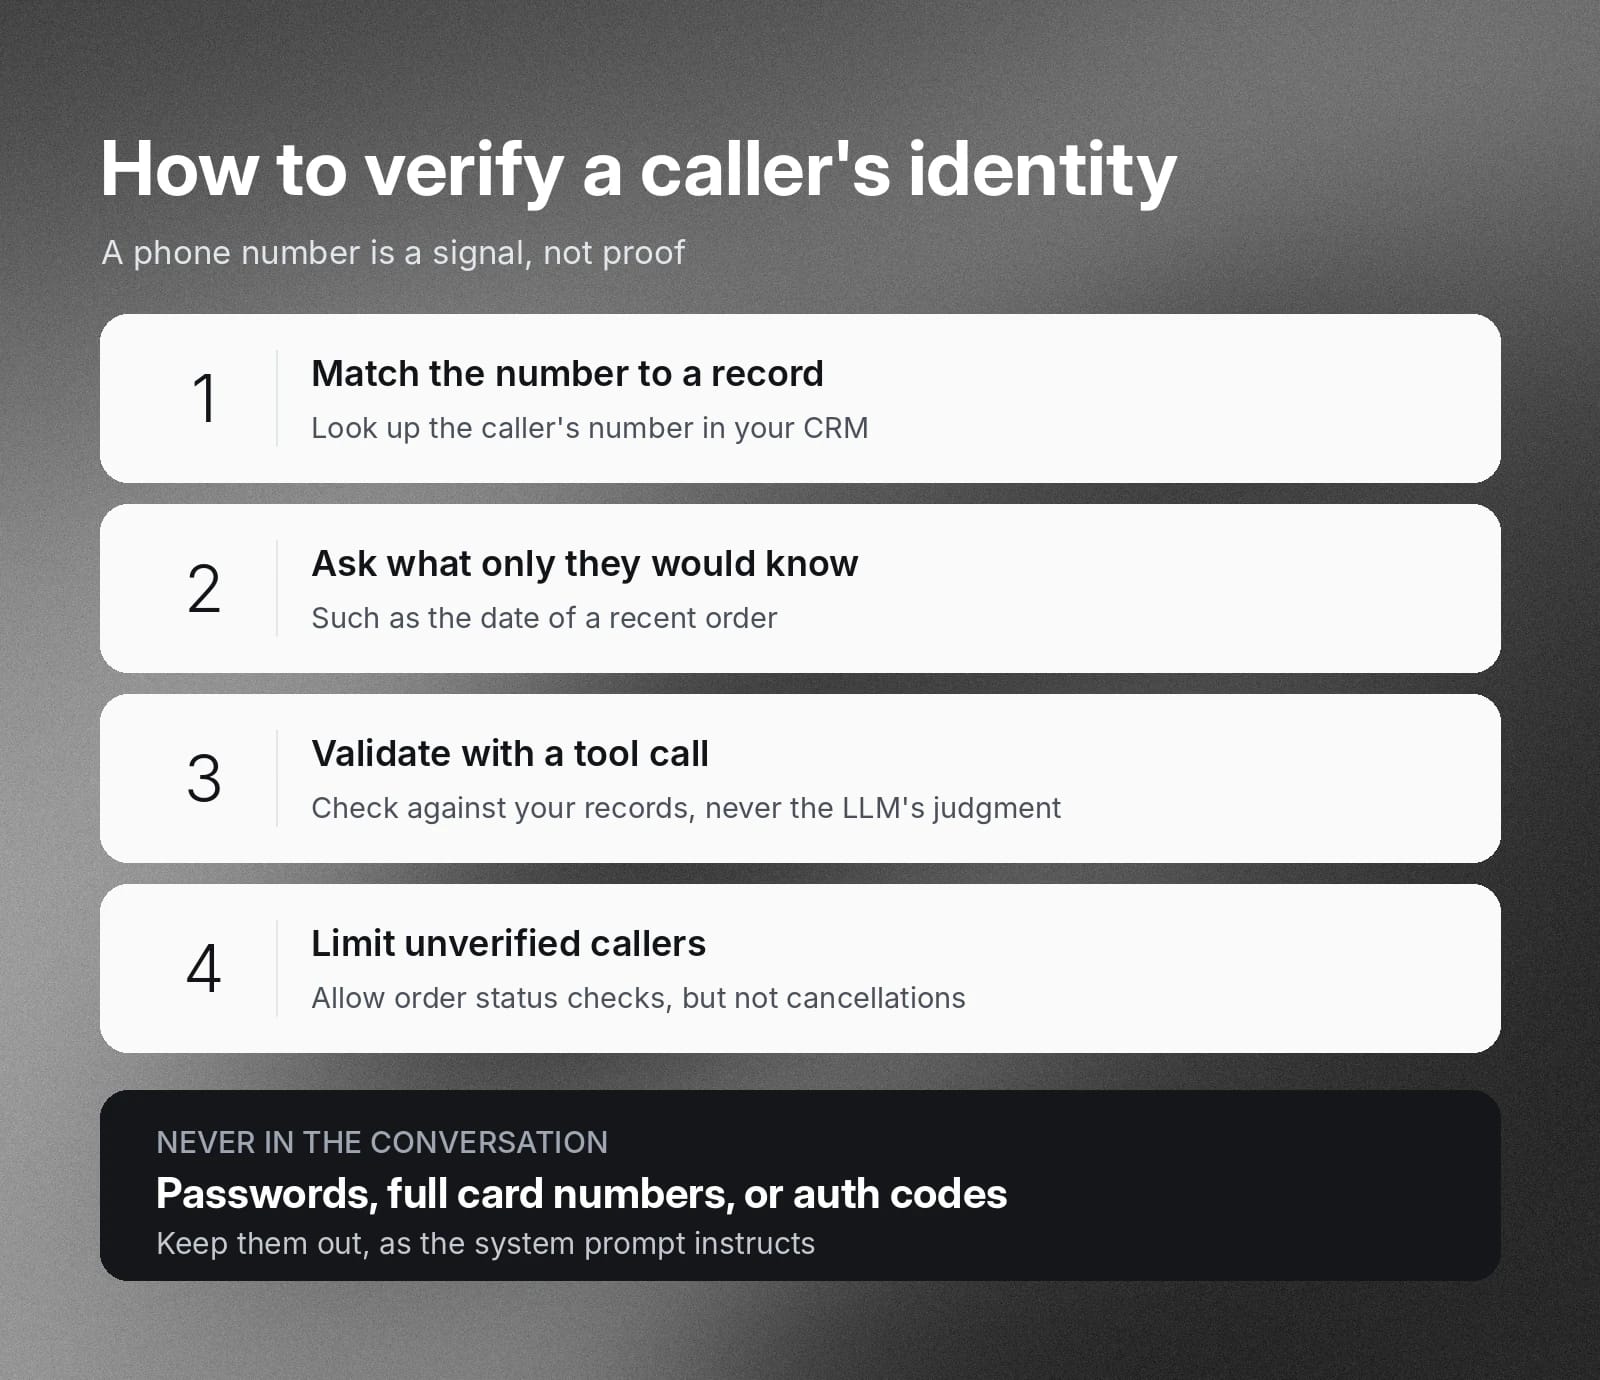
AI音声エージェントがアカウント情報を共有したり、アカウントを変更したりする前に、会話相手が誰なのかを確認する必要があります。発信者の電話番号は有用な手がかりですが、本人であることの証明にはなりません。次の確認方法を組み合わせてください。
- 発信者の電話番号をCRM内の顧客レコードと照合します。
- 最近の注文日など、アカウント所有者しか知らない情報を尋ねます。
- ツール呼び出しを使って記録と回答を照合し、正しいかどうかの判断をLLMに任せないでください。
- 未確認の発信者が実行できる操作を制限します。たとえば、注文状況の確認は許可しても、キャンセルは許可しません。
上記のシステムプロンプトの指示どおり、パスワード、支払いカード番号全体、認証コードは会話に含めないでください。
ライブ通話転送とエスカレーションに対応するAI音声エージェント
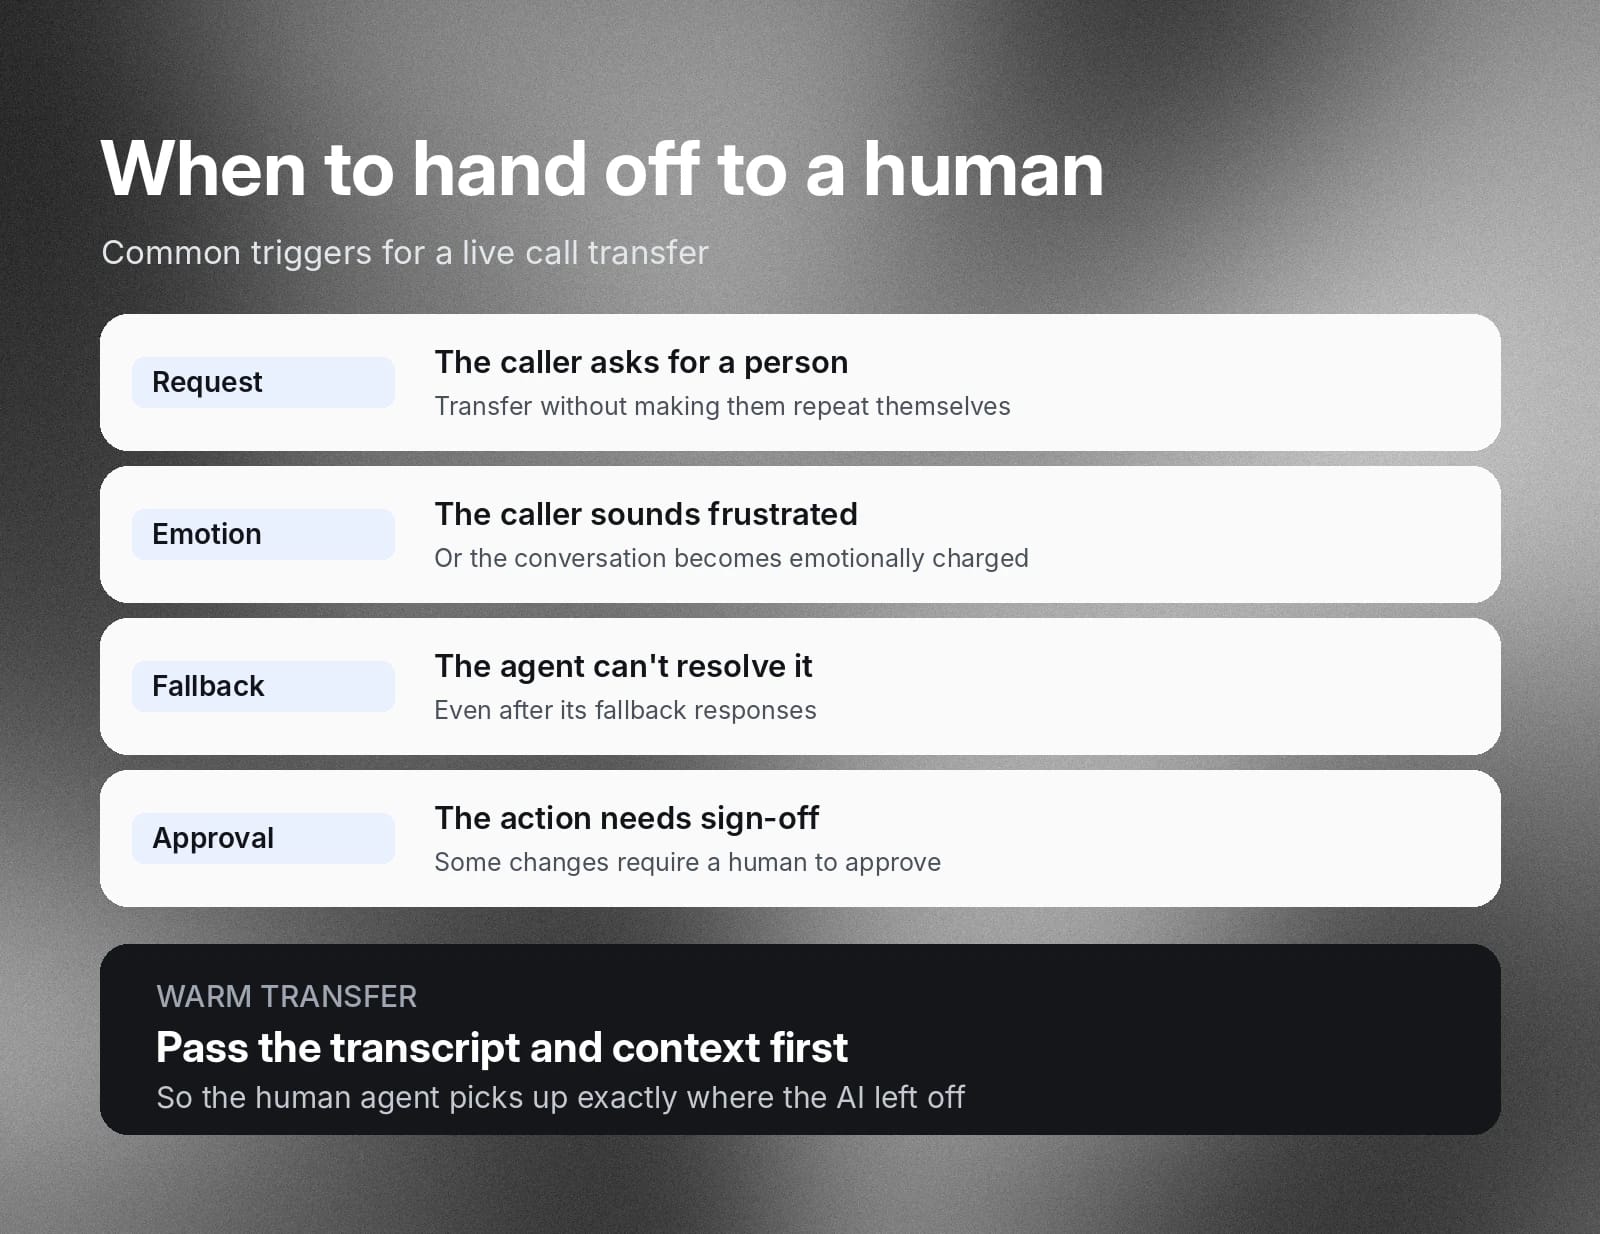
ライブ転送では、発信者に同じ説明を繰り返させることなく、人間の担当者へ引き継ぎます。ウォーム転送では、通話が接続される前に、音声エージェントが文字起こしと文脈を人間の担当者へ渡します。一般的な実行条件は次のとおりです。
- 発信者が人間の担当者との会話を求めた場合。
- 発信者が不満を示している場合や、会話が感情的になった場合。
- フォールバック応答を行っても、エージェントがリクエストを解決できない場合。
- 人間の承認が必要なアクションを求められた場合。
状況によっては、AIエージェントが通話を人間の担当者へエスカレーションする必要があります。多くの場合、音声エージェントは不満を示す意図や特定の言葉を検出し、転送を実行します。コードでは、顧客に仕組みを意識させることなく、通話転送がシームレスに行われる必要があります。
切り替え前に、文字起こし、顧客情報、その他の補足情報を有人サポート窓口へ渡します。ElevenLabsは、AIエージェントが対応している通話をSIPトランクまたはTwilioの電話番号へ転送する番号転送ツールを提供しています。
以下のコードは、Twilioの会議通話を使った引き継ぎを示しています。
ElevenAgentsでコードを使わずにAI音声アシスタントを構築する
カスタムコードが不要なら、同じアシスタントをElevenAgentsでリリースできます。手順は上記のアーキテクチャと同じですが、コードを書く代わりに、ダッシュボードで各レイヤーを設定します。
- エージェントを作成し、口調、対応範囲、エスカレーション条件などの役割をシステムプロンプトに記述します。
- ボイスライブラリから音声を選ぶか、独自の音声をデザインまたはクローンし、エージェントが話す言語を設定します。
- 独自の文書に基づいて回答できるよう、ナレッジベースを追加します。
- CRMやヘルプデスクなどのツールやインテグレーションを接続し、エージェントがアクションを実行できるようにします。
- アシスタントが解決できない通話を人間の担当者へ転送するよう設定します。
- リリース前にシミュレーションと自動テストを実行し、動作を確認します。
- エージェントを電話番号またはチャネルにデプロイし、成功率、CSAT、文字起こしを確認します。
以下のセクションで説明するテストと測定のガイダンスは、コードを使う場合にも使わない場合にも適用できます。
ブランドに合ったAI音声アシスタントの構築方法
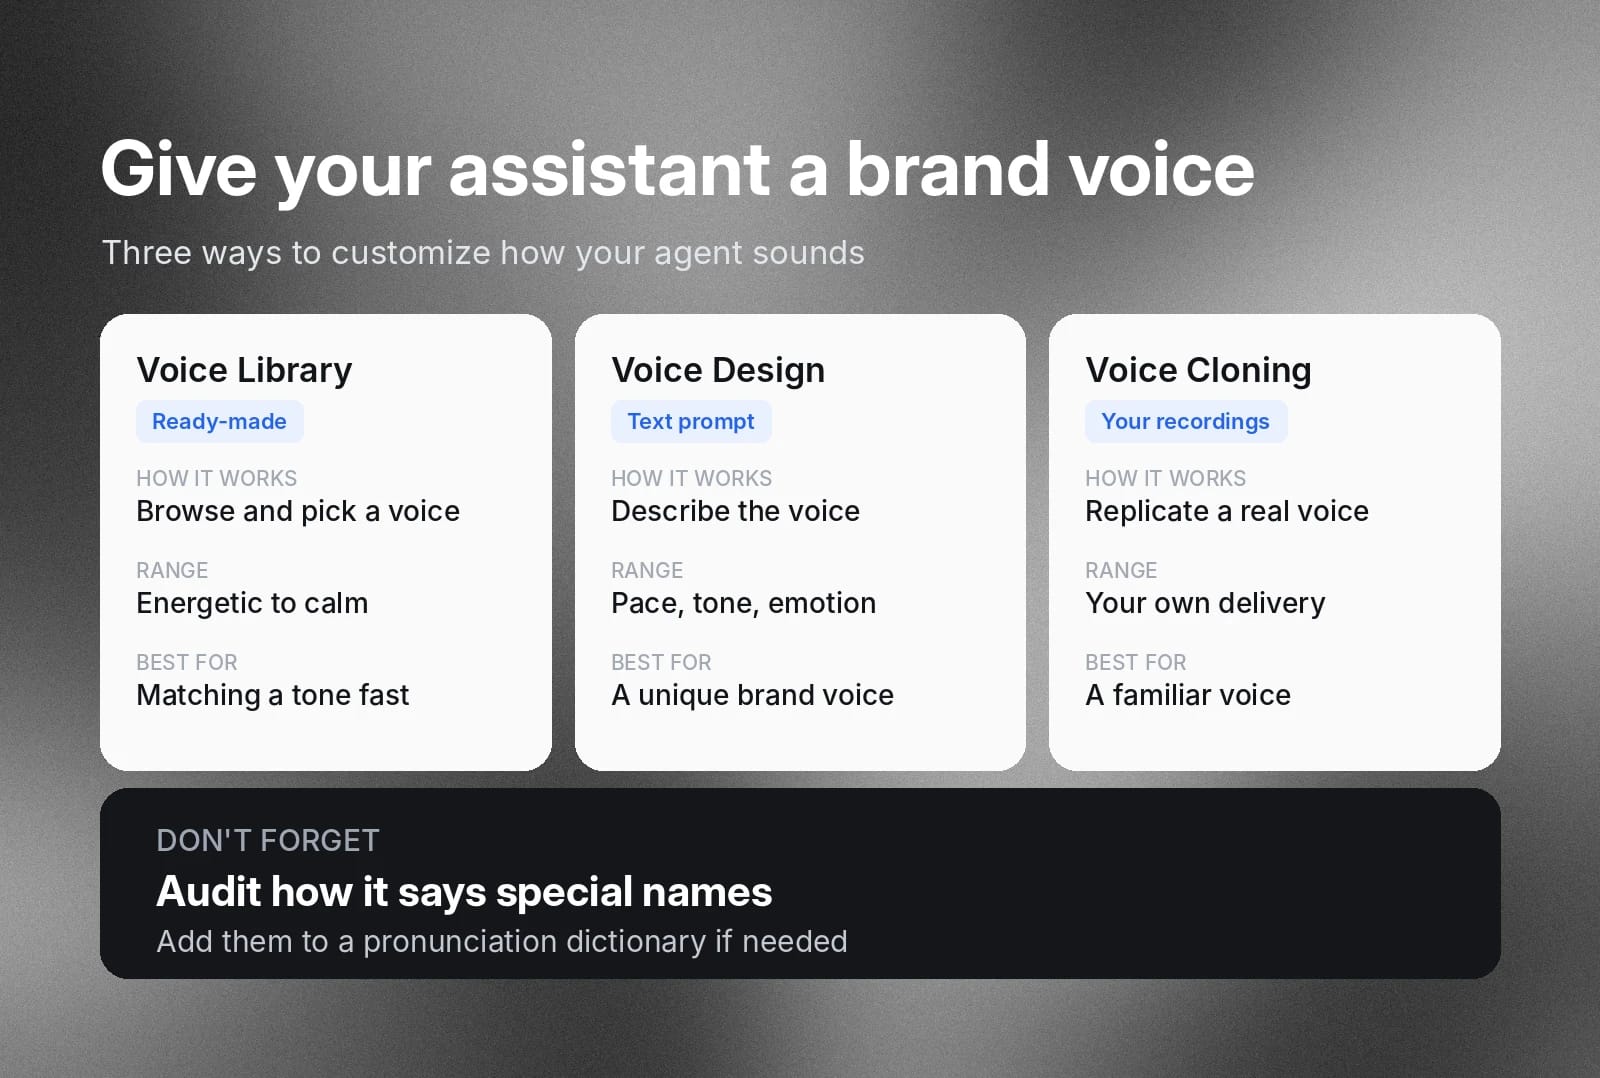
組織は、ブランドを反映するようAIエージェントの音声を調整できます。会話全体で一貫したトーンを保つことは、信頼の構築につながります。ElevenLabsでは、AIエージェントの音声を複数の方法でカスタマイズできます。
- ElevenLabsボイスライブラリでは、90以上の言語を自然に話す20,000以上のAI音声を提供しています。エネルギッシュな声から穏やかで自信に満ちた声まで、ブランドのトーンに合う音声を探して利用できます。
- ElevenLabsボイスデザインでは、テキストプロンプトから独自の声質を作成できます。話す速さ、トーン、感情、その他の音声特性を記述することで、希望する音声を作れます。
- ElevenLabs AIボイスクローンは、音声録音のサンプルを分析し、声のデジタルレプリカを作成します。
感情やニュアンスを適切に表現するだけでなく、特に固有名詞についてAI音声の発音を検証することも重要です。必要に応じて、音声モデルが参照できる発音辞書を作成してください。
リリース前に遅延、割り込み、精度、セーフティをテストする
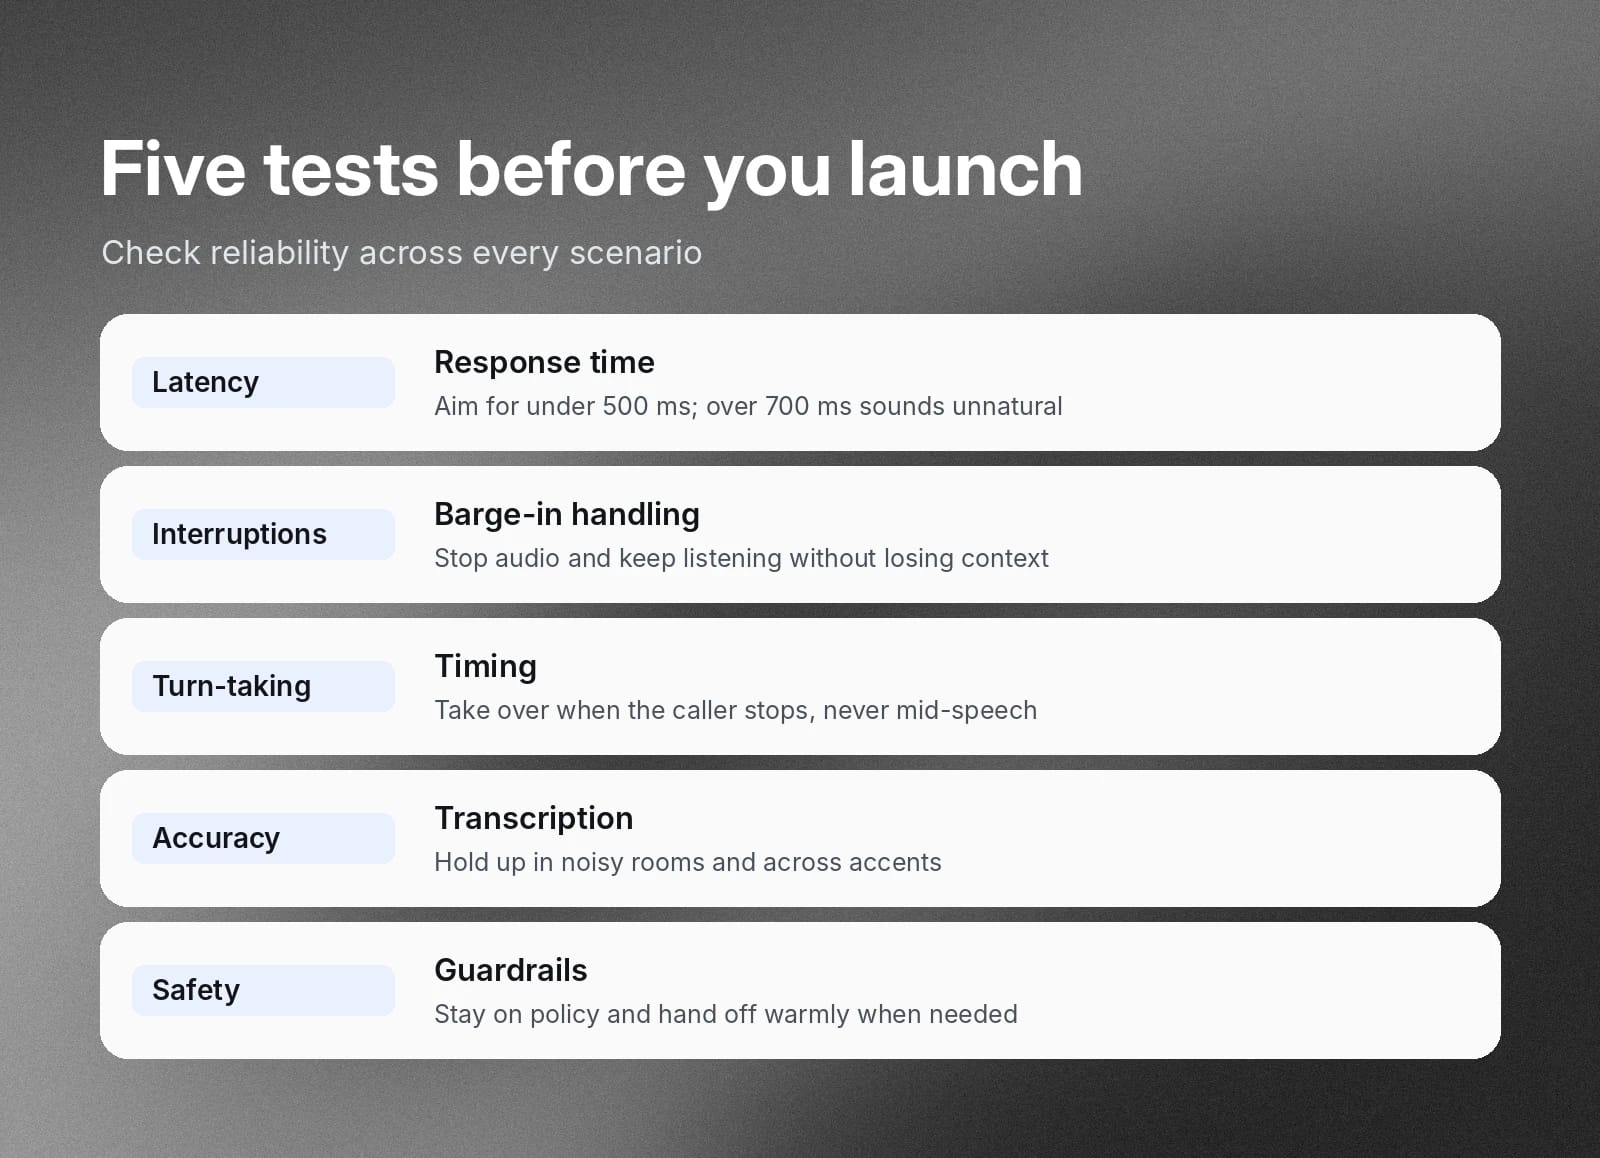
リリース前にAI音声エージェントを徹底的にテストし、さまざまなシナリオで安定して動作することを確認してください。
- 遅延テスト:応答に700ms以上かかるエージェントは、顧客に不自然な印象を与えます。構成によっては、ネットワーク速度、LLM、音声モデル、外部APIが遅延に影響します。会話の遅延は500ms未満に抑えるのが理想です。
- 割り込みテスト:エージェントが会話途中の割り込みに対応できるか確認します。具体的には、出力オーディオフレームを破棄してTTSを停止し、文脈を失うことなく音声入力の取り込みを再開できる必要があります。
- 話者交替テスト:ユーザーが話し終えたら、エージェントは自然に会話を引き継ぐ必要があります。適切なタイミングで応答を始めるか、発話の途中で割り込まないかを確認してください。詳しくは、ElevenLabsの話者交替への対応方法をご覧ください。
- 精度テスト:STTレイヤーの不正確さは後続の処理にも影響します。騒がしい環境でも音声アシスタントが発話を理解できることを確認してください。また、音声モデルはさまざまなアクセントの発話を一貫して正確に文字起こしする必要があります。
- セーフティテスト:ブランドポリシーに違反するシステム動作をガードレールで防止できることを確認します。やり取りが感情的になった場合、エージェントは事前設定されたガイドラインに従い、人間の担当者へのウォーム引き継ぎを行う必要があります。
成果を測定し、音声アシスタントの開発を改善する
社内テストの基準を満たせば、AI音声エージェントを実環境にデプロイする準備が整います。ただし、これは開発ライフサイクルの最終目標ではありません。AI音声エージェントが顧客のリクエストを継続して解決できるようにするには、デプロイ後の改善も同じく重要です。
会話型AIの指標から得たフィードバックを使って、AIアシスタントの課題を特定します。そのうえで、アプリケーションロジック、APIインテグレーション、モデルの選択、その他の技術スタック要素を段階的に改善し、会話型AIの性能を高めます。
自己完結率、解決率、顧客満足度、失敗パターンを追跡する
AIアシスタントを業界ベンチマークと継続的に比較して測定します。追跡すべき指標には次のようなものがあります。
- 自己完結率:AIエージェントだけで正常に解決できた会話の割合を追跡します。
- エスカレーション率:最終的に人間の介入が必要になった通話の割合を測定します。
- 単語誤り率:AIがオーディオをどれだけ正確に文字起こしできるかを示す精度指標です。
- ハルシネーション率:LLMが不正確ながらもっともらしい回答を生成した事例を示します。
- CSAT:AI音声エージェントに対する顧客満足度を示すフィードバックです。
AI音声アシスタント向けElevenAPIを使い始める
ElevenAPIは、AI音声アシスタントの開発を簡素化します。業界をリードするテキスト読み上げとスピーチtoテキストモデルを使って、企業のワークフローに自然に組み込める、文脈を理解する会話型AIエージェントを構築できます。ElevenLabsの音声・オーディオモデルは高精度かつ低遅延で安定して動作し、自然な顧客体験を実現します。
こちらでElevenAPIのAPIキーを取得し、公式ドキュメントを参照して構築を始めてください。
FAQ:AI音声アシスタントの構築

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


