会話型AIの測定:成功に不可欠な指標
- 公開日
- 最終更新日
会話型AIツールは、24時間体制のカスタマーサポートにかかるコストを大幅に削減します。深夜勤務の人員を配置したり、業務を海外委託することによるデータプライバシーのリスクを負ったりする必要もありません。
しかし、コスト削減が意味を持つのは、AIエージェントが顧客の問題を解決できる場合に限られます。適切な主要業績評価指標(KPI)で会話型AIを測定すれば、特に大量の顧客問い合わせを扱う企業にとって、それが機能しているかどうかを把握できます。
この記事では、会話フローと応答精度の評価が、顧客体験とブランドの両方をどう守るかを解説します。顧客体験チームが、発信者へのあいさつについて効果的なA/Bテストを実施する方法も紹介します。さらに、信頼性の高い多言語会話型AIプラットフォームを維持する方法も学べます。
概要
- 品質、体験、運用の指標にわたって会話型AIを体系的に測定することで、顧客体験を守るために必要なデータを得られます。
- 自動評価ツールは会話型AIの指標を大規模に継続して追跡・改善し、人による担当者は定期的な抜き取りチェックを行います。
- A/Bテストでは一度に1つの変数だけを切り分けることで、何が問題だったかを正確に特定し、特定された問題に直接対応する修正を導入しやすくなります。
- AI企業は基盤モデルを頻繁に更新するため、以前は信頼できたチャットボットでも本番環境で異なる挙動を示すことがあります。そのため、継続的な改善が必要です。
会話型AIの測定とは何か、なぜ重要なのか
会話型AIの測定とは、テスト済みまたは導入済みのAIエージェントが、顧客のリクエストにどれだけ対応し、問題を解決できているかを体系的に評価することです。目標は、設定したパフォーマンス基準に基づいて、自動化システムが現実世界の複数ターンの会話をどれだけ効果的に処理できるかを判断することです。一般的に、こうした基準は、モデルがユーザーの意図をどれだけ理解し、ブランドらしさを維持し、正確な応答を提供し、問題を解決できるかを反映します。
モデルの評価は、チームの業務を減らすためのシステムにとって、余分な作業が多いように感じるかもしれません。しかし、一貫した評価がなければ、実際のユースケースでモデルがどれほど機能しているかを知るのは困難です。つまり、AIシステムがカスタマーサポート運用コストを削減していることは分かっていても、顧客を満足させているのか、それとも別の解決策を探すよう促しているのかを確認できるでしょうか?
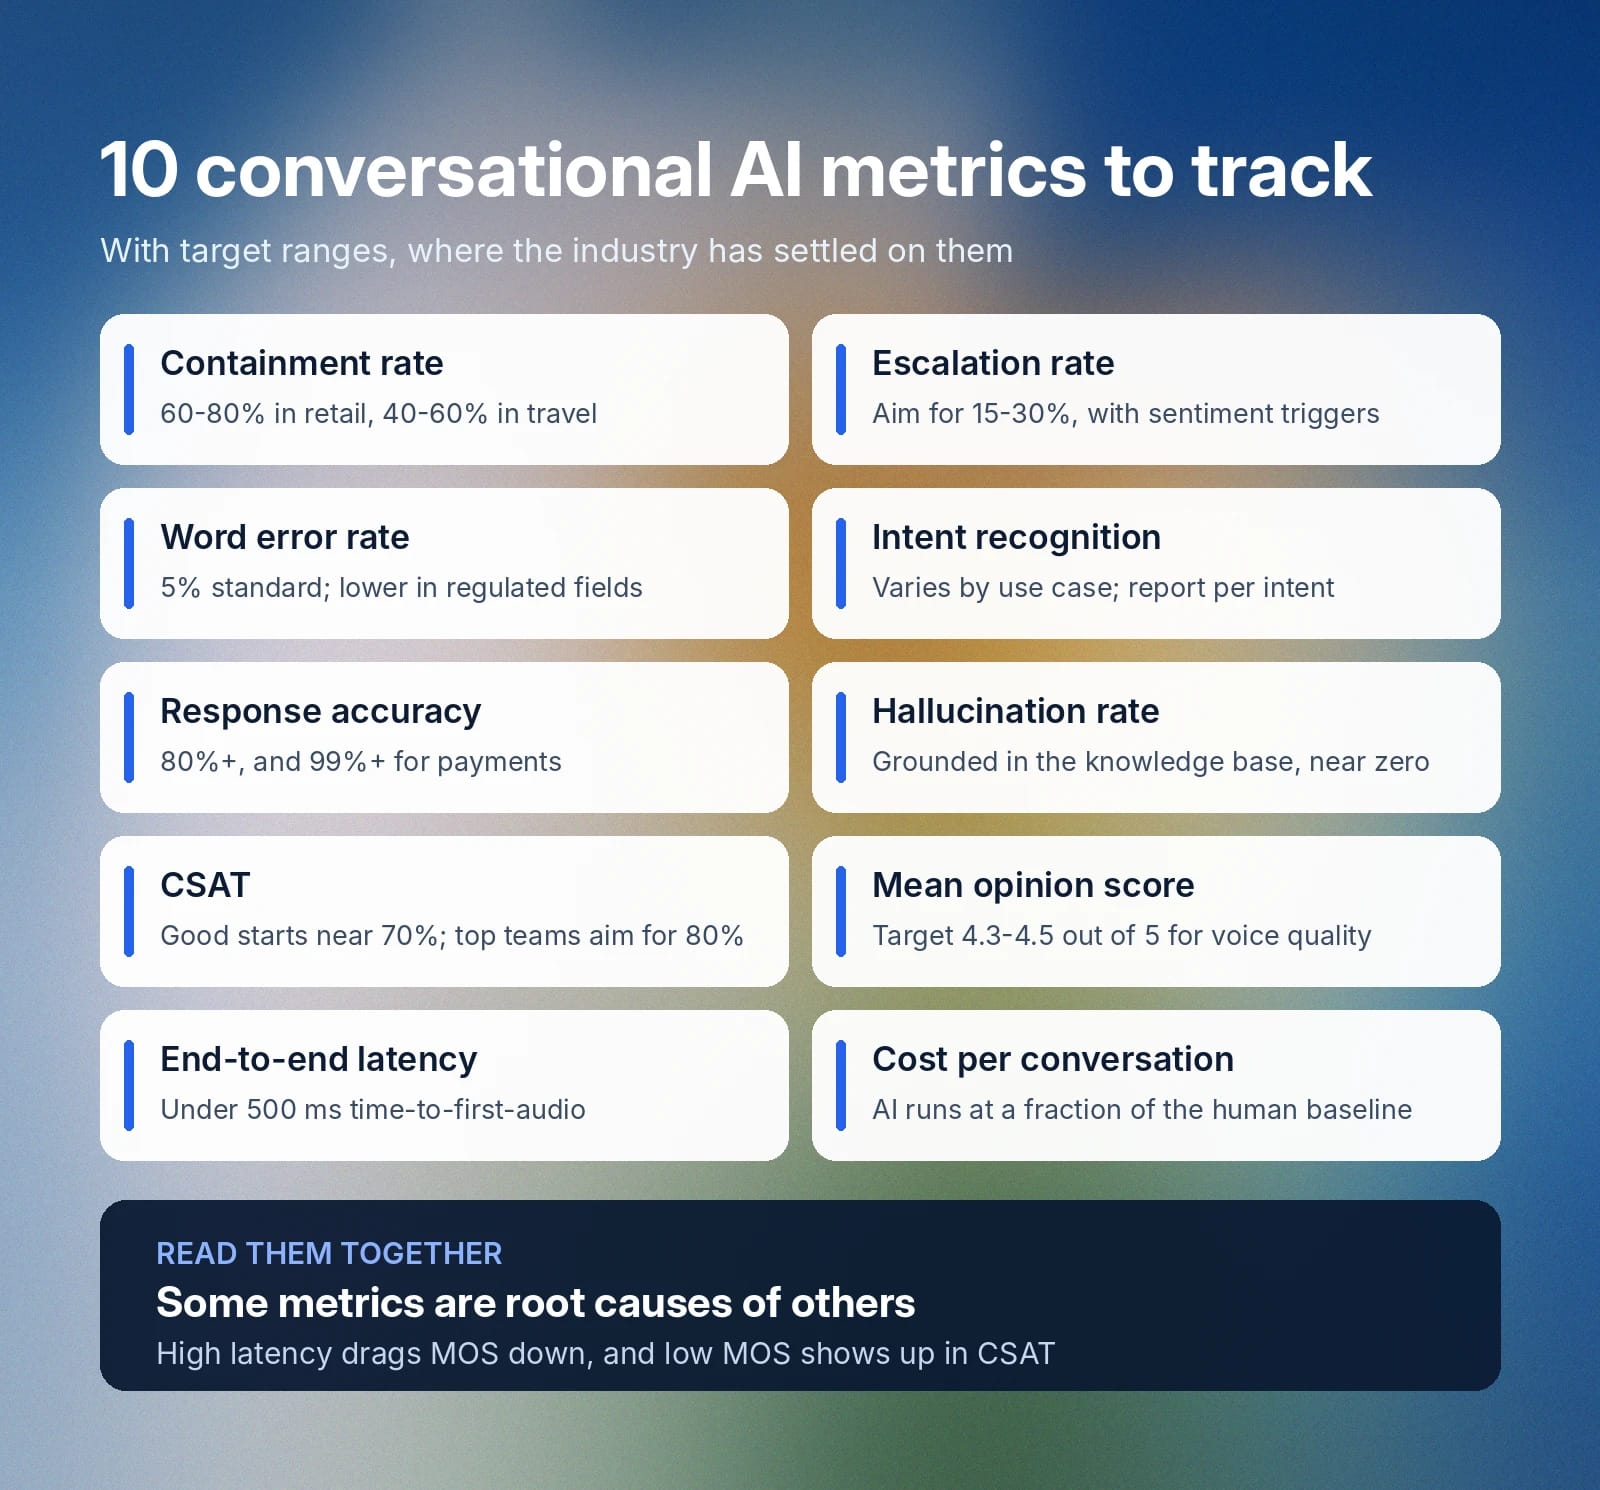
包括的な測定には、次の3つの主要カテゴリでモデルを評価する必要があります。
- 品質:ユーザーの最初のリクエストに照らして、AIの応答がどれほど正確で、一貫性があり、関連性が高いかを評価します。ここでの主な問いは、AIは正しく理解してユーザーに正解を提供できているのか、それともハルシネーションを起こして誤りを作っているのか、ということです。
- 体験:AIが迅速に応答したか、満足のいく回答を出すまでに何ターン必要だったかなど、顧客体験を評価します。ここでの主な問いは、その体験がユーザーにとって自然で役立つものか、それとも機械的でストレスを感じるものか、ということです。
- 運用:システムが信頼性高く動作し、カスタマーサポートのニーズに対して費用対効果の高いソリューションであり続けているかを判断します。主な懸念点には、システムの稼働率は高いか、利用を正当化するために必要な投資対効果を提供しているか、などがあります。
成功の形はチームごとに異なり、サポートを自動化する前に抱えていた最初の課題が大きな判断材料になります。たとえば、チームが当初、24時間365日のカスタマーサポートの維持に苦労していた場合、AIエージェントの常時対応により、カスタマーサポートのパフォーマンスを容易に高められます。ただし、これらのカテゴリはいずれも全体的な成功に重要です。常時オンラインでほとんどクラッシュしないシステムでも、機械的に感じられ、回答をハルシネーションするなら、顧客にとって大きな価値にはなりません。
追跡すべき会話型AIの主要指標
エージェントの顧客対応パフォーマンスや、現在の実装が実際のビジネス価値を生んでいるかを判断するには、明確で行動につながる数値を追跡しましょう。継続的な評価は、定期的な改善への道も開きます。ワークフロー内のボトルネックや調整が必要な箇所を具体的に特定すれば、根本原因に効果的に対処するためのデータを得られます。
音声通話とチャットボットのパフォーマンスを評価する際は、まず次の会話型AI指標を出発点として使用してください。
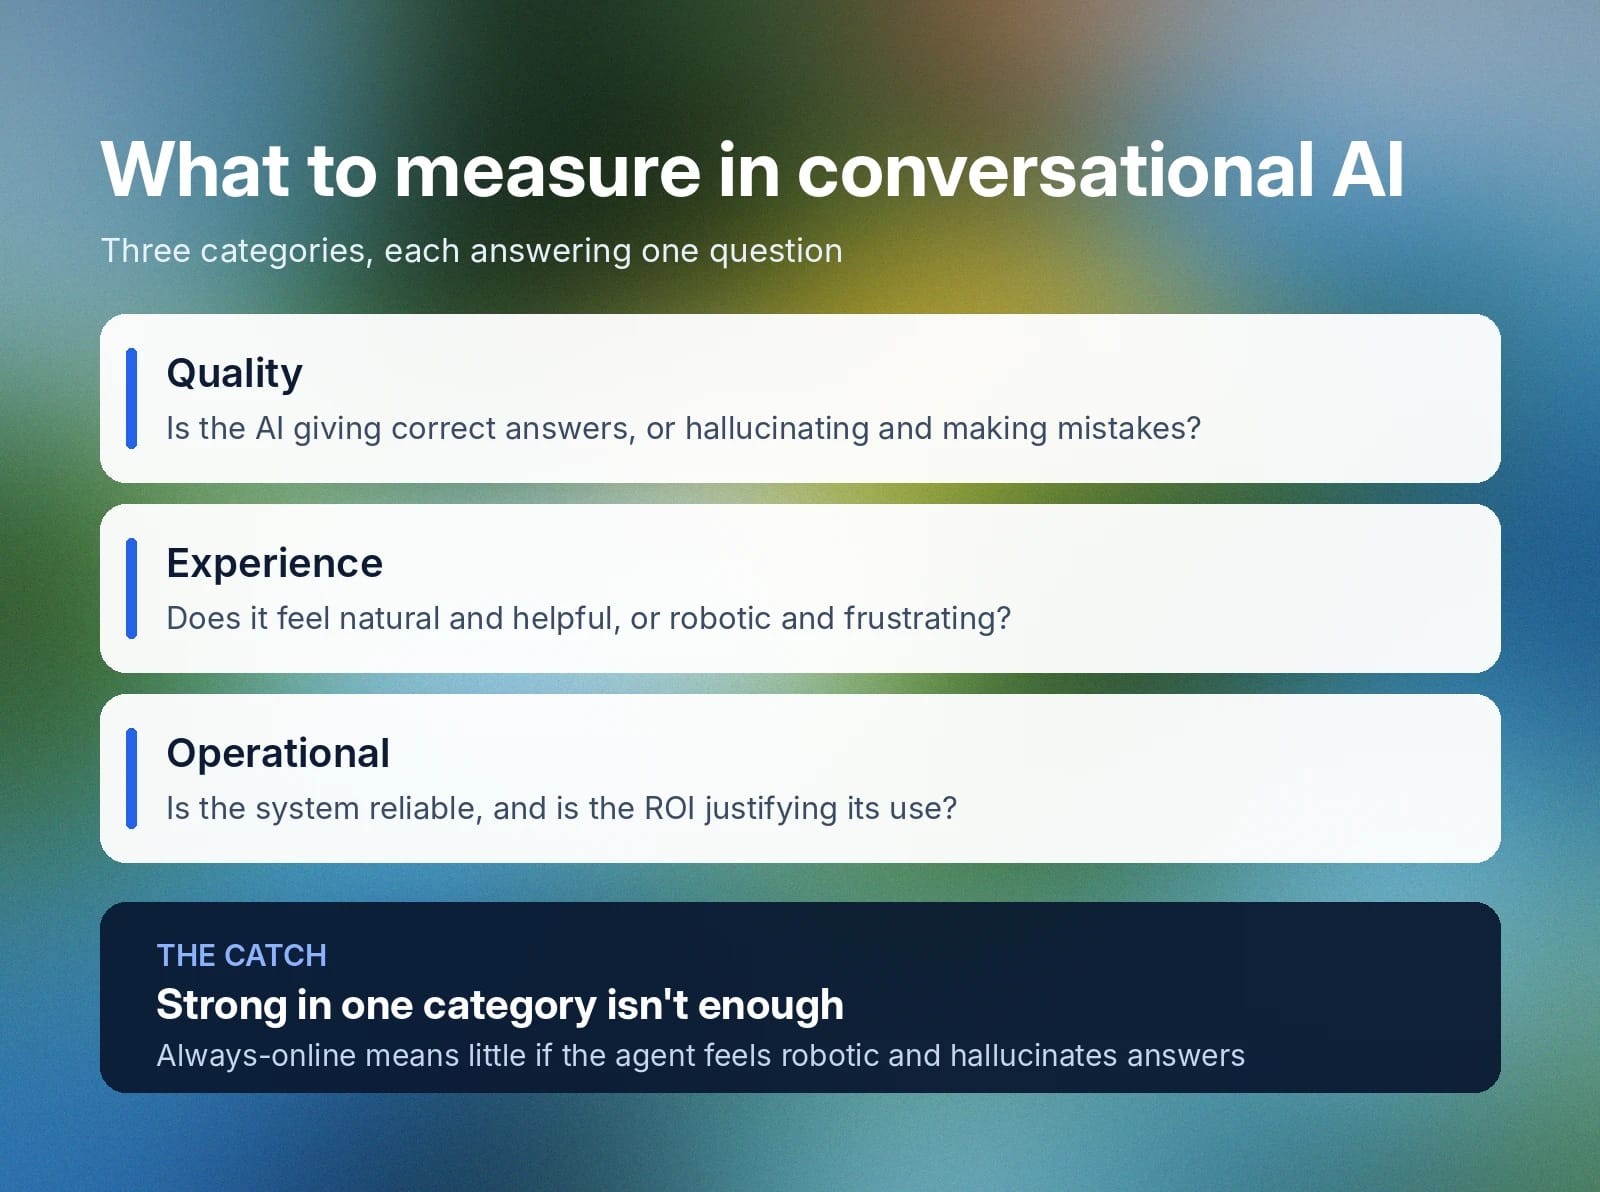
- 自己完結率:自動チャネル内で完全に解決された問い合わせの割合を追跡します。目標値は業界、状況、ユースケース、ボットの種類によって異なります。たとえば、小売業では60~80%が一般的ですが、旅行サイトでは40~60%です。
- エスカレーション率:AIエージェントが人間にエスカレーションせずに通話を処理できる頻度を測定します。積極的な企業では、感情がネガティブに傾いたらすぐに通話を人間へ引き継ぐ自動しきい値を設定しています。適切なエスカレーション率は業界やタスクの複雑さによって異なりますが、15~30%を目標にしましょう。
- 単語誤り率(WER):通話中または文字起こし時に、AIが単語をどれだけ正確に「聞き取れる」かを追跡します。業界の目安は5%ですが、医療、金融、法律など、規制のある分野や機密情報を扱うユースケースでは、より低いWERが必要です。
- 意図認識の精度:単語だけでなく、AIエージェントの成功は、ユーザーの課題と必要としていることを正確に理解することから始まります。精度の目標は、ユースケースや意図ごとのカテゴリによって異なります。
- 応答精度:モデルが真実で意味のある応答をどれだけ信頼性高く返せるかを判断します。これは、顧客が問題を解決できるようにするうえで不可欠です。一般的なカスタマーサービスの問い合わせでは80%以上が必要ですが、決済などのセンシティブなユースケースでは99%以上が求められます。
- ハルシネーション率:応答精度と密接に関連していますが、ハルシネーションは特に、ナレッジベースに基づく応答の事実正確性を判断します。役に立つ応答を提供し、モデルが企業が守れない約束をしないようにするには、ハルシネーション率を低く保つことが不可欠です。
- 顧客満足度(CSAT):通話後アンケートで顧客の感情を収集し、満足度を判断します。企業は5段階評価でこのデータを収集しますが、結果はパーセンテージで表すことが一般的です。SurveyMonkeyによると、優れたCSATスコアは通常70%程度から始まります。80%以上を目標にする企業もあります。
- 平均オピニオン評点(MOS):この人間中心の指標も5段階評価を使いますが、AIの応答がどれほど自然に聞こえるか、合成音声がどれほど明瞭かを測定することが目的です。MOSは4.3~4.5程度を目標にしてください。
- エンドツーエンドの音声レイテンシー:ユーザーがリクエストを完了してから、エージェントが応答を開始するまでの総遅延を測定します。本番運用レベルのエージェントは、エンドツーエンドの初回音声生成時間(TTFA)を500ミリ秒未満に抑えることを目標とします。ElevenLabs Flash v2.5モデルは現在、モデル内部の推論レイテンシーとして約75msを実現しています。実際のエンドツーエンドのレイテンシーは、所在地や使用するエンドポイントの種類などの要因によって異なります。
- 会話あたりのコスト:人間による対応と比較して、自動化された顧客対応ごとの総運用コストを測定します。ElevenLabsの会話は1分あたり10セントから利用できる一方、カスタマーサービス担当者の平均時給からすると、人間との会話には1分あたり約32セントかかります。これにより、およそ70%のコスト削減につながりますが、料金はプランや使用量によって異なる場合があります。最新の料金はElevenLabsの料金ページでご確認ください。
モデルのパフォーマンス測定に使用する指標を選ぶ際は、業界やビジネスモデルにとって最も重要な領域を考慮してください。たとえば、銀行業務や患者情報のような領域では精度と事実性が特に重要である一方、レイテンシー、MOS、エスカレーション率は、顧客体験を重視する企業にとって特に重要です。
一部の指標は、ほかの指標の根本原因を示すことにも注意してください。たとえば、レイテンシーが高いとMOSスコアが低下し、その結果、CSATで示される顧客満足度も低くなる可能性があります。
会話型AIの精度を測定する方法
実際の過去の会話を約500~1,000件用いて、グラウンドトゥルースのテストセットを構築し、モデル精度を測定します。実際のログには、合成データでは見落とされがちな誤字、スラング、ユーザーの入力ミスなど、雑多で自然な表現が含まれています。次に、意図認識、応答精度、ハルシネーション率について、これらの実際のログを基準にシステムを評価します。
LLM-as-a-judgeの採点手法を用いて、こうしたやり取りの自動評価を実行します。ただし、整合性を確認するため、自動スコアは必ず人間がラベル付けしたシステムと照合してください。その後、人間のレビュアーが、次のシンプルな3段階の評価基準を使って、毎週チャットボットのパフォーマンスを抜き取りチェックします。
- 正しい:応答が事実に基づき、文脈に関連し、ユーザーの主な意図を直接満たしている。
- 許容範囲:応答は技術的に正しく有用だが、軽微なスタイル上の問題、不自然な表現、ブランドらしくない書式がいくつかある。
- 誤り: 事実性の誤り、深刻なハルシネーション、またはユーザーの意図の完全な誤解が含まれているため、応答を直ちに修正する必要がある。
AIエージェントは、ある文脈では高いパフォーマンスを発揮する一方、別の文脈では大きく失敗することがあるため、理想的には意図ごとの手法でモデルを評価します。集計値を使うと、高パフォーマンスの領域により重大な弱点が隠れてしまいます。
ElevenAgentsのテストにNext Reply(シナリオ)テストを直接組み込むことで、このワークフローを簡素化しました。Next Reply機能は、会話全体ではなく、エージェントが送る次のメッセージを評価します。ただし、評価時点までのチャット履歴を提供し、その返信をポリシー、トーン、品質の基準に照らして採点します。
会話型AIの応答をA/Bテストする方法
A/Bテストでは、顧客が何を好むかを推測せず、現実世界からのフィードバックを収集します。その実証データを使って、AIモデルのパフォーマンスを微調整します。指標を追跡した後、チームには変更したいことや実施したい実験のリストがあるはずです。しかし、複数のことを同時に変更すると、何が機能し、何が機能しなかったのかを判断しにくくなります。
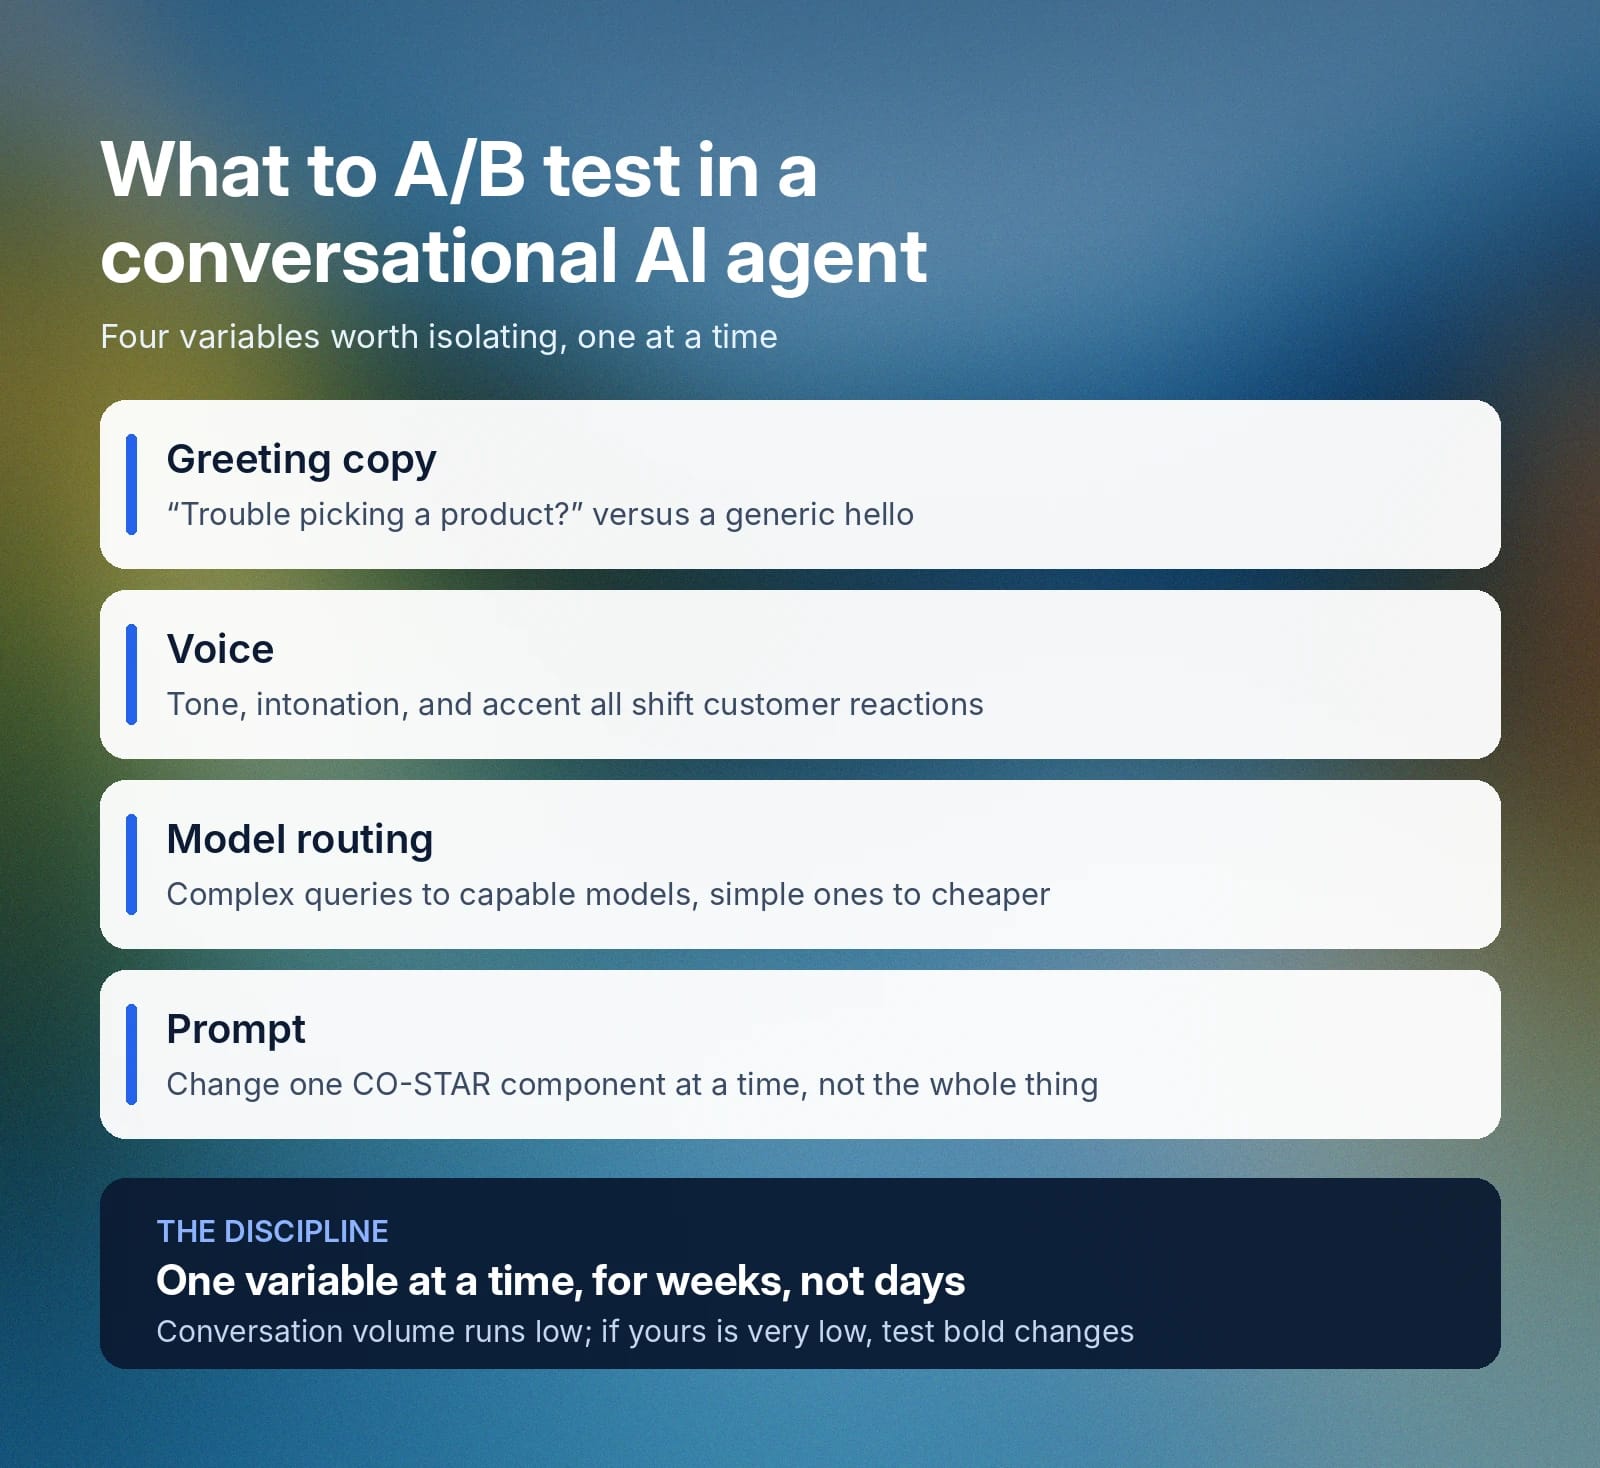
したがって、有効なテストを実施するには、基盤となるナレッジベースの残りの部分を一定に保ちながら、一度に1つの特定の変数を切り分ける必要があります。変更対象になり得る要素には、次のようなものがあります。
- あいさつ文:最初のあいさつメッセージを、単に「こんにちは、どのようなご用件ですか?」と言う代わりに、「こんにちは。商品選びでお困りですか?」のように具体的な内容へ調整します。
- 音声:特定の状況では、男性的か女性的か、トーン、イントネーション、さらにはアクセントによって、顧客がある音声をほかの音声より好意的に受け取る場合があります。
- モデルルーティング:高性能なモデルは通常コストも高いため、複雑な問い合わせと単純な問い合わせを適切に振り分けることが、効率的で費用対効果の高い選択肢になります。
- プロンプト:プロンプトには複数の要素があるため、コンテキスト、目的、スタイル、トーン、対象ユーザー、応答テンプレート(CO-STAR)など、一度に変更するのは1つの側面だけにしてください。
チームはテスト期間も調整すべきです。会話トラフィックは通常、Webページの閲覧数よりはるかに少ないため、統計的有意性を得るには数日ではなく数週間テストを実行する必要があります。ボリュームが極端に少ない場合は、小さな調整ではなく、大きく明確な変更をテストしてください。
実用的なワークフローには、エージェントのバージョン管理、比較、ロールバックのツールも必要です。これらはElevenAgentsに直接組み込まれています。
導入前に会話型AIエージェントをテストする方法
カスタマーサービスは収益に影響する人々との直接的な接点であり、AIは小さな変更にも予測不能な反応を示すことがあります。したがって、新規または改訂した会話型AIエージェントは、本番環境でリリースする前に必ずテストしてください。単なる「感覚的なテスト」では不十分です。
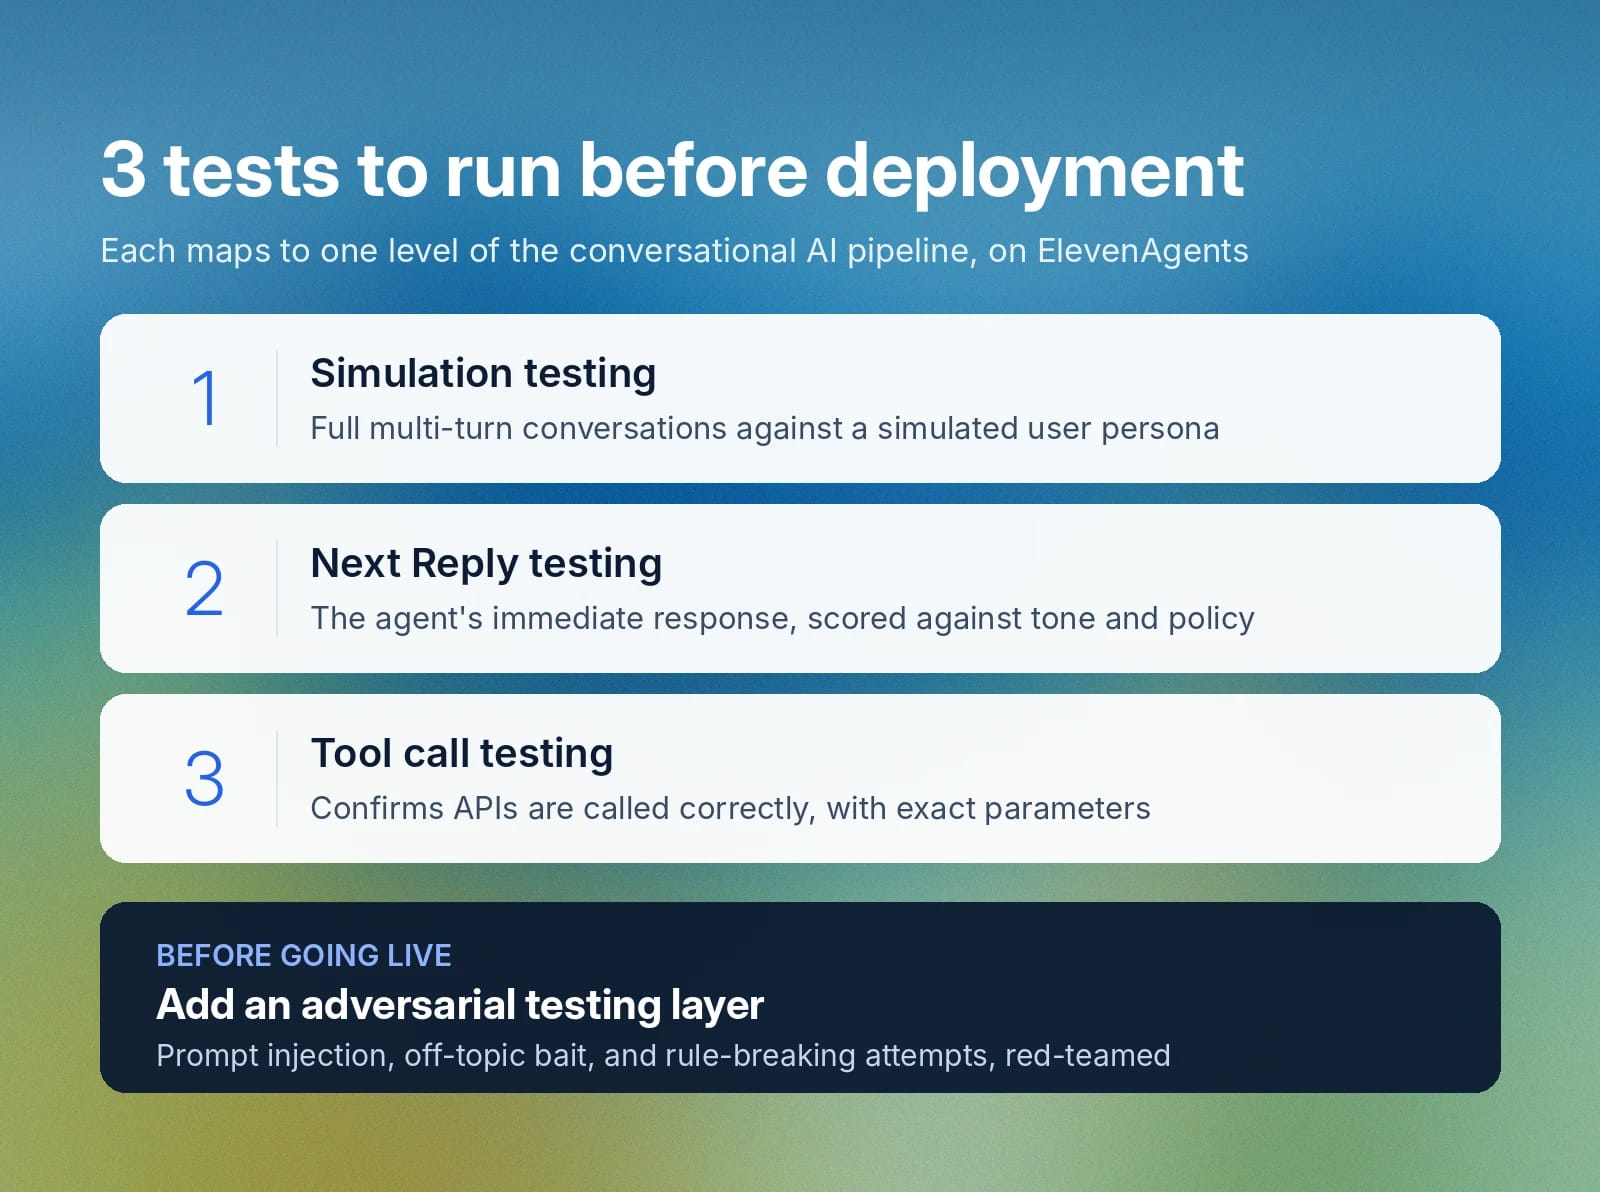
ElevenAgentsのテストフレームワークは、会話型AIパイプラインの特定のレベルを対象とする、次の3つの主要なテストタイプを中心に設計されています。
- シミュレーションテスト:完全なシミュレートされたユーザーペルソナとの複数ターンの会話を実行し、対話が求めるパフォーマンスレベルを満たしているかを確認します。
- Next Replyテスト:特定のトーン、ポリシー、その他の制約に対してエージェントの即時応答のみをテストし、応答の適切性と正確性を確認します。
- ツール呼び出しテスト:エージェントが接続されたAPIを正しく呼び出し、重要度の高いデータベース検索や転送に必要な正確なパラメータを渡すことを確認します。
悪意ある目的でモデルのジェイルブレイクを試みる攻撃者が多いため、本番稼働前には敵対的テストのレイヤーも必要です。QAチーム、プロンプトエンジニア、レッドチームのサイバーセキュリティ専門家と協力し、プロンプトインジェクション、話題から外れた誘導、ルール違反の試みをテストしてください。
最後に、少数のユーザーにパイロット版をリリースし、実際の行動を監視する段階的なロールアウトを行ってください。より大きなグループまたはすべての顧客にリリースする前に、モデルが満たすべき厳格な基準を設定します。また、リリースを監督する責任者を1人割り当て、調整によってパフォーマンス指標が低下した場合に備えてロールバック手順を用意してください。
本番環境でチャットボットのパフォーマンスを評価する
会話型AIモデルをリリースする前に、ユースケースごとの成功の定義を明確にしてください。これは、精度とデータプライバシーにより高い基準と厳格な要件がある、高度に規制された分野のアプリケーションでは特に重要です。
自動応答により、モデルのA/Bテストを大規模に実施しやすくなりますが、客観的なテストには、アドホックな文字起こしの確認と人間のテスターからのフィードバックを組み合わせる必要があります。ヒューマン・イン・ザ・ループは、AIモデルが見落とす会話のニュアンスや、集計値では失われてしまうデータの癖を捉えます。包括的な評価戦略には、感情分析とユーザーからの直接的なフィードバックも含まれます。
継続的な改善は、高い投資対効果を提供する成熟したシステムをさらに際立たせます。競合他社がテストと監視を別々のタスクとして扱う一方、成熟したパイプラインでは両者を1つに統合します。この場合、本番環境での失敗が直接テストセットに取り込まれ、次の最適化されたエージェントの学習に活用されます。
AI企業がエージェントの稼働するベースモデルを更新する際にも、定期的な調整が必要になります。この変更により、それまで効果的だったプロンプトが突然、信頼できない、あるいは不適切な回答につながることがあります。
このフィードバックループをプラットフォームに直接組み込んでいます。会話分析ツールを使用すると、構造化データの収集を自動化し、感情を簡単に評価できます。大規模組織では、エンタープライズ向け会話型AIインフラストラクチャも活用し、世界中でエージェントを安心して監視・拡張しています。
カスタマーサービス指標にElevenAgentsを活用する
会話型AIを大規模に導入して成功するには、高品質な音声と低レイテンシーのモデルだけでは不十分です。マルチエージェントのワークフローを設計、構築、テスト、導入、調整するための統合エコシステムが必要です。
ElevenAgentsは、必要なスケーラブルなインフラストラクチャを提供します。チームは、Next Reply検証、感情追跡、自動データ収集などのツールを利用して、最良の結果に向けてモデルを継続的に監視・最適化できます。さらに、問題の再発を顧客に届く前に発見できます。
会話型AIの測定プロセスをシンプルにする準備はできていますか?エージェントテスト機能を確認し、エンタープライズチームがカスタマーサービス指標を高める信頼性の高いエージェントをどのように導入しているかをご覧ください。
ElevenAgentsについて詳しく見る、または登録して、今すぐ始めましょう。
会話型AIの測定に関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。