音声エージェントの機能:記憶、エスカレーションなど
- 公開日
聴くこの記事を聴く
従来の電話システムは、スクリプト化されたメニュー主導の応答に依存していました。そのため、自然な会話への対応や複雑なワークフローのリクエスト処理には限界がありました。今日の音声エージェントは、リアルタイムの音声認識、推論、コンテキストを組み合わせることで、より柔軟な音声システムへと大きく進化しています。
最新の音声エージェントは、顧客認証、システム内の情報取得、ライブデータに基づく適切な応答、引き継ぎが必要な状況の判断などを行えます。これらはすべて通話中に実行され、ユーザーを電話キューで待機させて有人エージェントにつなぐ必要はありません。
このガイドでは、AI音声エージェントの機能に関する6つの疑問に答えます。発信者をどう記憶するのか、不満にどう対応するのか、どのようなデータで学習するのか、どうパーソナライズするのか、機密データをどう保護するのか、CSATにどのような影響があるのかを解説します。各項目では、ElevenAgentsでの実践的な方法を紹介します。
概要:
- 音声エージェントは、リアルタイムの音声認識とライブデータに基づく推論を組み合わせ、発信者を認証し、最新情報に基づいて回答し、電話キューを経由せずに通話中のタスクを完了できます。
- エージェントの記憶は、1回の通話内と繰り返しのやり取りの間で機能します。動的変数を使って通話開始時にCRMから顧客履歴を取得し、通話後Webhookで結果を記録します。
- 不満を抱えた発信者には、感情検出とリアルタイムの沈静化対応で対処します。不満が閾値を超えた場合や、発信者が担当者を求めた場合は、人間または専門エージェントへ転送できます。
- エージェントは、PDF、Word、テキスト、Markdown、HTML、EPUBなどのアップロード済みコンテンツから知識を構築します。RAGで関連する箇所を取得し、小規模なドキュメントはフルコンテキストに保持されます。
- パーソナライズされた提案では、CRMデータ、通話中のリクエスト、ツール呼び出しによる通話中の商品検索を組み合わせ、発信者の履歴と実際の在庫状況を照合します。
- 設定可能なプライバシー設定により、データ保持、オーディオ保存、文字起こしの編集、ゼロ保持モードを管理できます。エンタープライズ向け医療導入ではHIPAA適格です。
音声エージェントの機能とは?
音声エージェントは、顧客とリアルタイムで音声会話できる人工知能(AI)システムです。意図や状況のコンテキストを理解し、顧客に代わってタスクを完了できるため、従来の音声機能を超えています。顧客の話を聞き、その内容を推論し、リクエストの完了に必要なシステムを参照して、人間のカスタマーサービス担当者のような自然な口調で顧客に応答します。
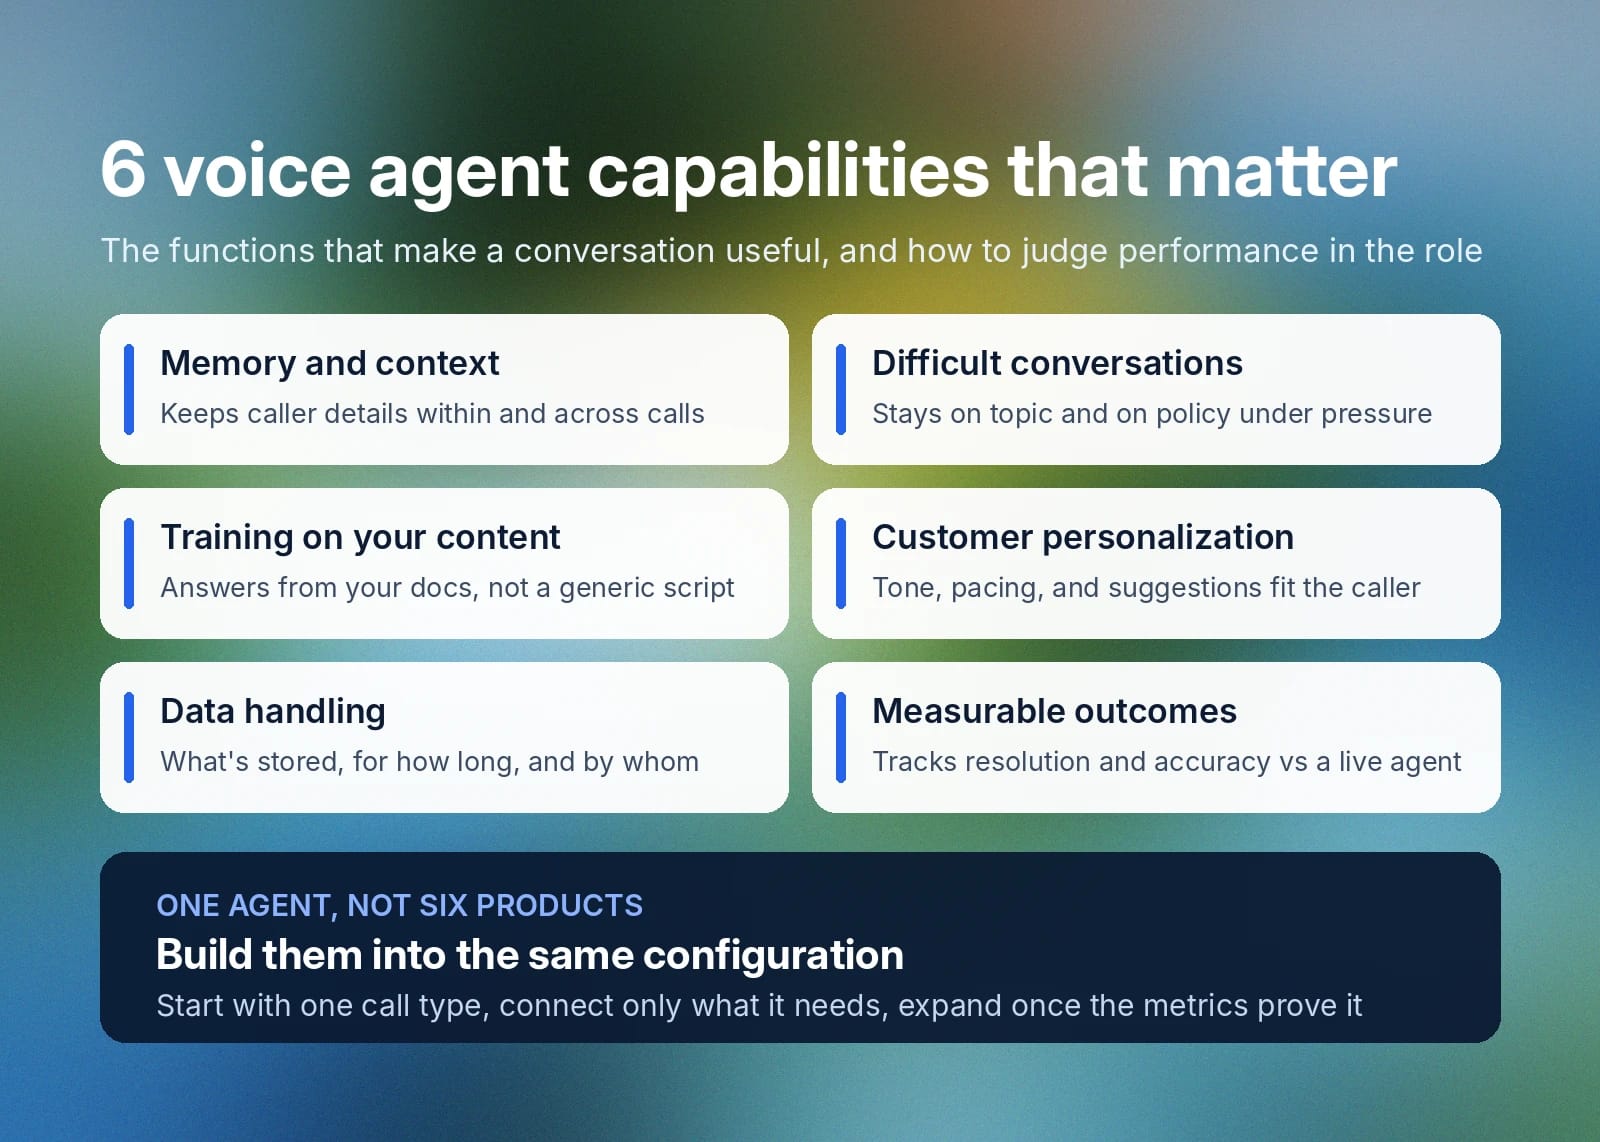
音声エージェントの機能とは、エージェントと顧客の会話を有用にする具体的な機能です。その役割でどれほど優れたパフォーマンスを発揮できるかは、次のカテゴリーに分けて判断できます:
- 記憶とコンテキスト:1回の通話または同じ顧客との複数回のやり取りにわたって、顧客に関する情報を保持する能力。
- 難しい状況や会話への対応:発信者が不満を抱えている、混乱している、または結果を受け入れようとしない場合でも、エージェントは話題を維持し、ポリシーに従います。
- コンテンツによるトレーニング能力:エージェントは、汎用的なスクリプトを使う代わりに、既存の社内ドキュメントやポリシーから学び、やり取りに必要な応答を取得します。
- 顧客ごとのパーソナライズ:エージェントは、画一的な選択肢メニューではなく、発信者に応じて口調、話すペース、提案を調整します。
- データ処理:エージェントと共有する情報は、保存するデータ、企業の保持期間、アクセスできるユーザーに基づいて管理されます。
- 測定可能な成功指標:音声エージェントが問題を解決しているか、有人エージェントと比較して正確に対応できているかをより適切に判断するための、社内トラッキングを提供する仕組み。
こうした音声エージェントの機能により、企業は顧客のニーズにより適したエージェントを構築できます。
音声エージェントは顧客との過去の会話をどのように記憶しますか?
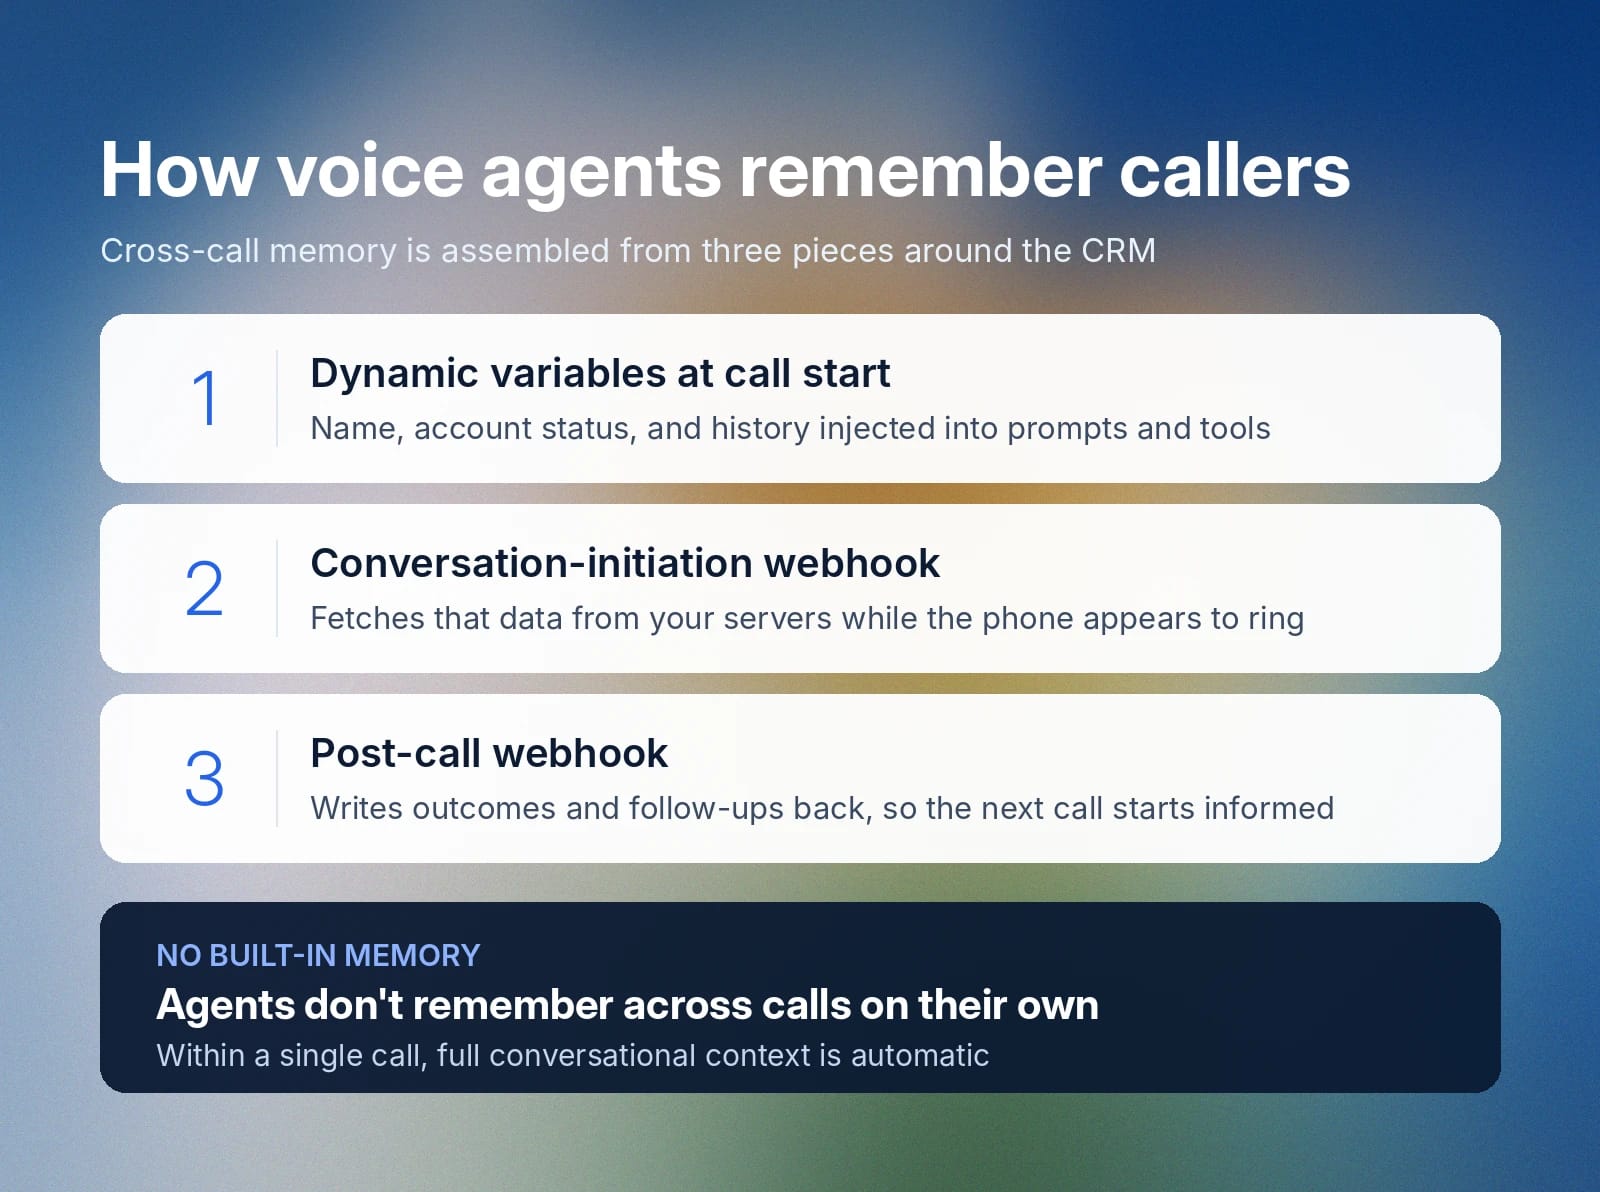
音声エージェントには、通話をまたぐ組み込みの記憶機能はありません。通話間の記憶は、通話開始時にCRMデータを注入する動的変数、そのデータを取得する会話開始Webhook、結果を書き戻す通話後Webhookという3つの要素で構成されます。1回の通話内では、エージェントが会話全体のコンテキストを自動的に保持します。
具体的なアーキテクチャに応じて、音声エージェントは顧客の記憶を次の2つのレベルで扱えます:
- 1回の通話内:エージェントは会話のコンテキストを維持し、セッション内で話されたすべてを追跡します。これにより、顧客が通話中に同じことを繰り返す必要を最小限に抑えます。
- 複数回のやり取りにわたって:この記憶は、マルチチャネルインテグレーションによって実現します。エージェントは通話の開始時に企業のCRMまたはデータベースから顧客履歴を取得し、やり取りの結果を記録します。これにより、次回の会話は履歴を把握した状態で始められます。
ElevenAgentsでは、会話の開始時に動的変数を通じてコンテキストを注入します。これらの変数は、実行時の値をエージェントのプロンプト、メッセージ、ツールに注入します。顧客ごとに個別のエージェントを作成しなくても、ユーザー固有の情報で各会話をパーソナライズできます。発信者の氏名、アカウント状況、識別可能な情報、過去のやり取りの履歴などを、会話の開始時に音声エージェントへ渡せます。
着信電話では、ElevenAgentsが会話開始Webhookを通じて企業サーバーから初期データを取得できます。エージェントがコンテキストを読み込む間に、エンドポイントから返されたJSONを適用します。ライブ環境では、プラットフォームが最初の顧客接続中に必要なデータを取得します。このプロセスは通常、エージェントが並行してコンテキストを確認している間の通常の呼び出し音や保留音として現れます。
通話終了後は、処理が逆方向に進みます。エージェントは、通話結果をCRMまたはサポートシステムに通話後Webhookや他の通話ツールを通じて送信します。通話中に起きたことや、顧客へのフォローアップが必要な事項を記録します。顧客とのやり取りを文書化することで、音声エージェントの記憶が持続します。これにより、顧客が次にやり取りするエージェントや有人担当者は、会話を始める前から全体の経緯を把握できます。
音声エージェントは不満や怒りを感じている顧客にどう対応しますか?
不満や怒りを感じる顧客は、あらゆるレベルやカスタマーサービス環境で発生し得ます。音声エージェントは、検出、適応、必要に応じたエスカレーションによって、このような状況に対応できます。
音声エージェントが顧客との難しい状況をどのように乗り越えるか、詳しく見ていきましょう:
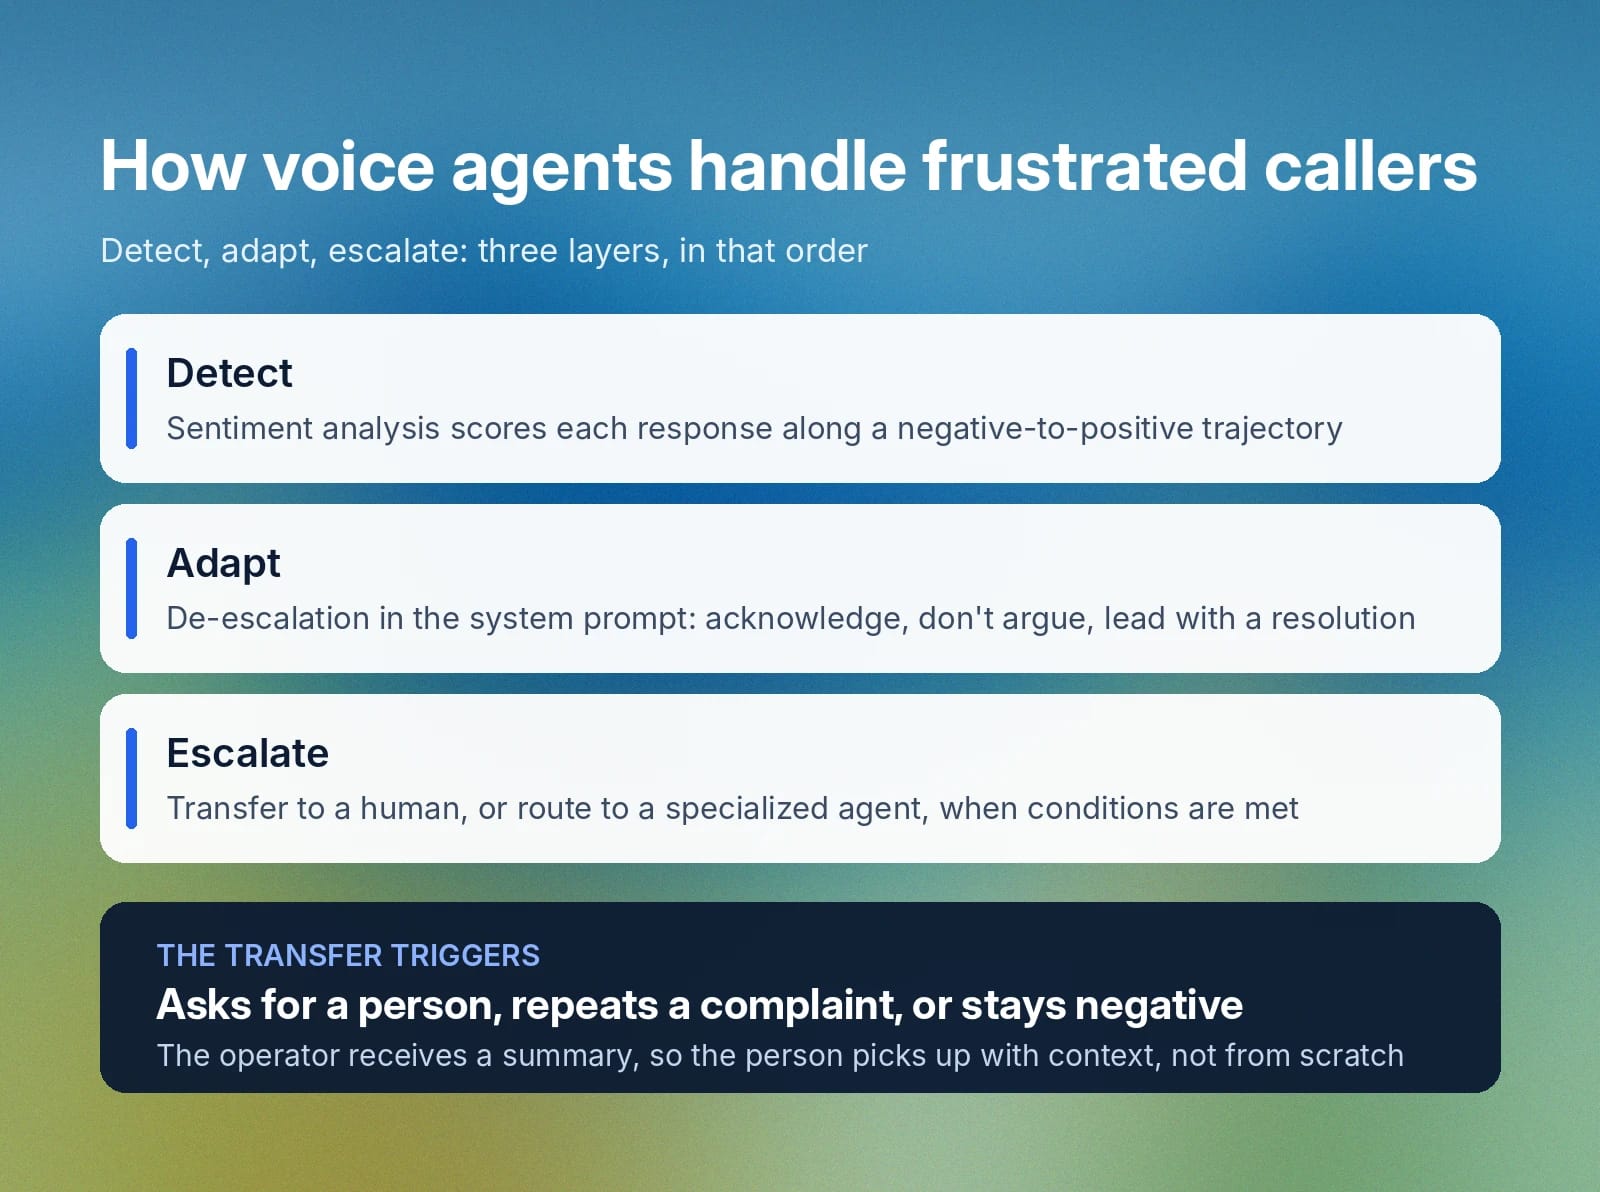
- 不満の検出:顧客の反応を検出するには、感情分析が最も効果的です。この分析では、会話をポジティブ、ネガティブ、ニュートラルにスコアリングします。個別の会話では、感情分析により各ユーザー応答をネガティブからポジティブへと続くスコア付きの推移として追跡でき、会話がどこでうまくいかなくなったかを確認できます。トピック別に検出結果を集計すると、発信者が最も不満を感じる領域を明らかにし、改善すべき箇所のデータを得られます。ElevenLabsで利用できるような先進的な音声エージェントモデルでは、ライブ文字起こしから口調を理解し、それに応じて対応を変えることもできます。
- リアルタイムでの適応:沈静化の動作は、エージェントのシステムプロンプトで直接定義できます。これにより、発信者の不満を認め、言い争いを避け、会話に沿った落ち着いた応答を維持し、解決への道筋を提示できます。
- 人間へのエスカレーション:電話番号転送ツールは、定義された条件が満たされたときに通話を人間へ引き継ぎます。通常は、発信者が担当者を求める場合、同じ苦情を2回繰り返す場合、または複数の連続したターンで感情がネガティブなままである場合です。これらの条件をシステムプロンプトに記述します。エージェントは発信者の待機中にメッセージを再生し、通話を受ける担当者には別途要約を渡せるため、担当者は最初からやり直すことなくコンテキストを把握した状態で応答できます。ElevenAgentsはエージェント間転送にも対応しており、人間ではなく別の専門知識が必要な場合に、会話を専門エージェントへルーティングできます。
不満を抱えた顧客への対応において、音声エージェントの機能で最も重要なのは転送経路です。
音声エージェントのトレーニングにはどのファイル形式を使用できますか?
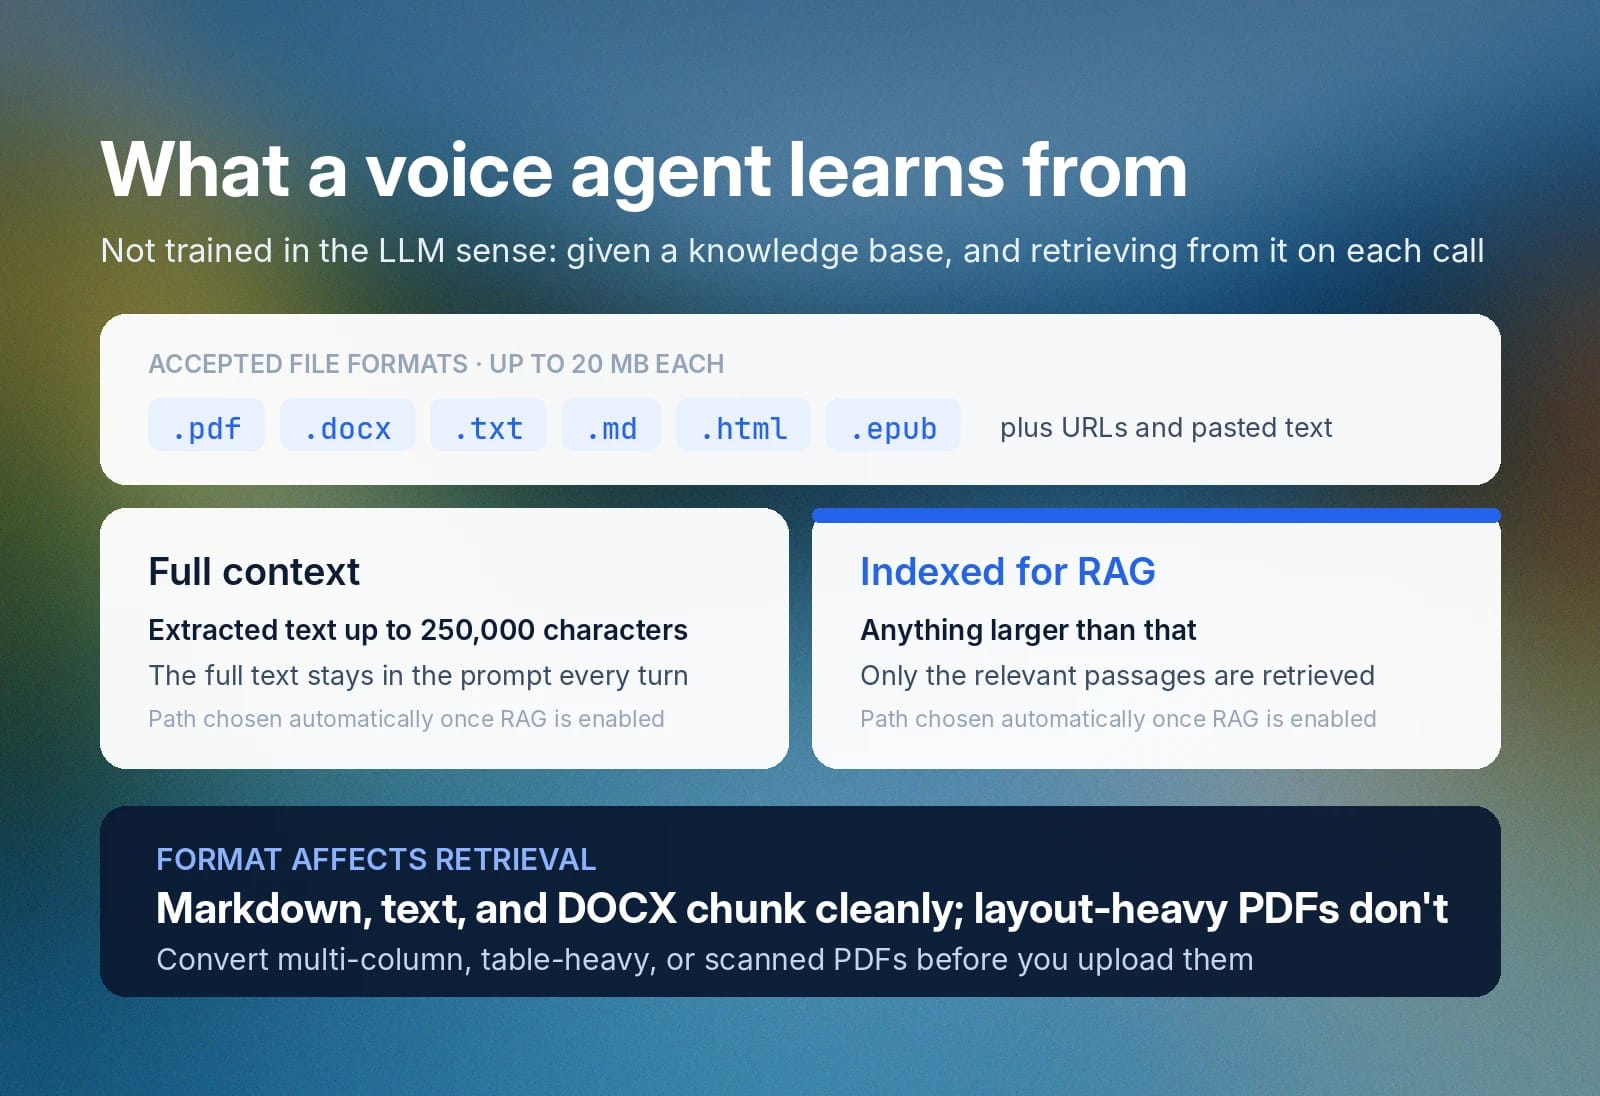
最新の音声エージェントは、従来のAI/LLMの意味でトレーニングされるわけではありません。エージェントには、活用するための知識が与えられます。ドキュメント、Webページ、またはナレッジベースを参照するプレーンテキストのリソースを提供し、エージェントは通話中にそこから関連する箇所を取得します。このアプローチは検索拡張生成(RAG)と呼ばれます。このプロセスにより、1つのプロンプトで提供できる情報をはるかに超える知識をエージェントが活用できます。
ナレッジベースに情報を追加する方法はいくつかあります。ファイルをアップロードする、エージェントにURLを指定する、またはテキストを直接貼り付けることから始めます。ElevenAgentsでは、アップロードするファイルは1件あたり最大20MBで、次の形式に対応しています:
- .docx
- .txt
- .md
- .html
- .epub
形式は検索の品質に影響します。Markdown、プレーンテキスト、DOCXはきれいに抽出され、RAG用のチャンクも予測可能です。複数列のレイアウト、表、スキャンページを含むPDFは抽出精度が低いため、アップロード前に変換してください。
ドキュメントを添付すると、エージェントは2通りの方法で利用します。小規模なドキュメントはフルコンテキストに置くことができ、ドキュメント全体のテキストが各ターンでプロンプトに保持されます。もう一方は、大規模なドキュメントをRAG用にインデックス化する方法です。
このプロセスでは、会話時に各質問に最も関連する箇所だけが取得されます。たとえば、抽出されたテキストが25万文字以内のドキュメントのみ、フルコンテキストで使用できます。それより大きいものはRAGで処理されます。RAGを有効にすると、システムが自動的に適切な方法を選択します。
音声エージェントはパーソナライズされた商品提案をどのように提供しますか?
パーソナライズされた商品提案は、音声エージェントとのやり取りの時点で、発信者に関する複数の情報を組み合わせることで実現します。これには、発信者が誰か、何を求めているか、何が利用可能かが含まれます。エージェントは、動的変数を通じて渡されるCRMデータから発信者に関する情報を把握します。
また、ライブ会話からリクエストを把握し、ツール呼び出しで商品データを確認して利用可能なものを把握します。そのうえで、十分な情報を得た人間の担当者と同じように、これらすべてを踏まえて発信者にパーソナライズされた選択肢を提案します。
実際の音声エージェントのコンテキストでこれがどのように機能するかを理解するために、実際の通話での流れを見てみましょう。
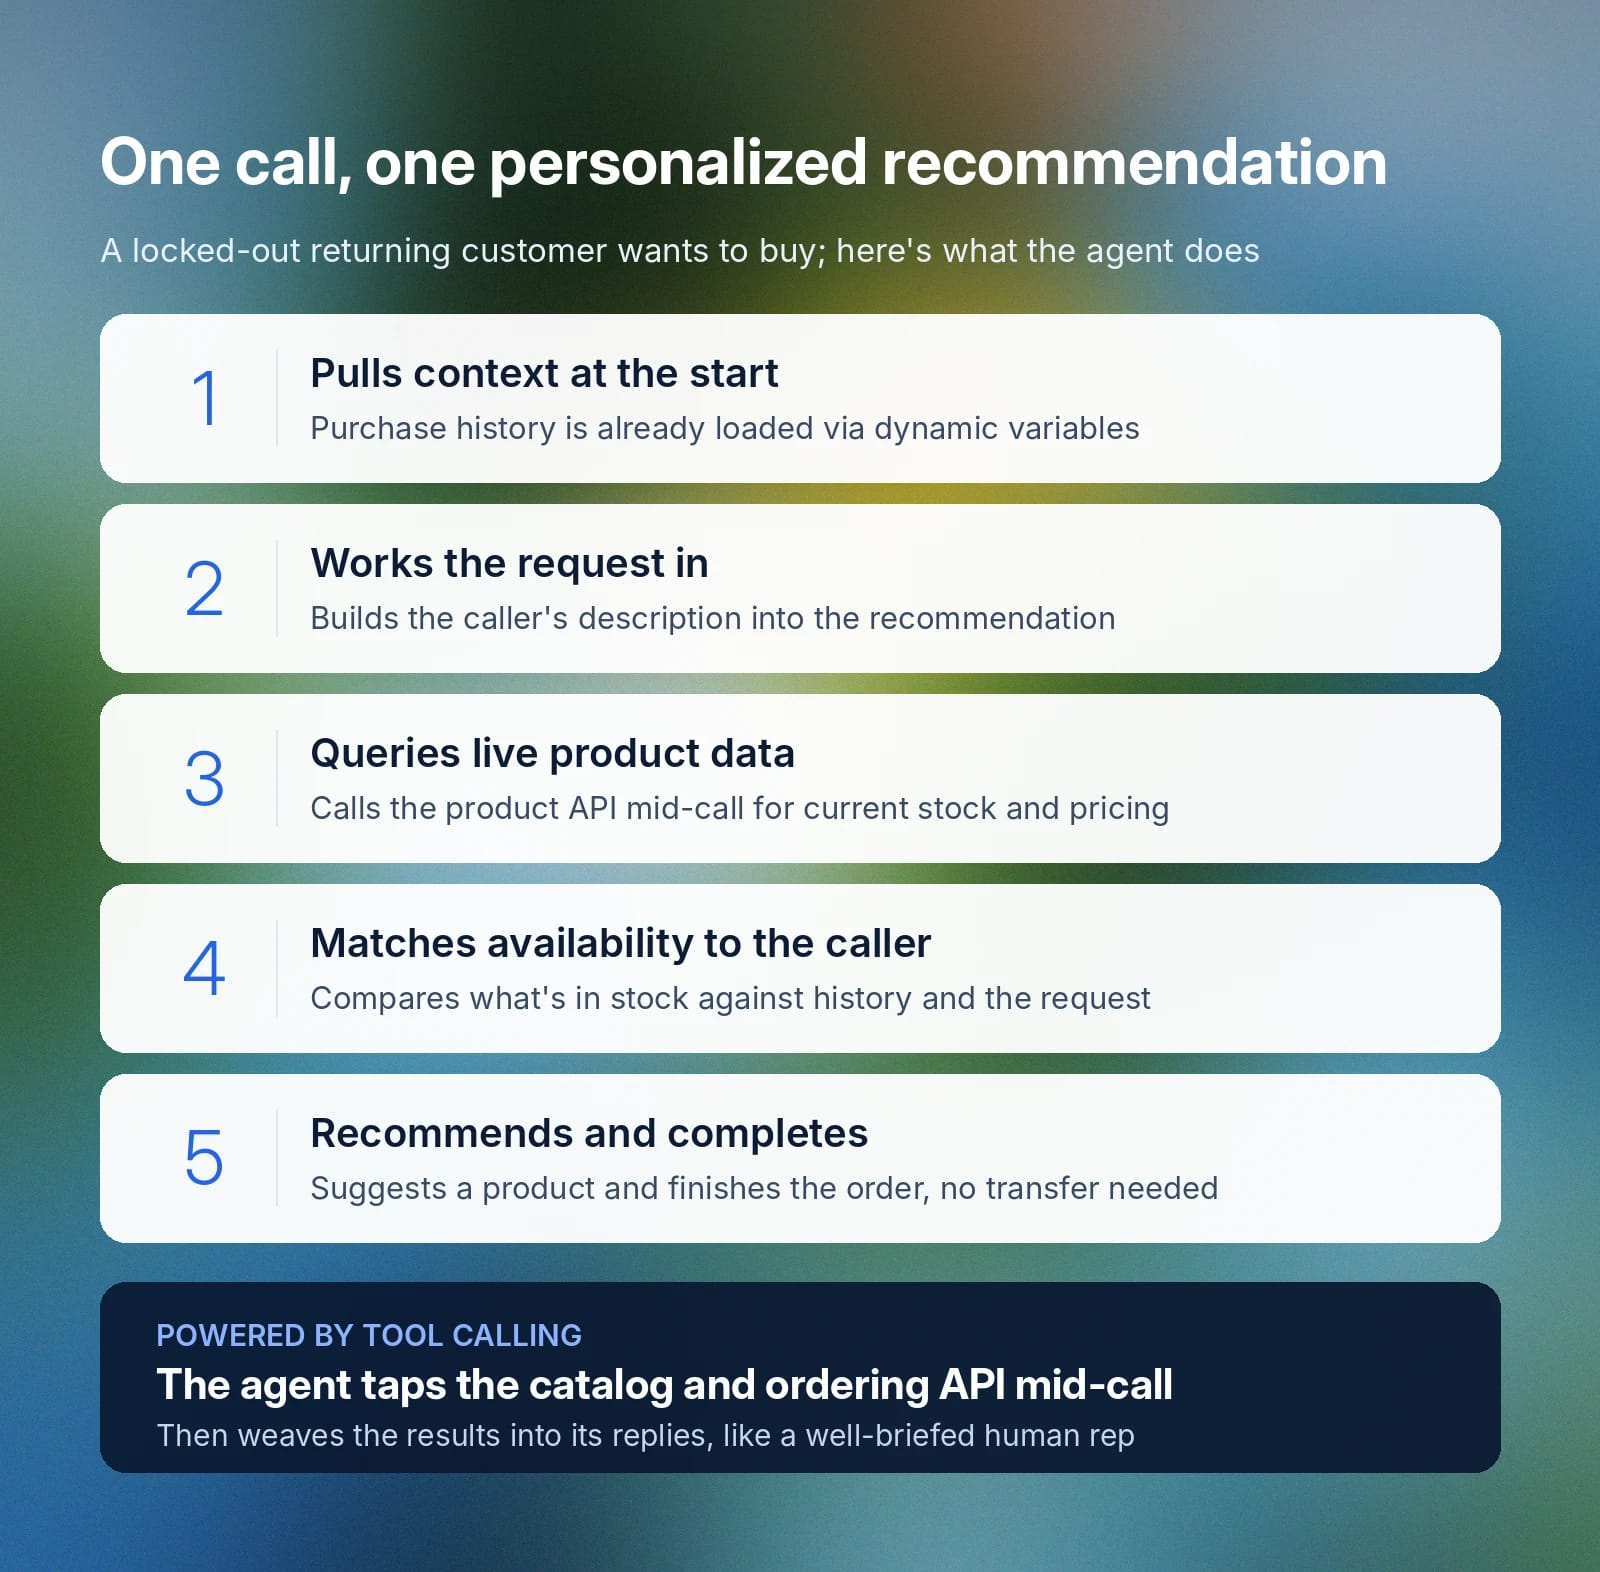
リピーターの顧客が、ユーザーアカウントにログインできず、購入もしたいという理由で、小売業者のテクニカルサポートに電話をかけます。音声エージェントは、この通話を次のようにパーソナライズされた提案につなげます:
- 開始時にコンテキストを取得:通話の開始時に取得されているため、エージェントはすでに発信者の購入履歴やその他の関連情報を把握しています。
- リクエストを提案に反映:発信者が必要なものを説明すると、エージェントはゼロから始めるのではなく、その説明を提案に反映します。
- 通話中にライブ商品データを照会:エージェントはトレーニング時の情報に頼るのではなく、会話中に商品APIを呼び出して現在の在庫数や価格を確認します。
- 発信者に在庫状況を照合:在庫がある商品を、発信者の説明や購入履歴と比較します。
- 提案して注文を完了:エージェントは商品を提案し、リクエストに応じて、発信者を別の窓口へ転送することなく注文を完了します。
この会話全体を支えているのがツール呼び出しです。これにより音声ボットは、商品カタログや注文APIなどの外部システムにアクセスし、その情報を応答に組み込めます。ElevenLabsのツールに関するドキュメントでは、この接続の設定方法を解説しています。
音声エージェントは機密性の高い顧客データを扱えますか?
音声エージェントでは、保持期間、通話オーディオを保存しないオプション、会話履歴の編集、医療などの高度に規制された業界向けの厳格な保持ポリシーを設定できます。
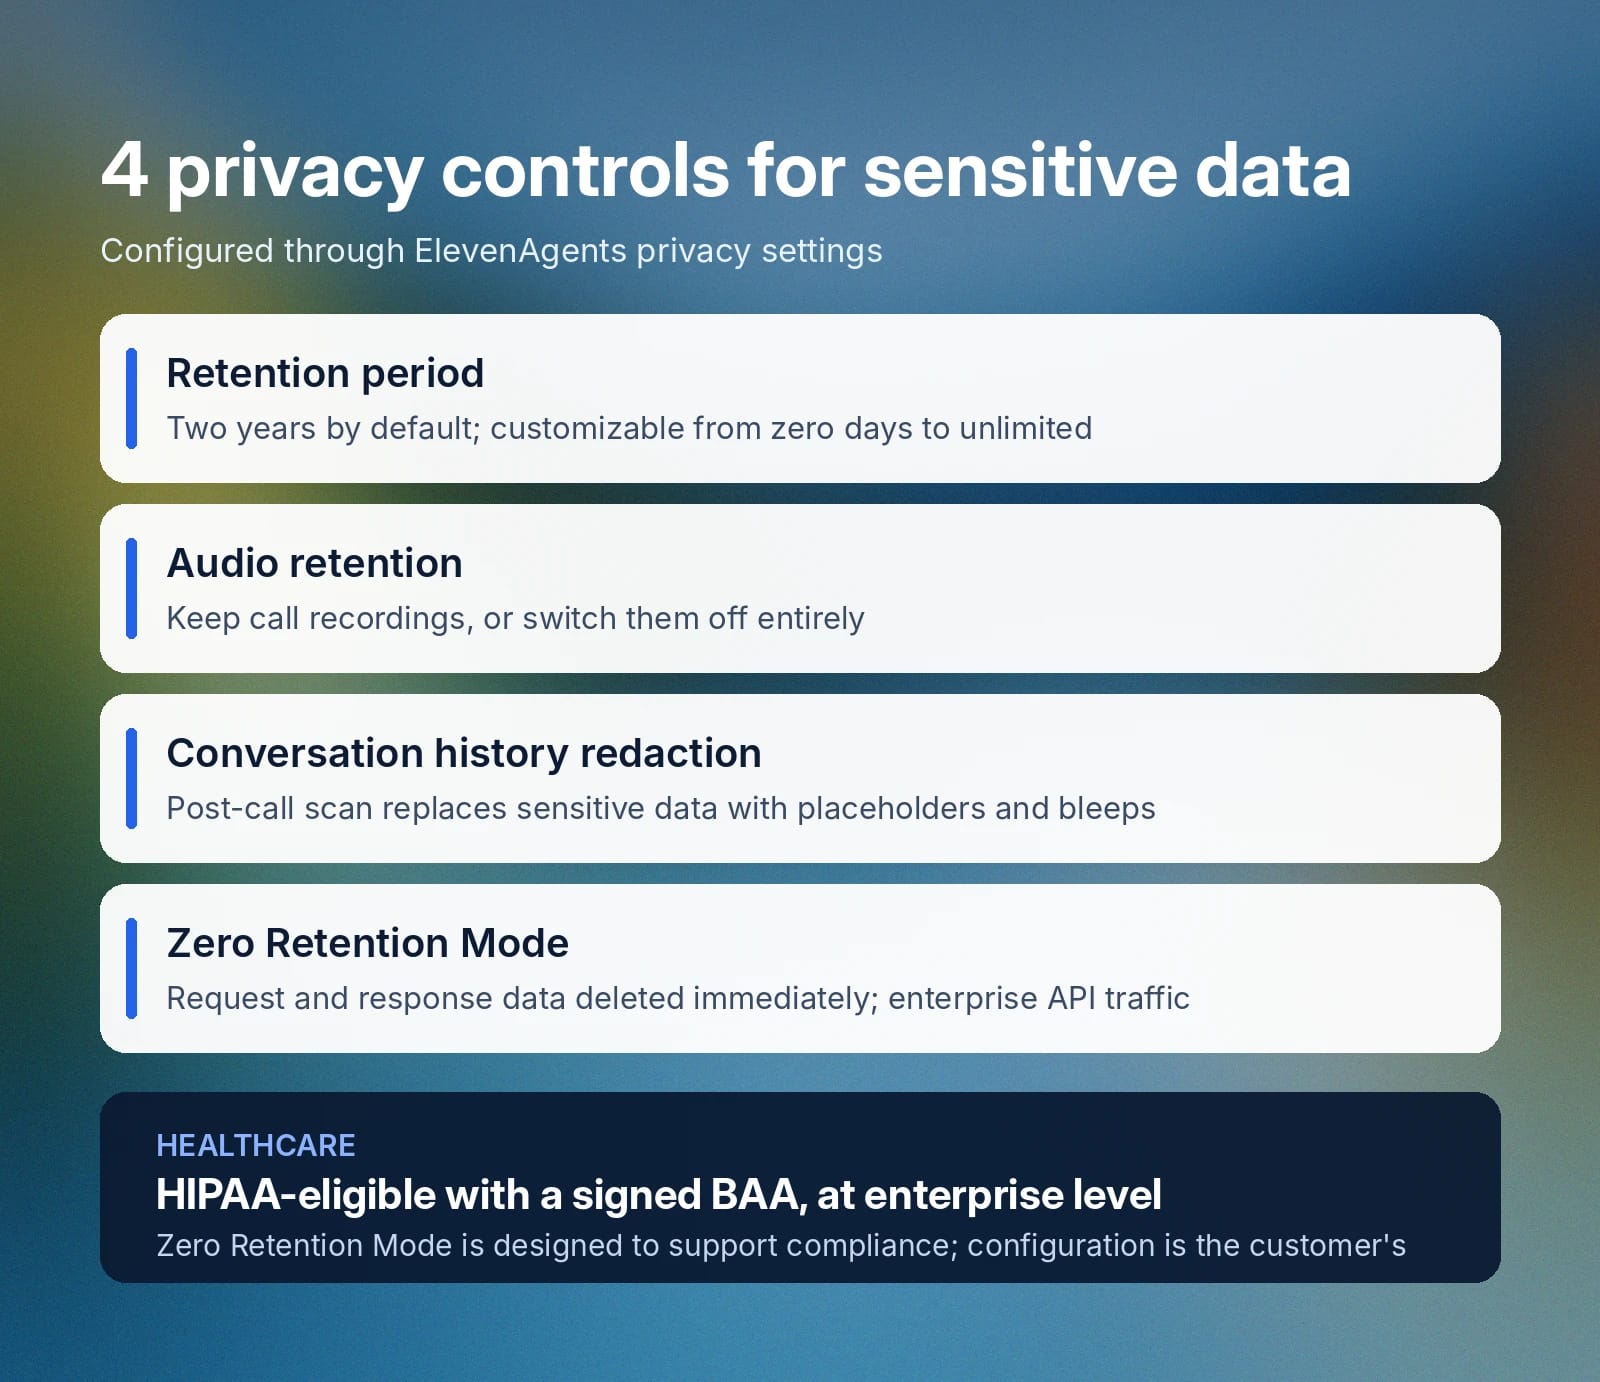
ElevenAgentsでは、これらすべての管理をプライバシー設定で構成します。仕組みは次のとおりです:
- 保持:会話の文字起こしとオーディオ録音は、指定した期間のみ保存されます。ElevenAgentsでは、文字起こしと録音をデフォルトで2年間保持しますが、0日から無期限までカスタマイズできます。HIPAA準拠には最低6年間の保持が推奨されます。HIPAAとの完全な整合性を確保するには、プラットフォーム上で保護対象保健情報を実際に処理する際、ゼロ保持モードを有効にする必要がある点にご留意ください。つまり、Webhookを通じて6年分の記録を自社インフラに安全に保存することになります。
- オーディオ保持:通話オーディオ録音は顧客保持の目的で保存することも、顧客のオーディオを保持しないよう完全にオフにすることもできます。オーディオ録音の保存を無効にし、保持ポリシーを0日に設定すると、データは通話直後に削除されます。
- 会話履歴の編集:会話終了後、各通話後に文字起こしとオーディオをスキャンする後処理ステップにより、機密性の高い顧客データを編集して保護できます。このステップでは、オーディオと文字起こしをスキャンして機密情報を検出し、文字起こしにはプレースホルダー、オーディオの抜粋にはビープ音を表示します。これにより、機密情報の露出を抑えながら会話履歴を確認用に保持できます。
- ゼロ保持モード:この設定は、厳格な保持要件に最適です。リクエストとレスポンスに含まれるほとんどのデータは、リクエスト完了後すぐに削除されます。この設定はAPIトラフィックに適用され、エンタープライズレベルの顧客が利用できます。
医療関連の導入では、エンタープライズレベルの顧客に提供されるBusiness Associate Agreement(BAA)と組み合わせることで、ElevenAgentsはHIPAA適格となります。署名済みのBAAと組み合わせたゼロ保持モードは、顧客がコンプライアンス要件を満たすようプラットフォームを設定・利用することを前提として、HIPAA準拠を支援するよう設計されています。これらの管理に関する完全な設定詳細は、ElevenLabsのプライバシードキュメントに記載されています。
音声エージェントは顧客満足度をどのように向上させますか?
顧客満足度の向上につながる要因には、保留時間の削減または解消、一貫性、迅速な解決があります。音声エージェントは遅延なく電話に応答できるため、発信者は時間帯にかかわらず一貫した品質の応答を受けられます。これにより、これまで有人エージェントを待つキューに置かれていた定型的なリクエストをより迅速に解決できます。
ただし、顧客とのやり取りで問題が起きた場合、不満を抱えた顧客をエージェントループに閉じ込めることは、保留音楽よりも早く顧客体験を損ないます。多くの組織は、顧客満足度を単独で追跡することはあまりありません。併せて報告される指標には、封じ込め率(人間の関与なしにエージェントがリクエストを解決する割合)、平均処理時間、初回通話解決率などがあります。
これらをレビュー用レポートで組み合わせると、単独の指標とは異なる状況が見えてくることがよくあります。たとえば、高い封じ込め率と顧客満足度スコアの低下が同時に見られる場合、人間の関与なしに通話が迅速に解決されていることを示す場合があります。
Admiralは、封じ込めよりも初回接点での解決を優先する好例です。このウェビナーで紹介したように、同社は24時間365日の対応と実質的なNPS向上に加え、90%の解決率を目標としていました。問題解決は通話を封じ込めることより重要だったため、人間への引き継ぎはエージェントの評価を下げる要因にはなりませんでした。
詳細を見るで、この音声エージェント機能がCRMと音声のセットアップにどのように結びついているかをご確認ください。
ElevenAgentsで音声エージェントの機能をフル活用する
このガイドで紹介した音声エージェントの機能は、独立した別々のプロダクトではありません。組織のビジネスニーズに応じた適切な動的変数、ツール、プライバシー設定とともに、同じエージェントと構成に組み込むべきものです。
まずは1つの通話タイプから始め、必要なシステムだけに接続するだけで導入できます。指標で効果を確認できたら、エージェントを拡張していけます。
ElevenAgentsについて詳しく知る、または営業担当者に問い合わせることで、今すぐ始められます。




