Infrastruttura IA vocale: lo stack del 2026 spiegato
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
L’infrastruttura IA vocale è l’insieme di modelli, connessioni, strumenti e servizi che consente a un agente IA di ascoltare una chiamata, decidere cosa fare, intervenire in altri sistemi e rispondere a voce. Con provider leader come ElevenLabs, tutto questo avviene in una frazione di secondo.
Un agente vocale in produzione si basa su uno stack di livelli che include riconoscimento vocale, gestione dei turni, un modello linguistico di grandi dimensioni, orchestrazione, strumenti, recupero delle conoscenze, sintesi vocale, telefonia e monitoraggio.
Questa guida spiega l’architettura degli agenti IA alla base di un agente vocale funzionante. Ogni sezione illustra cosa fa un livello, perché è importante nell’infrastruttura più ampia e come lo implementa ElevenAgents, usando Eleven v4 come esempio per il livello vocale.
Come si integra l’infrastruttura IA vocale
Un agente vocale trasforma l’audio in testo, ragiona in base a quell’input, genera una risposta e poi la ritrasforma nell’audio che il cliente ascolta. Questa sequenza di azioni è resa possibile da un solido stack di architettura per agenti IA.
Ecco i principali livelli che contribuiscono all’infrastruttura IA vocale nel 2026:
- Riconoscimento vocale: la tecnologia Automatic Speech Recognition (ASR) converte l’audio di chi chiama in testo da elaborare.
- Gestione dei turni: il turn taking decide quando chi chiama ha finito e quando smettere di parlare, rendendo la conversazione più fluida e reattiva.
- Modello/i linguistico/i: interpreta la richiesta trascritta e genera una risposta, dopo aver recuperato il contesto necessario.
- Orchestrazione: un livello di orchestrazione IA instrada la conversazione tra prompt, subagenti, strumenti e persone.
- Strumenti e MCP: collegano l’agente a sistemi esterni, come piattaforme CRM o contact center, per eseguire attività.
- Conoscenza e memoria: forniscono fatti e contesto su chi chiama tramite Retrieval Augmented Generation.
- Sintesi vocale: usa Text to Speech per trasformare la risposta generata in testo in audio.
- Trasporto e telefonia: trasportano l’audio tra l’agente e chi chiama.
- Guardrail, test e monitoraggio: mantengono l’agente focalizzato e misurabile.
Insieme, questi componenti creano conversazioni in tempo reale tra agenti IA e clienti che chiamano.
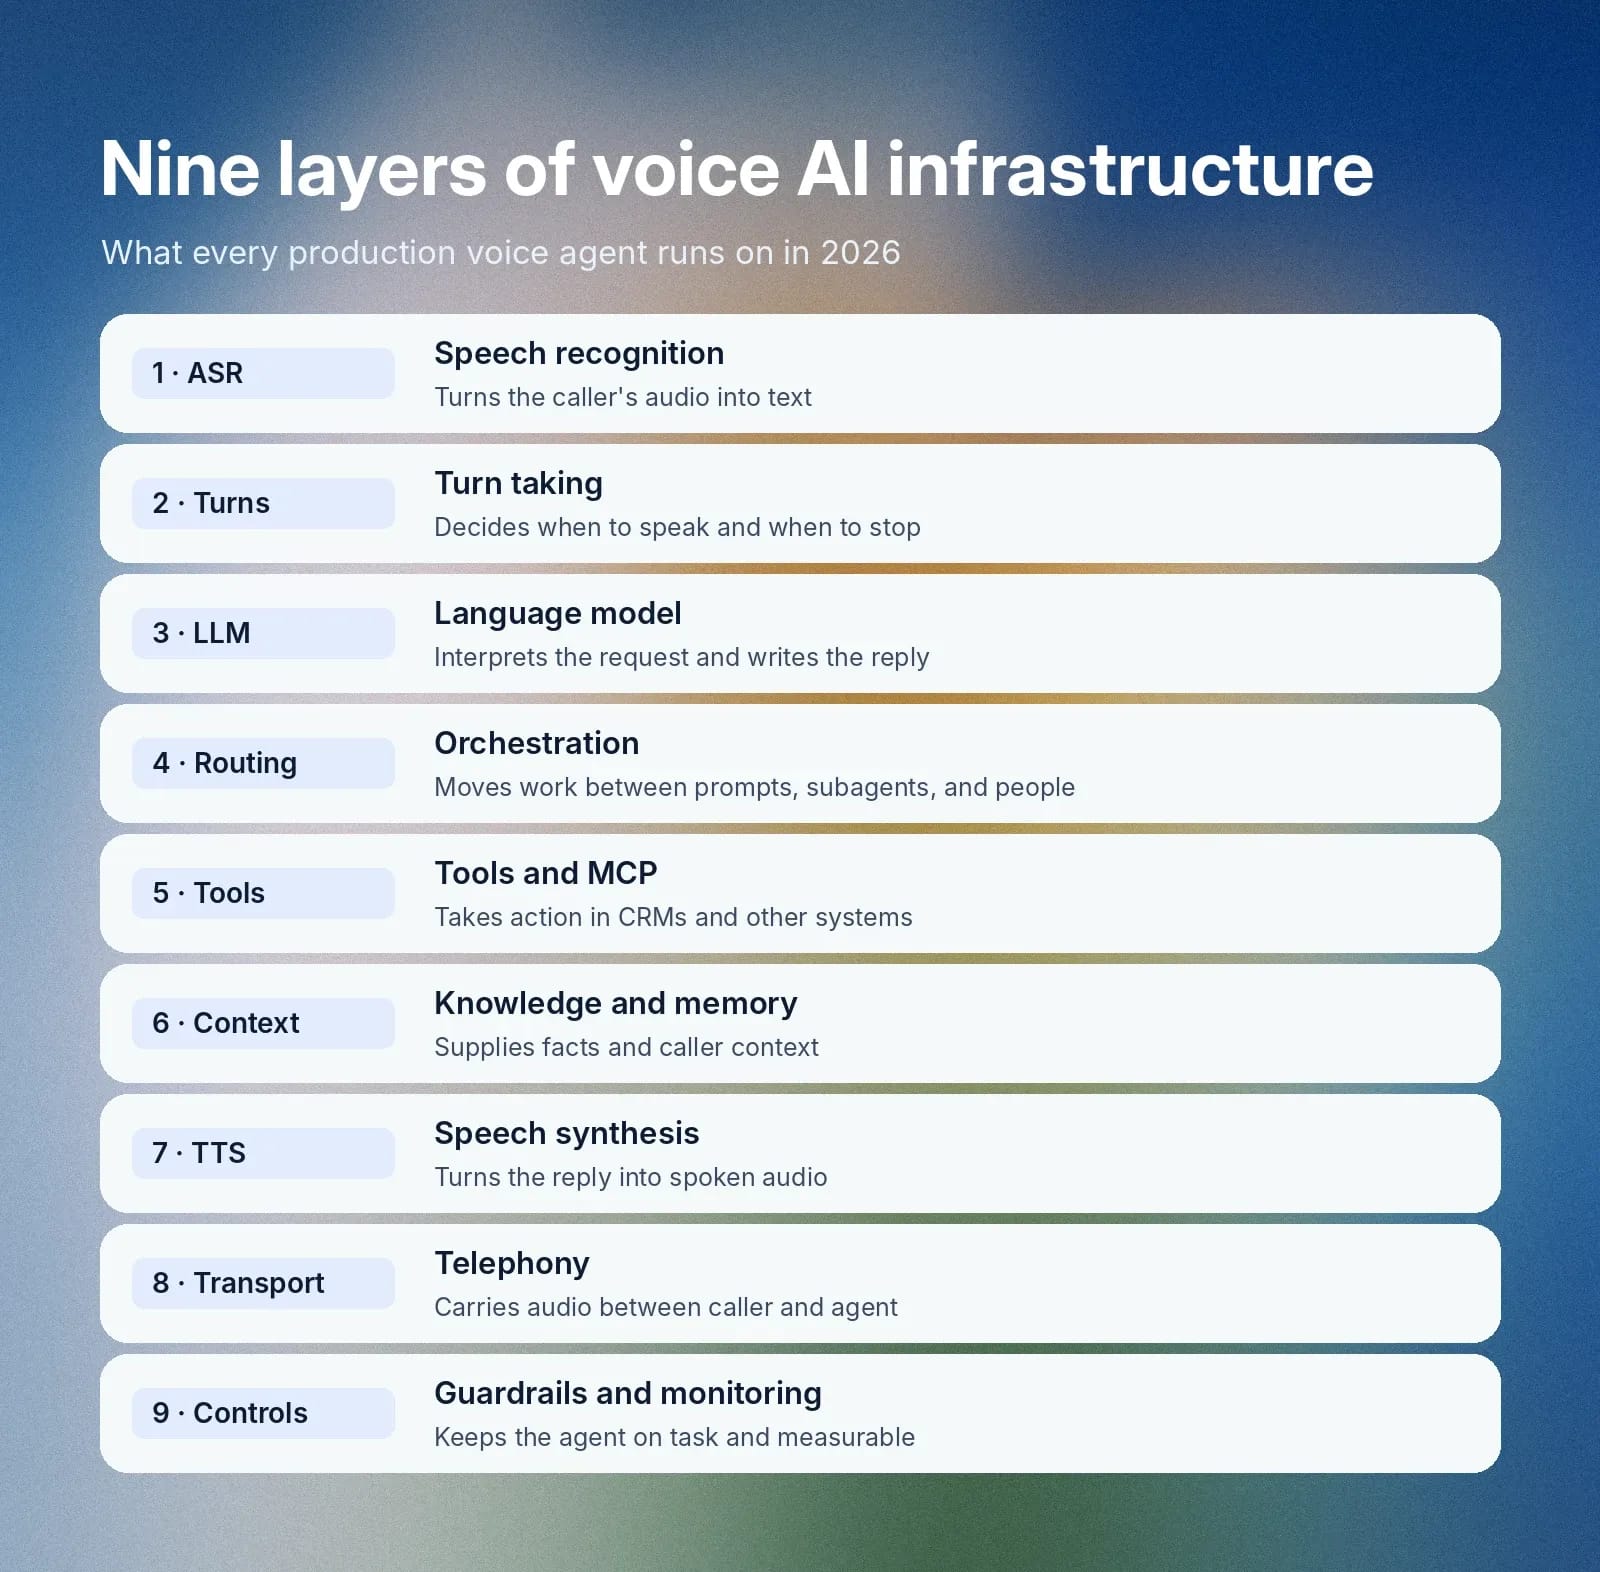
Diagramma dell’architettura IA vocale
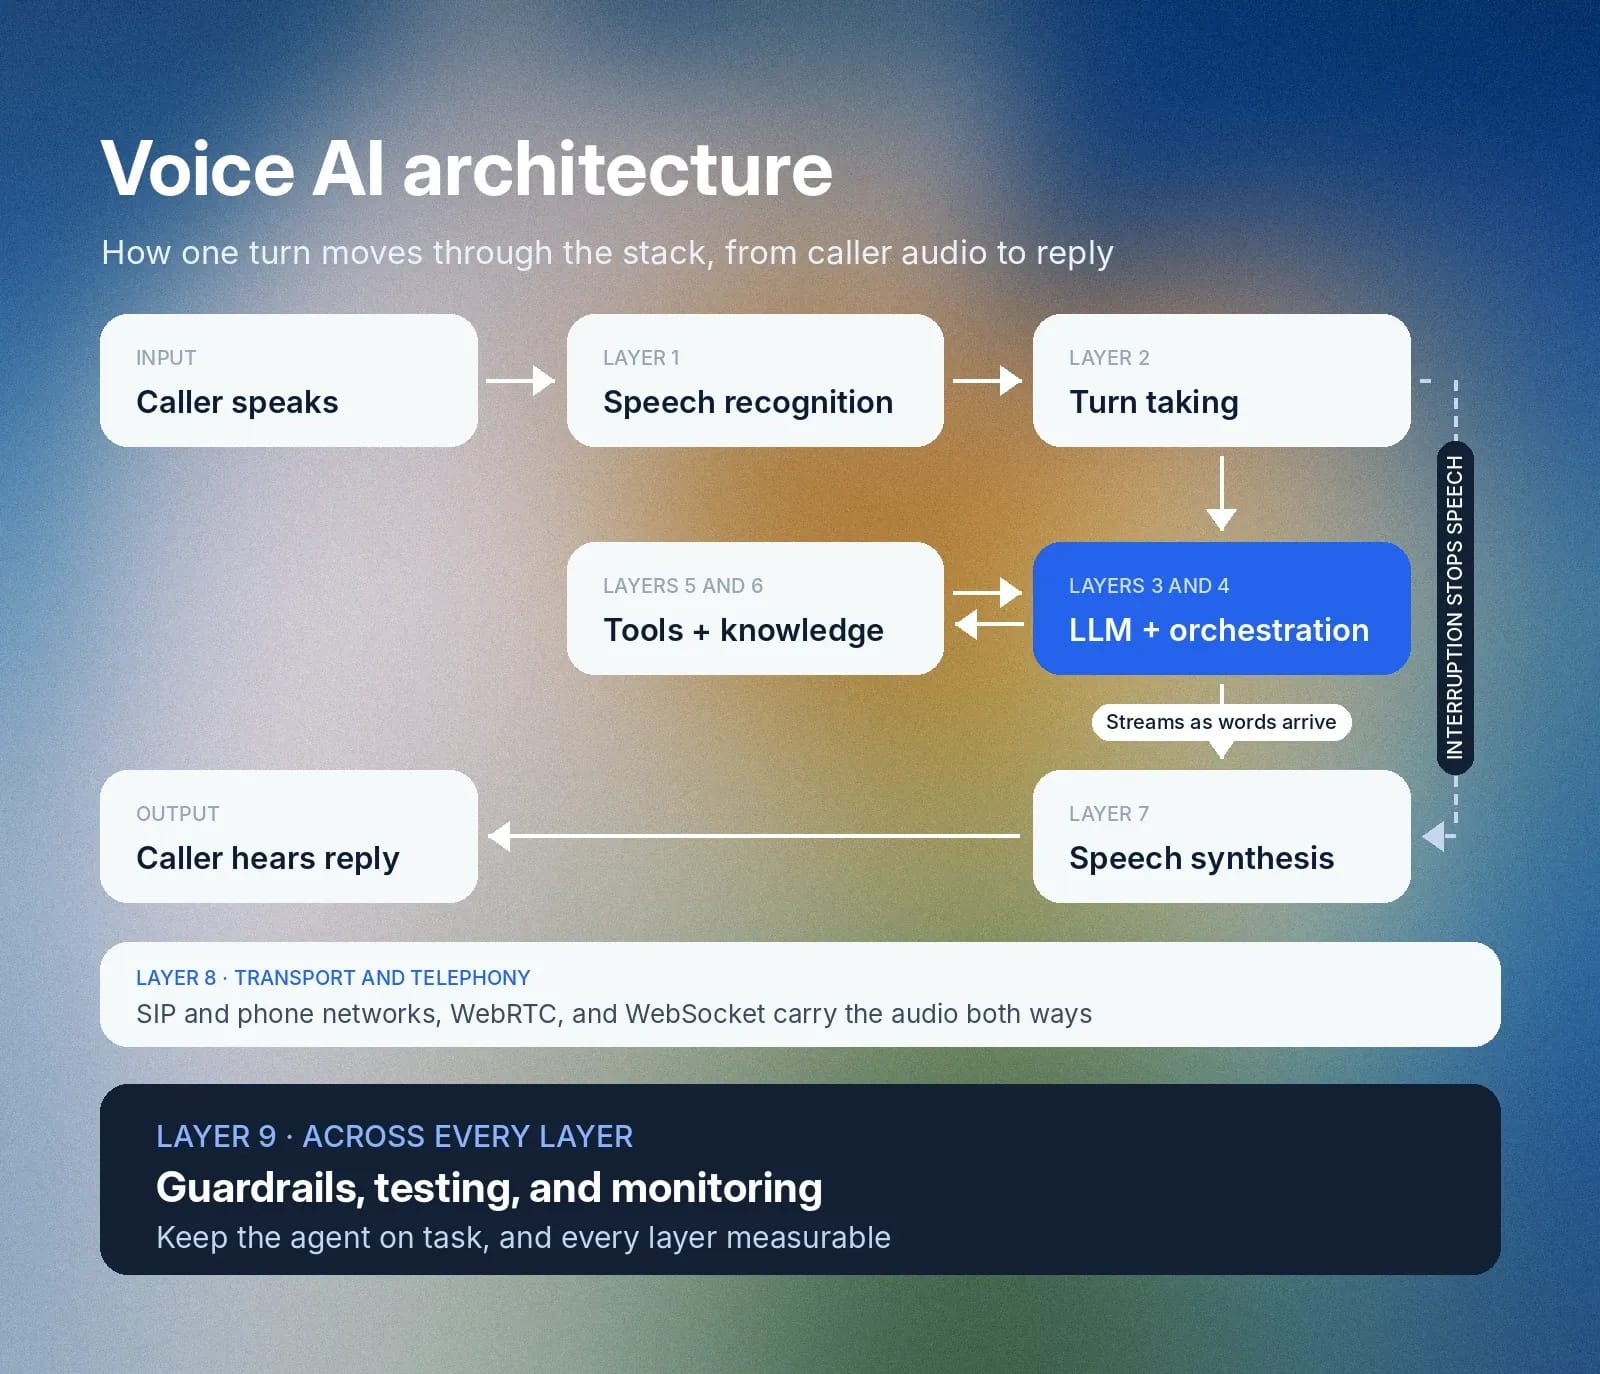
Il flusso non è una linea retta. ElevenAgents inizia a parlare dopo aver ricevuto dal modello linguistico “abbastanza parole e una virgola”, quindi l’audio inizia a essere riprodotto prima che la risposta completa esista. Le chiamate agli strumenti e il recupero delle informazioni vengono eseguiti durante un turno. Le interruzioni possono arrivare e vengono gestite naturalmente dall’agente mentre genera il parlato.
Due modi per creare un’architettura IA vocale
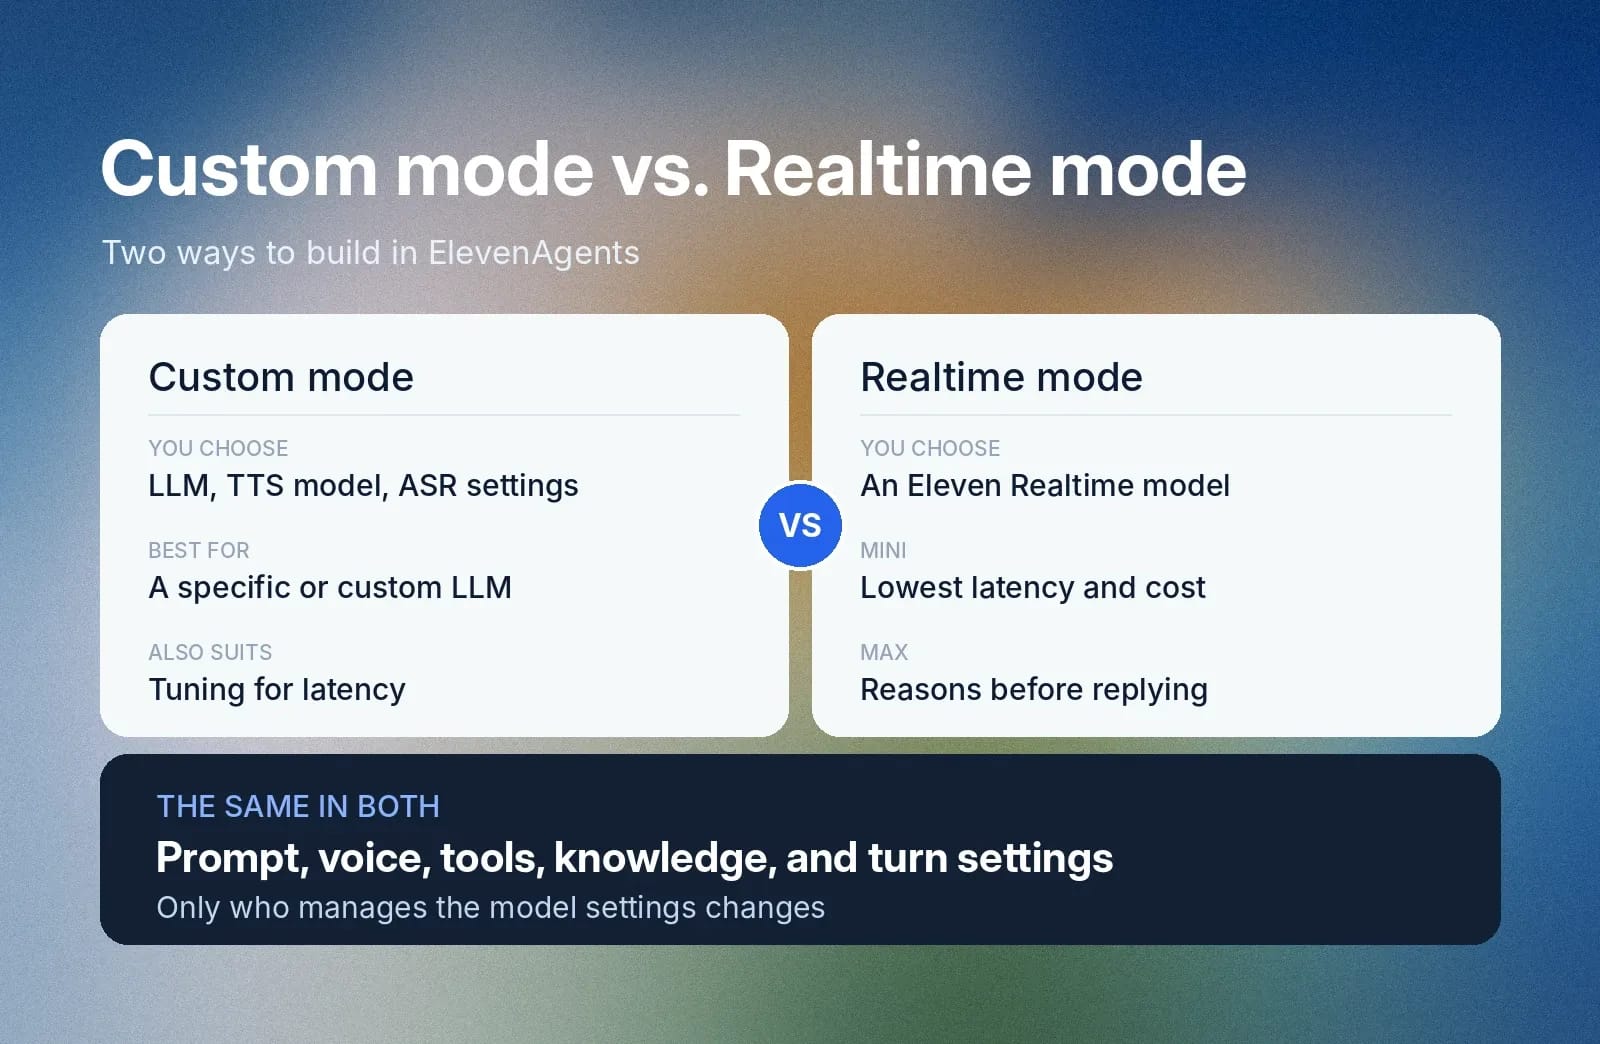
ElevenAgents supporta due modalità vocali. In modalità Custom, scegli tu il modello linguistico, il modello Text to Speech e le impostazioni del riconoscimento vocale.
In modalità Realtime, selezioni un modello Eleven Realtime e ElevenLabs gestisce queste impostazioni per te. Eleven Realtime v1 Mini è quello predefinito e offre la latenza e il costo più bassi. Eleven Realtime v1 Max ragiona prima di rispondere, quindi è adatto a istruzioni più complesse e ai casi in cui è necessario usare strumenti in più passaggi.
Il system prompt, la voce scelta, gli strumenti, la knowledge base collegata e le impostazioni dei turni funzionano allo stesso modo in entrambe le modalità. La modalità Custom è la scelta migliore quando hai bisogno di un modello linguistico specifico, di un LLM personalizzato o di un modello TTS specifico, per le prestazioni o l’ottimizzazione della latenza.
Riconoscimento vocale: trasformare l’audio in testo
Il riconoscimento vocale, chiamato anche ASR o speech to text, è il primo livello dello stack.
Cosa fa
Il modello trascrive continuamente l’audio di chi chiama mentre parla. Questo permette al resto della pipeline di iniziare a lavorare prima della fine della frase, riducendo la latenza. I modelli avanzati gestiscono accenti marcati, diverse velocità di eloquio e rumore di fondo.
Perché è importante per l’infrastruttura IA vocale
La trascrizione è probabilmente uno dei livelli più importanti dello stack, perché eventuali errori qui si propagano a tutte le fasi successive. Si interpreta male un riferimento di prenotazione? Viene gestita la scheda cliente sbagliata. Si sbaglia il nome di un farmaco? Potrebbe essere un disastro.
Nel suo Trust Framework for Healthcare, ElevenLabs mostra quanto possano essere alte le conseguenze di una sola sillaba fraintesa: hydroxyzine invece di hydralazine.
Come lo fa ElevenAgents
ElevenAgents usa Scribe v2 Realtime, che trascrive il parlato in circa 150 ms. ElevenLabs lo ha addestrato per ambienti rumorosi, accenti diversi e identificativi quali nomi, email e ID. Nel benchmark multilingue FLEURS su 30 lingue, ElevenLabs ha riportato il più basso tasso di errore delle parole tra tutti i modelli ASR a bassa latenza.
Lo abiliti nella sezione Avanzate della configurazione dell’agente. Nello stesso white paper citato sopra, ElevenLabs riporta che Scribe v2 Medical supera tutti i modelli nel benchmark pubblico Eka Medical ASR, con un tasso di errore delle parole del 7,0% al momento della pubblicazione.
Una trascrizione accurata e rapida fornisce ai livelli successivi l’input pulito di cui hanno bisogno, senza aggiungere una latenza significativa.
Gestione dei turni: sapere quando parlare e quando fermarsi
La gestione dei turni è l’insieme di regole che decide quando l’agente risponde e quando ascolta. La capacità di comprendere efficacemente i turni della conversazione e agire di conseguenza è ciò che distingue una conversazione da un vecchio menu telefonico IVR.
Cosa fa
Un componente per la gestione dei turni fornisce diverse funzioni all’infrastruttura IA vocale:
- Rilevamento dell’attività vocale (VAD): il VAD classifica l’audio in ingresso come parlato o silenzio decine di volte al secondo.
- Rilevamento della fine del turno: valuta se chi chiama ha finito, usando tono, ritmo e contesto delle parole.
- Barge-in: consente a chi chiama di interrompere, momento in cui l’agente smette di parlare per permettere all’utente di continuare.
- Backchannel: brevi segnali di assenso, come “sì”, che non prendono il turno.
Perché è importante
In una conversazione umana, circa 200 ms è l’intervallo tipico tra due interlocutori. Un agente che risponde troppo presto interrompe chi chiama, mentre uno che aspetta troppo crea silenzi che fanno sembrare la chiamata interrotta o poco reattiva.
Per esempio, considera chi chiama e dice: “Vorrei prenotare per venerdì pomeriggio, ma...” e fa una pausa. Un timer di silenzio risponde durante la pausa e perde la precisazione. Un modello che interpreta le parole e il ritmo aspetta, consentendo all’utente di concludere: “Non può essere tra le 15 e le 17, perché sarò occupato.”
Un agente interpreta male l’intenzione di chi chiama e fissa l’appuntamento all’orario sbagliato. L’altro, grazie a un’efficace gestione dei turni, evita la fascia oraria indicata.
Come lo fa ElevenAgents
ElevenAgents esegue un modello proprietario di gestione dei turni che analizza tono, ritmo e contesto delle parole, anziché basarsi solo sui timer di silenzio. Quando chi chiama interrompe, il segnale che ferma l’agente arriva in meno di 200 ms.
ElevenLabs misura una mediana di circa 150 ms dalla richiesta al parlato udibile con Eleven v4 Turbo su ElevenAgents.
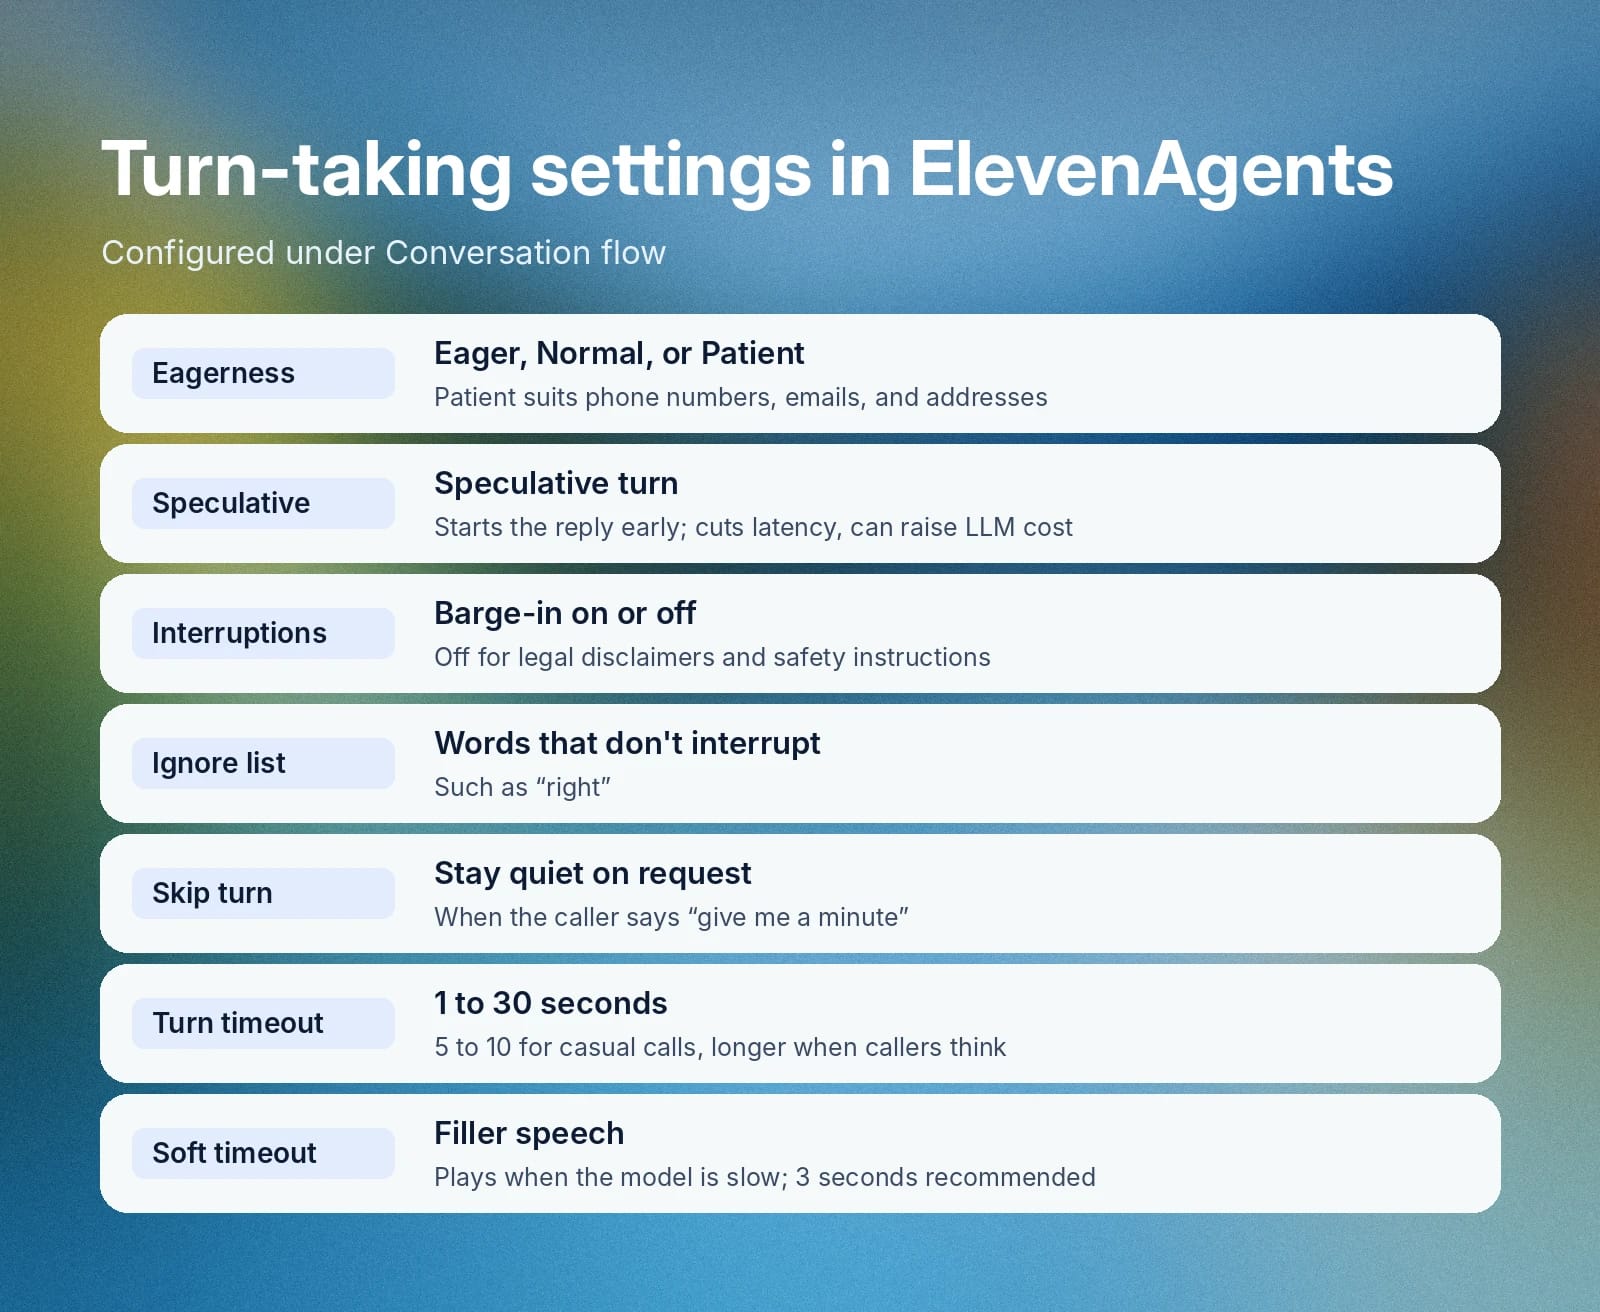
Il comportamento è configurabile tramite Conversation flow:
Impostazione
Cosa controlla
Prontezza del turno
Eager risponde alla prima opportunità. Normal è l’impostazione predefinita bilanciata. Patient aspetta più a lungo ed è adatta a numeri di telefono, indirizzi ed email.
Turno speculativo
Avvia la risposta del modello linguistico prima che sia confermato che chi chiama ha finito. Riduce la latenza, ma può aumentare il costo dell’LLM.
Interruzioni
Disattivale quando ogni parola deve essere ascoltata, ad esempio per disclaimer legali e istruzioni di sicurezza.
Elenco da ignorare
Parole come “giusto” che non devono interrompere l’agente.
Strumento per saltare il turno
Mantiene l’agente in silenzio quando chi chiama dice “dammi un minuto”.
Timeout del turno
Prende il turno dopo 1-30 secondi di silenzio. Usa 5-10 secondi per conversazioni informali e 10-30 quando chi chiama ha bisogno di tempo per pensare.
Timeout soft
Riproduce frasi riempitive come “Hhmmmm... sì.” quando il modello è lento. L’intervallo va da 0,5 a 8 secondi, con 3 secondi consigliati.
Rilevamento di ambienti rumorosi
Un’impostazione Enterprise che rileva le voci di sottofondo e chiede a chi chiama di spostarsi in un luogo più silenzioso, al massimo una volta per conversazione.
I workflow possono modificare la prontezza del turno durante la chiamata. Il tuo client riceve inoltre un evento vad_score, una probabilità da 0 a 1 che l’utente stia parlando.
Una gestione dei turni ben configurata determina se chi chiama percepisce l’agente come attento o brusco. Per approfondire, consulta la nostra guida completa sul turn taking.
Il modello linguistico: ragionamento e generazione della risposta
Il modello linguistico di grandi dimensioni (LLM) è il livello di ragionamento. Legge la trascrizione, le istruzioni e la conversazione finora, quindi scrive la risposta o decide di chiamare uno strumento.
Cosa fa
Un bot vocale basato su script riconosce una manciata di comandi. Un LLM interpreta richieste formulate in molti modi diversi, mantiene il contesto tra i turni e decide quando recuperare informazioni o trasferire la conversazione.
Perché è importante
I modelli differiscono per profondità di ragionamento, velocità e costo. In una conversazione vocale dal vivo, il tempo di risposta conta quanto la qualità della risposta, quindi la scelta del modello è una decisione sia di latenza sia di costo.
Come lo fa ElevenAgents
ElevenAgents ti offre un’unica interfaccia per i modelli di Google, OpenAI e Anthropic, oltre a modelli aperti forniti da ElevenLabs. Puoi anche collegare il tuo LLM specificando un endpoint e memorizzando le credenziali come secrets. ElevenLabs trasferisce i costi degli LLM di terze parti alla tariffa pubblicata dal provider, senza ricarichi.
Puoi scegliere il modello per ciascun subagente. The Enterprise Conversational Agent Playbook, Volume 2, consiglia di riservare i modelli con prestazioni superiori al ragionamento complesso e di usare modelli più economici e a bassa latenza per attività quali classificazione dell’intento e FAQ.
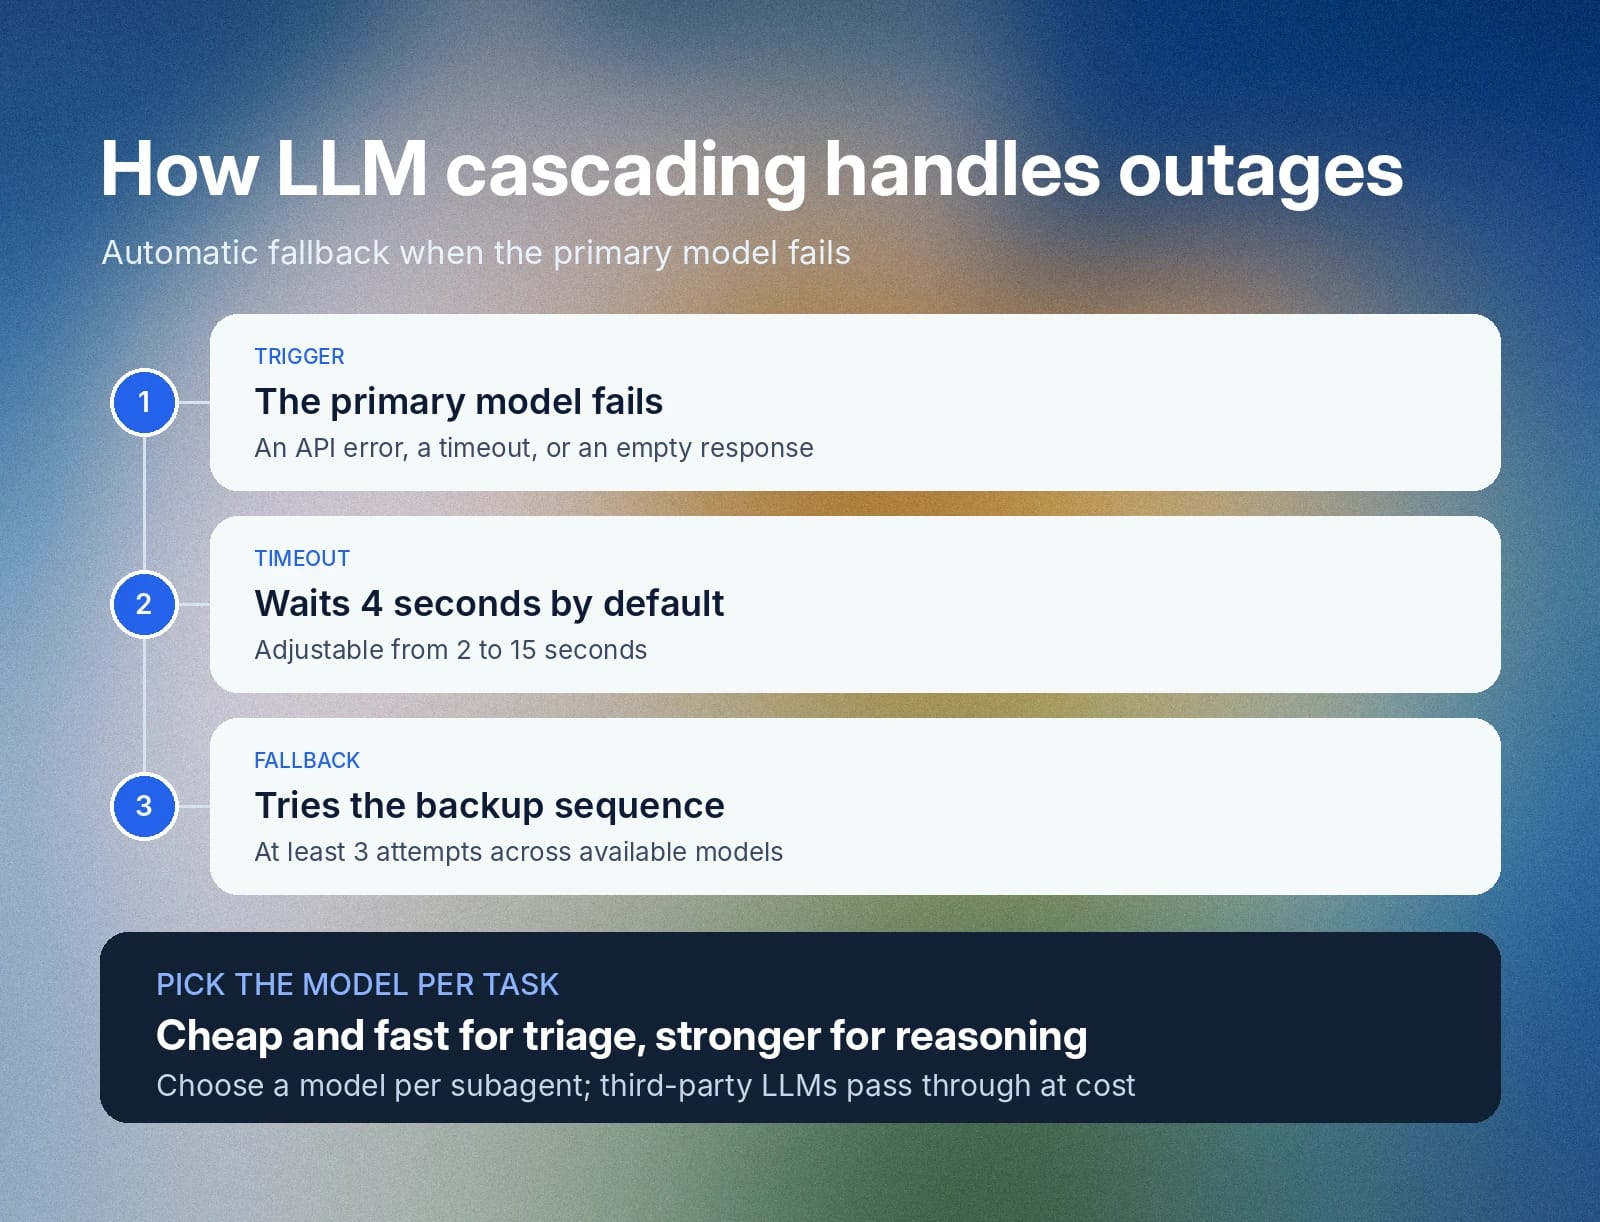
I provider possono avere interruzioni di servizio. Il cascading degli LLM le gestisce: se il modello primario restituisce un errore API, va in timeout o invia una risposta vuota, ElevenAgents prova una sequenza di backup. Il timeout predefinito dal primario al backup è di 4 secondi, regolabile da 2 a 15 secondi, e il sistema effettua almeno 3 tentativi tra i modelli disponibili.
Un LLM personalizzato usato come modello primario riprova automaticamente almeno 3 volte, a meno che tu non definisca il tuo ordine di backup. Il modello giusto per ogni attività mantiene l’agente veloce e conveniente.
Orchestrazione: instradare il lavoro tra agenti e persone
L’orchestrazione degli agenti coordina prompt, subagenti, strumenti e persone coinvolti nel completamento di un’attività. Decide cosa accade dopo in ogni punto della chiamata.
Cosa fa
Un singolo agente con un prompt molto lungo diventa difficile da gestire con l’accumularsi delle responsabilità. L’orchestrazione divide il lavoro in fasi, ciascuna con istruzioni, modello e strumenti propri, e sposta chi chiama tra di esse.
Perché è importante
I prompt più piccoli sono più facili da testare e meno costosi da eseguire, perché ogni interazione carica meno testo. Suddividere un flusso consente a un modello economico di gestire il triage e le FAQ, trasferendo a un modello più potente solo le richieste che ne hanno bisogno.
Come lo fa ElevenAgents
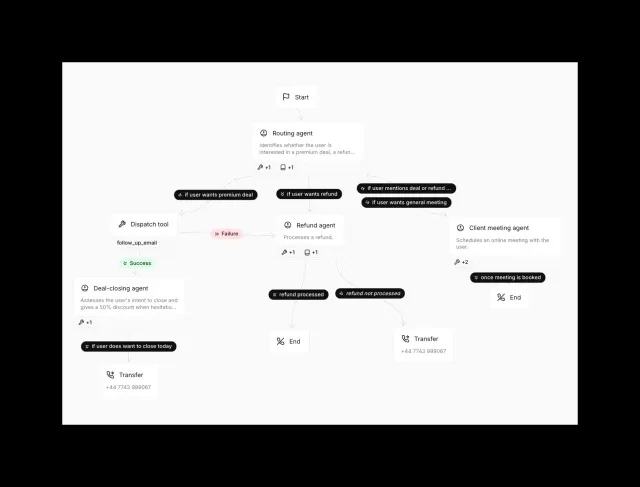
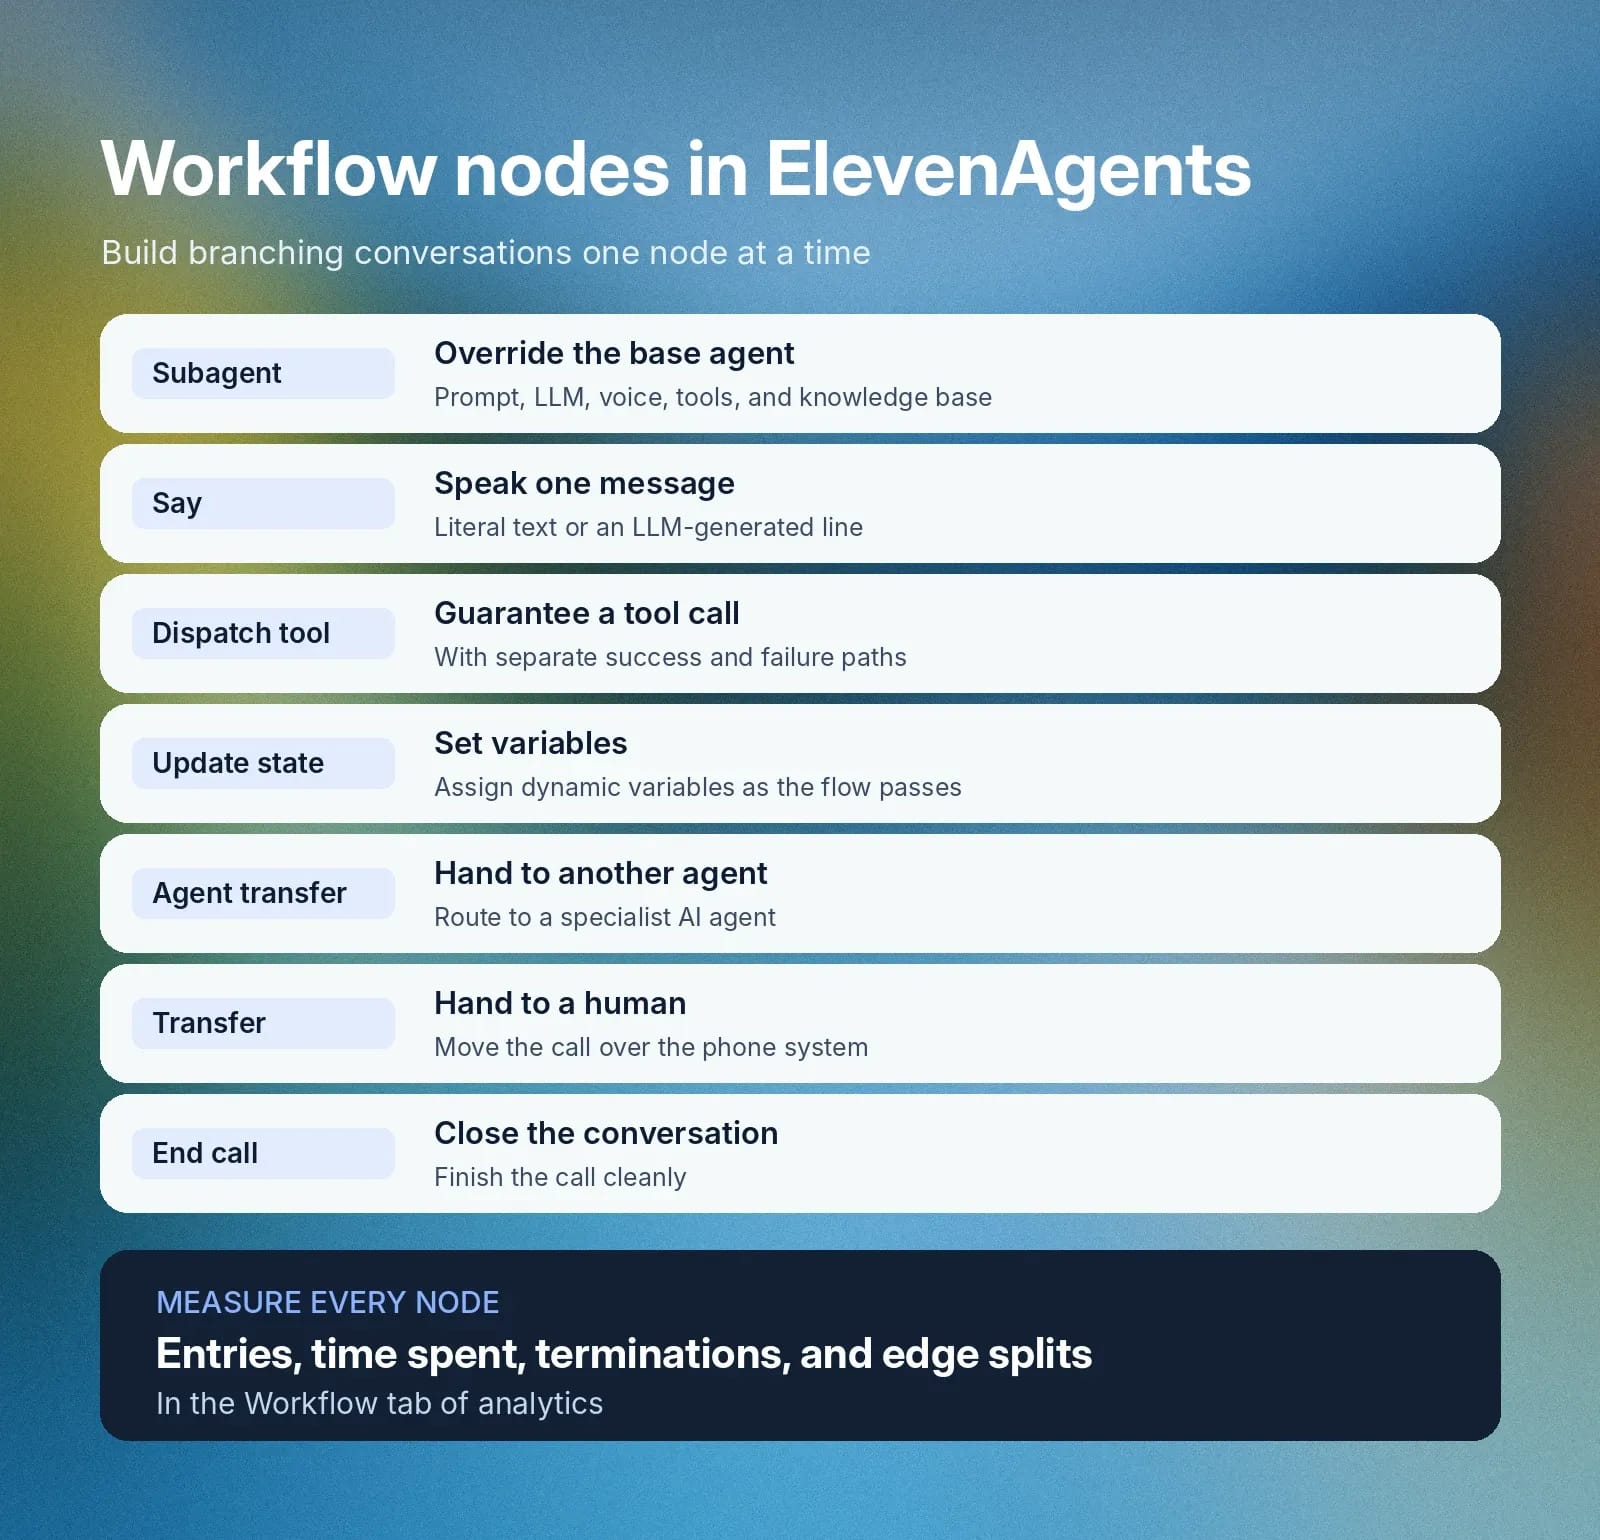
I workflow in ElevenAgents sono un builder visuale per grafi di conversazione ramificati.
I nodi sono:
- Subagent: modifica o sostituisce l’agente di base, inclusi prompt, LLM, voce, strumenti e knowledge base.
- Say: pronuncia un messaggio, testo letterale o riga generata da un LLM.
- Dispatch tool: passaggio dedicato che garantisce una chiamata a uno strumento, con percorsi distinti per successo e fallimento.
- Update state: assegna variabili dinamiche durante il passaggio nel flusso.
- Agent transfer: trasferisce la chiamata a un altro agente.
- Transfer to number: trasferisce la chiamata dall’agente IA a una persona tramite il sistema telefonico.
- End call: chiude la conversazione.
I collegamenti tra i nodi contengono condizioni in linguaggio naturale che l’LLM valuta in tempo reale. Un flusso di assistenza potrebbe iniziare con un subagente di instradamento su un modello veloce, inviare le domande di fatturazione a un subagente dedicato su un modello più potente e terminare con un nodo di trasferimento a un numero quando chi chiama chiede una persona. Dopo il lancio, la scheda Workflow nelle analisi mostra ingressi, tempo medio trascorso, terminazioni e distribuzione dei collegamenti per ogni nodo.
L’orchestrazione trasforma un singolo agente in un sistema che puoi progettare, misurare e migliorare un nodo alla volta.
Strumenti e MCP: consentire all’agente di agire
Il function calling, chiamato anche tool calling, permette a un agente di richiedere azioni a software esterni collegati al tuo stack tecnologico.
Trasforma un’interfaccia di domande e risposte in un sistema IA agentico capace di completare attività e interagire con altri strumenti per tuo conto.
Cosa fa
Prendi chi chiama e chiede di spostare l’appuntamento di domani a venerdì. L’agente recupera la prenotazione, verifica la disponibilità di venerdì, aggiorna il sistema di pianificazione e conferma la modifica. Ogni passaggio è una chiamata a uno strumento che compie un’azione.
Perché è importante
Gli strumenti sono il punto in cui le conversazioni producono risultati. Ogni strumento necessita di input e output chiari e l’agente deve sapere se una chiamata è riuscita prima di comunicarlo a chi chiama.
Come lo fa ElevenAgents
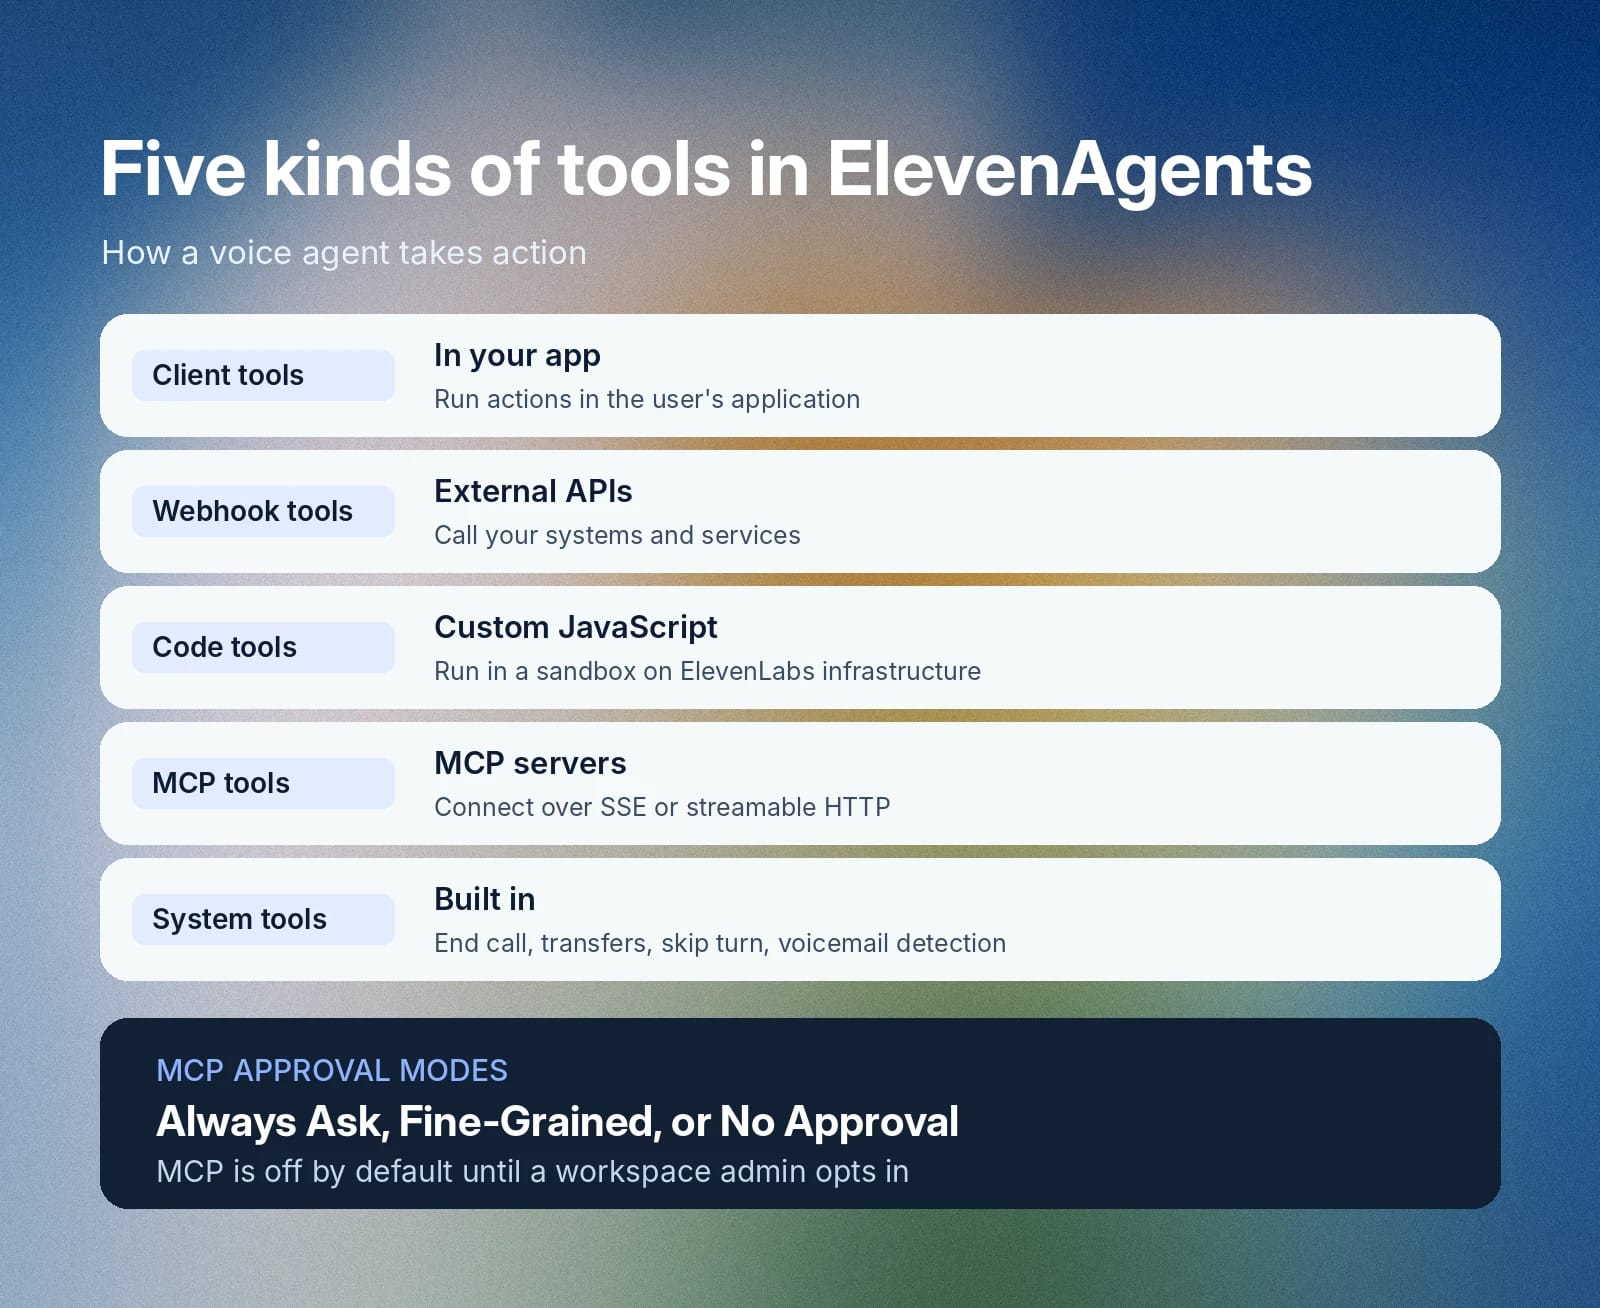
ElevenAgents supporta client tools eseguiti nell’applicazione dell’utente, webhook tools che chiamano API esterne, code tools che eseguono JavaScript personalizzato in una sandbox nell’infrastruttura ElevenLabs, MCP tools e strumenti di sistema integrati.
Gli strumenti di sistema includono fine chiamata, rilevamento della lingua, trasferimento dell’agente, trasferimento a un numero, salto del turno, riproduzione del tono dei tasti e rilevamento della segreteria telefonica. Puoi aggiungere audio ambientale mentre uno strumento è in esecuzione e controllare se chi chiama può interrompere durante l’esecuzione.
Il Model Context Protocol (MCP) è uno standard aperto che definisce come le applicazioni forniscono contesto e strumenti ai modelli linguistici. ElevenAgents si collega ai server MCP tramite SSE e HTTP streamable. Gli amministratori del workspace devono prima dare il consenso, poiché MCP è disabilitato per impostazione predefinita in ogni workspace. Scegli quindi una modalità di approvazione per ogni server: Chiedi sempre, Approvazione granulare degli strumenti oppure Nessuna approvazione.
Gli eventi client come client_tool_call e mcp_tool_call segnalano l’attività degli strumenti, mentre i report degli eventi MCP indicano quattro stati: caricamento, in attesa di approvazione, successo e fallimento. Strumenti affidabili offrono all’agente la capacità di agire nel mondo reale, e regole di approvazione chiare mantengono tale capacità sotto controllo.
Conoscenza e memoria: fatti e contesto di chi chiama
La generazione aumentata dal recupero (RAG) fornisce all’agente fatti provenienti dai tuoi contenuti, come un database interno di informazioni o un registro più ampio della cronologia clienti. Memoria e personalizzazione gli danno contesto su chi chiama, consentendo al tuo agente di migliorare la personalizzazione e l’utilità per la tua azienda.
Cosa fa
Un modello linguistico ha una data limite di addestramento e non può accedere alla tua documentazione o ai tuoi record. RAG cerca una knowledge base per ogni query, recupera i passaggi più pertinenti e li fornisce al modello per dargli il contesto aggiuntivo necessario a una risposta utile.
I dati di personalizzazione dicono all’agente chi sta chiamando e cosa è rilevante per quella persona.
Perché è importante
Basare le risposte su contenuti approvati le mantiene accurate. Anche la velocità di recupero è importante, perché ogni millisecondo aggiunto è un altro millisecondo di attesa per i tuoi clienti. Le funzioni di personalizzazione evitano inoltre che chi chiama debba ripetere informazioni in chiamate diverse, perché gli agenti avranno a disposizione i record CRM all’inizio di ogni nuova sessione.
Come lo fa ElevenAgents
Aggiungi documenti alla knowledge base come file (PDF, DOCX, TXT, MD, HTML o EPUB, fino a 20 MB ciascuno), URL o testo incollato. Un documento usa il contesto completo quando il testo estratto rientra nel prompt, fino a circa 300.000 caratteri. I documenti più grandi usano RAG. Il recupero può essere eseguito a ogni turno o su richiesta e la modalità d’uso predefinita è Auto, che usa RAG quando è abilitato e il documento è indicizzato.
ElevenLabs lavora direttamente sulla velocità di recupero. Il suo articolo tecnico, How we reduced RAG latency, documenta una riduzione della latenza RAG mediana da 326 ms a 155 ms usando modelli forniti sull’infrastruttura già gestita da ElevenLabs.
Per il contesto di chi chiama, ElevenAgents usa variabili dinamiche scritte come {{ var_name }}, che popolano messaggi, system prompt e strumenti. Per le chiamate in entrata tramite Twilio, trunk SIP, WhatsApp e SMS, ElevenAgents può recuperare i dati di avvio dal tuo server prima dell’inizio della conversazione. Il tuo server cerca chi chiama tramite caller_id e restituisce le variabili, ad esempio dal CRM, con una risposta fino a 256 KB. Dopo la chiamata, i webhook post-chiamata inviano risultati delle valutazioni e dati estratti ai tuoi sistemi esterni.
Insieme, recupero e personalizzazione forniscono all’agente sia i fatti giusti sia il contesto giusto su chi chiama.
Sintesi vocale: dare una voce all’agente
Text to speech (TTS) trasforma la risposta del modello linguistico in audio parlato. È il livello che chi chiama ascolta effettivamente.
Cosa fa
Il modello converte il testo in audio con ritmo naturale ed espressività emotiva. In una chiamata dal vivo, trasmette l’audio in blocchi, così la riproduzione inizia prima che venga generata la risposta completa.
Perché è importante
Latenza e resa vocale influenzano entrambe la valutazione della chiamata da parte di chi chiama. Per il lavoro in tempo reale contano due numeri: il tempo per generare l’audio e il tempo prima che chi chiama senta il primo suono. Anche nomi, nomi di farmaci e termini tecnici devono essere pronunciati correttamente, altrimenti si perde fiducia nell’agente.
Come Eleven v4 alimenta il livello vocale
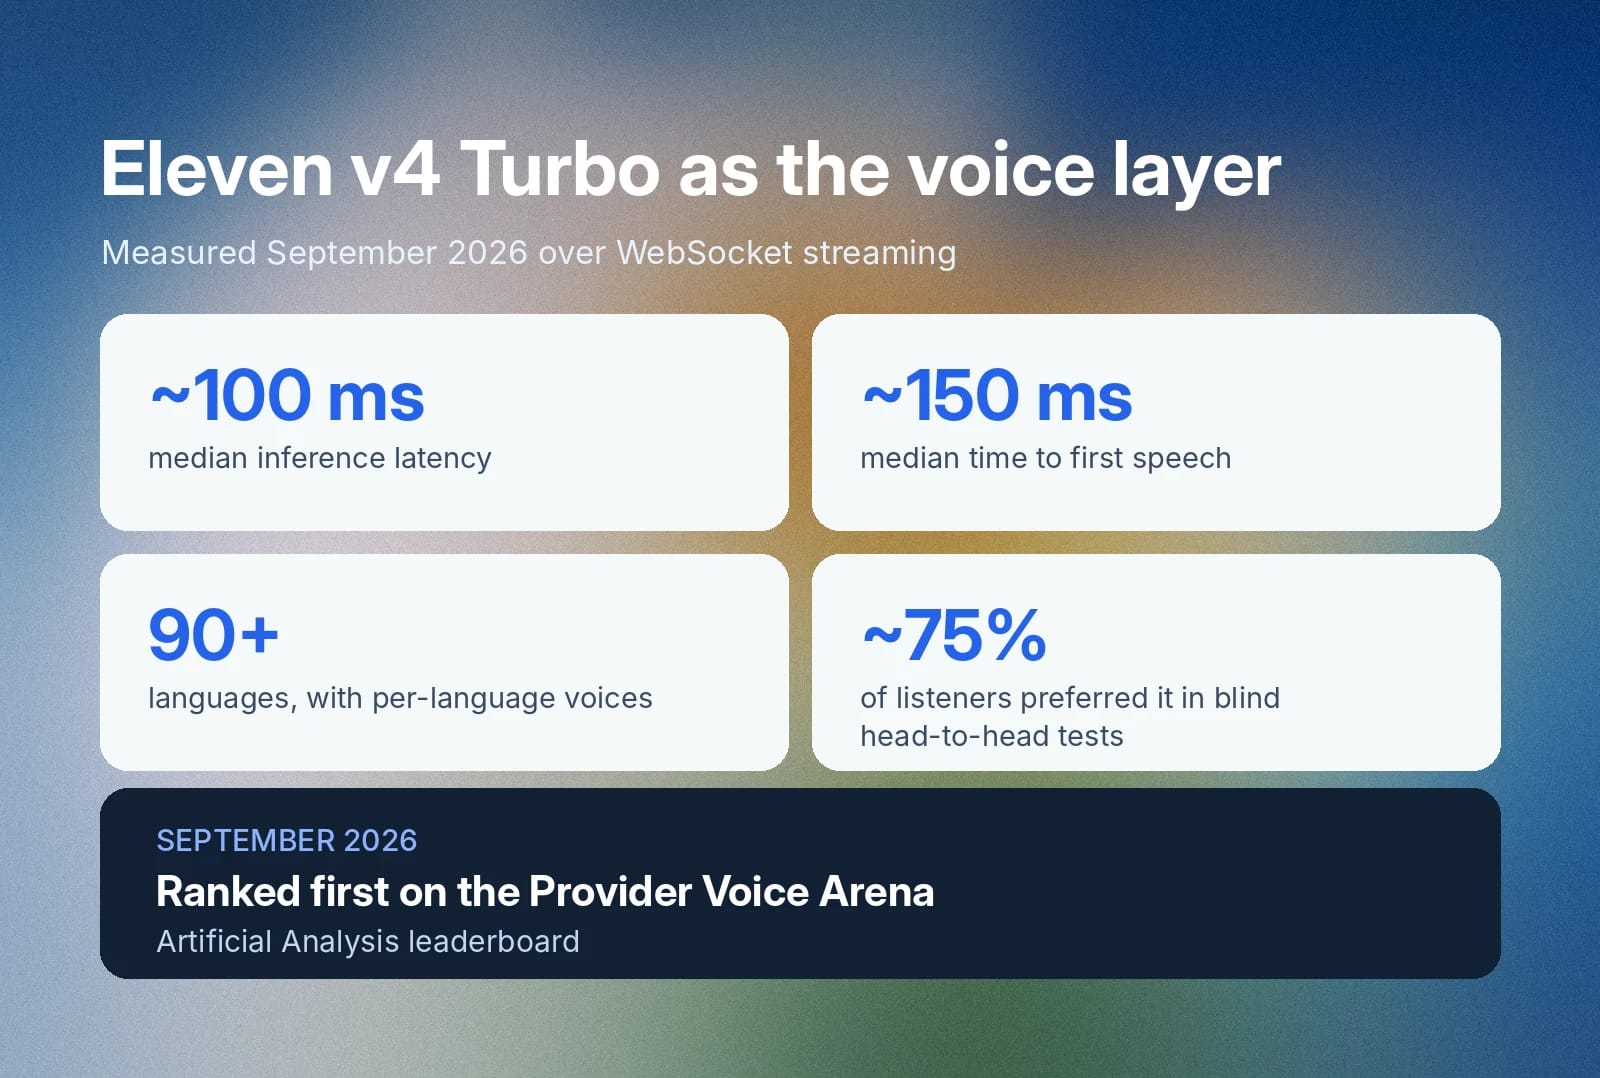
Eleven v4 è il modello Text to Speech più espressivo di ElevenLabs finora, costruito su un’architettura completamente nuova. Eleven v4 Turbo è la variante a bassa latenza per l’uso in tempo reale, ad esempio con gli agenti, ottimizzata insieme a ElevenAgents come un unico sistema.
Eleven v4 Turbo
Valore
Latenza di inferenza mediana
Circa 100 ms
Tempo mediano fino al primo parlato
Circa 150 ms
Lingue
90+
ElevenLabs ha misurato i dati di latenza a settembre 2026 tramite streaming WebSocket, rimuovendo la latenza di rete. Eleven v4 si è classificato al primo posto nella Artificial Analysis Provider Voice Arena Leaderboard a settembre 2026* e circa il 75% degli ascoltatori lo ha preferito nei test alla cieca**.
* Artificial Analysis, Provider Voice Arena Leaderboard, set 2026
** Basato su test delle preferenze degli utenti in confronti diretti con Cartesia Sonic 3.6, Inworld TTS-2, Google Gemini 3.8 Flash-Lite TTS e Google Gemini 3.8 Flash TTS.
Eleven v4 supporta audio tag inline come [laughs] per la resa e il supporto per i fonemi IPA per la pronuncia. Negli agenti per il settore sanitario, questo controllo della pronuncia include i termini medici. ElevenAgents aggiunge inoltre controlli a livello di agente. Il supporto multivoce consente a un agente di passare da una voce all’altra nelle conversazioni con più personaggi. La velocità va da 0,7x a 1,2x. Ogni lingua aggiuntiva può usare la propria voce. I dizionari di pronuncia accettano la notazione IPA o CMU per parole specifiche.
Un primo suono rapido e una voce accurata ed espressiva fanno sembrare l’agente un interlocutore.
Telefonia e trasporto: collegare l’agente a chi chiama
Il livello di trasporto trasferisce l’audio tra chi chiama e l’agente. Le integrazioni da includere qui nella tua infrastruttura IA vocale variano in base al canale telefonico utilizzato.
Cosa fa
Le chiamate telefoniche viaggiano su una rete telefonica e tramite SIP, mentre le conversazioni da browser e app viaggiano tramite WebRTC o WebSocket. Un widget per sito web racchiude la connessione del browser in un’interfaccia pronta all’uso.
Perché è importante
Ogni canale ha esigenze di configurazione e vincoli audio diversi, quindi decidi presto quali canali usare. Un’implementazione incentrata sul telefono richiede trunking e gestione dei numeri. Un’implementazione di prodotto richiede un SDK.
Come lo fa ElevenAgents
- Trunking SIP: collega direttamente il tuo sistema telefonico a ElevenLabs, per chiamate in entrata e in uscita. Funziona con Twilio, Vonage, Sinch, Infobip, Telnyx e altri provider standard. La segnalazione avviene tramite TCP sulla porta 5060 o TLS 1.2 o superiore sulla porta 5061, mentre l’audio usa G.711 o G.722. Pianifica almeno 100 Kbps per chiamata. I limiti delle chiamate simultanee dipendono dal tuo piano di abbonamento e chi chiama attende quando è abilitata la coda delle chiamate.
- Integrazione Twilio nativa: importa un numero Twilio acquistato per chiamate in entrata e in uscita. Gli ID chiamante verificati funzionano solo per le chiamate in uscita.
- Chiamate in batch: carica un elenco di destinatari CSV o XLS e ogni colonna aggiuntiva diventa una variabile dinamica. Puoi avviarle subito o programmarne l’inizio. I batch usano il minore tra il 50% del limite di concorrenza del workspace e il 70% del limite di concorrenza dell’agente, lasciando capacità per le chiamate in arrivo.
- WebRTC e WebSocket: gli SDK usano WebRTC per la voce e WebSocket per le conversazioni solo testuali per impostazione predefinita. Gli agenti privati si autenticano con un URL firmato o un token di conversazione creato sul tuo server. L’endpoint WebSocket è wss://api.elevenlabs.io/v1/convai/conversation.
- SDK: Python, JavaScript, React, React Native, Swift, Kotlin e Unity.
- Widget: aggiungi l’elemento <elevenlabs-convai> a una pagina. Supporta modalità solo voce, voce più testo e chat, e l’agente può mostrare risposte rapide e caroselli.
Un solo agente può servire telefono, web, WhatsApp, SMS ed email, consentendo ai team di creare una volta e distribuire su più canali.
Guardrail: mantenere l’agente focalizzato
I guardrail sono controlli che mantengono il comportamento di un agente entro limiti definiti. Operano insieme al grounding, poiché un guardrail limita ciò che un agente dice senza rendere corretti i fatti alla base. I guardrail vengono eseguiti in parallelo alle conversazioni dell’agente, contribuendo a mantenerle conformi e accurate.
Cosa fa
ElevenAgents applica guardrail a tre livelli. Il system prompt definisce il comportamento consentito e non consentito, idealmente sotto un’intestazione # Guardrails. La convalida dell’input utente filtra i messaggi per rilevare prompt injection. La convalida della risposta controlla ogni risposta prima della consegna.
Perché è importante
Un agente che divaga o inventa una policy erode rapidamente la fiducia. Un agente di assistenza clienti deve recuperare la policy di rimborso da una fonte approvata prima di rispondere, e un guardrail impone questo limite.
Come lo fa ElevenAgents
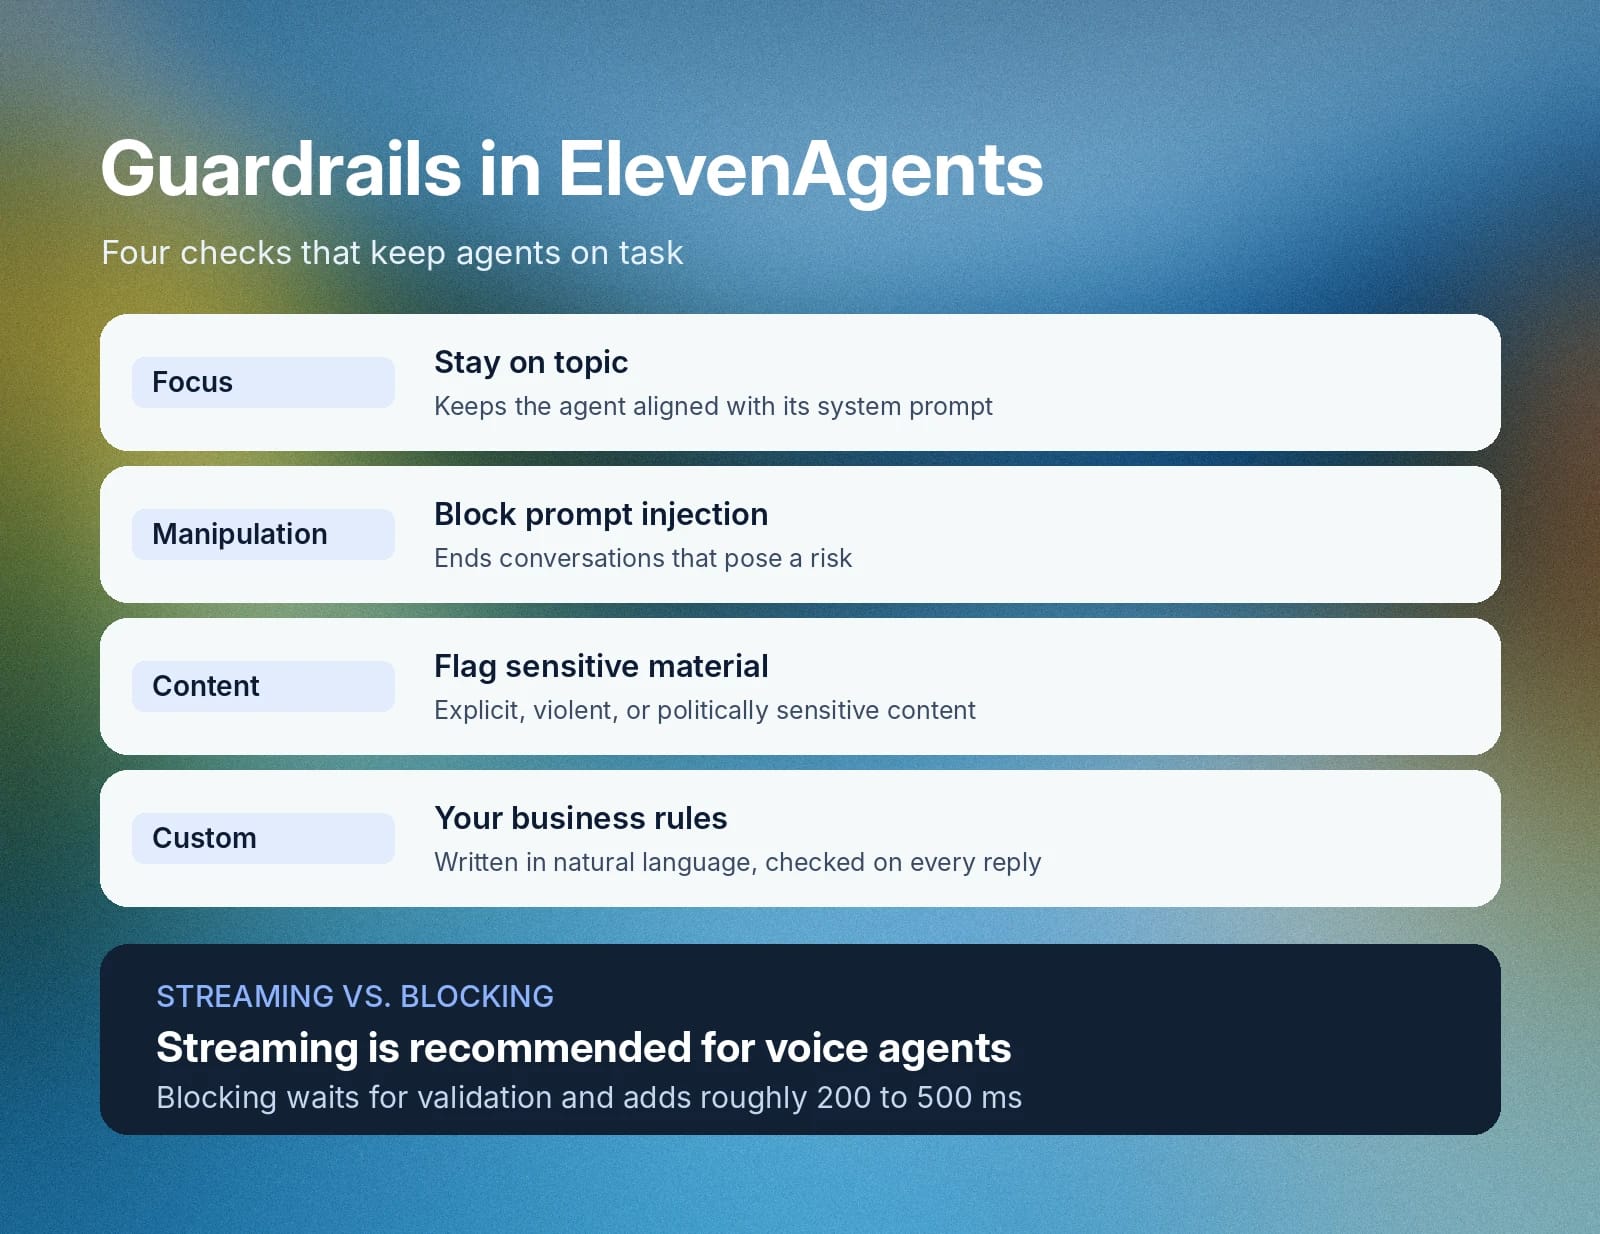
ElevenAgents ha introdotto Guardrails 2.0 a settembre 2026. Con questo nuovo sistema, ecco alcune configurazioni che aiutano i guardrail a funzionare in modo efficace:
- Focus: mantiene l’agente sul tema e allineato al suo system prompt.
- Manipulation: rileva le prompt injection e termina le conversazioni che rappresentano un rischio.
- Content: segnala categorie quali materiale sessualmente esplicito, violento o politicamente sensibile.
- Custom: regole aziendali che scrivi in linguaggio naturale e vengono valutate su ogni risposta.
La modalità di esecuzione determina il compromesso sulla latenza. La modalità streaming consente alla risposta di iniziare prima del completamento del controllo, quindi meno di 500 ms di audio possono essere riprodotti prima che un blocco termini la chiamata; ElevenLabs la consiglia per gli agenti vocali. La modalità blocking attende la convalida e aggiunge circa 200-500 ms.
Quando si attiva un guardrail personalizzato, l’azione può terminare la chiamata o ritentare la risposta fino a tre volte con il feedback che scrivi. Il tuo client può ascoltare l’evento guardrail_triggered.
Guardrail su più livelli con un profilo di latenza scelto mantengono il comportamento prevedibile senza rallentare ogni risposta.
Test ed esperimenti: dimostrare che l’agente funziona
I test verificano un agente prima del lancio. Gli esperimenti verificano le modifiche rispetto al traffico reale dopo il lancio.
Cosa fa
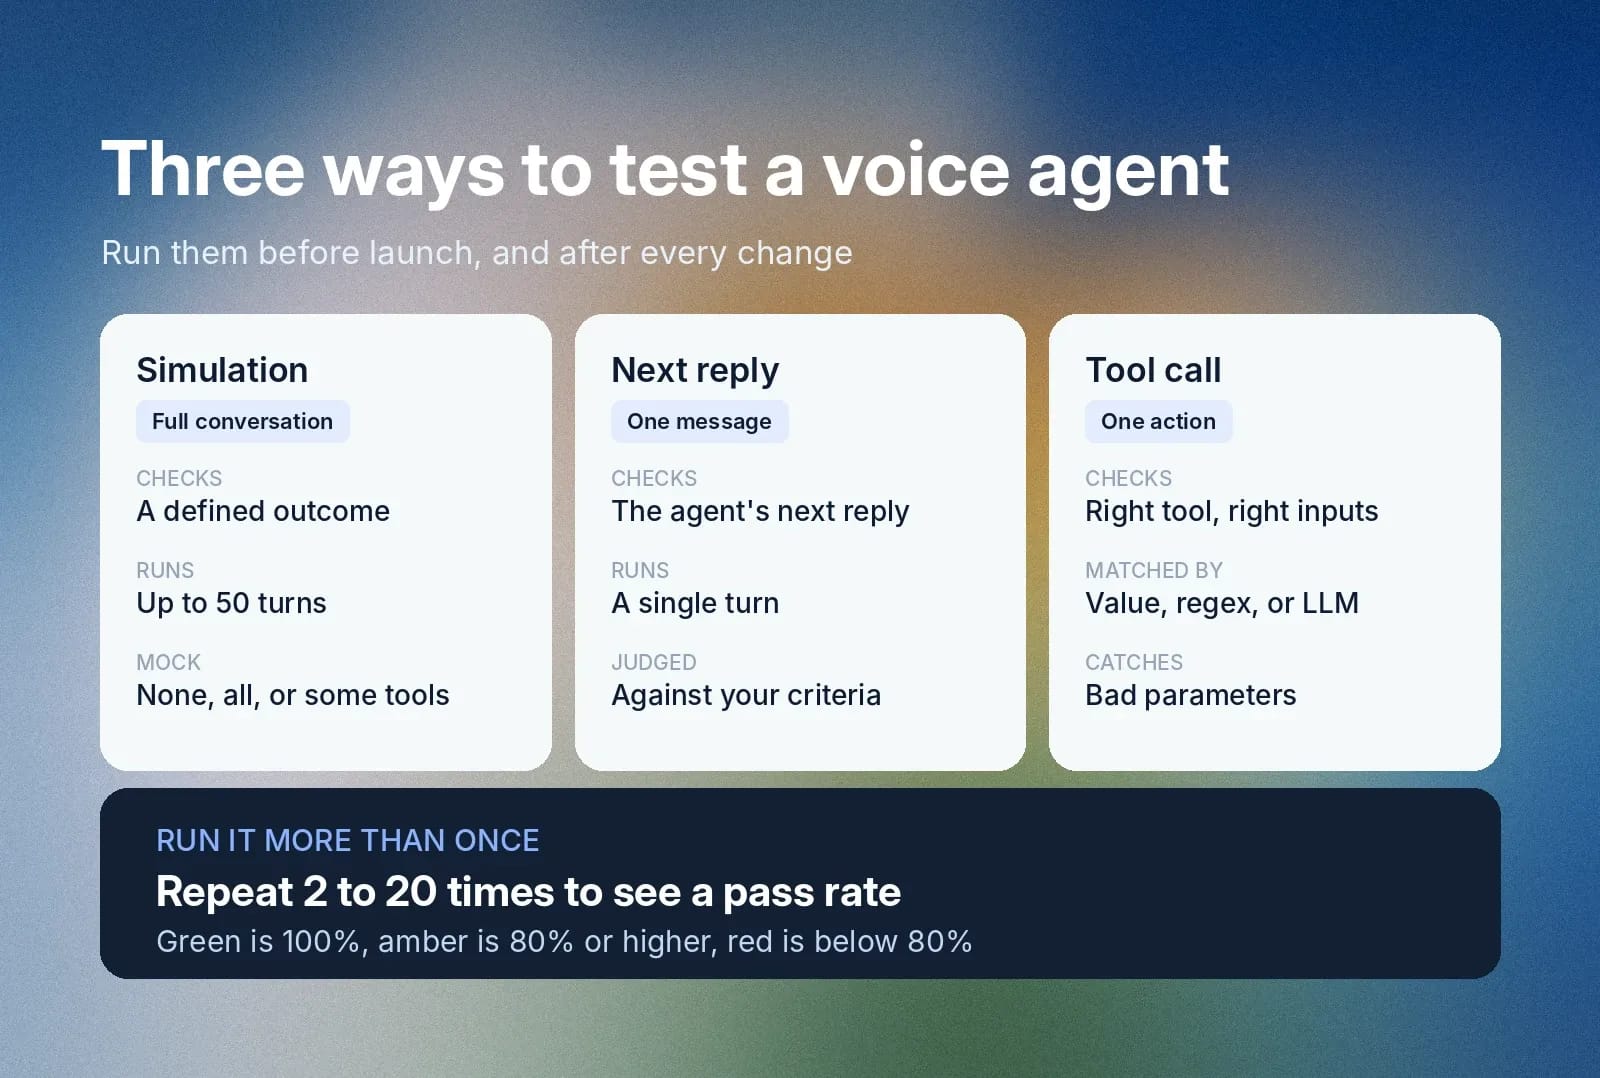
ElevenAgents offre tre tipi di test degli agenti. Simulation esegue una conversazione completa con un utente simulato e verifica se raggiunge un risultato definito, con un massimo di 50 turni, 5 per impostazione predefinita. I test Next Reply valutano solo il messaggio successivo dell’agente rispetto ai tuoi criteri. I test Tool Call verificano che l’agente usi lo strumento corretto con i parametri giusti, tramite corrispondenza esatta, regex o valutazione LLM. Nelle simulazioni puoi simulare nessuno strumento, tutti gli strumenti o strumenti selezionati.
Perché è importante
Una singola esecuzione superata mostra che un agente può riuscire. Eseguire ripetutamente i test mostra quanto spesso riuscirà. L’API accetta repeat_count da 2 a 20 e i risultati mostrano una percentuale di superamento. Verde significa 100%, ambra 80% o più, rosso meno dell’80%. I fallimenti sono raggruppati per motivo. Prompt, modelli, workflow e integrazioni modificano tutti il comportamento, quindi i test continuano dopo il lancio.
Come funzionano gli esperimenti
Gli esperimenti sono test A/B basati sul versioning degli agenti. Crei un ramo della configurazione, modifichi una variabile come system prompt, workflow, voce, strumenti, knowledge base o impostazioni LLM e indirizzi una quota del traffico reale alla variante. ElevenLabs consiglia di iniziare dal 5-10%.
L’instradamento è deterministico in base all’ID della conversazione, quindi un determinato utente rimane sullo stesso ramo e le percentuali devono totalizzare il 100%. CARS24, cliente di ElevenLabs, ha aumentato progressivamente il traffico passando dal 5% al 10%, 20%, 50% e 100%, mantenendo ogni livello per due giorni, come descritto nel report.
Insieme, i test pre-lancio e gli esperimenti dal vivo trasformano le modifiche in miglioramenti misurabili.
Osservabilità: misurare ciò che accade in produzione
L’osservabilità è la capacità di vedere cosa ha fatto l’agente, come ha operato e, se necessario, dove ha fallito. Un agente che funziona in un test può comportarsi diversamente con chi chiama davvero, perciò servono osservabilità completa e registri verificabili.
Cosa fa
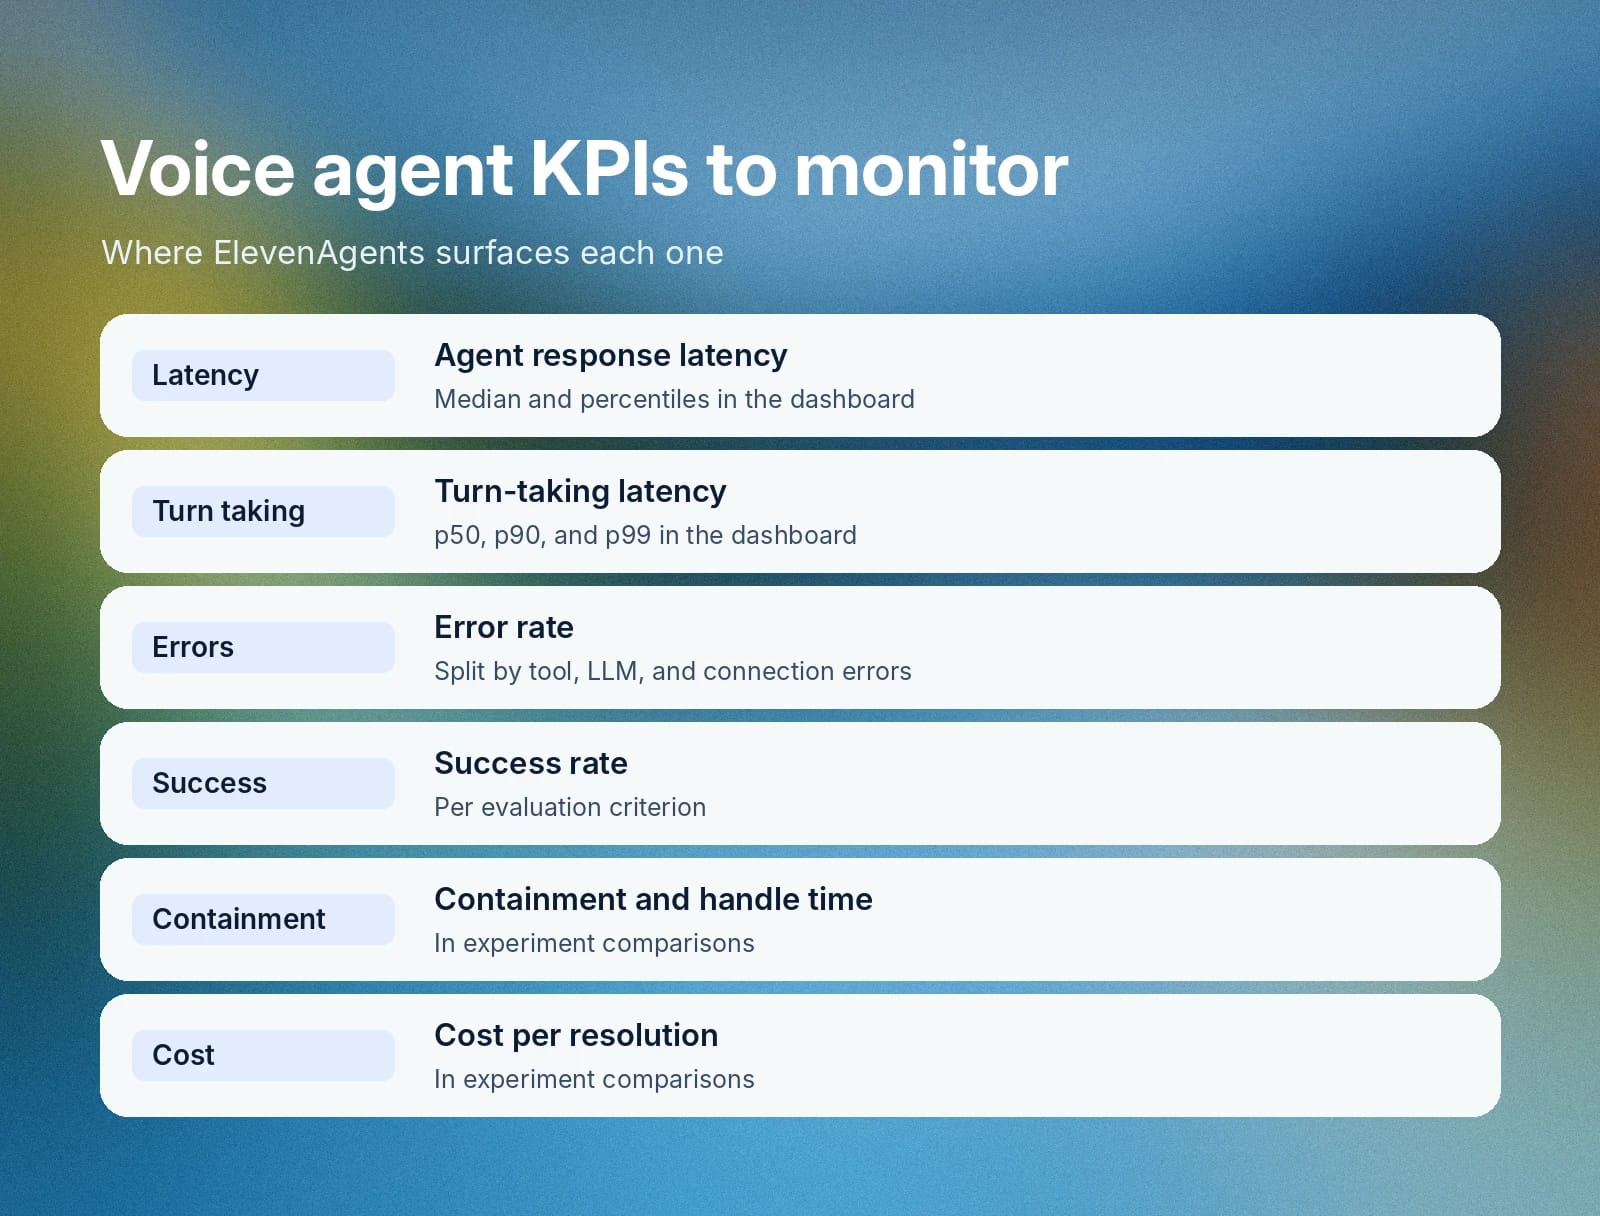
L’analisi delle conversazioni assegna un punteggio a ogni chiamata. La valutazione del successo applica criteri definiti da te per il raggiungimento dell’obiettivo e la qualità, mentre la raccolta dati estrae campi strutturati come dettagli di contatto e tipo di problema. La dashboard di analisi aggiunge volume delle chiamate, durata, costo, tassi di errore e latenza. Le chiamate attive si aggiornano in tempo reale e gli avvisi scattano quando i tassi di errore aumentano.
Perché è importante
Senza monitoraggio, una chiamata scadente è un aneddoto. Con il monitoraggio, puoi vedere quale nodo, strumento o modello ha causato il problema.
KPI
Cosa indica
Dove lo mostra ElevenAgents
Latenza di risposta dell’agente
Quanto attendono chi chiama una risposta
Dashboard di analisi, mediana e percentili
Latenza della gestione dei turni
Quanto velocemente l’agente prende il turno
Dashboard di analisi, p50, p90 e p99
Tasso di errore
Quota di conversazioni con errori
Dashboard, suddivisa per errori di strumenti, LLM e connessione
Tasso di successo
Raggiungimento dell’obiettivo per criterio
Criteri di valutazione, con tassi di successo, fallimento e sconosciuto
Tasso di contenimento e tempo di gestione
Chiamate risolte senza una persona e durata della chiamata
Confronti tra esperimenti
Costo per risoluzione
Quanto costa ogni conversazione risolta
Confronti tra esperimenti
Scegli le metriche più utili per l’attività specifica che hai in mente. Un agente di assistenza si concentra sulla risoluzione e l’escalation, mentre un agente outbound si concentrerebbe soprattutto su connessione e completamento.
Scalabilità, affidabilità e trasferimento a una persona
L’infrastruttura IA vocale deve poter operare sia con 5 clienti sia con 500.000. Anche lavorando su grandi volumi, questi componenti devono resistere ed essere in grado di passare a una persona quando necessario.
Cosa fa
La scalabilità significa supportare molte conversazioni simultanee tra riconoscimento vocale, inferenza LLM, sintesi vocale, integrazioni e telefonia. L’affidabilità significa che ciascuna di queste dipendenze ha un percorso di errore definito. Il trasferimento significa avere un percorso chiaro verso una persona.
Pur non essendo strettamente componenti dell’infrastruttura IA vocale, sono tutti elementi essenziali per un buon sistema nella pratica.
Perché è importante
Un sistema che gestisce dieci chiamate di test può comportarsi diversamente con diecimila. Uno strumento di prenotazione che va in timeout non deve portare l’agente a confermare una prenotazione mai avvenuta. Chi chiama e chiede una persona deve raggiungerla con il contesto intatto, in genere tramite warm transfer.
Come lo fa ElevenAgents
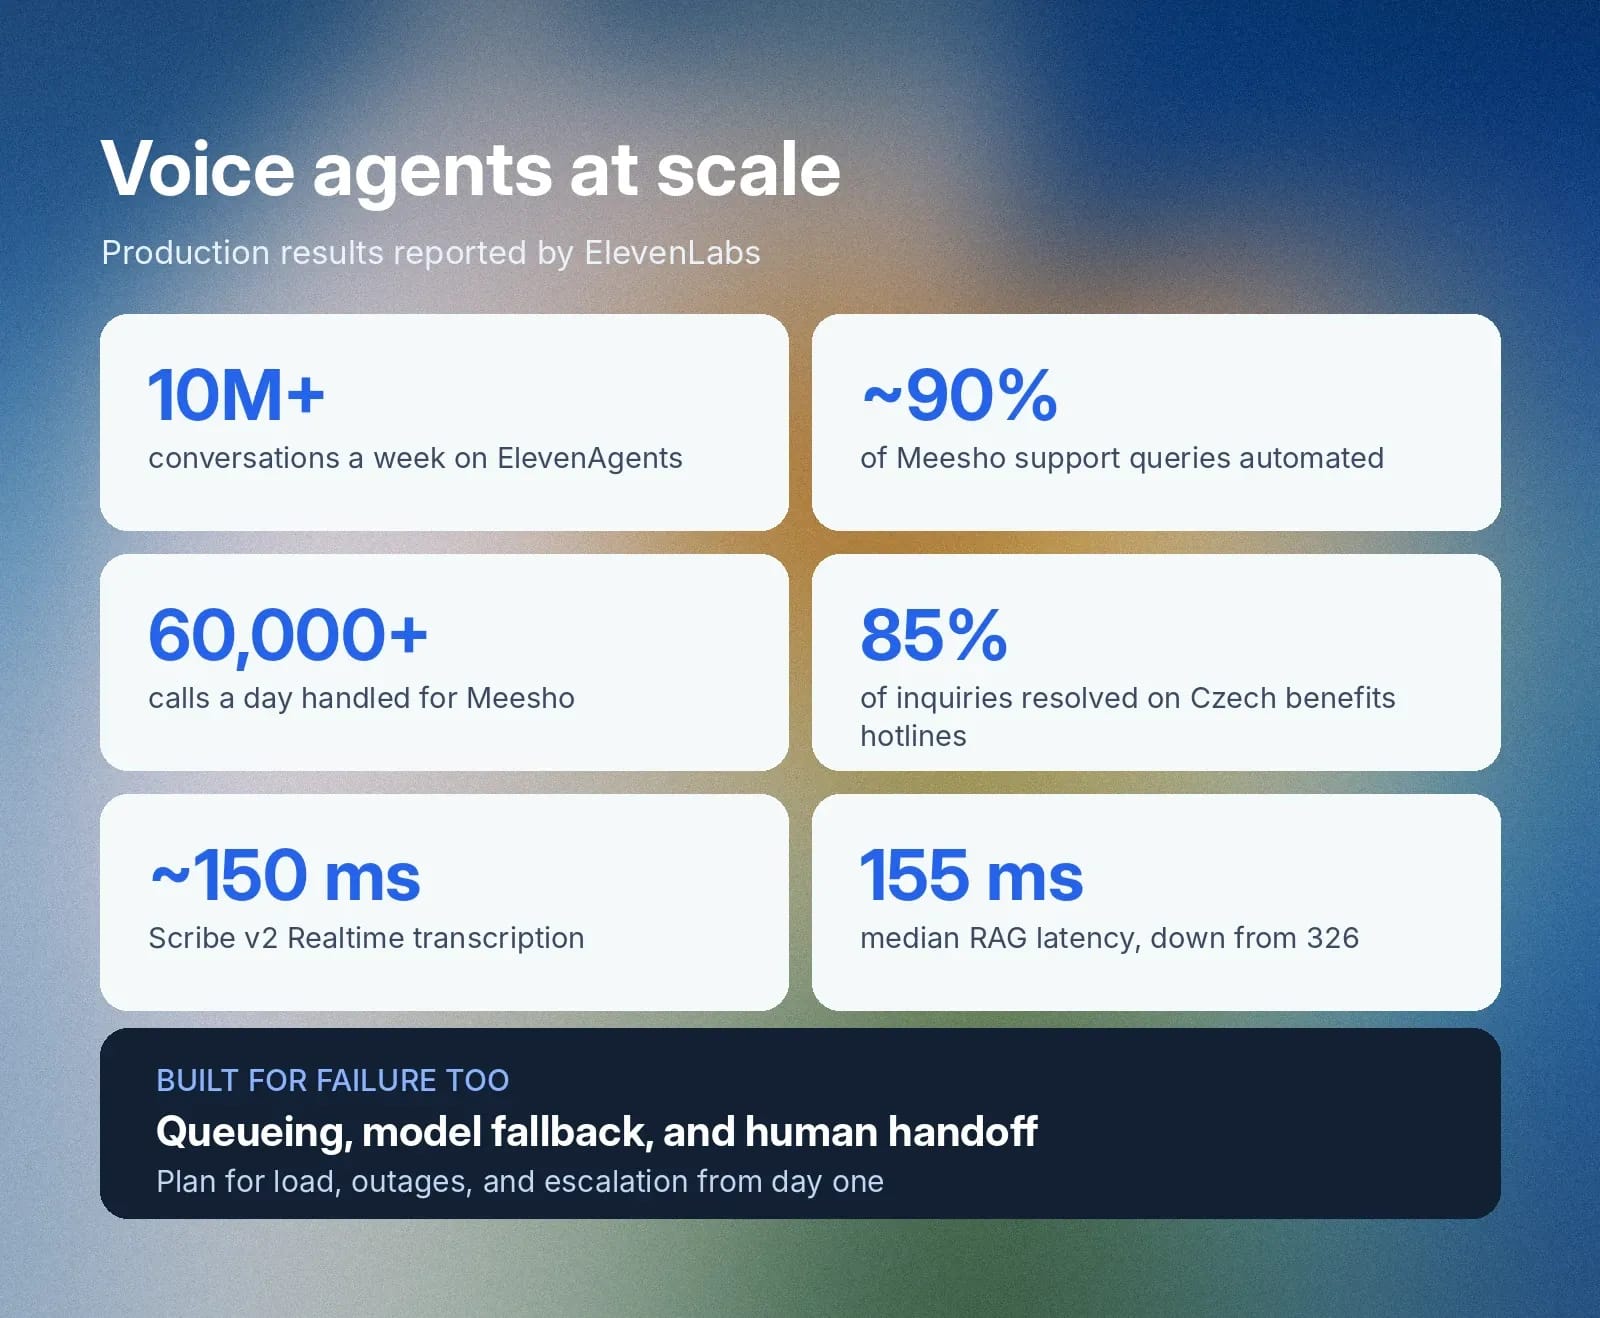
I limiti di concorrenza dipendono dal piano di abbonamento e la coda delle chiamate trattiene chi chiama quando viene raggiunto un limite. Il cascading degli LLM copre le interruzioni dei modelli. I nodi di trasferimento a un numero, lo strumento di sistema transfer to number e agent transfer gestiscono il trasferimento, mentre i criteri di valutazione possono decidere quando eseguire l’escalation. I periodi di silenzio vengono fatturati al 5% della normale tariffa al minuto.
ElevenLabs riporta risultati di produzione su larga scala. ElevenAgents gestisce oltre 10 milioni di conversazioni alla settimana. Meesho automatizza circa il 90% delle richieste di assistenza su oltre 60.000 chiamate al giorno, secondo il report Building Enterprise-grade Voice Agents. Nella Repubblica Ceca, gli agenti basati su ElevenLabs gestiscono circa 5.000 chiamate al giorno sulle linee telefoniche nazionali per i sussidi e risolvono autonomamente l’85% delle richieste, secondo il report State of Conversational Agents in Government.
Pianificare fin dall’inizio carico, errori e trasferimenti è ciò che distingue una demo da un’implementazione.
Cosa cercare in un’infrastruttura IA vocale pronta per la produzione nel 2026
Usa questa checklist per valutare qualsiasi piattaforma IA vocale rispetto ai tuoi requisiti.
- Riconoscimento vocale: trascrizioni accurate per le tue lingue, i tuoi accenti e la qualità audio, inclusi nomi e identificativi.
- Gestione dei turni: comportamento di fine turno configurabile, barge-in e tempo di risposta alle interruzioni misurato.
- Scelta del modello: un LLM selezionabile per agente o subagente, un’opzione LLM personalizzata e fallback automatico.
- Orchestrazione: workflow in più passaggi e instradamento tra agenti specializzati.
- Strumenti: webhook, client tools, supporto MCP e controlli di approvazione.
- Conoscenza: i tuoi documenti, con latenza di recupero misurabile.
- Personalizzazione: dati di chi chiama disponibili prima che venga pronunciata la prima parola.
- Voce: tempo ridotto fino al primo parlato e controllo della pronuncia e dell’espressione.
- Canali: telefono, web, mobile e messaggistica, con SDK e API.
- Guardrail: limiti di comportamento configurabili con un costo di latenza noto.
- Test: conversazioni simulate, controlli delle chiamate agli strumenti ed esecuzioni ripetute.
- Esperimenti e analisi: test A/B, latenza percentilare e analisi degli errori.
- Scalabilità e trasferimento: concorrenza, accodamento ed escalation alle persone documentati.
I principali sistemi di agenti vocali IA come ElevenAgents ti offrono tutti questi componenti in un’unica piattaforma.
Inizia oggi contattando il team oppure crea i tuoi sistemi di agenti IA registrando un account.
Domande frequenti sull’infrastruttura IA vocale

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.