
Word Error Rate (WER): concetti chiave, formula e utilizzi
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
In teoria, il word error rate (WER) è una metrica per determinare l'accuratezza di uno strumento di Riconoscimento vocale automatico (ASR). Un WER basso indica che la trascrizione finale è più accurata, mentre un tasso di errore più alto segnala informazioni trascritte in modo errato.
In pratica, il WER può fare la differenza tra un software di trascrizione medica che indica che un paziente necessita di «quindici milligrammi» anziché «cinquanta milligrammi» di un farmaco. È la differenza tra uno strumento di assistenza che trascrive accuratamente le esigenze di un cliente e uno che lascia l'utente frustrato.
In questo articolo vedremo cos'è il WER, come calcolarlo e come usarlo per confrontare il tuo provider ASR.
In sintesi
- Il word error rate conta tre tipi di errore — sostituzioni, omissioni e inserimenti — e li divide per il numero di parole nella trascrizione di riferimento.
- La formula del WER è WER = (S + D + I) / N.
- Punteggi WER più bassi indicano un output finale più accurato.
- Un WER inferiore al 5% è un buon benchmark, anche se le trascrizioni legali o mediche possono richiedere un Word Error Rate ancora più basso.
- Il WER considera tutti gli errori uguali, quindi non è una metrica perfetta per valutare il contesto. Metriche emergenti, come il Semantic Word Error Rate (SWER), cercano di risolvere questo problema misurando se il significato di un enunciato è stato preservato.
Cos'è il word error rate?
Il word error rate (WER) è la metrica standard per misurare l'accuratezza del riconoscimento vocale nei modelli Speech to Text. È un valore compreso tra 0 e 1 (0,8 rappresenterebbe un tasso di errore dell'80%) che indica ciò che un sistema STT sbaglia durante la trascrizione, in base a sostituzioni, omissioni e inserimenti.
Una sostituzione avviene quando una parola viene rimpiazzata da quella sbagliata. Un'omissione avviene quando una parola viene completamente tralasciata. Infine, un inserimento si verifica quando nella trascrizione viene aggiunta una parola mai pronunciata. Il WER usa tutti e tre questi componenti e li divide per il numero di parole nella trascrizione corretta, ottenendo un valore che puoi confrontare con altri fornitori.
Ecco la formula del WER:
WER = (S + D + I) / N
Dove:
- S: Sostituzioni (la parola è errata)
- D: Omissioni (manca una parola)
- I: Inserimenti (è presente una parola aggiuntiva)
- N: Numero totale di parole nella trascrizione di riferimento
Puoi esprimere il WER come decimale o percentuale. Più il WER è basso, migliore è il risultato, perché il modello ha commesso meno errori durante la trascrizione.
In pratica, un WER del 10% significa che circa 1 parola su 10 nella trascrizione di una riunione richiede una seconda verifica.
Perché il word error rate è importante nei sistemi di riconoscimento vocale?
Il word error rate fornisce una metrica oggettiva che i team possono usare per confrontare diversi fornitori. Va oltre le dichiarazioni di marketing e mostra chiaramente quanto è accurato un modello di riconoscimento vocale. Partendo dai dati, ogni azienda che valuta le proprie opzioni può capire quali modelli sono attualmente leader in questo ambito.
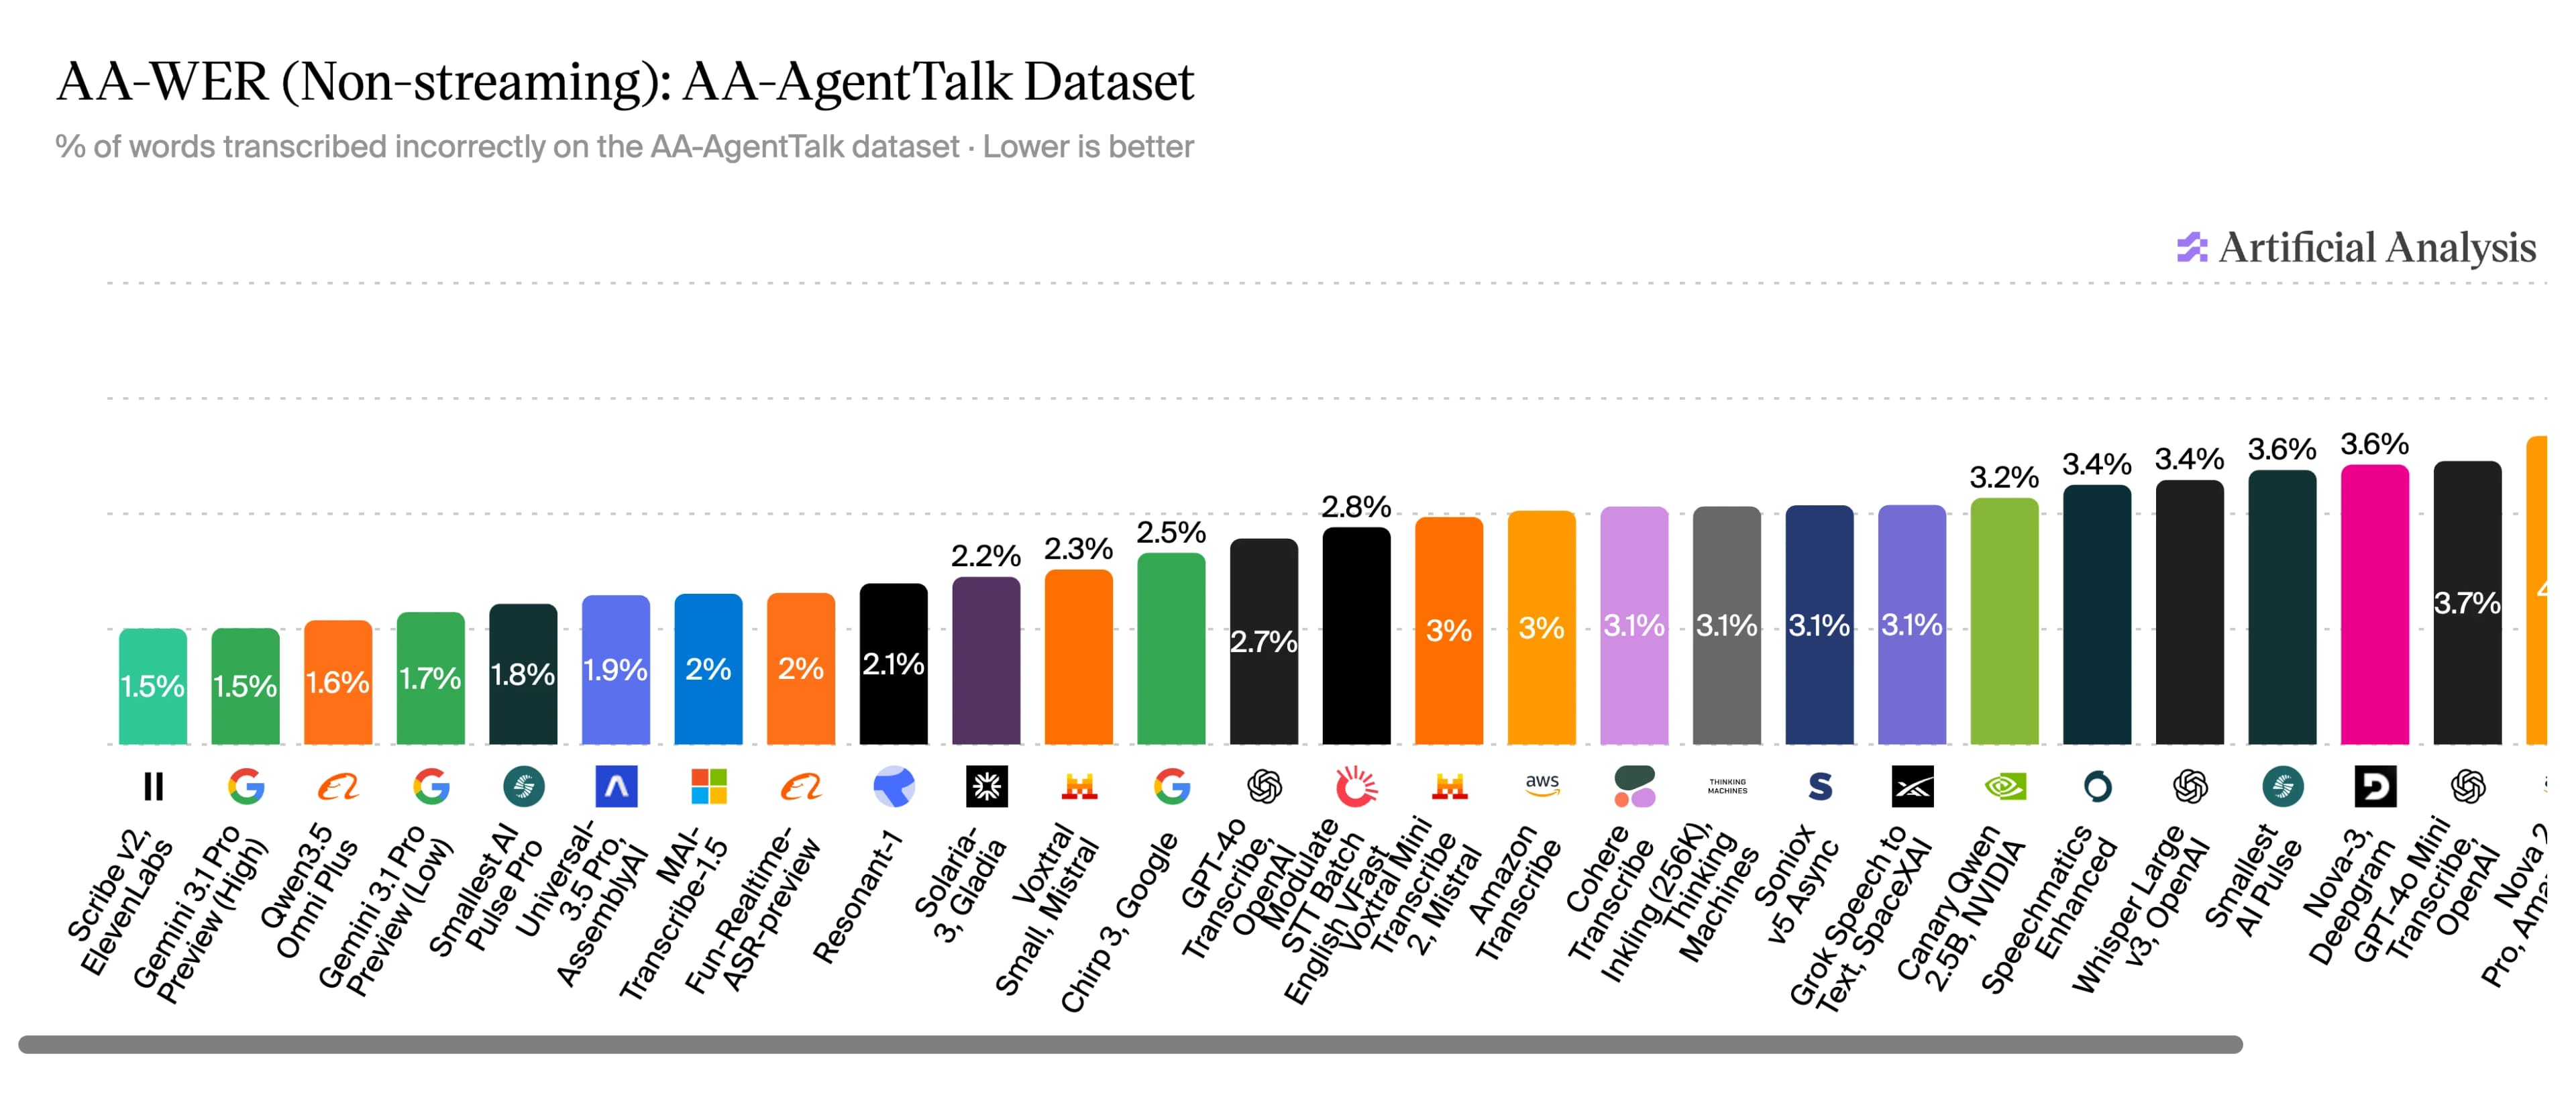
Fonte: Artificial Analysis consultato il 10 luglio 2026.
A luglio 2026, una ricerca indipendente di Artificial Analysis classifica Scribe v2 di ElevenLabs come il modello con il WER più basso del settore sul dataset AA-AgentTalk per i modelli di trascrizione non in streaming, con un WER dell'1,5%.
Oltre alla valutazione dei fornitori, il WER ha un impatto concreto a livello di prodotto. Un software di trascrizione medica con un WER del 12% potrebbe introdurre errori critici nelle cartelle cliniche dei pazienti. Trascrizioni errate in una chiamata di assistenza clienti potrebbero causare problemi a valle, come un'analisi del sentiment imprecisa o una categorizzazione scadente.
Oltre a questi problemi specifici dei casi d'uso, quando i sistemi ASR falliscono, le persone più colpite sono spesso quelle per cui la trascrizione è l'unico modo per accedere ai contenuti parlati. Il World Wide Web Consortium offre ampia documentazione sugli standard minimi previsti dalle iniziative di accessibilità.
Come calcolare il word error rate: formula ed esempio
Calcolare il word error rate è semplice una volta che conosci i passaggi. Come visto sopra, la formula da usare è WER = (S + D + I) / N. Tutti i termini sono descritti sopra; in breve, indicano sostituzioni, omissioni, inserimenti e N, ovvero il numero totale di parole nella trascrizione.
Ecco come calcolare il WER:
- Crea una trascrizione di riferimento: usa la trascrizione e la verifica umane per produrre una trascrizione accurata di una clip audio.
- Usa il tuo strumento STT: usa una piattaforma ASR per trascrivere la clip audio e generare una trascrizione IA da usare per il test.
- Allinea le due versioni: usa la programmazione dinamica, in particolare l'algoritmo di Levenshtein, per trovare il numero minimo di modifiche. Approfondiremo questo algoritmo in una sezione successiva.
- Applica la formula: conta il numero totale di errori nella versione generata dall'IA rispetto alla copia verificata da un essere umano, quindi usa WER = (S + D + I) / N per calcolare il WER esatto.
Sulla carta può sembrare piuttosto tecnico, ma in pratica è molto più semplice. Ecco un esempio per mostrarti cosa intendiamo.
Trascrizione di riferimento: La signora Dalloway disse che avrebbe comprato i fiori da sola.
Output ASR: La signorina Dalloway disse che avrebbe comprato fiori da sola.
Se calcoliamo gli errori totali, abbiamo 1 S e 1 D su 9 parole complessive.
Usando la formula, otteniamo: WER = 2 / 9 = 0,222 = 22,2%.
Calcolare il word error rate con Python
Anche se il metodo manuale funziona molto bene, puoi risparmiare tempo calcolando il WER con Python. La libreria jiwer gestisce tutto questo in modo completamente automatico.
Usando la documentazione di jiwer, puoi installare il pacchetto, creato appositamente per valutare un sistema ASR e produrre metriche essenziali come il WER. Dopo averlo scaricato, puoi usare il seguente codice per calcolare rapidamente il WER con Python:
Nota che, in questo esempio, l'output ASR differisce dal riferimento originale in due punti. La parola ‘jumps’ è stata trascritta erroneamente come ‘leaps’ (una sostituzione) e ‘last’ è stata inserita prima di ‘lazy’ (un inserimento). Con due errori sulle nove parole della trascrizione di riferimento, il risultato è un Word Error Rate (WER) di 0,222, ovvero 22,2%.
Confronto tra word error rate e altre metriche di riconoscimento
Sebbene il WER sia la metrica standard per calcolare l'accuratezza di un ASR, puoi usare anche altri strumenti. Ad esempio:
- Character Error Rate (CER): come il WER, misura l'accuratezza della trascrizione a livello di carattere anziché di parola. È ideale per le lingue senza confini chiari tra le parole (scriptio continua) o per attività sensibili all'ortografia.
- Match Error Rate (MER): misura la proporzione degli errori di trascrizione, trattando sostituzioni, inserimenti e omissioni in modo leggermente diverso dal WER. Si concentra sulla proporzione di errori presenti in una frase.
- Word Information Lost (WIL): stima quante informazioni originali sono andate perse durante la trascrizione, fornendo una misura della comprensibilità anziché il conteggio diretto degli errori del WER.
- Embedding Error Rate (EmbER): offre un'analisi semantica tra le trascrizioni. Va oltre il WER e consente di comprendere la distanza semantica tra la parola corretta e la trascrizione errata.
Ciascuna di queste metriche è più adatta a uno scenario diverso. Ecco una tabella di riferimento:
Esempi di distanza di Levenshtein: la matematica alla base del WER
Il word error rate è essenzialmente una misura della distanza tra l'originale e l'output dell'ipotesi. Per comprendere questa differenza dal punto di vista matematico, usiamo la distanza di Levenshtein.
La distanza di Levenshtein conta il numero minimo di modifiche di una singola unità necessarie per trasformare una sequenza in un'altra. Nel caso del WER, si tratta nello specifico di sostituzioni, inserimenti e omissioni. Ad esempio, per trasformare Cat in Mat, dovresti sostituire la lettera ‘C’ con ‘M’, ottenendo una distanza di Levenshtein pari a 1.
Anche se questo concetto è molto più comune nei calcoli CER, il WER applica la distanza di Levenshtein a livello di parola. Ogni unità è una parola intera anziché un carattere e la distanza effettiva misura quante modifiche alle parole sarebbero necessarie per trasformare il nostro output ASR nell'originale accurato.
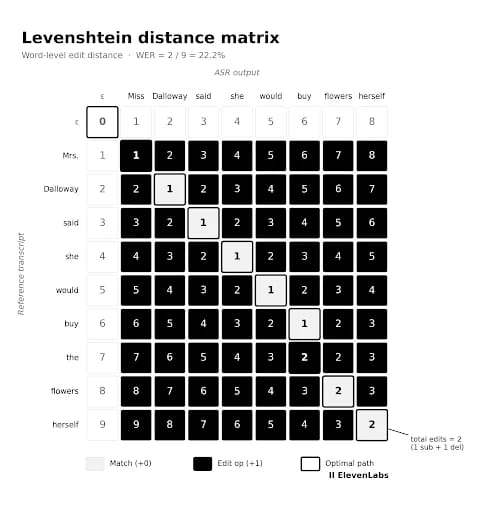
Costruiamo una matrice in cui ogni cella rappresenta la distanza totale tra la trascrizione originale e quella ASR. La distanza di Levenshtein riempie poi la matrice dall'alto a sinistra al basso a destra, e la cella finale fornisce il numero totale di modifiche a livello di parola. Dividendo questo numero per N ottieni il WER.
Sebbene questa matrice venga solitamente calcolata con singoli caratteri, qui trovi una versione semplificata e su scala più ampia dell'esempio precedente.
Errori e idee sbagliate comuni sul word error rate
In particolare, poiché le API STT diventano più accessibili e i software ASR entrano comunemente in stack di agenti più ampi, vedremo molti confronti tra strumenti diversi.
Prima di calcolare i tuoi word error rate, è importante comprendere alcuni problemi e idee sbagliate comuni.
- Tutti gli errori sono uguali: il WER considera ogni errore ugualmente significativo. In molti contesti può andare bene, ma in alcuni casi d'uso è inaccettabile. Ad esempio, in un ospedale, un errore del 5%, che sarebbe considerato un buon WER, potrebbe comunque essere incomprensibile, poiché anche solo uno o due errori potrebbero mettere a rischio un paziente. Questo limite ha portato allo sviluppo di metriche più recenti, come il Semantic Word Error Rate (SWER), che cerca di misurare se il significato di una frase è stato preservato anziché verificare che ogni parola corrisponda esattamente.
- Il WER può superare il 100%: anche se abbiamo detto che il WER è compreso tra 0 e 1, può comunque superare il 100%. Questo accade perché gli errori di inserimento possono creare più parole del totale nella trascrizione originale. Un caso comune è trascrivere ‘I’m’ come ‘I am’, dove una parola diventa due.
- Un WER più basso non è sempre tecnicamente migliore: un WER del 5% è, sulla carta, migliore di un WER del 10%. Tuttavia, se gli errori che hanno contribuito a quel 5% hanno modificato significativamente il contesto di una frase, mentre quelli del 10% no, il quadro complessivo non viene rappresentato. Il contesto resta molto importante; metriche come lo SWER vengono sviluppate proprio per cogliere questo impatto semantico.
Nel 2024, Apple ha pubblicato un interessante studio che ha esplorato l'ultimo punto sopra. Quando le persone hanno valutato un calcolo WER del 9,4% in base alla leggibilità dell'ASR, hanno assegnato allo stesso passaggio un WER di appena il 2,2%. Nell'esempio testato, le persone hanno considerato gli «errori» insignificanti in molti casi, ottenendo un Human WER oltre 4 volte più tollerante rispetto alle macchine.
Benchmark di settore per il WER
Il WER ideale dipende molto dal settore o dal caso d'uso in cui utilizzi la tecnologia ASR. Sebbene un valore inferiore al 5% sia un benchmark di settore per il WER, settori specifici come la trascrizione medica o legale richiedono un tasso molto più basso.
Nello studio di Artificial Analysis del luglio 2026, Scribe v2 di ElevenLabs ha ottenuto un WER dell'1,5%. Tuttavia, è importante ricordare che queste statistiche vengono solitamente calcolate usando l'inglese come lingua principale. La tecnologia STT potrebbe non essere altrettanto efficace in altre lingue.
La documentazione di ElevenLabs illustra le fasce WER generali per tutte le lingue supportate da Scribe v1 e Scribe v2.
Inizia con ElevenAPI per migliorare l'accuratezza del riconoscimento
Quando sviluppi un'applicazione o un prodotto in cui la qualità della trascrizione è importante, la differenza tra un'API ASR scelta con cura e una mediocre si riflette prima nel WER e poi nell'esperienza degli utenti.
ElevenLabs Scribe è il livello di Speech to Text accessibile tramite ElevenAPI. Oltre a supportare più di 90 lingue e a offrire un WER leader nel settore, include funzionalità come la diarizzazione dei parlanti, timestamp a livello di parola, keyterm prompting e rilevamento delle entità.
Esplora la documentazione di ElevenLabs per saperne di più su ElevenAPI oppure inizia registrandoti oggi.
FAQ sul word error rate

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


