Che cos'è il riconoscimento vocale automatico (ASR)?
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Nel 1952, il sistema di riconoscimento vocale più avanzato al mondo riusciva a comprendere esattamente 9 parole.
Circa 75 anni dopo, il riconoscimento vocale automatico (ASR) trascrive decine di lingue in tempo reale, alimentando qualsiasi cosa, dagli assistenti vocali sul tuo telefono ai sottotitoli che compaiono nei video in diretta.
Questa guida esplora la tecnologia che ha colmato il divario tra le versioni del 1952 e quelle moderne, spiegando cos'è l'ASR, come converte il parlato in testo e come continua a evolversi ancora oggi.
In sintesi:
- ASR significa riconoscimento vocale automatico, la tecnologia che converte l'audio parlato in testo scritto.
- La prima forma di ASR è comparsa nel 1952, mentre i sistemi di deep learning hanno raggiunto benchmark umani verso la fine degli anni 2010.
- L'ASR moderno usa reti neurali end-to-end addestrate su milioni di ore di audio.
- Il word error rate (WER) è la metrica standard di accuratezza, ma anche la latenza, la qualità della diarizzazione e la comprensione del contesto hanno un ruolo nell'ASR in produzione.
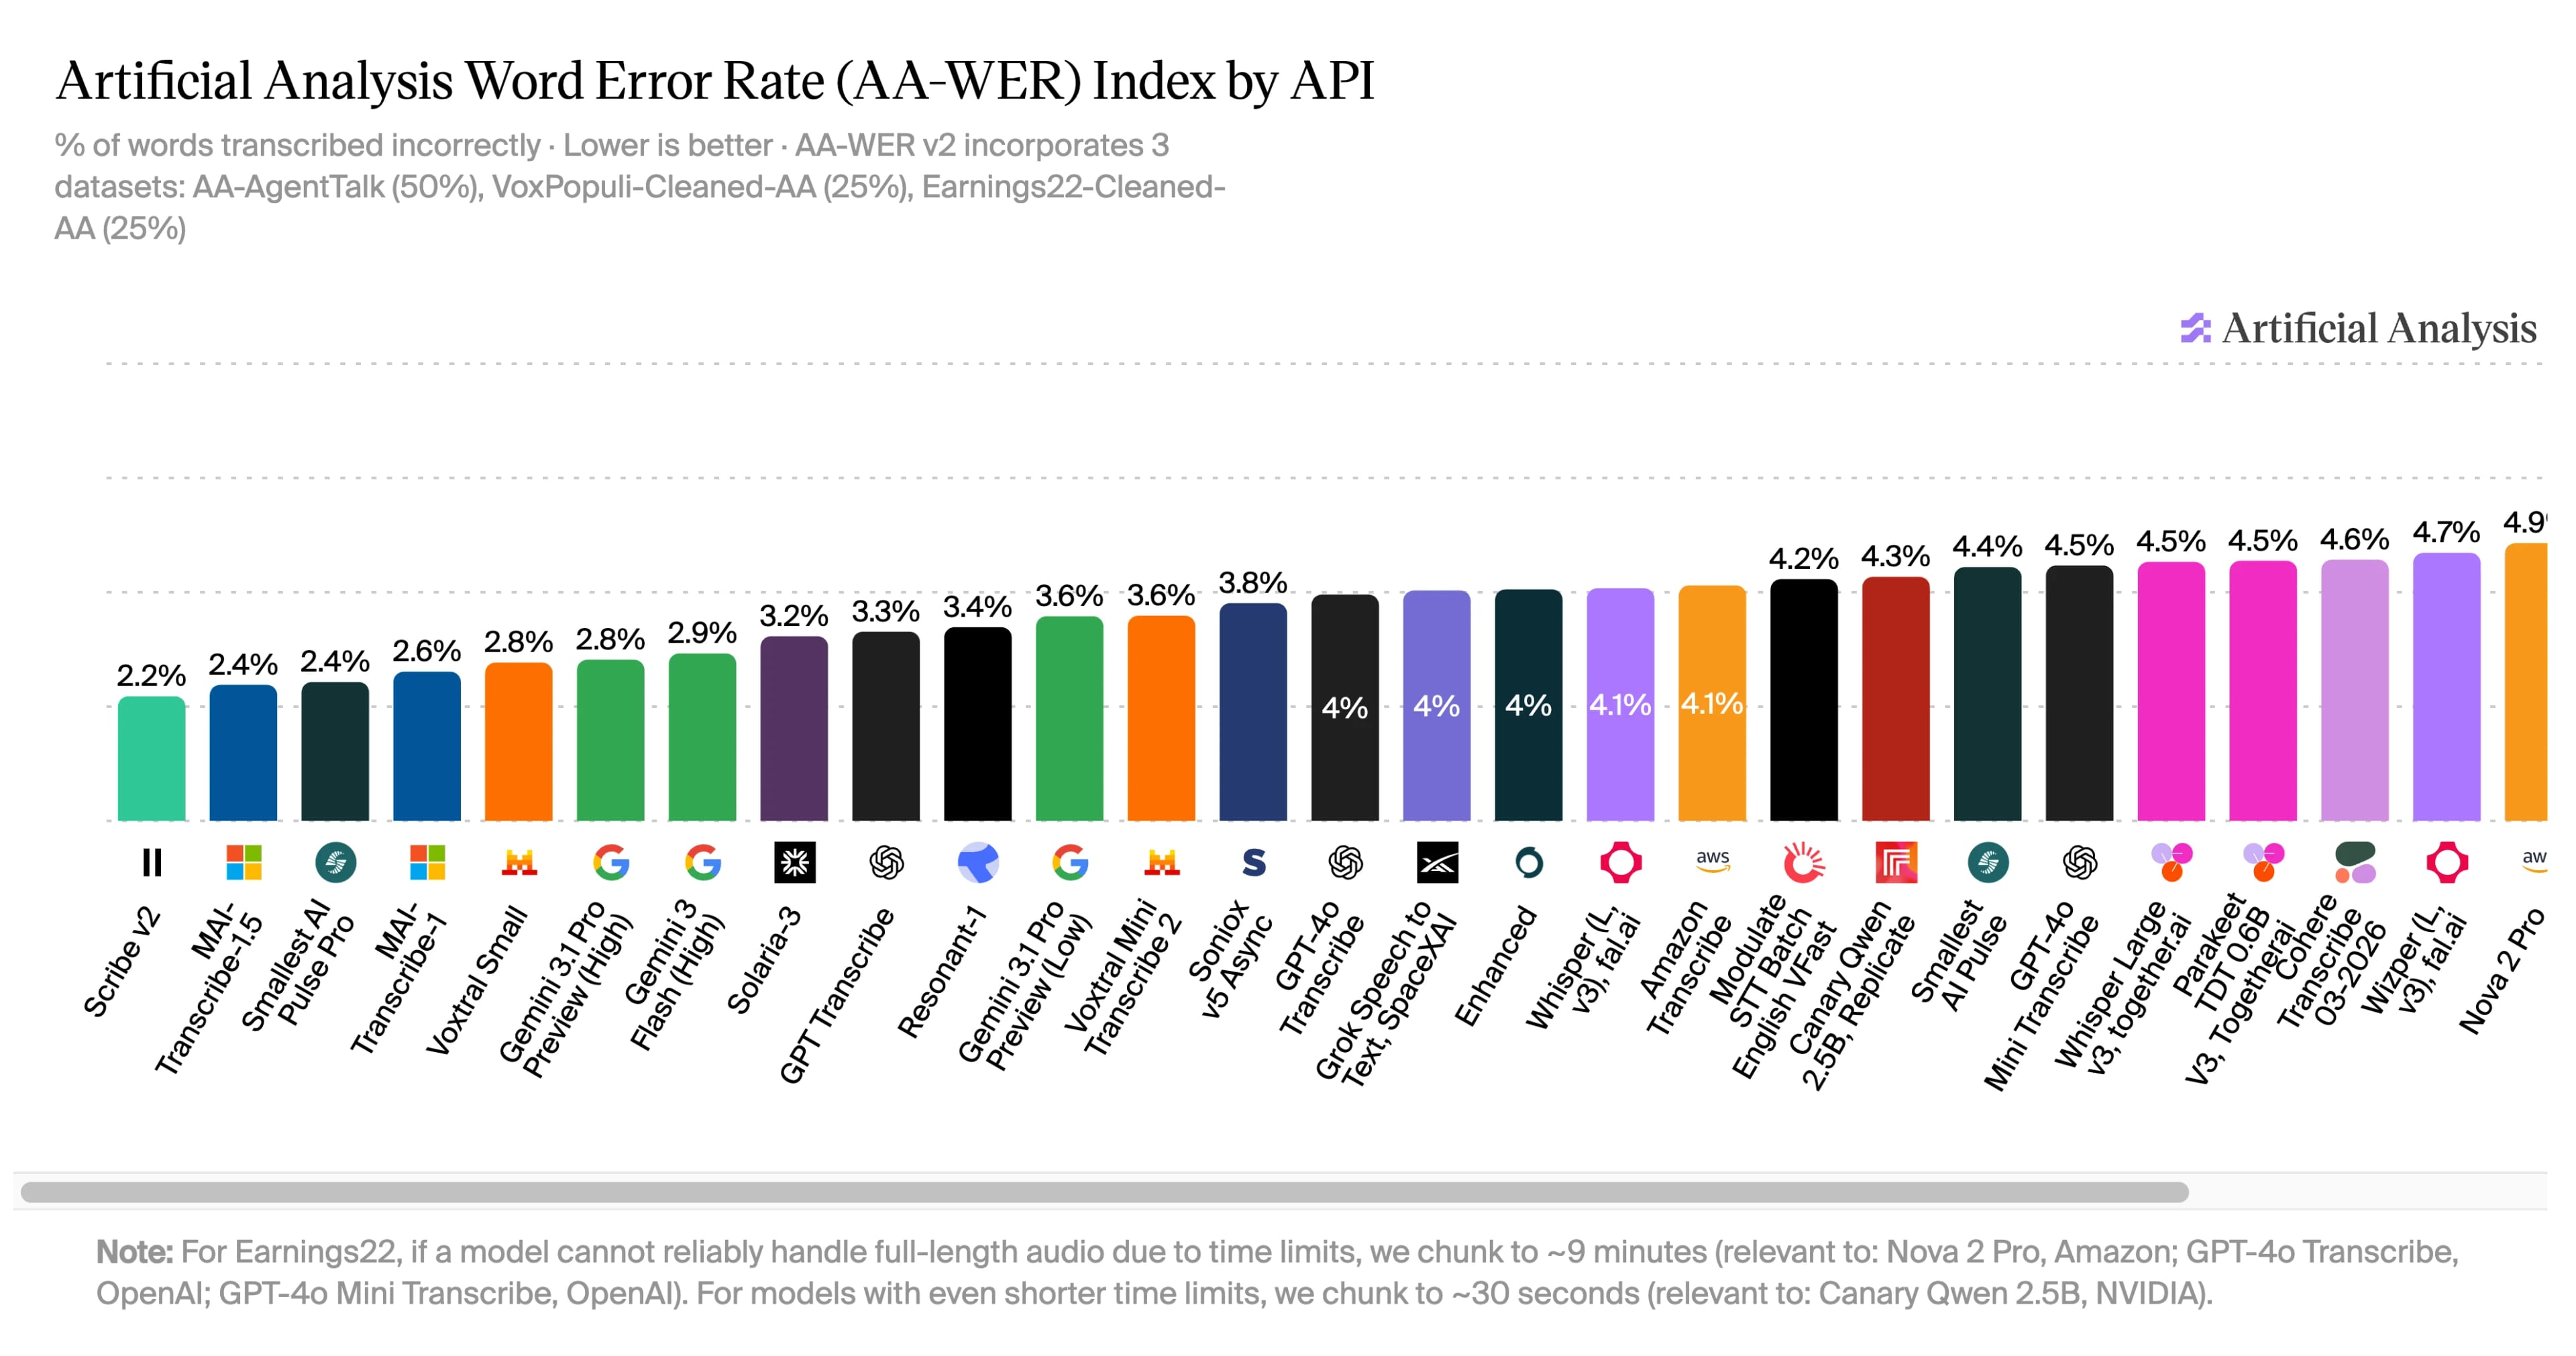
- ElevenAPI offre agli sviluppatori un ASR pronto per la produzione, valutato in modo indipendente da Artificial Analysis con un word error rate del 2,2%, il più basso nel suo indice (luglio 2026).
Cos'è il riconoscimento vocale automatico (ASR)?
Il riconoscimento vocale automatico, spesso chiamato semplicemente con l'acronimo ASR, descrive un software che ascolta il parlato umano e lo trasforma in testo accurato e leggibile dalle macchine. Viene anche comunemente chiamato speech to text o riconoscimento vocale, e talvolta persino riconoscimento vocale computerizzato.
L'ASR è diventato così diffuso che potresti interagirci ogni giorno senza nemmeno rendertene conto. Ogni volta che detti un messaggio, fai una domanda a un assistente vocale, leggi i sottotitoli durante un video in diretta o navighi in un sistema telefonico di risposta vocale interattiva, stai usando l'ASR.
Sebbene speech to text e ASR siano spesso usati come sinonimi, e siano strettamente correlati, non sono esattamente la stessa cosa. L'ASR è la tecnologia che identifica ciò che viene detto, mentre lo STT è l'applicazione pratica di questa tecnologia. Il software di riconoscimento della voce si basa sull'ASR e identifica chi ha pronunciato una determinata parola, costituendo la base delle funzionalità di diarizzazione dei parlanti.
Sono distinzioni piccole, ma utili da comprendere se vuoi integrare sistemi ASR/STT/di riconoscimento della voce nelle tue app o nel tuo sito web.
Breve storia della tecnologia di riconoscimento vocale automatico
La tecnologia di riconoscimento vocale automatico è molto più vecchia di quanto la maggior parte delle persone immagini: le prime versioni risalgono agli anni Cinquanta. Negli oltre 70 anni dalla sua nascita, l'ASR ha attraversato diverse fasi importanti che hanno in gran parte posto le basi dei suoi progressi storici.
Ecco le principali fasi attraversate dalla tecnologia ASR:
- Il 1952 e il primo ASR: Nel 1952, l'Automatic Digit Recognizer, noto come AUDREY, fu realizzato dai Bell Laboratories per comprendere le cifre da uno a nove. Lo strumento aveva un'accuratezza di appena il 90% circa e funzionava soltanto se veniva usato dal suo inventore, il che lo rendeva estremamente limitato. Pur essendo lontanissimo dalle capacità moderne, anche il semplice riconoscimento dei numeri da 1 a 9 era un risultato notevole.
- Gli anni Sessanta e Settanta e il crescente vocabolario dell'ASR: Nei decenni successivi, laboratori di tutto il mondo, tra cui IBM, University College London e NEC in Giappone, riuscirono a produrre modelli simili ad AUDREY in contesti diversi. Raj Reddy, studente indiano di dottorato a Stanford, realizzò un riconoscitore di vocali per il suo progetto di PhD, gettando le basi per il riconoscimento del parlato continuo senza dover fare pause tra le parole. In questo periodo DARPA (Defense Advanced Research Projects Agency) finanziò ricerche che portarono al Beam Search, un metodo di costruzione e decodifica delle frasi fondamentale per riconoscere oltre 1.000 parole totali entro il 1976.
- Dagli anni Ottanta ai primi anni 2010: i progressi statistici: Nel 1987, uno studente di Raj Reddy, ormai professore, combinò gli Hidden Markov Models con il Beam Search, rendendo possibili ASR che non richiedevano l'addestramento su un unico parlante specifico. Questa innovazione ridusse radicalmente i tempi di addestramento dei sistemi di riconoscimento vocale. Nel 1997 Dragon Systems rilasciò il primo ASR disponibile in commercio, chiamato NaturallySpeaking Preferred. Poteva riconoscere 100 parole al minuto e ottenne buone vendite.
- L'era moderna e il deep learning: Negli anni 2010, i ricercatori dimostrarono che una singola rete neurale addestrata end-to-end su audio e trascrizioni superava una pipeline puramente statistica. Con l'arrivo delle reti neurali profonde, gli ASR potevano raggiungere prestazioni vicine a quelle umane, con un tasso di errore tra il 5% e il 10%. In questo periodo arrivarono sul mercato assistenti vocali come Alexa e Siri.
Da allora, l'ASR è diventato sempre più accurato e utilizzato. A luglio 2026, la ricerca indipendente di Artificial Analysis ha identificato Scribe v2 di ElevenLabs come il modello con il miglior word error rate (WER) del settore, pari ad appena il 2,2%.
Come funziona l'ASR? Le basi della tecnologia speech to text
L'ASR acquisisce un campione audio, lo converte in una rappresentazione numerica e usa poi un modello addestrato per prevedere la sequenza di parole più probabile rappresentata da quei dati. L'ASR moderno esegue questo sistema in tempo reale, completando l'intero processo end-to-end in meno di un secondo.
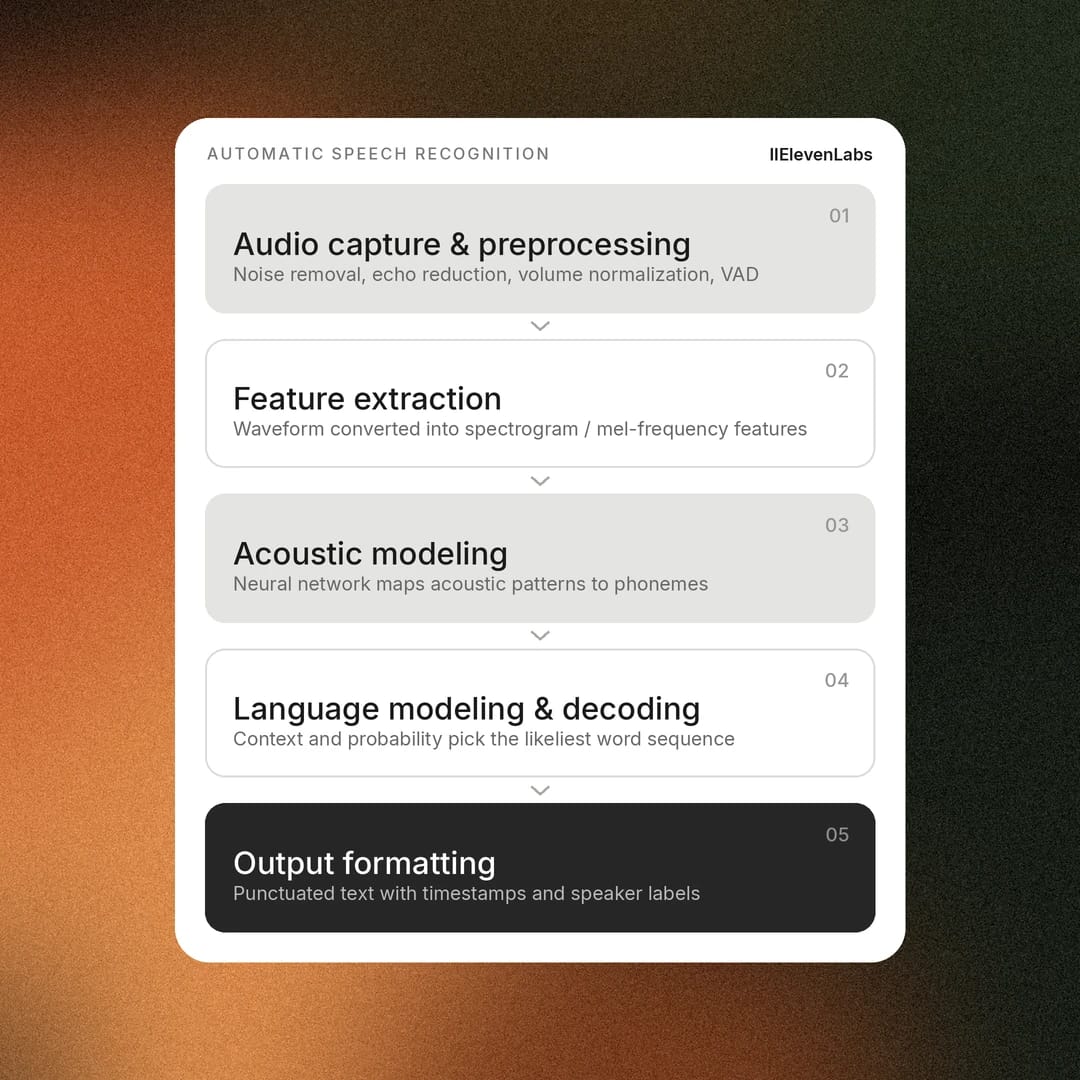
Una pipeline ASR comprende cinque fasi principali:
- Acquisizione e pre-elaborazione dell'audio: Il sistema registra il segnale audio, rimuove il rumore di fondo, riduce l'eco e normalizza i livelli di volume per migliorare la coerenza. In base al modello specifico, può usare il rilevamento dell'attività vocale (VAD) per distinguere il parlato dal silenzio o dai rumori di fondo prima che inizi la trascrizione.
- Estrazione delle caratteristiche: L'audio viene convertito in una rappresentazione numerica, in genere uno spettrogramma o caratteristiche mel-frequency, che evidenzia con precisione le frequenze e i pattern presenti nel parlato umano. Questo passaggio trasforma essenzialmente una forma d'onda grezza in dati che un modello di machine learning può elaborare efficacemente.
- Modellazione acustica: Una rete neurale analizza le caratteristiche del passaggio precedente e prevede fonemi o altre unità del parlato, apprendendo la relazione tra pattern acustici e lingua parlata. I moderni modelli end-to-end spesso eseguono questo passaggio insieme alla comprensione del linguaggio, anziché come fase completamente separata.
- Modellazione e decodifica del linguaggio: Il sistema valuta quindi quali sequenze di parole siano più probabili sulla base di regole quali grammatica, contesto e probabilità matematica. Gli ultimi due aspetti sono fondamentali: la trascrizione IPA (International Phonetic Alphabet) di due frasi può essere simile, pur avendo un contesto completamente diverso. Ad esempio, in inglese “Recognize Speech” e “Wreck a nice peach” possono suonare allo stesso modo, ma hanno significati completamente diversi. Se la precisione non basta a stabilirlo con certezza, il contesto aiuta il sistema a decidere quale sia corretta.
- Formattazione dell'output: Dopo aver stabilito il contenuto del parlato, viene trascritto il testo finale, con punteggiatura e maiuscole. Metadati aggiuntivi, come i timestamp a livello di parola e le etichette dei parlanti, permettono di creare trascrizioni più dettagliate.
In queste fasi principali, il modello trasforma i dati audio in arrivo in una trascrizione scritta.
Sistemi ibridi tradizionali e ASR con deep learning end-to-end
Sebbene la pipeline sopra descriva il funzionamento dell'ASR, esistono in realtà due approcci tecnologici per la parte centrale della pipeline.
I sistemi legacy concatenano diversi componenti: un modello lessicale che codifica la pronuncia delle parole, un modello acustico che mappa l'audio sui fonemi e un modello linguistico che prevede le sequenze di parole probabili. Ciascuno di questi componenti richiede competenze umane per essere creato, dai linguisti che realizzano manualmente dizionari di pronuncia agli annotatori che allineano ogni parola alla sua posizione esatta nell'audio.
Il deep learning end-to-end riunisce tutti questi componenti in un'unica rete neurale. La rete mappa direttamente l'audio sul testo, comprendendo implicitamente pronuncia, acustica e statistiche di probabilità linguistiche da milioni di ore di audio e trascrizioni abbinate.
Vediamo le differenze tra gli approcci tradizionali e moderni alla tecnologia ASR.
Come si misura l'accuratezza dell'ASR: benchmark del word error rate (WER)
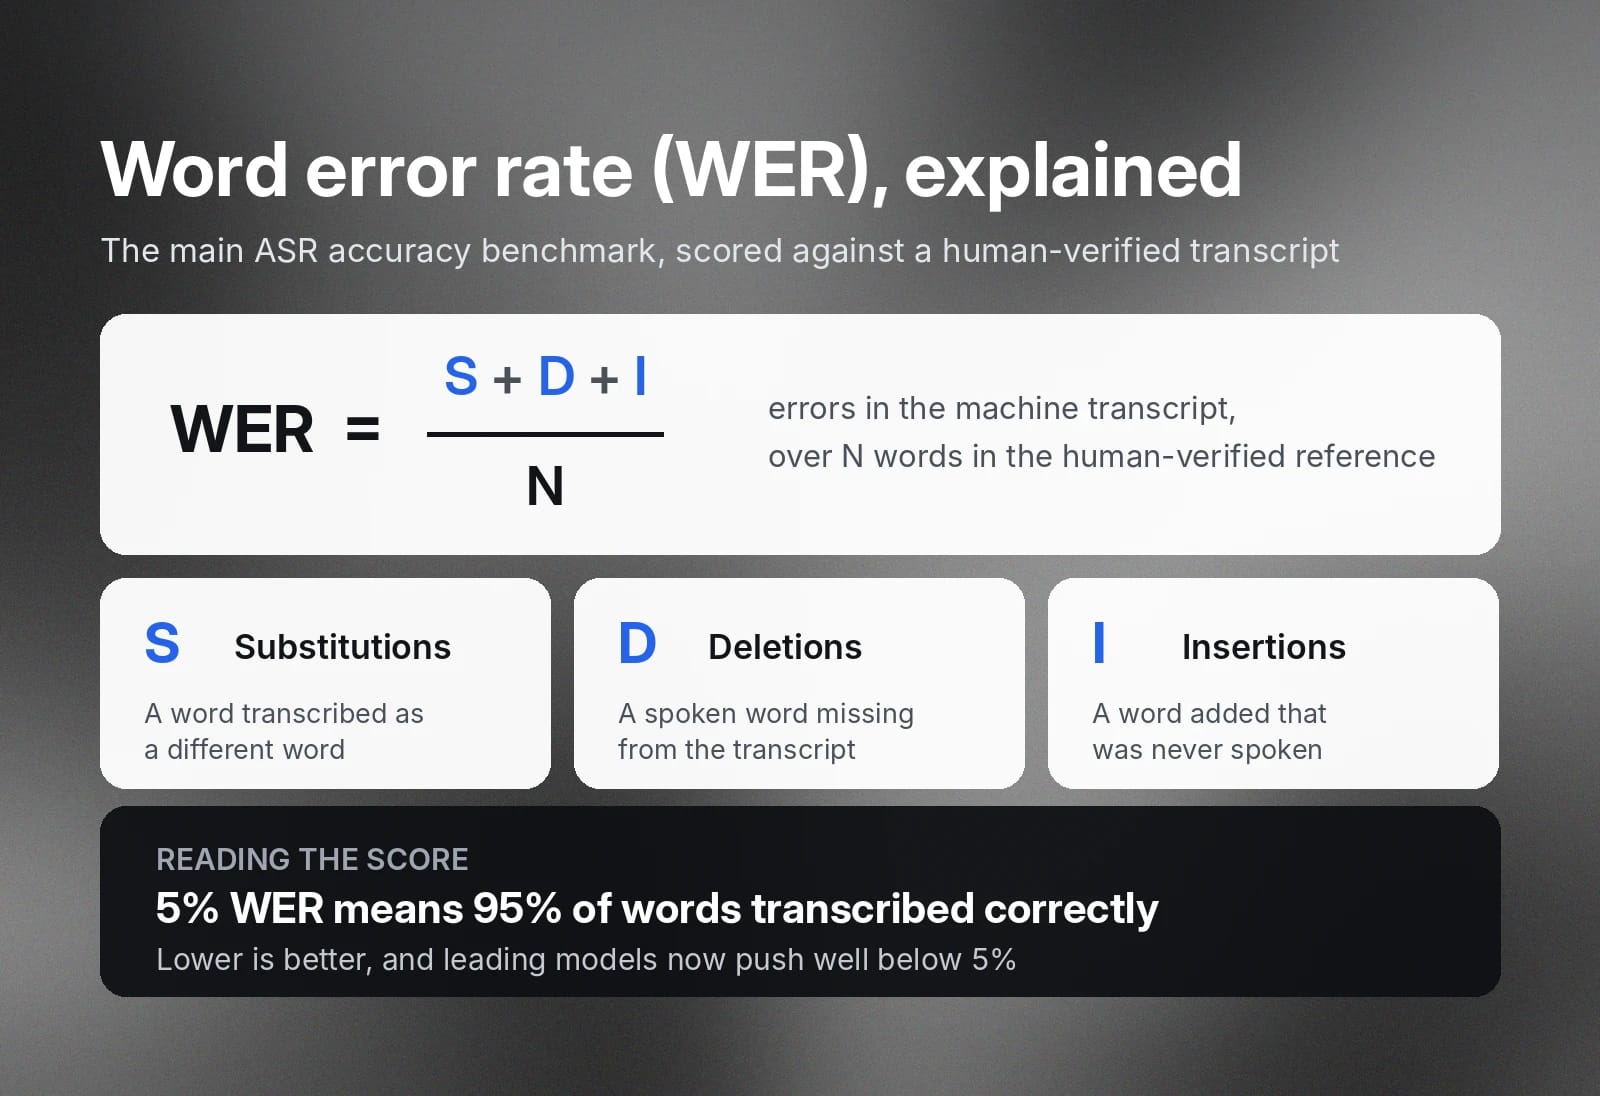
In tutti i workflow speech to text e ASR, il word error rate (WER) è la principale metrica di accuratezza usata dalle aziende. Confronta una trascrizione generata dall'ASR con una versione verificata da una persona. Ci sono tre principali tipi di errore da considerare: sostituzioni, eliminazioni e inserimenti.
La formula del WER divide gli errori totali per il numero di parole nella trascrizione di riferimento. Un WER del 5% significherebbe che il sistema è riuscito a trascrivere accuratamente il 95% del testo, mentre i modelli leader stanno ormai scendendo ben al di sotto del 5%, avvicinandosi alla perfezione.
Sebbene il WER sia un benchmark utile, per determinare l'efficacia di uno strumento ASR bisogna considerare anche altri fattori:
- Accuratezza della formattazione: Il sistema riesce a formattare correttamente stringhe non standard? Ad esempio, un importo come $1.225 viene visualizzato così oppure scritto in lettere come “milleduecentoventicinque dollari”?
- Latenza: L'accuratezza è importante, ma se per generare una semplice trascrizione servono alcuni minuti, lo strumento diventa inutilizzabile. Anche se è estremamente accurato, deve bilanciare questo aspetto con una bassa latenza per essere utile.
- Robustezza: Anche casi d'uso come accenti marcati o ambienti rumorosi non dovrebbero ridurre significativamente l'accuratezza del modello.
- Qualità della diarizzazione: I casi d'uso con più parlanti dipendono dalla corretta attribuzione di ogni parola al parlante giusto. La capacità di identificare i diversi parlanti e di etichettarli correttamente contribuisce all'ASR, soprattutto in settori con molti parlanti, come le aule di tribunale.
Per maggiori informazioni, leggi la nostra guida completa al word error rate.
Principali vantaggi dell'ASR per le aziende moderne
Si prevede che il mercato globale del riconoscimento vocale e del parlato supererà i 23,11 miliardi di dollari entro il 2030. Il CAGR del 19,1% del mercato riflette quanto questa tecnologia sia diventata diffusa nei dispositivi commerciali. Ogni moderno telefono cellulare dispone di una tastiera per la dettatura e di un assistente vocale, la maggior parte delle nuove auto risponde ai comandi vocali e gli altoparlanti intelligenti o gli assistenti sono ormai presenti nelle case di tutto il mondo.
Interagire con la tecnologia tramite la voce è ormai un'opzione predefinita per i clienti. Per le aziende, l'ASR offre dalla trascrizione delle chiamate dei clienti all'assistenza tramite agenti vocali, integrandosi nei processi e aumentando la produttività.
Ecco alcuni dei principali vantaggi dell'ASR per le aziende moderne:
- Inserimento e documentazione più rapidi: Già oltre 10 anni fa, Stanford ha pubblicato uno studio che dimostrava come la tecnologia di riconoscimento vocale fosse quasi tre volte più veloce della digitazione su tastiera, mantenendo al contempo un tasso di errore inferiore. Per la grande maggioranza delle persone, l'ASR rende più rapida la documentazione nei workflow di trascrizione e nella presa di appunti tramite voce.
- Costi operativi inferiori: In molti casi d'uso che un tempo richiedevano ore di appunti manuali, la tecnologia ASR riduce radicalmente il costo della trascrizione di alta qualità. Casi giudiziari, contact center, cliniche sanitarie e riunioni aziendali possono ora disporre di sistemi ASR accurati che creano note dettagliate e trascrizioni complete delle conversazioni con diarizzazione.
- Maggiore accessibilità: L'Organizzazione Mondiale della Sanità prevede che 2,5 miliardi di persone vivranno con una qualche forma di perdita dell'udito entro il 2050. I sottotitoli in tempo reale forniti dagli strumenti ASR avanzati possono rendere riunioni digitali e media accessibili agli utenti.
- Dati vocali ricercabili: Quando trascrivi automaticamente il parlato con l'ASR, ogni interazione tra cliente e azienda viene registrata integralmente. Ogni chiamata di vendita, ticket di assistenza, chiamata con un potenziale cliente o riunione diventa un testo ricercabile e verificabile. Soprattutto nell'era dell'IA, rendere disponibile il contesto in un formato leggibile dalle macchine può aiutare a creare knowledge base estese. Per funzionalità o conformità, questo aiuta a mantenere visibili le informazioni.
- Esperienze cliente sempre attive: L'ASR offre una delle tecnologie fondamentali per gli agenti vocali, contribuendo a rendere possibili casi d'uso di assistenza automatizzata che risolvono le chiamate dei clienti 24 ore su 24, 7 giorni su 7, 365 giorni l'anno.
Il riconoscimento vocale automatico è così predominante nella tecnologia per i numerosi vantaggi che offre e per l'ampia varietà di casi d'uso che supporta. Che tu lavori in ambito medico o voglia trascrivere chiamate dei clienti per analizzarne il sentiment, l'ASR è una tecnologia fondamentale che puoi integrare e usare.
Applicazioni popolari dell'ASR nei vari settori
Il riconoscimento vocale automatico è una tecnologia centrale in innumerevoli workflow e prodotti. Ha raggiunto un livello di diffusione tale che gli utenti spesso non pensano nemmeno a come sia integrato nella tecnologia che usano.
Ecco una rapida panoramica di alcuni casi d'uso popolari dell'ASR nel mondo.
Servizio clienti e contact center
I contact center sono stati tra i primi ad adottare l'ASR, usandolo per trascrivere le chiamate ai fini della qualità e della conformità normativa. Oggi l'ASR può funzionare in tempo reale, offrendo suggerimenti agli operatori durante la conversazione e trasformando migliaia di interazioni con i clienti in dati analizzabili dai team.
Media e intrattenimento
Emittenti e piattaforme di streaming possono usare l'ASR per generare sottotitoli e didascalie delle conversazioni umane su una scala che i trascrittori umani non potrebbero mai eguagliare. Consente la trascrizione in tempo reale e rende completamente ricercabili anche le librerie video e audio.
Sanità
Il personale clinico dedica una parte sorprendente della giornata alla documentazione e alla compilazione delle cartelle cliniche. L'ASR aiuta a recuperare questo tempo, offrendo ai medici una piattaforma di STT medico su cui dettare le proprie note in tempo reale.
Riunioni virtuali
Le piattaforme per riunioni spesso offrono una qualche forma di presa di appunti digitale per trascrivere le conversazioni mentre avvengono, così nessuno deve scegliere tra partecipare e prendere appunti. Servizi come Google Meet inviano persino le trascrizioni dopo ogni riunione, evidenziando le azioni da svolgere e contribuendo a creare un indice di informazioni ricercabile.
Ambito legale e conformità normativa
In ambito legale, registrare con precisione cosa è stato detto e da chi è un requisito fondamentale in tribunale. Gli studi legali usano piattaforme ASR per trascrivere riunioni, udienze, chiamate con i clienti e sedute in tribunale con timestamp precisi da consultare in futuro.
Istruzione
I docenti universitari possono fornire una trascrizione registrata delle loro lezioni per aiutare gli studenti a creare un archivio dei corsi frequentati. Per comprendere e memorizzare le informazioni, gli studenti hanno a disposizione una risorsa completa da cui partire.
Dove si inserisce l'ASR nella pipeline di un agente vocale
L'ASR è una componente standard di diverse implementazioni tecnologiche. Nella tecnologia degli agenti vocali, è la prima di tre fasi più ampie che si ripetono in un ciclo continuo.
- Ascoltare (ASR): L'agente acquisisce i flussi audio in arrivo e converte il parlato in testo in tempo reale. L'ASR moderno elabora continuamente l'audio man mano che arriva, filtra il rumore di fondo, gestisce le interruzioni, produce trascrizioni parziali e identifica quando parla ogni persona.
- Pensare (modello linguistico): Un large language model interpreta la trascrizione, comprende l'intento dell'utente, recupera informazioni da strumenti e knowledge base connessi, mantiene il contesto conversazionale e determina la risposta o l'azione più appropriata.
- Parlare (text to speech): Un modello di text to speech converte la risposta LLM generata in audio naturale ed espressivo. I moderni sistemi TTS possono poi regolare ritmo, intonazione, emozione ed enfasi mentre trasmettono l'audio al chiamante man mano che viene generato, anziché attendere la risposta completa.
La latenza conversazionale si accumula in ciascuna di queste fasi. Per ridurre la latenza, l'ASR in streaming inizia a produrre parole non appena vengono pronunciate, invece di aspettare la fine di un enunciato. ElevenAgents usa questo standard per gli agenti vocali in tempo reale, contribuendo a creare un'esperienza efficiente.
Sfide dell'ASR e come si sta evolvendo la tecnologia
Sebbene la tecnologia ASR abbia fatto molta strada dalle sue origini nel 1952, restano diverse sfide che possono ridurne l'accuratezza.
Ecco alcuni dei problemi che gli strumenti ASR incontrano ancora oggi:
- Accenti e dialetti: I dati disponibili per l'addestramento tendono a concentrarsi su poche lingue e accenti, rendendo più difficili per gli strumenti ASR gli accenti meno comuni o le lingue parlate da meno persone. La soluzione consiste in set di dati di addestramento ricchi e diversificati.
- Rumore di fondo e parlanti sovrapposti: Ambienti con volumi variabili o rumore di fondo intenso rendono più difficile individuare le singole parole in una registrazione. I parlanti sovrapposti possono avere un effetto simile, riducendo l'accuratezza di una trascrizione ASR.
- Vocabolario specifico di settore: I settori con gergo o acronimi specifici richiedono dizionari e riferimenti di dominio per migliorare l'accuratezza. Medicina e diritto sono due ambiti in cui gli strumenti ASR necessitano di assistenza aggiuntiva o di un addestramento specializzato.
- Privacy e sicurezza: In molte giurisdizioni, i dati vocali sono considerati dati personali. Le aziende devono disporre di policy di conservazione chiare e di misure di protezione per tutelare la gestione dei dati vocali e garantire la conformità alle normative più ampie.
Quando si lavora con la tecnologia ASR, una considerazione più ampia riguarda il rapporto tra latenza e accuratezza. Alcuni casi d'uso devono trovare un equilibrio tra le due, mentre settori come la medicina probabilmente danno priorità all'accuratezza sopra ogni altra cosa.
Inizia con ElevenAPI per un'integrazione ASR pronta per la produzione
ElevenAPI porta il riconoscimento vocale automatico pronto per la produzione nel tuo prodotto tramite Scribe v2, il modello Speech to Text di ElevenLabs. Scribe v2 offre timestamp a livello di parola, diarizzazione dei parlanti, tagging degli eventi audio e l'accuratezza e l'affidabilità necessarie per le applicazioni in tempo reale.
Esplora la pagina Speech to Text di ElevenLabs per maggiori informazioni oppure crea un account gratuito per rendere operativa un'API in pochi minuti.
Domande frequenti sull'ASR

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.