
Che cos'è la latenza dell'IA conversazionale e cosa la influenza?
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Per l'IA conversazionale, la latenza è ciò che distingue le buone applicazioni da quelle eccellenti.
Per sua natura, l'IA conversazionale è ambiziosa. Mira a replicare la sensazione di conversare con una persona, rispecchiandone la stessa gamma emotiva, il tono e la cadenza. Se aggiungi un ritardo che sembra «naturale» tra il momento in cui smetti di parlare e quello in cui un agente IA inizia a rispondere, ottieni un obiettivo di latenza basato su come le persone comunicano davvero.
Le aziende che vogliono implementare agenti di IA conversazionale su larga scala devono ridurre il più possibile questa latenza per ottenere un'interazione naturale. Questo articolo spiega cos'è la latenza dell'IA conversazionale, quali sono le cause dei ritardi nell'intera pipeline e come ridurli a grandi linee.
In sintesi
- La latenza dell'IA conversazionale è il ritardo end-to-end totale dal momento in cui un utente smette di parlare a quello in cui sente la prima parola dell'agente.
- Gli agenti con una latenza superiore a 700 ms possono sembrare poco naturali, mentre quelli oltre 1.200 ms hanno tassi di abbandono elevati.
- La latenza si accumula in ogni fase della pipeline dell'IA conversazionale.
- ElevenAgents gestisce l'intera pipeline in un'unica architettura unificata, rendendo l'IA conversazionale a bassa latenza accessibile alla tua azienda.
Cos'è la latenza dell'IA conversazionale?
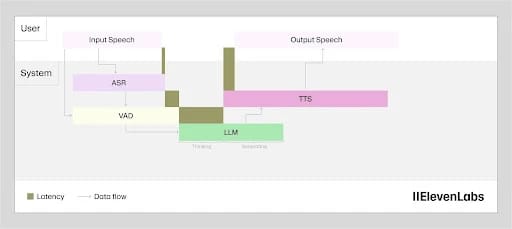
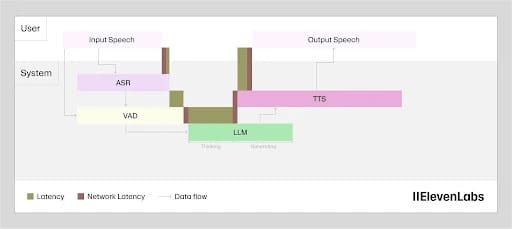
La latenza dell'IA conversazionale indica il tempo totale che un sistema impiega a rispondere dopo che hai parlato. Per i moderni modelli IA, la latenza si misura in ms. Dietro le quinte, il valore di latenza totale è in realtà composto da diversi processi distinti, ognuno dei quali contribuisce a una parte della pipeline end-to-end.
Una tipica pipeline di IA conversazionale è composta da:
- Un utente parla
- L'audio viene trascritto da un modello speech to text
- La trascrizione viene passata a un modello LLM, che produce una risposta
- Il testo dell'LLM viene quindi sintetizzato in audio con un modello text to speech
- L'audio viene quindi riprodotto all'utente
Ognuna di queste fasi aggiunge latenza a un sistema di IA conversazionale. Per questo, quando si parla di latenza, è utile chiarire alcuni acronimi.
Latenza di inferenza del modello
La latenza di inferenza del modello è il tempo che un modello impiega per generare output, misurato internamente ed escludendo tutti i fattori esterni. È la misura specifica del modello che indica quanto rapidamente il motore elabora input tipici. Ad esempio, Flash v2.5 ha una latenza di inferenza di circa 75 ms. Conoscendola, puoi confrontare la velocità dei modelli tra diversi concorrenti.
Detto questo, ricorda che non è il valore di latenza effettivamente percepito da un utente. Riguarda esclusivamente il tempo totale che un modello impiega per generare output.
Tempo al primo token dell'LLM
Il tempo al primo token (TTFT) di un large language model (LLM) è il tempo totale necessario a un LLM per elaborare un prompt e generare il primo token di output utilizzabile.
La generazione TTS inizia quando arriva il primo token dal tuo LLM, quindi questa misura indica quanto tempo impiega l'LLM a iniziare a far eseguire il tuo modello TTS. Per la maggior parte dei sistemi di IA conversazionale end-to-end, il TTFT dell'LLM rappresenta una parte significativa della latenza totale.
Tempo al primo audio del TTS (TTFA)
Il tempo al primo audio del TTS (TTFA) misura il tempo che intercorre dalla prima richiesta TTS al momento in cui il primo chunk audio esce effettivamente dal modello. È un modo per descrivere la latenza di inferenza del modello, ma specificamente per i motori TTS.
Tempo end-to-end al primo audio (TTFA)
Il TTFA end-to-end corrisponde alla latenza totale dell'IA conversazionale. È la somma di ogni parte della pipeline, dal riconoscimento vocale, al TTFT dell'LLM, al TTS, al TTFA e a tutte le trasmissioni di rete tra le fasi. Quando si parla della latenza complessiva dell'IA conversazionale, questa è la metrica percepita dall'utente.
Quando parla, dovrà attendere il TTFA end-to-end prima di sentire una risposta dal tuo agente. È una misura olistica, il che significa che migliorare qualsiasi parte della pipeline la migliorerà.
Perché la latenza dell'IA conversazionale è importante
Quando un utente parla con il tuo agente IA, la latenza diventa un fattore centrale nel modo in cui percepisce l'esperienza. Tempi di latenza ridotti diminuiscono l'attesa per una risposta, rendendo la conversazione più naturale e l'agente più efficace.
Gli agenti con latenza elevata sembrano artificiali e meno competenti, anche se la qualità delle risposte è la stessa. Per le aziende, anche una differenza di poche centinaia di ms può sembrare un'eternità, facendo apparire il tuo agente di assistenza clienti macchinoso e inefficace.
Ecco alcuni scenari che mostrano perché la latenza dell'IA conversazionale è importante nella pratica:
- Meno di 500 ms: un agente conversazionale risulta reattivo e fluido. Gli utenti potrebbero non notare il ritardo tra quando smettono di parlare e quando ricevono la prima risposta, permettendo alla conversazione di procedere senza intoppi.
- Da 500 ms a 1000 ms: il ritardo tra il momento in cui un utente smette di parlare e quello in cui riceve una risposta può diventare percepibile. È appena un po' troppo lungo, quindi gli utenti potrebbero cercare di adattarsi in anticipo ripetendosi o facendo una pausa per capire se l'agente li ha davvero compresi.
- Oltre 1000 ms: i ritardi iniziano a sembrare lenti, con pause che fanno pensare ad alcuni utenti che l'agente IA non riesca a tenere il passo della conversazione. Le trascrizioni possono mostrare interruzioni occasionali o richieste di parlare con un operatore umano. In alcuni casi, gli utenti possono abbandonare la chiamata.
Ognuna di queste soglie si traduce in risultati concreti per l'azienda.
Nella fascia più bassa dello spettro di latenza, avrai un agente di assistenza clienti in grado di gestire naturalmente le domande in arrivo e aiutare gli utenti a risolvere le richieste senza ulteriore assistenza. Riduce il carico dei tuoi operatori umani e mantiene alta la soddisfazione dei clienti. Nella fascia più alta dello spettro di latenza, invece, frustrerai i clienti con un agente che sembra esitare troppo a lungo.
Abbiamo definito i benchmark del budget di latenza degli agenti vocali in un altro articolo, per mostrare come si presenta una buona latenza sia per i valori P50 sia per quelli P95.
Quali sono le cause della latenza nell'IA conversazionale?
La latenza dell'IA conversazionale è un termine che riassume diversi processi, con ogni segmento che contribuisce al totale. Per questo, il collo di bottiglia per una bassa latenza è più un problema a livello di sistema che qualcosa risolvibile semplicemente scegliendo un modello migliore. Dopotutto, nella pipeline interagiscono diversi modelli.
Per gli sviluppatori, abbiamo scritto una guida tecnica approfondita sull'ottimizzazione della latenza degli agenti vocali che puoi usare per migliorare ogni fase del tempo end-to-end al primo audio (TTFA).
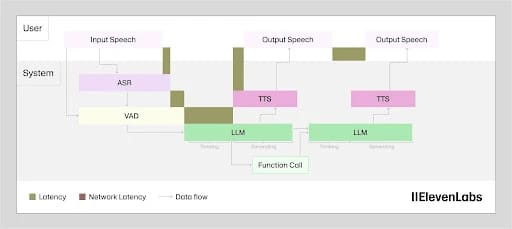
Oltre alla pipeline principale, anche altri fattori come la telefonia e il function calling aggiungono latenza, pur non essendo interni all'infrastruttura del modello.
Ecco una panoramica di tutti i fattori che contribuiscono alla latenza dell'IA conversazionale.
Riconoscimento vocale automatico
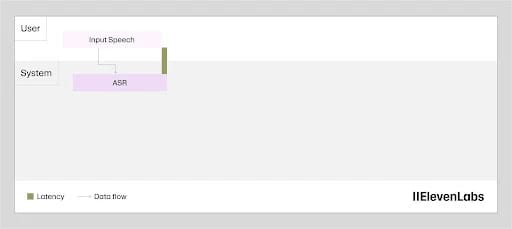
La latenza del riconoscimento vocale non è il tempo necessario per generare una trascrizione. Il processo di trascrizione viene eseguito in background mentre l'utente parla, quindi quando il parlato termina, il testo è in gran parte già pronto.
Qui la latenza è in realtà l'intervallo tra la fine del parlato e il momento in cui la trascrizione viene finalizzata e passata alla fase successiva. Scribe v2 Realtime riduce questo intervallo a circa 150 ms, effettuando streaming continuo affinché l'output sia pronto nel momento in cui termina il turno.
Gestione dei turni ed endpointing
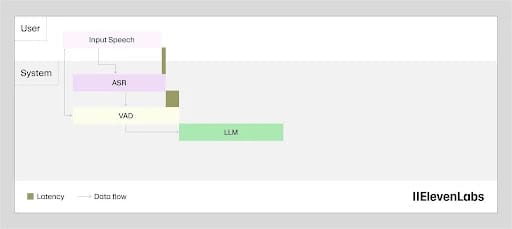
Un Voice Activity Detector (VAD) si colloca tra il riconoscimento vocale e il modello linguistico. Il suo compito è decidere quando l'utente ha effettivamente finito di parlare.
Per evitare errori, il VAD attende una soglia di silenzio prolungato prima di dichiarare concluso il turno, e questa attesa aggiunge latenza prima che il modello linguistico elabori una parola. Questa piccola latenza aggiuntiva richiede tempo, ma impedisce anche al sistema di iniziare a rispondere mentre l'utente sta ancora parlando.
Tecnicamente, se tutti gli altri componenti dell'IA conversazionale avessero latenza zero, la latenza attribuita alla gestione dei turni sarebbe un aspetto positivo. Le persone si prendono un attimo prima di rispondere. Una macchina che fa una pausa simile rende l'interazione più realistica. Tuttavia, poiché gli altri componenti dell'IA conversazionale generano già latenza, l'ideale è una latenza minima.
Elaborazione del modello linguistico
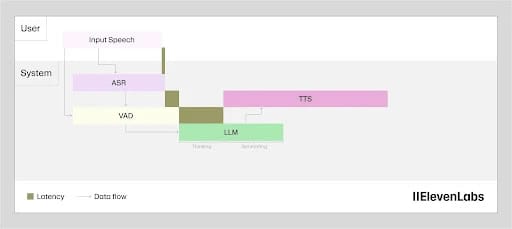
Una volta pronta la trascrizione dal motore speech to text (STT), il modello linguistico genera una risposta. Qui la latenza è il tempo necessario per iniziare a generare token, non per generare l'intera risposta. Questi token vengono trasmessi direttamente alla fase TTS man mano che arrivano, quindi ciò che conta di più è il TTFT.
Oltre alla scelta del modello, sia la lunghezza del prompt sia la dimensione della knowledge base influiscono su questa fase. Più contesto deve considerare l'LLM, più tempo impiega. Quando progetti questi sistemi su larga scala, devi trovare il giusto equilibrio tra una knowledge base utile e un prompt essenziale per mantenere la velocità.
Sintesi vocale
La latenza TTS è il tempo che intercorre tra la ricezione dei primi token dal modello linguistico e l'inizio dell'audio. Poiché i token arrivano più velocemente di quanto venga riprodotto il parlato umano, il modello di sintesi non aspetta mai la risposta completa. La latenza TTS è strettamente il tempo fino al primo chunk audio.
Questa fase era in passato il principale contributo alla latenza dell'IA conversazionale: i modelli meno recenti impiegavano 2-3 secondi per iniziare a generare parlato. Flash v2.5 di ElevenLabs affronta direttamente questo problema, offrendo sintesi vocale con una latenza di ~75 ms e riducendo quel collo di bottiglia da secondi a una frazione di secondo.
Latenza di rete
L'invio di dati da un luogo a un altro aggiunge sempre latenza e la distanza geografica non fa che aggravare la latenza di rete di andata e ritorno.
Poiché diversi componenti collaborano per fornire una risposta end-to-end, una latenza significativa può accumularsi attraverso vari hop di rete.
Function calling
Le chiamate di funzione aggiungono round trip API nella fase dell'LLM. Una rapida ricerca interna aggiunge decine di millisecondi, mentre un processore di pagamenti o un sistema di inventario potrebbe aggiungere secondi. La quantità di latenza dipende interamente dal servizio chiamato, rendendo questa la fase più difficile da ottimizzare direttamente.
Il pattern più efficace consiste nell'istruire l'LLM a rispondere prima che la chiamata allo strumento sia completata. Una frase come "Controllo subito" mantiene l'utente coinvolto mentre la chiamata esterna viene elaborata, anziché lasciare silenzio. La risposta vocale inizia mentre lo strumento viene eseguito in parallelo.
Come ridurre la latenza dell'IA conversazionale
Ridurre la latenza dell'IA conversazionale richiede di intervenire su ogni fase della pipeline in ordine di impatto. Sebbene i singoli miglioramenti abbiano un effetto sulla latenza, dovrai lavorare sull'intera pipeline in modo olistico per ottenere il cambiamento maggiore.
Ecco alcuni principi che possono guidarti nella riduzione della latenza dell'IA conversazionale a grandi linee:
- Scelta del modello TTS: i modelli TTS ottimizzati per la velocità, come Flash v2.5, utilizzano architetture diverse dai modelli ottimizzati per la qualità, come Eleven v3 ed Eleven v4. Per gli agenti vocali in tempo reale, la scelta giusta è il modello di qualità più elevata che soddisfa il tuo obiettivo di latenza, che quasi sempre è un modello ottimizzato per la velocità.
- Scelta del modello LLM: gli LLM più piccoli e veloci in genere producono un tempo al primo token inferiore rispetto a quelli più grandi. Scegliere l'LLM più rapido che soddisfi comunque i tuoi standard qualitativi per l'attività è importante quanto la scelta del modello TTS.
- Streaming: lo streaming TTS restituisce l'audio in chunk man mano che procede la sintesi, quindi l'utente sente la prima parola mentre il modello sta ancora generando il resto. Questo concetto vale anche per l'output dell'LLM: avviare la sintesi TTS sulla prima frase mentre il modello linguistico genera quelle successive può recuperare latenza nella pipeline.
- System prompt: gli utenti possono semplificare i system prompt spostando le istruzioni in procedure o workflow, invece di mantenerle in ogni fase decisionale. Così si riduce la quantità di contesto su cui il modello deve ragionare a ogni turno.
- Guardrail: eseguire i guardrail nel modello di streaming consente all'output di iniziare la riproduzione prima che il controllo del guardrail sia completato, anziché bloccare la riproduzione fino alla fine della verifica.
- Collocazione dei modelli: usare, dove possibile, modelli collocati nella stessa sede, come nello stack ElevenLabs Agents, mantiene i componenti vicini e impedisce che la latenza venga aggiunta dai hop tra modelli forniti separatamente.
- Geografia: la vicinanza tra i tuoi server e gli utenti può ridurre significativamente la latenza, poiché diminuisce direttamente il contributo della rete al TTFA end-to-end.
Oltre a questi fattori, puoi usare questa guida tecnica all'ottimizzazione della latenza per maggiori dettagli.
Inizia a usare l'IA conversazionale a bassa latenza con ElevenAgents
La latenza dell'IA conversazionale è un aspetto fondamentale da considerare quando crei e implementi agenti. Con ElevenAgents, l'ottimizzazione della latenza è integrata nel processo. Dalle tecniche di sovrapposizione per recuperare tempo alla bassa latenza di inferenza dei singoli componenti, ElevenAgents crea stack di IA conversazionale a bassa latenza per la tua azienda.
In definitiva, l'obiettivo è creare realismo. Un utente deve percepire la semplicità di parlare con una persona, ottenendo al contempo i vantaggi di un programma informatico. Ottimizzando i sottoprocessi, questo ora è possibile.
Scopri di più su ElevenAgents oppure contatta il team vendite per iniziare oggi.
FAQ sulla latenza dell'IA conversazionale

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.




