
Come funziona la trascrizione audio con timestamp e tag degli eventi?
- Scritto da
- Jack Limebear
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Un modello nativo di trascrizione a livello di parola riceve come input una registrazione audio o uno stream in tempo reale e restituisce un array strutturato di oggetti token etichettati e con timestamp, che rappresentano parlato e suoni non verbali. Ogni token appartiene a uno di tre tipi: word, spacing o audio_event. Gli eventi audio possono includere risate, applausi o altri suoni di sottofondo.
In questo articolo esploreremo come funziona la trascrizione audio con timestamp e perché è una forma di trascrizione più flessibile e potente rispetto a quella convenzionale, che si basa sul forced alignment.
In sintesi
- La trascrizione a livello di parola restituisce direttamente array strutturati e con timestamp di dati vocali ed eventi audio non verbali.
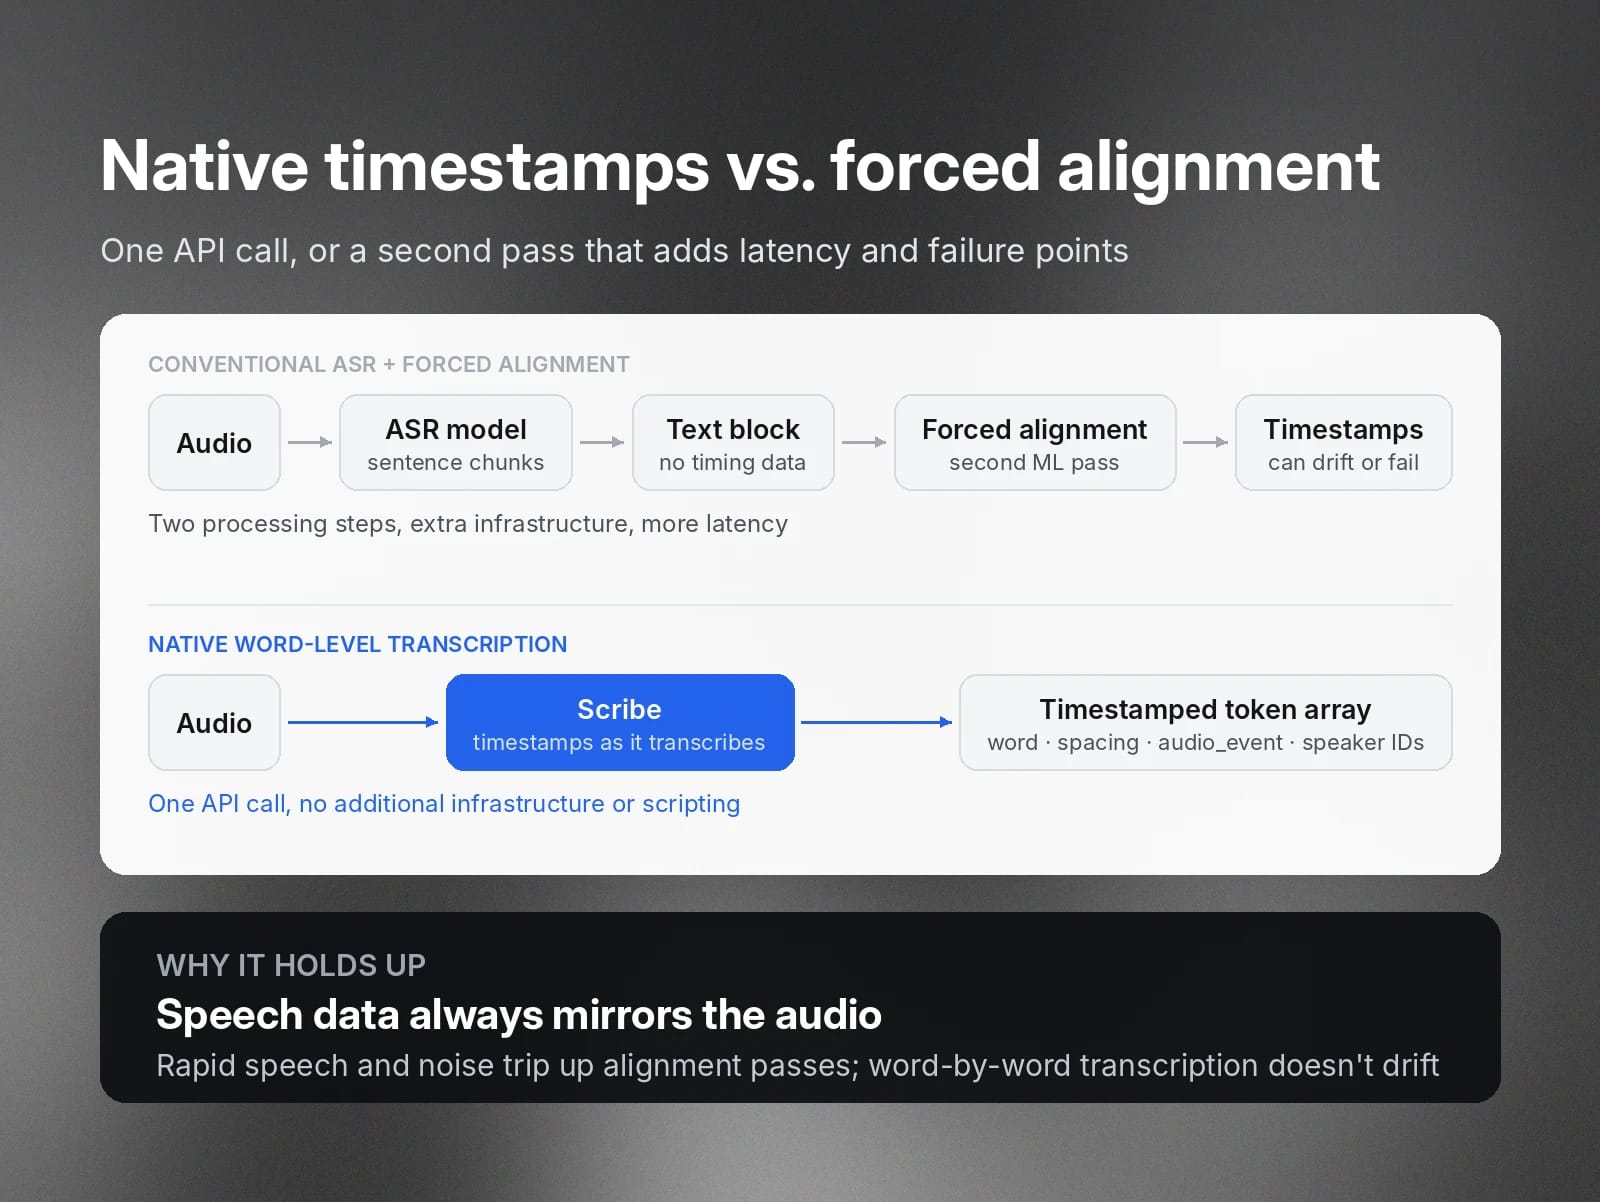
- Questo approccio è diverso dai modelli convenzionali di riconoscimento vocale automatico, che restituiscono blocchi di testo completi. Per associare timestamp all'audio originale, devi eseguire un secondo processo di forced alignment, che richiede più tempo e risorse di calcolo.
- I tag degli eventi ti aiutano a rilevare contenuti non verbali, come risate o applausi. Poiché questi dati sono ricercabili, puoi usarli per identificare momenti salienti o potenzialmente virali in base alle reazioni del pubblico.
- Puoi fornire i dati strutturati risultanti alle applicazioni per diversi casi d'uso, tra cui sottotitoli estremamente accurati, archivi audio ricercabili e creazione automatica di clip per i social.
- La trascrizione a livello di parola di Scribe può supportare fino a 5 canali, ciascuno trascritto in modo indipendente.
Che cos'è la trascrizione audio con timestamp e tag degli eventi?
La trascrizione con timestamp è una forma di riconoscimento vocale automatico (ASR) che, durante la trascrizione, rileva con precisione i punti di inizio e fine delle parole e di altri eventi audio, come gli applausi. Restituisce dati completamente strutturati e navigabili.
La trascrizione ASR convenzionale analizza l'audio in grandi blocchi di testo leggibile. Ti fornisce sottotitoli e una trascrizione per i lettori, ma non è particolarmente utile come dato.
Se vuoi strutturarla con timestamp, devi elaborarla di nuovo tramite un servizio secondario di machine learning per associare il testo all'audio. Potresti ottenere un output simile, ma sarebbero necessari più passaggi di elaborazione anziché riceverlo nativamente dall'API, con l'aggiunta di latenza e un maggiore carico computazionale.
Rendere l'audio navigabile
Il vantaggio principale della trascrizione con timestamp e tag degli eventi è che può essere letta sia dalle persone sia dalle macchine. Questo apre a importanti applicazioni aziendali:
- Audit di conformità: puoi cercare parole chiave in una trascrizione e ottenere timestamp esatti per ogni menzione di dati sensibili.
- Produzione e montaggio video: i software di produzione video possono sincronizzare i sottotitoli al millisecondo con ciò che viene detto sullo schermo. Possono anche etichettare correttamente le reazioni del pubblico.
- Archivi ricercabili: i team di pubbliche relazioni, vendite e formazione, tra gli altri, possono trascrivere grandi volumi di interviste ai clienti, discorsi in fiere, webinar o riunioni cittadine in enormi archivi ricercabili.
- Analisi di marketing e sentiment dei clienti: il tagging degli eventi può etichettare le reazioni del pubblico che potrebbero andare perse in una semplice trascrizione testuale.
Quali sono i vantaggi dei timestamp nativi a livello di parola?
I modelli standard di Speech to Text elaborano il parlato in blocchi, in genere frasi o paragrafi completi. Se vuoi timestamp parola per parola, devi progettare un ulteriore livello di elaborazione per eseguire il cosiddetto forced alignment in una seconda fase. Questo aggiunge infrastruttura e latenza, oltre a più potenziali punti di errore. Ad esempio, i timestamp possono slittare o l'elaborazione può fallire del tutto quando si cerca di gestire un parlato rapido o coperto da forte rumore di fondo.
La trascrizione con timestamp, come quella eseguita da Scribe, evita questo problema trascrivendo a un livello più granulare, parola per parola. Lo fa in una sola chiamata API. Non sono necessarie infrastrutture o script aggiuntivi. Il modello calcola i timestamp durante la trascrizione, quindi i dati vocali rispecchiano sempre fedelmente l'audio.
Come funziona la trascrizione con timestamp e tag degli eventi?
Prendiamo Scribe come esempio.
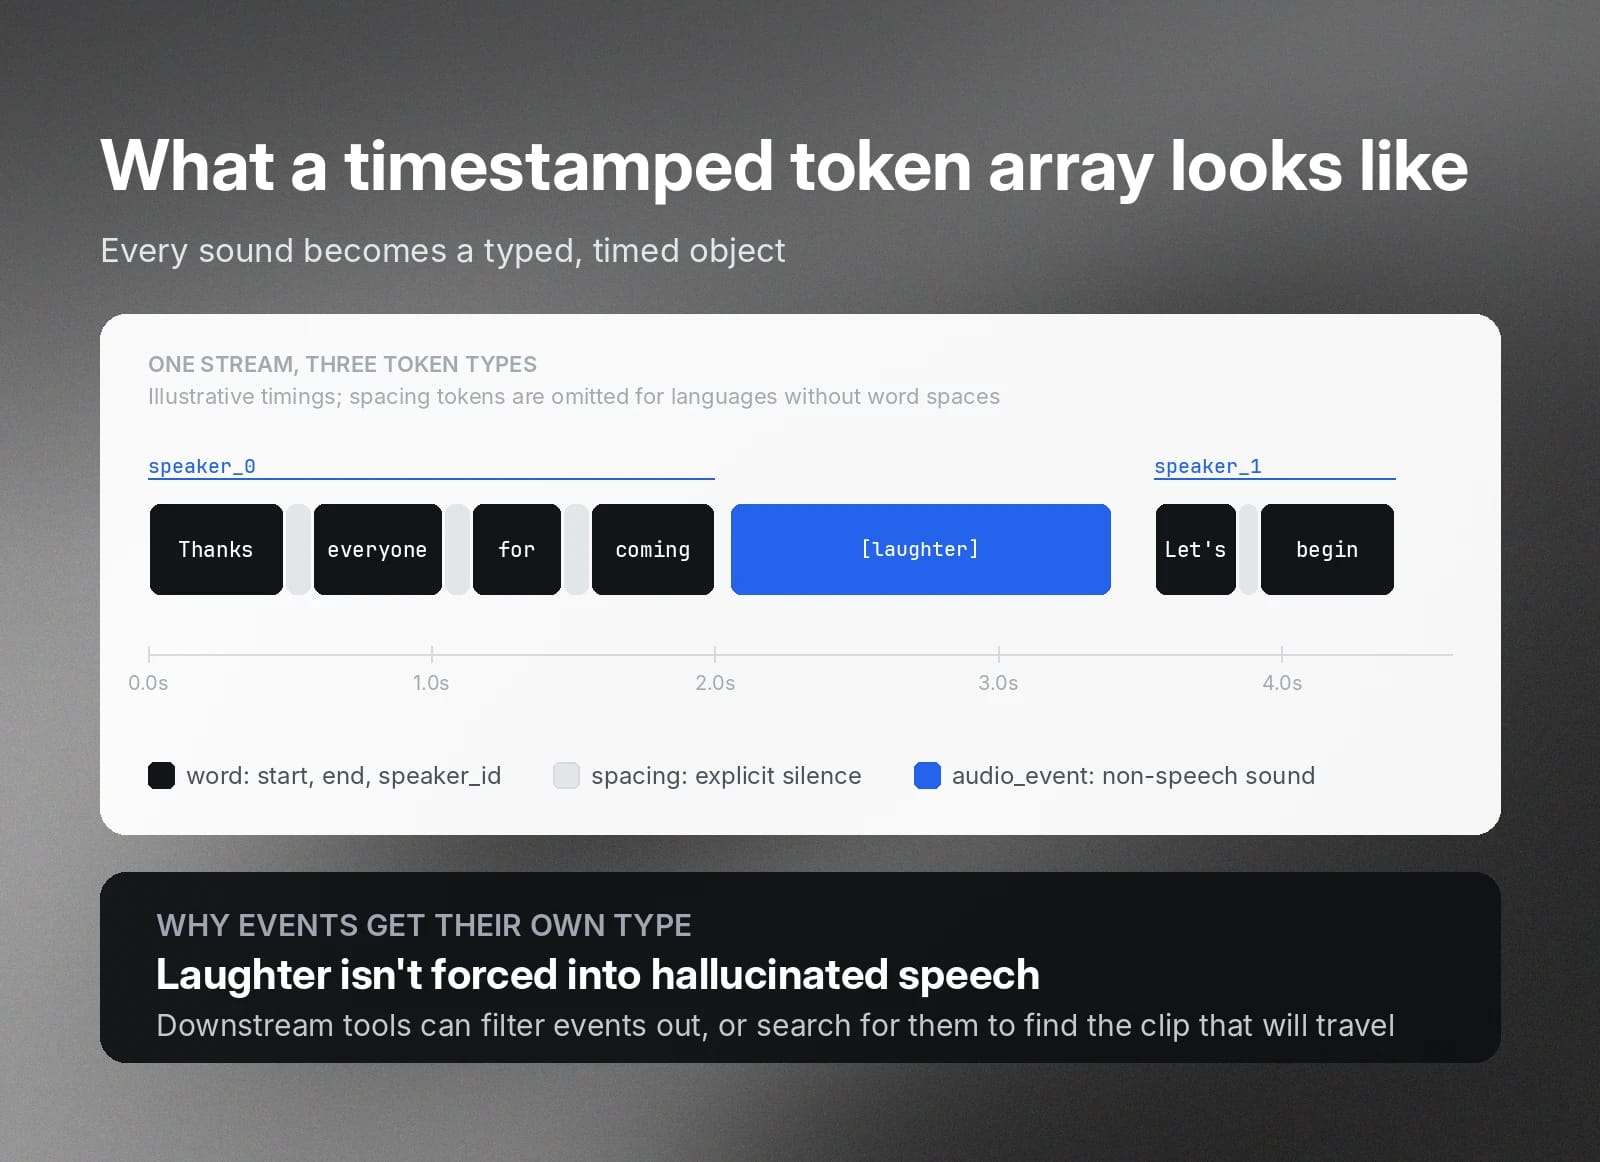
Un modello nativo di trascrizione a livello di parola associa i suoni del parlato in un flusso audio a un array strutturato di oggetti token. Etichetta ogni token come uno di tre tipi: word, spacing o audio_event.
- word: una singola parola pronunciata e riconosciuta, con orari di inizio e fine e un tag speaker_id.
- spacing: silenzio o pause durante il parlato esplicitamente etichettati. È utile per aiutare i servizi di sottotitolazione a mantenere il giusto ritmo. Non viene usato per le lingue rilevate che non separano le parole con spazi, come giapponese, mandarino, thai, lao, birmano e cantonese.
- audio_event: audio non verbale significativo, come risate o applausi. Il modello sa strutturarlo come tipo di evento separato e non forza l'audio in parlato allucinato.
Parametri di streaming in tempo reale
I modelli di trascrizione a livello di parola possono anche includere funzionalità speciali per supportare la trascrizione audio live via WebSocket. Ad esempio:
- include_timestamps=true: questo parametro fa sì che la connessione includa timestamp a livello di parola nei messaggi JSON committed_transcript_with_timestamps inviati alla fine di ogni blocco audio finalizzato, così ricevi i timestamp mentre lo stream è ancora in esecuzione. I tag degli eventi audio sono inclusi soltanto se è abilitato anche tag_audio_events.
- include_language_detection=true: questo parametro indica alla connessione di etichettare le diverse lingue parlate rilevate insieme al punteggio di confidenza del modello per il rilevamento. Ti aiuta a gestire sottotitoli multilingue in diretta.
Come fa un modello Speech to Text a etichettare gli eventi non verbali?
Scribe etichetta gli eventi audio quando hai abilitato il parametro tag_audio_events. In questo caso, assegna tag e timestamp con orari specifici di inizio e fine, proprio come fa per le parole. Può etichettare vari tipi di reazioni, soprattutto risate e applausi, ma anche altri suoni ambientali che potrebbero essere significativi nel contesto, inclusi passi o musica di sottofondo.
Nell'immediato, questo arricchisce trascrizioni e sottotitoli aggiungendo un contesto importante. Per un lettore può essere più difficile cogliere il sarcasmo leggendo un testo semplice e piatto. Un tag [laughter] arricchisce la trascrizione e la rende più coinvolgente sul piano emotivo.
Analisi migliori
Il tagging degli eventi rende anche più pulite le analisi a valle, perché questi strumenti non devono analizzare un unico blocco di testo non strutturato. La trascrizione nativa a livello di parola separa gli eventi audio come dati strutturati, così i tuoi strumenti possono filtrarli quando opportuno e operare su contenuti esclusivamente verbali.
Poiché i token spacing rendono visibili le pause, puoi analizzarle. Questo può essere utile per l'analisi del sentiment e per casi d'uso di QA, ad esempio per misurare per quanto tempo un operatore del servizio clienti è rimasto in silenzio durante una chiamata.
Ricerca dei timestamp più semplice
Oppure puoi cercarli in modo specifico. Se stai eseguendo un'analisi del sentiment su un'intervista per il test di un prodotto, puoi individuare reazioni emotive significative. Se gestisci un account social, puoi invece cercare rapidamente le risate in un discorso di un'ora per trovare le clip che ritieni abbiano maggiori probabilità di diventare virali.
Quali sono le applicazioni pratiche delle trascrizioni strutturate con timestamp?
Ottenere dati strutturati nativamente nelle trascrizioni offre diversi importanti casi d'uso.
Generazione di didascalie e sottotitoli
Puoi esportare le trascrizioni con timestamp direttamente nei formati di sottotitolazione per la produzione, inclusi SRT e VTT, senza elaborazioni intermedie. Il tuo strumento di montaggio video può usare la temporizzazione delle parole per evidenziarle nei sottotitoli mentre vengono pronunciate.
Il modello di trascrizione può analizzare facilmente il parlato rapido perché lo elabora parola per parola. Laddove un modello convenzionale potrebbe avere difficoltà con un parlato molto veloce o con voci sovrapposte, un modello a livello di parola come Scribe può restituire una trascrizione pulita e strutturata.
Ricerca di audio e video
La trascrizione convenzionale ti permette di trovare parole chiave nel blocco di testo, ma senza forced alignment non puoi passare al momento in cui è stata pronunciata una frase. Una ricerca per parole chiave su una trascrizione a livello di parola è completamente indicizzata e ti porta esattamente al secondo in cui una frase è stata pronunciata nell'audio. In questo modo, il tuo archivio audio diventa un catalogo di riferimento completamente ricercabile. Questa funzionalità è particolarmente utile per gestire grandi librerie multimediali, reti di podcast e archivi aziendali.
Audit di conformità e dei rischi
Spesso vorrai registrare audio contenente informazioni sensibili, ad esempio chiamate al servizio clienti per il QA. Sono proprio queste le chiamate che più probabilmente contengono informazioni personali sensibili o soggette a regolamentazione.
Per restare conforme continuando ad avere dati audio per le analisi, hai bisogno di un modo per oscurare i dati sensibili dalle trascrizioni in tempo reale. Il timestamping nativo a livello di parola ti permette di sfruttare funzionalità come Entity Detection di ElevenLabs, che segnala entità sensibili, come numeri di carte di credito o nomi, e restituisce i relativi offset e timestamp affinché tu possa oscurarle nelle trascrizioni man mano che arrivano.
Ad esempio, puoi rilevare e oscurare un numero di carta di credito, il cognome da nubile della madre, la data di nascita e il nome del cliente mentre vengono pronunciati durante una chiamata di verifica dell'identità.
Creazione automatica di clip per i social media
Puoi anche automatizzare programmaticamente le ricerche per parole chiave per trovare momenti salienti nei contenuti più lunghi. Ad esempio, potresti evidenziare momenti importanti di un discorso elettorale o di un seminario aziendale. Questo ti aiuta a trasformare i contenuti recenti in highlight montati professionalmente per YouTube, LinkedIn o TikTok.
Temporizzazione multicanale e multirelatore
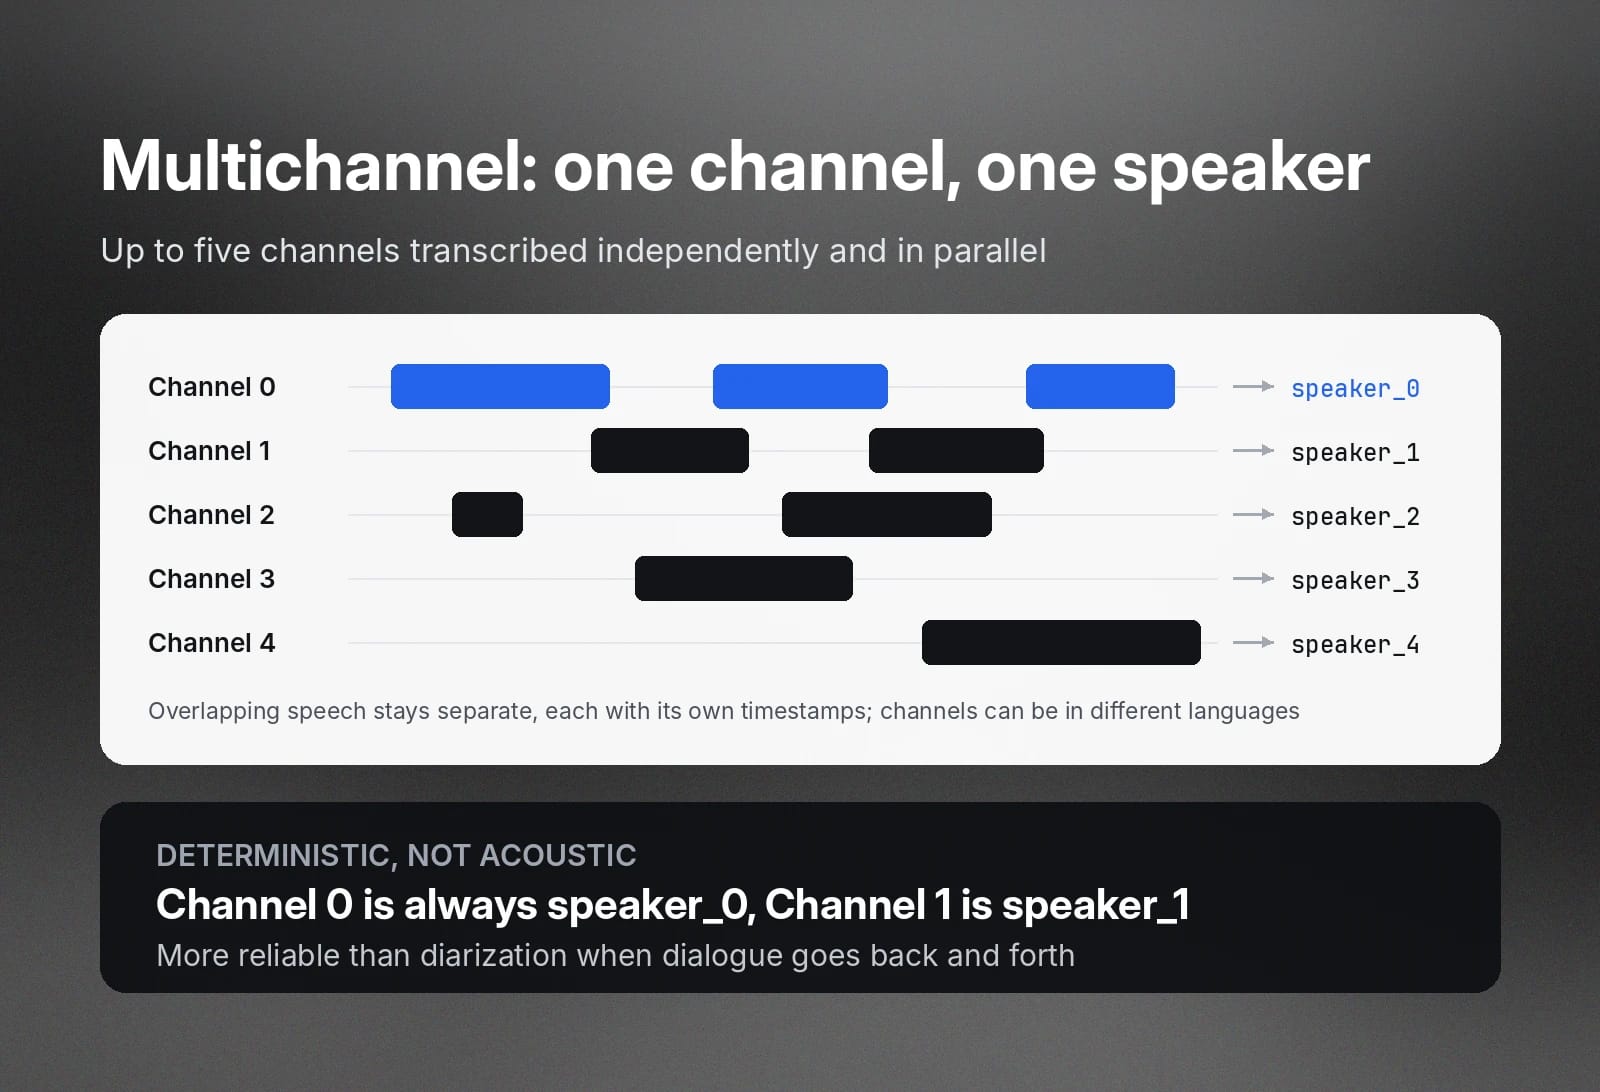
Scribe può trascrivere fino a cinque canali in modo indipendente e parallelo. A ciascuno vengono assegnati un ID del parlante e timestamp. È più affidabile della tradizionale diarizzazione del parlante, che spesso fatica con i dialoghi a botta e risposta. Per le registrazioni multicanale, l'assegnazione dei parlanti di Scribe è puramente deterministica. Ciò significa che il canale 0 corrisponde a speaker_0, il canale 1 a speaker_1 e così via.
Può riconoscere i parlanti che cercano di parlare contemporaneamente e generare comunque timestamp indipendenti per il loro parlato. Possono anche parlare lingue diverse.
Esportare dati con timestamp nel formato che ti serve
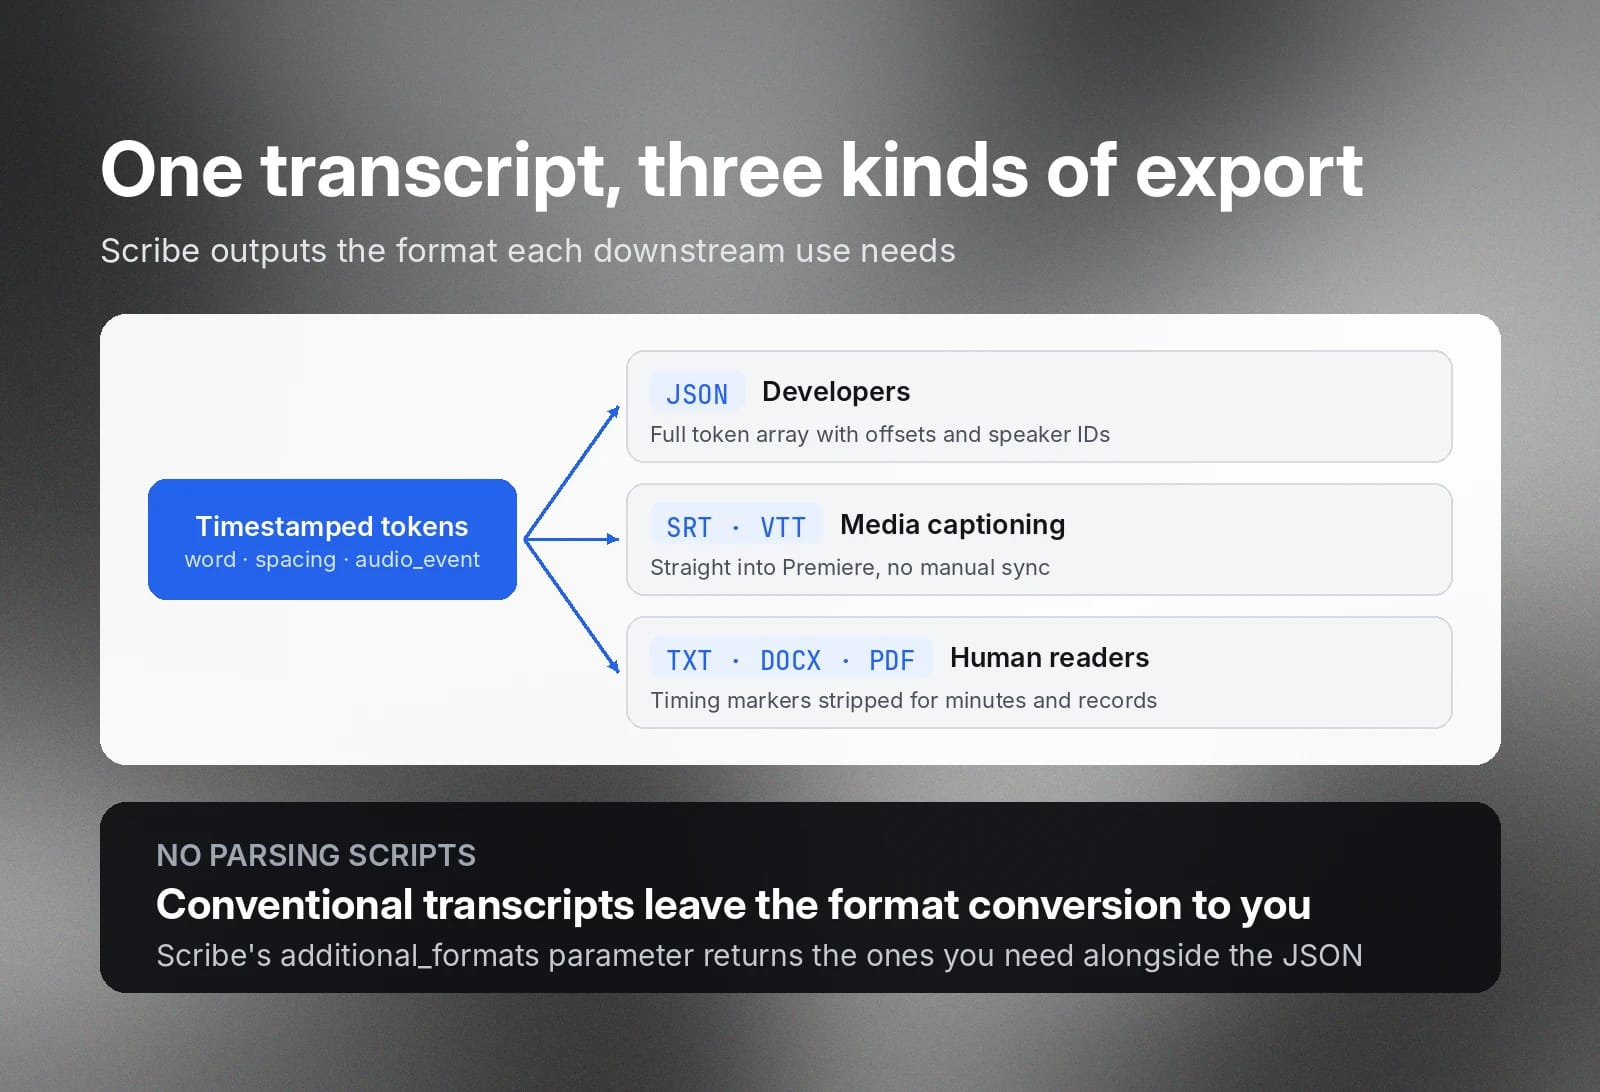
Se vuoi distribuire trascrizioni convenzionali in più formati, probabilmente dovrai scrivere tu gli script di parsing. Scribe può esportare le trascrizioni in più formati, a seconda di come intendi usarle. Puoi trovare le definizioni complete dello schema nel Riferimento API Create Transcript di ElevenLabs.
Dati strutturati per sviluppatori: JSON
Scribe supporta l'esportazione in JSON per gli sviluppatori che desiderano dati in uno schema da passare alle applicazioni a valle. Ad esempio, gli sviluppatori possono usare questi dati JSON per creare contenuti interattivi o un database di ricerca semantica per la propria organizzazione. L'array completo di token word, spacing e audio_event viene restituito con offset di inizio e fine e ID dei parlanti.
Sottotitolazione per contenuti multimediali: SRT e VTT
Scribe può restituire trascrizioni SRT e VTT da inserire direttamente in Adobe Premiere o in altre applicazioni di produzione, senza sincronizzazione manuale.
Leggibile: TXT, DOCX e PDF
Può anche restituire trascrizioni in formati facili da leggere. In questi formati, Scribe rimuove i marcatori temporali di basso livello per rendere il testo più leggibile e adatto alla documentazione legale o di audit. Ad esempio, è utile quando devi distribuire in modo efficiente i verbali di un consiglio di amministrazione subito dopo una sessione, pubblicare trascrizioni di podcast per la SEO o archiviare documenti legali.
Inizia a usare le trascrizioni di ElevenLabs con timestamp e tag degli eventi
La trascrizione nativa a livello di parola ti fornisce in modo rapido ed efficiente i dati strutturati necessari per i tuoi workflow.
Inizia oggi a trascrivere il tuo audio con Scribe in ElevenAPI oppure scopri di più sulla trascrizione a livello di parola.
Domande frequenti sui timestamp e sulla trascrizione con tag degli eventi

Jack Limebear fa parte del team Growth e si occupa di scrivere contenuti e definire strategie per il blog e le pagine insights. Prima di arrivare in ElevenLabs, ha guidato la strategia dei contenuti per oltre dieci anni in realtà che vanno da startup SaaS in rapida crescita a grandi aziende Fortune 500. Ha conseguito un Master in Letteratura Inglese presso l’Università di Cambridge.


