Text to Speech vs Speech to Text: qual è la differenza?
- Pubblicato
- Ultimo aggiornamento
AscoltaAscolta questo articolo
Immagina questa scena: stai guidando verso il lavoro e il tuo smartphone legge le email non lette usando un software di Text to Speech (TTS). Ancora meglio, invii le tue risposte senza nemmeno dover toccare il telefono o distogliere lo sguardo dalla strada, tutto grazie al software Speech to Text (STT).
Queste tecnologie non sono solo concetti divertenti e futuristici. Stanno diventando rapidamente parte integrante della nostra vita quotidiana, semplificando le attività di tutti i giorni e migliorando l'accessibilità.
Esploriamo il mondo del TTS e dello STT basati sull'intelligenza artificiale, per capire cosa sono, in cosa differiscono, come funzionano, cosa cercare nei fornitori di TTS e STT e i vari modi in cui vengono applicati nei diversi settori.
Le differenze tra TTS e testo dal parlato
Esistono diverse differenze chiave tra TTS e la tecnologia di testo dal parlato. Ecco quali sono.
Funzionalità
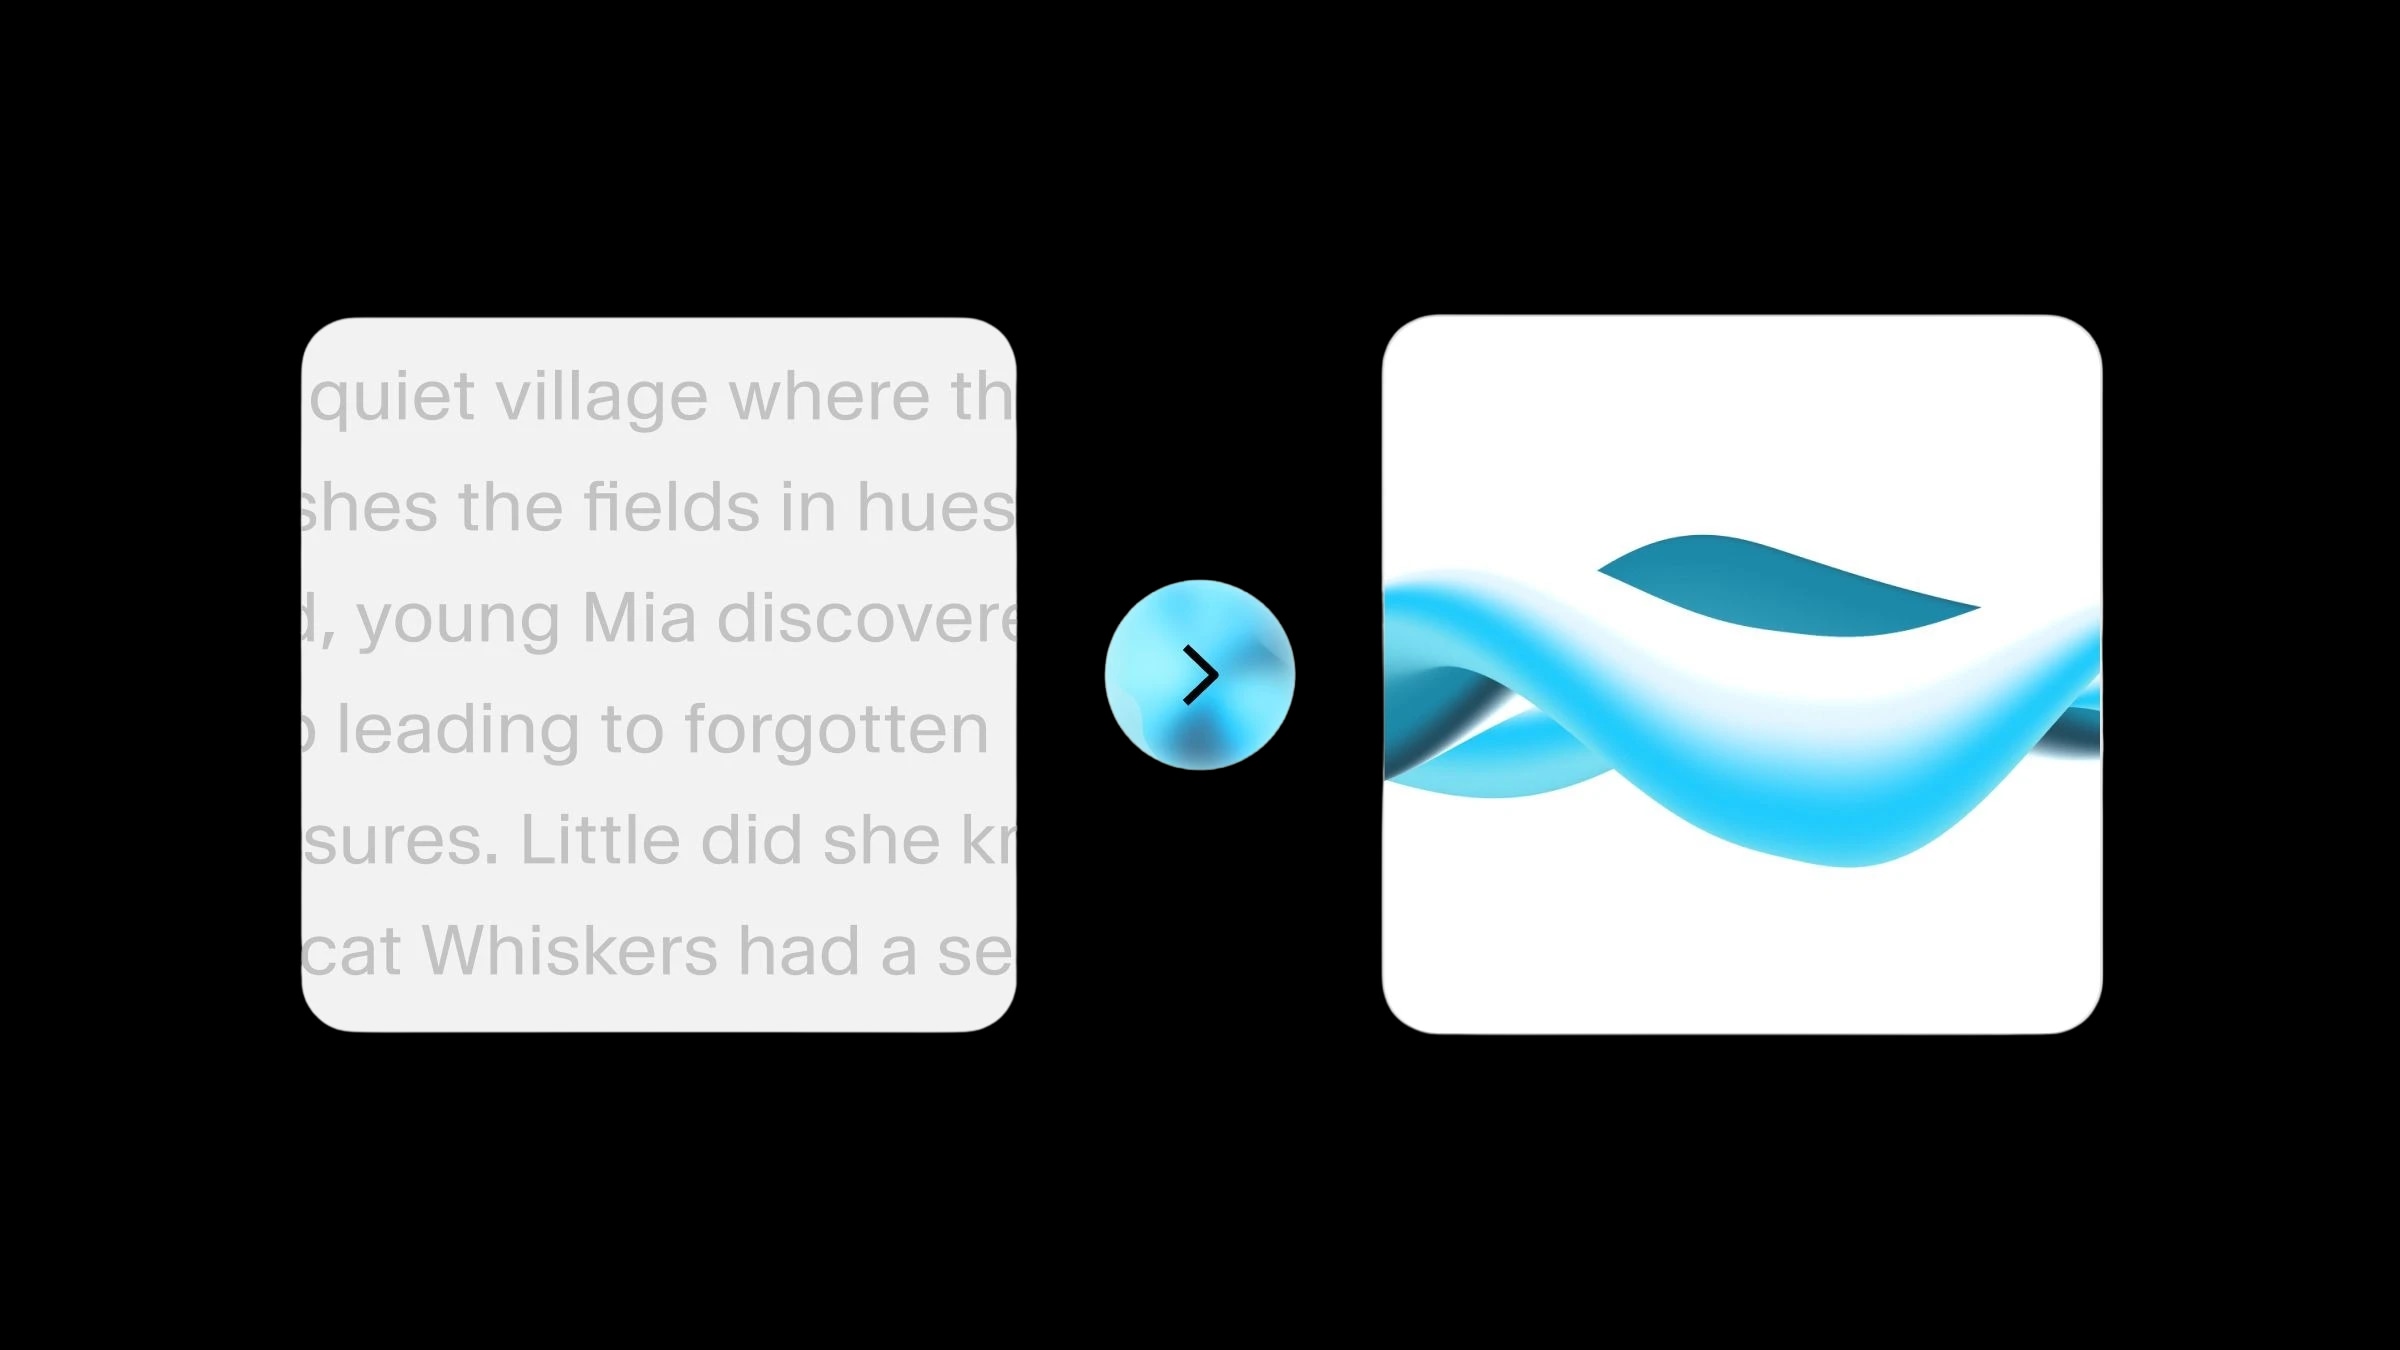
Il TTS (Text to Speech) converte il testo scritto in parole pronunciate, mentre Speech to Text (STT) fa il contrario, trascrivendo le parole pronunciate in testo. Il TTS rende udibili i contenuti scritti e funge da assistente vocale per le persone con disabilità visive o difficoltà di apprendimento. Lo STT, invece, acquisisce il linguaggio parlato e lo trasforma in una trascrizione scritta, utile per la dettatura e i comandi vocali.
Contesto d'uso
TTS è comunemente integrato in e-reader, sistemi di annunci pubblici e assistenti virtuali per fornire un output audio. Lo STT viene usato nei servizi di trascrizione, nelle applicazioni controllate vocalmente e nei sottotitoli in tempo reale per le persone con problemi di udito. Il contesto d'uso del TTS è principalmente orientato all'output e alla trasmissione di informazioni in forma audio. Al contrario, lo STT è incentrato sull'input, ovvero sull'acquisizione e l'elaborazione del linguaggio parlato.
Approccio tecnologico
TTS richiede l'analisi del testo, l'elaborazione del linguaggio e la sintesi vocale. Deve trasmettere accuratamente le sfumature del linguaggio parlato, incluse intonazione e ritmo. Lo STT richiede capacità avanzate di riconoscimento vocale per trascrivere con precisione accenti, dialetti e modalità di espressione diverse, spesso in tempo reale.
Cos'è il TTS (Text to Speech)?
Il TTS (Text to Speech) è una tecnologia che converte il testo scritto in parole pronunciate. Alla base, il TTS consente ai computer di leggere ad alta voce, trasformando qualsiasi testo in una voce sintetica. Questa tecnologia è ampiamente utilizzata in applicazioni che spaziano dagli assistenti virtuali agli strumenti di accessibilità per le persone con difficoltà di lettura.
Un esempio significativo di tecnologia TTS avanzata sono le capacità TTS di ElevenLabs. Il TTS di ElevenLabs si distingue per la capacità di produrre voci eccezionalmente naturali e simili a quelle umane. Ci riesce sfruttando sofisticati algoritmi di IA che non solo imitano il suono del parlato umano, ma comprendono e riproducono anche le sfumature e le inflessioni che caratterizzano i modelli del parlato naturale.
Questo livello di realismo rende il TTS di ElevenLabs ideale per creare contenuti audio coinvolgenti per vari media, migliorare le interfacce utente con feedback vocali e offrire un'alternativa di lettura accessibile agli utenti con disabilità visive.
Cos'è il testo dal parlato (Speech to Text, STT)?
Il testo dal parlato, noto anche come Speech to Text (STT), è il processo di conversione del linguaggio parlato in testo scritto. Questa tecnologia di riconoscimento vocale è fondamentale per creare trascrizioni da registrazioni audio, abilitare i comandi vocali e facilitare la sottotitolazione in tempo reale per l'accessibilità.
ElevenLabs ha compiuto notevoli progressi nella tecnologia STT. Il nostro modello Scribe converte in modo efficiente audio e video in testo in 99 lingue. Offre un'interfaccia intuitiva, ideale per acquisire riunioni, lezioni e interviste in forma scritta da file audio e video.
Come funziona il TTS?
La tecnologia TTS (Text to Speech) trasforma il testo scritto in parlato udibile attraverso un processo che comprende diversi passaggi complessi.
Inizialmente, il sistema TTS analizza il testo, segmentandolo in fonemi, le unità sonore più piccole di qualsiasi lingua. Questa segmentazione è fondamentale affinché il sistema possa pronunciare correttamente le diverse parole.
Dopo questa segmentazione fonemica, il sistema converte questi suoni in parlato digitale. Qui l'intelligenza artificiale (IA) svolge un ruolo cruciale. Sfruttando algoritmi di IA addestrati su ampi dataset di linguaggio parlato, il sistema può produrre un parlato con toni e ritmi simili a quelli umani. Il parlato generato viene quindi allineato con i fonemi identificati, dando vita a un output dal suono naturale.
Grazie ai progressi nell'IA e nel machine learning, le moderne tecnologie TTS si sono evolute notevolmente. Ora sono in grado di comprendere le sfumature contestuali, gestire più lingue ed emulare in parte le inflessioni emotive. Questi miglioramenti hanno reso l'output vocale molto più umano, portando a interazioni più naturali e coinvolgenti con i dispositivi digitali.
Quali sono i migliori fornitori di TTS?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
Come funziona lo Speech to Text?
La tecnologia Speech to Text (STT) trasforma il linguaggio parlato in testo scritto attraverso un processo complesso composto da più passaggi.
Innanzitutto, acquisisce le parole pronunciate, solitamente tramite un microfono. Questo input audio viene poi convertito in un formato digitale che il sistema può elaborare. Il cuore dello STT è la capacità di analizzare questo audio digitale. Utilizza algoritmi sofisticati per suddividere il parlato in segmenti più piccoli e riconoscibili.
Questi segmenti sono fonemi, le unità sonore più piccole del parlato. Il sistema STT confronta questi fonemi con un modello linguistico predefinito per identificare parole e frasi. Questo passaggio è fondamentale per comprendere accenti, dialetti e variazioni del parlato diversi.
Successivamente, il sistema applica tecniche di elaborazione del linguaggio naturale (NLP). L'NLP aiuta a comprendere il contesto e la sintassi del linguaggio parlato, consentendo una trascrizione più accurata. Permette inoltre al sistema di gestire strutture di frasi complesse e gergo specifico di settore.
I sistemi STT avanzati impiegano algoritmi di machine learning e deep learning, che migliorano con l'aumento dei dati e dell'utilizzo. Queste tecnologie consentono al sistema di apprendere nel tempo nuovi modelli di parlato, accenti e persino lingue, migliorandone accuratezza ed efficienza.
In sintesi, la tecnologia STT comprende l'acquisizione dell'audio, l'analisi fonemica, la modellazione linguistica e l'NLP, tutti supportati dal machine learning, per convertire efficacemente il parlato in testo.
Quali sono i migliori fornitori di Speech to Text?
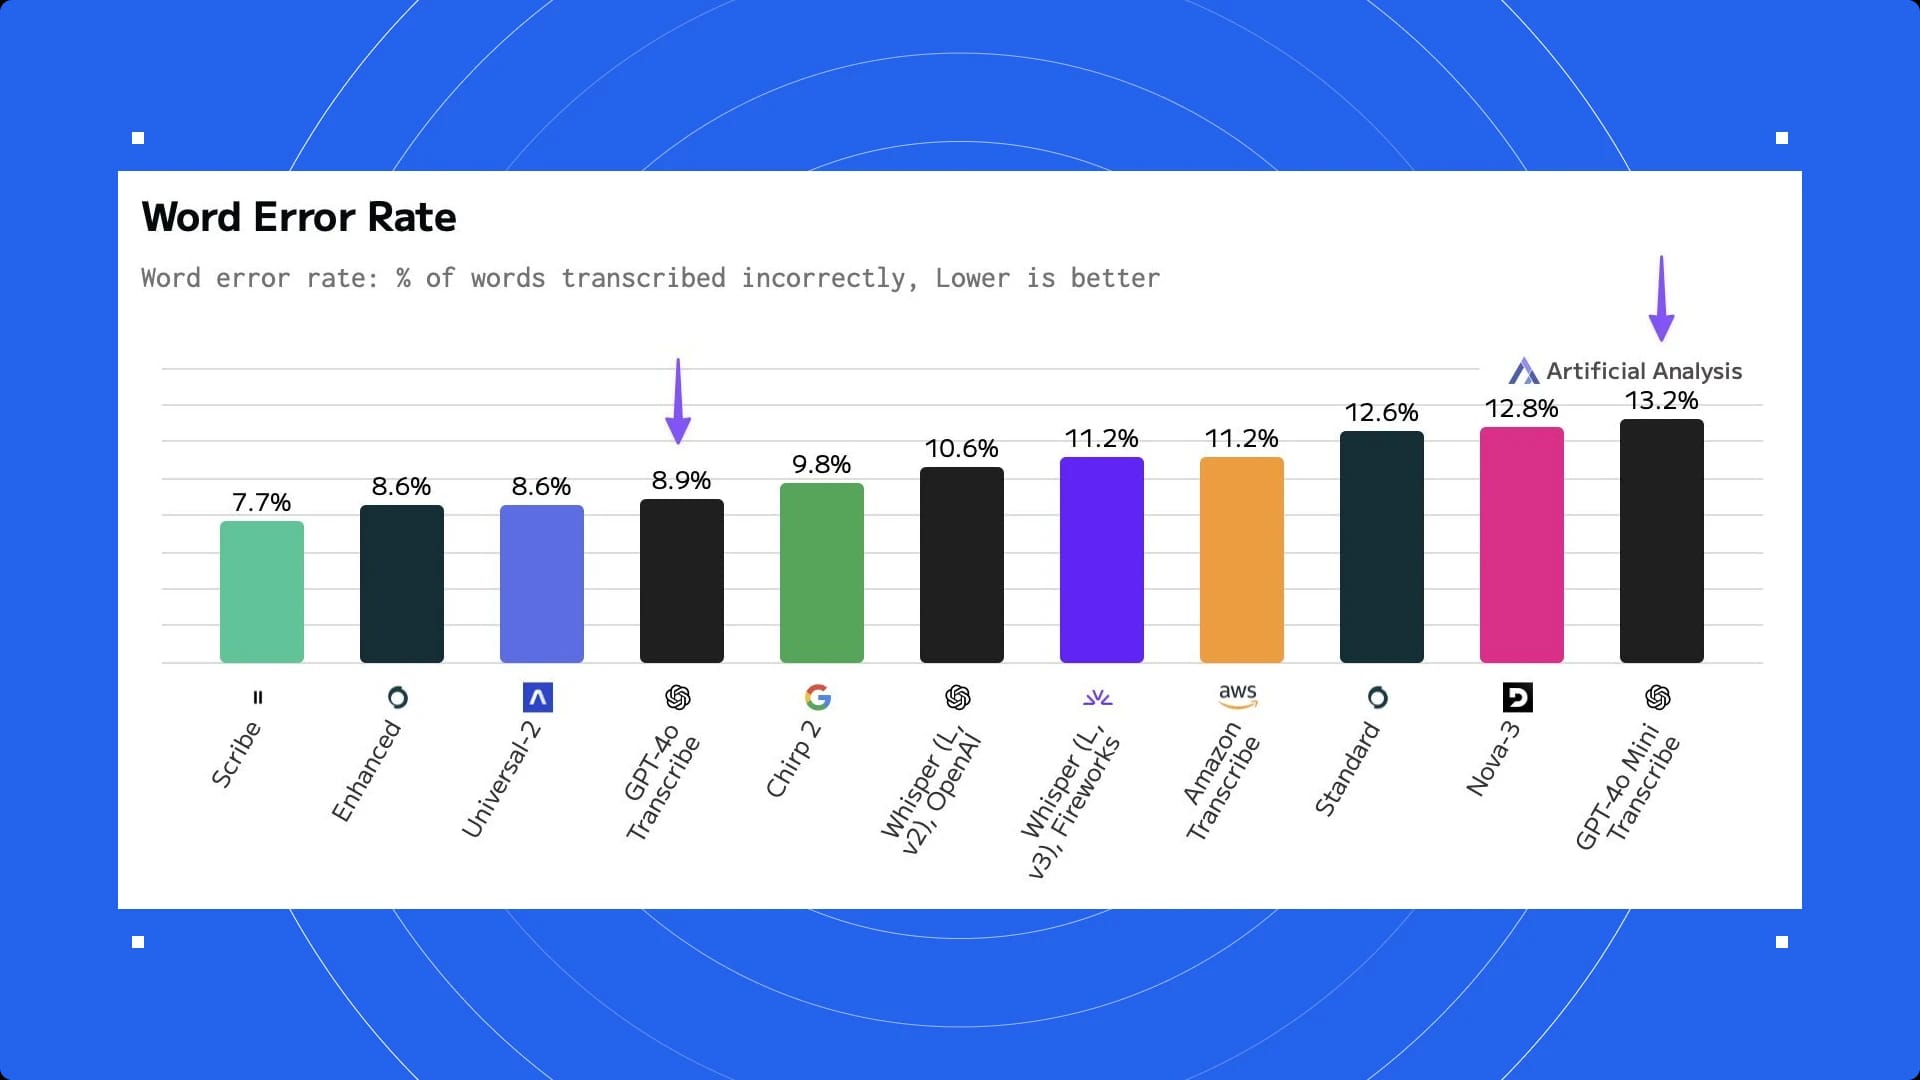
I migliori fornitori di Speech to Text sono Scribe di ElevenLabs, seguito da OpenAI e altri fornitori come Google.
TTS e STT: accuratezza e sfide
Le tecnologie TTS e Speech to Text puntano a una precisione simile a quella umana. La loro accuratezza migliora costantemente, ma questo non significa che siano perfette. Ecco cosa puoi aspettarti in termini di accuratezza e sfide da entrambe queste tecnologie.
Accuratezza e sfide del TTS (Text to Speech)
La tecnologia TTS per voci IA si è evoluta notevolmente, ma deve ancora affrontare alcune sfide. La principale è ottenere voci umane dal suono naturale. Sebbene i moderni sistemi TTS possano produrre un output audio chiaro e comprensibile, integrare inflessioni ed emozioni simili a quelle umane resta un ostacolo. Inoltre, il TTS fatica a interpretare il contesto e talvolta pronuncia erroneamente le parole in base a esso. Un'altra sfida è la personalizzazione delle voci per rispondere a esigenze diverse, come accenti e modalità di espressione differenti, essenziale per l'accessibilità globale.
Accuratezza e sfide del testo dal parlato/Speech to Text (STT)
La tecnologia STT ha fatto notevoli progressi in termini di accuratezza, soprattutto con l'avvento del deep learning. Tuttavia, incontra difficoltà in ambienti rumorosi, dove i suoni di sottofondo possono interferire con il riconoscimento vocale. Anche acquisire e trascrivere accuratamente accenti e dialetti diversi rappresenta una sfida significativa. Inoltre, i sistemi STT spesso faticano con gli omofoni, ovvero parole che suonano allo stesso modo ma hanno significati diversi, e con la comprensione di sintassi complesse o slang, compromettendo la loro efficacia complessiva nelle applicazioni reali.
Applicazioni in diversi settori
TTS e Speech to Text hanno trovato casi d'uso innovativi in un'ampia varietà di settori, trasformando il modo in cui interagiamo con le informazioni e migliorando l'accessibilità.
Applicazioni del TTS nei settori
La tecnologia TTS trova applicazione in vari settori. Nell'istruzione, aiuta a creare materiali didattici accessibili per studenti con difficoltà di lettura o disabilità visive. Per esempio, trasformando i libri di testo in audiolibri.
Nel settore automobilistico, il TTS alimenta le risposte vocali nei sistemi di navigazione. Il settore del servizio clienti utilizza il TTS per le risposte automatizzate nei call center, migliorando l'efficienza. Inoltre, il TTS è fondamentale nel settore dell'intrattenimento, in particolare nel gaming e negli assistenti virtuali, dove offre esperienze utente interattive.
Applicazioni dello STT nei settori
La tecnologia STT ha applicazioni diverse in molti settori. In ambito sanitario, aiuta a trascrivere le conversazioni tra medico e paziente e a dettare la documentazione clinica, migliorando così l'efficienza. In ambito legale, lo STT viene utilizzato per trascrivere procedimenti giudiziari e documentazione legale. Questa tecnologia svolge inoltre un ruolo fondamentale nei media, supportando i sottotitoli in tempo reale delle trasmissioni per le persone con problemi di udito. Nel mondo aziendale, lo STT facilita trascrizioni efficienti delle riunioni, migliorando la conservazione dei documenti e l'accessibilità delle informazioni.
Considerazioni finali
Le tecnologie TTS (Text to Speech) e Speech to Text (STT), pur sembrando simili, svolgono funzioni distinte. Il TTS trasforma il testo scritto in parole pronunciate, dando vita ai contenuti scritti con voci simili a quelle umane. Al contrario, lo STT fa l'opposto: converte le parole pronunciate in testo scritto, catturando le sfumature del linguaggio parlato in formato testuale.
Entrambe le tecnologie sfruttano un'IA avanzata, ma rispondono a esigenze diverse: il TTS per ascoltare materiale scritto e lo STT per creare documenti scritti a partire da contenuti parlati.
Pronto per iniziare? Prova Eleven v4, il nostro modello Text to Speech più espressivo.
Se vuoi provare una tecnologia TTS all'avanguardia, registrati a ElevenLabs oggi. Non rimarrai deluso.